Le schéma montre l'ouverture d'une session en mode public : la page charge widget.js, le widget demande une session à ATG, et ATG vérifie l'origine du site appelant avant de déclarer le chat prêt. Aucune authentification côté client n'intervient.
### Mode 2 - Connecté ```mermaid sequenceDiagram participant User as Utilisateur participant Site as App client participant Widget as Widget (JS) participant Backend as Backend client participant Iframe as Iframe ATG participant ATG as ATG User->>Site: Ouvre l'app avec le chat intégré Site->>Widget: Charge widget.js Widget->>Backend: getSignedParams() Backend-->>Widget: JWT (TTL ≤ 15 min) Widget->>ATG: POST /session/init { jwt } + preuve DPoP ATG-->>Iframe: Access token lié DPoP (en mémoire) Iframe-->>User: Chat prêt ```Le schéma montre l'ouverture d'une session en mode connecté : votre backend signe un JWT de courte durée (15 minutes au plus), le widget le présente à ATG avec une preuve DPoP, et ATG renvoie à l'iframe un access token lié à cette preuve, conservé en mémoire. Votre clé privée ne quitte jamais vos serveurs.
Une fois la session établie, le widget envoie les messages utilisateur à ATG sur un canal sécurisé (SSE/HTTPS), et ATG renvoie en temps réel les tokens de l'assistant à l'iframe, qui affiche l'interface de chat. ```mermaid sequenceDiagram participant User as Utilisateur participant Widget as Widget (lanceur) participant Iframe as Iframe (app chat) participant ATG as ATG ([app.askthisguy.com](http://app.askthisguy.com)) Note over Widget,ATG: La session est déjà établie User->>Widget: Clique sur le lanceur / saisit un message Widget->>Iframe: Ouvre le panneau (postMessage) / transmet la saisie Iframe->>ATG: Envoie le message (SSE/HTTPS POST) ATG-->>Iframe: Stream tokens/chunks (SSE) Iframe->>User: Affiche la réponse en streaming Iframe-->>ATG: Accusés / keepalive User->>Iframe: Message de suivi Iframe->>ATG: Envoie le message suivant (même session) ATG-->>Iframe: Stream réponse suivante Note over Widget,ATG: Renouvellement de session géré de façon transparente près de l'expiration (détails en FAQ) ```Le schéma décrit la conversation une fois la session établie : le lanceur transmet la saisie à l'iframe, qui envoie le message à ATG et reçoit la réponse en streaming, token par token, via SSE. Les messages suivants réutilisent la même session, dont le renouvellement est géré de façon transparente à l'approche de l'expiration.
## Étapes d'intégration (les deux modes) > **Sur WordPress ?** Évitez l'intégration manuelle du script et utilisez notre plugin officiel. Il prend en charge les étapes 3 et 4 et couvre les deux modes (ouvert et signé). Consultez [Installer sur WordPress avec le plugin ATG](https://www.askthisguy.com/doc/atg-embedded/install-on-wordpress-with-the-atg-plugin). ### Étape 1 : Configurer votre agent dans la console d'administration ATG ### Créer un agent Widget et configurer ses connaissances Créez d'abord un agent dans la console d'administration et choisissez le type **Widget**. Le type ne peut plus être modifié après la création. Configurez les instructions, les catégories de connaissances et les outils de l'agent avant de l'intégrer. Voir [Configurer les agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents) pour plus de détails. Cette étape est généralement prise en charge par l'équipe fonctionnelle ou les utilisateurs métier. Ils peuvent tester le comportement de l'agent dans le Playground intégré à la console d'administration. ### **Origines autorisées (Allow-Listed Origins)** Dans la console d'administration, indiquez à ATG les origines exactes autorisées à intégrer le widget (ex. [`https://yourapp.com`](https://yourapp.com), [`https://staging.yourapp.com`](https://staging.yourapp.com)). Cela sera appliqué automatiquement via des contrôles à l'exécution et les en-têtes CSP (Content Security Policy) sur l'iframe, pour que le chat ne soit intégrable que sur les domaines approuvés. ATG définira sa CSP (Content-Security-Policy) avec une directive `frame-ancestors` basée sur vos origines autorisées : ``` Content-Security-Policy: frame-ancestors [https://yourapp.com](https://yourapp.com) [https://staging.yourapp.com](https://staging.yourapp.com); ``` ### Étape 2 : Vérifier que votre site ne bloque pas ATG Si votre site utilise une Content-Security-Policy (CSP) stricte qui bloque par défaut les iframes ou scripts externes, vous devez autoriser explicitement le widget et l'iframe ATG. Pour vérifier si votre site utilise une CSP, vous pouvez utiliser une commande `curl` par exemple : ```bash curl -I [https://yourwebsite.com](https://yourwebsite.com) | grep -i content-security-policy ``` Si la commande ne retourne rien ou seulement une règle `frame-ancestors` (cas le plus fréquent), vous n'avez pas besoin d'étendre l'en-tête CSP, passez à l'étape suivante. Si elle retourne des CSP strictes du type `Content-Security-Policy: default-src 'self'; script-src 'self'; frame-src 'none';`, ajoutez ou étendez votre en-tête CSP ainsi : ``` Content-Security-Policy: script-src 'self' [https://app.askthisguy.com](https://app.askthisguy.com); frame-src [https://app.askthisguy.com](https://app.askthisguy.com); ``` > Cet en-tête est défini sur votre propre serveur ou CDN (par votre équipe tech/ops). > > Il indique au navigateur que votre page est autorisée à charger le script et l'iframe ATG. > ### Étape 3 : Ajouter le script du widget Vous trouverez dans la console d'administration ATG un code JS simple à ajouter vers la fin du `\| Méthode | Ce qu'elle fait |
|---|---|
window.ATG.open() |
Ouvre le panneau de chat. |
window.ATG.close() |
Ferme le panneau de chat. |
window.ATG.toggle() |
Ouvre ou ferme le panneau de chat selon son état. |
window.ATG.expand() |
Agrandit le chat en vue complète (mode bulle uniquement). |
window.ATG.minimize() |
Réduit le chat à sa vue compacte (mode bulle uniquement). |
window.ATG.isExpanded() |
Renvoie true si le chat est actuellement agrandi. |
window.ATG.resetConversation() |
Démarre une nouvelle conversation en effaçant l'historique des messages. (Ouvrez le chat au moins une fois au préalable pour que l'iframe soit initialisée.) |
window.ATG.updatePageRoute(url) |
Met à jour la route de la page courante pour que l'agent dispose du contexte à jour. Surtout utilisé dans les SPA (voir ci-dessous). |
window.ATG?.open?.() pour éviter une erreur si le script n'est pas encore chargé, et branchez-les après DOMContentLoaded ou le hook de montage de votre framework.
### Quelques cas d'usage
**Ouvrir le chat depuis votre propre bouton.** Combinez `data-launcher="hidden"` (pas de lanceur intégré) avec votre propre déclencheur :
```html
```
**Transformer une barre de recherche en point d'entrée du chat.** Quand l'utilisateur lance une recherche, ouvrez l'assistant au lieu (ou en plus) d'afficher des résultats :
```javascript
searchForm.addEventListener('submit', (e) => {
e.preventDefault();
window.ATG?.open?.();
});
```
**Ouvrir le chat automatiquement sur une page précise** (ex. une page de tarifs ou d'onboarding), après un court délai pour ne pas gêner le rendu initial :
```javascript
window.addEventListener('load', () => {
if (location.pathname === '/tarifs') {
setTimeout(() => window.ATG?.open?.(), 1500);
}
});
```
**Démarrer une nouvelle conversation** depuis une entrée de menu « Nouveau chat » :
```javascript
newChatButton.addEventListener('click', () => {
window.ATG?.resetConversation?.();
window.ATG?.open?.();
});
```
## URL des pages dans vos agents (optionnel)
> **Note :** Ceci n'est nécessaire que si vous avez une **Single Page Application (SPA)** avec routage côté client et souhaitez que l'agent fournisse une aide contextuelle spécifique à chaque page.
### Pourquoi les SPA ont besoin de ceci
Dans les sites web traditionnels, chaque navigation charge une nouvelle page et réinitialise le widget avec l'URL actuelle. Dans les SPA, l'URL change sans rechargement de page, donc le widget ne détecte pas automatiquement la navigation.
Si vous souhaitez que votre agent fournisse une **aide contextuelle spécifique à la page** en fonction de la route actuelle, vous devez notifier le widget des changements de route.
### Solution
Appelez `window.ATG.updatePageRoute()` à chaque navigation de votre routeur SPA :
```javascript
window.ATG.updatePageRoute(window.location.href);
```
### Exemples d'implémentation
**React Router (v6+)**
```jsx
function App() {
const location = useLocation();
useEffect(() => {
if (window.ATG?.updatePageRoute) {
window.ATG.updatePageRoute(window.location.href);
}
}, [location]);
return | Attribut | Description |
|---|---|
data-agent-id |
Requis. ID de l'agent fourni par ATG. |
data-signed-params |
Optionnel. Booléen (true ou false). Active l'authentification par paramètres signés. Nécessite l'implémentation du callback window.ATG.getSignedParams. Par défaut : false. |
data-launcher |
Optionnel. Position du lanceur de chat (bottom-right, bottom-left, floating, hidden). Par défaut : bottom-right. Utilisez hidden pour charger le widget sans bouton de lanceur et l'ouvrir vous-même via l'API JS. |
data-mode-style |
Optionnel. Mode d'affichage du panneau de chat (bubble, drawer). Par défaut : bubble. bubble : panneau compact ancré au lanceur, agrandissable en fenêtre centrée. drawer : panneau pleine hauteur ancré à droite qui glisse à l'écran (le lanceur est masqué pendant l'ouverture ; agrandir/réduire sont désactivés). Sur mobile, l'affichage reste plein écran quel que soit le mode. |
data-language |
Optionnel. Langue de l'interface : en, fr. Par défaut : en. |
data-page-route |
Optionnel. Route canonique de la page courante (ex. /plans). Utile si vous configurez des instructions d'agent qui en tiennent compte pour le contenu contextuel. |
data-theme-json |
Optionnel. Objet JSON définissant des tokens visuels (couleur de marque, polices, rayon des coins). Permet de styliser rapidement l'assistant. Exemple : {'{"color.brand":"#6D28D9","radius.lg":"12px"}'} |
data-aria-label |
Optionnel. Label d'accessibilité pour le bouton du lanceur de chat (ex. « Ouvrir l'assistant de chat »). |
data-debug |
Optionnel. Booléen (true ou false). Active des logs détaillés dans la console pour le diagnostic. Par défaut : false. |
| Nom du token | Description | Exemple de valeur |
|---|---|---|
color.brand |
Couleur de marque principale | #6D28D9 |
color.bg |
Couleur de fond du chat | #0B0B0F |
color.text |
Couleur du texte principal | #F3F4F6 |
color.muted |
Couleur du texte secondaire | #9CA3AF |
color.assistant-bg |
Couleur de fond des bulles de message de l'assistant | #F8F8F8 |
radius.sm, radius.lg |
Rayon des coins pour boutons, cartes | 8px, 16px |
font.family |
Stack de polices | Inter, system-ui, sans-serif |
shadow.elevation |
Ombre des cartes / lanceur | 0 8px 24px rgba(0,0,0,0.25) |
| Claim | Type | Description | Exemple / Notes |
|---|---|---|---|
kid |
string |
Key ID : identifie quelle clé publique utiliser pour la vérification de signature. Doit correspondre à une clé enregistrée pour votre agent dans la console ATG. | "prod-key-2024-01" |
alg |
string |
Algorithme : doit être "ES256" (ECDSA avec courbe P-256 et SHA-256). | "ES256" |
| Claim | Type | Description | Exemple / Notes |
|---|---|---|---|
iat |
number (secondes Unix) |
Heure d'émission du jeton. Utilisé pour détecter dérive d'horloge ou rejeu. | 1739298000 |
exp |
number (secondes Unix) |
Expiration : date d'expiration absolue de ce jeton de paramètres signés. Doit être courte (≤ 15 min). ATG refuse les jetons expirés ou à trop longue durée de vie. | 1739298900 |
jti |
string (UUID/aléatoire) |
JWT ID : nonce unique pour ce jeton. Doit être aléatoire à chaque émission. | 550e8400-e29b-41d4-a716-446655440000 |
| Claim | Type | Description | Exemple / Notes |
|---|---|---|---|
external_user_ref |
string |
Référence ou ID utilisateur externe de votre système. Peut servir à identifier l'utilisateur dans les instructions de l'agent ou les logs. | "user_12345" |
entitlements |
object (JSON) |
Droits ou permissions de l'utilisateur. Utilisable par l'agent pour la logique de contrôle d'accès. | {'{"plan": "premium", "features": ["export"]}'} |
context_metadata |
object (JSON) |
Métadonnées de contexte supplémentaires sur la session ou l'utilisateur. | {'{"department": "sales", "region": "EU"}'} |
{'{ type: "ATG_REQUEST_SIGNED_PARAMS_FOR_ROTATION" }'}
- Le widget appelle automatiquement votre callback window.ATG.getSignedParams() pour obtenir un nouveau JWT signé.
- Votre callback doit appeler l'endpoint presign de votre backend et retourner le nouveau JWT.
- Le widget renvoie le JWT à l'iframe et l'iframe renouvelle la session avec le serveur ATG.
### Utilisez-vous des cookies tiers ?
Non, nous n'utilisons pas de cookies tiers (ils seraient bloqués). Pour notre access token, nous utilisons JWT + preuve DPoP.
### Comment ATG gère-t-il la rotation des clés et l'en-tête `kid` ?
Chaque JWT de paramètres signés inclut un `kid` (Key ID) dans son header.
ATG utilise cette valeur pour retrouver immédiatement la bonne clé publique que vous avez téléversée dans la console.
Lors d'une rotation de clés :
1. Générez une nouvelle paire de clés de signature et donnez-lui un nouveau `kid` (ex. `key-2025-02`).
2. Ajoutez la nouvelle clé publique dans la console ATG en gardant l'ancienne jusqu'à expiration des jetons signés avec elle (≤ 15 min).
3. Signez les nouveaux jetons avec le nouveau `kid`, puis retirez l'ancienne clé.
ATG vérifie chaque jeton avec la clé publique qui correspond à son `kid`, donc la rotation se fait sans interruption ni reconfiguration manuelle.
---
# Traitement sur mesure
URL: https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-processing/
Language: fr
Section: Documentation
## Adapter ATG aux fichiers propres à votre organisation
**ATG peut être personnalisé** pour traiter intelligemment **les types de fichiers spécifiques de votre organisation** et transformer des documents complexes en informations exploitables.
### Quels contenus peuvent être traités ?
Que vous travailliez avec des **feuilles Excel**, des **catalogues produits**, des **rapports commerciaux**, des **jeux de données scientifiques** ou tout autre document spécialisé, ATG peut apprendre à les traiter exactement comme vous en avez besoin :
- **Bases de contacts** – Extraire et structurer les informations sur les parties prenantes
- **Fiches produit** – Analyser stocks et spécifications
- **Rapports commerciaux** – Analyser performances et tendances commerciales
- **Données scientifiques** – Traiter résultats de recherche et mesures
- **Formats métiers** propres à votre secteur
### Fonctionnement
Un traitement sur mesure repose sur **deux éléments clés** :
1. **Critères de déclenchement** – Définir ce qui active le traitement personnalisé (par ex. mots-clés dans les noms de fichiers, types de fichiers ou motifs dans le contenu)
2. **Règles de traitement** – Préciser comment ATG doit extraire, transformer et structurer les données
**Une fois configuré, le traitement s’applique automatiquement**, quelle que soit l’origine du fichier. Déposé directement, synchronisé via **Notion**, récupéré depuis **Google Drive**, **Confluence**, **SharePoint** ou tout autre connecteur, vos règles personnalisées s’appliquent de la même façon sur toutes les sources. Voir [Connecteurs](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors) pour plus d’informations sur les connecteurs.
Votre équipe obtient ainsi **la bonne information** issue des bons fichiers, à chaque fois.
### Pourquoi le contexte compte : pas de traitement CSV/Excel générique
Vous vous demandez peut-être : **« Pourquoi ne pas traiter automatiquement tous les fichiers Excel et CSV ? »**
La réponse est simple : **le contexte est essentiel**.
Un tableur sans contexte n’est que des données brutes. Cette colonne « Montant » est-elle en euros ou en dollars ? « Statut » signifie-t-il statut de commande, de projet ou d’employé ? Quelles lignes sont des en-têtes, des totaux, les données utiles ?
**Un traitement automatisé générique produit souvent du bruit**. Notre approche est plus réfléchie :
- **Comprendre d’abord votre activité** – Nous apprenons comment votre organisation structure ses données
- **Concevoir des règles ciblées** – Un traitement sur mesure qui sait ce que signifie chaque colonne et comment gérer les cas limites
- **Livrer des informations de qualité** – Votre équipe obtient des éléments exploitables, pas seulement des cellules parsées
**Données médiocres en entrée, résultats médiocres en sortie.** En investissant un peu de temps au départ pour comprendre votre contexte, nous faisons en sorte qu’ATG alimente une base de connaissances de qualité, réellement utilisable par vos équipes.
### Prochaines étapes
Le traitement personnalisé des fichiers est proposé sous la forme d’un **développement sur mesure** adapté aux besoins de votre organisation.
**Contactez votre interlocuteur ATG** pour parler de votre cas d’usage et explorer comment optimiser ATG pour vos flux de travail.
---
# Outils et MCP
URL: https://www.askthisguy.com/fr/doc/admin-console/tools-management/
Language: fr
Section: Documentation
La section **Outils et MCP** recense les outils intégrés à ATG et permet de connecter des systèmes externes via le **Model Context Protocol (MCP)**, avec le **catalogue MCP** pour ajouter rapidement des services tiers.
Dans la console, ouvrez **Outils et MCP**, puis l’onglet **Serveurs MCP** pour gérer vos connexions ou parcourir le catalogue.
Les outils s’activent agent par agent : l’onglet **Outils** de chaque agent détermine les outils intégrés, personnalisés et MCP utilisables dans ses conversations. Consultez [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents).
## Dans cette section
- **[Outils](https://www.askthisguy.com/doc/admin-console/tools-management/chat-tools)** - Les outils intégrés dont dispose chaque organisation : recherche documentaire, web, génération de fichiers, e-mail, revue de presse.
- **[Serveurs MCP](https://www.askthisguy.com/doc/admin-console/tools-management/mcp-servers)** - Ajouter et configurer des points d’accès MCP (URL, authentification, transport, filtrage des outils).
- **[Catalogue MCP](https://www.askthisguy.com/doc/admin-console/tools-management/mcp-catalog)** - Découvrir des services MCP tiers pré-intégrés et les ajouter à votre organisation, qu’ils soient en accès libre ou qu’ils exigent une clé API.
---
# Plugin d'ATG pour WordPress
URL: https://www.askthisguy.com/fr/doc/atg-embedded/install-on-wordpress-with-the-atg-plugin/
Language: fr
Section: Documentation
## Introduction
Le plugin d'ATG vous permet d'activer un agent de chat sur votre site WordPress et de le configurer en quelques clics : choisir la forme du widget, l'endroit où il s'affiche, sa charte graphique, cibler les pages concernées, et plus encore. En option, vous pouvez aussi sécuriser les sessions de chat pour ne les rendre accessibles qu'aux utilisateurs authentifiés sur votre site.
## Prérequis
- **Un site WordPress** en version 6.0 ou ultérieure, PHP 7.4 ou ultérieur. Pour le mode signé, l'extension PHP `openssl` doit être activée (elle l'est sur la quasi-totalité des hébergeurs de production).
- **L'UUID d'un agent Widget.** Créez un agent ATG et choisissez le type **Widget**. Le type ne peut plus être modifié après la création. Consultez [Configurer les agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents). L'UUID est disponible dans l'onglet Code d'intégration de l'agent.
- **La liste des domaines de votre site WordPress :** dans la console d'administration ATG, ajoutez les domaines de votre site (par exemple `https://votresite.com`, `https://staging.votresite.com`) à la liste des origines autorisées de l'agent. Le Chat ne fonctionnera que sur ces domaines.
## Étape 1 : Télécharger et installer le plugin
Téléchargez le ZIP du plugin : [atg-chat-widget.zip](https://www.askthisguy.com/downloads/atg-chat-widget.zip)
Puis installez-le comme n'importe quel plugin WordPress :
1. Dans l'administration de WordPress, allez dans **Extensions → Ajouter → Téléverser une extension**.
2. Sélectionnez le fichier `atg-chat-widget.zip` que vous venez de télécharger puis cliquez sur **Installer maintenant**.
3. Cliquez sur **Activer l'extension**.
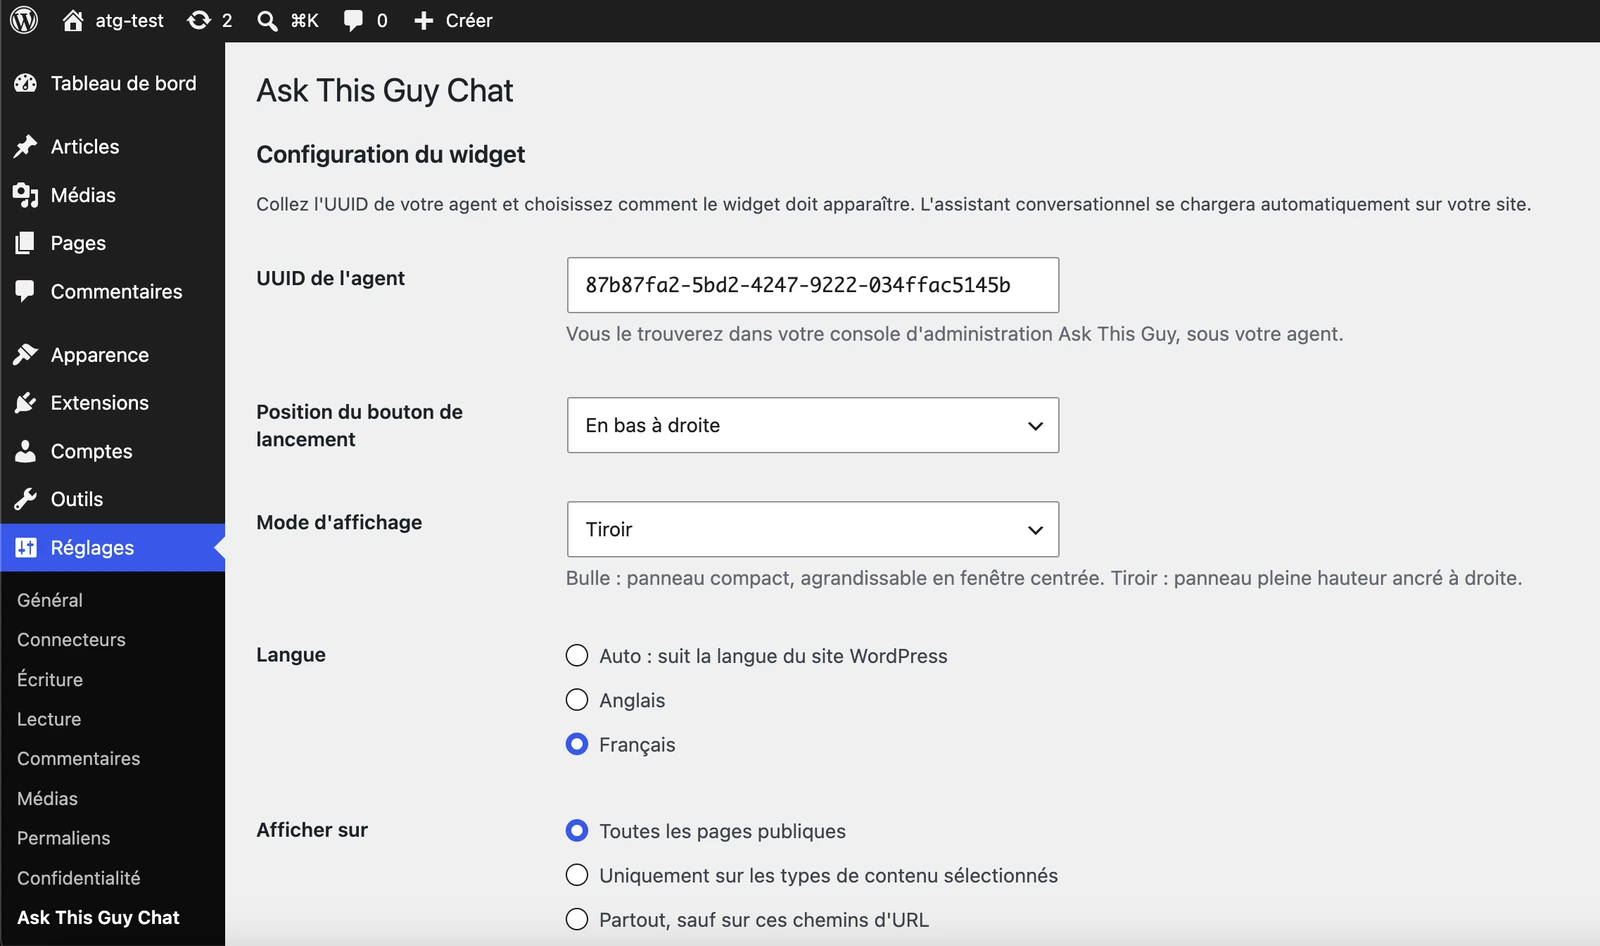
Un nouveau menu **Réglages → Ask This Guy Chat** apparaît.
## Étape 2 : Renseigner l'UUID de l'agent
1. Allez dans **Réglages → Ask This Guy Chat**.
2. Collez l'UUID de votre agent dans le champ **Agent UUID**.
3. Cliquez sur **Enregistrer les modifications**.
Ouvrez la partie publique de votre site ; le lanceur de chat doit apparaître en bas à droite.
## Étape 3 : Configurer les options d'affichage
Sur la même page de réglages, vous pouvez affiner où et comment le widget s'affiche :
| Réglage | Ce qu'il contrôle |
|---|---|
| Position du lanceur | En bas à droite (défaut), en bas à gauche, flottant, ou masqué. Masqué charge le widget sans bouton de lanceur, vous pouvez alors déclencher l'ouverture via l'API JS window.ATG. |
| Mode d'affichage | Bulle (défaut) : panneau compact, agrandissable en fenêtre centrée. Tiroir : panneau pleine hauteur ancré à droite. |
| Langue | Détection automatique depuis la locale du site WordPress, ou forcer anglais / français. |
| Afficher sur | Tout le site, restreint à certains types de contenus, ou partout sauf une liste de chemins d'URL. |
| Libellé d'accessibilité | Remplace l'aria-label du bouton du lanceur. |
| Personnalisation du thème | Couleur de marque, police, ombre. Le JSON complet du thème par défaut est affiché à titre de référence à copier-coller-modifier. |
| Outil | Ce qu’il fait | Widget | Actif par défaut |
|---|---|---|---|
| Recherche dans les connaissances | Cherche le sens de vos [documents](https://www.askthisguy.com/doc/admin-console/knowledge-management) indexés et renvoie les passages pertinents. | Oui | Oui |
| Recherche de documents pertinents | Identifie les documents correspondant à une description, quand l’utilisateur cherche un fichier plutôt qu’une réponse. | Oui | Oui |
| Lecture d’un document | Lit un document en entier, une fois qu’il a été identifié, y compris les fichiers déposés par l’utilisateur. | Oui | Oui |
| Interrogation du catalogue documentaire | Répond sur la base elle-même : combien de documents, quels dossiers, quelle source, quel statut. | Oui | **Non** |
| Contexte de l’organisation | Récupère la description libre de votre organisation saisie dans [Organisation](https://www.askthisguy.com/doc/admin-console/organization-settings). | Oui | Oui |
| Outil | Ce qu’il fait | Widget | Actif par défaut |
|---|---|---|---|
| Recherche web | Cherche sur le web public les informations récentes que vos documents et le modèle ne couvrent pas. | Oui | Oui |
| Lecture d’une page web | Lit les pages derrière les URL fournies par l’utilisateur, ou derrière un lien présent dans vos connaissances. | Oui | Oui |
| Outil | Ce qu’il fait | Widget | Actif par défaut |
|---|---|---|---|
| Génération de document Word | Transforme une réponse rédigée en fichier `.docx`, avec ses titres et ses listes. | Non | Oui |
| Génération de présentation PowerPoint | Construit un diaporama `.pptx`, une diapositive par titre principal. | Non | Oui |
| Génération de tableur | Exporte des données structurées en fichier CSV ou Excel. | Non | Oui |
| Génération d’image | Crée ou modifie une illustration à partir d’une description textuelle. | Non | Oui |
| Outil | Ce qu’il fait | Widget | Actif par défaut |
|---|---|---|---|
| M’envoyer par e-mail | Envoie à l’utilisateur courant un e-mail reprenant un contenu produit dans la conversation. | Non | Oui |
| Outil | Ce qu’il fait | Widget | Actif par défaut |
|---|---|---|---|
| Revue de presse | Produit une synthèse d’actualité suivant le brief défini dans [Revue de presse](https://www.askthisguy.com/doc/admin-console/organization-settings/press-review). | Oui | Oui |
| Base de données des bâtiments (BDNB) | Interroge la Base de Données Nationale des Bâtiments pour obtenir les données publiques d’un bâtiment ou d’une parcelle. | Oui | **Non** |
| Réglage | Webapp | Widget |
|---|---|---|
| Configuration | Oui | Oui |
| Connaissances | Oui | Oui |
| Outils | Oui | Oui |
| Playground | Oui | Oui |
| Accès des utilisateurs internes | Oui | Non |
| Visibilité des sources | Non | Oui |
| Sécurité JWT et origines autorisées | Non | Oui |
| Code d'intégration et UUID | Non | Oui |
Le schéma suit une question de bout en bout : l’IA principale décide d’appeler l’outil Requête base de données en formulant une question en langage naturel, une IA dédiée traduit cette question en SQL, et l’outil exécute la requête en lecture seule avant de renvoyer le résultat accompagné de son explication. Plusieurs tours de dialogue sont possibles, et l’outil Requête base de données n’est que l’un des outils disponibles.
**[Réserver une démo](https://www.askthisguy.com/demo)** pour échanger sur la connexion de votre base ou la mise en place d’une base gérée pour cette capacité. --- # Configurer le mode vocal URL: https://www.askthisguy.com/fr/doc/admin-console/voice-mode/ Language: fr Section: Documentation Le mode vocal se configure séparément pour chaque agent. Une fois activé, il transforme l'agent en assistant vocal IA : les utilisateurs dictent leurs messages et écoutent ses réponses dans la webapp ATG authentifiée. **Périmètre :** le fonctionnement présenté ici a été vérifié dans la webapp principale authentifiée. Ne présumez pas que le mode vocal est disponible dans le widget intégré ou les conversations partagées. ## Activer le mode vocal 1. Dans la console d'administration, ouvrez **Agents**. 2. Sélectionnez l'agent à configurer. 3. Ouvrez l'onglet **Configuration**. 4. Activez **Activer le mode vocal**. 5. Vérifiez le fournisseur de reconnaissance vocale, le fournisseur de synthèse vocale et la voix.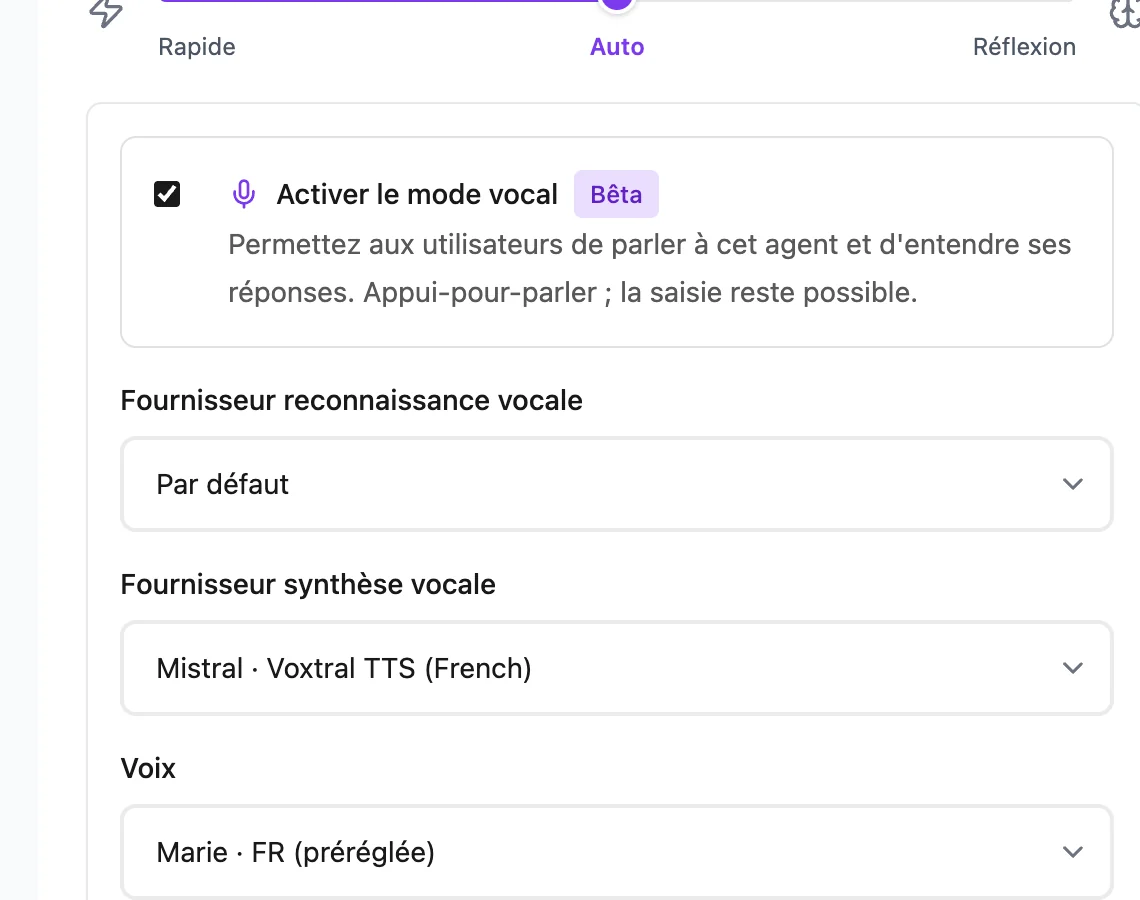 Dès que l'agent est actif et accessible à un utilisateur, un bouton de microphone **Parler** apparaît dans le champ de saisie de la webapp.
## Choisir les services vocaux
Les fournisseurs et les voix disponibles dépendent des services configurés dans votre environnement.
- **Fournisseur de reconnaissance vocale :** transcrit l'enregistrement de l'utilisateur en texte modifiable.
- **Fournisseur de synthèse vocale :** transforme la réponse terminée de l'agent en audio.
- **Voix :** détermine la voix utilisée pour lire les réponses.
L'option **Par défaut** utilise le service par défaut disponible sur la plateforme. Si vous sélectionnez une voix précise, vérifiez que sa langue correspond au public de l'agent.
## Effets de l'activation pour les utilisateurs
Pour les utilisateurs de l'agent configuré :
- un bouton de microphone devient disponible dans les nouvelles conversations comme dans les conversations existantes ;
- chaque enregistrement est transcrit puis préparé pour un envoi automatique ;
- la réponse à un message dicté est lue automatiquement ;
- toute réponse terminée peut aussi être écoutée à la demande.
Le mode vocal complète la conversation écrite. Il ne désactive ni le clavier, ni les pièces jointes, ni les modes de réponse, ni les autres fonctions du chat. Il ne crée pas non plus d'appel vocal continu en temps réel.
## Mode vocal, chatbot vocal ou voicebot ?
Le mode vocal ATG répond à un besoin précis. Avant de le déployer, vérifiez qu'il correspond bien à l'usage attendu.
- **Mode vocal ATG :** dictée des messages et lecture des réponses, agent par agent, dans la webapp authentifiée. C'est un agent vocal IA interne, adossé à vos connaissances et à vos outils.
- **Chatbot vocal sur site public :** le widget [ATG Embedded](https://www.askthisguy.com/doc/atg-embedded) n'est pas couvert par cette page. Ne présumez pas que le vocal y est disponible. Pour le cadrage d'un agent conversationnel de site web, voir la page [Chatbot de site web](https://www.askthisguy.com/solutions/website-chatbot/).
- **Voicebot ou callbot téléphonique :** hors périmètre. Le mode vocal n'établit pas d'appel téléphonique et ne tient pas de conversation audio continue en temps réel.
## Valider la configuration
Testez la fonctionnalité avec un compte utilisateur autorisé à accéder à l'agent :
1. Vérifiez que le bouton **Parler** apparaît pour cet agent.
2. Autorisez le microphone et enregistrez une courte question.
3. Contrôlez la transcription et le compte à rebours de deux secondes avant l'envoi automatique.
4. Annulez l'envoi et vérifiez que le texte reste modifiable.
5. Envoyez un message vocal et vérifiez que la réponse terminée est lue à voix haute.
6. Arrêtez la lecture, puis utilisez **Lire à voix haute** sur une réponse précédente.
Testez également les navigateurs pris en charge par votre organisation. Les autorisations du microphone et les règles de lecture automatique du navigateur peuvent influer sur l'enregistrement et la restitution audio.
## Contraintes actuelles
- Chaque enregistrement est limité à 60 secondes.
- La transcription et la synthèse vocale nécessitent une connexion réseau.
- Les utilisateurs ne peuvent pas choisir le fournisseur ou la voix depuis le chat, et aucune préférence vocale n'est enregistrée par utilisateur.
- Parler n'interrompt pas automatiquement un contenu audio en cours de lecture.
- La disponibilité des fournisseurs peut varier selon les environnements.
Ne faites aucune supposition sur la durée de conservation des extraits audio. Avant le déploiement, vérifiez les exigences de confidentialité de votre organisation et les politiques des fournisseurs vocaux configurés.
Partagez la page [Utiliser le mode vocal](https://www.askthisguy.com/doc/webapp/using-voice-mode) avec vos utilisateurs pour les instructions et le dépannage.
---
# Tags et alertes
URL: https://www.askthisguy.com/fr/doc/admin-console/tags-alerts/
Language: fr
Section: Documentation
Les **Tags et alertes** permettent de définir des règles qui **étiquettent** automatiquement les conversations et, si vous le souhaitez, **envoient des notifications par e-mail** lorsqu’une conversation correspond à une condition que vous décriviez en langage clair—sans vous limiter à une liste figée de mots-clés.
## Liste et filtres
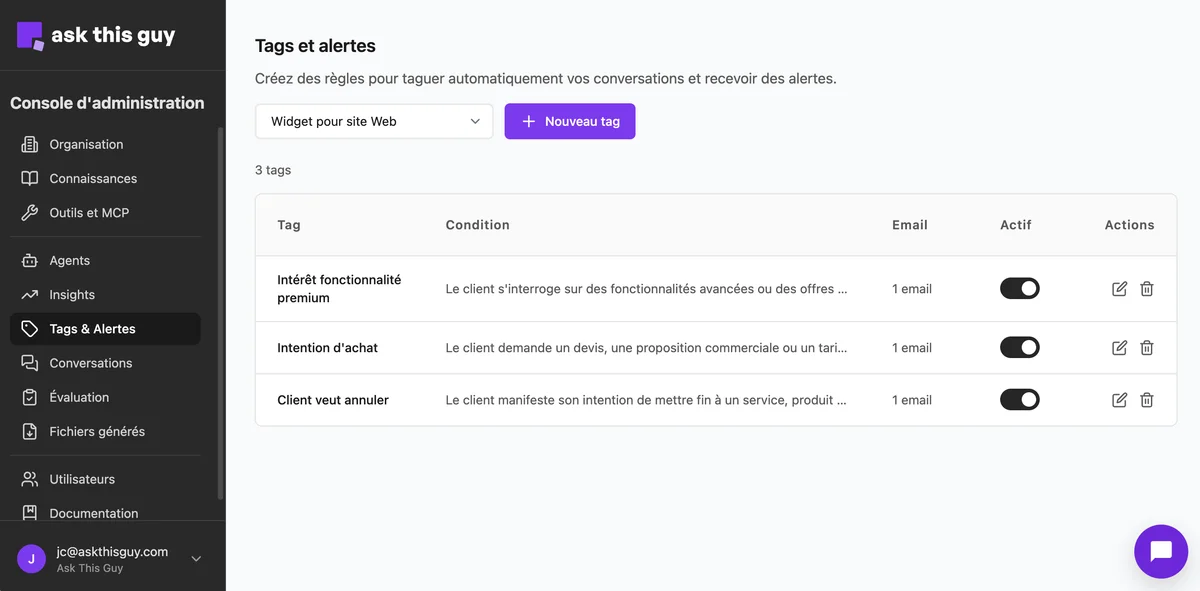
La vue principale présente vos tags dans un tableau. Utilisez le menu déroulant **Agent** en haut de page pour gérer les règles **pour un assistant précis** (chaque tag est rattaché à un agent).
### Colonnes du tableau
- **Tag** — Libellé appliqué aux conversations correspondantes (réutilisé ailleurs dans les analyses).
- **Condition** — Brève description du cas où le tag s’applique ; le texte complet se modifie dans le panneau latéral.
- **E-mail** — Nombre de destinataires configurés pour les alertes sur ce tag.
- **Actif** — Active ou désactive la règle sans la supprimer.
- **Actions** — Modifier ou supprimer le tag.
## Créer ou modifier un tag
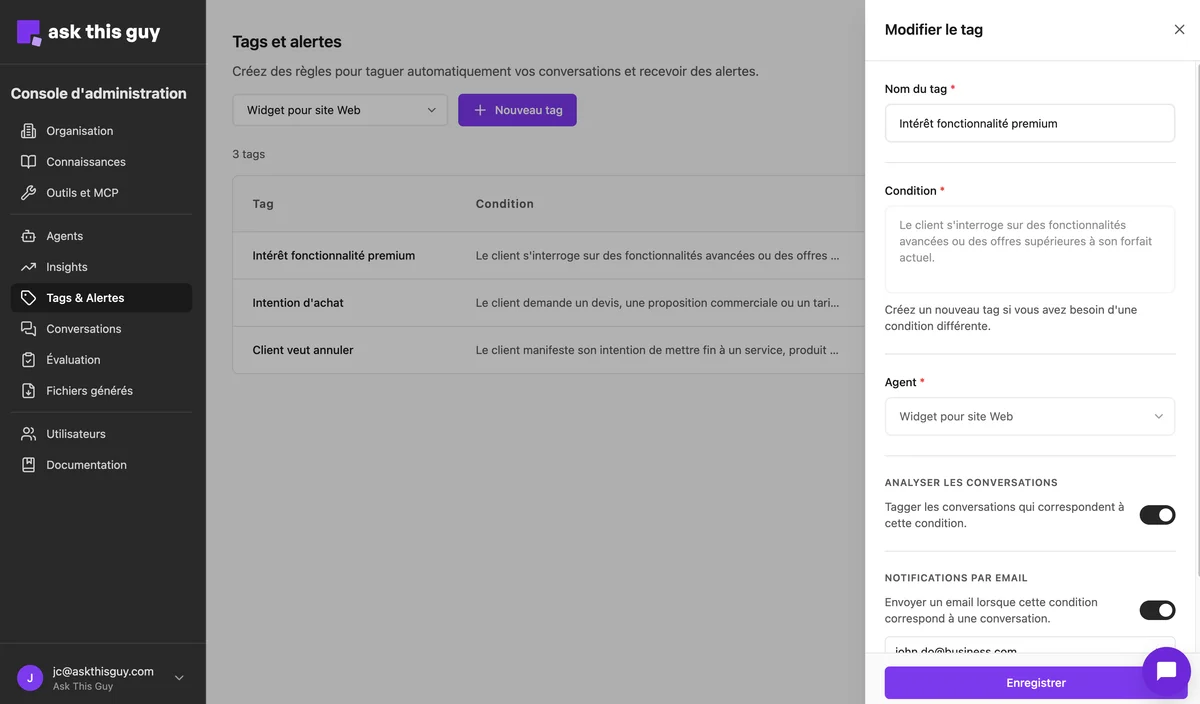
Choisissez **+ New Tag** ou ouvrez une ligne existante. Un **panneau latéral** s’ouvre pour la définition du tag.
### Champs obligatoires
- **Tag label** — Nom clair du tag (par exemple « Intention d’achat » ou « Client veut annuler »).
- **Condition** — Décrivez en **langage naturel** ce qui doit compter comme correspondance (par exemple intérêt pour une offre supérieure, demande de devis ou risque de désabonnement). Le système tient compte du **contexte de la conversation** ; vous pouvez formuler la règle comme votre équipe raisonne sur le cas.
- **Agent** — L’assistant auquel cette règle s’applique.
### Analyser les conversations
Activez **Tag conversations that match this condition** pour appliquer ce tag lorsque la condition est satisfaite.
### Notifications par e-mail
Activez **Send an email when this condition matches a conversation** pour prévenir une ou plusieurs adresses lors d’une correspondance. Saisissez le ou les e-mails dans le champ prévu.
Enregistrez vos modifications avec l’action en bas du panneau.
## Utiliser les tags avec Insights
Les conversations étiquetées alimentent **Insights** (par exemple les répartitions par tag). Définissez des tags stables ici, puis consultez volumes et tendances dans [Insights](https://www.askthisguy.com/doc/admin-console/insights).
---
# Évaluation des agents
URL: https://www.askthisguy.com/fr/doc/admin-console/agent-evaluation/
Language: fr
Section: Documentation
## Qu'est-ce que l'évaluation des agents ?
L'**évaluation des agents** vous aide à tester comment votre agent répond à un grand nombre de questions.
**Utilisez-la pour :**
- L'assurance qualité avant de lancer votre agent
- Identifier les domaines où votre agent doit s'améliorer
- Les tests de régression après des modifications de votre base de connaissances
- Mesurer les performances de l'agent dans le temps

## Pour commencer
### 1. Sélectionner un agent
Choisissez l'agent que vous souhaitez évaluer dans le menu déroulant **Agent** en haut de la page.
### 2. Choisir la langue de test
Sélectionnez la langue pour vos questions de test :
- **EN** - Anglais
- **FR** - Français
Vos jeux de questions en anglais et en français sont séparés et l'agent répondra dans la même langue que la question.
## Ajouter des questions
Vous pouvez :
- saisir vos questions manuellement
- importer un fichier de questions
- demander à la plateforme de générer des questions pour vous
### Importer des questions
**Formats supportés :** fichiers CSV ou TXT
1. Cliquez sur **Upload Questions**
2. Sélectionnez un fichier `.csv` ou `.txt` depuis votre ordinateur
3. Les questions doivent être une par ligne/rangée
4. Pour les fichiers CSV, utilisez uniquement la première colonne (supprimez les colonnes supplémentaires)
5. Si votre question existe déjà dans votre jeu, elle ne sera simplement pas ajoutée pour éviter les doublons
**Notes importantes :**
- Maximum 50 questions par exécution de test
- Si vous importez depuis un tableur (Excel, Numbers), exportez d'abord en CSV
- Les fichiers sont automatiquement enregistrés dans votre jeu de questions
### Option B : Générer des questions
Laissez le système générer automatiquement des questions à partir de la base de connaissances de votre agent :
1. Cliquez sur **Generate Questions**
2. Choisissez le nombre de questions (5-50)
3. Sélectionnez les types de contenu à inclure (documents, fichiers, sources web)
4. Examinez les questions générées
5. Sélectionnez celles à conserver et cliquez sur **Add Selected**
Pour vous donner une image complète des performances de votre agent, la fonctionnalité d'évaluation génère un mélange de questions pertinentes et hors sujet. Cela vous aide à voir comment votre agent gère les requêtes qui sortent de son domaine prévu.
**Gain de temps :** Générez des questions automatiquement pour démarrer rapidement, puis affinez votre jeu de tests en fonction des schémas d'utilisation réels.
## Gérer votre jeu de questions
Une fois que vous avez chargé des questions, vous pouvez :
- **Sélectionner/désélectionner** des questions avec les cases à cocher (seules les questions sélectionnées seront exécutées)
- **Modifier** le texte d'une question en cliquant dessus
- **Supprimer** les questions dont vous n'avez pas besoin
- **Ajouter** de nouvelles questions manuellement avec le bouton "+ Add Question"
### Télécharger les questions
Exportez vos questions sous forme de fichier CSV avec le bouton **Download Questions**. Utile pour :
- Sauvegarder votre jeu de questions
- Partager avec les membres de l'équipe
- Modifier en masse dans un tableur
## Lancer des tests
### Démarrer un test
1. Assurez-vous d'avoir des questions sélectionnées (cases cochées)
2. Cliquez sur le bouton **Run Test**
3. Suivez la progression en temps réel à mesure que chaque question reçoit une réponse
4. Les résultats apparaissent un par un au fur et à mesure qu'ils sont terminés
**Maximum :** 50 questions par exécution
Vous ne pouvez lancer qu'une seule évaluation à la fois pour un agent spécifique dans votre organisation.
### Pendant l'exécution du test
Vous verrez :
- **Barre de progression** indiquant l'état d'avancement
- **Résultats en direct** apparaissant au fur et à mesure que chaque question est terminée
- **Temps d'exécution** pour chaque réponse
- **Indicateurs de succès/échec**
### Arrêter un test en cours
Si vous devez arrêter un test avant la fin :
1. Cliquez sur le bouton **Stop** dans la zone de progression
2. Attendez que le système arrête le traitement en toute sécurité
3. Les résultats partiels seront conservés
## Comprendre les résultats
### Pour chaque paire question-réponse
Cliquez sur n'importe quelle question pour l'agrandir et voir :
**Détails de la réponse :**
- Réponse complète de l'agent (avec formatage markdown)
- Temps d'exécution (temps nécessaire pour générer)
- Outils utilisés (recherche, récupération de documents, etc.)
- Sources citées (documents ou pages web)
**Options de feedback :**
- **Pouce levé** - Bonne réponse
- **Pouce baissé** - Réponse problématique (ajoutez des détails sur les raisons)
### Détails du feedback
Lorsque vous marquez une réponse comme négative, vous pouvez ajouter des notes spécifiques :
- Ce qui n'allait pas avec la réponse
- Ce que vous attendiez à la place
- Les schémas que vous remarquez
Ce feedback vous aide à identifier :
- Les lacunes de connaissances de votre agent
- Les questions qui nécessitent de meilleures données d'entraînement
- Les schémas d'échec courants
### Exporter les résultats
Téléchargez les résultats des tests au format CSV avec le bouton **Download Results**.
L'export comprend :
- Texte de la question
- Réponse de l'agent
- Statut de succès/échec
- Temps d'exécution
- Messages d'erreur (le cas échéant)
- Notes de feedback
## Onglet Historique
### Voir les exécutions de tests passées
Basculez vers l'onglet **History** pour voir toutes les évaluations précédentes :
**Vue liste des exécutions :**
- Date et heure de chaque exécution
- Statut (Terminé, Arrêté, En cours, Erreur)
- Total de questions testées
- Comptages de succès/échec
**Vue détails de l'exécution :**
1. Cliquez sur n'importe quelle exécution pour voir les résultats détaillés
2. Agrandissez les paires question-réponse individuelles
3. Ajoutez du feedback aux réponses passées
4. Exportez les résultats d'une exécution spécifique au format CSV
### Pagination
- **Liste des exécutions :** 10 exécutions par page
- **Détails de l'exécution :** 50 résultats par page
Utilisez les contrôles de pagination en bas pour naviguer dans les jeux de résultats plus larges.
## Bonnes pratiques
### Créer des jeux de questions efficaces
- Couvrez différents sujets de votre base de connaissances
- Incluez des cas limites et des questions délicates
- Mélangez questions simples et complexes
- Testez les requêtes courantes des utilisateurs
### Planning de tests réguliers
Envisagez de lancer des évaluations :
- Avant les versions majeures ou les mises à jour
- Après l'ajout de nouveau contenu à la base de connaissances
- Lorsque les utilisateurs signalent des problèmes sur des sujets spécifiques
- Mensuellement pour le suivi de la qualité
**Itérer :** Commencez avec un petit jeu (10-15 questions), affinez en fonction des résultats, puis étendez. Lancez les mêmes questions périodiquement pour suivre les améliorations dans le temps !
## Dépannage
### "Maximum de 50 questions atteint"
Vous avez sélectionné trop de questions. Décochez certaines questions ou divisez en plusieurs exécutions de tests.
### "Test déjà en cours"
Un autre test est en cours. Attendez qu'il se termine ou arrêtez-le d'abord.
### Erreurs d'import de fichier
**"Type de fichier invalide"**
- Utilisez uniquement des fichiers `.csv` ou `.txt`
- Si vous utilisez un tableur, exportez en CSV
**"Plusieurs colonnes détectées"**
- Supprimez toutes les colonnes sauf la première (questions)
- Ou enregistrez en texte brut (.txt) avec une question par ligne
**"Aucune question trouvée"**
- Vérifiez que votre fichier n'est pas vide
- Assurez-vous que chaque ligne contient du texte
### Impossible de voir les résultats
Si un test est en cours mais que vous ne voyez pas les résultats :
1. Vérifiez l'onglet **History**
2. Cherchez l'exécution en cours
3. Cliquez sur **Reconnect** pour reprendre la visualisation des résultats en direct
## Limites et contraintes
- **Questions max par exécution :** 50
- **Questions max stockées :** 100 par agent
- **Taille de fichier :** fichiers CSV/TXT de taille raisonnable uniquement
- **Exécutions simultanées :** un test par agent à la fois
**Rappel :** L'évaluation des agents est un processus continu, pas une tâche ponctuelle. Des tests réguliers vous aident à maintenir des interactions IA de haute qualité à mesure que votre base de connaissances grandit et que les besoins des utilisateurs évoluent !
---
# Insights
URL: https://www.askthisguy.com/fr/doc/admin-console/insights/
Language: fr
Section: Documentation
**Insights** est l'espace d'analyse de la console d'administration. Il permet de comprendre comment les assistants sont utilisés, quel ressenti les utilisateurs ont de l'expérience et où porter l'attention — avec les mêmes filtres pour les indicateurs et les graphiques.
## Filtres
En haut de la page, vous pouvez restreindre ce que le tableau de bord affiche :
- **Agents** — Sélectionnez un ou plusieurs agents. Seules les conversations prises en charge par les agents choisis sont incluses.
- **Préréglages de durée** — Plages rapides : **7 jours**, **30 jours** ou **90 jours**.
- **Plage personnalisée** — Définissez une date de **début** et de **fin** pour analyser la période souhaitée.
- **Période de comparaison** — Le tableau de bord compare la plage sélectionnée à la **période précédente de même durée** (par exemple, pour une fenêtre de 7 jours, les indicateurs sont comparés aux 7 jours qui la précèdent immédiatement). Les dates de comparaison sont indiquées à côté des filtres pour que « précédente » soit toujours explicite.
## Indicateurs récapitulatifs
La ligne du haut résume les indicateurs clés pour la période choisie, chacun avec une **variation par rapport à la période précédente** (pourcentage ou points de pourcentage, selon l'indicateur) :
- **Conversations** — Nombre total de conversations sur la plage.
- **Messages par conversation** — Nombre moyen de messages par conversation (indicateur simple de la profondeur d'échange).
- **Sentiments** — Part des conversations classées en sentiment **positif** et **négatif** (détection automatique par l'IA).
- **Réactions** — Part des conversations où les utilisateurs ont laissé un **pouce vers le haut** ou un **pouce vers le bas** sur la réponse de l'assistant, avec la variation par rapport à la période précédente.
Ces cartes offrent un premier diagnostic avant d'explorer les tendances et les répartitions.
## Graphiques et répartitions
Sous le récapitulatif, le tableau de bord visualise la même période sous plusieurs formes (la disposition exacte peut évoluer avec le produit) :
- **Tendance dans le temps** — En général un graphique en courbes pour le **volume quotidien de conversations**, et/ou des courbes qui ventilent le volume par **sentiment** (par exemple positif vs. négatif) afin de repérer les pics ou les changements sur certains jours.
- **Par tag** — Graphiques horizontaux montrant comment les conversations **se rattachent aux tags** (par exemple volume par tag, ou répartition **positive / neutre / négative** par tag). Les tags reflètent la manière dont les conversations sont catégorisées dans votre espace (par exemple des thèmes comme l'onboarding ou la facturation).
- **Par agent** — Répartitions similaires **par agent**, pour comparer charge et sentiment entre assistants (par exemple customer success vs. spécialiste produit).
Les infobulles sur les graphiques permettent de lire les effectifs ou pourcentages exacts.
## Comment utiliser Insights
- **Suivi opérationnel** — Observer le volume de conversations et les réactions après une mise en ligne, une campagne ou une modification des consignes d'un agent.
- **Qualité et sentiment** — Suivre le sentiment et les pouces haut/bas dans le temps pour voir si les utilisateurs sont satisfaits et où apparaît la friction.
- **Priorisation** — S'appuyer sur les répartitions par tag et par agent pour identifier les zones qui concentrent le volume ou un signal négatif, et les croiser avec la configuration ou les mises à jour des connaissances ailleurs dans la console d'administration.
Insights est en **lecture seule** : il ne modifie ni les agents ni le contenu ; il sert à décider **où** agir ensuite.
---
# Confluence
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide/
Language: fr
Section: Documentation
**Vous cherchez les capacités du connecteur ?** Cette page donne les instructions de configuration pas à pas. Pour une vue d'ensemble du connecteur Confluence et de ses fonctionnalités, consultez la page [Connecteur Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/confluence-connector).
*Temps approximatif : 5-7 minutes, hors prérequis*
## Avant de commencer
Pour connecter votre ou vos espace(s) Confluence à ATG, suivez les étapes ci-dessous :
[1. Créer un jeton API sur le compte Atlassian](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide) : un compte administrateur Atlassian est requis.
[2. Configurer le connecteur Confluence dans ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide) : un compte administrateur ATG est requis.
## 1. Créer un jeton API sur le compte Atlassian
### Accédez à la page dédiée de votre [compte Atlassian](https://id.atlassian.com/manage-profile/security/api-tokens)

### Cliquez sur *Créer un jeton API*

### Saisissez un nom pour votre clé

### Saisissez une date d'expiration

La date d'expiration ne peut pas dépasser un an. Lorsque la clé expire, il faudra en générer une nouvelle et mettre à jour la configuration du connecteur. Nous recommandons de mettre une alerte pour ne pas oublier.
### Cliquez sur *Créer*

### Copiez votre clé

Enregistrez ce jeton API dans un outil sécurisé (gestionnaire de mots de passe, etc.).
Si vous ne l'enregistrez pas à cette étape, il ne pourra pas être récupéré plus tard. Il faudra en générer un nouveau.
### Cliquez sur *Terminé*


Votre nouveau jeton apparaît dans le tableau
## 2. Configurer le connecteur Confluence dans ATG
### Revenez à votre console d'administration ATG

Saisissez le nom de domaine (ex. ***votreentreprise***.atlassian.net)
Saisissez votre adresse e-mail (celle avec laquelle le jeton API a été créé sur Atlassian)
Saisissez le jeton API généré précédemment
Cliquez sur « Valider »
### Ajouter une ou plusieurs sources depuis Confluence
### Cliquez sur « Ajouter une source »

### Sélectionnez les espaces à inclure dans l'import

### Cliquez sur Suivant

### Configurez les filtres de documents

Cliquez sur **« Suivant »**
### Choisissez le nom de votre source et enregistrez la configuration

### Vérifier les documents
Une fois tous les documents traités (cela peut prendre quelques minutes selon le volume), ils apparaîtront dans la source

## Modification et mise à jour de la clé API
Lorsque votre jeton expire, vous devrez créer un nouveau jeton et mettre à jour la configuration du connecteur.
---
# Connecteur Confluence
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/confluence-connector/
Language: fr
Section: Documentation
**Vous voulez configurer ce connecteur ?** Cette page présente le connecteur Confluence et ses capacités. Pour les instructions pas à pas, consultez le [Guide de configuration Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide).
## Connecter votre base Confluence à ATG
Le **connecteur Confluence** synchronise la documentation de votre organisation depuis **Confluence Cloud** vers ATG, pour que les connaissances de votre équipe soient accessibles via la recherche et le chat IA.
### Ce qui est synchronisé
Le connecteur peut importer du contenu depuis :
- **Espaces de collaboration** — Espaces d'équipe où votre organisation crée et partage la documentation
- **Espaces personnels** — Espaces individuels pour notes et contenu personnels
Vous gardez un **contrôle total** sur ce qui est importé grâce aux options de filtrage.
### Traitement complet du contenu
Lors de la synchronisation des pages Confluence, ATG traite **à la fois le texte et les images** de vos articles pour une capture complète des connaissances. Votre assistant IA peut ainsi comprendre et référencer le contenu visuel en plus du texte.
En savoir plus : [Documents et images](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
### Options de filtrage flexibles
Une fois connecté, vous pouvez préciser ce qu'ATG importe :
- **Sélectionner des espaces** — Choisir quels espaces de collaboration ou personnels synchroniser
- **Filtres de date** — Importer uniquement les documents mis à jour avant une date donnée, après une date donnée, ou entre deux dates
- **Inclure/Exclure dossiers et fichiers** — Inclure ou exclure des dossiers ou fichiers précis
- **Filtrage par labels** — Utiliser les [labels Confluence](https://support.atlassian.com/confluence-cloud/docs/use-labels-to-organize-your-content/) pour inclure ou exclure du contenu selon la taxonomie de votre organisation
Ainsi, ATG ne traite que le contenu pertinent pour votre équipe.
### Mises à jour automatiques
Après la première synchronisation, le connecteur se rafraîchit selon la **fréquence configurée pour la source**. Les nouvelles sources sont réglées sur **Quotidien** ; un administrateur peut choisir Manuel, Hebdomadaire ou Mensuel, ou lancer une actualisation à la demande, pour que votre assistant IA dispose de la documentation à jour. Voir [Fréquence de rafraîchissement](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#frquence-de-rafrachissement).
### Prêt à démarrer ?
Consultez le [Guide de configuration Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide) pour les instructions détaillées.
---
# Utilisateurs
URL: https://www.askthisguy.com/fr/doc/admin-console/users-management/
Language: fr
Section: Documentation
L'espace **Utilisateurs** permet aux administrateurs d'inviter des membres, de gérer les privilèges administrateur et de choisir les agents Webapp que chaque personne peut utiliser.
## Inviter et intégrer des utilisateurs
Les nouveaux utilisateurs rejoignent une organisation ATG sur invitation d'un administrateur. Ils reçoivent un e-mail de validation et suivent les étapes d'onboarding pour activer leur compte.
Après l'activation, donnez à l'utilisateur accès aux agents Webapp nécessaires à son rôle. Un utilisateur doit disposer d'au moins un agent Webapp actif et accessible pour démarrer une conversation.
## Comprendre le modèle d'accès
ATG distingue deux types de droits :
- **Accès administrateur** : autorise la gestion des utilisateurs, des agents et des paramètres de l'organisation.
- **Accès aux agents** : détermine les agents Webapp que l'utilisateur peut voir et sélectionner dans une nouvelle conversation.
Les catégories de connaissances ne sont **jamais affectées aux utilisateurs**. Elles sont configurées sur les agents. Lorsqu'un utilisateur peut accéder à un agent, il peut utiliser les connaissances et les outils configurés pour cet agent.
## Gérer les accès depuis la fiche d'un utilisateur
Ouvrez un utilisateur depuis la liste, puis utilisez la section **Accès aux agents** pour sélectionner les agents disponibles pour cette personne. Vous pouvez tout sélectionner ou choisir les agents individuellement.
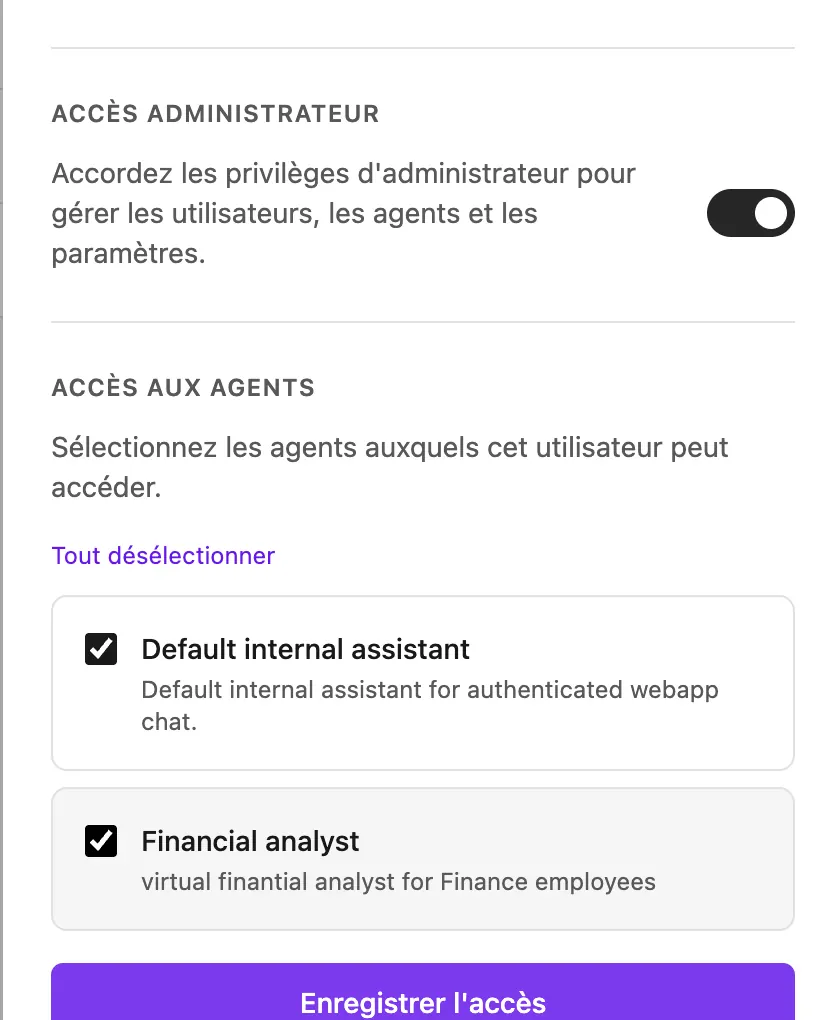 Enregistrez les modifications lorsque la sélection est terminée. Seuls les agents Webapp actifs affectés à l'utilisateur apparaissent dans son sélecteur d'agents.
## Gérer les accès depuis un agent
Vous pouvez gérer la même relation depuis l'onglet **Accès** de l'agent :
- **Ouvert à tous** rend l'agent accessible à tous les utilisateurs de l'organisation.
- **Restreint** réserve l'agent aux utilisateurs sélectionnés.
Les modifications effectuées depuis la fiche d'un utilisateur ou depuis un agent mettent à jour les mêmes règles d'accès. Consultez [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents).
## Privilèges administrateur
Activez **Accès administrateur** uniquement pour les personnes chargées de gérer l'organisation. Les utilisateurs standard peuvent utiliser les agents Webapp qui leur sont affectés, mais ne peuvent pas modifier les paramètres administratifs.
Les privilèges administrateur et l'accès aux agents sont indépendants. Un administrateur peut donc disposer d'un ensemble limité d'agents Webapp pour ses conversations courantes.
## Bonnes pratiques
- **Appliquez le principe du moindre privilège** : donnez à chaque utilisateur uniquement les agents nécessaires à son travail.
- **Utilisez des agents spécialisés** : placez les connaissances confidentielles ou propres à un métier derrière des agents dédiés.
- **Revoyez régulièrement les accès** : retirez les agents qui ne correspondent plus aux responsabilités d'un utilisateur.
- **Traitez rapidement l'onboarding et l'offboarding** : mettez à jour les accès lors d'une arrivée, d'un changement de rôle ou d'un départ.
- **Limitez les droits administrateur** : réservez-les aux personnes qui gèrent l'espace.
## Exemple
Pour une organisation composée d'équipes RH, Finance et Ingénierie :
- créez un agent Finance avec les connaissances et outils financiers, puis limitez-le à l'équipe Finance ;
- créez un agent RH avec les connaissances RH, puis limitez-le aux utilisateurs RH autorisés ;
- gardez un agent interne général ouvert à tous pour les usages communs à l'entreprise.
Ce modèle protège les connaissances spécialisées en contrôlant l'accès aux agents capables de les utiliser.
---
# Google Drive
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide/
Language: fr
Section: Documentation
**Vous cherchez les capacités du connecteur ?** Cette page décrit la configuration pas à pas. Pour une vue d’ensemble du connecteur Google Drive et de ses fonctionnalités, consultez la page [Connecteur Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/google-drive-connector).
*Temps approximatif : 5 à 10 minutes, hors prérequis*
## Avant de commencer
Les actions ci-dessous ne peuvent être effectuées que par les administrateurs de votre espace GCP. Assurez-vous d’avoir accès à un compte administrateur GCP de votre organisation.
Pour connecter ATG à Google Drive, vous devrez :
- [1. Activer l’API Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#1-enable-the-google-drive-api) : cela permettra à votre compte de service GCP d’utiliser Google Drive.
- [2. Configurer le compte de service dans la console cloud GCP](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#2-setup-the-service-account-in-your-gcp-cloud-console) : cela créera un compte de service lié à votre Google Drive.
- [3. Créer les clés du compte de service](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#3-create-keys-for-the-service-account) : cela vous permettra de créer une clé pour votre compte de service et de générer un fichier JSON à importer dans ATG.
- [4. Partager le contenu avec ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#4-share-content-to-atg) : cela vous permettra de choisir quels Drive et contenus autoriser pour ATG.
- [5. Connecter Google Drive dans ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#5-connect-google-drive-in-atg) : cela vous permettra de configurer le connecteur et de choisir quels dossiers seront accessibles aux utilisateurs ATG.
## **1. Activer l’API Google Drive**
### Accéder à la console Google Cloud
Rendez-vous sur [https://console.cloud.google.com/](https://console.cloud.google.com/)
### Ouvrir la section « API et services activés »
Ouvrez le menu de navigation :

Sélectionnez « API et services », puis « API et services activés » :

### Sélectionner un projet
Cliquez sur le bouton « Sélectionner un projet » :

Si aucun projet n’a été créé auparavant, cliquez sur « Créer un projet » :

### Créer votre projet (si ce n’est pas déjà fait)
Saisissez un nom de projet, sélectionnez votre organisation et l’emplacement du projet. Puis cliquez sur « Créer » :

### Ouvrir « API et services »
Cliquez sur « API et services activés » dans le menu de gauche :

### Activer des API et services
Cliquez sur le bouton « + Activer des API et services » :

### Rechercher l’API Google Drive
Saisissez « google drive » dans la barre de recherche et appuyez sur Entrée, puis sélectionnez « Google Drive API » dans les résultats :

Sélectionnez l’API Google Drive :

### Activer l’API Google Drive
Cliquez sur le bouton « Activer » pour activer l’API Google Drive :

## **2. Configurer le compte de service dans la console cloud GCP**
### Accéder à la console Google Cloud
Revenez à la section « API et services » dans le menu de navigation et cliquez sur « Identifiants » :

### Créer des identifiants
Cliquez sur le bouton « + Créer des identifiants » :

Sélectionnez « Compte de service » :

Créez le compte de service.
Saisissez un nom de compte de service et (optionnellement) une description :

Cliquez sur « Créer » puis « Continuer » :

Choisissez le rôle à attribuer au compte de service en cliquant sur « Sélectionner un rôle ».

Vous pouvez choisir le rôle « Lecteur » pour accorder un accès en lecture seule au compte de service.

Terminez la création du compte de service en cliquant sur « Terminé ».

## 3. Créer les clés du compte de service
### Sélectionner votre compte de service
Allez dans la section « Identifiants » du menu « API et services », puis cliquez sur le compte de service créé précédemment.

### Accéder aux clés
Cliquez sur le menu « Clés » :

### Créer une nouvelle clé
La section Clés est vide tant qu’aucune clé n’a été créée. Cliquez sur « Ajouter une clé » puis « Créer une clé ».

### Choisir JSON et créer
Sélectionnez le type de clé JSON puis cliquez sur « Créer ».

**Enregistrez ensuite la clé JSON :**

Un message indiquera que la clé a été enregistrée. Cliquez sur « Fermer ».
Cette clé permet d’accéder à votre Google Drive. **Elle est confidentielle.** Ne la partagez avec personne et ne l’incluez pas dans des dépôts de code publics.
Conservez-la en suivant les [bonnes pratiques Google](https://docs.cloud.google.com/iam/docs/best-practices-for-managing-service-account-keys).
### En cas de message d’erreur lors de la création de la clé
Si vous voyez le message d’erreur suivant :

Vous devrez mettre à jour les stratégies de l’organisation.
Pour cela, votre compte doit disposer des droits d’administrateur.
Allez dans Stratégies de l’organisation, recherchez `iam.disableServiceAccountKeyCreation` et désactivez-la au niveau du projet (ou au niveau de l’organisation si le projet hérite des règles de l’organisation).

## 4. Partager le contenu avec ATG
Par défaut, ATG n’a aucun accès à votre Google Drive. Vous devez d’abord partager le contenu que vous souhaitez importer dans ATG.
Vous pouvez partager avec ATG tout contenu Google Drive souhaité : Drive, dossiers, fichiers, etc., comme vous le faites habituellement.
En règle générale, par mesure de sécurité, ne partagez pas plus que le nécessaire avec un système externe.
Rassurez-vous : partager du contenu avec ATG ne donne pas à ATG l’accès aux utilisateurs de votre organisation. Vous pouvez configurer les accès directement dans ATG (voir plus loin dans le document).
Commencez par récupérer l’adresse e-mail associée à votre compte de service : elle figure dans les détails du compte de service ou dans le fichier JSON enregistré précédemment.
Elle ressemble à ceci : [`atg@master-puppets-493931-f4.iam.gserviceaccount.com`](mailto:atg@master-puppets-493931-f4.iam.gserviceaccount.com) par exemple.
Vous pouvez ensuite partager tout contenu avec cette adresse (un accès Lecteur suffit) :

## 5. Connecter Google Drive dans ATG
### Accéder au menu Connecteurs dans la console d’administration ATG
Rendez-vous dans [le menu Connecteurs](https://app.askthisguy.com/admin/knowledge?tab=connectors) :

Cliquez sur « Ajouter un connecteur », puis sélectionnez « Google Drive » :

Téléversez le fichier JSON des identifiants généré précédemment :

Le connecteur Google Drive est maintenant ajouté à ATG :

Le connecteur Google Drive a bien été ajouté à ATG !
Pour ajouter une source, allez dans [le menu Sources](https://app.askthisguy.com/admin/knowledge?tab=sources) et ajoutez une source (le connecteur Google Drive apparaît dans la liste) :

---
# Connecteurs
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/
Language: fr
Section: Documentation
Les **connecteurs ATG** automatisent l'import et la mise à jour des connaissances de votre organisation. Au lieu de téléverser les fichiers un par un, les connecteurs s'intègrent directement à vos outils existants — **Google Drive**, **Confluence**, **Slack**, etc. — pour synchroniser les documents automatiquement.
Chaque connecteur peut être configuré avec des **paramètres précis** (dossiers, plages de dates, types de contenu). Une fois en place, les connecteurs peuvent se **rafraîchir automatiquement** ou à la demande, pour que votre assistant IA ait toujours accès aux dernières informations.
**Connecteurs personnalisés :** Vous devez vous connecter à un outil qui n'est pas dans la liste ? C'est là qu'ATG apporte une vraie valeur. **Nous pouvons développer des connecteurs sur mesure** — système propriétaire, plateforme de niche ou besoin d'intégration spécifique. Contactez-nous pour en discuter.
## Connecteurs disponibles
Découvrez chaque connecteur et ses capacités :
**Stockage cloud**
[Connecteur Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/google-drive-connector)
[Connecteur SharePoint et OneDrive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/sharepoint-onedrive-connector)
[Connecteur FTP](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/ftp-connector)
**Documentation et communication**
[Connecteur Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/confluence-connector)
[Connecteur Notion](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/notion-connector)
[Connecteur Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/slack-connector)
**Fichiers**
[Téléversement de fichiers](https://www.askthisguy.com/doc/admin-console/knowledge-management/file-upload)
**Sites web**
[Sites web](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/web-sites-connector)
**Connecteurs personnalisés :** Besoin d'intégrer un outil non listé ? Nous pouvons développer des connecteurs adaptés à votre organisation — système propriétaire, base interne ou toute autre plateforme. Contactez-nous pour en discuter.
## Fréquence de rafraîchissement
La **fréquence de rafraîchissement** définit à quel rythme ATG met à jour le contenu importé depuis une source. Elle se règle source par source, et seuls les administrateurs de l'organisation peuvent la modifier.
À chaque rafraîchissement, ATG détecte les fichiers ajoutés, modifiés et supprimés depuis le passage précédent, et ne retraite que ce qui est nécessaire.
1. Dans la console d'administration, ouvrez **Connaissances**, puis l'onglet **Sources**.
2. Repérez la source à configurer et sélectionnez **Modifier**.
3. Dans le champ **Fréquence de rafraîchissement**, choisissez **Manuel**, **Quotidien**, **Hebdomadaire** ou **Mensuel**.
4. Sélectionnez **Enregistrer les modifications**.
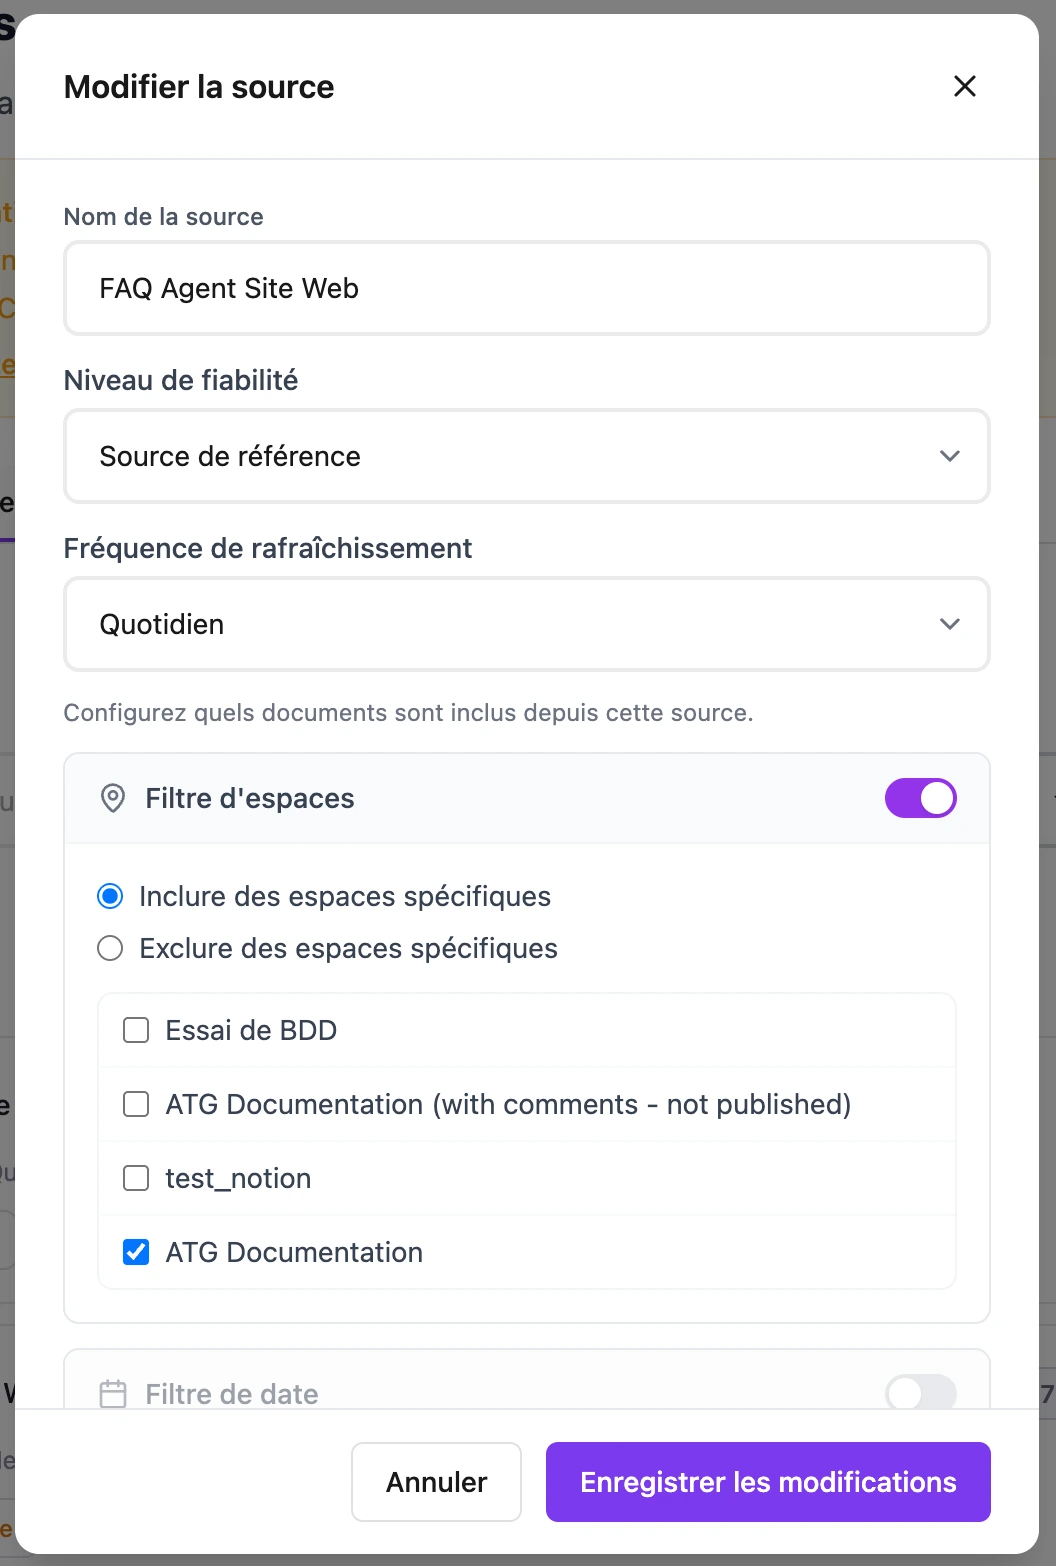 La fréquence retenue apparaît sur la ligne de la source, à côté de sa dernière date de traitement. En mode **Manuel**, aucun rafraîchissement automatique n'est lancé : utilisez **Actualiser** sur la source au moment voulu.
À la création, les sources Google Drive, Confluence, Notion, Slack, SharePoint et FTP/SFTP sont réglées sur **Quotidien**, et les sources de type site web sur **Hebdomadaire**.
### Ce qu'il faut savoir
- Enregistrer une nouvelle fréquence ne relance pas l'importation. Le nouveau rythme s'applique aux prochains passages de la planification.
- Un rafraîchissement automatique peut être décalé si la source a été traitée trop récemment ou si un autre traitement est déjà en cours.
- Il n'est pas possible de choisir une heure précise, un jour précis ou une fréquence personnalisée.
- Une source en cours de mise à jour apparaît **en actualisation** dans la liste. En cas d'échec, consultez le message associé à la source, puis relancez une actualisation manuelle une fois la situation corrigée.
## Guides de configuration
Instructions pas à pas pour configurer chaque connecteur dans votre organisation :
[Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide)
[SharePoint et OneDrive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/sharepoint-onedrive-conf-guide)
[Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide)
[Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide)
[Notion](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/notion-conf-guide)
---
# Console d'administration
URL: https://www.askthisguy.com/fr/doc/admin-console/
Language: fr
Section: Documentation
La **console d'administration** est votre centre de contrôle pour gérer votre environnement ATG ! Configurez les agents IA, organisez les connaissances, gérez les outils et contrôlez l'accès des utilisateurs — le tout en un seul endroit.
**Personnalisez l'expérience ATG de votre organisation en toute simplicité.** Configurez les membres de l'équipe, définissez les permissions, connectez les sources de données et organisez les connaissances IA avec des outils conçus pour l'efficacité.

Explorez les sous-pages ci-dessous pour des guides pas à pas sur les politiques IA, le traitement des données, la gestion des utilisateurs, etc. Tout ce qu'il faut pour maîtriser vos super-pouvoirs d'administrateur !
**Organisation**
- [Organisation](https://www.askthisguy.com/doc/admin-console/organization-settings)
**Menus de la console**
- [Connaissances](https://www.askthisguy.com/doc/admin-console/knowledge-management)
- [Outils et MCP](https://www.askthisguy.com/doc/admin-console/tools-management)
- [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents)
- [Tags et alertes](https://www.askthisguy.com/doc/admin-console/tags-alerts)
- [Évaluation des agents](https://www.askthisguy.com/doc/admin-console/agent-evaluation)
- [Insights](https://www.askthisguy.com/doc/admin-console/insights)
- [Utilisateurs](https://www.askthisguy.com/doc/admin-console/users-management)
**Infrastructure et sécurité**
- [Infrastructure et sécurité](https://www.askthisguy.com/doc/infrastructure-and-security)
## Prêt à vous lancer ?
Accédez à la console d'administration sur [https://app.askthisguy.com/admin/](https://app.askthisguy.com/admin) et explorez les fonctionnalités ci-dessous !
---
# Connecteur Google Drive
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/google-drive-connector/
Language: fr
Section: Documentation
**Vous souhaitez configurer ce connecteur ?** Cette page présente une vue d'ensemble du connecteur Google Drive et de ses fonctionnalités. Pour les instructions de configuration pas à pas, consultez le [guide de configuration Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide).
## Connecter votre Google Workspace à ATG
Le **Connecteur Google Drive** synchronise les documents de votre organisation depuis **Google Workspace** (Entreprise) vers ATG, rendant le savoir de votre équipe immédiatement accessible via la recherche et le chat pilotés par l'IA.
**Note :** Ce connecteur fonctionne exclusivement avec les comptes **Google Workspace** (anciennement G Suite). Les comptes Google Drive grand public ne sont pas pris en charge.
### Que peut-on synchroniser ?
Le connecteur peut importer des documents depuis :
- **Les espaces partagés Drive** - Les espaces d'équipe accessibles à votre organisation
- **Les dossiers partagés** - Les dossiers individuels partagés depuis les Google Drive des collaborateurs
Vous gardez un **contrôle total** sur ce qui est importé grâce à des options de filtrage avancées.
### Options de filtrage flexibles
Une fois connecté, vous pouvez préciser exactement quel contenu ATG importe :
- **Sélectionner des Drive spécifiques** - Choisir quels espaces partagés ou dossiers synchroniser
- **Filtres par date** - Importer uniquement les documents mis à jour avant une date, après une date, ou entre deux dates
- **Règles d'inclusion/exclusion** - Indiquer des dossiers ou fichiers précis à inclure ou exclure
Ainsi, ATG ne traite que le contenu pertinent pour votre équipe, pour une base de connaissances ciblée et efficace.
### Mises à jour automatiques
Après la première synchronisation, le connecteur se rafraîchit selon la **fréquence configurée pour la source**. Les nouvelles sources sont réglées sur **Quotidien** ; un administrateur peut choisir Manuel, Hebdomadaire ou Mensuel, ou lancer une actualisation à la demande, pour que votre assistant IA dispose des dernières versions de vos documents. Voir [Fréquence de rafraîchissement](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#frquence-de-rafrachissement).
### Types de fichiers pris en charge
Le connecteur Google Drive gère un **large éventail** de formats :
**Fichiers natifs Google Workspace :**
- Google Docs
- Google Slides
- Google Drawings
**Formats de documents courants :**
- PDF (.pdf)
- Documents Word (.docx)
- Présentations PowerPoint (.pptx)
- Fichiers HTML (.html)
- Markdown (.md)
- Texte brut (.txt)
- Format RTF (.rtf)
**Images :**
- PNG (.png)
- JPEG (.jpg)
**Types de fichiers personnalisés (Excel par exemple) :**
- [Traitement de documents sur mesure](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) - ATG peut être configuré pour prendre en charge les formats spécifiques de votre organisation avec des règles de traitement dédiées.
### Prêt à commencer ?
Consultez le [guide de configuration Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide) pour les instructions de configuration détaillées.
---
# Dépôt de fichiers
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/file-upload/
Language: fr
Section: Documentation
## Déposer vos documents directement dans ATG
Le **dépôt de fichiers** est la façon la plus simple d'ajouter les documents de votre organisation dans ATG : **glissez, déposez, c'est fait**. Déposez des fichiers depuis la console d'administration et affectez-les à des catégories de connaissances.
### Idéal pour partager rapidement des connaissances
C'est adapté lorsque vous souhaitez :
- **Rendre des documents disponibles** aux agents qui utilisent la catégorie choisie
- **Ajouter des fichiers ponctuels** sans mettre en place une intégration complète
- **Tester du contenu** avant de connecter de gros dépôts
- **Déposer des fichiers** qui ne sont pas dans vos systèmes de stockage cloud
Après traitement, les fichiers deviennent disponibles pour les agents qui disposent à la fois de la catégorie choisie et de l'outil Recherche dans la base de connaissances. Aucun accès direct à une catégorie n'est attribué aux utilisateurs.
### Formats supportés
Le dépôt de fichiers prend en charge un **large éventail** de formats :
**Formats standards :**
-
 Documents PDF (.pdf)
-
 Texte brut (.txt)
- Markdown (.md)
-
 Fichiers HTML (.html)
**Documents Office :**
-
 Documents Word (.docx)
-
 Présentations PowerPoint (.pptx)
Tous les fichiers déposés sont traités avec **extraction du texte et des images** pour une capture complète du contenu.
En savoir plus sur le traitement des images et du contenu visuel : [Documents et images](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
**Types de fichiers personnalisés :**
- [Traitement sur mesure](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) : ATG peut être adapté pour traiter les formats spécifiques de votre organisation avec des règles de traitement dédiées.
### Comment déposer des fichiers
C'est très simple :
1. **Ouvrez la console d'administration** et allez dans la section **Connaissances**
2. **Sélectionnez une catégorie de connaissances** où ajouter les fichiers
3. **Glissez-déposez vos fichiers** dans l'interface, ou cliquez pour parcourir et les sélectionner
4. **C'est tout !** Les fichiers sont traités automatiquement et prêts à l'emploi
Aucune configuration complexe ni authentification n'est nécessaire.
### Traitement automatique
Une fois déposés, vos fichiers sont automatiquement :
- **Extraits** : le texte et les images sont traités pour une compréhension complète du contenu
- **Indexés** : le contenu devient recherchable dans la base de connaissances ATG
- **Catégorisés** : le contenu est organisé dans la catégorie choisie
Après traitement, les agents qui disposent de la catégorie choisie et de l'outil Recherche dans la base de connaissances peuvent retrouver les documents déposés.
### Bonnes pratiques
- **Organiser par catégorie** : déposez les documents liés dans la même catégorie pour un meilleur contexte
- **Tenir les fichiers à jour** : déposez les nouvelles versions lorsque les documents changent
- **Utiliser des noms de fichiers explicites** : des noms clairs aident les utilisateurs et les agents à comprendre le contenu
---
# Notion
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/conf-guides/notion-conf-guide/
Language: fr
Section: Documentation
**Vous cherchez les capacités du connecteur ?** Cette page donne les instructions de configuration pas à pas. Pour une vue d'ensemble du connecteur Notion et de ses fonctionnalités, consultez la page [Connecteur Notion](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/notion-connector).
*Temps approximatif : 3 à 5 minutes*
## Avant de commencer
Pour connecter ATG à Notion, vous aurez besoin de :
- Un **espace de travail Notion** où vous avez le droit de créer des intégrations et de gérer les connexions de pages
- Un compte **administrateur ATG** pour configurer le connecteur dans la [Console d'administration](https://app.askthisguy.com/admin/knowledge?tab=connectors)
La configuration se déroule en quatre étapes :
- [1. Créer une connexion Notion](#1-crer-une-connexion-notion)
- [2. Configurer les permissions et copier le jeton d'accès](#2-configurer-les-permissions-et-copier-le-jeton-daccs)
- [3. Donner accès à votre contenu Notion](#3-donner-accs-votre-contenu-notion)
- [4. Connecter Notion dans ATG](#4-connecter-notion-dans-atg)
## 1. Créer une connexion Notion
### Ouvrir le portail développeur Notion
Rendez-vous sur le [portail développeur Notion](https://www.notion.so/developers/connections) et ouvrez la page **Connexions**.
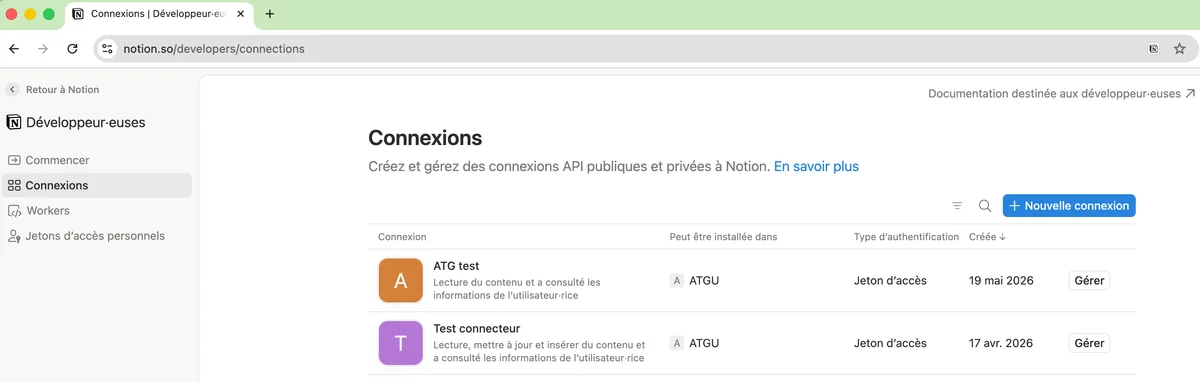
Cliquez sur **+ Nouvelle connexion** pour créer une nouvelle intégration.
### Créer la connexion
Dans la fenêtre **Nouvelle connexion** :
- Saisissez un **Nom de la connexion** (par exemple `Ask This Guy` ou `ATG`)
- Sélectionnez **Jeton d'accès** comme méthode d'authentification. Il s'agit du jeton limité à l'espace de travail qu'ATG utilise pour lire votre contenu.
- Choisissez l'**espace de travail** dans lequel la connexion sera installée
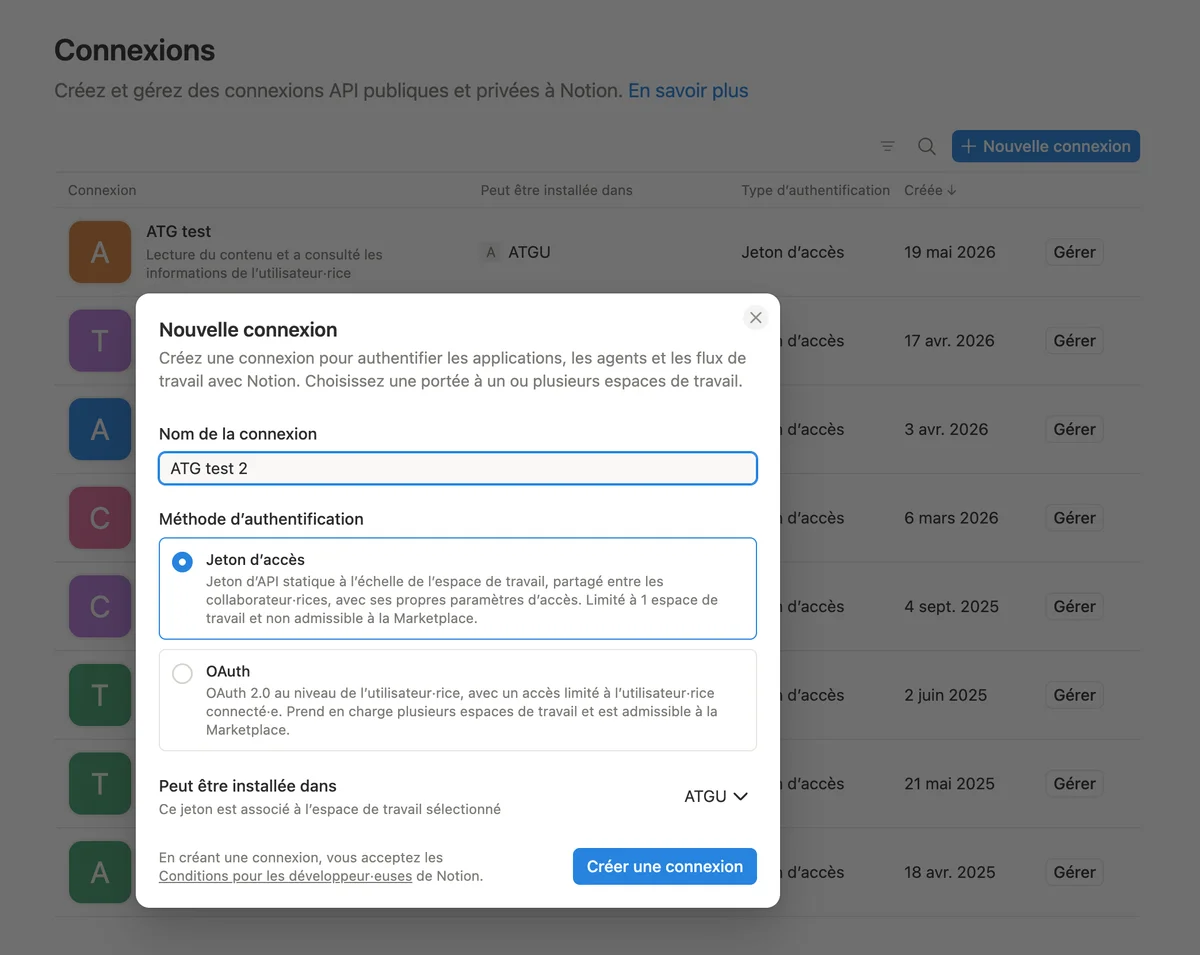
Cliquez sur **Créer une connexion**.
## 2. Configurer les permissions et copier le jeton d'accès
Après la création, vous êtes redirigé vers la page de configuration de la connexion.
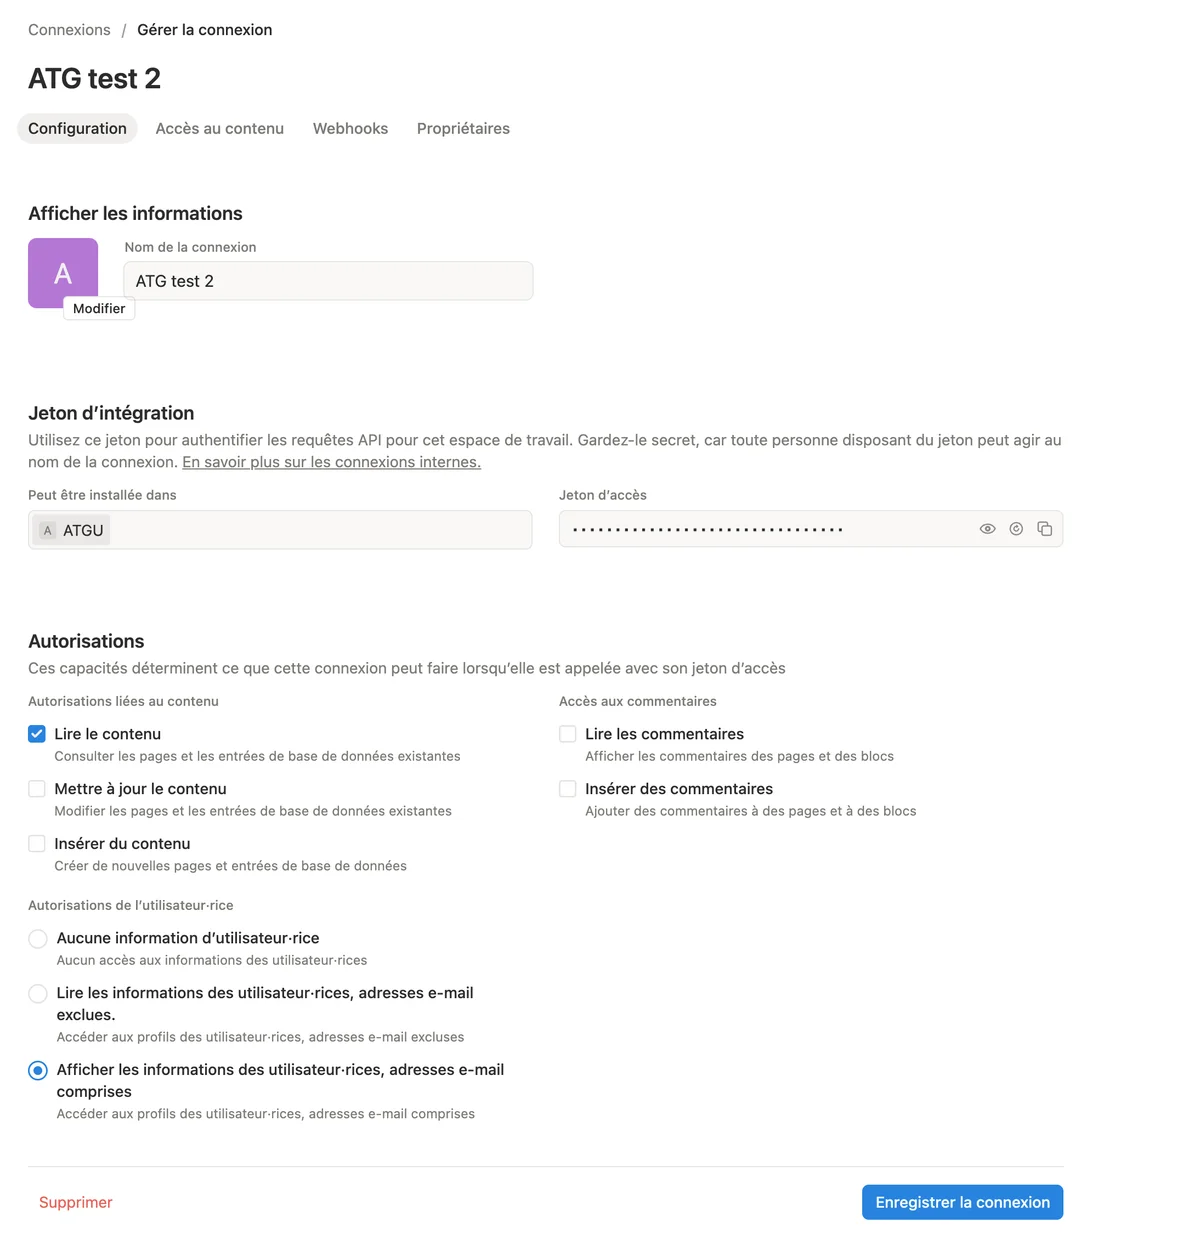
Sous **Capacités**, activez les permissions dont ATG a besoin :
| Capacité | Requis |
|---|---|
| **Lire le contenu** | Oui. Permet à ATG d'importer les pages et les bases de données. |
| **Afficher les informations des utilisateur.rices** | Oui. Permet à ATG d'attribuer le contenu aux bons utilisateurs. |
| Mettre à jour le contenu | Non |
| Insérer du contenu | Non |
| Lire / Insérer des commentaires | Non |
| **Concept** | **Signification** | **Exemple** |
|---|---|---|
| RAG | LLM + recherche en temps réel pour des réponses ancrées | Bibliothécaire avec accès à toutes les ressources |
| Embeddings | Empreintes mathématiques du sens du texte | Cote unique pour chaque livre |
| Base vectorielle | Stocke et organise les embeddings pour une récupération rapide | Catalogue pour une recherche rapide |
| Recherche sémantique | Trouve le sens, pas seulement les mots | Bibliothécaire qui « comprend » ce que vous voulez |
| Recherche par mots-clés | Trouve les correspondances exactes de mots | Recherche par titre de livre |
| Chunking | Découpe les longs textes en parties pertinentes | Diviser un livre en chapitres |
| Prompt engineering | Concevoir comment l’info est présentée au LLM | Poser une question claire au bibliothécaire |
| Mise à jour des données externes | Rafraîchir sources et embeddings régulièrement | Mettre la bibliothèque à jour avec de nouveaux livres |
| Attribution des sources | Fournir des références pour les réponses | Notes de bas de page dans un rapport |
| [**channels:history**](https://api.slack.com/scopes/channels:history) | Voir les messages et le contenu des canaux publics de l'utilisateur |
|---|---|
| [**channels:read**](https://api.slack.com/scopes/channels:read) | Voir les informations de base sur les canaux publics du workspace |
| [**files:read**](https://api.slack.com/scopes/files:read) | Voir les fichiers partagés dans les canaux et conversations auxquels l'utilisateur a accès |
| [**users:read**](https://api.slack.com/scopes/users:read) | Voir les personnes du workspace |
 ## Connecter les serveurs de fichiers distants à ATG
Le **connecteur FTP** synchronise les documents des serveurs **FTP**, **FTPS** ou **SFTP** de votre organisation vers ATG, afin que vos équipes puissent rechercher et dialoguer sur ce contenu comme sur les autres sources de connaissances.
### Protocoles pris en charge
- **FTP** — transfert de fichiers classique
- **FTPS** — FTP sur TLS
- **SFTP** — transfert de fichiers par SSH
### Qu'est-ce qui est synchronisé ?
Le connecteur importe les fichiers depuis les **chemins distants** que vous configurez sur le serveur (dossiers et sous-dossiers autorisés). Vous maîtrisez le périmètre grâce aux options de filtrage ci-dessous.
### Options de filtrage
Vous pouvez préciser exactement ce qu'ATG importe :
- **Règles d'inclusion / d'exclusion** — Cibler des dossiers ou fichiers précis à inclure ou à exclure
- **Date de dernière modification des fichiers** — N'importer que les fichiers modifiés avant une date, après une date, ou entre deux dates
### Types de fichiers pris en charge
Le connecteur gère une **large gamme** de formats :
**Documents**
- Markdown (.md)
- PDF (.pdf)
- Texte brut (.txt)
- Rich Text Format (.rtf)
- HTML (.html)
**Microsoft Office**
- Word (.docx)
- PowerPoint (.pptx)
**Images**
- PNG (.png)
- JPEG (.jpg)
**Autres formats**
- [Traitement sur mesure](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) — ATG peut être personnalisé pour d'autres types de fichiers selon les besoins de votre organisation.
### Mise à jour du contenu
Après la synchronisation initiale, le connecteur se rafraîchit selon la **fréquence configurée pour la source**. Les nouvelles sources sont réglées sur **Quotidien** ; un administrateur peut choisir Manuel, Hebdomadaire ou Mensuel, ou lancer une actualisation à la demande, afin que votre base de connaissances reste alignée avec le serveur. Voir [Fréquence de rafraîchissement](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#frquence-de-rafrachissement).
---
# Connecteur Slack
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/slack-connector/
Language: fr
Section: Documentation
**Vous voulez configurer ce connecteur ?** Cette page présente le connecteur Slack et ses capacités. Pour les instructions pas à pas, consultez la page [Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide).
## Connecter votre workspace Slack à ATG
Le **connecteur Slack** synchronise les conversations, fichiers partagés et connaissances collaboratives de votre équipe depuis **Slack** vers ATG, pour que tout l'historique Slack soit recherchable et accessible via le chat IA.
### Ce qui est synchronisé
Le connecteur importe du contenu depuis :
- **Canaux publics** — Tous les messages et fils des canaux accessibles à l'utilisateur connecté
- **Informations utilisateur** — Profils des membres pour le contexte et l'attribution
Vous gardez un **contrôle total** sur l'accès via les permissions natives Slack — ATG respecte les paramètres de sécurité existants de votre workspace.
### Traitement complet du contenu
Lors de la synchronisation des canaux Slack, ATG traite **messages et fichiers joints** pour une capture complète des conversations. Votre assistant IA comprend ainsi le contexte des échanges, y compris documents partagés, images et discussions collaboratives.
En savoir plus : [Documents et images](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
### Accès intelligent aux canaux
Le connecteur synchronise automatiquement tous les **canaux publics** auxquels l'utilisateur connecté a accès, en respectant les contrôles d'accès et les périmètres de sécurité existants. Les membres n'accèdent qu'aux conversations qu'ils sont autorisés à voir.
### Mises à jour automatiques
Après la première synchronisation, le connecteur se rafraîchit selon la **fréquence configurée pour la source**. Les nouvelles sources sont réglées sur **Quotidien** ; un administrateur peut choisir Manuel, Hebdomadaire ou Mensuel, ou lancer une actualisation à la demande, pour que votre assistant IA dispose des messages et contenus partagés les plus récents. Voir [Fréquence de rafraîchissement](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#frquence-de-rafrachissement).
### Prêt à démarrer ?
Consultez la page [Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide) pour les instructions détaillées.
---
# Sites web
URL: https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors/web-sites-connector/
Language: fr
Section: Documentation
## Importer du contenu web dans ATG
Le **connecteur Sites web** permet d'intégrer du **contenu web externe** directement dans la base de connaissances de votre organisation. En définissant une URL de départ, ATG crawl et indexe le site pour que son contenu soit recherchable et accessible via le chat IA.
### Fonctionnement
Indiquez une **URL** de départ pour le crawl, et ATG va :
- **Télécharger les pages web** du site ou de la section définie
- **Suivre chaque page individuellement** — Chaque page devient une ressource recherchable
- **Respecter le périmètre** — Contrôler quelles parties du site inclure
Idéal pour importer des sites de documentation, des bases de connaissances, des wikis internes ou tout contenu web pertinent pour votre équipe.
### Contrôler ce qui est importé
Vous contrôlez le périmètre du crawl :
- **Définir l'URL de départ** — Choisir d'où commence le crawler
- **Définir les limites** — Importer tout le site ou seulement certaines sections
- **Filtrer le contenu** — Préciser quelles pages ou chemins inclure ou exclure
### Fréquence de rafraîchissement
Les nouvelles sources de type site web sont réglées sur un rafraîchissement **hebdomadaire**. Un administrateur peut modifier cette fréquence, ou passer la source en **Manuel** pour décider lui-même quand relancer le crawl et garder la maîtrise de la synchronisation du contenu externe. Voir [Fréquence de rafraîchissement](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#frquence-de-rafrachissement).
### Ce qui est indexé
Le connecteur traite les **pages HTML** et en extrait le texte, les liens et la structure. Chaque page devient une ressource distincte et citable dans votre base ATG.
### Prêt à démarrer ?
**Configuration rapide en 4 étapes :**
1. Dans la **console d'administration**, allez dans **Connaissances** et sélectionnez une catégorie
2. Cliquez sur **+ Ajouter** à côté de **Sites web**
3. Saisissez l'URL (ou les URL) à crawler — à la main ou en choisissant parmi les suggestions

Écran Sélection des sites web dans la console d'administration
4. Nommez votre source et cliquez sur **Créer**
L'import du contenu web démarre immédiatement !
---
# Widget ATG
URL: https://www.askthisguy.com/fr/doc/atg-embedded/
Language: fr
Section: Documentation
**Guides essentiels :**
- [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents): Configurer vos agents dans la console d'administration
- [Intégrer dans votre webapp](https://www.askthisguy.com/doc/atg-embedded/how-to-integrate-atg-embedded-in-your-webapp): Intégrer le widget dans votre site ou application (iframe, modes, JWT)
## Transformez votre plateforme avec les agents IA
Le **widget ATG** permet d'intégrer les agents ATG dans des sites web tiers, des produits SaaS ou des outils internes, sans la complexité ni le coût d'un développement complet. Créez un **agent Widget** dans la console d'administration, configurez ses connaissances et ses outils, puis intégrez cet agent précis à votre plateforme.
Que vous souhaitiez renforcer le support client, automatiser des processus internes ou proposer des expériences utilisateur intelligentes, le widget ATG rend l'intégration rapide, flexible et économique.
## Cas d'usage : où les agents IA font la différence
### **Sites web publics**
Ajoutez un assistant intelligent sur votre site institutionnel ou marketing qui :
- **Répond aux questions des visiteurs** instantanément en s'appuyant sur le contenu de votre site et votre base de connaissances
- **Guide les prospects** à travers vos produits et services
- **Détecte les intentions** (intérêt d'achat, demande de démo, etc.) et déclenche des notifications pour votre équipe commerciale
- Fonctionne pour les **utilisateurs non authentifiés** sans friction
### **Applications SaaS et web**
Intégrez un copilote IA directement dans votre produit qui :
- **Aide les utilisateurs à naviguer** dans des fonctionnalités et parcours complexes
- **Fournit un support contextuel** selon l'endroit où se trouve l'utilisateur dans l'application
- **Exécute des actions** pour le compte des utilisateurs (création d'enregistrements, mise à jour de paramètres, déclenchement de workflows)
- **Personnalise les réponses** avec les données client et le contexte utilisateur
- Est entièrement **white-label** pour correspondre à votre marque
### **Outils et plateformes internes**
Donnez à vos équipes des agents IA qui :
- **Recherchent** dans les bases de connaissances (Notion, Confluence, Google Drive, SharePoint, Slack, etc.)
- **Répondent aux questions** des employés sur les processus, politiques et documentation
- **Automatisent** les tâches répétitives et la recherche d'information
- **S'intègrent aux systèmes internes** pour récupérer des données ou déclencher des actions
## Pourquoi choisir le widget ATG ?
### **Déploiement rapide et économique**
Pas besoin de construire une infrastructure IA from scratch. Notre **API prête à l'intégration** ne demande qu'un minimum de développement front et back. Configurez vos agents via une **console d'administration no-code**: ce qui réduit fortement le time-to-market et les coûts.
### **Qualité IA de premier plan**
Bénéficiez du **Retrieval Augmented Generation (RAG)** pour des réponses précises et pertinentes ancrées dans votre base de connaissances. Le système limite les « hallucinations » de l'IA et assure des réponses fiables.
### **Gestion des connaissances simplifiée**
Gardez les connaissances de votre IA **à jour automatiquement** en connectant vos sources existantes :
- **Notion**, **Confluence**, **Google Drive**, **SharePoint**, **Slack**
- **Téléversement de fichiers** et **crawling de pages web**
- La **synchronisation automatique** garantit que votre IA dispose toujours des dernières informations
### **Personnalisation et contrôle complets**
- **Instructions personnalisées** pour définir la personnalité et le comportement de l'agent
- **Identité visuelle** pour s'aligner sur votre plateforme
- **Catégories de connaissances** pour contrôler finement ce à quoi chaque agent a accès
- **Outils personnalisés** pour interagir avec votre plateforme (lecture de données, actions, notifications)
- **Mécanisme de validation des outils** pour des opérations d'écriture en toute sécurité
### **Détection d'intention et automatisation**
Configurez vos agents pour **reconnaître les intentions** (signaux d'achat, risque de churn, escalade support) et **déclencher automatiquement des actions** (notifications, création de tickets, etc.).
## Fonctionnement
1. **Configurer la base de connaissances** : connectez vos sources via la console d'administration: sans code
2. **Créer un agent Widget** : choisissez le type Widget, définissez ses instructions, sélectionnez ses catégories de connaissances et ses outils, puis configurez sa sécurité
3. **Intégrer l'API** : ajoutez notre API légère à votre plateforme avec un minimum de travail front et back
4. **Lancer et itérer** : vos agents sont en ligne et s'enrichissent continuellement avec votre base à jour
## Extensibilité
Besoin de quelque chose de spécifique ? Le widget ATG prend en charge :
- Les **connecteurs personnalisés** pour des sources de données uniques
- Les **outils personnalisés** adaptés à votre plateforme
- Un **modèle d'intégration API** flexible
### Pour aller plus loin
[Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents)
[Intégrer dans votre webapp](https://www.askthisguy.com/doc/atg-embedded/how-to-integrate-atg-embedded-in-your-webapp)
---
# Politique IA
URL: https://www.askthisguy.com/fr/doc/admin-console/organization-settings/choosing-the-right-ai-policy/
Language: fr
Section: Documentation
ATG vous donne un contrôle total sur les fournisseurs d'IA qui peuvent accéder à vos données. En coulisses, ATG s'intègre à plusieurs fournisseurs d'IA de premier plan, notamment :
## Fournisseurs européens
- [**Scaleway**](http://scaleway.com/) : hébergeur cloud français pour modèles open-weight
- [**Nebius**](https://nebius.com/) : fournisseur d'infrastructure IA européenne, spécialisé en IA, héberge des modèles open-weight
- [**Mistral**](https://mistral.ai/) : entreprise française d'IA avec ses propres modèles (commerciaux ou open-weight)
- [**Black Forest Labs**](https://bfl.ai/) : entreprise européenne de R&D en IA, spécialisée dans la génération d'images
## Fournisseurs mondiaux
En plus de tous les fournisseurs européens ci-dessus, la politique mondiale inclut :
- [**Google**](https://gemini.google.com/) : fournisseur américain avec les modèles Gemini
- [**Cerebras**](https://www.cerebras.ai/) : fournisseur d'infrastructure IA américain, spécialisé dans l'inférence ultra-rapide
- [**Groq**](https://groq.com/) : fournisseur d'infrastructure IA américain, spécialisé dans l'inférence ultra-rapide
- [**SambaNova**](https://sambanova.ai/) : fournisseur d'infrastructure IA américain, spécialisé dans l'inférence ultra-rapide
- [**OpenAI**](https://openai.com/) : fournisseur américain des modèles GPT (ChatGPT)
- [**DeepInfra**](https://deepinfra.com/) : fournisseur d'infrastructure IA américain
## Modèles commerciaux vs open-weight
Les fournisseurs utilisent différentes approches :
- **Modèles commerciaux :** modèles propriétaires développés et maintenus par le fournisseur (ex. : modèles Mistral, Gemini de Google, GPT d'OpenAI)
- **Modèles open-weight :** modèles dont les poids sont publics et peuvent être téléchargés, inspectés et hébergés de façon indépendante. Des fournisseurs comme Scaleway hébergent ces modèles sur leur infrastructure, pour allier transparence open-weight et hébergement européen.
Les modèles open-weight offrent une plus grande transparence (architecture et paramètres accessibles), permettant des audits de sécurité indépendants et limitant le vendor lock-in.
## Deux niveaux de politique de confidentialité
La protection de vos données est une priorité : ATG propose deux niveaux de politique de confidentialité :
- **Fournisseurs UE uniquement :** limite le traitement IA aux fournisseurs européens (Scaleway, Nebius, Mistral, Black Forest Labs). Vos données restent sous juridiction UE et protégées par le RGPD.
- **Fournisseurs mondiaux :** autorise tous les fournisseurs, y compris américains (OpenAI, Google, DeepInfra), en plus des fournisseurs européens.
**Important :** Choisir des fournisseurs mondiaux peut soumettre vos données à des réglementations américaines (Patriot Act, Cloud Act), qui peuvent exiger que des entreprises américaines donnent accès aux données aux autorités US, y compris pour des données stockées hors des États-Unis. Choisir uniquement des fournisseurs UE vous protège de ces réglementations.
Pour configurer la politique IA : [Console d'administration](https://admin.askthisguy.com) → Organisation ⇒ Paramètres ⇒ Politique IA

## Infrastructure européenne au-delà de l'IA
Quelle que soit votre politique IA, toute l'infrastructure plateforme ATG et le stockage des données (hors traitement LLM) sont hébergés exclusivement par des fournisseurs européens dans des datacenters européens. Vos données principales restent ainsi sous juridiction UE et protection RGPD en permanence.
Nous recommandons de choisir le niveau de confidentialité qui correspond le mieux aux exigences de protection des données et aux obligations de conformité de votre organisation.
## Ressources
[AI and data privacy: What your company needs to know](https://usercentrics.com/guides/data-privacy/ai-and-data-privacy/)
[Rethinking Privacy in the AI Era: Policy Provocations for a Data-Centric World | Stanford HAI](https://hai.stanford.edu/policy/white-paper-rethinking-privacy-ai-era-policy-provocations-data-centric-world)
[The growing data privacy concerns with AI: What you need to know](https://www.dataguard.com/blog/growing-data-privacy-concerns-ai/)
---
# Prompts prédéfinis
URL: https://www.askthisguy.com/fr/doc/admin-console/organization-settings/predefined-prompts/
Language: fr
Section: Documentation
## Standardiser les interactions IA dans votre organisation
Les **Prompts prédéfinis** permettent de créer des **modèles de prompts réutilisables** que toute l'équipe peut utiliser en deux clics. Au lieu que chaque employé rédige ses propres prompts from scratch, vous définissez une fois des modèles professionnels et optimisés — et tout le monde bénéficie de sorties IA cohérentes et de qualité.
### Qu'est-ce qu'un prompt prédéfini ?
Pensez aux Prompts prédéfinis comme à des **modèles d'interaction IA** pour votre organisation. Ce sont des modèles préconfigurés qui :
- **Standardisent les workflows** — Garantissent que tout le monde applique les bonnes pratiques avec l'IA
- **Font gagner du temps** — Les utilisateurs insèrent des prompts éprouvés en deux clics au lieu de les rédiger
- **Améliorent la qualité** — Des modèles bien conçus produisent des résultats meilleurs et plus cohérents
- **Capitalisent l'expertise** — Encodent le savoir-faire de votre organisation en instructions IA réutilisables
### Cas d'usage courants
Les organisations utilisent les Prompts prédéfinis pour de nombreuses tâches :
**Classification de documents :**
- Standardiser les systèmes d'étiquetage entre départements
- Appliquer une catégorisation cohérente aux fichiers et contenus
- Automatiser l'organisation du contenu avec des taxonomies prédéfinies
**Création de contenu :**
- Générer de la documentation produit selon votre guide de style
- Rédiger des articles de blog avec la voix de votre marque
- Créer des contenus marketing alignés sur votre message
- Rédiger des communications client avec un ton cohérent
**Traitement de données :**
- Extraire des informations structurées de documents non structurés
- Résumer des rapports dans le format préféré de votre organisation
- Traduire du contenu en préservant la terminologie technique
**Analyse et recherche :**
- Analyser les retours avec des critères d'évaluation standardisés
- Passer en revue des documents selon des listes de contrôle qualité
- Générer des insights selon vos cadres d'analyse
### Fonctionnement
**Pour les administrateurs (dans la console d'administration) :**
1. **Créer un modèle** — Rédigez votre prompt avec des instructions claires et le contexte nécessaire
2. **Optimiser avec l'IA** — Utilisez la fonction de réécriture IA intégrée pour améliorer automatiquement votre prompt
3. **Publier** — Rendez le modèle disponible à votre équipe
Vous gardez le contrôle sur les prompts disponibles et pouvez les modifier à tout moment.
**Optimisation des prompts par l'IA**
Vous ne savez pas si votre prompt est optimal ? ATG inclut une **fonction de réécriture IA** qui affine automatiquement vos prompts pour une efficacité maximale. Rédigez votre prompt initial, puis cliquez sur le bouton d'optimisation — ATG le restructure et l'enrichit selon les bonnes pratiques de prompt engineering. Chaque Prompt prédéfini livre ainsi les **meilleurs résultats possibles**, même sans être expert.
Exemple de configuration de prompt dans la console d'administration
**Pour les utilisateurs (dans l'application web sur [app.askthisguy.com](http://app.askthisguy.com)) :**
1. **Parcourir les prompts disponibles** — Voir tous les modèles configurés par l'équipe admin
2. **Sélectionner un prompt** — Cliquer pour l'insérer dans la conversation
3. **Ajouter les détails** — Remplir les variables ou le contexte requis
4. **Obtenir les résultats** — ATG traite la requête avec le modèle optimisé
**Deux clics** suffisent pour accéder à des prompts IA de niveau professionnel.

Illustration de la sélection de prompt dans la webapp ATG
### Bénéfices
**Pour l'organisation :**
- **Cohérence** — Tout le monde utilise des prompts éprouvés et de qualité
- **Efficacité** — Moins de temps passé à concevoir et affiner des prompts
- **Partage de connaissances** — Les bonnes pratiques se diffusent dans l'équipe
- **Contrôle** — Les administrateurs veillent à ce que l'usage de l'IA respecte les standards de l'entreprise
**Pour les utilisateurs :**
- **Rapidité** — Insérer des prompts de niveau expert instantanément
- **Apprentissage** — Voir des exemples d'interactions IA efficaces
- **Résultats** — Obtenir de meilleures sorties sans expertise en prompt engineering
- **Simplicité** — Se concentrer sur le travail, pas sur la formulation des questions
### Démarrer
Les administrateurs peuvent créer et gérer les Prompts prédéfinis depuis la **console d'administration**. Commencez par quelques modèles à fort impact pour vos tâches les plus courantes, puis enrichissez la bibliothèque selon les retours et l'usage.
Les utilisateurs trouvent les Prompts prédéfinis directement dans l'application web ATG — l'assistance IA devient un simple point-and-click.
---
# Revue de presse
URL: https://www.askthisguy.com/fr/doc/admin-console/organization-settings/press-review/
Language: fr
Section: Documentation
## Obtenir des briefings actualités pilotés par l'IA sur ce qui compte pour vous
La **Revue de presse** fournit des **revues de presse personnalisées** adaptées aux centres d'intérêt de votre organisation. Rédigez un brief décrivant ce que vous voulez suivre, et ATG recherche, filtre et compile automatiquement les actualités pertinentes à la demande.
### Qu'est-ce que la Revue de presse ?
La Revue de presse est votre **veille actualités IA**. Au lieu de passer des heures à parcourir les sites d'actualité, définissez une fois vos sujets, puis générez des briefings frais et ciblés quand vous en avez besoin.
**Suivez ce que vous voulez :**
- **Concurrents** : Lancements de produits, levées de fonds, mouvements stratégiques
- **Tendances du secteur** : Réglementations, innovations, évolutions du marché
- **Comptes clés** : Actualités clients ou partenaires
- **Sujets précis** : Technologies, marchés, régions
- **Thèmes généraux** : Évolutions et tendances du secteur
Le brief est **totalement flexible** : vous décidez de ce qui compte.
### Fonctionnement
**Les administrateurs** configurent la Revue de presse dans la console d'administration :
1. **Rédiger un brief** : Décrire en langage naturel quelles actualités suivre (concurrents, sujets, secteurs, entreprises, mots-clés : tout ce qui vous importe)
2. **Optimiser avec l'IA** : Utiliser la fonction de réécriture IA intégrée pour améliorer votre brief et maximiser la pertinence
3. **Publier** : Rendre le brief disponible à l'équipe
**Optimisation du brief par l'IA**
Vous ne savez pas comment structurer votre brief ? La **fonction de réécriture IA** d'ATG l'optimise automatiquement. Rédigez votre description initiale, puis cliquez sur le bouton d'optimisation : ATG restructure et enrichit le brief pour que vous obteniez les **actualités les plus pertinentes** à chaque fois.

Configuration de la revue de presse dans la console d'administration
**Les utilisateurs** génèrent des revues depuis l'application web sur [app.askthisguy.com](http://app.askthisguy.com) :
1. **Choisir une Revue de presse** : Sélectionner parmi les briefs configurés
2. **Générer** : ATG recherche sur le web, filtre les articles pertinents et produit un briefing structuré
3. **Lire les insights** : Obtenir une revue complète et facile à parcourir avec les dernières actualités pertinentes
Exemple de revue de presse dans la webapp ATG
Chaque revue est **générée à la demande**, vous avez toujours une information à jour.
### Bénéfices
**Gagner du temps** : Quelques minutes au lieu d'heures de veille
**Rester focalisé** : Ne voir que ce qui est pertinent pour votre activité
**Repérer les opportunités** : Détecter tôt les mouvements concurrentiels et les tendances marché
**Mieux décider** : Fonder la stratégie sur une intelligence marché à jour
### Cas d'usage
- **Veille concurrentielle** : Suivre ce que fait la concurrence
- **Gestion de comptes** : Suivre l'actualité des clients et prospects pour un contact au bon moment
- **Planification stratégique** : Alimenter les réflexions de la direction avec du contexte marché
- **Veille sectorielle** : Rester à jour sur les évolutions et réglementations du secteur
### Démarrer
Les administrateurs configurent la Revue de presse dans la **console d'administration**. Plus votre brief est précis, plus les revues seront pertinentes. La fonction d'optimisation IA vous aide à affiner tout brief pour de meilleurs résultats.
Les utilisateurs génèrent des revues à tout moment depuis l'**application web ATG** : une intelligence fraîche, à la demande.
---
# Webapp
URL: https://www.askthisguy.com/fr/doc/webapp/
Language: fr
Section: Documentation
La webapp ATG donne aux membres authentifiés de votre organisation accès aux agents IA configurés pour leur travail.
Rendez-vous sur [app.askthisguy.com](https://app.askthisguy.com) et connectez-vous pour démarrer une conversation.
## Démarrer une conversation avec un agent
Chaque conversation utilise obligatoirement un agent. Lorsque vous commencez un nouveau chat :
1. Ouvrez **Nouveau chat**.
2. Ouvrez le sélecteur d'agents dans la zone de saisie.
3. Choisissez l'agent adapté à votre tâche.
4. Rédigez votre message et envoyez-le.
Le sélecteur affiche uniquement les **agents Webapp actifs que vous êtes autorisé à utiliser**. ATG présélectionne le dernier agent que vous avez utilisé.
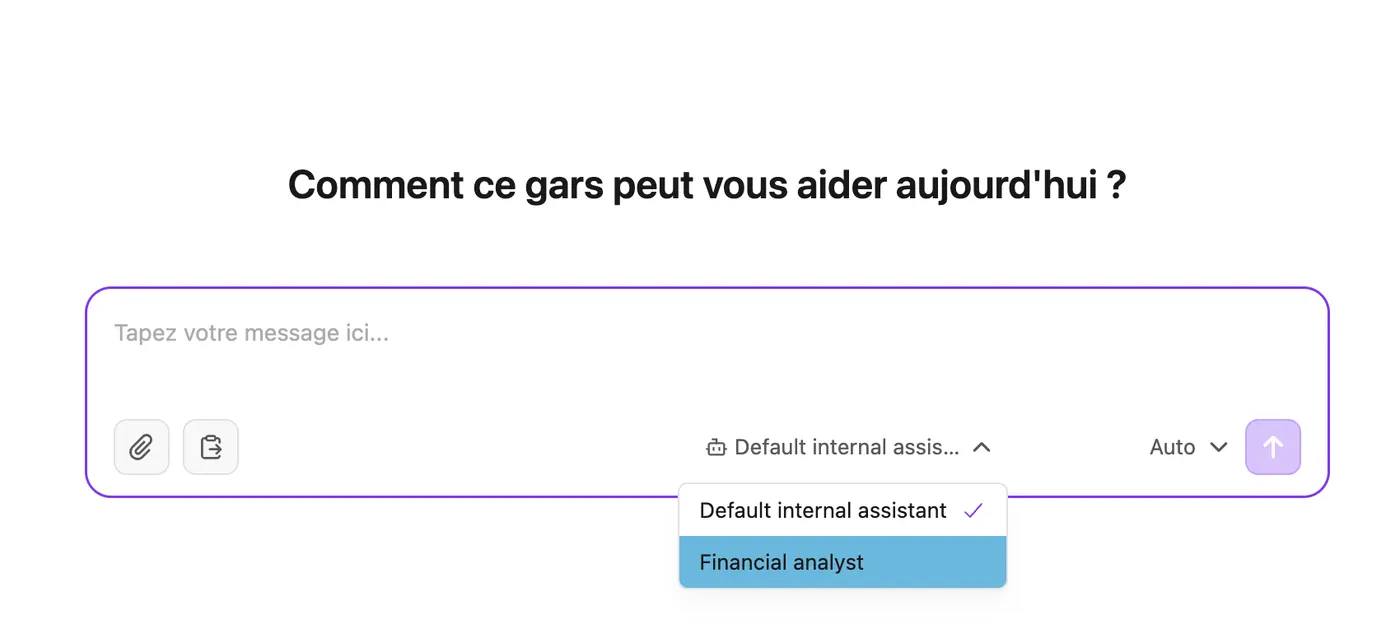
L'agent sélectionné reste attaché à la conversation après le premier message. Démarrez un nouveau chat pour utiliser un autre agent.
## Ce que contrôle l'agent sélectionné
Votre administrateur configure chaque agent avec :
- des **instructions** : son rôle, son comportement, son ton et ses règles de réponse ;
- des **connaissances** : les catégories et sources de l'organisation qu'il peut rechercher ;
- des **outils** : les capacités qu'il peut utiliser, comme la recherche dans les connaissances, la recherche web, la récupération de documents, la génération d'images ou les outils personnalisés.
La configuration de l'agent détermine entièrement les outils disponibles. La webapp ne propose plus de boutons permettant aux utilisateurs d'activer les connaissances de l'organisation ou la recherche web. Décrivez le résultat attendu : l'agent choisit comment répondre en utilisant uniquement les outils qui lui sont autorisés.
Si l'agent ne dispose pas d'un outil ou d'une catégorie de connaissances nécessaire, démarrez une nouvelle conversation avec un autre agent disponible ou contactez votre administrateur.
## Ajouter du contexte à votre demande
La zone de saisie permet aussi de :
- **joindre des fichiers** que l'agent analysera dans la conversation en cours ;
- **utiliser des prompts prédéfinis** créés par votre organisation ;
- **choisir le mode de réponse** lorsque cette option est disponible.
Les pièces jointes personnelles appartiennent à la conversation. Elles sont distinctes des sources de connaissances de l'organisation.
Consultez [Utiliser les pièces jointes](https://www.askthisguy.com/doc/webapp/using-attachments) pour connaître les formats pris en charge et les modalités d'utilisation.
## Naviguer dans la webapp
La barre latérale donne accès à :
- **Nouveau chat** : démarrer une conversation et choisir un agent ;
- **Prompts** : ouvrir la bibliothèque de prompts ;
- **Revues de presse** : accéder aux fonctionnalités configurées pour votre organisation ;
- **Historique des conversations** : rouvrir une conversation avec son agent et son contexte d'origine.
Depuis le menu de votre profil, vous pouvez changer de langue, vous déconnecter et ouvrir la console d'administration si vous disposez des droits nécessaires.
## Partager une conversation
Le partage de conversation transmet une discussion ATG à vos collègues de la même organisation, pour relecture, alignement ou transmission d'un résultat. Seul le propriétaire de la conversation peut activer ou arrêter son partage.
1. Ouvrez une conversation de votre historique.
2. Sélectionnez **Partager** dans l'en-tête de la conversation.
3. Dans la fenêtre de partage, choisissez **Partager avec l'organisation**.
4. Sélectionnez **Copier le lien**, puis envoyez ce lien aux personnes concernées.
 Une fois le partage actif, le bouton est identifié comme **Partagé**. Rouvrez son menu à tout moment pour copier de nouveau le lien, ou sélectionnez **Arrêter le partage** pour révoquer l'accès.
 ### Ce que voit le destinataire
Une personne connectée à ATG, membre de votre organisation et disposant du lien, ouvre la conversation dans une vue dédiée en lecture seule. Elle lit les messages et voit qui a partagé la conversation, mais elle ne peut ni répondre, ni poursuivre la discussion, ni la modifier. La conversation partagée n'est pas ajoutée à son historique ni à sa barre latérale.
### Règles de partage
- Le partage couvre tous les membres authentifiés de votre organisation. Il ne s'agit ni d'un partage nominatif, ni d'un lien public.
- Le lien ne fonctionne pas pour une personne non connectée, pour un compte sans organisation ou pour un membre d'une autre organisation.
- **Arrêter le partage** révoque l'accès immédiatement, y compris pour les personnes qui avaient déjà reçu le lien. Vous pouvez partager de nouveau plus tard : le même lien redevient utilisable tant que le partage est actif.
- Une conversation supprimée, ou dont le partage a été arrêté, s'affiche comme indisponible.
- Un lien donne accès à cette seule conversation, jamais à votre historique ni aux autres conversations de l'organisation.
Avant de partager, vérifiez que la conversation peut être vue par l'ensemble de votre organisation. Arrêtez le partage dès que ce n'est plus le cas.
## Obtenir de meilleures réponses
- Choisissez l'agent dont le rôle correspond le mieux à votre tâche.
- Précisez le contexte, le format attendu et les contraintes utiles.
- Joignez les fichiers nécessaires à la demande.
- Posez vos questions de suivi dans la même conversation lorsque vous souhaitez conserver le contexte.
Pour aller plus loin :
- [Bonnes pratiques LLM](https://www.askthisguy.com/doc/webapp/llm-best-practices)
- [Utiliser les pièces jointes](https://www.askthisguy.com/doc/webapp/using-attachments)
---
# Mode vocal : utiliser un agent vocal IA
URL: https://www.askthisguy.com/fr/doc/webapp/using-voice-mode/
Language: fr
Section: Documentation
Le mode vocal permet de parler à un agent Ask This Guy comme à un assistant vocal IA, sans saisir tout son message au clavier. La conversation reste disponible par écrit et vous pouvez toujours utiliser le clavier, joindre des fichiers et choisir un mode de réponse.
**Périmètre :** le mode vocal est activé séparément pour chaque agent. Cette page décrit son fonctionnement dans la webapp ATG authentifiée.
## Vérifier que le mode vocal est disponible
Sélectionnez un agent. Si le mode vocal est activé pour celui-ci, un bouton de microphone intitulé **Parler** apparaît sous le champ de saisie.
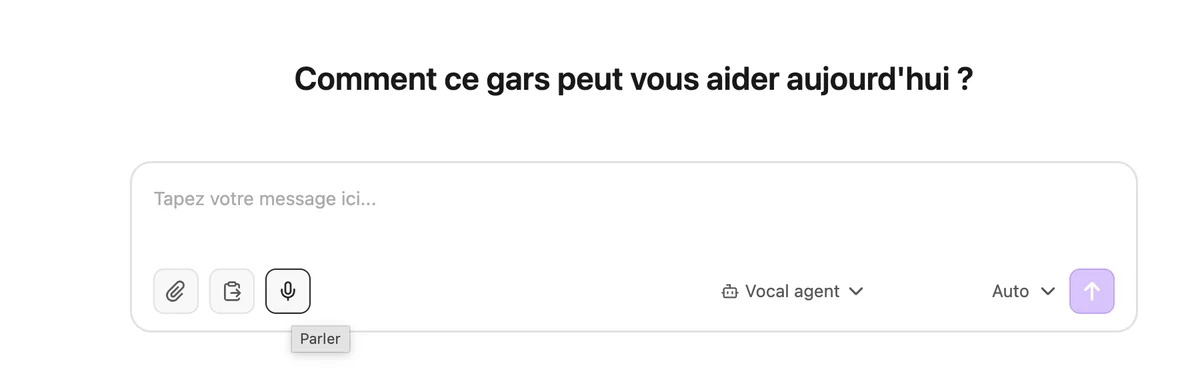 Si le bouton n'apparaît pas ou reste inactif, plusieurs raisons sont possibles :
- le mode vocal n'est pas activé pour l'agent sélectionné ou votre organisation ;
- le navigateur ne prend pas en charge l'enregistrement audio nécessaire ;
- la conversation est en lecture seule ou la saisie est temporairement désactivée.
## Dicter un message
1. Sélectionnez **Parler**. Le bouton devient un carré rouge et une onde sonore indique que le microphone écoute.
2. Lors du premier enregistrement, autorisez le navigateur à utiliser votre microphone.
3. Parlez naturellement. La langue de l'interface aide le service de transcription à interpréter l'enregistrement dans la langue appropriée.
4. Pour terminer, sélectionnez le carré rouge ou marquez une pause après avoir parlé. L'enregistrement s'arrête automatiquement environ **1,5 seconde après la détection d'un silence** et reste toujours limité à **60 secondes**.
5. Patientez pendant l'affichage de **Transcription…**. Le texte reconnu est ajouté dans le champ de saisie.
La transcription se comporte comme du texte ordinaire. Elle s'ajoute au contenu déjà présent dans le champ : vous pouvez donc combiner clavier et dictée, ou enregistrer plusieurs segments successifs.
## Vérifier ou annuler l'envoi automatique
Après la transcription, ATG affiche **Envoi dans 2 s**, puis **Envoi dans 1 s**.
- Ne faites rien pour envoyer le message automatiquement.
- Sélectionnez **Annuler** pour conserver la transcription dans le champ, puis la corriger, la compléter, l'envoyer ou l'abandonner.
- Sélectionnez de nouveau le microphone pour annuler le compte à rebours et commencer une autre dictée.
Relisez toujours les noms propres, les nombres, les informations sensibles et les références techniques avant l'envoi.
## Écouter la réponse de l'agent
Lorsqu'au moins une partie du message envoyé a été dictée, ATG considère l'échange comme un tour vocal et lit automatiquement la réponse terminée de l'agent. Corriger ou compléter la transcription au clavier ne désactive pas ce comportement.
Pendant le traitement, de courtes annonces vocales peuvent signaler que l'agent recherche dans la base de connaissances ou sur le web, consulte des documents ou des données, ou prépare un graphique. Si l'opération se prolonge, ATG peut aussi vous demander de patienter encore un instant. Chaque type d'annonce n'est prononcé qu'une fois par réponse.
La barre audio affiche **Préparation de l'audio…** pendant la synthèse, puis **Lecture en cours…** pendant la restitution. Sélectionnez **Arrêter** pour interrompre la lecture et vider la file audio. Si la génération de la réponse échoue, la lecture automatique est annulée.
La version orale est adaptée pour une écoute naturelle : les marqueurs Markdown, les séparateurs de tableaux, les blocs de code, les images et les marqueurs techniques des sources ne sont pas lus. L'intitulé d'un lien peut être prononcé, tandis que la réponse complète, sa mise en forme et ses sources restent visibles à l'écran.
## Écouter une réponse à la demande
Chaque réponse terminée de l'agent propose une action **Lire à voix haute**. Vous pouvez l'utiliser même si la question d'origine a été saisie au clavier, ou pour réécouter une ancienne réponse de la conversation.
Sélectionnez **Lire à voix haute** pour préparer et lancer l'audio. Le bouton carré permet de l'interrompre. Le lancement d'une autre réponse remplace la lecture en cours : une seule réponse est diffusée à la fois.
## Autoriser l'accès au microphone
Lors de la première utilisation, le navigateur demande l'autorisation d'accéder au microphone. Son indicateur d'enregistrement reste actif uniquement pendant la prise de parole et le flux du microphone s'arrête avec l'enregistrement. L'extrait audio est alors envoyé pour transcription.
Si l'accès est bloqué, ATG vous invite à autoriser le microphone dans le navigateur. Ouvrez les autorisations du site, activez l'accès au microphone pour ATG, puis lancez un nouvel enregistrement.
## Limites actuelles
- Le mode vocal peut ne pas être activé pour toutes les organisations ou tous les agents.
- Une prise de parole est limitée à 60 secondes.
- La transcription et la synthèse vocale nécessitent une connexion réseau et ne fonctionnent pas hors ligne.
- Le mode vocal repose sur des enregistrements ponctuels et lit la réponse terminée : il ne s'agit pas d'une conversation audio continue en temps réel.
- Le fournisseur de transcription, le fournisseur de synthèse et la voix sont configurés pour l'agent. Les utilisateurs ne peuvent pas les modifier depuis le chat.
- Aucune préférence vocale n'est mémorisée pour chaque utilisateur.
- Parler n'interrompt pas automatiquement la lecture. Sélectionnez **Arrêter** avant d'utiliser le microphone.
- Si le navigateur bloque la lecture automatique, utilisez **Lire à voix haute** sur la réponse terminée.
## Résoudre les problèmes courants
| Situation | Que faire ? |
|---|---|
| Le microphone n'apparaît pas | Sélectionnez un autre agent compatible avec le mode vocal ou demandez à votre administrateur de l'activer. |
| L'accès au microphone est bloqué | Autorisez le microphone dans les réglages du site de votre navigateur, puis recommencez l'enregistrement. |
| ATG ne parvient pas à transcrire l'audio | Vérifiez votre connexion, réduisez les bruits de fond et réessayez. |
| La lecture ne démarre pas automatiquement | Sélectionnez **Lire à voix haute** sous la réponse terminée. |
| Vous devez corriger la transcription | Sélectionnez **Annuler** pendant le compte à rebours de deux secondes. |


Le schéma met en regard les trois risques principaux qui pèsent sur vos données et la réponse d'ATG pour chacun : aucun entraînement de modèle sur vos contenus, une rétention minimale sans stockage chez un tiers, et une politique UE uniquement qui bloque les fournisseurs américains.
### 1) Entraînement des IA publiques et fuite shadow AI Nombre de systèmes d'IA publics peuvent utiliser l'usage des consommateurs pour améliorer les modèles. En clair : si un employé colle des informations confidentielles dans un chatbot public, cela peut contribuer à une future version du modèle, sans traçabilité fiable. **Notre engagement :** ATG n'utilise des fournisseurs IA que via des API qui garantissent contractuellement qu'ils **n'entraînent pas les modèles** sur vos données. ### 2) Rétention minimale par conception Nous appliquons une approche de **rétention minimale** : ATG ne conserve que ce qui est nécessaire au fonctionnement du service. - Nous évitons de stocker les fichiers bruts lorsqu'ils ne sont pas nécessaires. - Nous n'utilisons pas les fonctionnalités « hosted data » de tiers (certains fournisseurs IA les proposent ; nous ne les utilisons pas volontairement). ### 3) Politique UE uniquement = pas de transferts vers les US Si votre **politique IA** est réglée sur **UE uniquement**, ATG ne transfère rien vers des fournisseurs américains. En savoir plus : [Politique IA](https://www.askthisguy.com/doc/admin-console/organization-settings/choosing-the-right-ai-policy) ## Transit des données : deux phases distinctes ATG traite les données en deux phases : 1. **Préparation des documents** (transformation des documents en base de connaissances interne) 2. **Réponses aux utilisateurs** (réponse aux questions via récupération interne + appels LLM contrôlés) La **politique IA** a le plus d'impact en phase 2 (fournisseurs LLM utilisés pour la génération). ## Phase 1 — Préparation des documents (ingestion et préparation RAG) ATG exécute un pipeline complet de préparation RAG : extraction du texte et des images, traitement, découpage en chunks, vectorisation et indexation. En savoir plus : [Comment les données de mon entreprise sont-elles traitées ? Qu'est-ce que le RAG ?](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag) ```mermaid flowchart LR Source["Sources client (Drive, etc.)"] --> ATG["Backend ATG"] ATG --> Prep["Extraction + traitement"] Prep --> Vec["Vectorisation (fournisseurs UE)"] Prep --> Img["Compréhension d'images (fournisseurs UE)"] Prep --> OCR["OCR (document complet) via Mistral (si besoin)"] Vec --> Store["PostgreSQL + PGVector + S3 (Supabase auto-hébergé)"] Img --> Store OCR --> Prep ```Le schéma détaille la phase de préparation : les documents issus de vos sources sont extraits et traités par le backend ATG, puis vectorisés et analysés par des fournisseurs européens, avec un passage par l'OCR Mistral uniquement quand la conversion en texte l'exige. Le résultat est stocké chez nous, dans PostgreSQL avec PGVector et S3 sur un Supabase auto-hébergé.
### Ce qui peut être envoyé à des services externes en phase 1 Certains appels à des services IA externes peuvent avoir lieu pendant la préparation, strictement contrôlés par le backend : - **Compréhension d'images** : fournisseurs européens uniquement - **Vectorisation** : fournisseurs européens uniquement - **OCR document complet** : le seul cas où un document entier peut être envoyé à un tiers est la **conversion en texte** via **Mistral OCR** ### Ce qui est stocké après la préparation Après la préparation, ATG stocke principalement : - le texte extrait, découpé en **chunks** - les vecteurs (embeddings) pour la recherche - les images sélectionnées lorsqu'elles sont conservées ATG **ne conserve pas** les fichiers originaux sauf nécessité : - Les **fichiers téléversés** ne sont conservés **que** si un admin souhaite explicitement que les utilisateurs puissent les télécharger plus tard - Pour les documents issus d'un drive/connecteur externe, ATG ne conserve pas les fichiers bruts (ce n'est pas nécessaire) ## Phase 2 — Réponse aux utilisateurs (chat et recherche) ATG n'envoie jamais les documents de votre organisation aux fournisseurs LLM. La récupération d'information se fait **en interne** (sur les serveurs ATG OVHCloud). Ce qui est envoyé à un fournisseur IA, ce sont : - la requête utilisateur - le petit ensemble de **snippets pertinents** (chunks) sélectionnés par ATG comme contexte ```mermaid sequenceDiagram participant U as Navigateur utilisateur participant B as Backend ATG participant DB as Stockage/DB participant LLM as Fournisseurs LLM U->>B: Envoyer la requête B->>DB: Récupérer les chunks pertinents (PGVector) DB-->>B: Top-k snippets B->>LLM: Requête + snippets sélectionnés (pas de documents complets) LLM-->>B: Réponse générée B-->>U: Réponse + citations (affichage par le frontend) ```Le schéma suit une question de bout en bout : le backend ATG récupère lui-même les extraits pertinents dans la base vectorielle, puis n'envoie au fournisseur LLM que la requête de l'utilisateur et ces quelques extraits. Les documents complets ne quittent jamais l'infrastructure ATG.
### Où la politique IA intervient La politique IA détermine quels fournisseurs externes peuvent être utilisés en phase 2 : - **UE uniquement :** fournisseurs européens uniquement - **Monde entier :** fournisseurs UE plus des fournisseurs mondiaux sélectionnés Voir : [Gestion des fournisseurs IA](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers) --- # Notre approche de l'IA souveraine URL: https://www.askthisguy.com/fr/doc/infrastructure-and-security/sovereign-ai/ Language: fr Section: Documentation ## Notre définition de l'IA souveraine Pour ATG, une **IA souveraine** ne se résume pas à utiliser un modèle européen. La souveraineté dépend de la maîtrise de trois éléments complémentaires : 1. **Le droit applicable à l'entreprise** qui fournit le service 2. **L'infrastructure** qui héberge la plateforme et les données 3. **Les modèles d'IA** qui traitent les requêtes et leur contexte Cette distinction est importante. Une plateforme peut être hébergée en Europe tout en faisant appel à un fournisseur d'IA soumis à une juridiction non européenne. À l'inverse, un modèle européen ne suffit pas à rendre souveraine une solution dont l'infrastructure ou l'opérateur échappe au périmètre européen. Cette page décrit **notre mise en œuvre**. Pour la définition générale, les critères d'évaluation et les questions à poser à n'importe quel fournisseur, voir notre page [IA souveraine](https://www.askthisguy.com/ia-souveraine/). Pour approfondir les enjeux de dépendance et de souveraineté numérique, consultez [nos articles consacrés à la souveraineté](https://www.askthisguy.com/blog/tag/souverainete/). ## 1. Une société française, soumise au droit européen Ask This Guy est une société française. Nos engagements contractuels et nos décisions concernant le traitement des données s'inscrivent dans le cadre du droit français et européen, notamment du RGPD. Ce premier niveau de souveraineté apporte un interlocuteur établi en France et un cadre juridique européen. Il ne suffit toutefois pas à lui seul : la localisation de l'infrastructure et le choix des fournisseurs IA sont tout aussi déterminants. ## 2. Une infrastructure européenne, avec une trajectoire on-premise La plateforme ATG est hébergée dans l'Union européenne par des sociétés de droit européen. Notre infrastructure principale repose notamment sur des serveurs dédiés OVHcloud situés à Gravelines, en France, avec une redondance à Francfort, en Allemagne. Les composants essentiels restent dans ce périmètre : - frontend et backend ATG ; - bases PostgreSQL et PGVector ; - stockage des documents et des médias ; - sauvegardes et réplication. Le backend ATG est le point de contrôle des appels vers les services externes. Il accède au stockage, applique les règles d'accès et ne transmet que les informations nécessaires aux fournisseurs IA autorisés par votre politique. ### Nos propres infrastructures GPU en Europe ATG ne se limite pas à consommer des API d'inférence externes. Nous montons également nos **propres infrastructures GPU** chez **Verda**, un acteur finlandais qui opère ses data centers en **Finlande** et en **Islande**. Nous y déployons et exploitons nous-mêmes certains modèles, sur des GPU dédiés à ATG. Cette brique complète le recours à des fournisseurs externes et apporte : - une **IA hébergée en Europe** jusqu'à la couche d'inférence, sans transit du contexte hors de notre périmètre ; - la maîtrise du modèle servi : version, configuration, cycle de mise à jour ; - un opérateur soumis au droit européen, la Finlande étant dans l'Union européenne et l'Islande dans l'Espace économique européen, donc couverte par le RGPD. Selon les cas d'usage, ATG combine ainsi ses propres GPU et des fournisseurs d'inférence tiers sélectionnés, dans les limites de la politique IA choisie par votre organisation. Notre article sur l'[infrastructure IA et les 7 approches d'inférence](https://www.askthisguy.com/blog/enterprise-ai-inference/) détaille les arbitrages de coût et de souveraineté derrière ces choix. ### Aller plus loin avec l'on-premise Pour certaines organisations, la souveraineté exige que la plateforme soit déployée dans leur propre environnement. Nous voulons que l'**on-premise** reste une option possible pour aller plus loin dans la maîtrise de l'infrastructure, du réseau et de la localisation des données. Selon le contexte, le périmètre et les exigences de sécurité, un déploiement dédié peut être étudié avec vos équipes. L'objectif est de rapprocher ATG de votre infrastructure de confiance, sans renoncer aux fonctions de recherche, de gestion des connaissances et d'assistance IA. ## 3. Les modèles IA : souveraineté totale ou meilleure performance Le marché de l'IA évolue rapidement. À ce stade, il existe encore, selon les tâches et les modèles comparés, un écart de performance entre certains fournisseurs américains et européens. Cet écart combine notamment : - la vitesse d'inférence ; - la qualité du raisonnement et de la génération ; - les capacités multimodales et le support natif de pièces jointes. Nous préférons donc être transparents sur ce compromis plutôt que de présenter une souveraineté théorique comme une réponse universelle. ATG vous laisse choisir le niveau adapté à votre organisation. ## Deux politiques IA selon votre niveau d'exigence ### UE uniquement : la souveraineté maximale La politique **UE uniquement** limite les traitements IA aux fournisseurs de droit européen qui exécutent leurs services en Europe, ainsi qu'aux modèles que nous opérons nous-mêmes sur nos GPU chez Verda. C'est le choix à privilégier lorsque la maîtrise de la juridiction et la résidence européenne des traitements sont prioritaires. Cette politique s'inscrit dans une approche d'**IA hébergée en Europe** et d'IA compatible avec les exigences de conformité RGPD. Elle peut toutefois réduire le choix de modèles, leur vitesse ou leurs capacités sur certains cas d'usage. ### Monde entier : une exception limitée à la couche IA La politique **Monde entier** autorise, en plus des fournisseurs européens, certains fournisseurs internationaux sélectionnés. Elle permet de bénéficier des modèles les plus performants ou les plus rapides lorsque cela apporte une valeur concrète à vos utilisateurs. Cette exception concerne la couche IA. L'infrastructure principale ATG, le stockage et les bases de données restent hébergés en Europe. Même avec cette politique, ATG : - n'envoie que les éléments nécessaires au traitement de la requête ; - transmet généralement la question et les extraits pertinents, plutôt que les documents complets ; - utilise les fournisseurs via des API encadrées ; - ne permet pas aux LLM utilisés via ATG d'entraîner leurs modèles sur vos données. Le choix mondial ne supprime donc pas nos exigences de minimisation et de contrôle. Il vous permet d'arbitrer explicitement entre souveraineté maximale et performance opérationnelle. ## Vous gardez la main à tout moment La politique IA peut être modifiée à tout moment depuis le menu **Politique IA** de la console d'administration : [Configurer la politique IA](https://www.askthisguy.com/doc/admin-console/organization-settings/choosing-the-right-ai-policy) Vous pouvez ainsi commencer avec une politique mondiale pour évaluer les performances, puis passer à une politique UE uniquement lorsque vos exigences de conformité ou votre cas d'usage le demandent. L'inverse est également possible si vos priorités évoluent. Pour comprendre précisément les fournisseurs disponibles et leurs garanties, consultez la page [Gestion des fournisseurs IA](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers). Pour le détail des flux de données, consultez [Gestion de vos données](https://www.askthisguy.com/doc/infrastructure-and-security/data-management). ## Notre trajectoire : vous laisser choisir votre IA Notre objectif à terme est de proposer un mode **Bring Your Own AI**. Il permettra aux organisations qui le souhaitent de connecter leurs propres modèles, fournisseurs ou points d'inférence, et de conserver davantage d'autonomie sur la dernière brique de la chaîne. Cette fonctionnalité est inscrite dans notre roadmap. En attendant, les politiques UE uniquement et Monde entier permettent déjà d'adapter le niveau de souveraineté au risque, aux contraintes réglementaires et aux objectifs de performance de chaque organisation. ## En résumé Notre approche de l'IA souveraine repose sur trois engagements : - **Une entreprise française** soumise au droit français et européen - **Une infrastructure européenne**, incluant nos propres GPU chez Verda en Finlande et en Islande, avec une option on-premise pour les besoins les plus exigeants - **Un choix explicite pour l'IA**, entre fournisseurs européens uniquement et accès à des fournisseurs mondiaux pour gagner en performance La souveraineté n'est pas un slogan ni un réglage unique. C'est un arbitrage documenté, que vous pouvez faire évoluer à mesure que vos contraintes et les performances des modèles changent. ## Questions fréquentes sur l'IA souveraine ### Quels critères vérifier pour évaluer la souveraineté d'une IA d'entreprise ? Vérifiez séparément le cadre juridique applicable à l'opérateur, l'infrastructure qui héberge les données et les fournisseurs IA qui traitent les requêtes. Un modèle européen ne suffit pas si l'opérateur ou l'infrastructure échappe à ce périmètre. ### Pourquoi l'hébergement européen ne suffit-il pas à garantir la souveraineté ? L'hébergement européen est un élément important, mais il ne garantit pas à lui seul la souveraineté. Il faut aussi examiner le droit auquel est soumis l'opérateur et les fournisseurs IA qui traitent les requêtes. Une solution peut stocker ses données en Europe tout en dépendant d'un fournisseur soumis à une juridiction non européenne. ### ATG est-elle une IA française ? Ask This Guy est une société française, soumise au droit français et européen. La notion d'**IA française** n'est toutefois pas la bonne : nous fournissons avant tout une plateforme française permettant d'exploiter l'IA. ### Quelle différence entre les politiques UE uniquement et Monde entier ? La politique **UE uniquement** limite les traitements IA aux fournisseurs de droit européen qui exécutent leurs services en Europe. La politique **Monde entier** autorise aussi certains fournisseurs internationaux, tout en conservant l'infrastructure principale, le stockage et les bases de données ATG en Europe. Vous choisissez ainsi entre souveraineté maximale et accès à davantage de modèles. ### ATG opère-t-elle ses propres infrastructures GPU ? Oui. En plus des fournisseurs d'IA externes, ATG monte ses propres infrastructures GPU chez **Verda**, un acteur finlandais dont les data centers se trouvent en **Finlande** et en **Islande**. Nous y déployons et opérons nous-mêmes certains modèles, ce qui permet de garder l'inférence dans un périmètre européen soumis au RGPD, en complément de la plateforme hébergée chez OVHcloud. ### ATG peut-elle être déployée en on-premise ? L'on-premise est une option envisagée pour les organisations qui doivent garder davantage de contrôle sur leur infrastructure, leur réseau et la localisation de leurs données. Selon le contexte, le périmètre et les exigences de sécurité, un déploiement dédié peut être étudié avec vos équipes. --- # Personnaliser ATG pour vous URL: https://www.askthisguy.com/fr/doc/customizing-atg-to-you/ Language: fr Section: Documentation Cette section décrit comment *Ask This Guy* (ATG) peut être **adapté à votre organisation** au-delà du déploiement standard. Plusieurs approches sont possibles ; ATG suit une philosophie **90-10** : garder l’essentiel du système générique tout en concentrant la personnalisation là où elle apporte le plus de valeur. **Dans cette section** - [Introduction](https://www.askthisguy.com/doc/customizing-atg-to-you/introduction) – Approches et modèle 90-10 - [Traitement sur mesure](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) – Gestion documentaire adaptée à vos types de fichiers - [Outils sur mesure](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-tools) – Interroger vos API d’entreprise (CRM, outils internes, etc.) - [Requête base de données](https://www.askthisguy.com/doc/customizing-atg-to-you/database-query) – SQL en langage naturel sur vos données --- # Infrastructure et sécurité URL: https://www.askthisguy.com/fr/doc/infrastructure-and-security/ Language: fr Section: Documentation ## Conçue pour la performance, la sécurité et la souveraineté des données L'infrastructure d'ATG a été **soigneusement conçue** pour offrir performance, sécurité et flexibilité — tout en assurant un **contrôle total** sur vos données. Chaque choix technique reflète notre engagement pour la **souveraineté des données en Europe** et les meilleures pratiques de sécurité. ### Architecture Toute l'infrastructure d'ATG — **frontend**, **backend** et **stockage/bases de données** — tourne sur **des serveurs ATG dédiés chez OVHCloud**, avec redondance sur un second site physique. Cela signifie un **hébergeur européen** et des données non soumises à la législation américaine (Cloud Act, Patriot Act, etc.). Site principal : **Gravelines (France)** ; secondaire : **Francfort (Allemagne)**. Votre appareil communique uniquement avec le frontend et le backend ; le backend seul accède au stockage et aux bases et est le seul à appeler les **services externes** (LLM, recherche web, etc.). Vos données restent sur les serveurs européens d'ATG ; tout appel à un fournisseur d'IA ou autre passe par notre backend sous contrôle strict. **Nos propres GPU, en plus des fournisseurs externes :** ATG ne se contente pas d'appeler des fournisseurs d'IA externes. Nous montons aussi nos **propres infrastructures GPU** chez **Verda**, un acteur finlandais qui opère des data centers en **Finlande** et en **Islande**. Nous y déployons et exploitons nous-mêmes certains modèles, sur des GPU dédiés, sans sortir du périmètre européen (la Finlande est dans l'Union européenne, l'Islande dans l'Espace économique européen, toutes deux couvertes par le RGPD). Détails sur la page [Gestion des fournisseurs IA](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers). **Technologies utilisées :** - **Python** pour tout le backend, permettant une intégration fluide entre les services et modules de la plateforme - **PostgreSQL** pour les données structurées et métadonnées, **PGVector** pour la recherche sémantique IA, **S3** pour les documents et médias. Concrètement il s'agit de **Supabase**, mais **auto-hébergé** sur les serveurs OVHCloud d'ATG et entièrement géré par ATG


| Mode | Typical Use Case | Authentication to scope the session | Requires Backend |
|---|---|---|---|
| Mode 1 - Public | Website FAQ, lead gen, simple SaaS help without per-user context | None | No |
| Mode 2 - Connected | Auth'd SaaS, contextual support, automations | Server-signed JWT with short TTL | Yes |
The diagram shows how a session opens in public mode: the page loads widget.js, the widget requests a session from ATG, and ATG checks the calling origin before declaring the chat ready. No client-side authentication is involved.
### Mode 2 - Connected ```mermaid sequenceDiagram participant User as User participant Site as Client App participant Widget as Widget (JS) participant Backend as Client Backend participant Iframe as ATG Iframe participant ATG as ATG User->>Site: Opens app with embedded chat Site->>Widget: Loads widget.js Widget->>Backend: getSignedParams() Backend-->>Widget: JWT (≤15 min TTL) Widget->>ATG: POST /session/init { jwt } + DPoP Proof ATG-->>Iframe: DPoP-bound access token (in-memory) Iframe-->>User: Chat ready ```The diagram shows how a session opens in connected mode: your backend signs a short-lived JWT (15 minutes at most), the widget presents it to ATG along with a DPoP proof, and ATG returns a DPoP-bound access token to the iframe, held in memory. Your private key never leaves your servers.
Once the session is established, the widget streams user messages to ATG over a secure channel (SSE/HTTPS), and ATG streams assistant tokens back in real time to the iframe, which renders the chat UI. ```mermaid sequenceDiagram participant User as User participant Widget as Widget (launcher) participant Iframe as Iframe (chat app) participant ATG as ATG ([app.askthisguy.com](http://app.askthisguy.com)) Note over Widget,ATG: Session is already established User->>Widget: Clicks launcher / types a message Widget->>Iframe: Open panel (postMessage) / pass input Iframe->>ATG: Send message (SSE/HTTPS POST) ATG-->>Iframe: Stream tokens/chunks (SSE) Iframe->>User: Render streaming reply Iframe-->>ATG: Acks / keepalive User->>Iframe: Follow-up message Iframe->>ATG: Send next message (same session) ATG-->>Iframe: Stream next reply Note over Widget,ATG: Session refresh handled transparently when near expiry (more details in FAQ) ```The diagram covers the conversation once the session is established: the launcher passes input to the iframe, which sends the message to ATG and receives the reply streamed token by token over SSE. Follow-up messages reuse the same session, whose refresh is handled transparently as expiry approaches.
## Integration Steps (both modes) > **Using WordPress?** Skip the manual script integration and use our official plugin instead. It handles steps 3 and 4 for you and supports both open and signed modes. See [Install on WordPress with the ATG plugin](https://www.askthisguy.com/doc/atg-embedded/install-on-wordpress-with-the-atg-plugin). ### Step 1: Configure your agent in ATG's admin console ### Create a Widget agent and set up its knowledge First, create an agent in the Admin Console and choose the **Widget** type. The type cannot be changed after creation. Configure the agent's instructions, knowledge categories, and tools before integrating it. See [Configure Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents) for more details. This is generally done by the functional team or business users. They can test the agent's behavior in the Playground integrated into the Admin Console. ### **Allow-Listed Origins** In the admin console, provide ATG with the exact origins authorized to embed the widget (e.g., [`https://yourapp.com`](https://yourapp.com), [`https://staging.yourapp.com`](https://staging.yourapp.com)) Then, it will be automatically enforced via both runtime checks and CSP (Content Security Policy) headers on the iframe, ensuring the chat can only be embedded on approved domains. ATG will set its CSP (Content-Service-Policy) with a `frame-ancestors` directive based on your allow-listed origins: ``` Content-Security-Policy: frame-ancestors [https://yourapp.com](https://yourapp.com) [https://staging.yourapp.com](https://staging.yourapp.com); ``` ### Step 2: Check that your website does not block ATG If your website uses a strict Content-Security-Policy (CSP) that blocks iframes or external scripts by default, you need to allow the ATG widget and iframe explicitly. To check if your website uses CSP, you can use a `curl`command for example: ```bash curl -I [https://yourwebsite.com](https://yourwebsite.com) | grep -i content-security-policy ``` If it returns nothing or only `frame-ancestors` rule (most common case), then you do not need to extend the CSP header, jump to next step If it returns strict CSPs, like `Content-Security-Policy: default-src 'self'; script-src 'self'; frame-src 'none';`, then add or extend your CSP header as follows: ``` Content-Security-Policy: script-src 'self' [https://app.askthisguy.com](https://app.askthisguy.com); frame-src [https://app.askthisguy.com](https://app.askthisguy.com); ``` > This header is set on your own server or CDN (by your tech/ops team). > > > It tells browsers your page is allowed to load the ATG script and iframe. > ### Step 3: Add the Widget script You will find a simple JS code in ATG’s admin console you can add near the end of the `\| Method | What it does |
|---|---|
window.ATG.open() |
Opens the chat panel. |
window.ATG.close() |
Closes the chat panel. |
window.ATG.toggle() |
Toggles the chat panel open/closed. |
window.ATG.expand() |
Expands the chat to its full view (bubble mode only). |
window.ATG.minimize() |
Minimizes the chat back to its compact view (bubble mode only). |
window.ATG.isExpanded() |
Returns true if the chat is currently expanded. |
window.ATG.resetConversation() |
Starts a new conversation, clearing the current message history. (Open the chat at least once first so the iframe is initialized.) |
window.ATG.updatePageRoute(url) |
Updates the current page route so the agent has up-to-date page context. Mainly used in SPAs (see below). |
| Attribute | Description |
|---|---|
data-agent-id |
Required. Agent ID provided by ATG. |
data-signed-params |
Optional. Boolean (true or false). Enables signed parameter authentication for enhanced security. Requires implementing window.ATG.getSignedParams callback. Defaults to false. |
data-launcher |
Optional. Position of the chat launcher (bottom-right, bottom-left, floating, hidden). Defaults to bottom-right. Use hidden to load the widget without a launcher button and open it yourself via the JS API. |
data-mode-style |
Optional. Display mode of the chat panel (bubble, drawer). Defaults to bubble. bubble: compact panel anchored to the launcher, expandable to a centered modal. drawer: full-height panel anchored right that slides in (launcher is hidden while open; expand/minimize disabled). Mobile viewports stay fullscreen regardless of mode. |
data-language |
Optional. Interface language en, fr. Defaults to en. |
data-page-route |
Optional. Canonical route for the current page (e.g. /plans). Useful if you set up agent instructions that take it in account for contextual content. |
data-theme-json |
Optional. JSON object defining custom visual tokens such as brand color, fonts or corner radius. It helps instantly style the assistant. Example: {'{"color.brand":"#6D28D9","radius.lg":"12px"}'} |
data-aria-label |
Optional. Provides an accessibility label for the chat launcher button, allowing screen readers to announce its purpose (e.g. "Open chat support assistant"). |
data-debug |
Optional. Boolean (true or false). Enables verbose console logging for troubleshooting. Defaults to false. |
| Token name | Description | Example value |
|---|---|---|
color.brand |
Primary brand color | #6D28D9 |
color.bg |
Chat background color | #0B0B0F |
color.text |
Main text color | #F3F4F6 |
color.muted |
Secondary text color | #9CA3AF |
color.assistant-bg |
Background color of assistant message bubbles | #F8F8F8 |
radius.sm, radius.lg |
Corner radius for buttons, cards | 8px, 16px |
font.family |
Font stack | Inter, system-ui, sans-serif |
shadow.elevation |
Card/launcher shadow | 0 8px 24px rgba(0,0,0,0.25) |
| Claim | Type | Description | Example / Notes |
|---|---|---|---|
kid |
string |
Key ID: Identifies which public key to use for signature verification. Must match a key registered with your agent in ATG's admin console. | "prod-key-2024-01" |
alg |
string |
Algorithm: Must be "ES256" (ECDSA with P-256 curve and SHA-256). | "ES256" |
| Claim | Type | Description | Example / Notes |
|---|---|---|---|
iat |
number (Unix seconds) |
Issued-at time: when the token was generated. Used to detect clock drift or replay. | 1739298000 |
exp |
number (Unix seconds) |
Expiration: absolute expiry of this Signed Params token. Must be short (≤ 15 min). ATG refuses expired or overly long-lived tokens. | 1739298900 |
jti |
string (UUID/random) |
JWT ID: unique nonce for this token. Must be random for each issuance. | 550e8400-e29b-41d4-a716-446655440000 |
| Claim | Type | Description | Example / Notes |
|---|---|---|---|
external_user_ref |
string |
External user reference or ID from your system. Can be used to identify the user in agent instructions or logs. | "user_12345" |
entitlements |
object (JSON) |
User entitlements or permissions. Can be used by agent for access control logic. | {'{"plan": "premium", "features": ["export"]}'} |
context_metadata |
object (JSON) |
Additional context metadata about the session or user. | {'{"department": "sales", "region": "EU"}'} |
{'{ type: "ATG_REQUEST_SIGNED_PARAMS_FOR_ROTATION" }'}
- Widget automatically calls your window.ATG.getSignedParams() callback to fetch a fresh signed JWT.
- Your callback should call your backend's presign endpoint and return the new JWT.
- Widget responds to iframe with the JWT and the iFrame rotates the session with ATG's server.
### Do you use any 3rd party cookie?
No, we do not use 3rd party cookies as these would get blocked. For our access token, we use instead JWT + DPoP proof.
### How does ATG handle key rotation and the `kid` header?
Each Signed Parameters JWT includes a `kid` (Key ID) in its header.
ATG uses that value to instantly find the right public key you've uploaded in the console.
When you rotate keys:
1. Generate a new signing keypair and give it a new `kid` (e.g. `key-2025-02`).
2. Add the new public key to ATG console while keeping the old one until all tokens signed with it expire (≤ 15 min).
3. Start signing new tokens with the new `kid`, then safely remove the old key.
ATG automatically verifies each token against the public key that matches its `kid`, so rotation happens seamlessly, no downtime or manual reconfiguration.
---
# Tailored Processing
URL: https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-processing/
Language: en
Section: Documentation
## Tailor ATG to Your Organization's Unique Files
**ATG can be customized** to intelligently handle **your organization's specific file types** - turning complex documents into actionable insights.
### What Can Be Processed?
Whether you work with **Excel spreadsheets**, **product catalogs**, **sales reports**, **scientific datasets**, or any other specialized documents, ATG can learn to process them exactly the way you need:
- **Contact databases** – Extract and organize stakeholder information
- **Product listings** – Parse inventory and specifications
- **Commercial reports** – Analyze sales performance and trends
- **Scientific data** – Process research results and measurements
- **Custom formats** unique to your industry
### How It Works
Custom handling requires **two key components**:
1. **Trigger criteria** – Define what activates the custom processing (e.g., specific keywords in file names, file types, or content patterns)
2. **Processing rules** – Specify exactly how ATG should extract, transform, and structure the data
**Once configured, the processing applies automatically** – no matter where the file comes from. Whether uploaded directly, synced via **Notion**, pulled from **Google Drive**, **Confluence**, **SharePoint**, or any other connector, your custom rules work seamlessly across all sources. See [Connectors](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors) for more information about connectors.
This ensures that **your team gets the right information** from the right files, every time.
### Why Context Matters: No Generic CSV/Excel Processing
You might wonder: **"Why not process all Excel and CSV files automatically?"**
The answer is simple: **context is everything**.
A spreadsheet without context is just raw data. Is that column "Amount" in euros or dollars? Does "Status" mean order status, project status, or employee status? Which rows are headers, which are totals, and which contain the actual data you need?
**Generic automated processing often produces garbage**. Instead, we take a smarter approach:
- **Understand your business first** – We learn how your organization structures data
- **Design targeted rules** – Custom processing that knows what each column means and how to handle edge cases
- **Deliver quality insights** – Your team gets meaningful, actionable information, not just parsed cells
**Garbage in, garbage out.** By investing a small amount of time upfront to understand your specific context, we ensure ATG delivers high-quality knowledge that your team can actually use.
### Ready to Get Started?
Custom file handling is **available as a bespoke development** tailored to your organization's needs.
**Reach out to your ATG contact** to discuss your specific use case and explore how we can optimize ATG for your workflows.
---
# Tools and MCP
URL: https://www.askthisguy.com/en/doc/admin-console/tools-management/
Language: en
Section: Documentation
The **Tools and MCP** section lists the tools built into ATG and lets you connect external systems through the Model Context Protocol (MCP), including the **MCP catalog** to add third-party services quickly.
In the console, open **Tools and MCP**, then the **MCP Servers** tab to manage your connections or browse the catalog.
Tools are enabled agent by agent: each agent's **Tools** tab determines which built-in, custom, and MCP tools can be used in its conversations. See [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents).
## In this section
- **[Tools](https://www.askthisguy.com/doc/admin-console/tools-management/chat-tools)** - The built-in tools every organization gets: knowledge search, web browsing, file generation, email, press review.
- **[MCP servers](https://www.askthisguy.com/doc/admin-console/tools-management/mcp-servers)** - Add and configure MCP endpoints (URL, authentication, transport, tool filters).
- **[MCP catalog](https://www.askthisguy.com/doc/admin-console/tools-management/mcp-catalog)** - Discover pre-integrated third-party MCP services and add them to your organization, including open-access offerings and providers that require an API key.
---
# ATG WordPress plugin
URL: https://www.askthisguy.com/en/doc/atg-embedded/install-on-wordpress-with-the-atg-plugin/
Language: en
Section: Documentation
## Overview
The ATG plugin lets you activate a chat agent on your WordPress site and configure it in a few clicks: choose the widget shape, where it appears, its branding, scope which pages it shows on, and more. Optionally, you can also secure chat sessions so they are only accessible to authenticated users on your site.
## Prerequisites
- **A WordPress site** running WordPress 6.0 or later, PHP 7.4 or later. For signed mode, the PHP `openssl` extension must be enabled (it is on virtually every production host).
- **A Widget agent UUID.** Create an ATG agent and choose the **Widget** type. The type cannot be changed after creation. See [Configure Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents). The UUID is available in the agent's Embed Code tab.
- **Your WordPress site domains.** In the ATG admin console, add your site domains (e.g. `https://yoursite.com`, `https://staging.yoursite.com`) to the agent's allow-listed origins. The chat will only work on those domains.
## Step 1: Download and install the plugin
Download the plugin ZIP: [atg-chat-widget.zip](https://www.askthisguy.com/downloads/atg-chat-widget.zip)
Then install it like any other WordPress plugin:
1. In your WordPress admin, go to **Plugins → Add New → Upload Plugin**.
2. Choose the `atg-chat-widget.zip` file you just downloaded and click **Install Now**.
3. Click **Activate Plugin**.
A new **Settings → Ask This Guy Chat** menu appears.
## Step 2: Paste your agent UUID
1. Go to **Settings → Ask This Guy Chat**.
2. Paste your agent UUID into the **Agent UUID** field.
3. Click **Save Changes**.
Visit your site front-end; the chat launcher should appear in the bottom-right corner.

## Step 3: Configure display options
On the same settings page, you can refine where and how the widget appears:
| Setting | What it controls |
|---|---|
| Launcher position | Bottom-right (default), bottom-left, floating, or hidden. Hidden loads the widget without a launcher button so you can wire up your own trigger via the window.ATG JS API. |
| Display mode | Bubble (default): compact panel, expandable to a centered modal. Drawer: full-height panel anchored right. |
| Language | Auto-detect from the WordPress site locale, or force English / French. |
| Show on | Site-wide, restricted to selected post types, or everywhere except a list of URL paths. |
| Accessibility label | Override the launcher button's aria-label. |
| Theme overrides | Brand color, corner radius, font family, shadow. The full default theme JSON is shown as a reference you can paste-and-edit. |
| Tool | What it does | Widget | Active by default |
|---|---|---|---|
| Knowledge base search | Searches the meaning of your indexed [documents](https://www.askthisguy.com/doc/admin-console/knowledge-management) and returns the relevant passages. | Yes | Yes |
| Find relevant documents | Identifies which documents match a description, when the user is looking for a file rather than an answer. | Yes | Yes |
| Get document content | Reads a document in full, once it has been identified, including files the user uploaded themselves. | Yes | Yes |
| Query document catalog | Answers questions about the library itself: how many documents, which folders, which source, what status. | Yes | **No** |
| Organization context | Retrieves the free-text description of your organization set in [Organization settings](https://www.askthisguy.com/doc/admin-console/organization-settings). | Yes | Yes |
| Tool | What it does | Widget | Active by default |
|---|---|---|---|
| Web search | Searches the public web for recent information that your documents and the model do not cover. | Yes | Yes |
| Fetch web page content | Reads the pages behind the URLs given by the user, or behind a link found in your knowledge base. | Yes | Yes |
| Tool | What it does | Widget | Active by default |
|---|---|---|---|
| Generate Word document | Turns a written answer into a `.docx` file, with its headings and lists. | No | Yes |
| Generate PowerPoint presentation | Builds a `.pptx` deck, one slide per main heading. | No | Yes |
| Generate spreadsheet | Exports structured data as a CSV or Excel file. | No | Yes |
| Generate image | Creates or modifies an illustration from a text description. | No | Yes |
| Tool | What it does | Widget | Active by default |
|---|---|---|---|
| Email me | Sends the current user an email containing content produced in the conversation. | No | Yes |
| Tool | What it does | Widget | Active by default |
|---|---|---|---|
| Press review | Produces a news digest following the brief defined in [Press review](https://www.askthisguy.com/doc/admin-console/organization-settings/press-review). | Yes | Yes |
| BDNB building database | Queries the French national building database (BDNB) for public data about a building or a plot. | Yes | **No** |
| Setting | Webapp | Widget |
|---|---|---|
| Configuration | Yes | Yes |
| Knowledge | Yes | Yes |
| Tools | Yes | Yes |
| Playground | Yes | Yes |
| Access to internal users | Yes | No |
| Source visibility | No | Yes |
| JWT security and allowed origins | No | Yes |
| Embed code and agent UUID | No | Yes |
The diagram follows one question end to end: the main AI decides to call the Database Query tool by phrasing a natural-language question, a dedicated AI turns that question into SQL, and the tool runs the read-only query before returning the result along with its explanation. Several dialogue turns are possible, and the Database Query tool is only one tool among others.
**[Book a demo](https://www.askthisguy.com/demo)** to discuss connecting your database or setting up a managed one for this capability. --- # Configure voice mode URL: https://www.askthisguy.com/en/doc/admin-console/voice-mode/ Language: en Section: Documentation Voice mode is configured separately for each agent. When enabled, it turns the agent into an AI voice assistant: users dictate their messages and hear its responses in the authenticated ATG webapp. **Scope:** the behavior documented here has been verified in the main authenticated webapp. Do not assume that voice mode is available in the embedded widget or shared conversations. ## Enable voice mode 1. In the Admin Console, open **Agents**. 2. Select the agent you want to configure. 3. Open the **Configuration** tab. 4. Turn on **Enable voice mode**. 5. Review the speech-to-text provider, text-to-speech provider, and voice.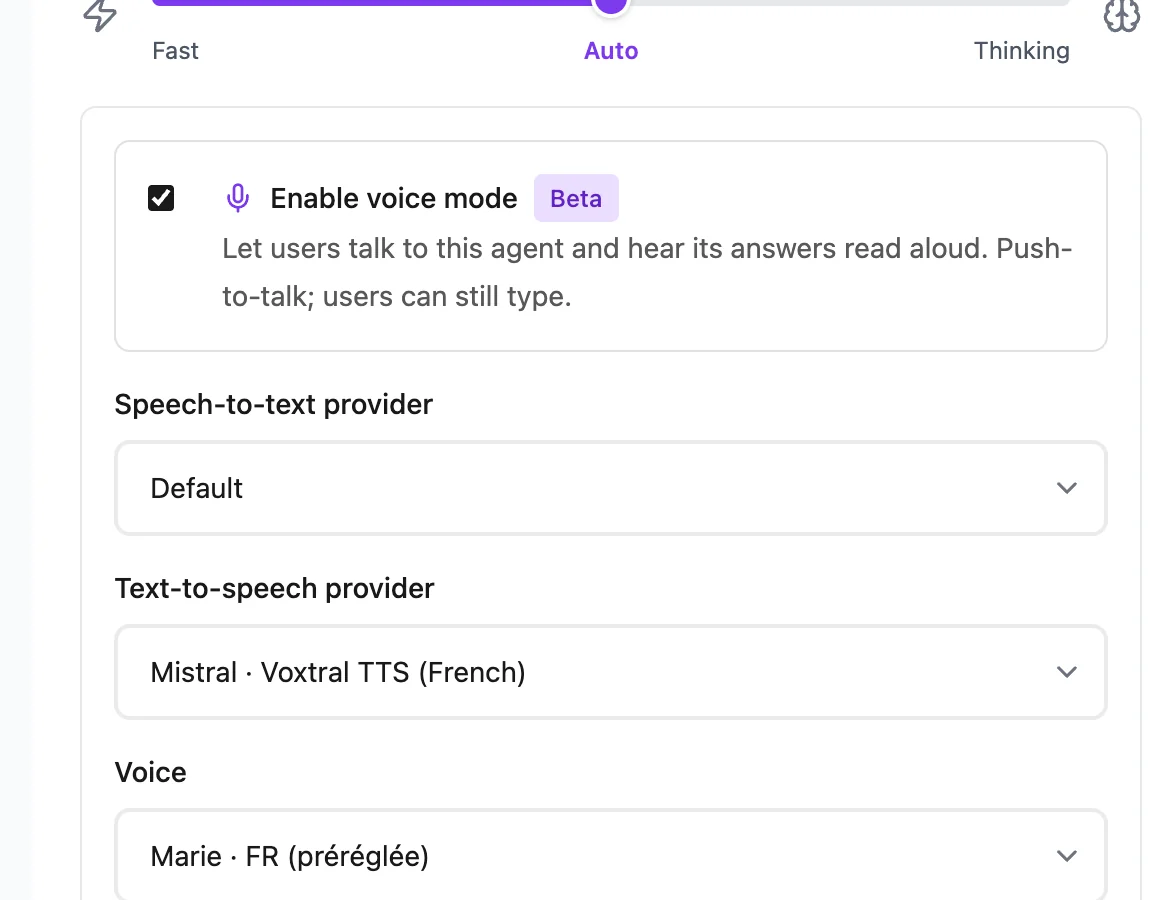 Once the agent is active and available to a user, a **Speak** microphone button appears in the webapp message field.
## Choose the voice services
The exact providers and voices available depend on the services configured in your environment.
- **Speech-to-text provider:** transcribes the user's recording into editable text.
- **Text-to-speech provider:** turns the agent's completed response into audio.
- **Voice:** selects the voice used to read responses.
The **Default** option uses the default service available on the platform. When selecting a specific voice, check that its language suits the agent's intended audience.
## What enabling voice mode changes
For users of the configured agent:
- a microphone button becomes available in new and existing conversations;
- each recording is transcribed and prepared for automatic sending;
- a response to a dictated message is read aloud automatically;
- any completed response can also be played on demand.
Voice mode supplements the written chat. It does not disable typing, attachments, response modes, or other chat features, and it does not create a continuous real-time voice call.
## Voice mode, voice chatbot, or voicebot?
Voice mode covers a specific need. Before rolling it out, check that it matches the expected use case.
- **ATG voice mode:** dictated messages and spoken responses, agent by agent, in the authenticated webapp. It is an internal AI voice agent backed by your knowledge and your tools.
- **Voice chatbot on a public website:** the [ATG Embedded](https://www.askthisguy.com/doc/atg-embedded) widget is not covered by this page. Do not assume that voice is available there. For website conversational agents, see the [Website chatbot](https://www.askthisguy.com/solutions/website-chatbot/) page.
- **Voicebot or phone callbot:** out of scope. Voice mode does not place phone calls and does not hold a continuous real-time audio conversation.
## Validate the configuration
Test the feature with a user account that can access the agent:
1. Confirm that **Speak** appears for the agent.
2. Allow microphone access and record a short question.
3. Check the transcription and the two-second automatic-send countdown.
4. Cancel the countdown and confirm that the text remains editable.
5. Send a voice message and confirm that the completed response is read aloud.
6. Stop playback, then use **Read aloud** on a previous response.
Also test the experience in the browsers supported by your organization. Browser microphone permissions and autoplay policies can affect recording and playback.
## Current constraints
- Each recording is limited to 60 seconds.
- Transcription and speech synthesis require a network connection.
- Users cannot choose a provider or voice from the chat, and voice preferences are not stored per user.
- Speaking does not automatically interrupt audio already playing.
- Provider availability can vary between environments.
Do not make assumptions about how long audio clips are retained. Confirm your organization's privacy requirements and the policies of the configured voice providers before rollout.
Share [Use voice mode](https://www.askthisguy.com/doc/webapp/using-voice-mode) with your users for operating instructions and troubleshooting.
---
# Tags & Alerts
URL: https://www.askthisguy.com/en/doc/admin-console/tags-alerts/
Language: en
Section: Documentation
**Tags & Alerts** is where you define rules that automatically **tag** conversations and optionally **send email notifications** when a conversation matches a condition you describe in plain language—not a fixed list of keywords.
## List and filters
The main view shows your tags in a table. Use the **agent** dropdown at the top to manage rules **for a specific assistant** (each tag is scoped to one agent).
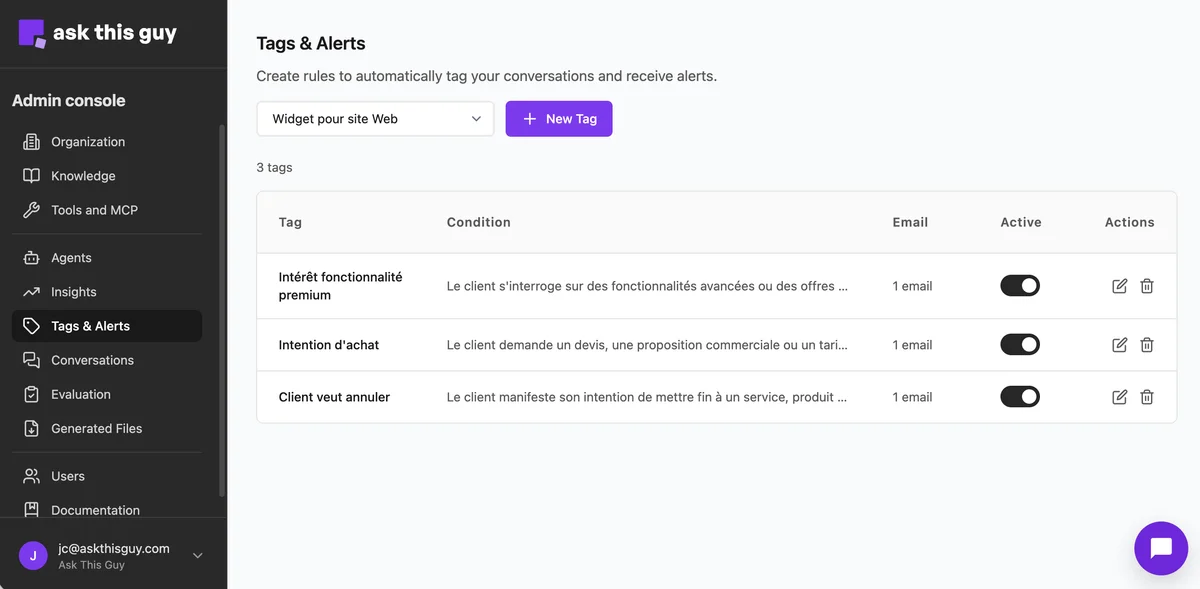
### Table columns
- **Tag** — The label applied to matching conversations (and used in analytics elsewhere).
- **Condition** — A short description of when the tag applies; the full wording is edited in the side panel.
- **Email** — How many email notification targets are configured for this tag.
- **Active** — Enable or disable the rule without deleting it.
- **Actions** — Edit or delete the tag.
## Creating or editing a tag
Choose **+ New Tag** or open an existing row. A **side panel** opens for the tag definition.
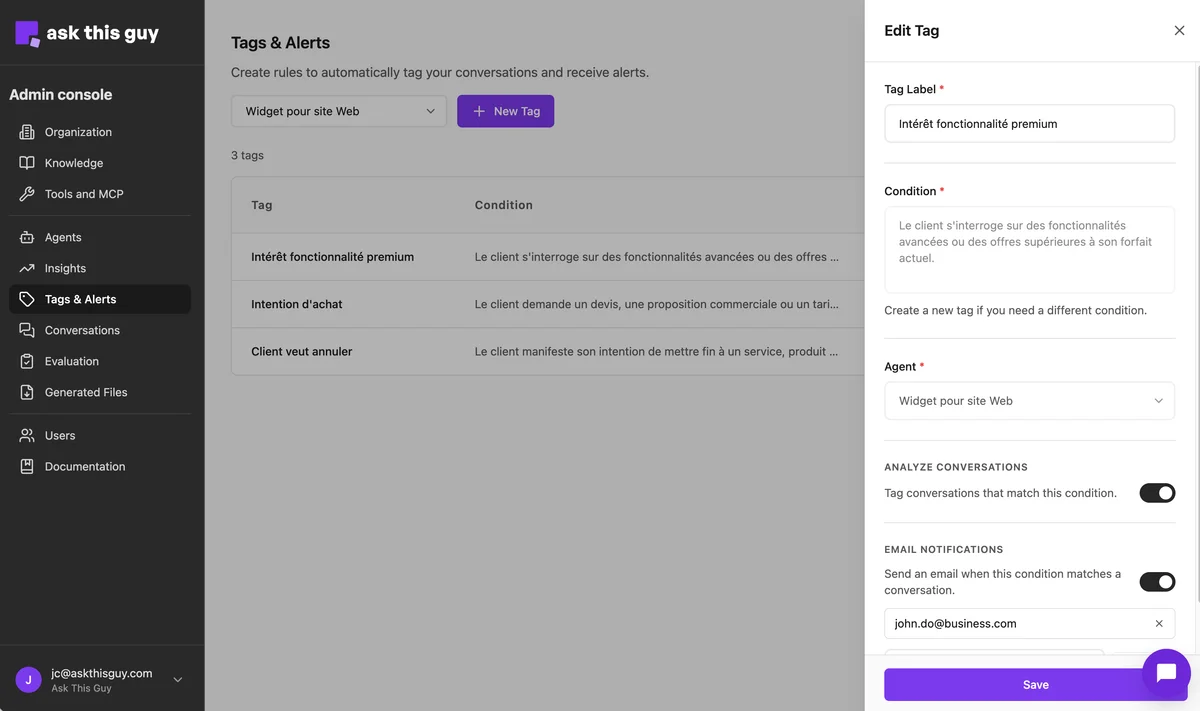
### Required fields
- **Tag label** — Clear name for the tag (for example “Purchase intent” or “Wants to cancel”).
- **Condition** — Describe in **natural language** what should count as a match (for example interest in a higher plan, request for a quote, or churn risk). The system evaluates **conversation context**; you can phrase the rule the way your team thinks about the scenario.
- **Agent** — The chatbot this rule applies to.
### Analyze conversations
Turn **Tag conversations that match this condition** on to apply this tag when the condition matches.
### Email notifications
Turn **Send an email when this condition matches a conversation** on to notify one or more addresses when a match occurs. Add the recipient email(s) in the field provided.
Save your changes with the action at the bottom of the panel.
## Using tags with Insights
Tagged conversations feed into **Insights** (for example breakdowns by tag). Define stable tags here, then review volume and trends in [Insights](https://www.askthisguy.com/doc/admin-console/insights).
---
# Agent evaluation
URL: https://www.askthisguy.com/en/doc/admin-console/agent-evaluation/
Language: en
Section: Documentation
## What is Agent Evaluation?
**Agent Evaluation** helps you test how your agent responds to a large set of questions.
**Use it for:**
- Quality assurance before launching your agent
- Identifying areas where your agent needs improvement
- Regression testing after making changes to your knowledge base
- Benchmarking agent performance over time

## Getting Started
### 1. Select an Agent
Choose which agent you want to evaluate from the **Agent** dropdown at the top of the page.
### 2. Choose Test Language
Select the language for your test questions:
- **EN** - English
- **FR** - French
Your set of questions in english and in french are separate and the agent will respond in the same language as the question.
## Adding Questions
You can:
- type your questions manually
- import a file of questions
- ask the platform to generate questions for you
### Uploading Questions
**Supported formats:** CSV or TXT files
1. Click **Upload Questions**
2. Select a `.csv` or `.txt` file from your computer
3. Questions should be one per line/row
4. For CSV files, use only the first column (delete any extra columns)
5. If your question already exists in your set it will simply not be added so you don't have duplicates
**Important notes:**
- Maximum 50 questions per test run
- If uploading from spreadsheet software (Excel, Numbers), export as CSV first
- Files are automatically saved to your question set
### Option B: Generate Questions
Let the system automatically generate questions from your agent's knowledge base:
1. Click **Generate Questions**
2. Choose the number of questions (5-50)
3. Select content types to include (documents, files, web sources)
4. Review the generated questions
5. Select which ones to keep and click **Add Selected**
To give you a complete picture of your agent's performance, the evaluation feature generates a mix of relevant and off-topic questions. This helps you see how well your agent handles queries that fall outside its intended scope.
**Time Saver:** Generate questions automatically to get started quickly, then refine your test set based on real-world usage patterns.
## Managing Your Question Set
Once you have questions loaded, you can:
- **Select/deselect** questions using checkboxes (only selected questions will run)
- **Edit** question text by clicking on it
- **Delete** questions you don't need
- **Add** new questions manually using the "+ Add Question" button
### Download Questions
Export your questions as a CSV file using the **Download Questions** button. Useful for:
- Backing up your question set
- Sharing with team members
- Editing in bulk using a spreadsheet
## Running Tests
### Start a Test
1. Ensure you have questions selected (checkboxes checked)
2. Click the **Run Test** button
3. Watch real-time progress as each question is answered
4. Results appear one by one as they complete
**Maximum:** 50 questions per run
You can only run one evaluation at a time for a specific agent across your organisation.
### During Test Execution
You'll see:
- **Progress bar** showing completion status
- **Live results** appearing as each question finishes
- **Execution time** for each response
- **Success/failure** indicators
### Stop a Running Test
If you need to stop a test before completion:
1. Click the **Stop** button in the progress area
2. Wait for the system to safely stop processing
3. Partial results will be preserved
## Understanding Results
### For Each Question-Response Pair
Click any question to expand and view:
**Response Details:**
- Full agent response (with markdown formatting)
- Execution time (how long it took to generate)
- Tools used (search, document retrieval, etc.)
- Sources cited (documents or web pages)
**Feedback Options:**
- **Thumbs up** - Good response
- **Thumbs down** - Problematic response (add details about why)
### Feedback Details
When you mark a response as negative, you can add specific notes:
- What was wrong with the response
- What you expected instead
- Any patterns you notice
This feedback helps you identify:
- Knowledge gaps in your agent
- Questions that need better training data
- Common failure patterns
### Export Results
Download test results as CSV using the **Download Results** button.
The export includes:
- Question text
- Agent response
- Success/failure status
- Execution time
- Error messages (if any)
- Feedback ratings
## History Tab
### View Past Test Runs
Switch to the **History** tab to see all previous evaluations:
**Run List View:**
- Date and time of each run
- Status (Completed, Stopped, In Progress, Error)
- Total questions tested
- Success/failure counts
**Run Details View:**
1. Click any run to see detailed results
2. Expand individual question-response pairs
3. Add feedback to past responses
4. Export specific run results as CSV
### Pagination
- **Runs list:** 10 runs per page
- **Run details:** 50 results per page
Use the pagination controls at the bottom to navigate through larger result sets.
## Best Practices
### Creating Effective Question Sets
- Cover different topics from your knowledge base
- Include edge cases and tricky questions
- Mix simple and complex questions
- Test common user queries
### Regular Testing Schedule
Consider running evaluations:
- Before major releases or updates
- After adding new content to knowledge base
- When users report issues with specific topics
- Monthly for quality monitoring
**Iterate:** Start with a small set (10-15 questions), refine based on results, then expand. Run the same questions periodically to track improvements over time!
## Troubleshooting
### "Maximum of 50 questions reached"
You've selected too many questions. Uncheck some questions or split into multiple test runs.
### "Test already running"
Another test is in progress. Wait for it to complete or stop it first.
### File Upload Errors
**"Invalid file type"**
- Use only `.csv` or `.txt` files
- If using spreadsheet software, export as CSV
**"Multiple columns detected"**
- Delete all columns except the first (questions) column
- Or save as plain text (.txt) with one question per line
**"No questions found"**
- Check that your file isn't empty
- Ensure each row contains text
### Cannot See Results
If a test is running but you don't see results:
1. Check the **History** tab
2. Look for the in-progress run
3. Click **Reconnect** to resume viewing live results
## Limits and Constraints
- **Max questions per run:** 50
- **Max questions stored:** 100 per agent
- **File size:** Reasonable CSV/TXT files only
- **Concurrent runs:** One test per agent at a time
**Remember:** Agent evaluation is an ongoing process, not a one-time task. Regular testing helps you maintain high-quality AI interactions as your knowledge base grows and user needs evolve!
---
# Insights
URL: https://www.askthisguy.com/en/doc/admin-console/insights/
Language: en
Section: Documentation
**Insights** is the analytics area of the Admin Console. It helps you understand how assistants are used, how users feel about the experience, and where attention may be needed—using the same filters across metrics and charts.
## Filters
At the top of the page you can narrow what the dashboard shows:
- **Agents** — Select one or more agents. Only conversations handled by the chosen agents are included.
- **Time presets** — Quick ranges: **7 days**, **30 days**, or **90 days**.
- **Custom range** — Set a **from** and **to** date to analyze any period you need.
- **Comparison period** — The dashboard compares the selected range to the **previous period of the same length** (for example, if you pick a 7-day window, metrics are compared to the 7 days immediately before). The comparison dates are shown next to the filters so you always know what “previous” means.
## Summary metrics
The top row summarizes key indicators for the selected period, each with a **change versus the previous period** (percentage or percentage points, depending on the metric):
- **Conversations** — Total number of conversations in the range.
- **Messages per conversation** — Average number of messages per conversation (a simple proxy for depth of engagement).
- **Sentiments** — Share of conversations classified with **positive** and **negative** sentiment (auto-detected by AI).
- **Reactions** — Share of conversations where users left a **thumbs up** or **thumbs down** on the assistant’s reply, including change versus the previous period.
These cards give you a quick health check before you dive into trends and breakdowns.
## Charts and breakdowns
Below the summary, the dashboard visualizes the same period with several views (exact layout may vary as the product evolves):
- **Trend over time** — Typically a line chart for **daily conversation volume**, and/or trends that split volume by **sentiment** (for example positive vs. negative) so you can spot spikes or shifts on specific days.
- **By tag** — Horizontal charts that show how conversations **relate to tags** (for example volume per tag, or a **positive / neutral / negative** split per tag). Tags reflect how conversations were categorized in your workspace (for example topics such as onboarding or billing).
- **By agent** — Similar breakdowns **per agent**, so you can compare workload and sentiment across assistants (for example customer success vs. product specialist).
Tooltips on the charts help you read exact counts or percentages.
## How to use Insights
- **Operational monitoring** — Watch conversation volume and reactions after a launch, a campaign, or a change in agent instructions.
- **Quality and sentiment** — Track sentiment and thumbs up/down over time to see whether users are satisfied and where friction appears.
- **Prioritization** — Use tag and agent breakdowns to see which areas drive volume or negative signal, and pair that with configuration or knowledge updates elsewhere in the Admin Console.
Insights is read-only: it does not change agents or content; use it to decide **where** to act next.
---
# Confluence
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide/
Language: en
Section: Documentation
**Looking for connector capabilities?** This page provides step-by-step configuration instructions. For an overview of the Confluence connector and its features, visit the [Confluence Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/confluence-connector) page.
*Approximate time to complete: 5-7 minutes, excluding prerequisite*
## Before you begin
To connect your Confluence space(s) to ATG, you will need to follow the steps below:
[1. Create API Token on Atlassian Account](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide) : An Atlassian Administrator account is required.
[2. Setup the Confluence Connector in ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide): An ATG Administrator account is required.
## 1. Create API Token on Atlassian Account
### Navigate to your [Atlassian account](https://id.atlassian.com/manage-profile/security/api-tokens) dedicated page

### Click on *Create API token*

### Enter a name for your key

### Enter an expiration date

You cannot set an expiration date longer than a year. Note that when the key expires, you will need to generate a new one and update the configuration of your connector. We recommend you add a reminder so you don't forget.
### Click on *Create*

### Copy your key

Please save this API token in a secure tool, such as a password manager.
If you do not save the token at this stage, it cannot be recovered later. You will need to generate a new one.
### Click on *Done*


You see your new token appear in the table
## 2. Setup the Confluence Connector in ATG
### Go back to your ATG Administrator Console

Enter the Domain name (e.g. ***yourcompany***.atlassian.net)
Enter your email address (the one with wich the API key was created on Atlassian)
Enter the API token previously generated
Click on “Validate”
### Add one or several Sources from Confluence
### Click on "Add source"

### Select the spaces you want to include in the import

### Click on Next

### Configure the document filters

Click on **"Next"**
### Chose your source name and Save configuration

### Check the documents
Once all the documents are processed (it can take a few minutes depending on the number of documents to process), they will be listed in the source

## API key modification and update
When your token expires, you will need to create a new token and update your Connector setup
---
# Confluence Connector
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/confluence-connector/
Language: en
Section: Documentation
**Looking to set up this connector?** This page provides an overview of the Confluence connector and its capabilities. For step-by-step configuration instructions, visit the [Confluence Conf Guide](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide).
## Connect Your Confluence Knowledge Base to ATG
The **Confluence Connector** seamlessly syncs your organization's documentation from **Confluence Cloud** into ATG, making your team's collective knowledge instantly accessible through AI-powered search and chat.
### What Gets Synced?
The connector can import content from:
- **Collaboration Spaces** - Team spaces where your organization creates and shares documentation
- **Personal Spaces** - Individual spaces for personal notes and content
You maintain **full control** over what gets imported with powerful filtering options.
### Comprehensive Content Processing
When syncing Confluence pages, ATG processes **both text and images** within your articles, ensuring complete knowledge capture. This multimodal approach means your AI assistant can understand and reference visual content alongside written documentation.
Learn more about how ATG handles images and visual content: [How Documents & Images are Processed by ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
### Flexible Filtering Options
Once connected, you can customize exactly what content ATG imports:
- **Select specific Spaces** - Choose which Collaboration or Personal Spaces to sync
- **Date filters** - Import only documents updated before a specific date, after a specific date, or between two dates
- **Include/Exclude folders and files** - Specify particular folders or files to include or exclude
- **Label-based filtering** - Use Confluence [labels](https://support.atlassian.com/confluence-cloud/docs/use-labels-to-organize-your-content/) to include or exclude content based on your organization's taxonomy
This ensures ATG only processes the content that's relevant to your team, keeping your knowledge base focused and efficient.
### Automatic Updates
After the initial sync, the connector refreshes on the **frequency set for the source**. New sources are set to **Daily**, and an administrator can switch them to Manual, Weekly, or Monthly, or run a refresh on demand, so your AI assistant has access to the latest versions of your documentation. See [Refresh frequency](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#refresh-frequency).
### Ready to Get Started?
Head over to the [Confluence Conf Guide](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide) for detailed setup instructions.
---
# Users
URL: https://www.askthisguy.com/en/doc/admin-console/users-management/
Language: en
Section: Documentation
The **Users** area lets administrators invite members, manage administrator privileges, and choose which Webapp agents each person can use.
## Invite and onboard users
New users join an ATG organization by administrator invitation. They receive a validation email and complete the onboarding steps to activate their account.
After activation, give the user access to the Webapp agents required for their role. A user needs at least one active, accessible Webapp agent to start a conversation.
## Understand the access model
ATG separates two types of permission:
- **Administrator access**: allows a user to manage users, agents, and organization settings.
- **Agent access**: determines which Webapp agents the user can see and select in a new conversation.
Knowledge categories are **not assigned to users**. Categories are configured on agents. When a user can access an agent, they can use the knowledge and tools configured for that agent.
## Manage access from a user profile
Open a user from the list, then use **Agent Access** to select the agents available to that person. You can select all agents or choose them individually.
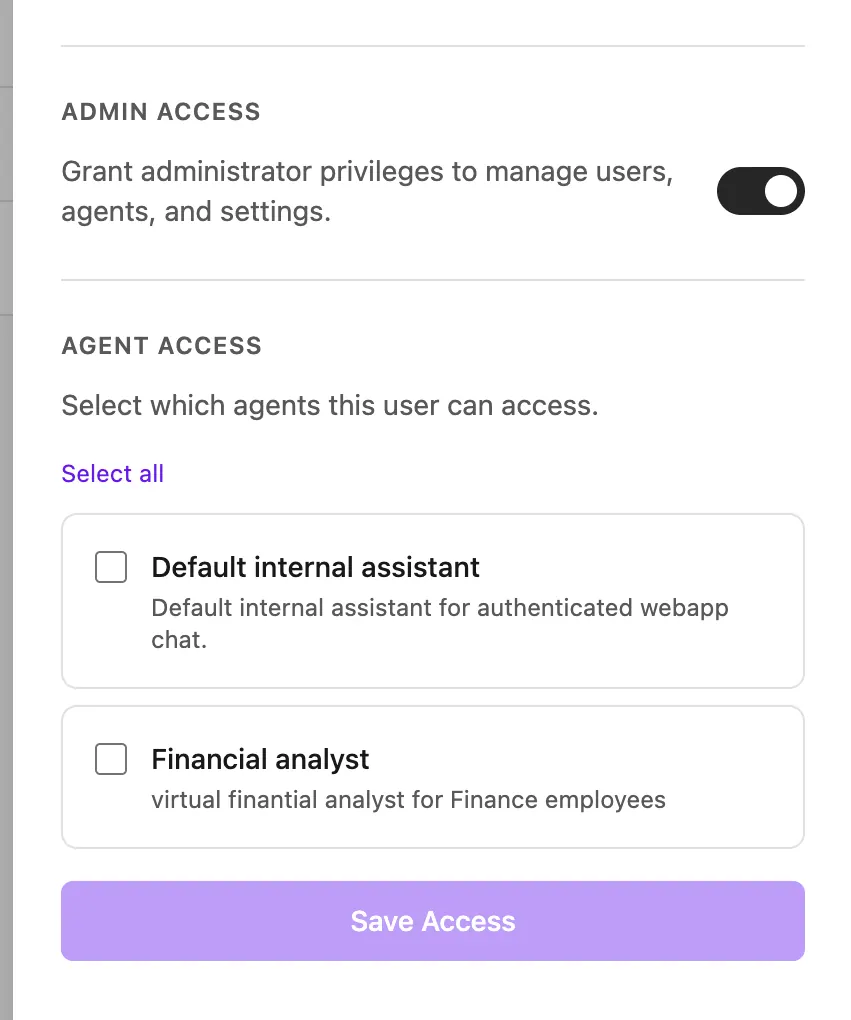 Save the changes when the selection is complete. Only active Webapp agents assigned to the user appear in their agent selector.
## Manage access from an agent
You can manage the same relationship from the agent's **Access** tab:
- **Open to all** makes the agent available to every user in the organization.
- **Restricted** makes the agent available only to selected users.
Changes made from a user profile and changes made from an agent update the same access rules. See [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents).
## Administrator privileges
Enable **Admin Access** only for people who need to manage the organization. Standard users can use their assigned Webapp agents but cannot change administrative settings.
Administrator privileges and agent access are independent. An administrator can still have a limited set of Webapp agents for normal conversations.
## Best practices
- **Apply least privilege**: give each user only the agents required for their work.
- **Use specialized agents**: separate confidential or role-specific knowledge behind dedicated agents.
- **Review access regularly**: remove agents that are no longer relevant to a user's responsibilities.
- **Handle onboarding and offboarding promptly**: update agent access when someone joins, changes role, or leaves.
- **Limit administrator access**: reserve it for people who manage the workspace.
## Example
For an organization with HR, Finance, and Engineering teams:
- create a Finance agent with finance knowledge and tools, then restrict it to the Finance team;
- create an HR agent with HR knowledge, then restrict it to authorized HR users;
- keep a general internal agent open to everyone for company-wide use cases.
This model protects specialized knowledge by controlling access to the agents that can use it.
---
# Google Drive
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide/
Language: en
Section: Documentation
**Looking for connector capabilities?** This page provides step-by-step configuration instructions. For an overview of the Google Drive connector and its features, visit the [Google Drive Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/google-drive-connector) page.
*Approximate time to complete: 5-10 minutes, excluding prerequisites*
## Before you begin
The actions below can only be performed by your GCP Workspace Administrators. Ensure you have access to a GCP Administrator account of your Organization.
To connect ATG to Google Drive, you will need to:
- [1. Enable the Google Drive API](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#1-enable-the-google-drive-api): this will allow your GCP Service Account to use Google Drive.
- [2. Setup the Service account in your GCP Cloud Console](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#2-setup-the-service-account-in-your-gcp-cloud-console): this will create a Service Account linked to your Google Drive.
- [3. Create keys for the Service account](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#3-create-keys-for-the-service-account): this will allow you to create a key for your service account, and generate a JSON file you can export to ATG.
- [4. Share content to ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#4-share-content-to-atg): this will allow you to choose which drive(s) and content you authorize ATG to have access to.
- [5. Connect Google Drive in ATG](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide#5-connect-google-drive-in-atg): this will allow you to setup the connector and chose which folders will be accessible to ATG users.
## **1. Enable the Google Drive API**
### Navigate to Google Cloud Console
Go to [https://console.cloud.google.com/](https://console.cloud.google.com/)
### Go to Enabled APIs & services section
Open the navigation menu:

Select API & Services, then "Enabled APIs & services":

### Select a Project
Click on 'Select a project' button:

If no project was previously created, click on ‘Create project’:

### Create your Project (if not done before)
Enter a project name, select your organization, and choose a location for your project. Then click on 'Create':

### Open "APIs & Services"
Click on 'Enabled APIs and services' on the left menu:

### Enable APIs and services
Click on the '+ Enable APIs and services' button:

### Search for Google Drive API
Type 'google drive' in the search bar and press Enter, select 'google drive api' from the list of results:

Select Google Drive API:

### Enable Google Drive API
Click on the 'Enable' button to activate the Google Drive API:

## **2. Setup the Service account in your GCP Cloud Console**
### Navigate to Google Cloud Console
Come back to the 'Open API & services' section in the navigation menu and click on "Credentials":

### Create Credentials
Click on the '+ Create credentials' button:

Select ‘Service account’:

Create the service account.
Enter a Service account name and (optionally) Service account description:

Click on 'Create' and continue:

Choose the role to grant access to the service account, click ‘Select a role’.

You can choose 'Viewer' role to grant read-only access to the service account.

Finish Creating Service account, clicking on 'Done' button.

## 3. Create keys for the Service account
### Select your Service account
Go to the ‘Credentials’ section within the ‘APIs & Services’ menu, and click on the Service account created previously.

### Go to Keys
Click on ‘Keys’ menu:

### Create new key
The Key section appears empty because no keys have been created yet. Click on ‘Add key’ and choose ‘Create new key’.

### Choose JSON and Create
Select the key type JSON and then click on ‘Create’.

Then **save the JSON key:**

A message will appear indicating that the key was saved. Click ‘Close’.
This key allows to access your Google Drive. **It is secret**. Please don't share it with anyone, and don’t include it in public code repositories.
Store them in secure ways following [Google best practices](https://docs.cloud.google.com/iam/docs/best-practices-for-managing-service-account-keys)
### In case you encounter an error message during the key creation
If you get the following error message:

You will need to update the Organization policies.
For this, your account should have the Administrator rights.
Go to Organization Policies and search for `iam.disableServiceAccountKeyCreation` and disable it at the project level (or at the organization level if the project inherits the rules from the organizations)

## 4. Share content to ATG
By default, ATG will not have any access to your Google Drive. You will need first to share the content you want to import to ATG.
You can now share any Google Drive content you want to ATG: Drives, folders, files, etc. just like you usually do.
Generally speaking, as a good security practice, do not share more than what is needed to any external system.
Do not worry: the fact that content to ATG does not mean it will give it access to any organization’s user. You can configure the access in ATG directly (see later in the document).
First, you have to find the email address associated to your service account, you can find it in the Service account details or in the JSON file you saved earlier.
It should look like this: [`atg@master-puppets-493931-f4.iam.gserviceaccount.com`](mailto:atg@master-puppets-493931-f4.iam.gserviceaccount.com) for example.
Then you can share any content to this email address (Reader access is enough):

## 5. Connect Google Drive in ATG
### Go the the Connectors Menu in ATG Administrator Console
Go to [the Connectors menu](https://app.askthisguy.com/admin/knowledge?tab=connectors):

Click on 'Add connector', select 'Google Drive':

Upload the JSON file with the credentials, that was previously generated:

Google Drive connector is now added to ATG:

The Google Drive connector is successfully added to ATG!
To add a source, go to [the Sources menu](https://app.askthisguy.com/admin/knowledge?tab=sources), and add a source (Google Drive Connector is now available in the list):

---
# Connectors
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/
Language: en
Section: Documentation
**ATG Connectors** automate the process of importing and keeping your organization's knowledge up to date. Instead of manually uploading files one by one, connectors integrate directly with your existing tools - like **Google Drive**, **Confluence**, or **Slack** - to sync documents automatically.
Each connector can be configured with **specific parameters** to control exactly what gets imported (e.g., specific folders, date ranges, or content types). Once set up, connectors can **refresh automatically** or on demand, ensuring your AI assistant always has access to the latest information.
**Custom Connectors:** Need to connect to a tool that's not listed below? That's where ATG's real value shines. **We can build custom connectors tailored to your specific needs** - whether it's a proprietary system, a niche platform, or a unique integration requirement. Reach out to discuss your use case.
## Available Connectors
Learn about each connector and what it can do:
**Cloud Storage**
[Google Drive Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/google-drive-connector)
[SharePoint & OneDrive Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/sharepoint-onedrive-connector)
[FTP Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/ftp-connector)
**Documentation & Communication Tools**
[Confluence Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/confluence-connector)
[Notion Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/notion-connector)
[Slack Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/slack-connector)
**Files**
[File Upload](https://www.askthisguy.com/doc/admin-console/knowledge-management/file-upload)
**Web sites**
[Web Sites](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/web-sites-connector)
**Custom Connectors:** Need to integrate with a tool not listed here? We can build custom connectors tailored to your organization's specific needs - whether it's a proprietary system, an internal database, or any other platform your team relies on. Contact us to discuss your requirements.
## Refresh frequency
The **refresh frequency** sets how often ATG updates the content imported from a source. It is configured per source, and only organization administrators can change it.
At each refresh, ATG detects the files added, modified, and deleted since the previous run, and only reprocesses what is needed.
1. In the Admin Console, open **Knowledge**, then the **Sources** tab.
2. Find the source to configure and select **Edit**.
3. In the **Refresh frequency** field, choose **Manual**, **Daily**, **Weekly**, or **Monthly**.
4. Select **Save Changes**.
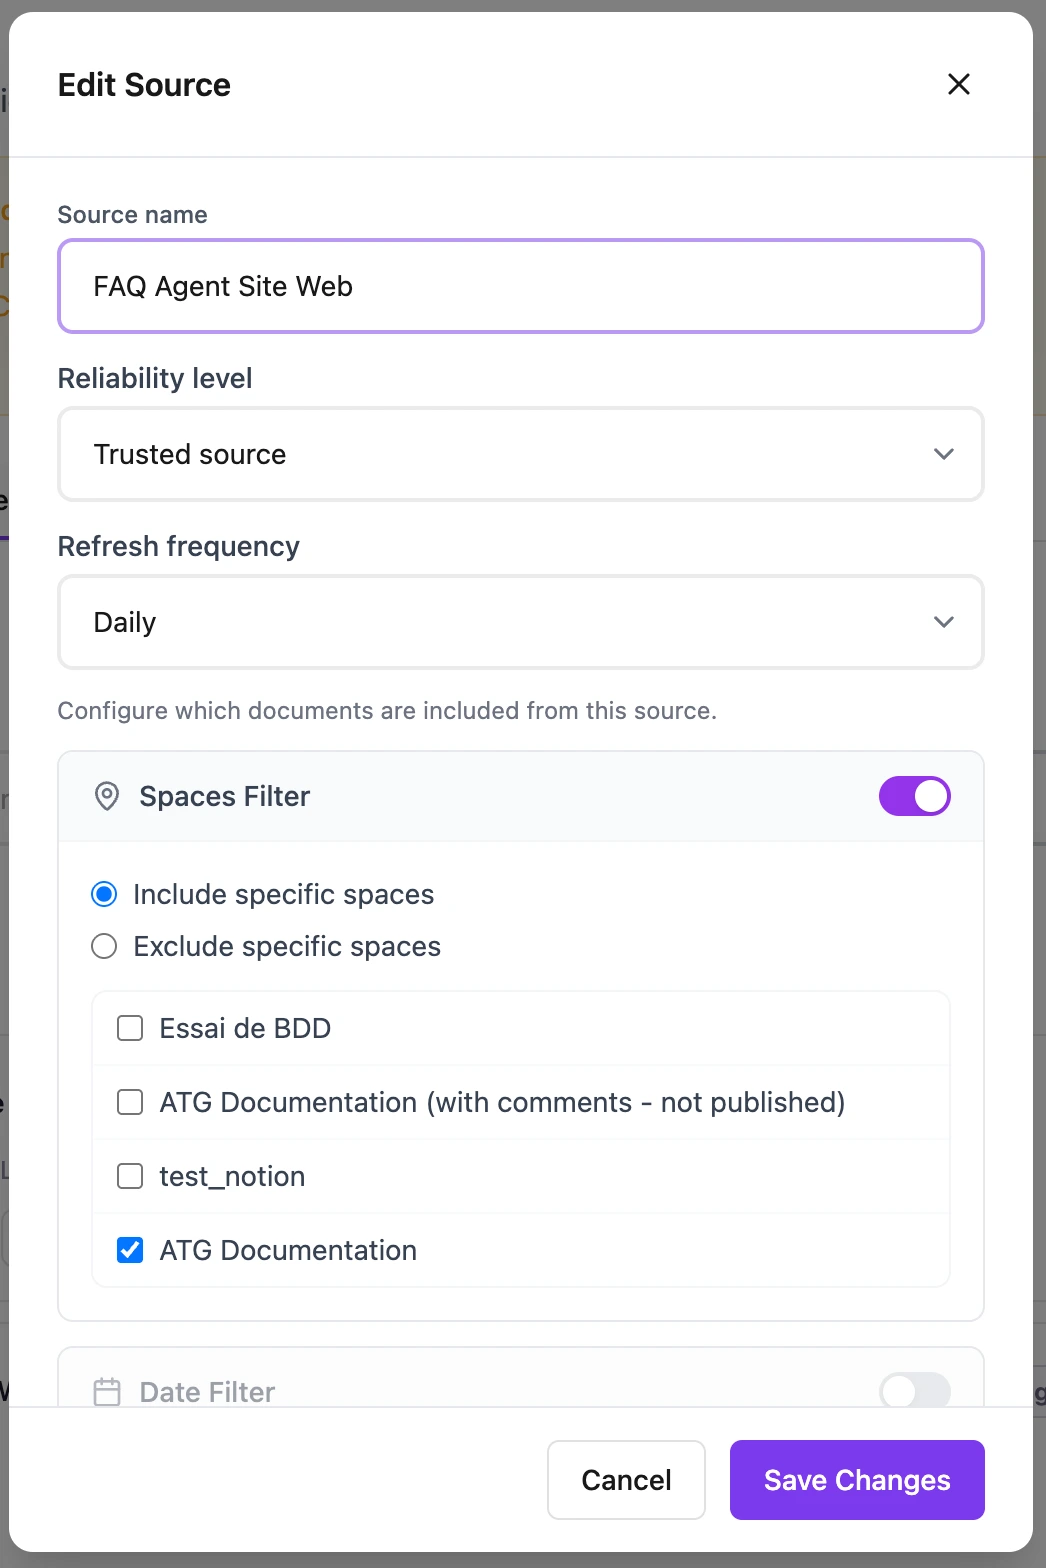 The selected frequency appears on the source's row, next to its last processing date. On **Manual**, no automatic refresh runs: use **Refresh** on the source whenever you need an update.
On creation, sources using the Google Drive, Confluence, Notion, Slack, SharePoint, and FTP/SFTP connectors are set to **Daily**, and web site sources to **Weekly**.
### What to keep in mind
- Saving a new frequency does not restart importing. The new rhythm applies to the next runs of the scheduler.
- An automatic refresh can be postponed if the source was processed too recently, or if another job is already running on it.
- You cannot pick a specific time, a specific day, or a custom frequency.
- A source being updated is shown as **refreshing** in the list. If it fails, read the message attached to the source, then run a manual refresh once the situation is fixed.
## Configuration Guides
Step-by-step instructions for setting up each connector in your organization:
[Google Drive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide)
[SharePoint & OneDrive](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/sharepoint-onedrive-conf-guide)
[Confluence](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/confluence-conf-guide)
[Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide)
[Notion](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/notion-conf-guide)
---
# Admin Console
URL: https://www.askthisguy.com/en/doc/admin-console/
Language: en
Section: Documentation
The **Admin Console** is your command center for managing your ATG environment! Configure AI agents, organize knowledge, manage tools, and control user access - all in one place.
**Customize your organization's ATG experience with ease.** Set up team members, define permissions, connect data sources, and curate AI knowledge using intuitive tools designed for efficiency.

Explore the sub-pages below for step-by-step guides on AI policies, data processing, user management, and more. Everything you need to master your administrative superpowers!
**Organization**
- [Organization](https://www.askthisguy.com/doc/admin-console/organization-settings)
**Console menus**
- [Knowledge](https://www.askthisguy.com/doc/admin-console/knowledge-management)
- [Tools and MCP](https://www.askthisguy.com/doc/admin-console/tools-management)
- [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents)
- [Tags & Alerts](https://www.askthisguy.com/doc/admin-console/tags-alerts)
- [Agent evaluation](https://www.askthisguy.com/doc/admin-console/agent-evaluation)
- [Insights](https://www.askthisguy.com/doc/admin-console/insights)
- [Users](https://www.askthisguy.com/doc/admin-console/users-management)
**Infrastructure & Security**
- [Infrastructure & Security](https://www.askthisguy.com/doc/infrastructure-and-security)
## Ready to dive-in?
Access the Admin Console at [https://app.askthisguy.com/admin/](https://app.askthisguy.com/admin) and explore the features below!
---
# Google Drive Connector
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/google-drive-connector/
Language: en
Section: Documentation
**Looking to set up this connector?** This page provides an overview of the Google Drive connector and its capabilities. For step-by-step configuration instructions, visit the [Google Drive Conf Guide](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide).
## Connect Your Google Workspace to ATG
The **Google Drive Connector** seamlessly syncs your organization's documents from **Google Workspace** (Enterprise) into ATG, making your team's knowledge instantly accessible through AI-powered search and chat.
**Note:** This connector works exclusively with **Google Workspace** (formerly G Suite) accounts. Consumer Google Drive accounts are not supported.
### What Gets Synced?
The connector can import documents from:
- **Shared Drives** - Team drives accessible to your organization
- **Shared Folders** - Individual folders shared from collaborators' Google Drives
You maintain **full control** over what gets imported with powerful filtering options.
### Flexible Filtering Options
Once connected, you can customize exactly what content ATG imports:
- **Select specific Drives** - Choose which Shared Drives or folders to sync
- **Date filters** - Import only documents updated before a specific date, after a specific date, or between two dates
- **Include/Exclude rules** - Specify particular folders or files to include or exclude
This ensures ATG only processes the content that's relevant to your team, keeping your knowledge base focused and efficient.
### Automatic Updates
After the initial sync, the connector refreshes on the **frequency set for the source**. New sources are set to **Daily**, and an administrator can switch them to Manual, Weekly, or Monthly, or run a refresh on demand, so your AI assistant has access to the latest versions of your documents. See [Refresh frequency](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#refresh-frequency).
### Supported File Types
The Google Drive connector handles a **comprehensive range** of file formats:
**Native Google Workspace files:**
- Google Docs
- Google Slides
- Google Drawings
**Standard document formats:**
- PDF (.pdf)
- Word documents (.docx)
- PowerPoint presentations (.pptx)
- HTML files (.html)
- Markdown (.md)
- Plain text (.txt)
- Rich Text Format (.rtf)
**Images:**
- PNG (.png)
- JPEG (.jpg)
**Custom file types (Excel for example):**
- [Tailored Processing](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) - ATG can be customized to handle your organization's unique file formats with specialized processing rules.
### Ready to Get Started?
Head over to the [Google Drive Conf Guide](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/google-drive-conf-guide) for detailed setup instructions.
---
# File Upload
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/file-upload/
Language: en
Section: Documentation
## Upload Your Documents Directly to ATG
**File Upload** provides the simplest way to get your organization's documents into ATG: just **drag, drop, and done**. Upload files through the Admin Console and assign them to specific knowledge categories.
### Perfect for Quick Knowledge Sharing
This is ideal when you need to:
- **Make documents available** to agents that use the selected knowledge category
- **Add one-off files** without setting up a full integration
- **Test content** before connecting larger document repositories
- **Upload files** that live outside your cloud storage systems
After processing, the files become available to agents that have both the selected category and the Knowledge Base Search tool enabled. Users cannot receive direct access to a knowledge category.
### Supported File Formats
File Upload processes a **comprehensive range** of document formats:
**Standard formats:**
- PDF documents (.pdf)
- Plain text (.txt)
- Markdown (.md)
- HTML files (.html)
**Office documents:**
- Word documents (.docx)
- PowerPoint presentations (.pptx)
All uploaded files are processed with **both text and image extraction**, ensuring complete content capture for your AI assistant.
Learn more about how ATG handles images and visual content: [Documents & Images](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
**Custom file types:**
- [Tailored Processing](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) - ATG can be customized to handle your organization's unique file formats with specialized processing rules.
### How to upload files
Adding files to ATG is incredibly simple:
1. **Open the Admin Console** and navigate to the **Knowledge** section
2. **Select a knowledge category** where you want to add files
3. **Drag and drop your files** into the interface, or click to browse and select them
4. **Done!** Your files are automatically processed and ready to use
No complex configuration or authentication setup is required.
### Automatic Processing
Once uploaded, your files are automatically:
- **Extracted**: text and images are processed for complete content understanding
- **Indexed**: the content becomes searchable in ATG's knowledge base
- **Categorized**: the content is organized within your chosen knowledge category
After processing, agents that have the selected category and the Knowledge Base Search tool can retrieve the uploaded documents.
### Best Practices
- **Organize by category**: upload related documents to the same knowledge category for better context
- **Keep files updated**: upload newer versions when your documents change
- **Use descriptive filenames**: clear names help users and agents understand document content
---
# Notion
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/conf-guides/notion-conf-guide/
Language: en
Section: Documentation
**Looking for connector capabilities?** This page provides step-by-step configuration instructions. For an overview of the Notion connector and its features, visit the [Notion Connector](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/notion-connector) page.
*Approximate time to complete: 3-5 minutes*
## Before you begin
To connect ATG to Notion, you will need:
- A **Notion workspace** where you have permission to create integrations and manage page connections
- An **ATG Administrator** account to configure the connector in the [Admin Console](https://app.askthisguy.com/admin/knowledge?tab=connectors)
The setup involves four steps:
- [1. Create a Notion connection](#1-create-a-notion-connection)
- [2. Configure permissions and copy the access token](#2-configure-permissions-and-copy-the-access-token)
- [3. Grant access to your Notion content](#3-grant-access-to-your-notion-content)
- [4. Connect Notion in ATG](#4-connect-notion-in-atg)
## 1. Create a Notion connection
### Open the Notion Developer portal
Go to the [Notion Developer portal](https://www.notion.so/developers/connections) and open the **Connections** page.
Click **+ New connection** to create a new integration.
### Create the connection
In the **New connection** dialog:
- Enter a **Connection name** (for example, `Ask This Guy` or `ATG`)
- Select **Access token** as the authentication method. This is the workspace-scoped token ATG uses to read your content.
- Choose the **workspace** where the connection will be installed
Click **Create connection**.
## 2. Configure permissions and copy the access token
After creation, you are redirected to the connection configuration page.
Under **Capabilities**, enable the permissions ATG needs:
| Capability | Required |
|---|---|
| **Read content** | Yes. Allows ATG to import pages and databases. |
| **Read user information including email addresses** | Yes. Allows ATG to attribute content to the right users. |
| Update content | No |
| Insert content | No |
| Read / Insert comments | No |
| **Concept** | **What It Means** | **Example** |
|---|---|---|
| RAG | LLM + real-time search for grounded answers | Librarian with access to all resources |
| Embeddings | Mathematical fingerprints of text meaning | Unique ID for every book in a library |
| Vector database | Stores and organizes embeddings for fast retrieval | Library catalog for quick searching |
| Semantic Search | Finds meaning, not just words | Librarian who "gets" what you mean |
| Keyword Search | Finds exact word matches | Searching by book title |
| Chunking | Breaks large texts into smaller, meaningful pieces | Dividing a book into chapters |
| Prompt engineering | Designing how info is presented to the LLM | Giving the librarian a clear question |
| Updating external data | Refreshing sources and embeddings regularly | Updating the library with new books |
| Source attribution | Providing references for answers | Footnotes in a research paper |
| [**channels:history](https://api.slack.com/scopes/channels:history)** | View messages and other content in a user’s public channels |
|---|---|
| [**channels:read**](https://api.slack.com/scopes/channels:read) | View basic information about public channels in a workspace |
| [**files:read**](https://api.slack.com/scopes/files:read) | View files shared in channels and conversations that a user has access to |
| [**users:read**](https://api.slack.com/scopes/users:read) | View people in a workspace |
## Connect remote file servers to ATG
The **FTP Connector** syncs documents from your organization’s **FTP**, **FTPS**, or **SFTP** servers into ATG, so your team can search and chat over that content with the same experience as other knowledge sources.
### Supported protocols
- **FTP** — classic file transfer
- **FTPS** — FTP over TLS
- **SFTP** — SSH file transfer
### What gets synced?
The connector imports files from the **remote paths** you configure on the server (folders and subfolders you allow). You stay in control of scope through the filtering options below.
### Filtering options
You can narrow exactly what ATG imports:
- **Include / exclude rules** — Target specific folders or files to include or leave out
- **File modification date** — Import only files updated before a date, after a date, or between two dates
### Supported file types
The connector handles a **wide range** of formats:
**Documents**
- Markdown (.md)
- PDF (.pdf)
- Plain text (.txt)
- Rich Text Format (.rtf)
- HTML (.html)
**Microsoft Office**
- Word (.docx)
- PowerPoint (.pptx)
**Images**
- PNG (.png)
- JPEG (.jpg)
**Other formats**
- [Tailored Processing](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) — ATG can be customized for additional file types your organization needs.
### Keeping content up to date
After the initial sync, the connector refreshes on the **frequency set for the source**. New sources are set to **Daily**, and an administrator can switch them to Manual, Weekly, or Monthly, or run a refresh on demand, so your knowledge base stays aligned with the server. See [Refresh frequency](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#refresh-frequency).
---
# Slack Connector
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/slack-connector/
Language: en
Section: Documentation
**Looking to set up this connector?** This page provides an overview of the Slack connector and its capabilities. For step-by-step configuration instructions, visit the [Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide) page
## Connect Your Slack Workspace to ATG
The **Slack Connector** seamlessly syncs your team's conversations, shared files, and collaborative knowledge from **Slack** into ATG, making your entire Slack history instantly searchable and accessible through AI-powered chat.
### What Gets Synced?
The connector imports content from:
- **Public Channels** - All messages and threads from channels accessible to the connected user
- **User Information** - Team member profiles for proper context and attribution
You maintain **full control** over access through Slack's native permissions - ATG respects your workspace's existing security settings.
### Comprehensive Content Processing
When syncing Slack channels, ATG processes **both messages and attached files**, ensuring complete conversation capture. This means your AI assistant can understand the full context of discussions, including shared documents, images, and collaborative exchanges.
Learn more about how ATG handles images and visual content: [Documents & Images](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg)
### Smart Channel Access
The connector automatically syncs all **public channels** that the connected user has access to, preserving your organization's existing access controls and security boundaries. This ensures team members only access conversations they're authorized to see.
### Automatic Updates
After the initial sync, the connector refreshes on the **frequency set for the source**. New sources are set to **Daily**, and an administrator can switch them to Manual, Weekly, or Monthly, or run a refresh on demand, so your AI assistant has access to the latest messages and shared content from your Slack workspace. See [Refresh frequency](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#refresh-frequency).
### Ready to Get Started?
Head over to the [Slack](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors/conf-guides/slack-conf-guide) for detailed setup instructions.
---
# Web Sites
URL: https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors/web-sites-connector/
Language: en
Section: Documentation
## Import Web Content Into ATG
The **Web Sites Connector** lets you bring **external web content** directly into your organization's knowledge base. By defining a starting URL, ATG will crawl and index the site, making its content searchable and accessible through AI-powered chat.
### How It Works
Simply provide a **URL** to start crawling from, and ATG will:
- **Download web pages** from the specified site or section
- **Track each page individually** - Every page becomes a searchable resource
- **Respect your scope** - Control which parts of the site to include
This is perfect for importing documentation sites, knowledge bases, internal wikis, or any web-based content relevant to your team.
### Control What Gets Imported
You have **full control** over the crawling scope:
- **Define the starting URL** - Choose where the crawler begins
- **Set boundaries** - Import the entire site or just specific sections
- **Filter content** - Specify which pages or paths to include or exclude
### Refresh Frequency
New web site sources are set to a **Weekly** refresh. An administrator can change that frequency, or switch the source to **Manual** to decide exactly when the site is crawled again, keeping control over how often external content is synced. See [Refresh frequency](https://www.askthisguy.com/doc/admin-console/knowledge-management/connectors#refresh-frequency).
### What Gets Indexed?
The connector processes **HTML web pages** and extracts their text content, links, and structure. Each page becomes a distinct, citable resource in your ATG knowledge base.
### Ready to Get Started?
**Quick setup in 4 steps:**
1. In your **Admin Console**, go to **Knowledge** and select a category
2. Click **+ Add** next to **Web Sites**
3. Enter the URL(s) you want to crawl - type manually or select from suggested sites

Select Web Sites screen from the Admin Console
1. Name your source and click **Create**
Your web content will start importing immediately!
---
# ATG Widget
URL: https://www.askthisguy.com/en/doc/atg-embedded/
Language: en
Section: Documentation
**Essential guides:**
- [Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents): Set up and configure your agents in the Admin Console
- [Integrate in your webapp](https://www.askthisguy.com/doc/atg-embedded/how-to-integrate-atg-embedded-in-your-webapp): Embed the widget in your site or app (iframe, modes, JWT)
## Transform Your Platform with AI Agents
The **ATG widget** lets you embed ATG agents into third-party websites, SaaS products, or internal tools without the complexity or cost of building from scratch. Create a **Widget agent** in the Admin Console, configure its knowledge and tools, then integrate that specific agent into your platform.
Whether you're looking to enhance customer support, automate internal workflows, or create intelligent user experiences, the ATG widget makes it fast, flexible, and cost-effective.
## Use Cases: Where AI Agents Shine
### **Public Websites**
Add an intelligent assistant to your institutional or marketing website that:
- **Answers visitor questions** instantly using your website content and knowledge base
- **Guides prospects** through your products and services
- **Captures intent** (e.g., purchase interest, demo requests) and triggers notifications to your sales team
- Works for **non-authenticated users** with zero friction
### **SaaS Applications & Web Apps**
Embed a smart AI copilot directly in your product that:
- **Helps users navigate** complex features and workflows
- **Provides contextual support** based on where users are in your app
- **Executes actions** on behalf of users (e.g., creating records, updating settings, triggering workflows)
- **Personalizes responses** using client-specific data and user context
- Fully **white-labeled** to match your brand
### **Internal Tools & Platforms**
Empower your team with AI agents that:
- **Search across knowledge bases** (Notion, Confluence, Google Drive, SharePoint, Slack, etc.)
- **Answer employee questions** about processes, policies, and documentation
- **Automate repetitive tasks** and information retrieval
- **Integrate with internal systems** to fetch data or trigger actions
## Why Choose the ATG Widget?
### **Fast & Cost-Effective Deployment**
No need to build AI infrastructure from scratch. Our **ready-to-integrate API** requires only minimal front-end and back-end development. Configure your agents with a **no-code admin console** - drastically reducing time-to-market and development costs.
### **Superior AI Quality**
Leverage state-of-the-art **Retrieval Augmented Generation (RAG)** to deliver accurate, relevant answers grounded in your knowledge base. Our system minimizes AI "hallucinations" and ensures trustworthy responses your users can rely on.
### **Effortless Knowledge Management**
Keep your AI's knowledge **automatically up-to-date** by connecting to your existing data sources:
- **Notion**, **Confluence**, **Google Drive**, **SharePoint**, **Slack**
- **Direct file uploads** and **web page crawling**
- **Automatic synchronization** ensures your AI always has the latest information
### **Full Customization & Control**
- **Custom instructions** to shape your agent's personality and behavior
- **Visual branding** to match your platform's look and feel
- **Knowledge categories** for granular control over what each agent can access
- **Custom tools** to interact with your platform (read data, trigger actions, send notifications)
- **Tool approval mechanism** for safe write operations
### **Intent Detection & Automation**
Configure your agents to **recognize user intentions** (e.g., purchase signals, churn risk, support escalation) and **automatically trigger actions** like sending notifications or creating tickets.
## How It Works
1. **Configure Your Knowledge Base**: Connect your data sources through our admin console - no coding required
2. **Create a Widget Agent**: Choose the Widget type, define its instructions, select its knowledge categories and tools, then configure security
3. **Integrate the API**: Add our lightweight API to your platform with minimal front-end and back-end work
4. **Launch & Iterate**: Your AI agents are live and continuously learning from your updated knowledge base
## Extensibility
Need something specific? The ATG widget supports:
- **Custom connectors** for unique data sources
- **Custom tools** tailored to your platform's functionality
- **Flexible API integration** pattern
### Where to go next
[Agents](https://www.askthisguy.com/doc/admin-console/how-to-configure-the-agents)
[Integrate in your webapp](https://www.askthisguy.com/doc/atg-embedded/how-to-integrate-atg-embedded-in-your-webapp)
---
# AI Policy
URL: https://www.askthisguy.com/en/doc/admin-console/organization-settings/choosing-the-right-ai-policy/
Language: en
Section: Documentation
ATG gives you full control over which AI providers can access your data. Behind the scenes, ATG integrates with several leading AI providers, including:
## European Providers
- [**Scaleway**](http://scaleway.com/): French cloud provider hosting open-weight models
- [**Nebius**](https://nebius.com/): European AI infrastructure provider, specialized in AI, hosting open-weight models
- [**Mistral**](https://mistral.ai/): French AI company with their own models (commercial or open-weight)
- [**Black Forest Labs**](https://bfl.ai/): European AI research and development company, building its own model and specialized in image generation
## Worldwide Providers
In addition to all European providers listed above, worldwide policy includes:
- [**Google**](https://gemini.google.com/): US-based provider with Gemini models
- [**Cerebras**](https://www.cerebras.ai/): US-based AI infrastructure provider specialized in ultra-fast inference
- [**Groq**](https://groq.com/): US-based AI infrastructure provider specialized in ultra-fast inference
- [**SambaNova**](https://sambanova.ai/): US-based AI infrastructure provider specialized in ultra-fast inference
- [**OpenAI**](https://openai.com/): US-based provider of GPT models (ChatGPT)
- [**DeepInfra**](https://deepinfra.com/): US-based AI infrastructure provider
## Commercial vs. Open-Weight Models
Providers use different approaches to AI models:
- **Commercial models:** Proprietary models developed and maintained by the provider (e.g., Mistral's models, Google's Gemini, OpenAI's GPT)
- **Open-weight models:** Models with publicly available weights that can be downloaded, inspected, and hosted independently. Providers like Scaleway host these models on their infrastructure, giving you the benefits of open-weight transparency with European hosting.
Open-weight models offer greater transparency since their architecture and parameters are publicly accessible, allowing independent security audits and reducing vendor lock-in.
## Two Privacy Policy Levels
Because protecting your data is our top priority, ATG offers two privacy policy levels:
- **EU Providers Only:** Restricts AI processing to European providers (Scaleway, Nebius, Mistral, Black Forest Labs). This ensures your data remains within EU jurisdiction and is protected by GDPR.
- **Worldwide Providers:** Allows all providers, including US-based companies (OpenAI, Google, DeepInfra) in addition to European providers.
**Important:** Selecting worldwide providers may subject your data to US regulations including the Patriot Act and Cloud Act, which can require US companies to provide data access to US authorities, even for data stored outside the US. Choosing EU-only providers protects you from these regulations.
To configure the AI policy, go to the [Admin console](https://admin.askthisguy.com), select Organization ⇒ Settings ⇒ AI Policy

## European Infrastructure Beyond AI
Regardless of your AI policy choice, all ATG platform infrastructure and data storage (outside of LLM processing) are hosted exclusively by European providers in European data centers. This ensures that your core data remains under EU jurisdiction and GDPR protection at all times.
We recommend choosing the privacy level that best aligns with your organization's data protection requirements and compliance obligations. This flexibility ensures you can balance innovation, compliance, and peace of mind as AI technology evolves.
## Resources
[AI and data privacy: What your company needs to know](https://usercentrics.com/guides/data-privacy/ai-and-data-privacy/)
[Rethinking Privacy in the AI Era: Policy Provocations for a Data-Centric World | Stanford HAI](https://hai.stanford.edu/policy/white-paper-rethinking-privacy-ai-era-policy-provocations-data-centric-world)
[The growing data privacy concerns with AI: What you need to know](https://www.dataguard.com/blog/growing-data-privacy-concerns-ai/)
---
# Predefined Prompts
URL: https://www.askthisguy.com/en/doc/admin-console/organization-settings/predefined-prompts/
Language: en
Section: Documentation
## Standardize AI Interactions Across Your Organization
**Predefined Prompts** let you create **reusable prompt templates** that your entire team can use with just two clicks. Instead of every employee crafting their own prompts from scratch, you define professional, optimized templates once - and everyone benefits from consistent, high-quality AI outputs.
### What Are Predefined Prompts?
Think of Predefined Prompts as **AI interaction blueprints** for your organization. They're pre-configured prompt templates that:
- **Standardize workflows** - Ensure everyone uses best practices when working with AI
- **Save time** - Users insert proven prompts in two clicks instead of writing from scratch
- **Improve quality** - Well-crafted templates produce better, more consistent results
- **Capture expertise** - Codify your organization's knowledge into reusable AI instructions
### Common Use Cases
Organizations use Predefined Prompts for a wide variety of tasks:
**Document classification:**
- Standardize tagging systems across departments
- Apply consistent categorization to files and content
- Automate content organization with predefined taxonomies
**Content creation:**
- Generate product documentation following your style guide
- Draft blog articles with your brand voice
- Create marketing copy that matches your messaging
- Write customer communications with consistent tone
**Data processing:**
- Extract structured information from unstructured documents
- Summarize reports in your organization's preferred format
- Translate content while maintaining technical terminology
**Analysis & research:**
- Analyze feedback with standardized evaluation criteria
- Review documents against specific quality checklists
- Generate insights following your analytical frameworks
### How It Works
**For Administrators (in the Admin Console):**
1. **Create a template** - Write your prompt with clear instructions and any necessary context
2. **Optimize with AI** - Use the built-in AI rewriting feature to automatically enhance your prompt
3. **Publish** - Make the template available to your team
You maintain full control over which prompts are available and can update them anytime.
**AI-Powered Prompt Optimization**
Not sure if your prompt is optimized? ATG includes a **built-in AI rewriting feature** that automatically refines your prompts for maximum effectiveness. Simply write your initial prompt, then click the AI optimization button - ATG will restructure and enhance it using proven prompt engineering best practices. This ensures every Predefined Prompt delivers the **best possible results**, even if you're not a prompt engineering expert.

Prompt configuration example in Admin Console
**For Users (in the web app at [app.askthisguy.com](http://app.askthisguy.com)):**
1. **Browse available prompts** - See all templates configured by your admin team
2. **Select a prompt** - Click to insert it into your conversation
3. **Add specifics** - Fill in any required variables or context
4. **Get results** - ATG processes your request with the optimized template
It takes just **two clicks** to access professional-grade AI prompts.

Prompt selection illustration in ATG's webapp
### Benefits
**For the organization:**
- **Consistency** - Everyone uses proven, high-quality prompts
- **Efficiency** - Reduce time spent crafting and refining prompts
- **Knowledge sharing** - Best practices spread across the team
- **Control** - Administrators ensure AI usage aligns with company standards
**For users:**
- **Speed** - Insert expert-level prompts instantly
- **Learning** - See examples of effective AI interactions
- **Results** - Get better outputs without prompt engineering expertise
- **Simplicity** - Focus on work, not on figuring out how to ask the AI
### Getting Started
Administrators can create and manage Predefined Prompts directly from the **Admin Console**. Start with a few high-impact templates for your most common tasks, then expand your library based on team feedback and usage patterns.
Users will find Predefined Prompts readily available in the ATG web app, making AI assistance as simple as point-and-click.
---
# Press Review
URL: https://www.askthisguy.com/en/doc/admin-console/organization-settings/press-review/
Language: en
Section: Documentation
## Get AI-Powered News Briefings on What Matters to You
**Press Review** delivers **custom news digests** tailored to your organization's interests. Write a brief describing what you want to track, and ATG will automatically search, filter, and compile relevant news on demand.
### What Is Press Review?
Press Review is your **AI news researcher**. Instead of spending hours browsing news sites, define your interests once - then generate fresh, focused briefings whenever you need them.
**Track anything:**
- **Competitors** - Product launches, funding rounds, strategic moves
- **Industry trends** - Regulations, innovations, market shifts
- **Key accounts** - Customer or partner company news
- **Specific topics** - Technologies, markets, geographic regions
- **General themes** - Broad industry developments and patterns
The brief is **completely flexible** - you decide what matters.
### How It Works
**Administrators** configure Press Review in the Admin Console:
1. **Write a brief** - Describe what news to track in plain language (competitors, topics, industries, companies, keywords - whatever matters to you)
2. **Optimize with AI** - Use the built-in AI rewriting feature to enhance your brief for maximum relevance
3. **Publish** - Make it available to your team
**AI-Powered Brief Optimization**
Not sure how to structure your brief? ATG's **built-in AI rewriting feature** automatically refines it for optimal results. Simply write your initial description, then click the AI optimization button - ATG will restructure and enhance your brief using proven techniques, ensuring you get the **most relevant news** every time.

Press review configuration in Admin Console
**Users** generate digests from the web app at [`app.askthisguy.com`](http://app.askthisguy.com):
1. **Select a Press Review** - Choose from configured digests
2. **Generate** - ATG searches the web, filters relevant articles, and compiles a structured briefing
3. **Read insights** - Get a comprehensive, easy-to-scan digest with the latest relevant news

Press review example in ATG's webapp
Each digest is **generated fresh** on demand, so you always get current information.
### Benefits
**Save time** - Minutes instead of hours researching news
**Stay focused** - Only see what's relevant to your business
**Spot opportunities** - Catch competitive moves and market trends early
**Make better decisions** - Base strategy on fresh market intelligence
### Use Cases
- **Competitive intelligence** - Track what your competition is doing
- **Account management** - Monitor customer and prospect news for timely outreach
- **Strategic planning** - Gather market context for leadership discussions
- **Industry awareness** - Stay current on sector developments and regulations
### Getting Started
Administrators can configure Press Review in the **Admin Console**. The more specific your brief, the more relevant your digests will be. But don't worry about perfection - the AI optimization feature helps refine any brief for better results.
Users generate digests anytime from the **ATG web app** - fresh intelligence, on demand.
---
# Webapp
URL: https://www.askthisguy.com/en/doc/webapp/
Language: en
Section: Documentation
The ATG webapp gives authenticated members of your organization access to AI agents configured for their work.
Go to [app.askthisguy.com](https://app.askthisguy.com) and sign in to start a conversation.
## Start a conversation with an agent
Every conversation requires an agent. When you start a new chat:
1. Open **New chat**.
2. Open the agent selector in the message composer.
3. Choose the agent that matches your task.
4. Write your message and send it.
The selector only lists **active Webapp agents that you are allowed to use**. ATG preselects the agent you used most recently.
The selected agent remains attached to the conversation after the first message. Start a new chat to use another agent.
## What the selected agent controls
Your administrator configures each agent with:
- **Instructions**: its role, behavior, tone, and response rules.
- **Knowledge**: the knowledge categories and organizational sources it can search.
- **Tools**: the capabilities it can use, such as knowledge search, web search, document retrieval, image generation, or custom tools.
The agent configuration fully determines which tools are available. The webapp no longer provides buttons for users to enable Organization Knowledge or Web Search. You can describe the result you need, and the agent decides how to answer using only its enabled tools.
If the agent does not have a required tool or knowledge category, start a new conversation with another available agent or contact your administrator.
## Add context to your request
The message composer also lets you:
- **Attach files** for the agent to analyze in the current conversation.
- **Use predefined prompts** created by your organization.
- **Choose the response mode** when this option is available.
Personal attachments are specific to the conversation. They are different from the organization's knowledge sources.
See [Using Attachments](https://www.askthisguy.com/doc/webapp/using-attachments) for supported files and usage details.
## Navigate the webapp
The sidebar gives you access to:
- **New chat**: start a conversation and choose an agent.
- **Prompts**: open the prompt library.
- **Press Reviews**: access configured press review features when available.
- **Conversation history**: reopen previous conversations with their original agent and context.
From your profile menu, you can change language, sign out, and open the Admin Console if you have administrator permissions.
## Share a conversation
Conversation sharing passes an ATG conversation on to colleagues in the same organization, for review, alignment, or handing over a result. Only the conversation owner can start or stop sharing it.
1. Open a conversation from your history.
2. Select **Share** in the conversation header.
3. In the share panel, choose **Share with organization**.
4. Select **Copy link**, then send that link to the people concerned.
 Once sharing is active, the button reads **Shared**. Reopen its menu at any time to copy the link again, or select **Stop sharing** to revoke access.
 ### What the recipient sees
Anyone signed in to ATG, belonging to your organization and holding the link, opens the conversation in a dedicated read-only view. They can read the messages and see who shared the conversation, but they cannot reply, continue the discussion, or modify it. The shared conversation is not added to their history or sidebar.
### Sharing rules
- Sharing covers every authenticated member of your organization. It is neither a per-person share nor a public link.
- The link does not work for someone who is not signed in, for an account without an organization, or for a member of another organization.
- **Stop sharing** revokes access immediately, including for people who already received the link. You can share again later: the same link works again as long as sharing is active.
- A deleted conversation, or one whose sharing has been stopped, is shown as unavailable.
- A link gives access to that single conversation, never to your history or to other conversations in the organization.
Before sharing, check that the conversation can be seen by your whole organization. Stop sharing as soon as that is no longer the case.
## Get better answers
- Choose the agent whose role best matches your task.
- Give clear context, expected format, and relevant constraints.
- Attach the specific files needed for the request.
- Continue with follow-up questions inside the same conversation when you want to preserve context.
For more guidance, see:
- [LLM Best Practices](https://www.askthisguy.com/doc/webapp/llm-best-practices)
- [Using Attachments](https://www.askthisguy.com/doc/webapp/using-attachments)
---
# Voice mode: use an AI voice agent
URL: https://www.askthisguy.com/en/doc/webapp/using-voice-mode/
Language: en
Section: Documentation
Voice mode lets you talk to an Ask This Guy agent like an AI voice assistant, instead of typing your entire message. Your conversation remains available in writing, and you can continue to use the keyboard, attach files, and choose a response mode as usual.
**Scope:** voice mode is enabled separately for each agent. This page describes the feature in the authenticated ATG webapp.
## Check that voice mode is available
Select an agent. If voice mode is enabled for it, a microphone button labeled **Speak** appears below the message field.
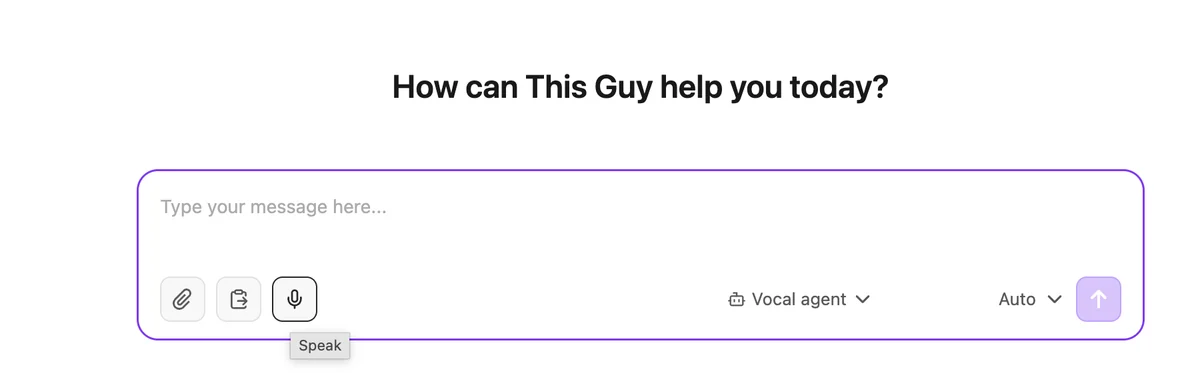 If the button is missing or unavailable, one of the following may apply:
- voice mode is not enabled for the selected agent or your organization;
- the browser does not support the required audio recording;
- the conversation is read-only or message input is temporarily disabled.
## Dictate a message
1. Select **Speak**. The button changes to a red stop button and a waveform shows that the microphone is listening.
2. If this is your first recording, allow the browser to use your microphone.
3. Speak naturally. The interface language helps the transcription service recognize the recording in the appropriate language.
4. Finish by selecting the red stop button, or pause after speaking. Recording stops automatically about **1.5 seconds after silence is detected** and is always limited to **60 seconds**.
5. Wait while **Transcribing…** is displayed. The recognized text is added to the message field.
The transcript is ordinary text. It is appended to anything already in the field, so you can combine typing and dictation or record several successive segments.
## Review or cancel automatic sending
After transcription, ATG displays **Sending in 2s**, then **Sending in 1s**.
- Do nothing to send the message automatically.
- Select **Cancel** to keep the transcript in the field and edit, complete, send, or discard it yourself.
- Select the microphone again to cancel the countdown and start another dictation.
Always review names, numbers, sensitive information, and technical references before sending them.
## Hear the agent's response
When at least part of a sent message was dictated, ATG treats it as a voice turn and reads the agent's completed response aloud automatically. Editing or completing the transcript with the keyboard does not disable this behavior.
While the agent is working, brief spoken updates may announce activities such as searching the knowledge base, browsing the web, consulting documents or data, or preparing a chart. If the operation takes longer, ATG may also ask you to wait a little longer. Each type of update is spoken only once per response.
The audio bar shows **Preparing audio…** during speech synthesis and **Playing…** during playback. Select **Stop** to interrupt playback and clear any queued audio. If response generation fails, automatic playback is canceled.
The spoken version is adapted for natural listening: Markdown markers, table separators, code blocks, images, and technical source markers are omitted. Link labels may be read, while the complete formatted response and its sources remain visible on screen.
## Listen to any response on demand
Every completed agent response has a **Read aloud** action. You can use it even when the original question was typed, or to replay an older response in the conversation.
Selecting **Read aloud** prepares and starts the audio. Select the square stop button to interrupt it. Starting another response replaces the audio already playing, so only one response is read at a time.
## Allow microphone access
Your browser asks for microphone access on first use. The recording indicator remains active only while you are speaking, and the microphone stream stops when the recording ends. The audio clip is then sent for transcription.
If access is blocked, ATG asks you to allow the microphone in your browser. Open the browser's site permissions, enable microphone access for ATG, and start a new recording.
## Current limitations
- Voice mode may not be enabled for every organization or agent.
- A single recording can last up to 60 seconds.
- Transcription and speech synthesis require a network connection and do not work offline.
- Voice mode uses separate recordings and reads the completed answer; it is not a continuous, real-time audio conversation.
- The transcription provider, speech synthesis provider, and voice are configured for the agent. Users cannot change them from the chat.
- There is no voice preference stored for each user.
- Speaking does not automatically interrupt playback. Select **Stop** before using the microphone.
- If the browser blocks automatic playback, use **Read aloud** on the completed response.
## Troubleshooting
| Situation | What to do |
|---|---|
| The microphone does not appear | Select another voice-enabled agent or ask your administrator to enable voice mode. |
| Microphone access is blocked | Allow microphone access in the browser's site settings, then start a new recording. |
| ATG cannot transcribe the audio | Check your connection, reduce background noise, and try again. |
| Playback does not start automatically | Select **Read aloud** below the completed response. |
| You need to correct the transcript | Select **Cancel** during the two-second sending countdown. |
The diagram lines up the three main risks to your data with ATG's answer to each: no model training on your content, minimal retention with no third-party storage, and an EU-only policy that blocks US providers.
### 1) Public AI training & shadow AI leakage Many public AI systems can use consumer usage to improve models. Put simply: if an employee pastes confidential information into a public chatbot, it may end up contributing to a future model version, with no reliable traceability. **Our guarantee:** ATG only uses AI providers through APIs that contractually guarantee they **do not train models** on your data. ### 2) Minimal retention by design We follow a **minimal retention** approach: ATG keeps only what is necessary to operate the service. - We avoid storing raw files when they are not needed. - We do not store your data with third-party “hosted data” features (some AI providers offer this, we deliberately do not use it). ### 3) EU-only policy means no US transfers If your **AI policy** is set to **EU-only**, ATG does not transfer anything to US providers. Learn more: [AI Policy](https://www.askthisguy.com/doc/admin-console/organization-settings/choosing-the-right-ai-policy) ## Data transit: two distinct phases ATG handles data in two separate phases: 1. **Document preparation** (turning documents into an internal knowledge base) 2. **User answers** (answering questions using internal retrieval + controlled LLM calls) The **AI policy** has the biggest impact in phase 2 (LLM providers used for generation). ## Phase 1 — Document preparation (ingestion & RAG prep) ATG performs a full RAG preparation pipeline: text and images are extracted, processed, split into chunks, vectorized, and indexed. Learn more: [How is my company’s data processed? What is RAG?](https://www.askthisguy.com/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag) ```mermaid flowchart LR Source["Customer sources (Drive, etc.)"] --> ATG["ATG backend"] ATG --> Prep["Extract + process"] Prep --> Vec["Vectorize (EU providers)"] Prep --> Img["Image understanding (EU providers)"] Prep --> OCR["OCR (full-document) via Mistral (when required)"] Vec --> Store["PostgreSQL + PGVector + S3 (self-hosted Supabase)"] Img --> Store OCR --> Prep ```The diagram details the preparation phase: documents from your sources are extracted and processed by the ATG backend, then vectorized and analyzed by European providers, with a detour through Mistral OCR only when text conversion requires it. The result is stored on our side, in PostgreSQL with PGVector and S3 on a self-hosted Supabase.
### What may be sent to external services in phase 1 Some calls to external AI services can happen during preparation, strictly controlled by the backend: - **Image understanding**: European providers only - **Vectorization**: European providers only - **Full-document OCR**: the only time a whole document can be sent to a third party is for **conversion to text**, via **Mistral OCR** ### What is stored after preparation After preparation, ATG primarily stores: - the extracted text, split into **chunks** - vectors (embeddings) for search - selected images when they are kept ATG does **not** keep original files unless it is necessary: - **Uploaded files** can be kept **only** if an admin explicitly wants end users to be able to download them later - If documents come from an external drive/connector, ATG does not keep raw files (it is not needed) ## Phase 2 — Answering users (chat & search) ATG never sends your organization’s documents to LLM providers. The information retrieval happens **internally** (on OVHCloud ATG servers). What is sent to an AI provider is: - the user query - the small set of **relevant snippets** (chunks) selected by ATG as useful context ```mermaid sequenceDiagram participant U as User browser participant B as ATG backend participant DB as Storage/DB participant LLM as LLM providers U->>B: Send query B->>DB: Retrieve relevant chunks (PGVector) DB-->>B: Top-k snippets B->>LLM: Query + selected snippets (no full docs) LLM-->>B: Generated answer B-->>U: Answer + citations (frontend displays the response) ```The diagram follows one question end to end: the ATG backend retrieves the relevant snippets from the vector store itself, then sends the LLM provider nothing but the user query and those few snippets. Full documents never leave ATG's infrastructure.
### Where AI policy matters The AI policy determines which external providers can be used in phase 2: - **EU-only**: European providers only - **Worldwide**: EU providers plus selected worldwide providers See: [AI providers management](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers) --- # Our approach to sovereign AI URL: https://www.askthisguy.com/en/doc/infrastructure-and-security/sovereign-ai/ Language: en Section: Documentation ## Our definition of sovereign AI For ATG, **sovereign AI** is not just about using a European model. Sovereignty depends on control over three complementary elements: 1. **The law that applies to the company** providing the service 2. **The infrastructure** that hosts the platform and the data 3. **The AI models** that process requests and their context This distinction matters. A platform can be hosted in Europe while calling an AI provider subject to a non-European jurisdiction. Conversely, a European model is not enough to make a solution sovereign if its infrastructure or operator falls outside the European perimeter. This page describes **our own implementation**. For the general definition, the assessment criteria and the questions to ask any vendor, see our [sovereign AI](https://www.askthisguy.com/sovereign-ai/) page. To go deeper into dependency and digital sovereignty issues, see [our articles on sovereignty](https://www.askthisguy.com/blog/tag/souverainete/). ## 1. A French company under European law Ask This Guy is a French company. Our contractual commitments and decisions about data processing sit within French and European law, including the GDPR. This first level of sovereignty gives you a counterpart established in France and a European legal framework. It is not enough on its own: infrastructure location and AI provider choices matter just as much. ## 2. European infrastructure, with an on-premise path The ATG platform is hosted in the European Union by companies under European law. Our main infrastructure relies in particular on dedicated OVHcloud servers in Gravelines, France, with redundancy in Frankfurt, Germany. The essential components stay within that perimeter: - ATG frontend and backend; - PostgreSQL and PGVector databases; - document and media storage; - backups and replication. The ATG backend is the control point for calls to external services. It accesses storage, applies access rules, and only sends the information required to the AI providers authorized by your policy. ### Our own GPU infrastructure in Europe ATG does not only consume external inference APIs. We also build our **own GPU infrastructure** with **Verda**, a Finnish provider running its data centers in **Finland** and **Iceland**. There, we deploy and operate some models ourselves, on GPUs dedicated to ATG. This layer complements the use of external providers and brings: - **AI hosted in Europe** all the way to the inference layer, with no context leaving our perimeter; - control over the model served: version, configuration, update cycle; - an operator under European law, since Finland is in the European Union and Iceland is in the European Economic Area, and therefore covered by the GDPR. Depending on the use case, ATG combines its own GPUs with selected third-party inference providers, within the limits of the AI policy your organization has chosen. ### Going further with on-premise For some organizations, sovereignty requires the platform to run in their own environment. We want **on-premise** to remain a possible option to go further in controlling infrastructure, network, and data location. Depending on context, scope, and security requirements, a dedicated deployment can be reviewed with your teams. The goal is to bring ATG closer to your trusted infrastructure, without giving up search, knowledge management, and AI assistance capabilities. ## 3. AI models: full sovereignty or better performance The AI market is moving fast. At this stage, there is still, depending on tasks and models compared, a performance gap between some US and European providers. That gap combines in particular: - inference speed; - reasoning and generation quality; - multimodal capabilities and native attachment support. We therefore prefer to be transparent about this trade-off rather than present theoretical sovereignty as a universal answer. ATG lets you choose the level that fits your organization. ## Two AI policies based on your requirements ### EU-only: maximum sovereignty The **EU-only** policy limits AI processing to providers under European law that run their services in Europe, plus the models we operate ourselves on our GPUs at Verda. This is the preferred choice when control of jurisdiction and European residency of processing are priorities. This policy fits an **AI hosted in Europe** approach and AI aligned with GDPR compliance requirements. It may, however, reduce model choice, speed, or capabilities for some use cases. ### Worldwide: an exception limited to the AI layer The **Worldwide** policy allows, in addition to European providers, selected international providers. It lets you benefit from the most capable or fastest models when that brings concrete value to your users. This exception concerns the AI layer. ATG's core infrastructure, storage, and databases remain hosted in Europe. Even with this policy, ATG: - only sends what is needed to process the request; - generally transmits the question and relevant excerpts, rather than full documents; - uses providers through governed APIs; - does not allow the LLMs used via ATG to train their models on your data. Choosing worldwide therefore does not remove our minimization and control requirements. It lets you explicitly trade off maximum sovereignty against operational performance. ## You stay in control at all times The AI policy can be changed at any time from the **AI Policy** menu in the admin console: [Configure the AI policy](https://www.askthisguy.com/doc/admin-console/organization-settings/choosing-the-right-ai-policy) You can start with a worldwide policy to evaluate performance, then switch to EU-only when your compliance requirements or use case require it. The reverse is also possible if your priorities change. For the exact available providers and their guarantees, see [AI providers management](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers). For data flow details, see [Your Data Management](https://www.askthisguy.com/doc/infrastructure-and-security/data-management). ## Our roadmap: letting you choose your AI Our longer-term goal is to offer a **Bring Your Own AI** mode. It will let organizations that want to connect their own models, providers, or inference endpoints keep more autonomy over the last link in the chain. This capability is on our roadmap. In the meantime, the EU-only and Worldwide policies already let you adapt the sovereignty level to each organization's risk, regulatory constraints, and performance goals. ## In summary Our approach to sovereign AI rests on three commitments: - **A French company** under French and European law - **European infrastructure**, including our own GPUs at Verda in Finland and Iceland, with an on-premise option for the most demanding needs - **An explicit choice for AI**, between European providers only and access to worldwide providers for better performance Sovereignty is not a slogan or a single switch. It is a documented trade-off that you can evolve as your constraints and model performance change. ## Frequently asked questions about sovereign AI ### What is sovereign AI for an enterprise? **Sovereign AI** is a solution where an organization controls the applicable legal framework, the infrastructure hosting its data, and the AI providers processing its requests. Using a European model alone is not enough if the operator or infrastructure falls outside that perimeter. ### Is AI hosted in Europe necessarily sovereign? No. European hosting is important, but it does not guarantee sovereignty on its own. You must also examine the law governing the operator and the AI providers processing requests. A solution may store its data in Europe while depending on a provider subject to a non-European jurisdiction. ### Is ATG a French AI company? Ask This Guy is a French company subject to French and European law. **French AI** is not the right description: we primarily provide a French platform for using AI. ### What is the difference between the EU-only and Worldwide policies? The **EU-only** policy limits AI processing to providers under European law that run their services in Europe. The **Worldwide** policy also allows selected international providers, while ATG's core infrastructure, storage, and databases remain in Europe. You can therefore choose between maximum sovereignty and access to a broader range of models. ### Does ATG run its own GPU infrastructure? Yes. On top of external AI providers, ATG builds its own GPU infrastructure with **Verda**, a Finnish provider whose data centers are located in **Finland** and **Iceland**. We deploy and operate some models there ourselves, which keeps inference within a European, GDPR-covered perimeter, alongside the platform hosted at OVHcloud. ### Can ATG be deployed on-premise? On-premise is an option considered for organizations that need more control over their infrastructure, network, and data location. Depending on the context, scope, and security requirements, a dedicated deployment can be reviewed with your teams. --- # Customizing ATG to YOU URL: https://www.askthisguy.com/en/doc/customizing-atg-to-you/ Language: en Section: Documentation This section describes how *Ask This Guy* (ATG) can be **adapted to your organization** beyond the standard, out-of-the-box setup. Different approaches are possible; ATG follows a **90-10** philosophy to keep most of the system generic while focusing customization where it brings the most value. **In this section** - [Introduction](https://www.askthisguy.com/doc/customizing-atg-to-you/introduction) – Approaches and the 90-10 model - [Tailored Processing](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-processing) – Custom document handling for your file types - [Tailored Tools](https://www.askthisguy.com/doc/customizing-atg-to-you/tailored-tools) – Query your enterprise APIs (CRM, internal tools, etc.) - [Database Query](https://www.askthisguy.com/doc/customizing-atg-to-you/database-query) – Natural-language SQL over your data --- # Infrastructure & Security URL: https://www.askthisguy.com/en/doc/infrastructure-and-security/ Language: en Section: Documentation ## Built for Performance, Security, and Data Sovereignty ATG's infrastructure has been **carefully designed** to deliver performance, security, and flexibility - while ensuring **complete control** over your data. Every technical choice reflects our commitment to **European data sovereignty** and best-in-class security practices. ### Architecture All of ATG’s infrastructure — **frontend**, **backend**, and **storage/databases** — runs on **dedicated ATG servers at OVHCloud**, with redundancy on a second physical site. That means a **European provider** and data not subject to US legislation (e.g. Cloud Act, Patriot Act). Primary site: **Gravelines (France)**; secondary: **Frankfurt (Germany)**. Your device talks only to the frontend and backend; the backend alone accesses storage and databases and is the only component that calls **external services** (e.g. LLMs, web search). Your data stays on ATG’s European servers; any call to an AI or other external provider goes through our backend under strict control. **Our own GPUs, on top of external providers:** ATG does not only call external AI providers. We also build our **own GPU infrastructure** with **Verda**, a Finnish provider running data centers in **Finland** and **Iceland**. We deploy and operate some models there ourselves, on dedicated GPUs, without leaving the European perimeter (Finland is in the European Union, Iceland is in the European Economic Area, and both are covered by the GDPR). Details on the [AI providers management](https://www.askthisguy.com/doc/infrastructure-and-security/ai-providers) page. **Technologies in use:** - **Python** for the entire backend, enabling seamless integration across platform services and modules - **PostgreSQL** for structured data and metadata, **PGVector** for AI-powered semantic search, **S3** for documents and media. In practice this is **Supabase**, but **self-hosted** on ATG’s OVHCloud servers and fully managed by ATG
 **Ask This Guy.** ATGU SAS, 100% de l'actionnariat chez des personnes physiques ou holdings personnelles françaises. Données sur serveurs dédiés OVHcloud à Gravelines, redondance à Francfort + des GPU propres chez Verda, société finlandaise. Deux politiques d'inférence au niveau de l'organisation, « UE uniquement » ou « Monde entier », modifiables depuis la console d'administration. C'est notre produit, nous y revenons plus bas.
*Sources : [notre approche de l'IA souveraine](https://www.askthisguy.com/fr/doc/infrastructure-and-security/sovereign-ai/), [gestion des fournisseurs IA](https://www.askthisguy.com/fr/doc/infrastructure-and-security/ai-providers/).*
 **IA-Souveraine.fr.** Édité par **DRI (Digital Rural Informatique)**, SAS créée en 2001 au Mans, contrôlée par une holding française. C'est le dossier le plus intégré du panel : DRI n'est pas un éditeur de logiciel qui loue du cloud, c'est un hébergeur de vingt-cinq ans qui a ajouté une couche IA. L'indépendance porte sur l'infrastructure, pas sur les modèles, qui restent des poids ouverts publiés par d'autres, Google, Meta ou Mistral selon les cas. Ses mentions légales le disent en toutes lettres, il est « éditeur **et** hébergeur » de la plateforme. Datacenter en propre au Mans, réseau et numéro de système autonome en propre, certifications ISO 27001 et ISO 14001, conformité HDS disponible, hébergement exclusivement en France pour l'offre souveraine.
Sur l'inférence, l'offre souveraine est limpide : les modèles à poids ouverts sont exécutés sur les machines de DRI, en France, donc par une société française. Et contrairement aux plateformes multi-modèles de cette liste, il n'y a rien à verrouiller, puisqu'il n'y a rien à exclure. La souveraineté est le produit, pas une option à activer. Une réserve tout de même : la plateforme annonce plus de 80 modèles au total, dont des « modèles commerciaux de référence » qui ne sont jamais nommés. Nous les lisons comme une offre distincte de l'offre souveraine, ce qui est cohérent avec la façon dont DRI présente les deux, mais la question mérite d'être posée si vous souscrivez.
*Sources : [mentions légales](https://www.ia-souveraine.fr/mentions-legales), [politique de confidentialité](https://www.ia-souveraine.fr/confidentialite), [page souveraineté](https://www.ia-souveraine.fr/souverainete), [communiqué de lancement DRI](https://www.dri.fr/communique-de-presse-national-ia-souveraine).*
 **LightOn.** Société anonyme cotée sur Euronext Growth Paris depuis novembre 2024. Modèles développés en interne, déploiement possible en on-premise et jusqu'à l'air-gap pour des environnements classifiés. Information que nous n'avons pas trouvée : LightOn ne nomme nulle part l'hébergeur de son offre SaaS, présentée comme un « cloud européen souverain » sans plus de précision.
*Sources : [politique de confidentialité développeurs](https://developers.lighton.ai/legal/privacy-policy), [options de déploiement](https://lighton.ai/deployment-options), [fiche IPO Euronext Growth](https://live.euronext.com/en/ipo-showcase/lighton).*
 **Mistral AI.** Le seul éditeur du panel qui produit ses propres modèles et opère ses propres datacenters : Bruyères-le-Châtel et Les Ulis dans l'Essonne, Borlänge en Suède, avec un campus francilien annoncé à 1,4 GW à pleine capacité. En septembre 2026, la société a levé 3 milliards d'euros, le plus gros tour jamais bouclé par une tech européenne, portant sa valorisation à environ 21 milliards. Le tour est mené par le sud-coréen Samsung, premier contributeur de l'opération, aux côtés du fonds Scale-up Europe de la Commission européenne, de PSG Equity, d'ASML, de Nvidia et de BNP Paribas CIB. Les fonds doivent financer des datacenters en propre et le doublement, en cinq ans, de la puissance de calcul détenue par la société. Sur le capital, Mistral revendique un actionnariat à majorité européenne : d'après franceinfo, les investisseurs européens représentent environ la moitié de ce tour, et l'Europe conserve après l'opération à peu près deux tiers du capital et trois quarts des droits de vote au conseil. On y trouve ASML, entré fin 2025 comme premier actionnaire à environ 11 %, Bpifrance, des fonds américains et le fonds souverain émirati MGX.
Deux nuances, qui n'enlèvent rien à la profondeur industrielle du dossier. Et signalons d'emblée que **nous ne les connaissons que parce que Mistral les publie** : son Trust Center est l'un des plus complets du panel, avec un onglet listant nommément ses sous-traitants. Beaucoup d'éditeurs de cette liste n'exposent rien de comparable, et c'est précisément ce qui rend leurs fiches plus courtes. Ce Trust Center cite donc **deux sociétés américaines dans la chaîne** : Microsoft comme fournisseur d'infrastructure cloud pour les clients Studio européens, et CoreWeave comme fournisseur de calcul d'inférence. Et le verrouillage européen **passe par une demande écrite** : les clients Enterprise font désactiver au niveau de l'organisation les fonctionnalités qui impliquent un transfert hors UE, en le demandant à Mistral.
*Sources : [où sont stockées mes données ?](https://help.mistral.ai/en/articles/347629-where-do-you-store-my-data-or-my-organization-s-data), [documentation de l'inférence régionale](https://docs.mistral.ai/inference/regional-inference), [Trust Center, onglet Subprocessors](https://trust.mistral.ai/subprocessors), [annonce infrastructure et modèles ouverts](https://mistral.ai/news/regional-inference-open-models-new-compute/), [levée de fonds de septembre 2026, franceinfo](https://www.franceinfo.fr/internet/intelligence-artificielle/la-start-up-francaise-mistral-annonce-une-nouvelle-levee-de-fonds-de-trois-milliards-d-euros-portant-sa-valorisation-a-plus-de-21-milliards-d-euros_8182583.html), [détail des investisseurs, Clubic](https://www.clubic.com/actualite-628704-mistral-ai-boucle-la-plus-grosse-levee-de-fonds-jamais-realisee-par-une-tech-europeenne.html).*
 **Wikit.** Wikit SAS, Lyon, spécialiste de l'assistant de support interne. Hébergement OVHcloud en France. Wikit nomme **sept tiers au total**, ce qui est déjà rare, et surtout il publie **la meilleure documentation du panel sur la couche modèle** : un tableau qui indique, fournisseur par fournisseur, si les données restent dans l'UE, avec une ligne qui répond franchement « non » pour OpenAI. Personne d'autre ne fait cela. Le choix des fournisseurs se règle au niveau du projet ; aucune console d'administration accessible au client n'est documentée.
*Source : [confidentialité et sécurité, documentation Wikit](https://docs.wikit.ai/privacy_and_security/).*
### Groupe 2 : L'infrastructure est là, la porte reste ouverte
 **Craft AI.** Craft.ai SAS, présidée par une holding française. Le dossier illustre bien le piège du « listé n'est pas imposé » : l'annexe de son DPA autorise cinq clouds, dont 3DS Outscale, OVHcloud et Scaleway, alors que la production tourne sur AWS et Scaleway. Autrement dit, la brique française existe, contractuellement, mais elle n'est jamais présentée comme une option catalogue. Côté modèles, sur les huit fournisseurs autorisés, **cinq sont américains** (AWS Bedrock, Google Vertex AI, Microsoft AI Foundry, OpenAI, Voyage AI), un est canadien (Cohere), et **deux seulement sont européens** : Mistral AI et Scaleway. Une configuration d'inférence entièrement européenne est donc possible sur le papier, mais elle suppose de s'en tenir à ces deux lignes.
*Sources : [annexes du DPA](https://www.craft.ai/en/cgu-craft-ai/annexes), annexe B pour l'hébergement effectif et annexe C pour les sous-traitants autorisés, [conditions complémentaires sur les modèles de fondation](https://www.craft.ai/en/cgu-craft-ai/conditions-complementaires-relatives-a-lutilisation-des-modeles-de-fondation-ccmf).*
 **Delos.** Le dossier le plus frustrant du panel. Delos Intelligence héberge **toutes les données chez Scaleway en région parisienne**, avec triple réplication, certification ISO 27001 et un trust center. Sur l'hébergement, rien à redire, et il s'agit de l'offre standard, pas d'une option payante.
La suite se complique. La page sécurité affirme que les modèles sont « hébergés exclusivement dans l'Union européenne ». Mais le catalogue affiché est GPT 5.2, Claude Opus 4.5, Gemini 3 Pro et Mistral Large 3 : **trois modèles fermés sur quatre, donc nécessairement opérés par leurs éditeurs américains**, où que tourne le serveur. Et l'interface laisse l'**utilisateur** choisir son modèle, sans que rien ne documente la possibilité pour un administrateur de restreindre la liste. À porter à son crédit tout de même, et c'est la seule atténuation sérieuse quand les modèles sont fermés : la page sécurité mentionne un **traitement sur données pseudonymisées** avant transmission au modèle. Reste à faire préciser ce qui est pseudonymisé, et à quel moment de la chaîne.
Si ce réglage d'administrateur existait, Delos deviendrait l'une des solutions les plus souveraines du marché sans toucher à son infrastructure.
*Sources : [page sécurité](https://www.delos.so/fr/security), [politique de confidentialité](https://www.delos.so/fr/politique-de-confidentialite), [page produit Assistant](https://www.delos.so/fr/applications/assistant) pour la liste des modèles, [levée de fonds, FrenchWeb](https://www.frenchweb.fr/delos-leve-25-millions-deuros-pour-imposer-un-os-francais-de-lia-dans-lentreprise/453448).*
### Groupe 3 : Adossés à un hyperscaler américain
 **Ask for the Moon.** Capital franco-allemand, 2,5 M€ levés en mars 2024 auprès de Matterwave Ventures et UI Investissement, sans investisseur extra-européen identifié : c'est le point fort du dossier. Les services sont hébergés chez **Microsoft Azure à Paris**, et l'inférence n'est pas documentée publiquement. Un point à faire confirmer par écrit : leur propre page de protection des données indique que les données au repos ne sont pas chiffrées, ce qui est inhabituel.
*Sources : [protection de vos données](https://askforthemoon.com/fr/protectingYourData), [portrait et levée de fonds, Maddyness](https://www.maddyness.com/2024/03/13/cette-startup-dune-ancienne-dg-de-la-sncf-utilise-lia-pour-relier-les-intelligences-humaines/).*
 **Dust.** Permutation Labs SAS, société française. Le capital, lui, est majoritairement américain. **L'hébergement repose exclusivement sur Google Cloud**, seule la région varie, et il n'existe aucune alternative documentée : c'est le seul point du dossier qui ne se corrige pas par un réglage.
Deux choses à mettre à leur crédit. Dust est très transparent : mentions légales, page des entités du groupe, mesures de sécurité, liste de sous-traitants datée, conditions spécifiques aux modèles de fondation, tout est public. Et c'est le seul à avoir contractualisé publiquement un droit d'opt-out par fournisseur, en libre-service pour l'inférence. Le mécanisme est cependant une liste noire, pas une liste blanche : la conformité s'obtient en désactivant cinq fournisseurs pour en garder un, et en mode strictement européen, il ne reste que Mistral.
*Sources : [mesures de sécurité](https://dust-tt.notion.site/816d4ef898364ba180973a2c883b6d32), [liste des sous-traitants](https://dust-tt.notion.site/Sub-Processors-cb656ff3093c4aee9e080e3021e71f9c), [conditions sur les modèles de fondation](https://dust-tt.notion.site/9ed7e35633084d5fa03ebb02286de0da), [entités et affiliés](https://dust-tt.notion.site/20f5657d59a34c38a40e2567ec59db25).*
 **Outmind.** Outmind SAS, Palaiseau. Traitements par défaut dans l'EEE, hébergeur **AWS EMEA à Paris**, instance dédiée par client avec clé de chiffrement propre. L'inférence n'est pas documentée. Autre point de vigilance : l'authentification des utilisateurs passe par Clerk, société de San Francisco, et rien n'indique qu'elle soit optionnelle.
*Sources : [page sécurité](https://www.outmind.ai/security), [politique de confidentialité](https://www.outmind.ai/data-privacy).*
### Groupe 4 : Trop peu d'information publique pour conclure
Pour ces trois-là, nous n'avons tout simplement pas trouvé assez de matière publique. Une demi-heure d'entretien ferait bouger les trois fiches, dans un sens comme dans l'autre.
 **Cominty.** Cominty SAS. Le produit est présenté comme « agnostique » : Docker, GCP, AWS, OVH. C'est vraisemblablement un choix laissé au client, mais l'hébergement par défaut n'est pas documenté, et aucun fournisseur de modèle n'est nommé. Sur la sécurité en revanche, Cominty en dit plus que la moyenne du groupe : **SOC 2 Type II**, conformité RGPD, chiffrement AES-256 au repos et TLS 1.2+ en transit. Attention à ne pas conclure trop vite : l'agnosticité peut tout aussi bien recouvrir un réglage d'organisation qu'un libre choix d'utilisateur.
*Sources : [site cominty.ai](https://www.cominty.ai/), [trust center](https://trust.cominty.ai).*
 **Limova.** Marque exploitée par Kainotom.ia SAS, à Nice. La politique de confidentialité affirme un hébergement « exclusivement sur des serveurs situés au sein de l'Union européenne », mais le seul sous-traitant nommé de toute la documentation est Google Firebase, service de Google LLC. La documentation ne décrit ni fournisseur de modèle ni chaîne de traitement, pour un produit dont les agents lisent les emails et prennent les appels téléphoniques. À noter aussi, sur la forme : les mentions légales ne publient ni le SIREN, ni le numéro RCS, ni l'hébergeur, alors que la loi les impose.
*Sources : [mentions légales](https://www.limova.ai/legal/mentions-legales), [politique de confidentialité](https://www.limova.ai/legal/politique-de-confidentialite), [le modèle Limova, Maddyness](https://www.maddyness.com/2026/01/29/agents-ia-entreprises/).*
 **Prisme.ai.** Prisme.ai SAS. La particularité change toute la lecture : la plateforme se déploie en **auto-hébergement ou en cloud privé du client**, par Kubernetes, aussi bien sur OVHcloud que sur AWS ou Azure. La souveraineté est donc entièrement déléguée au client : celui qui déploie sur OVHcloud obtient une pile française, celui qui déploie sur AWS n'en obtient pas, et l'éditeur ne garantit ni l'un ni l'autre. Aucun fournisseur de modèle n'est nommé, aucune certification n'est mentionnée, et le capital n'est pas publié.
*Sources : [documentation Prisme.ai](https://docs.prisme.ai/), [pages produit](https://www.pages.prisme.ai/fr).*
### Groupe 5 : Le faux ami
 **Slite.** Slite est régulièrement rangé parmi les alternatives françaises : fondateurs français, équipe française, bureau parisien, produit de gestion de connaissance avec une recherche par IA. Sa propre page légale est pourtant sans ambiguïté.
> L'entité contractante et responsable de traitement est **Slite, Inc., société du Delaware**, domiciliée à San Francisco. Slite France SAS « ne commercialise pas le Service et n'agit pas comme entité contractante pour les clients : elle fournit des services d'emploi et de support au sein du groupe ».
Les données de production sont hébergées sur Google Cloud, à Saint-Ghislain en Belgique. Un client européen contracte donc avec une société américaine, sur une infrastructure américaine, avec des serveurs en Belgique. C'est parfaitement légal, l'entreprise ne s'en cache pas, et sa sécurité est solide, avec un SOC 2 Type II. Slite ne promet pas la souveraineté.
C'est aussi, sur quatorze éditeurs, **le seul cas de société contrôlée depuis l'étranger**.
*Sources : [informations légales](https://slite.com/legal), [politique de confidentialité](https://slite.com/privacy), [page sécurité](https://slite.com/security).*## Petit reality check complémentaire : où est hébergé leur propre site
Celui-là n'a aucune portée opérationnelle. Un site vitrine ne porte pas vos données, et le confier à un prestataire américain n'engage rien sur l'architecture du produit. Mais c'est le seul test que vous pouvez faire vous-même, en trente secondes, avant même le premier rendez-vous. Et il en dit un peu sur l'état d'esprit de la maison.
Voici ce que nous avons pu déterminer :
| Hébergeur du site institutionnel | Éditeurs |
|---|---|
| **Hébergeur français** | Ask This Guy et Wikit (OVHcloud, Scaleway) ; IA-Souveraine.fr sur son propre réseau |
| **AWS (Etats-Unis)** | Prisme.ai |
| **Webflow (États-Unis)** | Ask for the Moon, Cominty, Craft AI, Delos, LightOn, Limova, Outmind |
| **Google Cloud ou Netlify (États-Unis)** | Dust, Mistral AI, Slite |
## Les trois questions à poser en démonstration
S'il ne fallait retenir qu'une chose de cet article, ce serait ces trois questions. Elles se posent en dix minutes et elles appellent des réponses vérifiables.
1. **« Qui héberge nos données, nommément, et existe-t-il une alternative européenne à votre offre standard ? »** Un éditeur sérieux nomme son hébergeur. Refuser de le nommer est en soi une réponse.
2. **« Peut-on choisir de façon pérenne et simple de ne jamais utiliser de fournisseurs d'inférence non européens ? »**
3. **« Si nous passons en configuration entièrement européenne, combien de fournisseurs nous reste-t-il ? »** Une conformité qui repose sur un fournisseur unique est un point de défaillance unique.
## Ce que nous en avons fait, chez Ask This Guy
Nous avons construit notre produit en essayant de répondre d'avance à ces questions, et c'est aussi pour ça qu'on avait envie d'écrire cet article. Notre offre est présentée en détail sur notre page [IA souveraine](https://www.askthisguy.com/fr/ia-souveraine/).
Concrètement : l'infrastructure et les bases de données sont sur des serveurs dédiés OVHcloud à Gravelines, avec une redondance à Francfort, et nous opérons nos propres GPU chez Verda, en Finlande et en Islande, pour exécuter nous-mêmes des modèles à poids ouverts. Sur l'inférence, un administrateur bascule toute son organisation entre deux politiques depuis un menu de la console : « UE uniquement », qui n'autorise que des fournisseurs européens et nos modèles auto-hébergés, ou « Monde entier », qui ouvre la couche modèle sans jamais déplacer l'hébergement. Le réglage se change à tout moment.
Nous ne prétendons pas que ce soit la seule bonne architecture. Plusieurs éditeurs de cette liste ont fait des choix différents et parfaitement défendables. Nous pensons simplement qu'un acheteur doit pouvoir constater, verrouiller et prouver, sans avoir à négocier.
Le détail de notre chaîne de traitement est documenté publiquement dans notre [approche de l'IA souveraine](https://www.askthisguy.com/fr/doc/infrastructure-and-security/sovereign-ai/) et dans notre [gestion des fournisseurs d'IA](https://www.askthisguy.com/fr/doc/infrastructure-and-security/ai-providers/).
## Questions fréquentes sur les IA françaises et souveraines
### Qu'est-ce qu'une IA souveraine pour une entreprise ?
Une IA souveraine est une solution dont la société éditrice, l'hébergeur des données et l'opérateur de l'inférence relèvent tous du droit européen, de sorte qu'aucune autorité étrangère ne peut exiger l'accès aux données ni interrompre le service. Le terme n'a aucune définition légale ni label officiel : il faut donc vérifier les trois maillons séparément, dans les documents publics de l'éditeur.
### Une IA hébergée en France est-elle forcément souveraine ?
Non. Un hébergement en France chez AWS, Microsoft Azure ou Google Cloud reste opéré par une société de droit américain, soumise au CLOUD Act quelle que soit la localisation des serveurs. La résidence des données satisfait une clause contractuelle de localisation, mais elle ne change pas la juridiction applicable au prestataire. C'est la distinction la plus souvent escamotée dans les argumentaires commerciaux.
### Mistral AI est-elle une entreprise française ?
Oui. Mistral AI est une société par actions simplifiée de droit français, immatriculée sous le SIREN 952 418 325, sans société mère hors Union européenne identifiée. En septembre 2026, elle a bouclé un tour de 3 milliards d'euros mené par le sud-coréen Samsung, pour une valorisation d'environ 21 milliards. Malgré l'arrivée d'investisseurs non européens (Samsung, Nvidia), la société revendique un actionnariat à majorité européenne : d'après franceinfo, environ deux tiers du capital et trois quarts des droits de vote au conseil restent européens après l'opération. Parmi les actionnaires figurent le néerlandais ASML, entré fin 2025 à environ 11 %, Bpifrance, des fonds américains et le fonds souverain émirati MGX.
### Dust est-elle une entreprise française ?
Oui sur le plan juridique. L'entité contractante est Permutation Labs SAS, société française immatriculée sous le SIREN 949 205 314, sans société mère étrangère, ce que confirment ses mentions légales et sa page des entités du groupe. Son capital est en revanche majoritairement américain après deux tours menés par Sequoia, et son infrastructure repose exclusivement sur Google Cloud.
### Peut-on utiliser ChatGPT ou Claude en restant souverain ?
Non, au sens strict. GPT et Claude sont des modèles fermés dont seuls OpenAI et Anthropic détiennent les poids : eux seuls peuvent les exécuter, et le traitement relève donc du droit américain même sur un serveur européen. Les configurations réellement européennes reposent sur des modèles (à poids ouverts ou non) opérés par un acteur européen, ou sur un éditeur qui produit ses propres modèles.
### Comment vérifier soi-même si un éditeur d'IA est réellement français ?
Ouvrez trois pages, cela prend une dizaine de minutes. Les mentions légales ou la page `/legal` donnent l'entité contractante et permettent de repérer une société mère étrangère. La politique de confidentialité ou l'annexe du DPA nomme l'hébergeur et les sous-traitants. Le numéro SIREN se recoupe gratuitement sur `annuaire-entreprises.data.gouv.fr`. Si l'une de ces trois informations est absente, c'est déjà un résultat.
---
## En résumé
Sur quatorze éditeurs, treize sont bien des sociétés européennes. Bonne nouvelle, mais c'est aussi le point le moins discriminant du marché. Tout se joue sur deux décisions d'ingénierie.
**L'hébergement**, où quatre éditeurs seulement s'appuient en standard sur un prestataire de droit européen, alors que le choix ne coûte rien à l'utilisateur final. Et **le contrôle de l'inférence**, où presque personne ne permet à un administrateur d'imposer une configuration européenne à toute son organisation, sans demande écrite ni désactivation manuelle.
Le mot « souverain » n'est défini nul part ni protégé par rien.
Demandez le nom des hébergeurs et des fournisseurs d'IA pour bien comprendre où partent vos données.
Si vous préparez un projet d'IA d'entreprise et que vous voulez confronter ces critères à votre contexte : **[réservez une démo](https://www.askthisguy.com/fr/demo/)**.
---
# Inférence IA : les 7 façons de faire tourner vos modèles en entreprise
URL: https://www.askthisguy.com/fr/blog/enterprise-ai-inference/
Language: fr
Section: Blog
« On achète des GPU et on héberge tout nous-mêmes. » « Non, on branche une API et on avance. »
Cette discussion est un grand classique des philosophies qui s'affrontent sur l'inférence IA en entreprise. Elle arrive tôt dans un projet d'IA, en général au moment de chiffrer le budget. D'un côté ceux qui veulent l'IA à la maison : on achète les cartes, on installe les modèles, rien ne sort de l'entreprise. De l'autre ceux qui veulent consommer un service : une clé d'API ou un abonnement, on paie à l'usage, aucun matériel à gérer.
Les deux camps ont de bons arguments. Le souci, c'est qu'ils débattent de deux options sur sept.
Ce qu'ils se disputent porte un nom : **l'inférence**.
## L'inférence, c'est quoi exactement
L'inférence, c'est le moment où un modèle d'IA répond à une question. Pas son apprentissage, qui a déjà eu lieu et qui a coûté des millions à quelqu'un d'autre : juste le fait de lui soumettre une requête et d'obtenir un texte en retour.
L'inférence revient tous les jours. Elle est proportionnelle à votre usage, aussi longtemps que votre service tourne. C'est elle qui détermine la vitesse, la facture et le niveau de confidentialité de votre projet.
Un **token** est une petite unité de texte, un mot ou un morceau de mot. Les fournisseurs facturent au million de tokens, en comptant séparément l'entrée et la sortie.
Les **tokens d'entrée** sont tout ce que vous envoyez au modèle : la question de l'utilisateur, mais aussi les consignes, l'historique de la conversation, les extraits de documents et la description des outils disponibles. Les **tokens de sortie** sont ce que le modèle génère en réponse. À volume égal, la sortie coûte en général trois à cinq fois plus cher, parce que chaque token produit demande un passage complet dans le modèle là où l'entrée est traitée d'un bloc.
Le rapport entre les deux dépend beaucoup de votre cas d'usage, et c'est lui qui façonne votre facture. Un assistant généraliste envoie peu et reçoit beaucoup : question courte, réponse développée. Une [IA agentique](https://www.askthisguy.com/fr/blog/enterprise-ai-agents/) fait l'inverse. À chaque étape, l'agent renvoie tout le contexte accumulé, les résultats de ses appels d'outils et l'historique de ses tentatives, pour produire parfois trois lignes de décision. L'entrée gonfle à chaque tour de boucle. C'est pour cette raison que les fournisseurs proposent des tarifs réduits sur la part du contexte réutilisée d'un appel à l'autre.
Reste la vitesse, mesurée en **tokens par seconde**. Pour du chat simple ou de la complétion, 100 tokens/s donnent une réponse qui paraît fluide. Pour de l'agentique, où le modèle enchaîne plusieurs appels avant d'afficher quoi que ce soit, il faut plutôt viser 500 tokens/s. Nous détaillons ces seuils dans notre article sur le [LLM en local](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/).
## Si vous ne devez retenir qu'une chose
Le monde n'est pas binaire. Entre « tout acheter » et « tout consommer », le marché propose une panoplie de solutions valables, toutes avec de bonnes raisons d'exister, et la plupart des entreprises qui tournent en production en panachent plusieurs. Le bon choix dépend de votre contexte, pas d'une position de principe.
Deux façons raisonnables d'aborder le sujet. La première : ne pas vous prendre la tête, prendre une solution chez un fournisseur, et concentrer votre vigilance sur un seul point, sa métrique de facturation. Une offre facturée au message, à l'utilisateur ou au forfait reste prévisible. Une offre facturée au token, beaucoup moins.
La seconde : y passer quelques jours, parce que l'écart de coût entre les sept approches se compte en ordres de grandeur et non en pourcentages.
Dans les deux cas, ce que vous cherchez à éviter s'appelle le *bill shock*, et il arrive régulièrement. En juin 2025, [Cursor](https://cursor.com/blog/june-2025-pricing) bascule ses abonnements individuels vers une facturation à l'usage sans que ses utilisateurs comprennent que l'« illimité » annoncé ne couvrait qu'un seul modèle ; l'éditeur a publié ses excuses le 4 juillet et remboursé trois semaines de dépassements. Sur le dépôt de [Gemini CLI](https://github.com/google-gemini/gemini-cli/discussions/4472), des développeurs persuadés de rester dans une limite de 1 000 requêtes par jour ont découvert des factures de 2 000, 6 400, parfois 10 000 dollars : leur clé d'API facturait au token, et les boucles de raisonnement du modèle en consommaient des centaines de millions.
Même racine dans les deux cas. L'utilisateur raisonnait en requêtes, le fournisseur facturait en tokens.
## Quatre choses se jouent sur la couche d'inférence
### Vos utilisateurs comparent avec ChatGPT
Ils arrivent avec une référence en tête, et cette référence s'appelle ChatGPT, Gemini ou Mistral. Ils ont pris l'habitude d'un texte qui se déroule instantanément. Si votre assistant interne met quinze secondes à démarrer sa réponse, personne ne dira que l'infrastructure est sous-dimensionnée. On dira que votre outil ne marche pas, et on retournera à celui d'avant.
Beaucoup de solutions B2B tournent à ce régime aujourd'hui. Le produit fait ce qu'il promet, la démo passe bien, et personne ne l'ouvre une deuxième fois.
Cette latence se joue presque entièrement au niveau de l'inférence, et c'est de loin le premier motif d'abandon que nous constatons sur les assistants internes. Un projet techniquement correct meurt très bien de quinze secondes de trop.
### Personne ne tient 99,9 % tout seul
Les grands fournisseurs d'IA tournent autour de 99 à 99,5 % de disponibilité, soit plusieurs jours d'indisponibilité cumulés par an. Vos utilisateurs, eux, ont l'habitude des quatre neuf sur leurs outils bureautiques. L'écart se voit.
Nous avons publié les chiffres réels par fournisseur dans [SLA IA entreprise](https://www.askthisguy.com/fr/blog/enterprise-ai-sla/). Le défaut de conception le plus fréquent que nous croisons n'a pas bougé depuis deux ans : un seul fournisseur, aucun repli.
### Vous envoyez vos documents à quelqu'un
Faire de l'inférence, c'est transmettre à un tiers la question de votre utilisateur et les extraits de documents qui servent à y répondre. Contrats, notes internes, données clients. Mieux vaut savoir à qui, sous quel droit, avec quelle politique de rétention et quel engagement de non-entraînement.
Il n'y a pas de bonne réponse universelle ici, seulement un curseur à placer. Nous avons documenté le nôtre sur la page [IA souveraine](https://www.askthisguy.com/fr/ia-souveraine/).
### Le modèle en tête du classement coûte cher pour rien
Il n'est presque jamais celui qu'il vous faut. Pour classer un ticket, extraire un champ ou reformuler une réponse à partir de documents fournis, un modèle plus petit et plus rapide fait le travail.
Surtout, l'écart de prix n'a aucun rapport avec l'écart de capacité. Voici quatre offres du marché, placées selon leur coût moyen au million de tokens et leur indice d'intelligence :
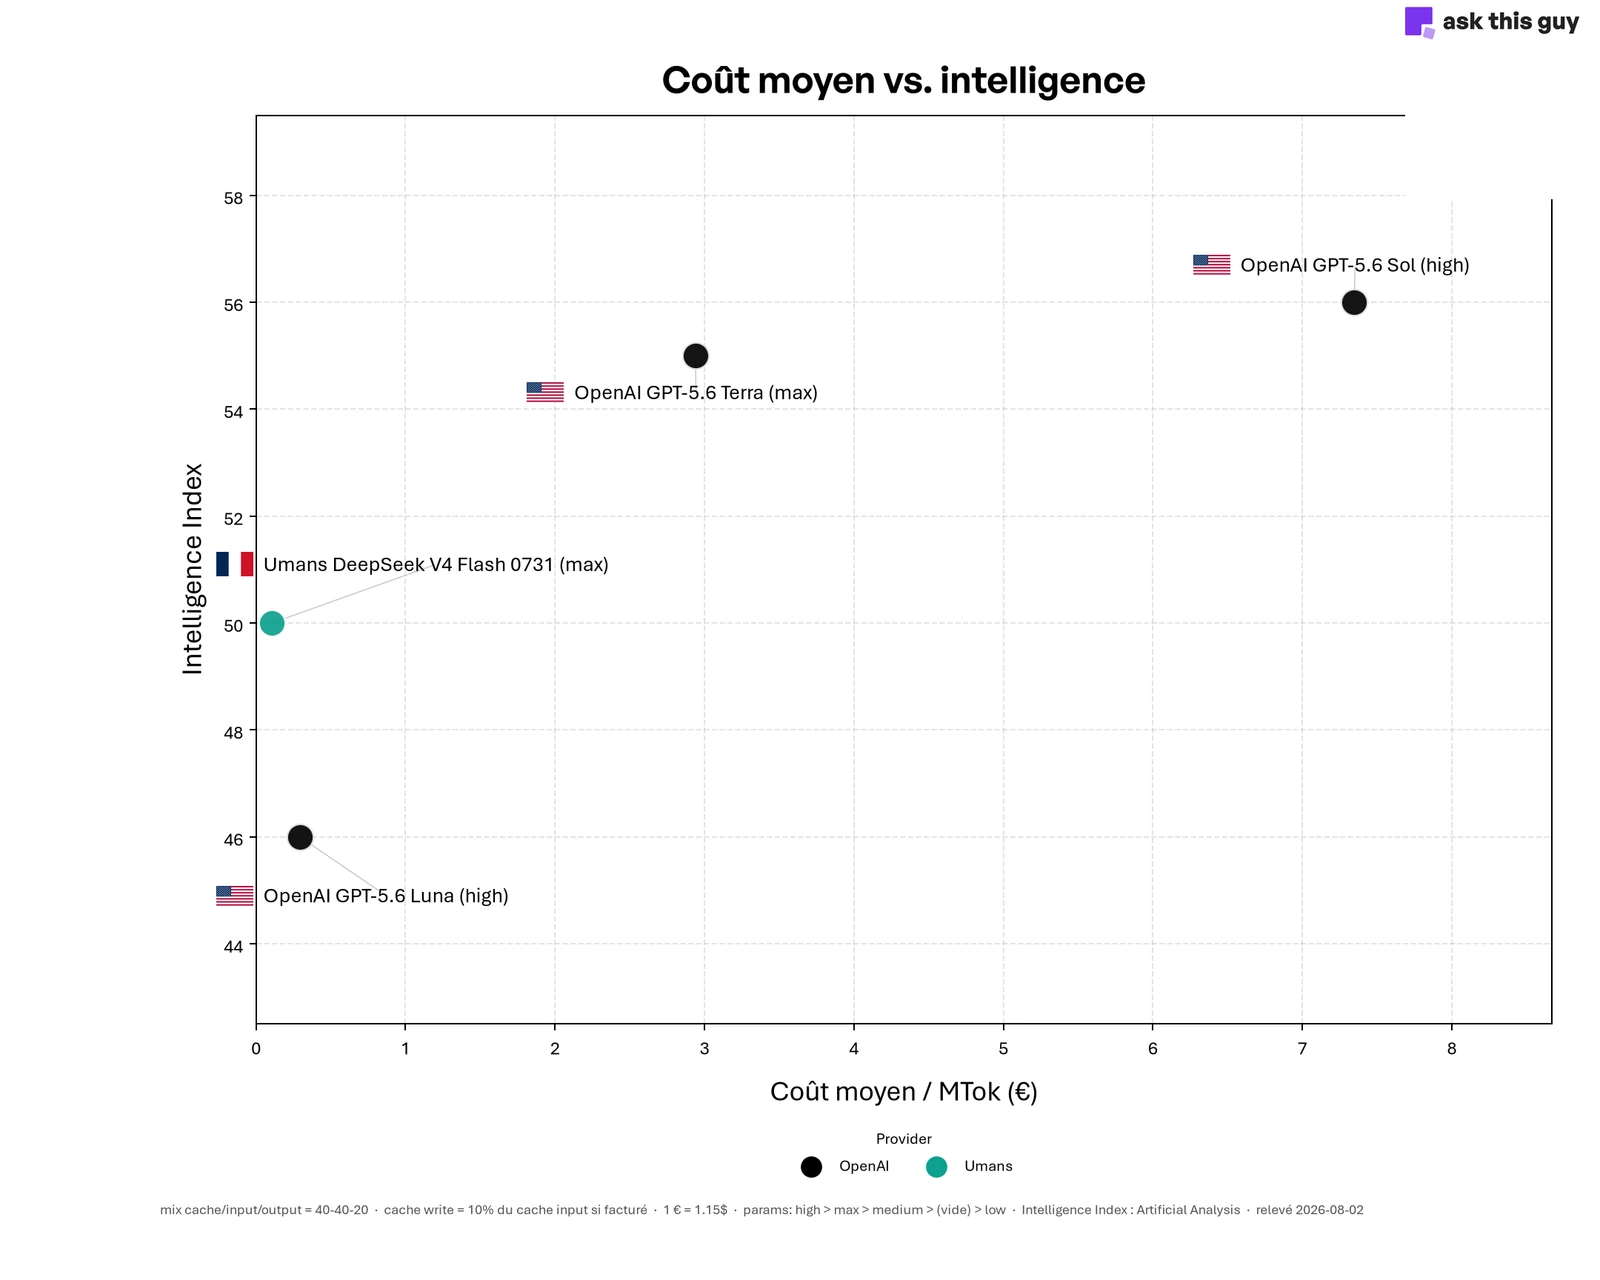
**GPT-5.6 Sol coûte 7,35 € au MTok pour un indice « d'intelligence » de 56. DeepSeek V4 Flash servi par Umans coûte 0,11 € pour un indice de 50.** Six points d'écart, un facteur 69 sur la facture.
Regardez ensuite GPT-5.6 Luna, en bas du nuage : près de trois fois le prix de l'offre Umans, pour un indice inférieur de quatre points. Payer plus ne garantit même pas d'obtenir mieux. Le classement vous dit ce qu'un modèle sait faire, jamais ce qu'il va vous coûter.
Un dernier point, et c'est celui que nous répétons le plus souvent : un benchmark classe les modèles sur des tâches génériques, jamais sur la vôtre. Un indice d'intelligence ne dit rien de la façon dont un modèle se comporte sur votre jargon métier, vos documents, votre langue ou le format de sortie que vous attendez. Prenez deux jours pour faire tourner trois ou quatre candidats sur un échantillon représentatif de vos cas réels, et comparez ce qui sort. C'est le seul classement qui compte pour vous, et il bouscule régulièrement l'ordre officiel.
*Indice d'intelligence : [Artificial Analysis](https://artificialanalysis.ai/), relevés d'août 2026. Coût moyen calculé sur un mélange de 40 % d'entrée en cache, 40 % d'entrée fraîche et 20 % de sortie, à raison de 1 € = 1,15 $. Les mentions max et high désignent le niveau d'effort de raisonnement du modèle.*
## Les sept approches
### 1. Acheter vos GPU et les exploiter vous-même
Vous achetez les cartes, vous les installez, vous déployez les modèles, vous maintenez l'ensemble. Maîtrise maximale : vos données ne sortent jamais, vous choisissez tout, et personne ne change vos conditions du jour au lendemain.
CAPEX maximal aussi. Pour un modèle vraiment rapide et capable, comptez six chiffres, plus les compétences à recruter pour opérer la machine. Votre infrastructure IA devient un projet à part entière, avec son budget et son équipe. Nous avons fait le calcul en détail dans [RAG on premise : que peut-on faire avec 60 k€ ?](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/).
À réserver aux contraintes réglementaires absolues, aux volumes massifs et stables, et aux entreprises qui ont déjà une équipe infrastructure. Ou à celles qui comptent revendre leur capacité quand elle est inactive, et nous y revenons à l'approche 4.
### 2. Louer des GPU dédiés chez un fournisseur cloud
Même architecture, même travail de déploiement, mais le matériel ne vous appartient plus. Le CAPEX devient de l'OPEX prévisible, électricité et refroidissement compris, et les pannes matérielles regardent votre fournisseur.
Méfiez-vous du prix affiché à l'heure. Un service disponible en continu tourne 730 heures par mois, donc ce prix horaire est en réalité un loyer mensuel. Un H100 chez [Scaleway](https://www.scaleway.com/fr/tarifs/gpu/) est à 2,73 € l'heure, ce qui passe très bien en réunion, et coûte **près de 2 000 € par mois, 24 000 € par an, pour une seule carte**. Chez [Verda](https://verda.com/pricing), opérateur finlandais dont les centres de données sont en Finlande et en Islande, le H100 SXM5 est à 3,25 $ l'heure, avec 8 % de remise sur un an et 25 % sur deux ans.
Le réflexe suivant, c'est de comparer avec l'achat. Un H100 PCIe [se négocie](https://www.cloudzero.com/blog/h100-gpu-cost/) entre 25 000 et 33 000 $ sur le marché, un H100 SXM5 entre 35 000 et 40 000 $. Louer une carte en continu coûte donc son prix d'achat en douze à dix-sept mois selon le modèle et le fournisseur. Et une carte suffit rarement : un serveur à huit H100, dimensionné pour servir correctement un gros modèle, tourne autour de 19 000 $ par mois, soit 228 000 $ par an, quand la machine équivalente s'achète au-delà de 350 000 $. Dix-huit mois de retour sur investissement.
Sur le papier, c'est excellent. Sauf que la comparaison oppose une carte à un service. Le prix d'achat n'inclut ni le data center, ni l'électricité, ni le refroidissement, ni le réseau, ni les équipes qui exploitent l'ensemble. Et l'actif se déprécie vite : un H100 d'occasion se revend 60 à 70 % du neuf pendant que les B200 et B300 arrivent et tirent les prix de location vers le bas. Vous amortissez sur trois ans un matériel dont le loyer équivalent aura baissé avant la fin de la période.
À cette échelle, la location ne fait pas disparaître les six chiffres de l'approche 1 : elle les transforme en loyer annuel.
{/* SLOT PARTENAIRE : Verda. Mention factuelle en place (grille tarifaire publique + localisation UE/EEE). Emplacement prêt pour une citation partenaire enrichie après accord. */}
### 3. Ne monter les GPU que lorsque vous en avez besoin
Vous allumez la machine, ou plutôt un container dans la plupart des cas, vous faites le travail, vous l'éteignez. Certains fournisseurs facturent par tranche de durée utilisée, dix minutes chez Verda par exemple, ce qui veut dire qu'un traitement bouclé en 45 minutes en coûte 50. Beaucoup proposent aussi des tarifs *spot*, sur capacité disponible, à moitié prix.
Deux heures de traitement par nuit font une soixantaine d'heures par mois, soit environ 98 $ en spot, là où la même carte tenue en continu coûte 2 370 $. Facteur vingt-quatre. C'est la meilleure affaire du marché pour du traitement de fond : réindexation documentaire, calcul d'embeddings, classification en masse, extraction sur un stock de PDF.
Pour un service ouvert en journée, oubliez. Démarrer une machine et charger un modèle prend des minutes, et une instance spot peut vous être reprise en cours de route. Personne n'attend cinq minutes que son assistant se réveille.
{/* SLOT PARTENAIRE : Verda (offre spot / à la demande). Emplacement prêt après accord. */}
### 4. Louer de la capacité excédentaire à ceux qui en ont trop
Ceux qui ont choisi l'approche 1 ont des GPU inactifs une partie du temps. Un marché s'est monté pour revendre ces heures creuses, souvent bien en dessous des prix des grands fournisseurs, puisque le matériel est déjà amorti de toute façon.
Cette catégorie couvre deux réalités très différentes. À une extrémité, des acteurs qui en ont fait un service d'entreprise : capacité réservée par contrat, engagement de disponibilité, opérateur identifié, matériel hébergé dans des data centers connus. Vous y accédez comme chez n'importe quel fournisseur cloud, avec une facture et un interlocuteur, mais à un tarif tiré vers le bas par le fait que les cartes existaient déjà.
{/* SLOT PARTENAIRE : Hexa Compute. Emplacement principal de cette section, à insérer ici après accord : c'est le bout "service d'entreprise" du spectre. */}
À l'autre extrémité, le marché de particulier à particulier. [Darkbloom](https://www.darkbloom.dev/), issu d'Eigen Labs, fait tourner de l'inférence sur des Mac Apple Silicon inactifs, avec un chiffrement conçu pour que le propriétaire de la machine ne puisse pas lire ce qui y transite. Le projet est encore expérimental et nous n'y mettrions pas un service critique aujourd'hui. L'idée tient debout : des dizaines de millions de Mac récents dorment une bonne partie de la journée avec beaucoup de mémoire disponible.
Dans les deux cas, regardez qui opère la machine, ce qu'il peut voir, et quel engagement de disponibilité il signe. C'est ce qui sépare une bonne affaire d'un pari.
### 5. Passer par un fournisseur d'inférence
Plus aucune machine à gérer. Vous appelez une API, vous payez au token, et quelqu'un d'autre garde des GPU chauds en permanence pour vous.
Deux familles cohabitent. Les pure players de l'inférence servent des modèles [open weights](https://www.askthisguy.com/fr/blog/open-source-vs-open-weights-ai/) et se battent sur la vitesse et le prix : Cerebras, Groq, DeepInfra, Nebius. Les acteurs grand public, OpenAI, Anthropic, Google, Mistral, servent leurs propres modèles.
La nuance se voit sur la facture. À qualité comparable sur beaucoup de tâches, les premiers sont sensiblement moins chers, parce que les seconds facturent aussi leur notoriété et l'exclusivité de leurs modèles. Comme un même modèle ouvert tourne chez une dizaine de fournisseurs, vous pouvez changer d'avis sans retoucher vos prompts.
Choisissez un acteur qui publie un vrai engagement de service, pas seulement une page de statut. Et prévoyez un repli dès le premier jour.
{/* SLOT PARTENAIRE : Umans. Emplacement prêt, à insérer après accord, dans la famille "pure players". */}
### 6. Mettre une passerelle devant plusieurs fournisseurs
Vous en branchez plusieurs derrière une couche unique, qui mesure leur santé, arbitre selon la vitesse et le prix, et bascule automatiquement quand l'un décroche. C'est ce qu'on appelle une passerelle multi-fournisseurs, ou *AI gateway*.
Aucun fournisseur n'atteint seul les 99,9 %. Mis bout à bout derrière une passerelle qui teste et bascule, on y arrive. Nous avons consacré un article entier au sujet, chiffres et produits du marché compris : [SLA IA entreprise](https://www.askthisguy.com/fr/blog/enterprise-ai-sla/).
{/* SLOT PARTENAIRE : Eden AI. À insérer après discussion sur le périmètre de la réciprocité. Eden AI est déjà cité dans blog/enterprise-ai-sla. */}
### 7. Laisser votre plateforme s'en charger
Vous achetez un produit d'IA d'entreprise et l'inférence devient le problème de quelqu'un d'autre. Aucun GPU à exploiter, pas de passerelle à construire, et la veille sur les modèles ne vous concerne plus.
En échange, vous héritez des choix de votre fournisseur IA. D'où la question à lui poser avant de signer : **est-il capable de décrire sa chaîne d'inférence ?** Quels fournisseurs, dans quelle juridiction, avec quel repli, sous quel engagement de non-entraînement. Celui qui reste vague sur cette partie vous demande de lui faire confiance sur le maillon le plus sensible.
## Les sept approches d'inférence IA comparées
*Lecture : le vert est favorable, le rouge défavorable. Le signe ± marque un critère qui dépend du fournisseur retenu.*
| # | Approche | Modèle de coût | Légèreté d'exploitation | Fiabilité | Souveraineté | Mise en route | Quand c'est le bon choix |
| --- | --- | --- | --- | --- | --- | --- | --- |
| 1 | Acheter les GPU | CAPEX élevé | −−− | ++ | +++ | Mois | Contrainte réglementaire absolue, volume massif |
| 2 | Louer du GPU dédié | OPEX élevé, prévisible | −− | ++ | ++ | Jours | Volume stable, exigence de localisation |
| 3 | GPU à la demande | OPEX à l'usage | − | −− | ++ | Heures | Traitement de fond, batch, pics ponctuels |
| 4 | Capacité excédentaire | OPEX très faible | − | − | ± | Heures | Budget contraint, opérateur vérifié |
| 5 | Fournisseur d'inférence | Au token | ++ | − | ± | Minutes | La majorité des projets |
| 6 | Passerelle multi-fournisseurs | Au token, plus la couche | ++ | +++ | ± | Jours | Dès qu'un vrai niveau de service est attendu |
| 7 | Plateforme clé en main | Abonnement | +++ | +++ | ± | Minutes | Vous achetez un résultat métier |
## En pratique, une entreprise combine souvent plusieurs solutions
Une seule approche peut très bien suffire, et c'est souvent le cas quand le périmètre est clair et les usages homogènes. Mais dès que les cas d'usage se diversifient, les entreprises finissent régulièrement avec deux ou trois régimes différents. Dans un cas comme dans l'autre, partez de votre contrainte la plus dure et laissez le reste s'organiser autour.
Une contrainte réglementaire ne porte presque jamais sur la totalité de votre périmètre. Isolez le cas d'usage réellement sensible sur une infrastructure dédiée, laissez le reste sur du mutualisé. C'est souvent ce découpage qui débloque un budget, parce qu'il ramène l'exigence forte à la part du projet qu'elle concerne vraiment.
Quand c'est la latence qui commande, elle ne commande que l'interactif. Une entreprise que nous accompagnons fait tourner sa réindexation documentaire nocturne sur du GPU à la demande, pour quelques dizaines d'euros par mois, et sert son assistant en journée via un fournisseur d'inférence rapide. Deux régimes de coût, un seul projet.
Et si c'est le budget, commencez par l'approche 5 ou 7, sans hésiter. Six mois d'usage réel vous diront si l'internalisation a le moindre sens. Elle est presque toujours plus chère que prévu, et personne ne s'en rend compte avant d'avoir les chiffres sous les yeux.
Pour fixer les ordres de grandeur, voici le même H100 vu sous trois angles :
| Accès à un H100 | Coût | Base de calcul |
| --- | --- | --- |
| Achat | ~30 000 $, soit ~26 000 €, la carte seule | Prix marché PCIe et SXM5 |
| Location dédiée, 24/7 | ~2 000 € par mois | Scaleway, 2,73 €/h × 730 h |
| À la demande, 2 h par nuit | ~98 $ par mois | Verda spot, 1,63 $/h × 60 h |
Le matériel est identique dans les trois cas, seul le régime d'usage change.
Combien de temps faut-il louer avant d'avoir dépensé le prix de la carte ? En continu, à 2 000 € par mois, il vous faut **treize mois** pour atteindre les 26 000 € d'achat. Sur le régime à la demande, à 85 € par mois, il vous en faut **plus de vingt-cinq ans**.
C'est là que se joue la décision, et pas ailleurs. L'achat ne devient intéressant que si vous savez que la machine tournera vraiment en continu, pendant plusieurs années, sur des volumes que vous avez déjà mesurés.
## Chez Ask This Guy
Aujourd'hui, nos clients sont dans le cas 7. Ils n'opèrent aucun GPU, ne construisent aucune passerelle, et l'inférence ne figure pas à leur budget.
Ça ne tient que parce que nous panachons nous-mêmes les approches 2, 3 et 5. Nous montons nos propres infrastructures GPU chez Verda, en Finlande et en Islande, où nous déployons et opérons certains modèles, et nous consommons en parallèle des fournisseurs d'inférence sélectionnés derrière notre [passerelle de fournisseurs IA](https://www.askthisguy.com/fr/doc/infrastructure-and-security/ai-providers/). Vous placez ensuite le curseur, politique UE uniquement ou monde entier, modifiable à tout moment depuis la console. Tout est public dans notre [approche de l'IA souveraine](https://www.askthisguy.com/fr/doc/infrastructure-and-security/sovereign-ai/).
Si nous écrivons cet article, c'est que les arbitrages décrits ici, nous les avons payés.
### Bring Your Own AI : branchez votre propre inférence
Le cas 7 ne devrait pas être une impasse. Si vous avez déjà des GPU, un contrat chez un fournisseur d'inférence ou votre propre passerelle, vous devez pouvoir les brancher plutôt que de les mettre au rebut.
C'est ce que permet notre mode **Bring Your Own AI** : connecter vos propres modèles, vos fournisseurs ou vos points d'inférence à la plateforme. Il est disponible **aujourd'hui sur demande**, et sera bientôt proposé en standard.
Concrètement, les six autres approches restent ouvertes. Des GPU achetés l'an dernier se branchent. Un tarif négocié chez un fournisseur d'inférence se conserve. Et si vous préférez démarrer clé en main pour internaliser dans dix-huit mois, une fois vos volumes réellement connus, vous n'aurez pas à changer d'outil en route.
## Questions fréquentes sur l'inférence IA
### Qu'est-ce que l'inférence en IA ?
L'inférence est la phase où un modèle d'intelligence artificielle déjà entraîné traite une requête et produit une réponse. Elle s'oppose à l'entraînement, qui est la phase d'apprentissage du modèle. Pour une entreprise, l'entraînement est un coût rare et souvent inexistant, alors que l'inférence est un coût récurrent proportionnel à l'usage réel du service.
### Combien coûte l'inférence d'un LLM en entreprise ?
Le coût d'une inférence LLM dépend entièrement de l'approche retenue. En location de GPU dédié, un H100 tenu en continu revient à environ 2 000 à 2 400 € par mois, soit près de 24 000 € par an pour une seule carte, et un serveur à huit cartes dépasse 200 000 € par an. En passant par un fournisseur d'inférence facturé au token, un assistant interne pour quelques centaines d'utilisateurs se chiffre le plus souvent en centaines d'euros par mois. L'écart entre les deux modèles justifie de mesurer ses volumes réels avant d'internaliser.
### Faut-il acheter des GPU pour faire de l'IA en entreprise ?
Dans la grande majorité des cas, non. L'achat de GPU se justifie quand une contrainte réglementaire interdit toute sortie des données, quand le volume est massif et stable, et quand une équipe infrastructure existe déjà pour exploiter le matériel. En dehors de ces conditions, la location ou le recours à un fournisseur d'inférence coûte moins cher et se met en place en quelques minutes plutôt qu'en quelques mois.
### Qu'est-ce qu'une infrastructure IA ?
Une infrastructure IA regroupe tout ce qui permet d'exécuter des modèles d'intelligence artificielle : les GPU, les serveurs qui les hébergent, le réseau, le stockage, et la couche logicielle qui sert les modèles. En entreprise, la question n'est pas seulement de savoir quels composants choisir, mais qui les exploite : vous, un fournisseur cloud, un fournisseur d'inférence, ou l'éditeur de votre plateforme.
### Quelle différence entre un fournisseur d'inférence et une API gateway ?
Un fournisseur d'inférence exécute lui-même les modèles sur ses propres GPU et vous facture les tokens consommés. Une API gateway, ou passerelle multi-fournisseurs, n'exécute aucun modèle : elle se place devant plusieurs fournisseurs, mesure leur disponibilité et leur vitesse, et bascule automatiquement de l'un à l'autre. On utilise généralement les deux ensemble, la passerelle servant à obtenir un niveau de service qu'aucun fournisseur n'atteint seul.
---
## Conclusion
Votre projet d'IA vous obligera à trancher la question de l'inférence, et probablement dès le chiffrage du budget. Vous pouvez bâtir votre propre infrastructure IA, tout déléguer, ou assembler quelque chose entre les deux.
Les projets qui tiennent en production ne sont pas ceux qui ont choisi le bon camp. Ce sont ceux qui savaient qu'il y en avait sept.
L'inférence se paie tous les mois, pour toute la durée de vie du service.
Partez de votre contrainte la plus dure, le reste s'organise autour.
Si vous préparez un projet d'IA et que vous voulez confronter votre cas d'usage à ces arbitrages : **[réservez une démo](https://www.askthisguy.com/fr/demo/)**.
---
# Agent IA en entreprise : cas d'usage et coûts réels
URL: https://www.askthisguy.com/fr/blog/enterprise-ai-agents/
Language: fr
Section: Blog
Depuis dix-huit mois, tout le monde vous parle d'**agents IA**. Les démonstrations sont impressionnantes : on pose une question, l'IA consulte trois outils, recoupe, agit et rend un résultat propre. Puis vous essayez de reproduire ça sur vos propres processus, et le sol se dérobe.
La technologie marche. Entre la démo et un **agent IA en entreprise** qui tourne tous les jours, il y a une liste de sujets qu'on n'aborde jamais en kick-off : la mission exacte de l'agent, les cas limites, la part du travail qu'il ne faut surtout pas confier à un modèle, la façon dont on vérifie le résultat, et le nom de la personne qu'on appellera quand l'agent se trompera un vendredi à 18 h.
Ce sont eux qui décident du sort d'un projet, et on va les prendre un par un : la méthode qui sépare une démo d'une production, les six agents que nous mettons en service chez nos clients, et les prix.
**En une phrase.** Un agent IA est un modèle de langage placé dans une boucle, équipé d'outils et d'un objectif, qui décide lui-même de la séquence d'actions à mener, observe le résultat de chaque action et recommence jusqu'à atteindre son but.
## Ce qu'on appelle un agent IA
La définition tient en quatre briques. Un agent, c'est :
1. **Un modèle de langage**, qui comprend la demande et raisonne.
2. **Des outils**, c'est-à-dire des fonctions que le modèle peut déclencher : `chercher_client`, `lire_facture`, `creer_ticket`, `envoyer_rapport`. Chaque outil est décrit au modèle, qui choisit lequel appeler et avec quels paramètres.
3. **Une boucle**. À chaque tour, l'agent regarde où il en est, décide de l'action suivante, l'exécute, observe le résultat, recommence. C'est cette itération qui lui permet de se corriger.
4. **Un périmètre** : ce qu'il a le droit de faire, sur quelles données, avec quelles limites, et éventuellement un budget en temps ou en tokens.
```mermaid
flowchart LR
O[Objectif] --> M[Modèle
décide de l'action suivante] M --> T[Outils
lire, calculer, écrire, envoyer] T --> R[Résultat observé] R --> V{Objectif atteint ?} V -- Non --> M V -- Oui --> F[Réponse ou action finale] P[Périmètre
droits, limites, budget] --- M ```
Le schéma montre la boucle d'un agent : à partir d'un objectif, le modèle choisit une action, l'exécute via un outil, observe le résultat et recommence tant que l'objectif n'est pas atteint. Le périmètre, rattaché au modèle, borne en permanence ce que l'agent a le droit de faire.
Un agent est donc un modèle placé au centre d'un système logiciel qui l'encadre. Rien de plus. Le protocole **MCP** (Model Context Protocol) a beaucoup simplifié la brique outils : au lieu de redévelopper chaque intégration pour chaque agent, on expose une fois un serveur que n'importe quel agent peut consommer. Nous détaillons ce mécanisme dans notre article sur [MCP et l'intégration d'outils](https://www.askthisguy.com/fr/blog/how-mcp-accelerate-agentic-ai/). > Un agent n'est pas plus intelligent qu'un modèle seul. Il est simplement autorisé à agir plusieurs fois, avec des outils. Toute sa valeur vient de ce que vous branchez au bout. ## Un agent, c'est un chatbot équipé d'outils On oppose souvent chatbot et agent. Un agent, c'est un chatbot auquel on a donné des outils. Le reste est une question de degré : la nature des outils et ce qu'ils ont le droit de faire. Chez Ask This Guy, **tout est agent**. Le même socle porte l'assistant qui répond à une question RH et celui qui met à jour une fiche client dans votre SaaS. | Niveau | Ce que l'agent sait faire | Outils typiques | | --- | --- | --- | | Répondre | Questions générales, reformulation, rédaction | Aucun | | Répondre sur vos données | Procédures, contrats, historique projet | Recherche documentaire ([RAG](https://www.askthisguy.com/fr/blog/rag-tutorial/)), requête SQL en lecture | | Consulter vos systèmes | État réel d'un dossier, d'un stock, d'un ticket | API métier en lecture, serveurs MCP | | Agir | Créer, modifier, envoyer, clôturer | API métier en écriture, envoi d'e-mail | | Orchestrer | Enchaîner plusieurs étapes vers un objectif | Combinaison des précédents, validation humaine | Ce tableau est une gradation, pas une typologie de produits. Un [assistant interne](https://www.askthisguy.com/fr/blog/internal-company-chatbot/) commence souvent au deuxième niveau, puis descend le tableau au fil des mois, à mesure que la confiance s'installe et que les outils s'ajoutent. Et les outils ne sont pas forcément génériques. Ils peuvent être très spécialisés, et contenir eux-mêmes de l'intelligence : un extracteur adapté à vos documents contractuels, un contrôleur de cohérence qui applique vos règles métier, un générateur de rapport au format que vos clients attendent. Nous en développons régulièrement sur mesure, et le code de ces [outils spécifiques](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools) vous appartient. Ce qui change vraiment entre le haut et le bas du tableau, c'est la nature du risque. Un agent qui se trompe en répondant produit une phrase imprécise que l'utilisateur peut ignorer. Un agent qui se trompe en agissant crée une ligne dans votre ERP ou envoie un e-mail à un client. **C'est ce niveau de risque qui doit gouverner la conception.** L'étiquette qu'on colle au produit n'a aucune importance. ## L'IA n'est jamais déterministe : c'est le point de départ de la conception Un modèle de langage est **probabiliste**. Deux fois la même entrée peuvent donner deux sorties différentes. Un algorithme, lui, est déterministe : la même entrée donne toujours la même sortie, et vous pouvez le prouver. Sur une tâche donnée, un logiciel classique sera toujours plus fiable qu'un modèle, surtout si la tâche est simple. D'où la règle que nous appliquons partout : **toute tâche qu'un algorithme sait faire doit être faite par l'algorithme.** - Vérifier qu'une adresse e-mail est valide, ou qu'une adresse postale existe : c'est une regex et un appel à une base d'adresses, pas une question à poser à une IA. - Calculer un total, appliquer un barème, contrôler qu'une somme de lignes correspond au pied de facture : du code. - Interroger une base : plutôt qu'un modèle qui écrit du SQL libre, un outil paramétré, avec des requêtes cadrées, des droits explicites et un jeu de paramètres que le modèle se contente de remplir. C'est plus fiable, moins cher, et le modèle ne peut pas écrire une requête que vous n'aviez pas prévue. Le modèle garde ce qu'il est le seul à savoir faire : comprendre du langage, lire un document non structuré, arbitrer entre plusieurs chemins selon le contexte, rédiger. C'est déjà énorme. Cette discipline n'est pas cosmétique, elle est arithmétique. Imaginez un agent qui enchaîne dix étapes. Si chaque étape réussit dans 95 % des cas, la probabilité que les dix réussissent est de 0,9510, soit environ **60 %**. Le calcul est volontairement simpliste, mais l'ordre de grandeur est le bon : chaque étape confiée au modèle multiplie le risque, alors qu'une étape confiée à du code le laisse intact. Nous avons développé cette logique dans notre article sur l'[automatisation IA minimale](https://www.askthisguy.com/fr/blog/use-minimal-ai-automation/). ## Définir la mission de l'agent Un agent qui marche est presque toujours un agent dont la mission a été écrite correctement, et ça se décide bien avant le choix du modèle. Commencez par un objectif, pas par une intention. « Traiter les factures fournisseurs », ce n'est pas un objectif. « Pour chaque facture reçue sur la boîte compta, extraire les dix champs de la liste, vérifier la correspondance avec le bon de commande, créer l'écriture si tout concorde et déposer dans la file d'attente humaine sinon », ça en est un. Écrivez les cas limites noir sur blanc, un par un. Que fait l'agent si le document est illisible, si le fournisseur est inconnu, si la facture est un avoir, si le montant dépasse un seuil, si deux bons de commande correspondent ? Ces questions n'ont pas de bonne réponse par défaut : elles ont votre réponse. Un agent à qui personne ne les a posées inventera une moyenne plausible, et une moyenne plausible fait plus de dégâts qu'une erreur franche. Nous demandons systématiquement une vingtaine de cas réels, pris tels quels, y compris les moches : le scan de travers, le contrat avec l'avenant manuscrit, le fichier client mal renseigné. C'est sur ceux-là que se conçoit l'agent. L'échantillon propre que tout le monde propose en premier ne sert à rien. Enfin, pour chaque cas, quelqu'un doit pouvoir dire si la sortie est bonne ou mauvaise. Si personne ne sait trancher, vous ne pourrez ni évaluer l'agent ni le laisser tourner seul. ## Mettre l'agent sous contrôle Un agent se met sous contrôle à trois niveaux, tous à prévoir dès la conception. **Les vérifications dans la boucle.** À chaque étape sensible, un contrôle déterministe : le champ extrait a-t-il le bon format, la référence existe-t-elle vraiment dans la base, le total est-il cohérent. Quand un contrôle échoue, l'agent recommence ou passe la main. C'est ce qui fait remonter les 60 % de tout à l'heure à un niveau exploitable. **L'évaluation avant chaque mise en production.** Un jeu de cas de référence, avec le résultat attendu, rejoué à chaque changement de prompt, d'outil ou de modèle. Vous faites évoluer l'agent sans repartir en phase de test manuel, et vous voyez une régression avant vos utilisateurs. Reste le suivi une fois en production, et c'est celui qu'on abandonne le plus vite. Taux de traitement automatique, taux de reprise humaine, coût par exécution, latence, cas signalés comme incertains par l'agent lui-même. Un agent qu'on ne surveille pas ne casse pas bruyamment : il devient silencieusement moins juste, pendant que vos formats de fichiers changent et que les modèles évoluent sous vos pieds. Ajoutez un humain dans la boucle sur les actions irréversibles et sur les cas que l'agent signale lui-même comme douteux. Le mettre partout ferait disparaître l'intérêt de l'agent. ## Six agents que nous mettons en production Tous les six tournent chez des clients en ce moment. ### Agir dans un SaaS depuis la conversation Un outil métier est équipé d'un agent capable de le modifier. L'utilisateur écrit « crée ce client avec ces informations » ou « passe le dossier en statut traité, je viens de faire l'intervention », et l'agent exécute l'action dans l'application, avec les droits de la personne qui parle. On supprime dix clics et trois écrans, et on capte l'information au moment où elle existe, pas trois jours plus tard. ### Traiter des documents spécialisés Des documents métier arrivent : bons de commande, formulaires administratifs, contrats, comptes rendus, pièces réglementaires. L'agent en extrait les bonnes informations, applique vos règles de contrôle, enrichit avec vos référentiels, alimente la base et signale ce qui sort du cadre. C'est le cas d'usage le plus rentable, parce que le volume est là et que la règle est explicite. Un bon de commande client ou un formulaire Cerfa se traitent très bien ainsi : le format varie d'un émetteur à l'autre, mais les champs attendus, eux, ne bougent pas. ### Générer des rapports personnalisés à partir de fichiers d'entrée Vos clients ou vos équipes déposent des fichiers. L'agent les analyse, applique vos règles de calcul et votre grille de lecture, produit un rapport au format attendu et l'envoie par e-mail aux bons destinataires. La personne qui y passait une demi-journée le relit maintenant en vingt minutes. ### Qualifier un lead et alerter le commerce Tout commence par une conversation banale sur le [chatbot de votre site web](https://www.askthisguy.com/fr/solutions/website-chatbot/). Un visiteur pose une question sur une offre, l'agent répond depuis votre contenu, puis enchaîne sur le contexte, la taille de l'entreprise, l'échéance. Quand les signaux d'un vrai lead sont réunis, il envoie dans la foulée un e-mail à l'équipe commerciale, avec le verbatim de la conversation, la qualification et l'action recommandée. Rappel dans l'heure au lieu du surlendemain. Nous avons décrit ce mécanisme en détail dans notre article sur les [leads qualifiés via le chatbot de site](https://www.askthisguy.com/fr/blog/qualified-leads-website-chatbot/). Le même schéma vaut pour un ticket de support ou une demande interne : l'agent recoupe avec le CRM ou la base de connaissances, classe, priorise et route vers la bonne personne avec un résumé déjà rédigé. ### Réconcilier et surveiller Comparer deux référentiels qui devraient dire la même chose, détecter les écarts, produire la liste des anomalies avec un diagnostic. Personne n'aime faire ça à la main, et personne ne le fait aussi régulièrement qu'il le faudrait. ### Anticiper, en combinant machine learning et veille Certains agents servent à prévoir plutôt qu'à réagir. C'est là que la répartition entre logiciel et modèle se voit le mieux. Prenons la gestion des stocks et des flux, dans la distribution ou l'industrie. La prévision elle-même relève du **machine learning classique** : un modèle statistique entraîné sur votre historique de ventes, vos saisonnalités et vos délais fournisseurs prévoit la demande bien mieux qu'un modèle de langage, et de façon reproductible. L'agent apporte deux choses que le modèle statistique ne sait pas faire. Il intègre le contexte non structuré, une veille sur vos fournisseurs, un mouvement social annoncé, une actualité réglementaire, un lancement concurrent. Et il traduit la prévision en action lisible, en signalant les références à risque de rupture ou de surstock avec l'explication associée. Le déterministe calcule, le modèle interprète et rédige. ## Les cas d'usage qui échouent, et pourquoi Autant être direct : certains projets ne devraient pas démarrer, et il nous arrive d'en écarter. - **Le processus n'est pas écrit.** Si personne ne sait le décrire en dix lignes, l'agent ne l'inventera pas. - **Le résultat n'est pas vérifiable.** Sans critère de succès, pas d'évaluation, donc pas d'autonomie possible. - **Le volume est faible et les cas sont tous différents.** Vingt dossiers par mois, tous atypiques : le coût de conception ne sera jamais amorti. - **L'action est irréversible et non supervisée.** Virement, envoi client, suppression de données. Techniquement possible, opérationnellement imprudent tant que l'agent n'a pas fait ses preuves. ## Combien coûte un agent IA en entreprise ? Le **coût d'un agent IA** se décompose en trois postes. ### 1. La conception et le développement C'est le poste dominant. Il couvre la formalisation de la mission, le développement des outils, les connecteurs vers vos systèmes, la gestion des droits, les tests sur cas réels, le jeu d'évaluation et le passage en production. Chez Ask This Guy, un agent **production-ready** se situe classiquement **entre 2 000 et 5 000 €** de développement. On parle d'un agent branché sur vos systèmes, avec ses droits, ses vérifications, sa journalisation et sa supervision, qui traite vos vrais dossiers dès le premier jour, pas d'un POC de démonstration. Le prix dépend fortement de la complexité, mais il reste dans cet ordre de grandeur parce que nous ne partons jamais de zéro : la plateforme apporte déjà les connecteurs, l'ingestion documentaire, la gestion des droits, le catalogue d'outils MCP, la journalisation et le socle LLMOps. Le travail spécifique porte sur votre règle métier, pas sur la plomberie. Deux comparaisons utiles : - **Tout reconstruire de zéro** se compte en dizaines de milliers d'euros, l'essentiel partant dans ce qui n'a aucune valeur métier pour vous. - **Faire poser votre automatisation sur une plateforme tierce grand public** (les outils de type no-code d'orchestration) coûte moins cher à l'entrée, mais pose un problème de pérennité. Ces plateformes évoluent très vite. Le jour où l'une d'elles change son fonctionnement, votre automatisation s'arrête et vous repayez le prestataire. Et par construction, un prestataire qui ne maîtrise pas la plateforme sur laquelle il construit ne peut pas s'engager sur un SLA. ### 2. Le coût d'exécution C'est le coût en tokens, et il n'obéit à aucune règle générale : tout dépend de ce que fait l'agent. Un agent qui traite 500 dossiers par mois, avec environ 30 000 tokens par dossier en comptant les allers-retours d'outils, coûte quelques dizaines d'euros mensuels sur un modèle de milieu de gamme. À l'inverse, une analyse à contexte long, un raisonnement poussé ou un volume important changent complètement l'ordre de grandeur, et un agent mal conçu qui boucle sans garde-fou peut multiplier la note par dix. C'est donc un poste à estimer cas par cas. Chez nous, il est **forfaitaire et connu d'avance** : vous savez ce que coûte l'agent avant de le mettre en service, et une dérive de consommation est notre problème, pas le vôtre. ### 3. La maintenance et l'industrialisation Le poste que tout le monde oublie, et celui qui casse le plus de projets. Vos outils évoluent, vos règles changent, un fournisseur modifie un format, un modèle est déprécié et son remplaçant ne se comporte pas exactement pareil. Il faut donc du LLMOps, de la supervision, un jeu d'évaluation rejouable et une veille sur l'obsolescence des modèles. Nous intégrons ces éléments dans notre offre plutôt que de les facturer au coup par coup. Un agent livré sans eux est une démo avec une date de péremption, et c'est aussi ce qui rend un engagement de service tenable dans la durée, sujet que nous traitons dans notre article sur le [SLA d'une IA en entreprise](https://www.askthisguy.com/fr/blog/enterprise-ai-sla/). ### Le ROI, systématiquement calculé Nous ne démarrons pas un projet sans avoir posé le calcul : temps gagné mensuel contre coût total de possession sur un an. **Visez un retour sur investissement en moins de six mois, idéalement en moins de trois.** Avec des développements dans la fourchette 2 000 à 5 000 € et des automatisations qui économisent couramment une vingtaine d'heures par mois à l'équipe concernée, l'objectif est atteignable dans la grande majorité des cas. Si ça ne l'est pas sur le vôtre, mieux vaut le savoir avant de commencer que six mois plus tard. ## S'engager sur le résultat Un dernier point, qui vous servira surtout à choisir un prestataire. Nous nous engageons sur le résultat et sur un prix forfaitaire, mais seulement après avoir regardé vos exemples réels et compris votre processus et votre attendu. Dans l'autre ordre, l'engagement ne vaudrait rien. **Privilégiez une entreprise qui procède de la même façon.** Un prestataire qui vend un agent en régie, sans avoir vu vos cas réels et sans s'engager sur un résultat mesurable, vous transfère l'intégralité du risque. Vu de l'extérieur, un bon et un mauvais agent se ressemblent beaucoup en démonstration. Ils ne se ressemblent plus du tout au bout de trois mois. ## L'approche Ask This Guy Nous construisons des agents sur une plateforme qui porte déjà les briques communes, ce qui nous permet de concentrer le budget sur votre métier. Trois choix guident notre pratique : - **Commencer petit et mesurable.** Un workflow, un gain chiffré, une mise en production rapide. L'ambition vient après la preuve. - **Rester souverain.** Hébergement européen, possibilité de restreindre les traitements aux fournisseurs de droit européen, aucun entraînement sur vos données. Le sujet est détaillé sur notre page [IA souveraine](https://www.askthisguy.com/fr/ia-souveraine/). - **Vous laisser partir.** Les développements réalisés pour vous, vos configurations et vos connecteurs vous appartiennent. La réversibilité fait partie du contrat. Pour voir ce que cela donne concrètement, notre page [IA agentique et automatisation](https://www.askthisguy.com/fr/solutions/agentic-automation/) détaille les workflows types et leurs coûts. ## Questions fréquentes sur les agents IA en entreprise ### Qu'est-ce qu'un agent IA en entreprise ? Un agent IA d'entreprise est un modèle de langage placé dans une boucle, équipé d'outils et d'un objectif métier. Il choisit lui-même la séquence d'actions à mener, exécute ces actions dans vos systèmes via ses outils, observe le résultat et recommence jusqu'à atteindre son but ou constater qu'il n'y arrivera pas. Techniquement, c'est un modèle de langage encadré par du logiciel. ### Quelle différence entre un agent IA et un chatbot ? La différence est dans l'équipement : un agent est un chatbot à qui on a donné des outils. Un chatbot sans outil se contente de répondre. Dès qu'on lui branche une recherche documentaire, une base de données ou une API métier, il peut consulter puis agir. La frontière qui compte se situe entre lecture et écriture : à partir du moment où l'IA modifie quelque chose dans vos systèmes, les exigences de fiabilité, de droits et de traçabilité changent d'échelle. ### Quelles tâches ne faut-il jamais confier au modèle dans un agent ? Toutes celles qu'un algorithme sait faire. Un modèle est probabiliste, un algorithme est déterministe et donc plus fiable. Valider un format d'e-mail, vérifier l'existence d'une adresse, calculer un total, appliquer un barème, exécuter une requête en base : tout cela doit passer par du code ou par un outil paramétré. Le modèle garde la compréhension du langage, la lecture de documents non structurés, l'arbitrage contextuel et la rédaction. ### Combien coûte un agent IA pour une entreprise ? Le développement d'un agent production-ready se situe classiquement entre 2 000 et 5 000 € lorsqu'on s'appuie sur une plateforme existante, et bien au-delà si l'on repart de zéro. S'y ajoutent le coût d'exécution en tokens, très variable selon la tâche et donc à estimer cas par cas, et la maintenance : LLMOps, supervision, évaluation rejouable et gestion de l'obsolescence des modèles. Chez Ask This Guy, l'ensemble est forfaitaire et connu avant la mise en service. ### En combien de temps un agent IA est-il rentabilisé ? L'objectif à poser avant de démarrer est un retour sur investissement en moins de six mois, et il est fréquemment atteint en moins de trois. Le calcul est simple : temps gagné mensuel multiplié par le coût horaire chargé, comparé au coût de développement et de maintenance sur un an. Si le calcul ne tient pas, le projet ne doit pas démarrer. ### Un agent IA peut-il accéder à nos données sensibles ? Il n'accède qu'à ce que vous lui donnez. La bonne pratique est de faire hériter l'agent des permissions de l'utilisateur qui le déclenche, ou de lui attribuer un compte de service au périmètre explicitement limité, et de journaliser chaque accès. Un agent qui a un accès global à votre système d'information est un risque. ### Combien de temps pour mettre un agent en production ? Quelques jours pour un premier workflow simple sur une plateforme existante. Quelques semaines si les connecteurs sont à créer, si les règles métier doivent être formalisées, ou si le processus touche des actions irréversibles nécessitant une validation humaine. --- ## Ce qu'il faut retenir Un agent IA, c'est un chatbot équipé d'outils, autorisé à agir dans un périmètre que vous définissez. Sa valeur vient de la qualité de sa mission, de ses outils et de ses vérifications, beaucoup plus que du modèle lui-même. Les projets qui réussissent partagent le même profil : une mission écrite avec ses cas limites, des exemples réels dès la conception, tout ce qui peut être fait par un algorithme confié à un algorithme, un jeu d'évaluation rejouable, un suivi en production, et un ROI posé avant de commencer. Vous avez un processus manuel en tête ? [Réservez une démo](https://www.askthisguy.com/fr/demo/) : en 30 minutes, nous vous dirons s'il est automatisable, à quel coût, et avec quel gain attendu. --- # Chatbot interne entreprise : bien cadrer votre projet URL: https://www.askthisguy.com/fr/blog/internal-company-chatbot/ Language: fr Section: Blog Dans la plupart des entreprises, l'information existe. Elle est écrite, quelque part. Le problème n'est pas qu'elle manque, c'est que **personne ne sait où elle est**, ou que la seule personne qui sait est en congés. Alors les collaborateurs font ce qu'ils ont toujours fait : ils demandent à un collègue. Une question qui aurait pris trente secondes à un moteur de recherche efficace mobilise deux personnes pendant dix minutes, et la réponse obtenue n'est pas forcément la bonne version. C'est ce qu'un **chatbot interne entreprise** est censé régler. Encore faut-il savoir ce qu'on construit : la moitié des projets qui portent ce nom fabriquent en réalité autre chose. **En une phrase.** Un chatbot interne est un assistant conversationnel réservé aux collaborateurs, branché sur les sources documentaires de l'entreprise, qui répond aux questions internes en citant les documents dont il tire sa réponse. ## Chatbot interne, chatbot de site : même outil, deux projets différents C'est la confusion à lever en premier, parce qu'elle décide du budget comme des critères de réussite. Un **chatbot de site web** parle à vos visiteurs. Il répond à des questions publiques, qualifie des prospects, oriente vers un commercial. Son corpus est petit et vous l'avez écrit vous-même, ses réponses sont validées à l'avance, et le risque principal est commercial : mal répondre, c'est perdre un lead. Un **chatbot interne** parle à vos collaborateurs. Il répond à partir de vos procédures, contrats, comptes rendus, documentation technique et politiques RH. Son corpus est vaste, hétérogène, mal rangé, et surtout **soumis à des droits d'accès différenciés**. Le risque principal est la confidentialité : mal répondre, c'est exposer un document à quelqu'un qui n'aurait pas dû le voir. | | Chatbot de site | Chatbot interne | | --- | --- | --- | | Public | Visiteurs, prospects | Collaborateurs | | Corpus | Petit, public, curé | Vaste, privé, hétérogène | | Droits d'accès | Uniformes | Différenciés par personne | | Objectif | Convertir, orienter | Retrouver, décider, gagner du temps | | Risque principal | Manque à gagner | Fuite d'information interne | | Mesure du succès | Leads qualifiés | Temps de recherche évité | L'architecture, elle, peut être la même : même moteur, même socle RAG, même interface. Nous recommandons d'ailleurs de partir sur un seul outil, pour éviter d'en administrer deux. Ce qui change, c'est le corpus, les instructions données au modèle et la façon dont on suit les réponses. Un prestataire qui vous propose le même corpus et les mêmes instructions pour les deux usages se trompe de projet. Nous traitons le premier cas dans notre article sur le [chatbot de site et la génération de leads](https://www.askthisguy.com/fr/blog/qualified-leads-website-chatbot/). ## Ce qui fait fonctionner un chatbot interne : le RAG Un modèle de langage généraliste connaît le monde, pas votre entreprise. Interrogé sur votre politique de note de frais, il produira une réponse plausible et fausse, ce qui est le pire des cas. La réponse technique s'appelle le **RAG** (Retrieval Augmented Generation). À chaque question, le système cherche d'abord les passages pertinents dans vos propres sources, puis les transmet au modèle qui rédige sa réponse à partir de ces éléments, en citant d'où ils viennent. Le modèle ne « sait » rien de votre entreprise : il lit, à la demande, ce qu'on lui donne à lire. 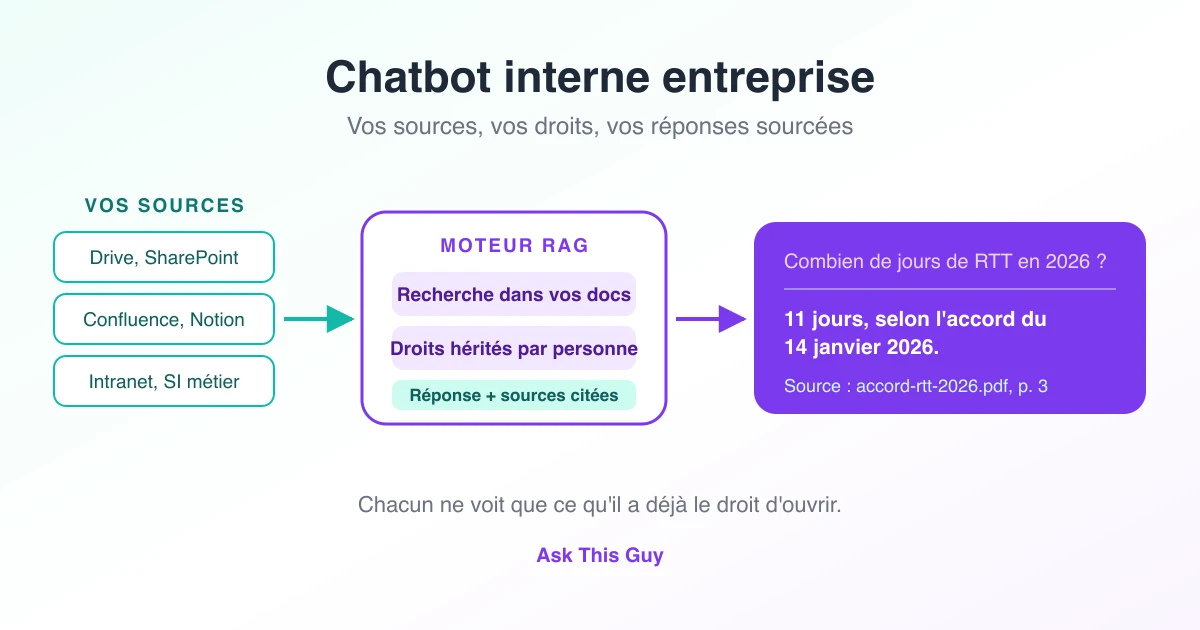 Nous détaillons [comment fonctionne le RAG en IA](https://www.askthisguy.com/fr/blog/rag-tutorial/) dans notre guide dédié. Trois conséquences, dans la pratique : - **La qualité des réponses dépend d'abord de l'ingestion**, pas du modèle. Un PDF scanné mal converti ou mal découpé produira des réponses médiocres avec n'importe quel LLM. - **Les sources citées font partie de la réponse.** C'est ce qui permet à l'utilisateur de vérifier, et donc de faire confiance. Un chatbot interne sans citations n'est plus ouvert au bout de quelques semaines. - **Les droits d'accès doivent être appliqués à la recherche**, pas au moment de l'affichage. Si le système retrouve un document confidentiel puis décide de ne pas le montrer, l'information a déjà fuité dans la réponse générée. ### Élargir ce que chacun consulte réellement Un effet que personne n'anticipe, et dont les utilisateurs parlent beaucoup : **le RAG élargit le corpus dans lequel travaille chaque collaborateur**. Au quotidien, chacun se sert des quelques dizaines de documents qu'il connaît et retourne toujours dans les mêmes dossiers. Le reste existe mais n'est jamais ouvert : la note juridique produite par une autre entité, le compte rendu d'un projet voisin, la fiche produit mise à jour le mois dernier. Un assistant qui cherche dans l'ensemble du corpus auquel l'utilisateur a droit ramène ces documents dans la réponse, avec leur source. L'utilisateur découvre ce qu'il ne savait pas qu'il fallait chercher. Le même raisonnement vaut pour les données. Une partie de l'information utile ne vit pas dans des documents mais dans le CRM, l'ERP, le ticketing ou l'outil de gestion de projet, que la plupart des collaborateurs ne consultent jamais : trop d'écrans, et trop de droits à demander pour une seule question. En branchant l'assistant sur ces systèmes via une [requête en base de données](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/database-query), des [outils sur mesure](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools) ou des [serveurs MCP](https://www.askthisguy.com/fr/doc/admin-console/tools-management/mcp-servers), une même réponse peut croiser la procédure écrite et l'état réel du dossier client, sans que personne n'ait à ouvrir l'ERP. ## Les cas d'usage qui rentabilisent un chatbot interne Les projets qui tiennent visent tous le même type de questions : **fréquentes, et dont la réponse est déjà écrite quelque part**. ### Support aux fonctions transverses RH, juridique, achats, IT. Ce sont les équipes les plus sollicitées pour des questions dont la réponse existe déjà dans un document. Congés, notes de frais, procédure d'achat, clauses standard, réinitialisation d'accès : un chatbot interne absorbe une bonne partie de ce flux et rend du temps à des équipes qui n'en ont jamais assez. ### Onboarding des nouveaux arrivants Les trois premiers mois d'un collaborateur sont une longue série de questions qu'il n'ose pas toujours poser. Un assistant interne raccourcit la montée en autonomie sans mobiliser un tuteur en permanence. ### Documentation technique et produit Équipes d'ingénierie, avant-vente, support. Retrouver la bonne section de la doc, la version applicable d'une spécification, ou un historique de décision technique dans un wiki de plusieurs milliers de pages. ### Réponse aux appels d'offres et aux questionnaires Sécurité, conformité, références clients : les mêmes questions reviennent, les réponses existent dans des documents antérieurs. C'est un des usages où le gain de temps est le plus facile à chiffrer. ### Mémoire des projets Comptes rendus, décisions, arbitrages. « Pourquoi avons-nous choisi ce fournisseur en 2024 ? » est une question à laquelle un chatbot interne bien alimenté répond mieux que la mémoire collective. ## Les cinq erreurs qui font échouer un projet de chatbot interne **1. Tout brancher d'un coup.** L'ambition « on indexe tout le SI » produit un assistant médiocre partout. Commencez par un périmètre où vous savez juger la qualité des réponses : un domaine, une équipe, un corpus. **2. Ignorer les droits d'accès jusqu'à la recette.** C'est le sujet qui fait échouer les projets en fin de parcours, quand la DSI découvre que l'assistant répond à tout le monde à partir de tout. Les permissions doivent être héritées des sources dès la conception. **3. Négliger la qualité documentaire.** Trois versions d'une même procédure, dont deux périmées, et l'assistant citera la mauvaise avec assurance. Un projet de chatbot interne est presque toujours, aussi, un projet de ménage documentaire. **4. Ne pas mesurer.** Deux mesures complémentaires manquent presque toujours. La première est un jeu de questions de référence, rejoué à chaque changement de modèle ou ajout de source : sans lui, vous ne saurez pas si l'assistant s'améliore ou se dégrade. C'est l'objet de l'[évaluation des agents](https://www.askthisguy.com/fr/doc/admin-console/agent-evaluation). La seconde est le retour des utilisateurs : pouce vers le haut ou vers le bas, commentaire libre, sentiment détecté automatiquement dans les conversations, le tout suivi dans la durée et ventilé par thème ou par tag pour repérer les sujets qui décrochent. C'est ce que notre console [Insights](https://www.askthisguy.com/fr/doc/admin-console/insights) rend visible. **5. Négliger l'expérience utilisateur.** Un assistant excellent sur le papier que personne n'ouvre une deuxième fois ne sert à rien. L'adoption se joue sur deux points très simples : une interface qui s'utilise sans mode d'emploi, et des réponses qui arrivent en quelques secondes. Un collaborateur qui attend, qui doit apprendre à formuler ses questions ou qui ne sait pas quoi faire de la réponse retourne chercher lui-même dans le drive, et ne revient pas. ## Faut-il le construire ou l'acheter ? Construire un chatbot interne à partir d'un modèle et d'une base vectorielle est facile, tant qu'il s'agit d'une démonstration. Ce qui coûte cher, c'est tout le reste : les connecteurs vers Google Drive, SharePoint, Confluence et Notion, la synchronisation incrémentale, l'extraction correcte des tableaux et des PDF scannés, la propagation des permissions, la recherche hybride, la citation fiable des sources, l'évaluation de la qualité, la supervision des coûts et le support aux utilisateurs. Nous détaillons ces écueils dans notre article sur les [erreurs classiques d'un RAG en production](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/). Un build interne complet se compte en mois-homme, et il faudra le maintenir aussi longtemps qu'il tournera. Une plateforme qui apporte déjà ces briques réduit le coût total de possession de l'ordre de **80 %** par rapport à un projet mené de bout en bout en interne, et surtout raccourcit le délai avant les premiers usages réels. | Critère | Build interne | Plateforme existante | | --- | --- | --- | | Premier périmètre utile | Plusieurs mois si l'équipe part de zéro | Quelques jours à quelques semaines selon les sources | | Connecteurs et permissions | À construire, tester et maintenir | Briques standard déjà disponibles, adaptations sur les sources spécifiques | | Évaluation des réponses | Dispositif à concevoir | Méthode et suivi déjà intégrés | | Maintenance | À la charge de l'équipe interne | Portée par l'éditeur, avec les évolutions du socle | | Choix pertinent si… | La pile technique constitue un avantage stratégique | La valeur se trouve dans les usages, les règles et les données métier | La question à trancher est donc simple : votre valeur est-elle dans la plomberie, ou dans l'adaptation à vos métiers ? Nous n'avons encore jamais rencontré d'entreprise dont la réponse était la plomberie. ## Et la souveraineté dans tout ça ? Un chatbot interne lit vos documents les plus sensibles : contrats, dossiers RH, éléments financiers, propriété intellectuelle. Savoir où ces contenus sont traités, et par qui, se règle avant la signature. À vérifier avant de signer : - Où sont hébergés les documents, les index vectoriels, les journaux et les sauvegardes. - Quels fournisseurs de modèles sont appelés, depuis quelle juridiction, et si vous pouvez restreindre les traitements aux seuls fournisseurs européens. - Ce qui est réellement transmis au modèle à chaque question : les extraits pertinents, ou le document entier. Nous avons consacré une page complète à ces arbitrages : [IA souveraine, définition et critères](https://www.askthisguy.com/fr/ia-souveraine/). ## L'approche Ask This Guy Nous déployons des assistants internes sur une plateforme qui apporte déjà les connecteurs vers vos sources, l'ingestion documentaire, la recherche hybride, l'héritage des permissions, la citation des sources et la supervision. Le travail spécifique porte alors sur votre vocabulaire, vos règles et vos cas d'usage. Personne ne repart de zéro sur la pile technique. Ce que nous appliquons à chaque déploiement : - **Un périmètre d'abord étroit**, choisi pour que la qualité soit jugeable dès les premières semaines. - **Des permissions héritées de vos sources**, pour que l'assistant ne montre jamais à un collaborateur ce qu'il ne pourrait pas ouvrir lui-même. - **Un hébergement européen** et une politique IA paramétrable, jusqu'à l'option on-premise selon vos contraintes. Notre page [RAG entreprise clé en main](https://www.askthisguy.com/fr/solutions/knowledge-rag/) détaille les connecteurs disponibles et le déroulé d'un déploiement. Si votre sujet dépasse le choix de l'outil, nous traitons le fond dans [Knowledge management : pourquoi vos démarches échouent](https://www.askthisguy.com/fr/blog/knowledge-management-why-it-fails/). ## Questions fréquentes sur le chatbot interne en entreprise ### Qu'est-ce qu'un chatbot interne en entreprise ? Un chatbot interne est un assistant conversationnel réservé aux collaborateurs d'une entreprise. Connecté aux sources documentaires internes (drives, intranet, wikis, outils métier), il répond aux questions professionnelles à partir de ces documents et cite ses sources, plutôt que de s'appuyer sur des connaissances générales issues du web. ### Quelle différence entre un chatbot interne et un chatbot de site web ? Le chatbot de site s'adresse à des visiteurs externes, sur un corpus public et restreint, avec un objectif commercial. Le chatbot interne s'adresse aux collaborateurs, sur un corpus privé et vaste, avec des droits d'accès différenciés par personne. L'outil peut être le même, mais le corpus, les instructions, les risques et les critères de réussite diffèrent complètement. ### Un chatbot interne peut-il respecter les droits d'accès de chaque collaborateur ? Oui, à condition que les permissions soient héritées des sources et appliquées au moment de la recherche, et non filtrées après coup à l'affichage. Chaque utilisateur ne doit obtenir de réponses qu'à partir des documents qu'il pourrait ouvrir lui-même dans l'outil d'origine. ### Combien de temps pour déployer un chatbot interne ? Quelques jours pour un premier périmètre sur une plateforme existante avec des connecteurs standards. Quelques semaines si les sources sont hétérogènes, si la qualité documentaire doit être reprise, ou si des connecteurs spécifiques sont à développer. Un build complet en interne se compte plutôt en mois. ### Sur quelles sources un chatbot interne peut-il s'appuyer ? Les sources habituelles sont Google Drive, SharePoint et OneDrive, Confluence, Notion, Slack, les sites et intranets, les dépôts de fichiers ou FTP, et les bases de données métier. Le nombre de connecteurs compte moins que la qualité de l'ingestion : découpage, extraction des tableaux, gestion des PDF scannés et synchronisation des mises à jour. ### Quel est le retour sur investissement d'un chatbot interne ? Il se mesure en temps de recherche évité et en sollicitations évitées sur les fonctions transverses. L'approche la plus fiable consiste à choisir un périmètre étroit, à mesurer le nombre de questions traitées et le taux de réponses jugées utiles, puis à étendre sur cette base plutôt que sur une estimation théorique faite avant le démarrage. ## Ce qu'il faut retenir Un chatbot interne d'entreprise est un projet de **recherche documentaire à droits différenciés**. Sa réussite se joue sur l'ingestion, les permissions et la citation des sources, bien plus que sur le choix du modèle. Prendre un chatbot de site et le placer derrière une authentification ne donne pas un chatbot interne. Commencez petit, sur un périmètre où vous savez juger la qualité. Mesurez. Étendez ensuite. Les projets qui échouent sont presque toujours ceux qui ont voulu tout indexer avant d'avoir prouvé quoi que ce soit. Vous avez un corpus en tête et une équipe qui perd du temps à chercher ? [Réservez une démo](https://www.askthisguy.com/fr/demo/) : nous vous dirons rapidement ce qui est branchable, en combien de temps, et à quel niveau de qualité. --- # Knowledge management : pourquoi vos démarches échouent, et ce que l'IA change URL: https://www.askthisguy.com/fr/blog/knowledge-management-why-it-fails/ Language: fr Section: Blog Dans beaucoup d'entreprises, deux choses coexistent sans jamais se rencontrer. D'un côté, un espace Confluence, un SharePoint ou un Notion. Quatre cents pages. Une arborescence pensée avec soin il y a trois ans, avec des conventions de nommage et un modèle de page. La dernière modification significative date de dix-huit mois. De l'autre, à quinze mètres de là, une personne que tout le monde va voir. Elle répond dix fois par semaine aux mêmes questions : où trouver la dernière version du contrat cadre, pourquoi on ne facture pas ce client comme les autres, quelle clause a coûté cher en 2023. L'entreprise a donc un référentiel et un savoir. Simplement, ils ne sont pas au même endroit. Le réflexe, à ce stade, est de blâmer l'outil. On a choisi Confluence, il aurait fallu Notion. On a choisi Notion, il aurait fallu autre chose. C'est presque toujours une fausse piste : **l'outil n'a jamais été la cause de l'échec**, et le remplacer ne répare rien. **Le knowledge management, ou gestion des connaissances, désigne l'ensemble des pratiques par lesquelles une organisation capte, structure, retrouve et réutilise ce qu'elle sait.** Quatre opérations distinctes : une démarche ne vaut jamais mieux que la plus faible des quatre. L'entreprise du début a très bien structuré, et raté les trois autres. ## Le knowledge management, ce n'est pas de la documentation Capter, c'est sortir le savoir des têtes et des échanges informels. Structurer, lui donner une forme réutilisable. Retrouver, le remettre sous les yeux de quelqu'un au moment où la question se pose. Réutiliser est le seul des quatre qui rapporte quelque chose. Les trois autres coûtent. La distinction classique reste la plus utile. Le **savoir explicite** est celui qui a été écrit : procédures, comptes rendus, spécifications, contrats, retours d'expérience formalisés. Le **savoir tacite** vit dans les têtes : pourquoi on a perdu ce client, quel fournisseur tient réellement ses délais, quelle clause ne doit jamais être acceptée, comment on rattrape une situation quand le process officiel ne s'applique pas. Un référentiel documentaire ne traite que le premier, et seulement une fois qu'il a été écrit. Or la quasi-totalité des démarches de knowledge management en entreprise ont concentré leurs efforts sur une seule des quatre opérations : structurer. Une arborescence, des gabarits, une charte de nommage, un comité éditorial. Capter est resté un acte de bonne volonté. Retrouver a été délégué à un moteur de recherche interne médiocre. Réutiliser n'a jamais été mesuré. C'est un déséquilibre suffisant pour expliquer la suite. ### Et votre savoir écrit n'est pas là où vous croyez Il reste une erreur de cadrage, plus discrète, qui fausse la plupart des diagnostics : croire que le savoir explicite se trouve dans l'outil documentaire. Il n'y est presque jamais en totalité, et souvent il n'y est même pas majoritairement. Faites l'inventaire honnête de votre entreprise. Vous y trouverez : - **le fichier Excel des règles de tarification**, maintenu par une seule personne, qui fait autorité bien plus que la procédure commerciale officielle ; - **la colonne « commentaires » du fichier de suivi client**, où se trouve la vraie histoire du compte, celle que le CRM ne raconte pas ; - **l'outil de ticketing**, et ses milliers de cas résolus qui constituent le savoir de dépannage réel de l'entreprise ; - **les tables de référence de l'ERP**, codes articles, règles de gestion et paramétrages, qui encodent des décisions métier que plus personne ne sait justifier ; - **le drive partagé**, avec douze versions de la même proposition commerciale et aucun moyen de savoir laquelle a été signée ; - **les fils de mails et les canaux Teams ou Slack**, où l'arbitrage a réellement eu lieu, avant d'être résumé nulle part. Rien de tout cela n'a jamais été appelé « connaissance ». Ce sont des outils de production, et le savoir s'y dépose comme un sous-produit de l'activité. C'est pour cette raison qu'aucune démarche de knowledge management ne les a jamais inclus dans son périmètre. Ce n'est pas un signe de désordre. C'est le fonctionnement normal d'une organisation qui travaille : les gens déposent l'information là où ils la produisent, pas là où un comité a décidé qu'elle devrait vivre. **Toutes les entreprises fonctionnent ainsi, et il n'y a aucune raison de penser que la vôtre fasse exception.** Deux conséquences en découlent, et elles éclairent tout ce qui suit. D'abord, une démarche qui se limite à l'outil documentaire ne traite qu'une fraction du savoir explicite, souvent minoritaire : le remplacer par un autre outil ne pouvait donc rien changer. Ensuite, l'objectif de « tout ranger au même endroit » n'a jamais été atteignable, parce qu'il supposait de faire migrer des informations qui n'ont de sens que dans l'outil où elles sont produites. ## Pourquoi les démarches de gestion des connaissances échouent Cinq causes reviennent, et elles sont structurelles. Aucune ne se règle par un choix de logiciel. ### 1. L'effort est asymétrique Celui qui documente n'est pas celui qui en profite. Rédiger une fiche prend quarante minutes, aujourd'hui, sur du temps qui manque déjà. Le bénéfice arrive dans six mois, pour quelqu'un d'autre, et personne ne saura jamais qu'il vient de vous. Un coût immédiat et certain contre un bénéfice différé, incertain et non attribué : c'est un arbitrage perdu d'avance. Les collaborateurs qui ne documentent pas ne sont pas négligents, ils sont rationnels. ### 2. L'obsolescence est silencieuse Une page fausse ne lève aucune alerte. Elle reste en ligne, bien rangée dans la bonne rubrique, avec le bon gabarit, et elle inspire exactement la même confiance que le jour de sa rédaction. C'est le point que la plupart des démarches sous-estiment : **une documentation périmée coûte plus cher qu'une documentation absente**. Face à un vide, on va demander. Face à une page obsolète, on applique. Et il suffit de quelques mauvaises surprises pour que les équipes cessent durablement de faire confiance au référentiel, y compris à ses parties encore justes. ### 3. Chercher coûte plus cher que redemander C'est la cause la plus décisive et la moins souvent nommée. Retrouver l'information dans le référentiel demande d'ouvrir l'outil, de deviner le vocabulaire employé par le rédacteur, de trier des résultats, d'ouvrir trois pages, puis de vérifier laquelle est à jour. Quinze à vingt minutes, sans garantie de succès. Envoyer un message au collègue qui sait prend trente secondes, et la réponse arrive fiable et contextualisée. Tant que ce rapport de coûts tient, le référentiel perd systématiquement. Non pas parce qu'il est mal fait, mais parce qu'il est plus cher à utiliser que l'alternative humaine. Et cette alternative a un prix caché, payé par les trois ou quatre personnes que tout le monde sollicite. ### 4. Le KM a été traité comme un projet, pas comme un flux Un budget, un comité, une phase de migration, une recette, un lancement, une communication interne. Puis la fin du projet, et l'équipe qui se disperse sur autre chose. La connaissance d'une entreprise n'est pas un stock à constituer une fois, c'est un flux qui se renouvelle en continu. Un flux dont on coupe l'alimentation se vide. Les six premiers mois donnent le change, parce que la base initiale est encore fraîche. La dégradation devient visible vers dix-huit mois, quand plus rien ne correspond à la réalité. ### 5. On a confondu stocker et rendre trouvable Un SharePoint de trois téraoctets n'est pas un **système de gestion des connaissances**. C'est un entrepôt. Stocker est résolu depuis vingt ans et ne coûte presque rien. Rendre trouvable, au sens de « la bonne réponse, à la bonne personne, au moment où elle en a besoin, avec la source », n'a jamais été résolu par les outils de gestion documentaire. Ils indexent des mots, pas des questions. Un collaborateur qui cherche « est-ce qu'on peut décaler la facturation pour ce type de client » ne dispose d'aucun mot-clé qui figure dans le document qui contient la réponse. ## Ce que l'IA change réellement Quatre choses ont bougé, et aucune ne mérite le mot « révolution ». ### Elle inverse la charge Le modèle classique demandait de ranger en amont pour pouvoir retrouver en aval. Toute la rigueur devait être investie au moment de l'écriture, par le rédacteur, sans qu'il connaisse les questions futures. Une recherche en langage naturel adossée aux documents de l'entreprise inverse ce contrat. L'effort d'interprétation se paie au moment de la question, par la machine, et pour une question réelle. Le rédacteur n'a plus besoin d'anticiper le vocabulaire de celui qui cherchera. ### Elle rend exploitable une base imparfaite C'est le changement le plus sous-estimé. Un moteur classique exigeait une base propre pour donner de bons résultats. Un dispositif de type **RAG** (*Retrieval-Augmented Generation*) lit ce qui est mal rangé : comptes rendus de réunion, PDF scannés, tickets de support, fils de discussion, vieilles propositions commerciales. Nous détaillons le mécanisme dans notre [guide du RAG en IA](https://www.askthisguy.com/fr/blog/rag-tutorial/). Ce n'est pas un détail de mise en œuvre, c'est ce qui change la faisabilité économique du sujet. La condition d'entrée n'est plus « avoir un référentiel propre », prérequis que personne n'a jamais rempli. Elle devient « avoir des sources accessibles », ce que presque toutes les entreprises ont déjà. ### Elle casse l'économie qui tuait le référentiel Reprenons la cause n° 3. Si obtenir une réponse sourcée prend trente secondes au lieu de vingt minutes, l'arbitrage entre chercher et redemander bascule. Pour la première fois, le système devient moins cher à utiliser que le collègue. C'est le seul mécanisme qui, à notre connaissance, fait effectivement revenir les équipes vers la connaissance formalisée. Pas la charte, pas le comité, pas la communication interne : le fait que ce soit devenu le chemin le plus court. ### Elle vous dit enfin ce qui manque C'est le point le moins connu, et probablement le plus intéressant sur la durée. Un référentiel classique est aveugle. Il sait combien de pages il contient, jamais ce que les gens ont cherché sans le trouver. Vous pilotez donc la documentation à l'opinion : le comité décide qu'il faudrait « documenter les processus achats », parce que quelqu'un l'a dit en réunion. Dès qu'un assistant est branché sur vos sources, chaque question posée devient un signal exploitable. Et les questions arrivent en langage naturel, telles que les gens se les posent vraiment. En les analysant, on fait apparaître trois choses que personne ne voyait : - **Les manques.** Une question qui revient vingt fois par mois et pour laquelle aucune source ne répond correctement désigne précisément la fiche à écrire. Ce n'est plus un avis, c'est une mesure. - **Les contradictions.** Quand deux documents répondent l'inverse sur le même sujet, l'assistant le rencontre à chaque requête concernée. Ces conflits, invisibles tant que personne ne lisait les deux pages côte à côte, deviennent une liste. - **L'obsolescence utile.** Toutes les pages périmées ne se valent pas. Celle que personne n'a jamais sollicitée peut attendre. Celle qui sert de source à trente réponses par semaine doit être reprise cette semaine. Les questions réelles hiérarchisent l'effort de mise à jour à votre place. C'est ce qui referme la boucle. Les causes n° 2 et n° 4 vues plus haut, l'obsolescence silencieuse et le KM traité comme un projet, tenaient toutes les deux au même aveuglement : impossible de savoir où le référentiel décroche, donc impossible d'entretenir autre chose qu'un stock figé. L'usage devient la source de vérité sur ce qu'il faut documenter, et l'entretien redevient un flux piloté par des faits. Récapitulatif honnête : | Cause d'échec | Ce que l'IA change | Ce qui reste à votre charge | | --- | --- | --- | | Effort asymétrique | Réduit fortement le besoin de mise en forme et de rangement a priori | Il faut toujours que quelqu'un écrive au moins une fois | | Obsolescence silencieuse | La réponse cite sa source et sa date, et les questions réelles révèlent les pages qui décrochent | Décider quoi archiver et quoi maintenir | | Chercher coûte plus cher que redemander | Inverse le rapport de coûts, c'est le levier principal | Garantir la qualité des réponses dans la durée | | Projet plutôt que flux | Les sources vivantes sont réindexées en continu, et l'usage indique en continu quoi écrire ou corriger | Le pilotage reste une fonction permanente | | Stocker au lieu de rendre trouvable | Résout la partie « trouvable » | Résout la partie « fiable », qui reste humaine | ## Ce que l'IA ne change pas Un article qui s'arrêterait là serait malhonnête. Quatre limites tiennent bon. **Un savoir qui n'a jamais été écrit reste introuvable.** Aucun modèle ne retrouvera pourquoi vous avez renoncé à ce fournisseur en 2021 si cela n'existe que dans la mémoire de deux personnes. L'IA améliore considérablement les opérations « retrouver » et « réutiliser ». Elle ne fait rien pour « capter ». C'est ce qui reste le vrai travail de knowledge management, et le fait qu'il soit désormais le seul point dur est une bonne nouvelle : vous pouvez y concentrer vos efforts au lieu de les diluer. **Les droits d'accès deviennent plus critiques, pas moins.** Un assistant qui traverse les silos traverse aussi les cloisons que ces silos assuraient sans qu'on y pense. Un dossier RH mal protégé n'était pas un problème tant que personne ne savait qu'il existait. Il le devient dès qu'une question en langage naturel peut le faire remonter. Un assistant sérieux hérite des permissions des outils d'origine et ne répond que dans le périmètre de celui qui pose la question. **Les contradictions demandent toujours un arbitrage humain.** Quand deux documents disent l'inverse, un bon système cite les deux et signale le conflit. Il ne tranche pas, et il ne doit pas. C'est un point de gouvernance, pas de technologie. **La confidentialité reste un choix d'architecture.** Verser des documents internes dans une IA grand public revient à en confier le contenu à un tiers, sans traçabilité et sans retour en arrière possible. Nous détaillons ce point et ses conséquences concrètes dans [L'IA contextualisée pour votre entreprise](https://www.askthisguy.com/fr/blog/contextual-ai-rag-use-cases/). ## À quoi ressemble un système de gestion des connaissances en 2026 Non plus un outil unique où tout le monde devrait ranger, mais cinq couches qui s'appuient sur ce que vous avez déjà. ```mermaid flowchart LR A[Sources existantesSharePoint, Confluence, Drive,
CRM, tickets, PDF] --> B[Ingestion et indexation
en continu] B --> C[Recherche sémantique
filtrée par les droits] C --> D[Assistant
Réponse en langage naturel] D --> E[Sources citées
et datées] E --> F[Vérification humaine
et correction à la source] F --> A ```
Le schéma se lit comme un circuit fermé : les documents restent dans les outils où ils vivent déjà, l'indexation continue et la recherche filtrée par les droits alimentent l'assistant, et la vérification humaine renvoie les corrections vers la source plutôt que vers une copie. C'est cette flèche de retour qui distingue un flux d'un projet ponctuel.
Les couches, dans l'ordre : les **sources là où elles sont déjà**, une **ingestion continue** plutôt qu'une migration ponctuelle, une **recherche sémantique** filtrée par les droits, une **restitution qui cite ses sources** avec leur date, et une **boucle de correction** qui permet à un utilisateur de signaler une réponse fausse et de faire corriger le document d'origine. Cette dernière couche est celle qu'on oublie, et c'est pourtant elle qui répond à la cause n° 4. Elle transforme chaque utilisation en occasion d'amélioration, et fait du dispositif un flux plutôt qu'un projet. Ajoutez une gouvernance légère : qui possède quelle source, à quel rythme on purge, qui arbitre les contradictions. Trois règles suffisent, à condition qu'elles aient un propriétaire. ### Faut-il encore un outil de gestion des connaissances dédié ? C'est la question qui revient systématiquement, et notre réponse est probablement à l'inverse de ce que vous attendez : la couche de stockage compte beaucoup moins qu'avant, la couche d'accès compte beaucoup plus. Autrement dit, ne remplacez pas votre Confluence ou votre SharePoint. Branchez-les. Une migration vers un nouveau **logiciel de gestion des connaissances** consomme six à douze mois, mobilise les mêmes personnes que celles dont vous voulez capter le savoir, et reproduit exactement les cinq causes d'échec dans un environnement plus récent. Vous aurez un entrepôt plus joli, avec le même problème. Le seul cas où changer d'**outil de gestion des connaissances** se justifie est celui où la source actuelle est techniquement fermée, c'est-à-dire sans API ni export exploitable. C'est rare, et cela se vérifie en une demi-journée. Pour le reste, le sujet du **knowledge management en entreprise** s'est déplacé du choix de l'outil vers la qualité de la couche d'accès : est-ce qu'elle couvre toutes vos sources, est-ce qu'elle respecte vos droits, est-ce qu'elle cite, est-ce qu'elle reste juste dans six mois. Le premier de ces quatre critères est celui qui disqualifie le plus de solutions. Une couche d'accès qui ne lit que votre outil documentaire vous ramène au point de départ : elle ignore le fichier de tarification, les tickets résolus et les tables de l'ERP, c'est-à-dire une grande partie de ce que vos équipes cherchent réellement. ## À partir de quand la gestion des connaissances devient rentable Quelques ordres de grandeur pour décider, à croiser avec votre situation plutôt qu'à prendre au pied de la lettre. Le facteur déclenchant n'est presque jamais le volume documentaire. C'est **la concentration du savoir**. Posez-vous la question autrement : combien de personnes, dans votre entreprise, sont sollicitées plus de cinq fois par jour pour des questions dont la réponse existe quelque part ? Si la réponse est deux ou trois, vous avez déjà un problème coûteux, et il est en train de s'aggraver avec la croissance. Les autres signaux qui comptent : - **Un onboarding supérieur à trois mois** avant qu'un nouvel arrivant devienne autonome sur des questions courantes. - **Un départ à venir** sur un poste clé, avec un savoir concentré sur une seule tête. - **Plus de trois ou quatre sources de vérité** différentes, dont personne ne sait laquelle prime. - **Des erreurs récurrentes** dues à l'utilisation d'une version obsolète d'un document. En dessous de quinze à vingt personnes, la mémoire collective informelle suffit généralement, et le sujet peut attendre. Entre cinquante et trois cents, c'est la zone où le coût devient net sans être encore visible dans un budget, parce qu'il se paie en interruptions et en délais plutôt qu'en factures. ## Un exemple concret : la maintenance informatique Prenons un prestataire de maintenance d'équipements informatiques, un cas que nous connaissons bien. Ses techniciens interviennent chez les clients. Certains sont salariés, d'autres sont des sous-traitants externes mobilisés selon la charge et la couverture géographique. Sur site, un technicien a besoin de trois choses en même temps : la procédure applicable, l'historique du client, et le contexte de l'intervention précédente. Or ce savoir est de deux natures différentes, et c'est ce qui rend le cas intéressant. Il y a d'abord des **documents** : les procédures génériques, mais aussi toutes les particularités propres à un client donné. Cet équipement doit être arrêté selon une séquence précise. Ce site impose une fenêtre d'intervention. Ce client a une configuration réseau qui ne ressemble à aucune autre. Ces spécificités sont écrites, mais dispersées entre des fiches, des annexes contractuelles et des comptes rendus. Il y a ensuite une **base de données** : l'historique des tickets et des interventions. Qui est venu, quand, ce qui a été remplacé, ce qui est retombé en panne trois semaines plus tard. Ce sont des données structurées, avec des dates, des références et des statuts, pas des documents. Aucun référentiel documentaire ne couvre les deux. C'est exactement la cause n° 5 : le prestataire ne manquait pas d'information, il n'avait pas de chemin unique pour y accéder. Résultat, le comportement rationnel du technicien sur site consistait à appeler le support, qui interrogeait l'outil de ticketing pendant que le client attendait. Chaque appel coûtait deux personnes au lieu d'une. Le cas des sous-traitants ajoutait une contrainte que les référentiels classiques traitent mal. Un technicien externe doit accéder aux procédures du client chez qui il intervient ce jour-là, et à rien d'autre. Donner un accès large est inacceptable, ne rien donner du tout revient à en faire un technicien moins efficace que ses collègues internes. À cela s'ajoute un troisième usage, dans les bureaux cette fois. Le support et la direction ont besoin d'interroger ces mêmes bases opérationnelles pour des questions d'analyse : rentabilité par contrat, récurrence des pannes sur un parc, respect des délais d'intervention. C'est le même patrimoine de données, avec une question complètement différente. Nous traitons ce volet spécifique dans [Vos bases de données sont une mine d'or](https://www.askthisguy.com/fr/blog/databases-gold-mine-ai-shovels/). Ce que montre ce cas : dès qu'une entreprise dépasse le stade du wiki, sa connaissance est mixte, documentaire et structurée, et adressée à des populations qui n'ont pas les mêmes droits. Un système de gestion des connaissances qui ne traite qu'une des deux natures laisse le problème entier. ## Comment nous abordons le sujet chez Ask This Guy Notre parti pris découle directement de ce qui précède : **aucune migration**. Ask This Guy se connecte à vos sources existantes, quelles qu'elles soient, et les indexe en continu. Vos équipes ne changent pas leurs habitudes de dépôt, et vous ne payez pas le coût de six mois de reprise documentaire avant d'obtenir le premier résultat utile. Nous traitons les deux natures de savoir dans le même assistant : les **documents**, via le RAG, et les **bases de données** métier, interrogées en langage naturel comme décrit sur notre page [Talk to data](https://www.askthisguy.com/fr/solutions/talk-to-data/). C'est ce qui permet de répondre à « quelle est la procédure sur ce site » et à « combien d'interventions sur ce parc depuis janvier » sans changer d'outil. Trois points sur lesquels nous ne transigeons pas, parce qu'ils déterminent si l'usage tient dans la durée : - **Chaque réponse cite ses sources**, avec leur date. Un utilisateur qui ne peut pas vérifier ne fera pas confiance, et un utilisateur qui ne fait pas confiance revient à sa messagerie et à son collègue. - **Les droits sont hérités des outils d'origine.** L'assistant ne répond jamais au-delà de ce à quoi la personne avait déjà accès. - **L'hébergement est européen**, avec une option on-premise quand la sensibilité des documents l'exige. Enfin, nous ne nous arrêtons pas à la mise en service. Une fois l'assistant en place, vos utilisateurs produisent chaque semaine la matière qui manquait à toutes vos démarches précédentes : les vraies questions. Notre console [Insights](https://www.askthisguy.com/fr/doc/admin-console/insights) suit les volumes, les tags, le ressenti et les réponses jugées insatisfaisantes ; nous vous aidons à en tirer un plan de travail documentaire concret, la liste des sujets à écrire, des contradictions à arbitrer et des pages à reprendre en priorité. **Vous voulez savoir ce que vos utilisateurs cherchent sans le trouver ?** C'est exactement le diagnostic que nous savons faire à partir de vos sources et des questions réelles de vos équipes. [Parlons-en](https://www.askthisguy.com/fr/demo/), ou écrivez-nous à [bonjour@askthisguy.com](mailto:bonjour@askthisguy.com). Le détail de l'approche, des connecteurs disponibles et du modèle de coût est sur la page [RAG entreprise clé en main](https://www.askthisguy.com/fr/solutions/knowledge-rag/), et le fonctionnement technique dans notre [documentation](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/). ## Questions fréquentes sur le knowledge management ### Qu'est-ce que le knowledge management ? Le knowledge management, ou gestion des connaissances, désigne l'ensemble des pratiques par lesquelles une organisation capte, structure, retrouve et réutilise ce qu'elle sait. Il couvre le savoir explicite, celui qui a été écrit, comme le savoir tacite, celui qui vit dans les têtes. La plus faible des quatre opérations décide de la valeur de l'ensemble. ### Quelle différence entre gestion des connaissances et gestion documentaire ? La gestion documentaire organise des fichiers : versions, classement, cycle de vie, archivage. La gestion des connaissances vise l'usage du savoir, y compris quand il n'a pas la forme d'un document. Un fichier de tarification, un historique de tickets ou une table de paramétrage de l'ERP portent du savoir sans être des documents au sens de la GED. C'est pour cette raison qu'un projet purement documentaire ne couvre qu'une fraction du sujet. ### Quelle différence entre savoir tacite et savoir explicite ? Le savoir explicite a été formalisé : procédures, comptes rendus, contrats, spécifications. Le savoir tacite n'a jamais été écrit : pourquoi un fournisseur a été écarté, quelle clause ne doit jamais être acceptée, comment on rattrape une situation quand le processus officiel ne s'applique pas. Les référentiels ne traitent que le premier, et seulement une fois qu'il a été mis par écrit. ### Qu'est-ce qu'un système de gestion des connaissances ? En 2026, il tient en cinq couches. Les sources restent là où elles sont. L'ingestion tourne en continu, au lieu d'une migration faite une fois. La recherche est sémantique et filtrée par les droits de chacun. Les réponses citent leurs sources avec leur date. Et un utilisateur qui tombe sur une réponse fausse peut la signaler et faire corriger le document d'origine. L'outil unique où tout le monde devait ranger n'en fait plus partie. ### Quels sont les outils de gestion des connaissances ? Les outils historiques sont les wikis et intranets (Confluence, SharePoint, Notion, Jalios), auxquels s'ajoutent les bases de connaissances du support et les GED. Le point important est ailleurs : la couche de stockage compte beaucoup moins qu'avant, la couche d'accès beaucoup plus. Un logiciel de gestion des connaissances qui ne lit que son propre contenu laisse dehors le fichier Excel des tarifs, les tickets résolus et les bases métier. C'est pourtant là que se trouve une bonne part des réponses. ### Quels sont les enjeux de la gestion des connaissances en entreprise ? Le volume documentaire compte peu. Ce qui déclenche le sujet, c'est la concentration du savoir sur deux ou trois personnes que tout le monde sollicite. Les autres signaux : un onboarding qui dépasse trois mois, un départ annoncé sur un poste clé, trois ou quatre sources de vérité concurrentes, des erreurs qui reviennent parce que quelqu'un a travaillé sur une version périmée. Le coût se paie en interruptions et en délais, rarement en factures, et reste donc longtemps invisible. ### L'IA remplace-t-elle la gestion des connaissances ? Non. Elle déplace l'endroit où se paie l'effort. Elle améliore nettement les opérations « retrouver » et « réutiliser », et rend exploitable une base imparfaite là où un moteur classique exigeait une base propre. Elle ne fait rien pour « capter » : un savoir qui n'a jamais été écrit reste introuvable. Les droits d'accès, l'arbitrage des contradictions et le choix d'hébergement restent des décisions humaines. ## Conclusion Les démarches de knowledge management des vingt dernières années n'étaient pas absurdes. Elles avaient raison sur l'intention et tort sur la méthode : elles demandaient un effort de rangement en amont, à des gens qui n'en tiraient aucun bénéfice, pour alimenter un système plus coûteux à consulter qu'un message à un collègue. Ce que l'IA change n'est pas la capacité à stocker, qui n'a jamais été le problème. C'est l'endroit où se paie l'effort. **Si vous ne devez retenir qu'une chose.** L'IA ne sauve pas un référentiel vide. Elle rend enfin exploitable un référentiel imparfait, ce qui est le cas de tous les référentiels. La question n'est donc plus « comment convaincre les équipes de mieux ranger », mais « comment rendre l'accès moins cher que la sollicitation d'un collègue ». Si le projet prend la forme d'un assistant interrogeable par vos équipes, notre guide du [chatbot interne en entreprise](https://www.askthisguy.com/fr/blog/internal-company-chatbot/) détaille les cas d'usage rentables, les pièges classiques et les conditions de réussite. Si vous reconnaissez votre entreprise dans la première scène de cet article, le sujet est mûr : **[réservez une démo](https://www.askthisguy.com/fr/demo/)**, nous partirons de vos sources réelles. --- # SLA IA entreprise : un seul fournisseur d'IA pour vos agents ne peut pas suffire URL: https://www.askthisguy.com/fr/blog/enterprise-ai-sla/ Language: fr Section: Blog Ouvrez la [page de statut d'Anthropic](https://status.claude.com/). Vous y trouverez le plus souvent un taux de disponibilité entre 99 et 99,5 %. « Two » nines. On est passé d'une époque où l'on visait les *four nines* (99,99 %) à une époque où **99,3 % d'uptime** ne choque plus (plus assez).
Les « vibe codeurs » utilisant Claude s'en contentent, mais est-ce assez pour votre entreprise ?
Probablement pas...
Anthropic est-il un cas isolé ? Non. Tenir un haut niveau de service sur de l'inférence à grande échelle est difficile pour tout le monde.
## Si vous ne devez retenir qu'une chose
Brancher votre production (RAG, assistant interne, agents) sur **un seul** fournisseur d'IA, que ce soit Claude, ChatGPT, Gemini ou Mistral, c'est accepter plusieurs jours d'indisponibilité cumulée par an. Pour un service métier qui compte, ce risque se traite comme n'importe quelle dépendance d'infrastructure.
## Rappel de l'impact des nines
Ordres de grandeur d'indisponibilité, toutes causes confondues, sur un an :
| Nines | Uptime | Indispo approximative |
| --- | --- | --- |
| Two nines | 99 % | ~3,6 jours |
| Three nines | 99,9 % | ~8,8 heures |
| Four nines | 99,99 % | ~52 minutes |
Votre projet d'IA peut-il encaisser plusieurs jours d'arrêt par an ?
Vos utilisateurs, eux, sont habitués aux « four nines » sur leurs outils du quotidien. Voici la disponibilité réelle de Microsoft 365 :
## Chez les concurrents d'Anthropic ?
[OpenAI](https://status.openai.com/) et [Mistral](https://status.mistral.ai/) publient aussi leur disponibilité. Les chiffres ne sont pas directement comparables : chaque page couvre des composants et des périodes différentes. Au 31 juillet 2026, Mistral affichait 99,4 % sur les trois derniers mois.
Une page de statut n'est pas un SLA financier. Certaines offres spécifiques publient toutefois un engagement, comme [Gemini Online Inference](https://cloud.google.com/vertex-ai/generative-ai/sla) à 99,5 % ou [OpenAI Scale Tier](https://openai.com/api-scale-tier/) à 99,9 %, en option payante.
Les hyperscalers peuvent proposer des engagements plus élevés sur certains services managés d'inférence, par exemple 99,9 % sur [Azure AI](https://azure.microsoft.com/en-us/products/ai-foundry/models/openai). L'engagement porte sur l'endpoint. La latence, la qualité des réponses et le reste de votre chaîne RAG n'entrent pas dedans.
On reste loin des garanties habituelles des SaaS de productivité, où les trois « nines » sont un standard sans surcoût.
## Les open weights rendent la bascule possible
Un même [modèle ouvert](https://www.askthisguy.com/fr/blog/open-source-vs-open-weights-ai/) tourne chez une dizaine de fournisseurs d'inférence. C'est l'une des sept façons de servir de l'inférence en entreprise, que nous comparons dans notre guide sur l'[inférence IA](https://www.askthisguy.com/fr/blog/enterprise-ai-inference/). Si l'un tombe, vous basculez sur un autre sans changer de modèle, donc sans retoucher vos prompts.
D'où la **passerelle multi-fournisseurs**, ou *LLM gateway* : une couche qui sait appeler plusieurs modèles chez plusieurs fournisseurs, et arbitrer entre eux selon qui répond, à quelle vitesse et à quel prix.
Aucun de ces fournisseurs n'atteint 99,9 % tout seul. Mis bout à bout derrière une passerelle qui teste leur santé et bascule dès que l'un décroche, on y arrive. Voici ce que nous mesurons en production chez Ask This Guy sur les 30 derniers jours :
Des produits font ça, [OpenRouter](https://openrouter.ai/) par exemple : un point d'accès unique vers plusieurs fournisseurs, et des règles de bascule à configurer. Côté européen, [Eden AI](https://www.edenai.co/), éditeur français, expose plus de 500 modèles derrière une seule API, avec bascule intégrée, endpoint européen et zéro rétention des données. De quoi mutualiser la disponibilité sans sortir votre contexte du périmètre RGPD.
Vous pouvez aussi la développer vous-même : brancher les fournisseurs un par un, mesurer ce qu'ils rendent vraiment, coder vos règles de priorité et de bascule. Comptez plus de temps que prévu sur la partie mesure.
Certaines plateformes l'intègrent nativement, c'est notre cas chez Ask This Guy.
Un **SLA RAG entreprise** ne s'arrête d'ailleurs pas à l'uptime du LLM. L'ingestion des sources, la recherche et les appels d'outils peuvent tomber sans que le modèle bouge d'un pouce. Pour les pièges après le POC, voir [RAG entreprise : 5 erreurs en production](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/).
## Questions fréquentes sur le SLA IA entreprise
### Qu'est-ce qu'un SLA IA entreprise ?
Un SLA IA entreprise fixe le niveau de disponibilité attendu pour un service d'IA, son périmètre de mesure, ses exclusions et les crédits dus si l'engagement n'est pas tenu. Une page de statut sert à observer les incidents, elle n'engage personne.
### Quel SLA pour un RAG entreprise ?
Un **SLA RAG entreprise** doit couvrir plus que l'API du modèle : l'ingestion des sources, la recherche, la passerelle et la latence de bout en bout. 99,9 % sert de référence courante, mais le chiffre ne veut rien dire tant que le périmètre et la méthode de mesure ne sont pas écrits noir sur blanc.
### SLA assistant IA : comment améliorer la disponibilité ?
Supprimez d'abord le point de défaillance unique : une passerelle multi-provider, plusieurs modèles, des contrôles de santé et une bascule automatique. Ajoutez un monitoring des erreurs et de la latence, et un mode dégradé pour les moments où plus rien ne génère.
## Chez Ask This Guy
Notre [passerelle de fournisseurs IA](https://www.askthisguy.com/fr/doc/infrastructure-and-security/ai-providers/) sélectionne en continu les modèles qui répondent, et vite. Objectif côté clients : un niveau de service **supérieur à 99,9 %** sur le périmètre défini, sans dépendre d'un seul modèle de pointe. Politique UE ou monde entier, selon votre contrainte de [souveraineté](https://www.askthisguy.com/fr/doc/infrastructure-and-security/sovereign-ai/).
Pas de miracle : une architecture qui part du principe que les LLM cloud tombent. C'est le socle de notre [solution RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/), et la même passerelle alimente un [assistant support produit](https://www.askthisguy.com/fr/solutions/product-assistant/) quand les utilisateurs sont vos clients.
**SLA IA entreprise utile** = multi-provider + bascule automatique.
Si vous industrialisez un RAG ou un assistant interne et que vous voulez voir cette passerelle en conditions réelles : **[réservez une démo](https://www.askthisguy.com/fr/demo/)**.
---
# Chatbot dans un SaaS : support produit, data et actions IA
URL: https://www.askthisguy.com/fr/blog/chatbot-produit-saas/
Language: fr
Section: Blog
Un client qui paie son abonnement **n'est pas forcément un client engagé** : un compte peut rester facturé pendant des mois pendant que l'utilisateur, lui, a déjà décroché, ouvre le produit de moins en moins, n'atteint jamais les fonctionnalités qui justifient le prix, et prépare sans le dire son départ.
L'enjeu permanent d'un éditeur SaaS n'est donc pas de vendre l'abonnement, c'est de **maximiser en continu la valeur que chaque client en tire réellement**. Sans usage, sans satisfaction, sans montée en compétence sur le produit, la résiliation n'est qu'une question de temps.
Ce risque s'aggrave avec un phénomène récent : à peu près n'importe qui peut désormais **vibe coder un outil interne avec une IA**, sans compétence de développement. La barrière qui protégeait un produit moyen, le coût de tout reconstruire soi-même, s'effondre pour une part croissante des cas d'usage. Un client insatisfait n'a plus seulement le choix d'aller voir un concurrent : il peut, de plus en plus souvent, se contenter de recréer la partie du produit qu'il utilise vraiment.
Un chatbot bien intégré à un SaaS s'attaque directement à ce problème. Pas comme un gadget posé sur la page d'accueil, mais comme une brique du produit qui augmente la valeur réellement extraite à chaque interaction, et qui rend enfin visible ce qui se jouait jusque-là dans l'angle mort entre deux relevés de facturation.
Cet article détaille trois niveaux d'intégration, du plus rapide au plus ambitieux, et la brique qui les relie tous : le pilotage de ce qui se passe réellement dans les conversations, le seul endroit où l'engagement réel devient visible avant qu'il ne soit trop tard.
## Trois niveaux, un seul chatbot
« Faire un chatbot produit » est souvent traité comme un projet unique et binaire : on le construit, ou on ne le fait pas. Dans les faits, la valeur s'ajoute par paliers, et chaque palier a un coût et une complexité différents.
- **Niveau 1 : répondre aux demandes génériques.** Le chatbot s'appuie sur la documentation produit et le contexte de l'utilisateur.
- **Niveau 2 : répondre avec les données propres au client.** Il interroge les données métier de son compte pour fournir une réponse personnalisée.
- **Niveau 3 : agir pour le client.** Il déclenche des actions autorisées dans le produit via des API et des workflows.
### Niveau 1 : répondre aux demandes génériques
**Personne ne lit plus la documentation produit.** Vos utilisateurs cherchent un menu, veulent comprendre une fonctionnalité ou vérifier leur configuration, et n'ont pas le temps de parcourir vingt pages pour trouver la réponse. Quand ils n'y arrivent pas, ils ouvrent un ticket, même quand la réponse existe déjà.

La différence avec un simple moteur de recherche intégré au produit, c'est le **contexte**. Un bon assistant support sait quel abonnement l'utilisateur a souscrit, quelle version du produit il utilise, quel rôle il occupe, parfois son historique récent, et jusqu'à la page sur laquelle il se trouve et ce qu'il est en train d'y faire. La réponse à « comment j'exporte mes données » n'est pas la même pour un utilisateur en plan gratuit et pour un administrateur en plan entreprise, et l'assistant devrait le savoir sans qu'on ait à le lui répéter à chaque fois.
C'est ce que fait notre propre console d'administration, elle-même un produit SaaS : un administrateur demande « comment je configure SharePoint ? » depuis la page Connaissances, et le widget répond avec une procédure sourcée, sans le renvoyer vers un article de doc séparé à chercher lui-même.
C'est aussi, de loin, le niveau le plus rapide à mettre en place. Il ne demande pas de refonte technique : un accès à votre documentation, éventuellement à quelques données de compte en lecture seule, suffit pour démarrer. Sur les déploiements de ce type, **40 à 60 % des tickets concernent du contenu déjà documenté**. C'est le volume que ce premier niveau vient absorber.
Détail à ne pas négliger : ce niveau sert **vos deux publics**. Le client obtient une réponse sourcée et contextualisée. Votre équipe support voit remonter ce qui reste vraiment : les bugs, les cas complexes, les signaux produit qui méritent un humain.
Chaque friction retirée, c'est un peu plus de valeur réellement extraite du produit, et un peu moins de raisons d'aller chercher une alternative, maison ou concurrente.
Voir la fiche solution : [assistant support produit](https://www.askthisguy.com/fr/solutions/product-assistant/).
### Niveau 2 : laisser l'utilisateur interroger ses propres données
La présentation des données dans un SaaS est presque toujours un compromis. Vous concevez des tableaux de bord et des menus d'accès à l'information pour l'usage le plus fréquent, et ils ne correspondent jamais exactement au besoin du moment. L'utilisateur qui veut croiser deux filtres que vous n'avez pas prévus retourne voir votre équipe, exporte un fichier, ou abandonne.
Un chatbot connecté à vos données change la question posée. Au lieu d'adapter son besoin au dashboard existant, l'utilisateur pose sa question directement, en langage naturel, et obtient une réponse chiffrée, un graphique, parfois un export.
Prenons un exemple concret : un SaaS de gestion de flotte automobile.
*« Comment ont évolué mes pannes sur la ville de Lyon sur les 12 derniers mois ? »*
L'assistant renvoie la tendance, avec un pic visible au mois de juillet. L'utilisateur enchaîne, sans changer d'outil ni reformuler sa demande depuis le début :
*« C'est un phénomène saisonnier ? Ça touche toujours les mêmes modèles ? La 308 peut-être ? »*
C'est le genre d'enchaînement qu'aucun tableau de bord figé ne permet, parce qu'il faudrait avoir prévu la question à l'avance. Sur ce type de déploiement, on observe généralement **deux fois plus d'utilisateurs qui exploitent réellement la donnée**, précisément parce que le canal ne demande plus de compétence technique ni d'aller-retour avec une équipe data.
Ce niveau reste, lui aussi, relativement simple à mettre en œuvre dès lors que le chatbot a accès à vos bases ou à vos API : il n'invente rien, il lit et restitue ce qui existe déjà dans votre système.
Il ne remplace pas votre dashboard, il le complète : le tableau de bord suit l'évolution de vos indicateurs dans le temps, la conversation explique pourquoi un chiffre a bougé et explore les facteurs, sans qu'il faille construire un nouveau rapport à chaque question.
C'est aussi le niveau où l'écart avec un outil bricolé en interne se creuse. Un tableau croisé sur un export, n'importe qui peut le vibe coder en une heure. Une conversation qui comprend le contexte métier d'un compte et répond avec les vraies données de production, c'est nettement plus difficile à improviser.
Voir la fiche solution : [Talk to Data](https://www.askthisguy.com/fr/solutions/talk-to-data/).
### Niveau 3 : déclencher des actions
**Un chatbot répond. Un agent agit.** C'est la bascule qui distingue vraiment ce troisième niveau des deux précédents, et c'est aussi celle qui change le calcul de complexité.
Deux familles d'actions ont du sens dans un produit SaaS. La première regroupe les **actions du quotidien**, simples mais répétitives : modifier un paramètre de compte, ajouter un utilisateur, changer une configuration, ce que l'utilisateur ferait de toute façon en trois clics, mais qu'il peut désormais demander en une phrase. La seconde est celle où **l'IA apporte une vraie valeur ajoutée** : aller chercher une donnée publique pertinente pour enrichir un dossier, générer un contenu à partir du contexte du compte, analyser l'usage récent d'un client pour recommander un changement de configuration ou de forfait avant même qu'il ne le demande.
C'est cette seconde famille qui différencie vraiment un produit, parce qu'elle dépasse la simple réponse à une question posée.
Ce niveau change la nature du projet. Il ne suffit plus d'un accès en lecture à de la documentation ou à des données : il faut un **système d'autorisation** qui définisse précisément ce que l'agent peut faire pour quel profil d'utilisateur, des **API adaptées** pour chaque action possible, et souvent des **workflows spécifiques** pour les cas où l'action a des conséquences (facturation, données personnelles, engagement contractuel). C'est un investissement réel, mais concentré sur un petit nombre d'actions à fort effet de levier plutôt que sur l'ensemble du produit, et c'est aussi le niveau le plus difficile à recréer soi-même sans équipe technique, ce qui en fait, une fois posé, l'avantage le plus durable des trois.
## Comprenez enfin vos clients et leurs besoins non exprimés
La plupart des projets de chatbot produit s'arrêtent à la réponse : le bot répond bien, tout le monde passe au projet suivant. C'est passer à côté de l'essentiel : **le tableau de bord revenu ne dit rien de l'engagement réel d'un client, mais ses conversations avec le chatbot, si**. Chaque échange est un signal, et la plupart de ces signaux ne remontent nulle part ailleurs.

Concrètement, deux briques transforment ces conversations en pilotage.
**Des règles de tag et d'alerte, décrites en langage naturel.** Plutôt qu'une liste figée de mots-clés, vous décrivez une condition comme vous la formuleriez à un collègue : « le client s'interroge sur des fonctionnalités avancées ou des offres supérieures à son forfait actuel », « le client manifeste son intention de mettre fin à un service ». Quand une conversation correspond, elle est étiquetée automatiquement et, si vous l'activez, une alerte part par e-mail vers la bonne équipe. C'est le mécanisme qui transforme une intuition (« on devrait détecter les signaux de désabonnement ») en processus qui tourne seul.
**Un tableau de bord de suivi dans le temps.** Volume de conversations, sentiment détecté automatiquement, réactions pouce haut ou bas des utilisateurs, répartition par tag et par agent, comparaison avec la période précédente. De quoi répondre à des questions simples mais rarement mesurées : le sentiment se dégrade-t-il sur telle fonctionnalité depuis la dernière mise à jour ? Quel agent concentre le plus de frustration ? Où porter l'attention cette semaine ?
C'est là que l'anti-churn et l'upsell cessent d'être des intentions pour devenir des règles actives. Un client qui manifeste son intention de mettre fin à un service ou qui s'interroge sur des fonctionnalités avancées déclenche une alerte avant que le sujet ne remonte par un autre canal, ou pas du tout.
Documentation : [tags et alertes](https://www.askthisguy.com/fr/doc/admin-console/tags-alerts) et [Insights](https://www.askthisguy.com/fr/doc/admin-console/insights).
## Faut-il le construire ou l'acheter ?
Dans l'immense majorité des cas, la réponse est d'acheter, et ça vaut pour les trois niveaux, du support au déclenchement d'actions.
Construire un chatbot minimal à partir d'un modèle et d'une base vectorielle est faisable en quelques jours pour une démonstration. Mais **ce qui coûte cher, ce n'est jamais la démo, c'est tout ce qu'il y a autour** : la gestion du contexte utilisateur par profil et par plan, une recherche qui trouve vraiment la bonne information dans vos sources, la citation fiable de ces sources, l'évaluation continue de la qualité des réponses, la supervision des coûts d'inférence, l'orchestration et les permissions dès qu'on touche aux actions, et tout le pan pilotage et alerting détaillé plus haut. Cette partie représente **environ 90 % du travail**. Elle est générique, au sens où elle ne dépend pas de votre métier, mais elle est loin d'être simple : c'est elle qui sépare un chatbot qui impressionne en démo d'un chatbot que vos clients utilisent encore six mois plus tard. Un build interne complet se compte en mois-homme, et il faut ensuite le maintenir aussi longtemps qu'il tourne : nous détaillons ces écueils dans notre article sur les [erreurs classiques d'un RAG en production](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/).
C'est la logique du **90/10** que nous appliquons chez Ask This Guy : ces 90 % (le chat, notre [recherche hybride à six niveaux](https://www.askthisguy.com/fr/blog/hybrid-search-retrieval-methods/), la gestion des permissions, le pilotage, l'hébergement) sont une plateforme déjà construite, qui continue d'évoluer sans que vous ayez à le faire. C'est le socle de notre [RAG entreprise clé en main](https://www.askthisguy.com/fr/solutions/knowledge-rag/). Les 10 % restants (vos documents, votre contexte utilisateur, vos API, vos workflows d'action) sont ce qui fait vraiment la différence pour vos clients, et **c'est le seul endroit où un travail sur mesure a du sens**.
Deux situations sortent de cette règle. La première, c'est quand l'IA n'est pas une fonctionnalité ajoutée à votre produit mais son cœur même : la maîtrise de la pile technique devient alors votre différenciation, et la construire en interne se justifie. La seconde, c'est quand votre volume d'affaires est très important, un gros produit B2C par exemple : le coût d'un build interne s'amortit sur une base d'utilisateurs assez large pour changer le calcul.
| Critère | Build interne complet | Plateforme existante |
| --- | --- | --- |
| Premier périmètre utile | Plusieurs mois si l'équipe part de zéro | Quelques jours à quelques semaines |
| Contexte utilisateur (plan, rôle, historique) | À concevoir et maintenir | Brique standard, à connecter à votre modèle de données |
| Pilotage et alerting | Dispositif à construire de A à Z | Déjà disponible, configuration par règles |
| Actions et permissions | Système d'autorisation à concevoir | Cadre existant, workflows spécifiques à définir |
| Maintenance | À la charge de l'équipe produit | Portée par l'éditeur |
| Choix pertinent si… | L'IA est le cœur du produit, ou le volume d'affaires est très important | Dans tous les autres cas |
Sur les projets que nous menons, le TCO baisse d'environ **80 %** par rapport à un développement mené intégralement en interne, avec un premier périmètre utile en semaines plutôt qu'en mois.
## L'approche Ask This Guy
Nous déployons des assistants produit sur une plateforme qui apporte déjà le chat, le contexte utilisateur, le pilotage et l'alerting. Le travail spécifique porte sur votre documentation, vos API et les actions qui ont vraiment du sens pour votre produit.
Notre approche part toujours du niveau 1 : un périmètre étroit, une documentation connectée, un premier cas d'usage mesurable en quelques semaines. Les niveaux suivants, data et actions, s'ajoutent une fois que le premier a fait ses preuves auprès de vos utilisateurs, sans repartir de zéro sur la pile technique.
Vous gérez un produit SaaS et vous voulez évaluer ce qu'un chatbot changerait pour vos clients ? [Prenez rendez-vous avec nous](https://www.askthisguy.com/fr/demo/).
## Questions fréquentes sur le chatbot dans un produit SaaS
### Le revenu récurrent ne suffit-il pas à mesurer la santé d'un compte client ?
Non. Un client peut rester facturé plusieurs mois après avoir cessé d'extraire une vraie valeur du produit : il ouvre moins souvent l'application, n'explore plus de nouvelles fonctionnalités, et prépare en silence son départ. Le MRR est un indicateur retardé, il confirme un problème après coup plutôt que de l'annoncer. Les signaux d'engagement réel, comme la fréquence d'usage, le sentiment exprimé dans les échanges avec un assistant ou les questions répétées sur une même friction, sont visibles bien plus tôt, à condition de les regarder.
### Un chatbot produit peut-il réellement réduire le churn ?
Indirectement, mais de façon mesurable. Le chatbot ne retient pas un client par lui-même : il repère, dans les conversations, les signaux qui précèdent souvent un désabonnement (une question sur la résiliation, une frustration répétée sur une fonctionnalité) et alerte la bonne équipe avant que le client ne parte. C'est la combinaison des réponses contextualisées, qui réduisent la frustration en amont, et des alertes automatiques, qui donnent le temps d'agir en aval, qui fait la différence.
### Combien de temps pour déployer un chatbot dans un produit SaaS ?
Pour le premier niveau, un assistant support connecté à votre documentation, quelques jours à quelques semaines suffisent sur une plateforme existante, contre plusieurs mois pour un développement interne complet. Les niveaux suivants, interrogation des données puis déclenchement d'actions, s'ajoutent progressivement et demandent davantage de cadrage, notamment sur les permissions et les workflows métier.
### Faut-il connecter le chatbot à toutes ses données dès le départ ?
Non. Le levier le plus rapide est presque toujours la qualité des instructions et des scénarios, pas l'exhaustivité des sources connectées. Un périmètre étroit, sur lequel vous pouvez juger la qualité des réponses, donne de meilleurs résultats qu'un branchement complet mais mal cadré. Vous élargissez ensuite le périmètre une fois le premier cas d'usage validé auprès de vos utilisateurs.
### Comment un chatbot détecte-t-il une opportunité d'upsell ?
Par des règles de tag définies en langage naturel plutôt que par des mots-clés figés : par exemple « le client s'interroge sur des fonctionnalités avancées ou des offres supérieures à son forfait actuel ». Quand une conversation correspond à cette condition, elle est étiquetée automatiquement et peut déclencher une alerte e-mail vers l'équipe commerciale ou customer success, en temps réel plutôt qu'après coup dans un export mensuel.
### Un chatbot produit remplace-t-il le support client humain ?
Non, il en absorbe la part répétitive et déjà documentée, en général 40 à 60 % du volume de tickets, pour que les équipes support se concentrent sur les cas complexes, les bugs et les sujets qui demandent un vrai jugement humain. L'objectif n'est pas de supprimer le contact humain mais de le réserver aux situations où il apporte le plus de valeur.
## Ce qu'il faut retenir
Le revenu récurrent d'un client ne dit rien de son engagement réel, et c'est précisément ce qui rend le désengagement dangereux : il reste silencieux jusqu'à la résiliation. Un chatbot dans un SaaS peut rester un simple assistant de documentation, ou devenir l'instrument qui maximise en continu la valeur extraite par chaque client et qui rend visible ce qui, autrement, ne se verrait qu'au moment du départ, vers un concurrent ou, de plus en plus souvent, vers ce que ce client aura fini par construire lui-même.
---
# Outils d'analyse de données : quelle famille pour quel besoin en 2026 ?
URL: https://www.askthisguy.com/fr/blog/data-analysis-tools/
Language: fr
Section: Blog
Il n'y a jamais eu autant d'outils pour analyser ses données. Excel, Power BI, Python, MATLAB, ChatGPT, sans compter la vague d'outils « text-to-SQL » et d'assistants conversationnels arrivés depuis deux ans.
**Quelle famille d'outils pour quel type de besoin ?**
On vous livre un éclairage ici !
## 1. Les tableurs : Excel, Google Sheets
**En bref.** Le point de départ universel de l'analyse de données.
**Exemples :** Microsoft Excel, Google Sheets.
**Pour qui, quand.** N'importe qui, tout le monde sait ouvrir un Excel. Très utilisé par le métier et les DAF, qui s'en servent au quotidien pour modéliser, simuler, faire un calcul ponctuel maîtrisé de bout en bout. Pour le contrôle de gestion, nous avons détaillé cet arbitrage dans notre guide [Excel, tableaux de bord Power BI et IA](https://www.askthisguy.com/fr/blog/financial-analysis-without-excel).
**Ce qu'ils font de mieux.** Modéliser. Construire un budget, simuler un scénario, poser des hypothèses et les rendre visibles. Souplesse inégalée, et surtout : tout le monde sait s'en servir.
**Leurs limites.** Dès qu'il s'agit d'analyse **récurrente**, les faiblesses apparaissent : pas de connexion automatique aux sources, des formules qui s'empilent et deviennent fragiles, des fichiers difficilement reproductibles et dépendants de la personne qui les maîtrise. De plus, chaque hypothèse que l'on veut valider en manipulant quelques chiffres peut s'avérer chronophage.
## 2. Les plateformes de business intelligence : Power BI, Tableau, Qlik
**En bref.** Suivre des indicateurs dans la durée.
**Exemples :** Microsoft Power BI, Tableau, Qlik, Looker.
**Pour qui, quand.** Généralement configuré par la DSI pour les métiers. Permet d'avoir le reporting financier ou opérationnel récurrent, le suivi d'indicateurs partagés dans le temps.
**Ce qu'ils font de mieux.** Le **tableau de bord** et la **visualisation de données** : chiffre d'affaires, marge, trésorerie, encours. Vous suivez l'évolution sur un format visuel stable, partagé, mis à jour automatiquement. C'est l'outil de référence du reporting régulier.
**Leurs limites.** Le dashboard est rigide par nature : dès qu'une question sort de la maille prévue par le concepteur du rapport, il faut modifier le dashboard. La réponse attendra. Quant à l'IA conversationnelle intégrée (Copilot avec Power BI par exemple), elle est généralement peu performante et dans le cas de Microsoft, particulièrement chère.
## 3. Les langages et notebooks : Python, R, SQL
**En bref.** L'analyse sur-mesure, sans limite de puissance. **Réservé aux profils techniques.** Le notebook permet de saisir du code et de visualiser les résultats directement.
**Exemples :** notebooks Jupyter, avec code Python et librairie Pandas (ou en plus moderne/performant Polars)
**Pour qui, quand.** Exclusivement des équipes techniques, pour des analyses avancées. Pas un outil en libre-service.
**Ce qu'ils font de mieux.** Tout, ou presque. Gros volumes, traitements complexes, analyses statistiques poussées, pipelines reproductibles et versionnés. C'est un outil clé pour les équipes data.
**Leurs limites.** Ils supposent de savoir coder et d'avoir une forte logique mathématique. Un utilisateur métier ne peut pas être autonome ici : il dépend d'un data engineer ou d'un développeur pour poser sa question et obtenir une réponse.
## 4. Le calcul scientifique et statistique : MATLAB, SAS, SPSS
**En bref.** Quand l'analyse devient une discipline scientifique à part entière. **Hors de portée du métier.**
**Exemples :** MATLAB, SAS, SPSS, Stata.
**Pour qui, quand.** Chercheurs, ingénieurs, biostatisticiens, quants. Cette famille est mentionnée ici pour être complet : pour une question métier courante, ce n'est jamais le bon outil.
**Ce qu'ils font de mieux.** Les statistiques avancées, la modélisation numérique, le traitement du signal, la recherche quantitative : des domaines où ces suites spécialisées restent des références.
**Leurs limites.** Coûteuses, très spécialisées, avec une longue courbe d'apprentissage. L'autonomie métier y est impossible : ce sont des outils de spécialistes, pas de décideurs ou d'analystes fonctionnels.
## 5. L'IA conversationnelle : parler à ses données
**En bref.** La famille la plus récente : **interroger ses données en langage naturel**, comme on poserait la question à un collègue, et obtenir une réponse chiffrée, un graphique, un export.
C'est aussi la famille la plus disparate car plus récente. On distingue trois grandes approches.
### Les IA généralistes : Mistral, ChatGPT, Claude
**Pour qui, quand.** L'analyse ponctuelle d'un fichier isolé que vous avez déjà sous la main.
**Ce qu'elles font de mieux.** Analyser un fichier qu'on leur donne. Vous importez un Excel ou un CSV, vous posez votre question, vous obtenez une analyse en quelques secondes. Zéro mise en place, accessible à tous, encore plus simple qu'Excel.
**Leurs limites.** C'est du **one-shot** : vous alimentez l'outil à la main, à chaque fois. Ces assistants commencent à proposer des connecteurs, mais ils ne sont pas conçus pour interroger, de façon **récurrente, gouvernée et permissionnée**, vos sources d'entreprise connectées (ERP, CRM, base SQL) avec votre contexte métier. Par défaut, la donnée quitte votre environnement. Enfin, le risque d'hallucination est élevé.
### Les pure players de la data : Vanna, Wren AI
**Pour qui, quand.** Les équipes techniques qui veulent construire leur propre couche conversationnelle sur mesure.
**Ce qu'ils font de mieux.** Transformer une question en requête SQL (le « text-to-SQL »). Connectés à votre base, souvent open-source, ils sont puissants sur les données **structurées**.
**Leurs limites.** Ils sont focalisés sur le SQL et le structuré, et ignorent vos documents. Surtout, ce sont des **briques à assembler** : il faut les héberger, les entraîner sur votre schéma, gérer les connecteurs, la gouvernance et la maintenance. C'est un projet data, pas un outil clé en main.
### Les plateformes métier : Ask This Guy
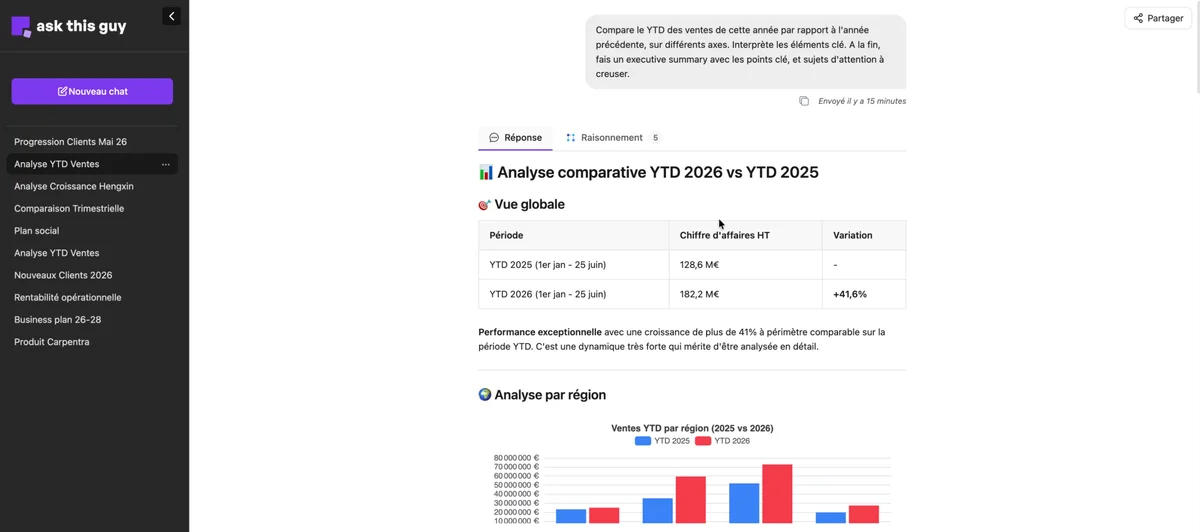
**Ce qu'elles font de mieux.** Réunir les avantages des deux approches précédentes, en managé. **Ask This Guy**, grâce à sa solution Talk to Data, est un pure player de la data **et plus** : il se connecte à vos sources vivantes, croise une requête structurée avec vos documents, applique votre contexte métier et vos permissions, sans que vous ayez rien à construire.
Grâce au **RAG**, une même question peut aller chercher une réponse dans votre **base SQL**, dans un **autre SI** (CRM, ERP), dans vos **documents bureautiques** (Excel, Word, PDF, SharePoint) et même sur le **web**, puis combiner le tout dans une seule réponse.
Nous y revenons plus bas.
## Tableau récapitulatif
| Famille | Exemple | Connexion aux sources | Compétences requises | Idéale pour |
| --- | --- | --- | --- | --- |
| **Tableurs** |
 | Import manuel | Faibles | Modéliser, simuler |
| **Plateformes BI** |
 | Connectée | Faibles à l'usage (config initiale) | Suivre des KPI récurrents |
| **Langages / notebooks** |
 | Connectée | Élevées à l'usage | Analyses avancées, industrialisées |
| **Calcul scientifique** |
 | Import / connectée | Élevées à l'usage | Statistiques, recherche |
| **IA généraliste** |
 | Import manuel | Faibles | Analyse ponctuelle d'un fichier |
| **Pure player data** |
 | Connectée | Faibles à l'usage (config initiale) | Brique text-to-SQL sur-mesure |
| **Plateforme métier** |
 | Multi-sources | Faibles à l'usage (config initiale) | Interroger et croiser ses données |
## Comment choisir : la bonne famille selon votre besoin
Plutôt que de chercher un gagnant, partez de votre besoin :
- **Suivre des indicateurs récurrents** (CA, marge, trésorerie) → une plateforme de BI.
- **Construire un modèle ou un budget** → un tableur.
- **Analyser un fichier isolé, une fois** → une IA généraliste.
- **Traiter de gros volumes, industrialiser une analyse** → langages et notebooks.
- **Faire des statistiques scientifiques** → une suite spécialisée.
- **Interroger vos sources connectées en langage naturel, croiser données et documents, sans coder** → une plateforme conversationnelle métier.
Un même service jongle souvent avec plusieurs familles. Pour le cas précis du contrôle de gestion (où Excel, dashboards et IA se complètent), nous avons écrit un [guide de décision dédié](https://www.askthisguy.com/fr/blog/financial-analysis-without-excel).
## Talk to Data : la couche conversationnelle en pratique
La plupart des familles ci-dessus ont un angle mort commun : la **question imprévue**, celle qui n'a pas de case dédiée dans un rapport et qui, aujourd'hui, finit dans un Excel ou dans la file d'attente de l'IT. C'est précisément ce que vient combler une plateforme conversationnelle métier.
**Talk to Data**, la solution d'Ask This Guy, se connecte à vos sources réelles (**base SQL, ERP et CRM comme Sage ou Salesforce, Excel, SharePoint, documents via RAG, MCP, API**) et répond à vos questions **en langage naturel, avec votre contexte métier**. Concrètement, elle apporte ce que ni un tableur, ni un dashboard, ni un chatbot généraliste ne réunissent :
- la **compréhension du contexte métier** (vos termes, vos règles, vos référentiels) ;
- le **croisement de sources hétérogènes grâce au RAG** : une même question peut interroger votre **base SQL**, un **autre SI** (ERP, CRM), vos **documents bureautiques** (Excel, Word, PDF, SharePoint) et une **recherche web**, pour combiner le tout dans une seule réponse cohérente, comme nous l'expliquons dans notre article sur [l'accès aux bases de données par l'IA](https://www.askthisguy.com/fr/blog/databases-gold-mine-ai-shovels) ;
- la **génération de graphiques** et l'**export Excel/CSV** pour retravailler les résultats ;
- le respect des **permissions** et un fonctionnement en **lecture seule**, sous contrôle de l'IT.
Là où un pure player open-source vous demande de tout construire et maintenir, une plateforme managée rend l'analyse accessible directement à vos équipes métier.
**Si vous ne devez retenir qu'une chose…** Ne choisissez pas un outil par habitude, mais par nature du besoin.
- KPI à suivre dans le temps : plateforme de BI.
- Modèle à construire : tableur.
- Question ouverte sur vos données connectées : conversation en langage naturel.
Ces familles se complètent bien plus qu'elles ne se remplacent.
## Questions fréquentes
### Quels sont les outils pour faire une analyse de données ?
On distingue cinq grandes familles : les **tableurs** (Excel, Google Sheets) pour modéliser ; les **plateformes de BI** (Power BI, Tableau, Qlik) pour suivre des KPI ; les **langages et notebooks** (Python, R, SQL) pour les analyses avancées ; le **calcul scientifique** (MATLAB, SAS, SPSS) pour la recherche ; et l'**IA conversationnelle** (ChatGPT, Wren AI, Ask This Guy) pour interroger ses données en langage naturel. Chacune répond à un besoin différent, voir le tableau récapitulatif ci-dessus.
### Quel outil pour analyser ses données sans savoir coder ?
Un tableur pour un calcul simple, une plateforme de BI pour suivre des indicateurs, et une **plateforme conversationnelle** (comme Ask This Guy) pour poser des questions ouvertes sur vos données connectées. Les langages comme Python ou les suites type MATLAB, eux, supposent de vraies compétences techniques.
### Power BI permet-il d'interroger ses données en langage naturel ?
En partie, via Copilot. Mais cette IA conversationnelle reste limitée sur les questions ouvertes, et elle repose sur une **capacité Fabric ou Premium payante** au niveau de l'organisation, particulièrement chère.
### Qu'est-ce que la business intelligence conversationnelle ?
C'est une couche qui se pose **au-dessus** de vos données pour permettre de les interroger en langage naturel, plutôt que via un dashboard figé ou une requête SQL. Le dashboard suit vos KPI dans le temps ; la conversation explique les écarts et explore les facteurs. Les deux sont complémentaires.
### Quel outil d'analyse de données pour une PME ou une ETI ?
Cela dépend du besoin, mais deux critères pèsent lourd pour une structure sans grande équipe data : la **connexion aux sources réelles** sans projet technique lourd, et le **contrôle des droits**. Une plateforme managée qui interroge vos données existantes en langage naturel offre souvent le meilleur rapport valeur / effort de mise en place.
---
Le paysage des outils d'analyse de données n'a jamais été aussi riche, et ce n'est pas près de se simplifier. La bonne stratégie n'est pas de choisir un camp, mais de mettre **chaque famille à sa place**, et de brancher la nouvelle couche conversationnelle là où les autres atteignent leurs limites.
**[Réservez une démo](https://www.askthisguy.com/fr/demo/)** pour voir **Ask This Guy** répondre, en direct, à une vraie question sur vos données.
---
# Contrôle de gestion : comment concilier Excel, tableaux de bord Power BI et IA ?
URL: https://www.askthisguy.com/fr/blog/financial-analysis-without-excel/
Language: fr
Section: Blog
*« Pourquoi la marge a-t-elle baissé sur la région Ouest ce trimestre ? »*
Cette question, un directeur général la pose en trente secondes. Y répondre, avec une bonne analyse et une bonne mise en forme, prend plusieurs heures. Le **contrôle de gestion** connaît bien ce décalage : entre la question et la réponse chiffrée, il y a une connexion à un SI, un export, des RECHERCHEV et des SOMMESI, un fichier à recouper, et un beau slide ou mail pour expliquer les résultats.
Face à ce genre de demande, deux réflexes viennent naturellement à l'esprit :
- aller fouiller le **tableau de bord** Power BI (ou Tableau ou autre) pour voir si l'on n'a pas déjà la réponse ;
- rouvrir un **Excel** d’analyse et reconstruire le calcul.
Alors qu'on aimerait juste poser la question dans un chatbot pour avoir les éléments d'entrée permettant l'analyse.
C'est ce que permet par exemple la solution **[Talk to Data](https://www.askthisguy.com/fr/solutions/talk-to-data)** d'Ask This Guy.
Les trois outils restent toutefois complémentaires.
Cet article propose une grille simple pour savoir lequel utiliser, et quand.
## Trois familles d’outils, trois usages
Avant de choisir, il faut voir clairement ce que chaque outil fait de mieux, et ses limitations.
### Excel : le couteau suisse de l’analyse
Excel reste imbattable pour **modéliser** : construire un budget, simuler un scénario, le présenter avec une transparence maximale sur les hypothèses et inputs. C’est pour ça qu’il est partout dans la finance.
Mais dès qu’il sert à **l’analyse de données récurrente**, les limites apparaissent vite :
- pas de mécanisme automatisé pour importer des données actualisées ;
- chaque question nouvelle demande de nouveaux traitements et formules ;
- les formules s’empilent, deviennent fragiles, et une cellule décalée fausse tout ;
- le résultat est **difficilement reproductible** : six mois plus tard, plus personne ne sait comment le fichier a été construit (car rarement documenté);
- l’analyse dépend de la personne qui maîtrise le classeur. Le jour où elle est absente, l’information l’est aussi (même cause)
Excel reste un incontournable et le restera longtemps, et [fait même l'objet d'un e-sport](https://www.youtube.com/watch?v=M0qha4l3Tls).
### Les tableaux de bord (Power BI par ex.) : suivre les KPI dans le temps
Un **tableau de bord** est fait pour une chose précise : suivre des indicateurs **dans la durée**. Chiffre d’affaires, marge, trésorerie, encours clients. Vous voyez l’évolution, sur un format visuel stable et partagé. C’est exactement ce qu’il faut pour le **reporting financier** régulier.
Son principal avantage par rapport à Excel est qu'il se met à jour automatiquement, et qu'il permet une interface plus intuitive et plus guidée pour ses utilisateurs.
Mais dès qu’une question sort de la maille modélisée par le développeur du rapport (« classe-moi les commerciaux par perte de commandes ce quarter vs. Y-1), il faut retourner le voir pour avoir sa réponse (peut-être tout de suite ou peut-être dans une semaine).
### La conversation avec une IA : interroger ses données en langage naturel
C’est l'outil le plus récent. L’idée : **interroger ses données en langage naturel**, comme on poserait la question à un collègue, et obtenir directement une réponse chiffrée, un graphique, voire un export.
Il ne remplace ni Excel ni les dashboards. Il comble le trou entre les deux : les **questions ponctuelles et imprévues**, celles qui n’ont pas de case dédiée dans un rapport et qui, aujourd’hui, finissent dans un Excel ou dans la file d’attente de l’IT.
## La vraie question : « suivre » ou « comprendre » ?
Tout se joue sur une distinction simple.
Un tableau de bord répond à la question **« quoi ? »** : *quel* est le CA, *quelle* est la marge, *comment* évolue la trésorerie. Il montre ce qui bouge.
La conversation répond à la question **« pourquoi ? »** : *pourquoi* la marge a baissé, *quels* clients ont décroché, *quelle* combinaison de facteurs explique l’écart. Elle aide à comprendre.
> Le dashboard suit vos KPI dans le temps ; la conversation explique les écarts et explore les facteurs.
Le **reporting financier** récurrent appartient clairement au monde du dashboard. Les questions d’**analyse financière** ponctuelles, elles, sont aujourd’hui traitées dans Excel. Mais dès aujourd'hui, elles peuvent être traitées plus efficacement avec une IA.
## Une grille de décision simple
Plutôt que d’opposer les outils, posez-vous une question : **mon besoin est-il récurrent et cadré, ou ponctuel et exploratoire ?**
| Votre besoin | Bon outil | Pourquoi |
| --- | --- | --- |
| Suivre un KPI récurrent (CA, marge, trésorerie) | Tableau de bord | Format visuel stable, partagé, comparable dans le temps |
| Construire un modèle ou un budget complexe | Excel | Souplesse de modélisation inégalée |
| Réfléchir à un pricing produit | Excel | Souplesse de modélisation inégalée |
| Refaire le même calcul chaque mois | Excel ou Tableau de bord | Reproductible une fois le modèle posé |
| Répondre à une question ponctuelle et précise | Conversation (IA) | Pas de nouveau rapport à construire |
| Croiser plusieurs sources (ERP + CRM + Excel) | Conversation (IA) | Évite les exports manuels et les RECHERCHEV |
| Comprendre *pourquoi* un chiffre bouge | Conversation (IA) | Explore les facteurs, pas seulement les totaux |
## La même question, trois chemins
Prenons un cas concret. *Atelier Norca*, PME industrielle fictive, voit sa marge reculer sur la région Ouest au T3. Le contrôleur de gestion doit comprendre pourquoi. Voici les trois chemins possibles.
**Chemin Excel.** Il exporte les ventes depuis l’ERP, la base clients depuis le CRM, colle le tout dans un classeur, monte un modèle et reconstitue l'impact des différents facteurs. Une trentaine de minutes plus tard, il a une piste (à condition de ne pas s’être trompé d’onglet ou de période).
**Chemin tableau de bord.** Il ouvre le dashboard. Il **voit** la baisse, nette, sur la courbe régionale. Mais le rapport est construit par région, pas par client ni par produit. Pour creuser, il faut demander une nouvelle vue au concepteur du rapport. La réponse attendra.
**Chemin conversation.** Il pose la question en langage naturel : *« Marge région Ouest au T3 vs T2, explore chaque facteur pouvant expliquer l'écart. »* Il obtient la réponse chiffrée, un graphique, et l’**export Excel/CSV** s’il veut retravailler les données, et un mail de synthèse. En moins d'une minute il identifie les causes clé.
 Quand le visiteur s'exprime librement, vous récupérez un signal beaucoup plus riche qu'une case cochée. Il vous dit spontanément ce qui l'intéresse, ce qui le bloque, ce qui l'a amené sur votre site.
Un bon chatbot doit remplir trois objectifs :
- D'abord, **satisfaire le visiteur** : répondre à son besoin immédiat.
- Ensuite, **comprendre son besoin** profond.
- Enfin, **prendre rendez-vous** si cela est pertinent pour vous.
## Le parcours conversationnel idéal
Le parcours le plus efficace n'est pas un tunnel. C'est une conversation avec une intention claire.
Le schéma décrit le parcours type d'un visiteur : une question libre, une réponse utile, puis une qualification légère qui oriente vers un rendez-vous quand le profil correspond, ou vers une ressource utile quand ce n'est pas encore le moment. Seul le premier chemin remonte au CRM.
La capture du lead arrive après la valeur. Le visiteur a reçu une réponse, le chatbot a compris son contexte, et le rendez-vous devient la suite logique. ## Exemple : d'une question floue à un lead qualifié Un visiteur lit un [article sur le déploiement d'un LLM en local en entreprise](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/). Il ouvre le chatbot et demande : > *« Je cherche à comprendre si déployer son infrastructure IA est vraiment un prérequis, comme me le dit mon collègue DSI. »* Il faut tout d'abord répondre au client à sa question, pas l'éluder, mais essayer en creusant d'en savoir plus sur son contexte. Au bout de quelques messages, on comprend le vrai sujet : l'utilisateur est un responsable de service client qui cherche à réduire son nombre de sollicitations, et veut comprendre si les freins mis en interne sont légitimes. Pour pouvoir prendre le rendez-vous, il lui faut une présentation à faire circuler en interne au préalable. Ca y est, la relation entre le visiteur et vous est initiée. Aux commerciaux de jouer maintenant, ils ont tous les éléments et le contexte pour le faire. Cet échange est illustré dans cette [vidéo de présentation](https://www.youtube.com/watch?v=QbZBn3GnCFI). ## Est-ce compliqué à mettre en oeuvre ? Non. La plupart des entreprises ont conscience que leur site Web est à améliorer et veulent d'abord avoir un contenu propre avant de se lancer. C'est une erreur. Plus votre contenu source est bon, plus les réponses seront précises, certes. Mais ce n'est pas un prérequis bloquant. Le levier le plus rapide, c'est souvent la qualité des **instructions** et des **scénarios conversationnels**. En une heure de travail bien menée, on peut déjà définir : - ce que le chatbot doit savoir ; - les offres à pousser selon le besoin ; - les questions de qualification utiles ; - les signaux d'un prospect chaud ; - le bon moment pour proposer un rendez-vous ; - les informations minimales à collecter. Même avec un contenu source moyen, le chatbot peut clarifier l'offre, orienter vers les bonnes pages, poser les bonnes questions et transmettre un résumé propre à l'équipe commerciale. Avec un contenu source excellent, il devient évidemment encore plus pertinent. ## Le moment compte autant que le message Il ne faut pas attendre que le visiteur cherche activement le chatbot. Certains signaux montrent qu'il peut avoir besoin d'aide : il reste longtemps sur une page, lit un article technique, revient plusieurs fois sur une offre, ou hésite sur une page de contact. Dans ces moments-là, afficher automatiquement une invitation discrète peut faire la différence : > *« Vous avez une question sur cette approche ? Je peux vous aider à voir si elle s'applique à votre contexte. »* Le bon chatbot ne contraint pas. Il propose une aide utile au bon moment. ## L'approche Ask This Guy Chez **Ask This Guy**, notre approche part d'une idée simple : le dialogue avec le visiteur doit être utile et lui apporter de la valeur, pas le contraindre. Le chatbot ATG s'appuie sur votre site, vos argumentaires et votre ton. Il répond, qualifie, collecte les coordonnées naturellement, puis notifie votre équipe commerciale avec le résumé de l'échange. L'information peut aussi partir vers votre CRM ou un outil de calendrier. La mise en place est volontairement simple : cadrage des instructions, configuration du chatbot, puis quelques lignes de code à intégrer. Sur des sites vitrines B2B, nous constatons généralement **+30 à 50 % de leads supplémentaires** lorsque le chatbot est bien positionné et bien instruit. Vous pouvez découvrir la solution ici : [chatbot site internet pour entreprise](https://www.askthisguy.com/fr/solutions/website-chatbot/), ou regarder la vidéo [Faites enfin du business avec votre site Web B2B](https://www.youtube.com/watch?v=QbZBn3GnCFI). ## Vous voulez en savoir plus ? Dialoguez avec notre bot ou [prenez rendez-vous avec nous](https://www.askthisguy.com/fr/demo/) ! --- # L'IA contextualisée pour votre entreprise : 6 gains concrets de productivité URL: https://www.askthisguy.com/fr/blog/contextual-ai-rag-use-cases/ Language: fr Section: Blog Les IA généralistes sont entrées dans le quotidien des entreprises. Elles savent rédiger, reformuler, résumer, générer des idées ou préparer des documents. Elles augmentent, si elles sont bien utilisées, la **productivité individuelle**. Une IA contextualisée pour l'entreprise permet d'aller plus loin. Tout le monde travaille avec une même base de connaissances : procédures, offres, contrats, historiques clients, études, dossiers techniques, règles internes, vocabulaire métier et outils. Techniquement, l'une des briques clés pour y parvenir s'appelle le **RAG** (*Retrieval-Augmented Generation*) : une méthode qui permet à l'IA de rechercher dans vos sources internes avant de répondre. Nous l'expliquons dans notre article [RAG en IA : connecter un LLM à vos documents d'entreprise](https://www.askthisguy.com/fr/blog/rag-tutorial/). Dans cet article, nous nous focalisons plutôt sur l'usage. ## L'IA individuelle peut aggraver la dispersion Le premier réflexe est souvent de laisser chaque salarié utiliser une IA généraliste. Chacun gagne du temps, chacun teste ses prompts, chacun travaille avec ses documents. Mais cela peut renforcer un problème déjà très présent en entreprise : la **dispersion de l'information**. Un commercial repart d'une ancienne proposition. Un autre garde son propre argumentaire. Un nouveau collaborateur apprend les règles par fragments. Une personne clé est sollicitée dix fois par semaine pour transmettre la même information. L'IA généraliste accélère alors chaque bulle individuelle, mais elle ne crée pas une **connaissance commune**. C'est le sujet de fond que nous traitons dans [Knowledge management : pourquoi vos démarches échouent](https://www.askthisguy.com/fr/blog/knowledge-management-why-it-fails/). ## Pourquoi ne pas laisser les salariés utiliser une IA grand public ? Les IA grand public restent utiles pour réfléchir ou rédiger. Mais elles ont trois limites pour une entreprise. - **Confidentialité.** Concrètement, les documents internes seront utilisées pour entrainer les modèles IA. Dit autrement, vos informations confidentielles peuvent très bien être données à un concurrent faisant une requête sur le même modèle dans six mois ou un an. **Une fuite de données intraçable et irréversible.** - **Temps perdu à charger le contexte.** Chaque collaborateur doit retrouver les bons fichiers, vérifier les versions, les joindre, expliquer le contexte, puis contrôler la réponse. - **Absence de mutualisation.** Les collaborateurs continuent généralement d'utiliser les fichiers et ressources qu'ils connaissent déjà, même s'ils ne sont pas les plus à jour ou les plus pertinents. Cela empêche la diffusion des bonnes pratiques : chacun reste dans sa logique, les doublons et les erreurs de version persistent, et l'information réellement utile circule mal d'une équipe à l'autre. Une IA contextualisée répond à cette limite. Elle se branche sur les sources utiles, respecte les droits, cite ses sources et fait émerger une connaissance commune. ## Le coût caché des interruptions Le problème n'est pas seulement le temps perdu à chercher une information. C'est le **temps perdu à donner l'information** qui coûte cher : messages, relances, appels rapides, réunions improvisées, demandes aux mêmes experts internes. Le [State of the Workplace d'ActivTrak](https://www.activtrak.com/resources/state-of-the-workplace/) rappelle que les interruptions sont le premier frein de productivité dans toutes les catégories de collaborateurs, citées par **53 % des travailleurs**. Une information introuvable ne ralentit donc pas seulement la personne qui cherche. Elle interrompt aussi celle qui la donne. Dans une entreprise, cette mécanique coûte cher parce qu'elle se répète plusieurs fois par heure. Une bonne IA contextualisée ne sert pas seulement à répondre plus vite. Elle sert aussi à **éviter de déranger la mauvaise personne pour retrouver la bonne information**. **Voici quelques gains de productivité concrets à déployer une IA contextualisée** ## 1. Réduire le temps perdu à chercher ou transmettre l'information **Gains clés :** ⏱️ gain de temps. Où est la dernière grille tarifaire ? Quelle règle s'applique à ce cas client ? Qui avait travaillé sur ce sujet ? Quelle version de la procédure est encore valable ? Une IA contextualisée répond en s'appuyant sur vos documents, vos historiques, vos bases de connaissance et vos outils métier. Elle ne remplace pas les experts internes. Elle évite de les interrompre pour des **questions répétitives**. ## 2. Accélérer la formation et la conduite du changement **Gains clés :** ⏱️ gain de temps ; 🎓 meilleure formation. Chaque changement important consomme beaucoup d'énergie : nouvelles règles, nouveaux outils, nouvelle doctrine, nouvelles obligations réglementaires. Prenons la réforme de la facturation électronique. L'approche classique consiste à produire des supports, organiser des formations, diffuser des documents généraux, les adapter à l'entreprise, puis répondre aux questions une par une. Cela prend du temps à ceux qui préparent, à ceux qui animent et à ceux qui assistent. **U**n chatbot contextualisé peut être configuré rapidement** avec les documents officiels, les règles propres à l'entreprise, les procédures internes et le vocabulaire métier. Chaque collaborateur pose ses questions au moment où il en a besoin : *« Est-ce que ce client est concerné ? »*, *« Quelle procédure appliquer pour ce cas ? »*, *« Où trouver le bon modèle ? »* Le résultat est plus efficace qu'une formation unique : moins d'information subie, plus de réponses utiles, et une **doctrine plus homogène**. ## 3. Préparer les rendez-vous clients et détecter des opportunités **Gains clés :** ⏱️ gain de temps ; 📈 augmentation des ventes. Un commercial ne perd pas seulement du temps à vendre. Il perd du temps à préparer : historique du compte, contrats, tickets support, offres déjà envoyées, objections passées, incidents, opportunités ouvertes. Une IA contextualisée peut préparer une synthèse exploitable avant le rendez-vous et faire émerger des **signaux faibles** : une option jamais proposée, un besoin récurrent dans les tickets, un contrat arrivant à échéance, un cas client similaire à réutiliser. L'IA dépasse alors le simple assistant de rédaction. Elle devient un outil de capitalisation commerciale. ## 4. Donner au management un accès direct à la vraie information **Gains clés :** ⏱️ gain de temps ; 🎯 meilleurs choix stratégiques. Dans beaucoup d'organisations, l'information remonte par couches successives : synthèse, tableau, réunion, reformulation, arbitrage. Le dirigeant reçoit une version utile, mais déjà filtrée. Ces **filtres managériaux** déforment parfois l'information, volontairement ou non. Un problème terrain peut être minimisé. Une objection commerciale peut être reformulée. Un signal faible peut disparaître parce qu'il ne rentre pas dans le reporting habituel. Une IA contextualisée donne au management un accès plus direct à la connaissance réelle de l'entreprise. Un DG, un directeur commercial ou un responsable de BU peut demander : - *« Quels sont les motifs de réclamation qui progressent depuis trois mois ? »* - *« Quels clients ont déjà demandé cette fonctionnalité ? »* - *« Quelles objections reviennent le plus souvent sur cette offre ? »* Le management gagne en autonomie et réduit le besoin de coordination : moins de réunions pour obtenir une première vision, moins de demandes ad hoc, moins de retraitements successifs. Surtout, les managers restent mieux connectés au terrain, avec moins de déformation entre la réalité opérationnelle et la décision. Certains pensent même qu'avec l'IA, le management devient obsolète. C'est sans doute excessif, mais le gain de temps est réel. Les managers peuvent alors se concentrer à de tâches à plus forte valeur ajoutée que la transmission de l'information. ## 5. Réduire les erreurs liées aux mauvaises versions de documents **Gains clés :** 🛡️ réduction des coûts liés aux erreurs. Les mauvaises versions coûtent cher : ancienne proposition commerciale, procédure qualité remplacée, condition contractuelle copiée depuis un ancien client, fiche produit obsolète. Une IA généraliste utilise ce qu'on lui donne. Si le collaborateur joint le mauvais fichier, elle produira une réponse propre, convaincante, mais potentiellement fausse. Une IA contextualisée peut privilégier les **sources officielles**, les documents récents, les espaces validés, les droits d'accès et les contenus approuvés. Une erreur évitée dans une offre, une procédure, un engagement client ou une décision qualité peut financer une grande partie du projet. ## 6. Réutiliser les travaux existants : R&D, propales, études, contenus **Gains clés :** ⏱️ gain de temps ; 🧠 meilleur niveau technique. Une entreprise produit beaucoup plus de connaissance qu'elle ne l'imagine : études R&D, benchmarks, prototypes, notes techniques, analyses concurrentielles, contenus de propositions commerciales, réponses à appels d'offres, supports de formation. Le problème est rarement l'absence de contenu. Le problème est de savoir que ce contenu existe. Une IA contextualisée aide à **ne jamais repartir de zéro** : retrouver une étude, réutiliser un paragraphe d'une ancienne proposition, identifier un benchmark proche, retrouver une réponse technique déjà validée, mutualiser des travaux entre équipes. Pour une propale, cela évite de réécrire ce qui existe déjà. En R&D, cela évite de refaire une étude ou de perdre une hypothèse déjà testée. ## Ce qu'il faut mesurer pour parler de ROI Un projet d'IA contextualisée doit partir d'un irritant opérationnel clair : recherche d'information, formation, préparation commerciale, coordination managériale, erreurs de version ou réutilisation de contenu. Mesurez simplement : temps de recherche évité, sollicitations aux sachants, vitesse de formation, temps de préparation commerciale, documents réutilisés, erreurs évitées, réunions raccourcies. Le ROI ne vient pas d'un grand effet magique. Il vient de **centaines de micro-frictions supprimées**. ## L'approche Ask This Guy Chez **Ask This Guy**, nous abordons l'IA contextualisée comme une infrastructure de connaissance, pas comme un simple chatbot branché sur un drive. C’est le cœur de notre [solution RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/). ATG permet notamment de brancher des [connecteurs de connaissance](https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors), de traiter des [documents complexes](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-processing) et d'ajouter des [outils métier sur mesure](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools). Les IA généralistes peuvent rester utiles pour des usages individuels. Mais si votre enjeu est la productivité collective, la qualité de l'information, la souveraineté, la réutilisation des contenus et l'homogénéité des pratiques, il faut une approche adaptée à votre entreprise. ## Conclusion : l'IA productive est une IA qui connaît votre entreprise L'IA grand public a montré ce que les modèles peuvent faire pour un individu : écrire plus vite, résumer plus vite, réfléchir plus vite. La prochaine étape est différente : faire en sorte que l'IA rende l'entreprise elle-même plus productive. Cela suppose une IA capable de comprendre vos sources, vos règles, vos formats, vos historiques, votre doctrine et votre vocabulaire. Une IA qui ne laisse pas chaque collaborateur dans sa bulle documentaire, mais qui aide toute l'organisation à mieux partager et réutiliser sa connaissance. **[Réservez une démo](https://www.askthisguy.com/fr/demo/) : nous vous aiderons à identifier le premier cas d'usage d'IA contextualisée capable de produire un gain de productivité mesurable dans votre entreprise.** --- # RAG entreprise : 5 erreurs qui arrivent après le POC URL: https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/ Language: fr Section: Blog Un **RAG** (*Retrieval-Augmented Generation*) est une architecture qui permet à une IA de chercher dans vos sources internes avant de répondre : documents, bases de connaissances, procédures, contrats, parfois bases de données ou web. Si le sujet est nouveau pour vous, vous pouvez commencer par notre page de documentation [Données et RAG](https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag). Mettre en place un RAG d'entreprise donne souvent une impression trompeuse. En quelques heures, vous pouvez obtenir une première démo convaincante. Vous prenez dix documents bien choisis, vous les faites passer dans un pipeline, et l'assistant répond déjà à des questions qui ressemblent à de vrais cas d'usage. Imaginez une direction RH qui teste un assistant interne. On lui donne le règlement intérieur, la convention collective, trois procédures de congés, deux notes sur le télétravail et une FAQ. Un collaborateur demande : "Combien de jours de télétravail puis-je prendre par semaine ?" L'assistant retrouve le bon passage, synthétise la réponse, cite la source. Tout le monde sourit. Le POC est validé. Puis arrive la production. Il ne s'agit plus de répondre à dix questions sur dix documents propres. Il faut absorber des milliers de fichiers, plusieurs versions contradictoires, des droits d'accès, des noms de produits, des références clients, des tableaux, des documents scannés, du jargon interne, et des utilisateurs pressés qui formulent rarement leurs demandes comme dans une démo. Rien d'étonnant à ce que [95% des projets IA échouent](https://fortune.com/2025/08/18/mit-report-95-percent-generative-ai-pilots-at-companies-failing-cfo/) en entreprise. Un RAG n'échoue presque jamais parce que le concept est mauvais. Il échoue parce que **l'entreprise confond une démo réussie avec un système prêt pour la production.** Voici cinq erreurs que nous constatons régulièrement chez nos clients. ## Erreur n°1 : prendre le POC pour la réalité Le premier piège du RAG, c'est sa facilité apparente. Pour une démo, le chemin est court : choisir un petit corpus, convertir les fichiers, découper le texte, calculer les embeddings, rechercher les extraits pertinents, puis générer une réponse. Cette chaîne fonctionne vite si les documents sont propres et le sujet bien cadré. Mais un système de production ne travaille pas dans un décor préparé. Dans une entreprise, les documents sont rarement homogènes. Vous avez des PDF exportés depuis Word, des présentations, des tableaux Excel, des captures d'écran, des tickets, des contrats, des comptes rendus et souvent des fichiers dont personne ne connaît vraiment l'origine. Le problème n'est pas seulement le volume. C'est la diversité, le statut des documents, et les incohérences entre sources. Une procédure de 2023 peut être techniquement pertinente mais remplacée par une note de 2026. Un contrat client peut contenir une exception qui contredit la règle générale. Une slide commerciale peut simplifier un produit que la documentation technique décrit autrement. Il faut aussi "éduquer" l'IA au vocabulaire de l'entreprise : acronymes internes, surnoms de produits, noms de projets, abréviations métier, anciennes appellations encore utilisées par les équipes. Sans ce travail, l'assistant peut chercher au mauvais endroit ou rater une information pourtant présente. > La connaissance d'entreprise n'est pas un tas de fichiers. C'est un ensemble de sources, de versions, de droits, de priorités et de vocabulaire partagé. Cet écart entre ce qui est rangé et ce que l'entreprise sait réellement n'a rien de nouveau : c'est l'échec classique des démarches de [gestion des connaissances](https://www.askthisguy.com/fr/blog/knowledge-management-why-it-fails/), et un RAG mal cadré en hérite tel quel. Pour passer en production, il faut donc décider quelle version fait autorité, quels fichiers ignorer, quels droits appliquer, comment gérer les contradictions et comment citer les sources. Ces sujets paraissent administratifs. En réalité, ils conditionnent la confiance. ## Erreur n°2 : dépendre d'un seul fournisseur d'IA Une entreprise attend d'un outil interne qu'il soit disponible, rapide et stable. Dans beaucoup de contextes, la référence implicite est celle des applications SaaS matures : 99,99 % de disponibilité, des temps de réponse prévisibles, peu d'interruptions visibles. Avec les modèles d'IA, cette attente se heurte à une réalité plus rude. Les fournisseurs d'IA sont puissants, mais ils ne se comportent pas toujours comme des briques d'infrastructure classiques. Les latences varient, certaines requêtes échouent, des modèles deviennent temporairement indisponibles, les performances changent selon la charge, les régions ou les mises à jour internes. Chez ATG, nous mesurons de façon permanente la vitesse de réponses des API de nombreux fournisseurs d'IA. Le benchmark ci-dessous compare le taux de succès de plusieurs fournisseurs sur des tâches de génération de texte.  Attention : ce graphe ne mesure que le taux de succès. Il ne dit rien de la latence. Un fournisseur peut afficher un excellent taux de réussite, mais répondre trop lentement pour une bonne expérience utilisateur (c'est le cas pour OpenAI notamment). La conclusion est simple : si votre RAG dépend d'un seul fournisseur d'IA et d'un seul modèle, toute l'expérience utilisateur dépend de cette brique. La bonne approche consiste plutôt à concevoir une architecture capable de changer de route : - plusieurs fournisseurs d'IA pour un même type de tâche ; - plusieurs modèles selon la complexité de la question ; - des mécanismes de fallback quand une requête échoue ; - du monitoring sur la latence, les erreurs et la qualité ; - une sélection dynamique du modèle le plus adapté. **Le bon objectif n'est pas de trouver le fournisseur parfait. C'est de ne jamais dépendre d'un seul fournisseur.** ## Erreur n°3 : croire qu'il suffit de déployer son propre modèle d'IA La solution paraît alors simple : il suffit de déployer son propre modèle d'IA. Sur le papier, l'idée est séduisante. Vous réduisez la dépendance externe, vous maîtrisez l'infrastructure, vous contrôlez mieux vos données. Et si le RAG fournit les bons extraits, le modèle n'a plus qu'à rédiger la réponse, non ? Pas vraiment. Les requêtes réelles sont rarement propres. Un utilisateur ne demande pas : > Quelle est la procédure de validation des congés payés ? Il demande plutôt : > euh pour Sophie du support elle veut poser 3j juste avant le rush, elle a deja pas mal abusé ce trimestre non ? on peut refuser ou faut tourner ça cmt? Le système doit comprendre la demande, retrouver les bons textes, distinguer règle générale et cas particulier, éviter de valider un biais managérial, puis proposer une formulation exploitable. La recherche apporte les sources. Le modèle doit encore raisonner. Le local peut avoir du sens pour des cas cadrés : extraction simple, reformulation, classification, RAG factuel sur un domaine étroit. Mais dès que l'assistant doit traiter des questions métier ambiguës, croiser plusieurs sources ou utiliser des outils, les modèles plus puissants redeviennent difficiles à éviter. Nous avons détaillé ce sujet dans notre article sur les [LLM en local](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/). Le point clé est simple : faire tourner un modèle robuste avec de bonnes performances coûte cher, surtout avec plusieurs utilisateurs simultanés. Cette erreur en cache souvent une autre : confondre **RAG on-premise** et LLM hébergé chez soi. Un RAG on-prem se décompose en trois couches indépendantes : les données et le retrieval (index, droits d'accès, citations), la plateforme (connecteurs, ingestion, évaluation, monitoring), et l'inférence. Les deux premières peuvent rester chez vous, là où se trouvent déjà vos documents et vos droits, sans acheter le moindre GPU. Beaucoup de projets « on-prem » s'enlisent parce qu'ils attaquent l'inférence en premier, alors que le délai et le coût réels sont sur les deux autres couches. Nous avons chiffré l'arbitrage dans notre analyse du [RAG on premise](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/). La bonne stratégie n'est donc pas de choisir une fois pour toutes entre cloud, local, petit modèle ou grand modèle. C'est d'orienter intelligemment les requêtes : modèle léger pour les tâches simples, modèle plus puissant pour les raisonnements complexes, modèle spécialisé pour les embeddings ou la vision, fournisseur alternatif si le premier est lent. ## Erreur n°4 : faire uniquement de la recherche vectorielle Beaucoup de projets RAG commencent avec une recherche vectorielle pure. C'est logique : les embeddings sont au cœur du RAG moderne, et la recherche sémantique est impressionnante. Elle permet de retrouver un passage même si l'utilisateur n'emploie pas les mêmes mots que le document. "Politique de télétravail" peut retrouver "modalités de travail à distance". "Comment déclarer une absence ?" peut retrouver "procédure d'absence maladie". Mais l'entreprise manipule énormément d'informations qui n'ont pas de sens sémantique universel. Un nom de client, une référence produit, un code projet, un identifiant contrat, un acronyme interne ou le nom d'un collaborateur ne "signifie" pas grand-chose pour un embedding. `ACME-0427`, `Projet Atlas`, `PRD-19-B`, `Jean Martin` ou `Pack Horizon` sont des clés. Pas des concepts. Si votre RAG repose uniquement sur la proximité sémantique, il risque de manquer précisément les informations que les utilisateurs cherchent. C'est pour cela qu'un bon RAG combine (au moins) recherche sémantique, recherche par mots-clés, métadonnées et priorisation des sources en fonction de leur fiabilité. Le RAG doit aussi apprendre à arbitrer entre documents contradictoires : date, propriétaire, statut, périmètre, source officielle, exception contractuelle. Sinon, il ne répond pas à partir de "la connaissance de l'entreprise". Il répond à partir d'un tas de fichiers. > Un bon RAG ne trouve pas seulement un passage proche. Il trouve le bon passage, dans le bon document, avec le bon niveau d'autorité. ## Erreur n°5 : croire que les utilisateurs veulent seulement chercher Le dernier piège est souvent découvert trop tard : les utilisateurs ne veulent pas seulement chercher. Au début, ils sont impressionnés par un assistant capable de répondre à partir des documents internes. Puis, très vite, ils demandent autre chose : - "Peux-tu me rédiger une note de synthèse au format Word ?" - "Va vérifier si cette information est toujours vraie sur Internet." - "Compare cette procédure avec le contrat du client." - "Envoie-moi la synthèse par e-mail" - "Cherche dans le CRM." - "Fais-moi un tableau exploitable." Autrement dit, ils ne perçoivent pas l'outil comme un simple RAG. Ils le perçoivent comme une interface de travail. Si votre solution ne sait faire que de la recherche documentaire, elle atteindra vite son plafond d'usage. C'est là que les architectures agentiques, les outils (recherche web, génération de documents, etc.) et des protocoles comme [MCP](https://www.askthisguy.com/fr/blog/how-mcp-accelerate-agentic-ai/) deviennent importants. Mais ajouter des outils ne suffit pas. Il faut aussi une interface fluide, intégrée aux usages existants quand c'est possible, et suffisamment claire pour que l'utilisateur comprenne ce que l'assistant sait faire. Enfin, il faut mesurer. Un système RAG ne se valide pas avec cinq questions en comité projet. Il se valide avec des centaines, puis des milliers de questions représentatives : simples, ambiguës, hors périmètre, avec noms propres, sur documents anciens, avec sources contradictoires, ou nécessitant un outil. Il faut générer des questions réalistes, analyser les feedbacks utilisateurs, suivre les échecs, analyser les sources citées, mesurer les temps de réponse et rejouer des jeux de tests après chaque changement. ## Si vous ne devez retenir qu'une chose Un RAG est facile à lancer, mais difficile à industrialiser. La démo montre le potentiel. La production révèle les contraintes : gouvernance documentaire, jargon métier, incohérences entre sources, disponibilité des fournisseurs d'IA, routage des modèles, recherche hybride, outils, interface et mesure de la qualité. Le vrai sujet n'est pas de brancher une IA sur vos documents. **C'est de construire un système fiable qui sait quoi chercher, où chercher, à qui répondre, avec quel modèle et avec quel niveau de confiance.** ## L'approche Ask This Guy Chez Ask This Guy, nous abordons le RAG comme une brique de production, pas comme une simple recherche vectorielle. Nous connectons les sources documentaires de l'entreprise, adaptons le traitement aux formats réels, combinons recherche sémantique, mots-clés, métadonnées et reranking, utilisons plusieurs modèles et fournisseurs d'IA selon les besoins, intégrons des outils ou serveurs MCP quand le cas d'usage le justifie, et mesurons les performances comme les feedbacks utilisateurs. Le but n'est pas de promettre un assistant magique. Le but est de construire un système fiable, explicable et utile, capable de progresser avec vos usages. Si votre projet prend la forme d'un [chatbot interne entreprise](https://www.askthisguy.com/fr/blog/internal-company-chatbot/), les mêmes écueils s'appliquent, avec en plus la question des droits d'accès. Si vous préparez un [RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/), commencez par la bonne question : non pas "peut-on faire une démo ?", mais "qu'est-ce qui devra tenir quand 500 utilisateurs poseront de vraies questions sur de vraies données ?" **[Réservez une démo](https://www.askthisguy.com/fr/demo/)** pour voir comment Ask This Guy peut vous aider à passer du RAG prometteur au RAG réellement utilisable en entreprise. --- # Bien automatiser avec l'IA : utiliser le moins d'IA possible URL: https://www.askthisguy.com/fr/blog/use-minimal-ai-automation/ Language: fr Section: Blog Vous souhaitez **automatiser** des tâches répétitives avec l’**intelligence artificielle** ? La vraie question n’est pas seulement *ce que l’IA peut faire*, mais **ce qu’elle doit vraiment faire**. Car oui, l’IA permet aujourd’hui de concevoir des automatisations plus vite. Mais en production, la meilleure stratégie reste souvent la plus simple : > **N'utilisez l’IA que lorsqu’il n’existe pas de solution fiable sans elle.** Cet article répond à une question très concrète : **comment faire de l’automatisation avec l’IA sans rendre son système plus fragile, plus cher et plus compliqué à maintenir ?** ## Si vous ne devez retenir qu'une chose... Si une tâche peut être **figée**, **règlée** et **testée**, elle doit plutôt être automatisée de manière classique. Si une tâche demande de **comprendre du contexte**, de **reformuler**, de **personnaliser** ou de **structurer de l’information floue**, alors l’IA devient pertinente. Autrement dit : - **le code classique** gère le prévisible ; - **l’IA** gère l’imprévisible ; - **l’humain** garde le contrôle là où l’erreur coûte cher. ## Le vrai piège : vouloir mettre de l’IA partout Depuis l’arrivée de ChatGPT et des autres assistants IA, un réflexe s’est installé dans beaucoup d’entreprises : *« Avec l’IA, on doit forcément pouvoir automatiser ça. »* Le réflexe est compréhensible. Les démonstrations sont bluffantes, les usages se multiplient, et l’on voit bien les **avantages de l’intelligence artificielle en automatisation d’entreprise**. Mais il y a un biais fréquent : on part de la **solution IA** avant d’avoir cadré le **problème métier**. La bonne question n’est donc pas : > *« Comment mettre de l’IA dans ce processus ? »* La bonne question est : > *« Quelle partie de ce processus nécessite réellement de l’IA ? »* Et souvent, la réponse est : **une petite partie seulement**. ## Oui, l’IA change la donne... surtout pour construire plus vite Dire qu’il faut utiliser le moins d’IA possible en production ne veut pas dire qu’il faut minimiser son impact. Au contraire : **l’IA a déjà transformé la manière de développer des automatisations**. Là où il fallait auparavant : - coder entièrement à la main ; - ou assembler des scénarios no-code parfois fragiles dans Make, n8n ou Zapier ; - ou renoncer parce que le projet semblait trop coûteux ; il est désormais possible de construire plus vite des systèmes : - **robustes** ; - **maintenables** ; - **moins chers à l’usage** ; - et donc rentables sur des cas qui ne l’étaient pas auparavant. En clair, l’IA est formidable comme **accélérateur de conception**. Elle est beaucoup moins intéressante quand on lui délègue **à chaque exécution** des opérations qui pourraient être traitées de manière déterministe. ## Deux types d’automatisation à distinguer Pour bien décider, il faut séparer deux logiques. ### 1. L’automatisation déterministe (à traiter par scripts / workflows) Une entrée donne toujours la même sortie. C’est le monde des règles, des templates, des calculs, des mappings, des scripts, des workflows bien cadrés. En pratique, c’est ce qu’il faut privilégier dès que possible, pour trois raisons : - **Fiabilité** : le comportement est prévisible. - **Sobriété** : le coût d’exécution reste faible. - **Rapidité** : on évite les vérifications inutiles. ### 2. L’automatisation probabiliste (à traiter par IA) Même avec la même consigne, le résultat peut varier légèrement. Cela ne veut pas dire que c’est mauvais. Cela veut dire qu’il faut utiliser cette approche **là où la variabilité est utile**, pas là où elle devient un risque. En général, l’IA est pertinente quand il faut : - comprendre un contexte riche ; - analyser des documents variés (PDF, scans, pièces jointes, etc.) pour retrouver une information présente sous des formes différentes ; - synthétiser des contenus non structurés ; - rédiger un texte personnalisé ; - classer ou reformuler de l’information ambiguë ; - transformer des données brutes en structure exploitable. ## La règle pratique Quand une tâche est **répétitive**, **stable** et **clairement définie**, essayez d’abord **sans IA**. Quand une tâche dépend du **contexte**, du **langage**, de la **nuance** ou de données **mal structurées**, l’IA peut apporter une vraie valeur. > **L’IA n’est pas là pour remplacer les règles. Elle est là pour traiter ce que les règles seules ne savent pas bien capturer.** ## Exemple concret : automatiser des bons de commande Prenons un cas très simple à comprendre : la génération de **bons de commande**. Vous partez d’un modèle Word pour le document final, et de données à injecter dedans. Dans certains cas, ces données sont déjà dans un Excel. Dans d’autres, elles sont dispersées dans des e-mails, des comptes-rendus de réunion ou différents fichiers. ### Cas 1 : quand l’entrée n’est pas propre Avant même de générer le document, il faut parfois **fabriquer l’entrée**. Les informations sont peut-être disséminées dans : - un échange commercial par e-mail ; - une réunion de cadrage ; - des notes prises à la volée ; - un PDF envoyé par le client. Dans cette phase, l’IA est très utile. Elle peut lire ces sources, extraire les bonnes informations, puis produire un **Excel brouillon** ou une structure équivalente. Cette sortie est ensuite **validée** par un humain avant de déclencher le reste du processus. Autrement dit, l’IA sert ici à **mettre de l’ordre dans du flou**. ### Cas 2 : tout ce qui peut être figé doit l’être Une fois les données validées, la logique change. Les champs comme : - `{{NUMERO_CLIENT}}` - `{{DATE_COMMANDE}}` - `{{NB_ARTICLES}}` - `{{MONTANT_TOTAL}}` ne demandent aucune intelligence artificielle. Un script peut remplir le document de manière fiable, instantanée et reproductible. C’est précisément là qu’il faut éviter de solliciter un modèle. Et cela ne concerne pas seulement des champs simples. On peut aussi gérer de manière déterministe des **blocs de texte entiers**. Par exemple : - si le client est en France, on garde la clause juridique A ; - si le client est hors UE, on insère la clause export B ; - si le montant dépasse un certain seuil, on ajoute le paragraphe de validation interne ; - si le produit est un abonnement, on conserve les conditions de renouvellement ; - sinon, on garde une version plus simple du document. Autrement dit, même le choix d’un **paragraphe**, d’une **clause** ou d’une **section complète** peut souvent être piloté par des règles métier très claires, sans aucune IA. ### Cas 3 : là où l’IA devient vraiment utile Imaginons maintenant que vos commerciaux perdent du temps à rédiger à la main une courte introduction personnalisée pour chaque client. Le besoin n’est pas de remplir un champ, mais de produire un texte comme : *« Cher [Nom du client], nous sommes ravis de vous accompagner depuis [Date de première commande]. Votre fidélité nous touche particulièrement, et nous espérons que ce nouveau lot de [Type de produits] répondra à vos attentes pour [Projet en cours]. »* Ici, il faut tenir compte du ton à adopter, de l’historique de la relation, du type de produits, du contexte commercial et du projet en cours chez le client. Et intégrer des informations dans le corps du texte. Dans ce cas, l’IA peut préparer un premier jet à partir d’un contexte bien structuré. L’utilisateur relit, corrige, apporte sa patte, valide. ### Synthèse du workflow ```mermaid flowchart LR A[Sources brutesEmails, audio réunion, PDF, etc.] --> B[IA
Extraction et structuration
Génération d'un Excel] B --> C[Validation humaine] C --> D[Automatisation déterministe
champs, clauses, paragraphes conditionnels] C --> E[IA contextuelle
introduction personnalisée] D --> F[Assemblage du document Word] E --> F F --> G[Finalisation] ```
Le schéma résume le trajet d’un document : les sources brutes (emails, audio de réunion, PDF) passent par une extraction IA qui produit un fichier structuré, qu’un humain valide avant toute production. La suite se sépare en deux branches, l’automatisation déterministe pour ce qui est réglé d’avance et l’IA contextuelle pour les seuls passages qui demandent du jugement, avant l’assemblage du document Word.
## Pourquoi ne pas tout donner à votre IA préférée ? Sur le papier, la promesse est séduisante : *« je donne le modèle, les données, et l’IA génère tout le document. »* Mais un modèle génératif a tendance à modifier aussi ce qu’il ne devrait pas toucher : la mise en page, des numéros, certains libellés ou des formulations sensibles. Quelques petites erreurs suffisent alors à annuler le gain de temps. Et surtout, un prompt qui fonctionne aujourd’hui peut se comporter différemment demain. Une bonne automatisation repose donc rarement sur un seul gros prompt, mais sur une **architecture claire**, avec une place précise donnée à l’IA. ## La première question n’est pas technique : c’est le ROI Avant de parler outil, workflow ou prompt, il faut mesurer le **temps réellement perdu** par votre équipe. Sans estimation sérieuse du temps-homme mobilisé, il est difficile de savoir si l’automatisation vaut le coup. Voici les bonnes questions à se poser : 1. Combien d’heures l’équipe passe-t-elle sur cette tâche ? 2. À quelle fréquence revient-elle ? 3. Quel est le coût complet de l’automatisation ? 4. Quel sera le coût de maintenance dans 6 mois, 12 mois, 24 mois ? 5. Le coût d’une erreur est-il faible ou élevé ? Quelques repères simples : - Si vous **externalisez** le projet, viser **au moins ×2** est un minimum raisonnable. - Si vous le faites **en interne**, mieux vaut viser **au moins ×4**, car le gain est souvent moins direct et plus diffus. - Dans tous les cas, intégrez la **maintenance** dans le calcul. C’est souvent la partie la plus sous-estimée. Si vous passez à côté de ce point, vous risquez de financer une jolie démo plutôt qu’un vrai gain durable. ## Ce qu’il faut retenir L’**automatisation par IA** n’est pas une question de quantité d’IA. C’est une question de **placement**. Plus vous réussissez à : - figer ce qui peut l’être ; - réserver l’IA à ce qui est vraiment contextuel ; - et garder un contrôle humain ciblé ; plus votre automatisation a des chances d’être utile dans la durée. ## Le lien avec ATG Chez **Ask This Guy**, c’est exactement l’approche que nous défendons avec **ATG** : utiliser des **agents** et des **outils** pour brancher intelligemment l’IA sur vos données et vos systèmes, sans transformer tout votre processus en boîte noire probabiliste. Pour aller plus loin : - [Agent IA en entreprise : cas d'usage et coûts réels](https://www.askthisguy.com/fr/blog/enterprise-ai-agents/) - [Personnaliser ATG](https://www.askthisguy.com/fr/doc/customizing-atg-to-you) - [Créer des outils sur mesure](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools) - [Traiter sur-mesure vos données/processus](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-processing) - [Configurer des agents](https://www.askthisguy.com/fr/doc/admin-console/how-to-configure-the-agents) - [Connecter des outils et MCP](https://www.askthisguy.com/fr/doc/admin-console/tools-management) **[Réservez une démo](https://www.askthisguy.com/fr/demo/)** si vous souhaitez identifier, dans vos processus, ce qui doit rester déterministe et ce qui mérite réellement l’IA. --- # Vos bases de données sont une mine d'or, l'IA vous fournit les pelles URL: https://www.askthisguy.com/fr/blog/databases-gold-mine-ai-shovels/ Language: fr Section: Blog  ## Le quotidien des équipes : quand chercher l'info devient un parcours du combattant Vous connaissez sûrement cette scène. Un manager a besoin d’une information simple : - Combien de commandes sont en retard sur l'usine de Lyon et quels sont les clients concernés ? - Quels sont nos 10 meilleurs clients ce trimestre ? - Combien d'arrêts maladies actuels ? Quels sont les services impactés ? En théorie, il devrait ouvrir son SI et retrouver l’information par lui-même. En pratique, il va souvent « pinger » un collègue, ou partir en chasse d’un reporting Excel ou PowerPoint déjà existant, quitte à travailler avec des chiffres obsolètes ou déformés. Résultat : du temps perdu, une réponse souvent partielle et souvent **fausse**. **Le vrai coût, ce n’est pas l’outil : c’est le détour.** Chaque sollicitation du « sachant » et chaque fichier recyclé sans requête à la source, c’est du temps et de la qualité de décision qui partent en fumée. ## Documents vs bases de données : deux mondes qui ne se parlent pas Quand une entreprise lance son projet d’IA, qu’est-ce qu’elle fait en premier ? **Elle ingère ses documents.** Elle connecte son SharePoint à Copilot, ou elle met en place [un système RAG](https://www.askthisguy.com/fr/blog/rag-tutorial/) pour interroger ses procédures internes, ses articles Confluence, ses PDFs. C’est logique : ces documents portent toute la complexité de l’entreprise, ses subtilités, son savoir-faire. Et avant l’IA, aucun système informatique ne pouvait vraiment les traiter. Mais il y a un problème. Ces documents sont souvent obsolètes, contradictoires, parfois carrément **faux**. Ils ne sont pas mis à jour régulièrement. Ils reflètent une vision théorique de l'entreprise, pas sa réalité opérationnelle. Pendant ce temps, **les vraies données de référence**, celles qui portent toute la valeur opérationnelle, restent dans l’ombre. Votre base client, vos ordres de fabrication, vos commandes en cours, vos données RH, l’état de vos appareils industriels… tout cela vit dans des bases structurées : SQL, Salesforce, SAP, solutions métier, outils maison. **Les documents racontent une histoire. Les bases portent la vérité du jour.** Tant qu’on ne branche son IA que sur les docs, on a qu'une partie de la vérité. C’est le **vivier de valeur le plus sous-estimé**. Ces données sont fiables, à jour, précises. Mais elles ne sont souvent accessibles que via des interfaces complexes ou des requêtes techniques. Résultat : personne ou presque ne les consulte. ## L'IA comme assistant ultra-contextualisé : des réponses précises à chaque étape Prenons une situation concrète : une responsable souhaite piloter les renouvellements de contrats de sa business unit : - *« Quels sont les contrats arrivant à échéance ce trimestre pour ma BU ? »* L’IA comprend la question, cible la base des contrats, applique les bons filtres, et répond. Un contrat attire l'attention de la collaboratrice : - *« Sur quoi porte le contrat X ? Quel est le montant en jeu ? »* L'IA va alors chercher les informations détaillées dans la base contrats et apporte une fiche synthétique : contenu de la prestation, options souscrites, engagement financier. - *« Rappelle-moi à quoi sert le produit auquel il a souscrit. »* Ici, l’IA va interroger les documents de référence à jour (RAG : brochures internes, fiches produit, anciens appels d’offres). - *« Qui est le point de contact principal sur ce compte ? »* L’IA consulte le CRM, identifie la bonne personne, répond. - *« Donne-moi des infos sur lui, je vais l'appeler. »* L'IA recherche alors dans le CRM, mais également sur le web : profil LinkedIn, dernières actualités, tout ce qui permet de préparer efficacement l’échange. - *« Quelles sont les actualités de l’entreprise de ce client ? »* L’IA analyse les sources web : articles récents, communiqués de presse, signaux faibles sur la santé ou l’actualité de l’entreprise. - *« D’ailleurs, le produit X, on ne le propose plus je crois ? »* L’IA croise l’ensemble de ses sources : les bases internes structurées confirment que le produit n’est plus au catalogue ; le RAG sur les documents internes précise la raison, et selon le contexte marché du client, elle indique : *« Il vaudrait mieux lui proposer Y, mieux adapté à ses enjeux actuels. Voici les principaux arguments de vente.»* À chaque question, l’IA navigue entre bases structurées, documents d’expertise, CRM et veille marché, pour des réponses exploitables, sans jongler entre cinq fenêtres. **Une seule conversation, plusieurs mondes branchés.** Contrats, CRM, docs internes, web : l’intérêt n’est pas de remplacer les outils, mais de les orchestrer au fil des questions — comme un collègue qui connaît tout le SI. ## Finies les idées préconçues : l'information factuelle à portée de question Quand l’information est difficile d’accès, les entreprises se nourrissent d’idées préconçues. *« Ce produit nous prend beaucoup de temps, mais il nous apporte beaucoup de marge. »*. Souvent, ce sont des impressions, pas des faits. Avec un assistant branché sur vos bases, vous obtenez des réponses exactes, pas des approximations. L’interrogation directe des bases retourne des chiffres fiables et à jour. Chaque réponse est instantanée et factuelle, et peut être approfondie au fil des questions. **Fini** le temps perdu entre les interfaces. **Finie** la dépendance aux « sachants ». **Finies** les décisions basées uniquement sur l'intuition. ## Comment Ask This Guy peut vous aider à débloquer vos données **Ask This Guy** est conçu pour cette étape : rendre vos données structurées aussi accessibles que vos documents.  Nous connectons votre assistant à vos [bases SQL](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/database-query), [API](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools) et outils métier via des [outils sur mesure](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools), sécurisés. Chaque intégration est pensée **sécurité d’abord** : l’IA n’exécute que ce que vous autorisez, avec les droits adaptés. La mise en place est progressive : commencez par vos données les plus porteuses de valeur (clients, commandes, production), puis élargissez. En quelques semaines : un seul assistant : RAG sur les docs + interrogation directe des bases. **Le résultat ?** Des équipes autonomes en quelques secondes. Des experts libérés des extractions récurrentes. Des décisions plus rapides et factuelles. Vos bases ne sont plus une mine d’or fermée : elles travaillent pour tous ceux qui en ont besoin, chaque jour. --- # RAG on premise : LLM en local pour votre entreprise, que peut-on faire avec 60 k€ ? URL: https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/ Language: fr Section: Blog Déployer une [**IA ouverte**](https://www.askthisguy.com/fr/blog/open-source-vs-open-weights-ai/), en local, sur vos infrastructures, c'est la promesse d'une [**vraie souveraineté**](https://www.askthisguy.com/fr/blog/souverainete-numerique-dependance-americaine/) et d'une vraie maitrise : vos données restent chez vous, vous maîtrisez l'infrastructure, vous êtes indépendant des providers. Pour un projet d'IA d'entreprise (agent intelligent, RAG, assistant interne, etc.), l'option est séduisante (et parfois indispensable). Beaucoup d'équipes formulent ce besoin sous l'angle **RAG on premise** (ou *RAG on-prem*) : un assistant qui répond depuis *vos* documents, hébergé chez vous. Mais les réflexions habituelles du 'Make or Buy' ou du 'Cloud ou On-Premise' sont très différentes dans le cadre de l'IA au vu du **coût massif** des infrastructures adaptées. Cet article vous donne quelques repères pour décider en connaissance de cause. Pour le panorama complet des options, de l'achat de GPU au fournisseur clé en main, voir notre guide sur l'[inférence IA en entreprise](https://www.askthisguy.com/fr/blog/enterprise-ai-inference/). ## Quelques définitions pour lire la suite sereinement : - **LLM** (Large Language Model) : le "cerveau" du système. C'est ce que vous allez déployer sur votre serveur ; - **Nombre de paramètres** : une mesure de la « taille » du modèle. Plus ce chiffre est élevé, plus le modèle est capable de raisonnements fins (et plus il demande de puissance de calcul et de mémoire) ; - **Inférence** : le moment où le modèle répond à votre requête. On ne parle pas ici de l’entraînement (qui a déjà eu lieu), mais du simple fait de lui poser une question et d’obtenir une réponse ; - **Token** : une petite unité de texte (un mot ou un bout de mot). Quand on dit « 100 tokens par seconde », cela signifie que le modèle produit environ 100 de ces unités chaque seconde : plus ce nombre est élevé, plus la réponse arrive vite ; - **RAG** (Retrieval-Augmented Generation) : une technique qui consiste à donner au modèle l’accès à vos documents (PDF, wiki internes, etc.) pour qu’il réponde en s’appuyant sur *vos* données plutôt que sur sa seule mémoire. Nous expliquons [ce qu'est le RAG en IA](https://www.askthisguy.com/fr/blog/rag-tutorial/) en détail. Souvent l'élément déclencheur d'un projet d'IA d'entreprise : voir notre [RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/) clé en main ; - **IA agentique** : une IA qui ne se contente pas de répondre directement mais qui enchaîne des étapes (utiliser un outil, faire une recherche, raisonner, réessayer) pour accomplir une tâche complexe, comme un [assistant qui prend des initiatives](https://www.askthisguy.com/fr/blog/how-mcp-accelerate-agentic-ai/).  ## RAG on premise : ce que l'on confond souvent Un **RAG on premise** (ou *on prem*) ne signifie pas forcément « tout reconstruire et héberger soi-même le LLM ». Trois couches se séparent : 1. **Les données et le retrieval** : documents, droits d'accès, index, citations. C'est le cœur métier du RAG. 2. **La plateforme** : connecteurs, ingestion, évaluation, monitoring. C'est ce qui coûte le plus à industrialiser. 3. **L'inférence LLM** : le modèle qui génère la réponse (cloud souverain, provider européen, ou GPU on-prem). Beaucoup de projets « on-prem » échouent parce qu'ils attaquent d'abord le point 3 (acheter des H100) alors que le vrai délai et le vrai TCO sont sur les points 1 et 2. Une [solution RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/) clé en main peut déjà tourner en hébergement européen, avec option on-premise selon vos contraintes, sans que vous ayez à dimensionner seuls la stack GPU. ## Pas un mais plusieurs modèles à déployer Premier élément important : un projet IA en entreprise, dès qu'il devient un peu avancé, ne repose pas sur un seul modèle, mais sur **plusieurs modèles** qui tournent en parallèle : - **LLM principal** : génération de texte, raisonnement complexe, dialogue ; - **Modèles légers ou spécialisés** : tâches rapides et simples (routage, extraction, nommage) ; - [**Modèle d'embeddings**](https://www.askthisguy.com/fr/blog/embedding-strategy/) : indispensable pour la recherche sémantique (RAG) ; - **Modèle de vision** : si vous analysez des images ou des captures d'écran ; - **Modèle de génération d'images** : si votre use case le demande. Bref, selon toute vraisemblance, vous commencerez avec 1 ou 2 modèles, et au fur et à mesure vous vous retrouverez avec 5 ou 6 modèles. ## Les utilisateurs sont exigeants Ils sont devenus impatients : habitués à des services 'grand public' comme ChatGPT qui leur délivrent des réponses quasi immédiates. La latence perçue devient un critère d'acceptation. Il est difficile de donner un seuil de référence, mais au-dessous de **100 tokens générés/seconde**, cela risque d'être perçu comme lent. Pour peu que l'IA soit **agentique** et appelle plusieurs outils, et "raisonne", c'est plutôt **500 tokens/seconde**, voire plus, qu'il faut viser, pour une réponse rapide. > **Seuils de référence :** > > - **~500 tokens/s** : projets multi-tâches, appels d'outils, raisonnement, agents complexes. > - **~100 tokens/s** : tâches simples sans réflexion (chat basique, complétion). Les utilisateurs sont aussi habitués à avoir **beaucoup de services additionnels**. Par exemple, joindre des documents aux messages (ex. des PDF) et avoir un traitement immédiat. Les services cloud de LLM excellent dans ce domaine (Gemini, ChatGPT, etc.). En local, on peut le proposer en convertissant le document en images et en utilisant un modèle de vision, mais cela sera beaucoup plus lent et souvent limité (en termes de nombre de pages du document par exemple). ## Les questions clés à se poser avant de décider ### 1) Quels sont vos cas d'usage réels ? - Tâches **simples** (extraction, reformulation, nommage) ou **complexes** (raisonnement, synthèse multi-documents, chaînes d'outils) ? - **Volume de requêtes** attendu (pic, moyenne, croissance). - **Niveau de raisonnement** requis : une réponse factuelle suffit-elle, ou faut-il enchaîner des étapes de raisonnement ? - Besoin en **multi-tâches** et **appels d'outils** (agents) ? Cela tire fortement vers des modèles plus gros (pour l'orchestrateur) et une vitesse d'inférence plus élevée. ### 2) Quelle qualité de réponse est acceptable ? Sur les requêtes complexes, l'écart entre un modèle moyen ou grand est net : profondeur de raisonnement, nuance, cohérence. Pour un assistant interne ou un agent métier, cette différence peut faire **accepter ou rejeter la solution par les utilisateurs.** À l'inverse, pour des use cases très ciblés (RAG simple, tâches répétitives bien définies), un modèle plus petit peut suffire avec une infrastructure bien plus légère. ### 3) Quelle est votre vision long terme ? - **Obsolescence du matériel** : les GPU achetés aujourd'hui seront-ils adaptés aux modèles de demain (taille, formats, frameworks) ? - **Évolution des besoins** : votre projet va-t-il se complexifier (plus d'outils, plus de raisonnement, plus d'utilisateurs) ? - **Flexibilité vs engagement** : le local vous "engage" sur 3 à 5 ans ; un provider vous permet d'évoluer sans changer de parc matériel. ## Quand les "petits" modèles suffisent  Plusieurs cas d'usage se contentent de modèles légers : - Tâches **simples et précises** : ex. générer un nom de conversation, extraire un champ, reformuler une phrase ; - **Retrieval simple** : recherche documentaire basique, RAG avec peu de raisonnement ; - Use cases **très orientés RAG** avec requêtes factuelles et peu de chaînage logique ; - Tâches avec **fine-tuning** spécifique sur un domaine étroit. Des modèles autour de 20 milliards de paramètres (ex. **mistral-small** ou **gpt-oss-20b**) peuvent suffire pour ceci, si vous tolérez quelques hallucinations et le fait que le modèle "ne raisonnera pas". L'avantage : une infrastructure très légère, rendant le scénario *Make* accessible. > **En résumé** : si votre use case est bien délimité, orienté retrieval et peu gourmand en raisonnement, un modèle de cette taille devrait suffire, et l'investissement reste raisonnable. > **En pratique** : c'est rare, et cela ne sera qu'un pilote avant un projet plus global. ## Quand les modèles moyens ou gros sont indispensables Dès que la complexité monte, **un modèle autour de 100 milliards de paramètres devient le minimum**. *gpt-oss-120b* d'OpenAI est fréquemment déployé, en raison de la notoriété de son éditeur, mais aussi d'un bon niveau de performance pour sa taille. Les modèles de plus de 300 milliards de paramètres (Mistral Large, GLM, DeepSeek, etc.) sont recommandés quand les usages incluent par exemple : - Des requêtes **complexes** avec raisonnement approfondi ; - **Agents multi-tâches** avec appels d'outils et enchaînements ; - **Analyse multi-documents** avec synthèse nuancée et prise de décision ; - Tâches nécessitant une **compréhension fine** du contexte et des implicites. La différence de qualité se voit dès que la requête demande du vrai raisonnement ou de la complexité. > **En résumé** : dès que vous visez des agents évolués, du RAG avancé ou du raisonnement métier exigeant, les gros modèles deviennent difficiles à remplacer sans dégrader fortement l'expérience. ## Parlons argent ### Scénario "Make" : déployer gpt-oss-120b en local Restons sur un exemple avec un modèle de taille "moyenne" (120 milliards de paramètres), qui sera donc limité à des scénarios simples. Prenons un déploiement réaliste avec **2× NVIDIA H100** (ordre de grandeur : **~60 k€** d'investissement direct). D'après le [benchmark Clarifai](https://www.clarifai.com/blog/comparing-sglang-vllm-and-tensorrt-llm-with-gpt-oss-120b), la vitesse d'inférence est de : - **~200 tokens/s** pour 1 utilisateur ; - **~40 tokens/s** pour 100 utilisateurs simultanés. Pour un usage multi-tâches et agents, l'objectif de **500 tokens/s** est loin d'être atteint : l'expérience utilisateur en pâtira, surtout en charge. Par ailleurs, un modèle de cette taille reste insuffisant pour les usages avancés et le raisonnement complexe : pour ceux-ci, il faut viser des modèles plus gros, ce qui alourdit encore l'infrastructure en local. ### Scénario "Buy" : utiliser un fournisseur d'inférence D'après la [documentation Cerebras](https://inference-docs.cerebras.ai/models/overview), les débits annoncés sur le même modèle sont de l'ordre de **~3 000 tokens/s**. Chez ATG, nous observons plutôt **1 000 à 2 000 tokens/s**, ce qui reste **5 à 50 fois** plus rapide que la config locale ci-dessus. Avec 60 k€ d'investissement, vous pouvez donc déployer une première brique de votre projet d'IA. Pas très rapide, pas très puissant, mais qui couvre toutefois quelques use cases peu complexes. ### Calcul de seuil de rentabilité Pour trancher entre Make et Buy, il faut : 1. **Estimer le volume de tokens** à traiter par an (pas évident); 2. **Comparer** le coût amorti du matériel (achat + électricité + maintenance + obsolescence) au coût API sur la même période ; 3. **Intégrer l'obsolescence** : le matériel perd de la valeur et peut devenir sous-dimensionné pour les prochains modèles ; les services API évoluent sans que vous ayez à renouveler le parc. En fonction de votre volume et de la durée de vie attendue du projet, le **Buy** peut être plus économique, mais en pratique c'est rare. ## Conclusion Le **local** / **on-prem** peut avoir du sens pour des cas d'usage **bien délimités** et peu exigeants en performance (RAG simple, tâches légères, souveraineté stricte) ou à l'atteinte d'un volume très conséquent. Pour un projet d'entreprise ambitieux (agents, RAG complexe, multi-tâches), le **Buy** gagne généralement en simplicité, en vitesse et en évolutivité. **Le local est avant tout un choix de conviction**, tout à fait légitime, qu'il vaut mieux mettre en oeuvre une fois une certaine maturité atteinte quant à ses projets d'IA. Notre recommandation chez **Ask This Guy** : **commencez par un provider** pour gagner en maturité, validez vos cas d'usage et vos volumes, puis évaluez le local uniquement si le volume et des exigences spécifiques (souveraineté, coût long terme) le justifient. Si votre priorité est un **RAG on premise** opérationnel sans reconstruire toute la stack, regardez d'abord notre [solution RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/) (hébergement européen, option on-prem). Et si votre motivation première est la souveraineté plutôt que le coût, commencez par lire ce que ce mot recouvre exactement : [IA souveraine, définition et critères](https://www.askthisguy.com/fr/ia-souveraine/). Héberger le modèle chez vous n'est qu'une des trois couches en jeu, et rarement la plus urgente. ### Pour monter en compétence sur l'IA Arbitrer entre local et fournisseur d'inférence, dimensionner ses GPU, maîtriser le coût d'un modèle en production : ces arbitrages s'apprennent. Pour les professionnels qui veulent [se former au MLOps et au LLMOps](https://www.jedha.co/formations/formation-mlops), Jedha propose un parcours de 150 heures dédié à l'industrialisation de l'IA : infrastructure distribuée (GPU, Kubernetes), gouvernance des données, conformité RGPD et AI Act, et maîtrise des coûts. C'est à ce jour la seule formation en France à couvrir les deux à la fois. Elle s'adresse à des profils ayant déjà deux ans d'expérience en data ou en IA. --- *Vous voulez déployer un assistant IA performant sans gérer l'infrastructure ? [Réservez une démo de 20 minutes](https://www.askthisguy.com/fr/demo/), on vous montre comment.* --- # MCP : Le protocole qui accélère l'intégration d'outils dans vos agents URL: https://www.askthisguy.com/fr/blog/how-mcp-accelerate-agentic-ai/ Language: fr Section: Blog ### Pourquoi MCP ? Pour comprendre MCP (Model Context Protocol) et pourquoi il a émergé, il faut regarder l’évolution récente des Large Language Models (LLM) comme ChatGPT, Gemini ou Mistral. Fin 2022, OpenAI lance son modèle GPT-3.5, qui rencontre un succès massif auprès du grand public. Le modèle est capable de comprendre des requêtes complexes, de synthétiser de l’information et de produire du contenu de bonne qualité. Mais à ce stade, il ne peut pas agir sur des outils ou accéder à des systèmes externes. Par exemple, il n’est pas encore capable d’aller chercher des informations récentes sur le web. Quelques mois plus tard, OpenAI introduit dans ChatGPT la notion d’outils qu’ils ont appelé "function calling". Très vite, ce concept est repris et intégré par les autres grands acteurs du marché. Aujourd’hui, la plupart des LLMs modernes permettent d’utiliser des outils externes. Le principe est simple : on décrit au LLM ce que fait un outil, les informations dont il a besoin en entrée, et ce qu’il renvoie en sortie (ou les actions qu’il peut déclencher, comme annuler une commande). En fonction de la question de l'utilisateur et du contexte, le modèle peut décider d'utiliser cet outil au bon moment. Exemple : - Outil : `get_order_status(order_id)` - L'utilisateur demande : "Où en est ma commande ?" - Le LLM comprend qu'il doit appeler cette outil. Voici comment cela fonctionne en pratique :  Pour les entreprises, la possibilité de créer des outils dédiés pour leurs agents IA multiplie les opportunités d’automatisation et les gains de temps. Par exemple, un agent peut s’appuyer sur des outils pour consulter l’état d’un devis ou d’une commande, analyser des indicateurs opérationnels, mettre à jour un statut logistique ou valider une facturation. Mais à mesure que les outils se multiplient, une nouvelle difficulté apparaît : chaque outil doit être intégré spécifiquement pour chaque agent. C’est précisément pour résoudre ce problème que MCP a été conçu. Introduit par Anthropic (l’éditeur de Claude) en 2024, **MCP** standardise la manière dont les outils et les données sont exposés, afin que les agents puissent : - les découvrir dynamiquement, - comprendre comment les utiliser, - et les appeler sans intégration spécifique On passe ainsi d’un monde d’intégrations sur mesure, à un monde où les IAs peuvent découvrir les données et outils de manière dynamique, permettant l’entrée réel dans le monde agentique. ### Comment fonctionne MCP concrètement ? Un serveur qui implémente MCP décrit quels outils sont disponibles, quelles données peuvent être consultées et comment les utiliser : voici un exemple de schéma d'entrée et de sortie d'un outil. Un client compatible MCP peut alors se connecter à ce serveur et récupérer automatiquement la liste des outils proposés pour les mettre à disposition de l'agent. À partir de là, le LLM peut décider quel outil utiliser en fonction de la demande de l’utilisateur et du contexte de la conversation. Prenons un exemple simple : un agent qui aide à la planification de voyage. Pour enrichir cet agent avec des données de surf, l'administrateur n'a pas besoin de développer une nouvelle intégration. Il lui suffit de renseigner l'adresse Web d'un serveur MCP fournissant des prévisions de surf. La plateforme récupère automatiquement la liste des outils disponibles sur ce serveur et les présente à l'administrateur, qui peut choisir lesquels activer pour son agent. Voici le processus de découverte et de sélection des outils :  Et voici comment cela se présente dans l'interface d'Ask This Guy :  Une fois activés, les outils sont mis à disposition de l'agent à la volée, sans aucun développement. Lorsque un utilisateur chat avec l'agent et demande “où est-ce qu’il pourrait surfer la semaine prochaine autour de Bordeaux”, le LLM comprend qu’il peut appeler l’outil find_best_session pour répondre à l’utilisateur :  Avec MCP, aucune modification du code de l’application n’est nécessaire, les outils du serveur sont découverts et utilsés dynamiquement. C’est là que se situe la véritable rupture et pourquoi MCP est souvent présenté comme un connecteur universel, donnant la capacité à se brancher n’importe où. ### MCP et les skills : leur rôle dans les architectures agentiques L’un des principaux défis des agents est de savoir comment orchestrer les outils pour répondre de manière pertinente à des questions complexes. Plus un agent dispose d’outils, plus il devient important de bien les organiser et de guider leur utilisation, afin d’éviter des appels inutiles ou mal adaptés. Les skills ont été introduits pour répondre à ce besoin. Ils regroupent des outils avec une couche de raisonnement et, parfois, des préférences propres à l’utilisateur. Par exemple, un utilisateur demande "Je veux surfer à Bordeaux la semaine prochaine avec 500€". Un skill "Surf Trip Planner" pourrait appeler plusieurs outils (prévisions de surf, météo, hébergement), applique des règles métier (niveau de l'utilisateur, contraintes budget) et retourne une proposition structurée adaptée. Dans une architecture agentique, les skills opèrent un niveau au-dessus de MCP. MCP expose les outils et les données ; les skills définissent comment les utiliser intelligemment. Les deux sont complémentaires. ### La dernière evolution : MCP Apps et le futur des interfaces IA Jusqu’à présent, l’expérience utilisateur dans le monde du SaaS et celle des agents IA se vivaient dans deux mondes parallèles. D'un côté, nous avons des applications SaaS aux interfaces graphiques (UI) riches mais rigides, où chaque action nécessite de naviguer entre des menus, des onglets et des formulaires. De l'autre, des agents IA capables de raisonner, mais limités à une fenêtre de chat textuelle : pour agir sur vos logiciels, l'agent devait soit vous "décrire" des données brutes, soit exécuter des commandes invisibles en arrière-plan. Cette déconnexion forçait l'utilisateur à un va-et-vient entre le chat et ses applications pour vérifier ou valider les actions de l'IA. C’est précisément ce problème que viennent résoudre les MCP Apps. Lancée début 2026, cette évolution du protocole permet aux agents de ne plus seulement échanger du texte, mais d’héberger directement des mini-applications interactives au cœur de la conversation. Par example, plutôt que de lire un résumé textuel de vos ventes, l'agent fait apparaître un graphique interactif de votre CRM directement dans le chat. Vous pouvez filtrer les données à la souris, et l'agent, observant vos clics en temps réel (bi-directionnalité), adapte son analyse au fur et à mesure. C’est cette convergence entre agents, outils et interfaces qui dessine le futur des applications professionnelles. ### Pour monter en compétence sur l'IA Comprendre comment un agent découvre et appelle ses outils donne envie d'en construire un soi-même. Pour un profil qui veut comprendre comment ça fonctionne et [créer ses propres agents IA](https://www.jedha.co/formations/formation-agent-ia) sans dépendre d'outils préconfigurés, Jedha enseigne le sujet en 75 heures : appels aux API des grands modèles, agents capables d'utiliser des outils et d'exécuter des actions, systèmes RAG et pipelines d'automatisation avec n8n. Le parcours se termine sur une application d'IA complète et se suit en 2 semaines à temps plein ou 6 à temps partiel, sans prérequis technique. ### L’approche d’Ask This Guy Chez ATG, notre approche est pragmatique. Nos clients peuvent s'appuyer sur des serveurs MCP lorsqu'ils permettent d'accélérer l'integration tout en développant des outils métier plus profondément intégrés quand cela améliore la performance de l’agent. Les skills, introduits dans les écosystèmes Anthropic et Google, commencent à être adoptés par certains acteurs, notamment dans le monde des IDE et des assistants développeurs. Leur trajectoire est prometteuse, mais encore en consolidation. Nous proposons déjà une approche pragmatique de ce besoin : chaque agent peut être configuré finement depuis la console d’administration, en définissant : - ses instructions, - les outils accessibles : ceux de la plateforme, ceux specifiques au client ou n’importe quel outil MCP - les sources de connaissance autorisées, - et d'autres d'options pour améliorer l'experience utilisateur dans leur conversation avec l'assistant. Nous accompagnons nos clients dans : - la définition des outils réellement utiles à leur métier, - la rédaction des spécifications de leur serveur MCP, - l’implémentation et les bonnes pratiques d’orchestration qui sont entièrement gérés sur la plateforme d'Ask This Guy. Si vous cherchez plutôt à savoir quels cas d'usage confier à un agent, ce qu'il coûte réellement et à quelles conditions il tient en production, nous avons écrit un guide dédié : [agent IA en entreprise](https://www.askthisguy.com/fr/blog/enterprise-ai-agents/). **Prêt à découvrir comment Ask This Guy vous permet de créer des assistant intelligents intégrés ?** **[Prenez rendez-vous pour une démo !](https://www.askthisguy.com/fr/demo/)** --- # Comment une démo ratée nous a forcés à repenser notre stratégie d'embeddings URL: https://www.askthisguy.com/fr/blog/embedding-strategy/ Language: fr Section: Blog *Note : toutes les données qui suivent sont extraites d’un benchmark opéré par la plateforme Ask This Guy, et concernent la période du 5 au 25 janvier 2026. Les requêtes sont envoyées de façon régulière depuis un serveur ATG situé en France, qui mesure les temps de réponse.* ## Un moment compliqué Call avec un prospect. Nous sommes là pour présenter **Ask This Guy**, notre solution d'IA qui (notamment) s'appuie sur les documents internes de l'entreprise. Tout est prêt, la démo est rodée. Je tape une requête simple dans l'interface. Et là... silence. Trois secondes. Dix secondes. On essaie d’enchainer sur un autre sujet, on bredouille un peu, mais on devine ce qui se passe dans la tête du client et la question non posée : *"Votre solution, elle marche vraiment ?"* La réunion terminée, on jette un coup d'oeil aux logs, le verdict tombe tout de suite : nous étions tombés au mauvais moment. Ce jour-là, l'API de Mistral a mis près d'une minute à répondre. Était-ce une simple anomalie ? Pas vraiment : comme nous allons le voir, c'est un problème structurel. Cet épisode embarrassant nous a forcés à nous poser une question simple mais cruciale : **comment garantir des performances fiables en production quand on dépend de providers d’IA externes ?** Ce que nous avons appris depuis, nous allons le partager avec vous. ## Retour sur les fondamentaux Avant de plonger dans le sujet, petit rappel. Si vous déployez une IA dans votre entreprise s'appuyant sur vos documents internes via une [architecture RAG](https://www.askthisguy.com/fr/blog/rag-tutorial/) (*Retrieval-Augmented Generation*), vous aurez besoin d'embeddings pour la recherche sémantique. **Qu'est-ce qu'un embedding ?** Imaginez que la signification de chaque phrase de vos documents soit transformée en un vecteur numérique, c'est-à-dire une représentation mathématique de sa signification. C'est ça, un embedding. Cela permet de trouver très vite une information qui répond au besoin d’un utilisateur. Le mécanisme est simple en théorie : 1. Un utilisateur envoie un message 2. Le système formule une ou plusieurs requêtes de recherche 3. Ces requêtes sont converties en embeddings (vecteurs) 4. Ces vecteurs sont comparés à ceux de vos documents 5. Les extraits les plus proches sont récupérés 6. La réponse est générée à partir de ces extraits **Vous voyez où je veux en venir ?** Chaque fois qu'un utilisateur envoie une requête, il faut calculer un embedding. Si ce calcul prend du temps, l'utilisateur attend. Si l'embedding échoue, il n'y a pas de réponse du tout. C'est pourquoi la performance des embeddings n'est pas un détail technique : c'est l'expérience utilisateur. On peut par exemple définir une performance acceptable ainsi : - **Objectif** : un délai inférieur à 300 ms dans la grande majorité des cas - **Limite critique** : ne jamais dépasser la seconde Et il ne faut pas oublier un autre point crucial : **tous les modèles d'embedding ne se valent pas**. Les écarts de pertinence des réponses sont énormes, nous l'avons expérimenté lorsque nous avons voulu tester des modèles "moyens". Si vous voulez comparer les modèles, le [MTEB leaderboard](https://huggingface.co/spaces/mteb/leaderboard) de HuggingFace est une très bonne base. ## Notre parcours initial : les “grands” du marché Quand nous avons commencé à développer Ask This Guy, le choix semblait évident : les grands acteurs du marché : Mistral, OpenAI. C'est plus ou moins ce que tout le monde fait, non ? C'est effectivement par là que nous avons commencé. La pertinence de cette approche est… mitigée. Les performances d'OpenAI se situent en moyenne autour de la seconde pour le modèle *large* (et environ une demi-seconde pour le modèle *small*). Ce n'est pas catastrophique, mais c'est loin de notre cible. Mistral, de son côté, affiche une meilleure performance médiane autour de 300 ms, mais un taux d’échec important :  Regardons de plus près l'irrégularité, jour par jour, notamment chez Mistral :  La plupart du temps, plus de 95% des requêtes sont traitées en moins d'une seconde. Sur le papier, c'est correct. Mais certaines journées sont tout simplement catastrophiques. C'est ce que nous avons vécu lors de notre démo. Et c'est ce que nos données mettent en évidence de manière implacable. ## Second problème : le lock-in Supposons que vous ayez trouvé le fournisseur parfait (même si ce n'est pas encore le cas à ce stade de l'article). Parfait. Mais que se passe-t-il demain si ses performances se dégradent ? Ou si ses prix augmentent ? Ou si l'entreprise disparaît ? La réponse naturelle serait : *"On change de fournisseur !"* Sauf que... ce n'est pas si simple. **Voici le problème technique fondamental :** comparer des embeddings générés avec des modèles différents ne fonctionne pas. Les vecteurs ne sont pas compatibles. Une fois que vous avez utilisé un modèle pour indexer vos documents, vous êtes condamné à utiliser le *même* modèle pour les requêtes (ou à réindexer tous vos documents). C'est là que le choix du modèle devient stratégique : - **Si vous utilisez un modèle propriétaire** (comme ceux d'OpenAI, par exemple), vous êtes totalement dépendants de ce fournisseur. Pas de sortie possible. - **Si vous utilisez un modèle open weights**, vous pouvez en revanche utiliser plusieurs fournisseurs pour le même modèle. Et c'est là que ça devient vraiment intéressant. ## Les spécialistes de l’inférence Revenons à nos résultats de benchmark. Une tendance se dégage : certains fournisseurs s'en sortent nettement mieux que les géants traditionnels. Ce sont des spécialistes de “l’inférence”, la capacité à appliquer un modèle d’IA vite et bien. Ils s'appuient sur des [modèles open weights](https://www.askthisguy.com/fr/blog/open-source-vs-open-weights-ai/).  En l’occurrence, sur les embeddings, **[Scaleway](https://www.scaleway.com/) et [Nebius](https://nebius.com/)** (deux européens !) émergent clairement du lot parmi les providers que nous avons testés. Et leur régularité est meilleure, en particulier chez Scaleway où elle est remarquable :  Pourquoi ? Probablement parce que ce sont des spécialistes de l'infrastructure cloud et de l'inférence, là où OpenAI ou Mistral sont avant tout des créateurs de modèles. La spécialisation paie. ## Est-ce suffisant ? Pas encore tout à fait. Si bonnes soient les performances de certains acteurs, il reste des moments de contre-performance. Et un risque inhérent au vendor lock-in, si ses performances se dégradent ou ses prix augmentent. Pour résoudre les deux problèmes, nous avons choisi un modèle d'embedding open weights particulièrement performant et disponible chez plusieurs fournisseurs eux-mêmes performants : Qwen 3 Embedding 8B. À partir de là, deux stratégies sont possibles : 1. **L'approche dynamique** : on surveille les performances en temps réel et on envoie chaque requête chez le provider le plus performant du moment. Si une requête échoue chez l'un, on la renvoie chez l'autre. 2. **L'approche "tous azimuts"** : vu le faible coût économique et écologique des embeddings (on peut descendre en dessous du centime d'euro par million de tokens. Si cela ne vous parle pas, dites-vous que générer l’embedding coûte environ 200 fois moins cher qu’envoyer le même document à GPT 5.2 dans une requête), pourquoi se priver ? On envoie la requête chez plusieurs providers simultanément, et on prend la première réponse qui arrive. C'est cette deuxième approche que nous avons retenue chez Ask This Guy. Le résultat ? Des performances ultra-stables, aucune dépendance critique envers un seul fournisseur, et un coût qui reste très raisonnable. ## Une leçon que chaque professionnel de l’IT connaît… mais qui est encore plus vraie avec l’IA Faire un POC, c'est facile. La production, c'est une autre histoire. Dans un POC, l'irrégularité ne se voit pas vraiment. Sur quelques requêtes, tout semble fonctionner. Mais en production, avec des utilisateurs réels, des volumes et des attentes élevées, chaque faiblesse devient évidente. Mais la bonne nouvelle, c'est que **avec de l'ingénierie et de la patience, on vient à bout de tous les sujets**. Notre démo ratée ? Elle nous a coûté un moment de gêne, mais elle nous a fait gagner une architecture beaucoup plus robuste. Et ça, ça n'a pas de prix. --- *Vous voulez en savoir plus sur notre approche RAG ou sur nos autres retours d'expérience en production IA ? N'hésitez pas à [réserver une démo](https://www.askthisguy.com/fr/demo/) !* --- # RAG en IA : connecter un LLM à vos documents d'entreprise URL: https://www.askthisguy.com/fr/blog/rag-tutorial/ Language: fr Section: Blog ## **Qu'est-ce que le RAG en IA ?** Le RAG (*Retrieval Augmented Generation*, ou génération augmentée par récupération) est une approche qui connecte un modèle d'IA à vos propres sources. À chaque question, le système recherche les passages pertinents dans vos documents, vos bases et vos outils, puis les transmet au modèle, qui rédige une réponse appuyée sur ces éléments et cite ses sources. Le modèle n'est ni réentraîné ni modifié : on change ce qu'il lit avant qu'il réponde. **Le point que les définitions oublient.** Un RAG se démontre en quelques heures et se stabilise en plusieurs mois. Ce qui casse entre les deux, nous l'avons documenté dans [5 erreurs qui arrivent après le POC](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/). ### **Le problème : une IA qui connaît tout… sauf vous** Vous utilisez une IA grand public (ChatGPT, Mistral Le Chat, Gemini, etc.) et vous êtes bluffé par ses capacités ? Il y a de quoi. Mais avez-vous essayé de lui poser des questions sur le dernier rapport financier de votre entreprise ou sur une procédure interne ? Dès que les sources ne sont pas publiques, elle est impuissante.  Les IA comme ChatGPT sont entraînées sur des quantités astronomiques de données publiques. Elles sont expertes du *monde*, mais pas de *votre* monde. Pour qu'une IA soit vraiment utile en interne, elle doit accéder à : - vos documents internes - vos politiques RH - vos processus métiers - vos outils (CRM, ERP, drive) - vos bases de données Bref : tout ce qui fait l'ADN de votre entreprise. ### **Les limites de l’approche “copier-coller”** Ajouter manuellement des documents dans ChatGPT peut sembler une solution rapide et pragmatique (si l'on met de côté les problèmes de confidentialité). Mais dans la pratique : - c'est chronophage - on ne sait pas toujours quels fichiers sont réellement pertinents - on envoie trop de documents ou des fichiers trop gros, rendant l’IA moins efficace - on oublie des documents ou on ne met pas les bonnes versions - cela n'intègre pas les informations d'un CRM ou d'un drive **Résultat** : la connaissance interne n'est jamais complète ni structurée. C'est un problème ancien, que les démarches de gestion des connaissances n'ont jamais vraiment résolu, et nous expliquons pourquoi dans [Knowledge management : pourquoi vos démarches échouent](https://www.askthisguy.com/fr/blog/knowledge-management-why-it-fails/). ## **La fenêtre de contexte : le talon d'Achille de nos IA préférées** L'IA a une mémoire de travail très performante... mais limitée. C'est sa **fenêtre de contexte** : elle ne peut traiter qu'une certaine quantité d'informations à la fois. ### **Des limites concrètes** Les modèles récents affichent des fenêtres de contexte de plusieurs centaines de milliers de tokens, parfois davantage. Traduit en pages, on parle de quelques centaines à un peu plus d'un millier de pages selon les modèles. Ça paraît beaucoup. Mais si vous envoyez dix documents de 300 pages, vous avez déjà dépassé la limite. Surtout, la taille annoncée n'est pas une garantie de qualité. Plus le contexte est chargé, plus le modèle perd en précision : il oublie des passages, confond des sources, ou s'appuie sur le mauvais paragraphe. C'est ce qu'on appelle parfois la dilution du contexte. Il vaut donc mieux pré-trier ce que l'on envoie, pour que seules les informations pertinentes parviennent au modèle. ## **C’est là qu’intervient le RAG : la solution pour une IA "intelligemment informée"** Le **RAG (Retrieval Augmented Generation)** est une approche où : 1. L'outil se connecte à vos sources et pré-traite les documents pour les futures recherches 2. Pour chaque requête, il recherche les "morceaux" de documents pertinents *("Retrieval")* 3. Il envoie à l'IA la requête enrichie de ces documents pertinents *("Augmented")* 4. L'IA génère ensuite une réponse précise basée sur ces éléments *("Generation")* C'est comme si vous ajoutiez à votre IA un **assistant bibliothécaire** ultra-rapide et ultra-précis.  Notez que le RAG ne modifie pas le modèle. Le LLM reste le même : on change ce qu'on lui donne à lire avant qu'il réponde. C'est une différence essentielle pour la suite. ## **RAG et LLM : qui fait quoi dans la chaîne ?** On parle souvent de **RAG LLM** comme s'il s'agissait d'une seule technologie. Ce sont en réalité deux briques distinctes, et savoir laquelle fait quoi évite la plupart des erreurs de conception. Le **LLM** (Large Language Model) est le générateur. Il comprend la question, raisonne sur ce qu'on lui fournit, et rédige la réponse. Il ne sait rien de votre entreprise et n'a aucun accès à vos systèmes. Le **RAG** est la couche qui l'entoure. Elle prépare vos documents, retrouve les passages utiles au moment de la question, et les place dans le contexte du LLM avant de l'appeler. Dans une chaîne RAG, chaque appel au LLM se déroule ainsi : | Étape | Qui la réalise | Ce qui se passe | | --- | --- | --- | | 1. Préparation | Le RAG | Vos documents sont découpés, vectorisés et indexés, en amont de toute question | | 2. Recherche | Le RAG | La question est transformée en requête, les passages pertinents sont retrouvés | | 3. Assemblage | Le RAG | Question, extraits et consignes sont assemblés en un contexte unique | | 4. Génération | Le LLM | Le modèle rédige la réponse à partir de ce contexte | | 5. Attribution | Le RAG | Les sources correspondantes sont rattachées à la réponse | Trois conséquences pratiques en découlent. **Le LLM n'apprend rien de vos documents.** Il les lit à chaque requête, puis les oublie. C'est une bonne nouvelle pour la confidentialité, et cela signifie qu'une mise à jour de vos sources est immédiatement prise en compte, sans réentraînement. **La qualité d'un RAG se joue surtout hors du LLM.** Si l'étape 2 remonte les mauvais passages, aucun modèle ne rattrapera l'erreur : il rédigera une réponse fluide et fausse. Dans nos projets, l'essentiel des gains de pertinence vient du découpage, de la recherche et du filtrage, pas du choix du modèle. **On peut changer de LLM sans refaire le RAG.** C'est l'intérêt d'une architecture multi-modèle : le même socle documentaire peut être servi par un modèle rapide et économique pour les questions simples, et par un modèle plus puissant pour les analyses complexes. ### **Quel LLM choisir pour un RAG ?** La question arrive vite, et la réponse n'est pas « le plus gros modèle disponible ». Cinq critères comptent réellement : - **Le respect des consignes.** Un bon LLM de RAG s'en tient aux extraits fournis et dit qu'il ne sait pas quand l'information est absente. Un modèle brillant mais bavard, qui complète les trous avec ses connaissances générales, est un mauvais choix. - **La capacité à citer.** Rattacher chaque affirmation à l'extrait dont elle provient est une compétence inégale d'un modèle à l'autre. - **La fenêtre de contexte.** Suffisante pour accueillir une dizaine d'extraits et l'historique de conversation, sans excès : au-delà, la précision se dégrade et le coût grimpe. - **Le coût et la latence.** Un assistant interne interrogé cent fois par jour n'a pas le même profil économique qu'une analyse mensuelle de dossiers. - **La langue et la juridiction.** La qualité en français varie selon les modèles, et le lieu de traitement des requêtes est un critère à part entière dès que les documents sont sensibles. Nous détaillons cet arbitrage sur notre page [IA souveraine](https://www.askthisguy.com/fr/ia-souveraine/). En pratique, un modèle de milieu de gamme discipliné donne de meilleurs résultats sur un RAG d'entreprise qu'un modèle haut de gamme mal cadré. **Le LLM est un composant remplaçable ; votre chaîne documentaire, non.** ## **RAG, fine-tuning ou contexte long : que choisir ?** Trois approches permettent de rendre une IA plus pertinente sur votre métier. Elles ne répondent pas au même besoin, et on les oppose souvent à tort. | | Ce que ça fait | Quand c'est le bon choix | Limite principale | | --- | --- | --- | --- | | **RAG** | Va chercher l'information dans vos sources au moment de la question | Connaissances nombreuses, qui changent, et qui doivent être citées | Demande un vrai travail d'ingénierie sur les données | | **Fine-tuning** | Réentraîne le modèle pour lui donner un style, un format, un vocabulaire | Faire adopter un ton, une nomenclature, un format de sortie | N'apporte pas de connaissance fiable et vérifiable, et vieillit vite | | **Contexte long** | Envoie les documents directement dans la question | Corpus petit et stable, usage ponctuel | Coûteux, lent, et la précision se dégrade quand le volume monte | La confusion la plus fréquente porte sur le fine-tuning. Beaucoup d'entreprises pensent qu'entraîner un modèle sur leurs documents va lui faire « apprendre » leur entreprise. En pratique, le modèle apprend surtout une manière de parler. Il ne saura pas vous dire quelle version du contrat est en vigueur aujourd'hui, et il ne citera aucune source. Pour la connaissance, c'est le RAG qui répond. Les trois se combinent d'ailleurs très bien : un RAG solide pour la connaissance, une fenêtre de contexte confortable pour raisonner sur ce qui a été récupéré, et éventuellement du fine-tuning pour le style. Si vous êtes une TPE ou une PME et que vous cherchez d'abord à savoir si le RAG est pertinent pour votre activité, nous avons rédigé pour France Num, l'initiative gouvernementale de transformation numérique des TPE et PME, une [fiche pratique sur la génération augmentée par récupération](https://www.francenum.gouv.fr/guides-et-conseils/intelligence-artificielle/recherche-intelligente-et-analyse-documentaire-0). Elle propose cinq questions à se poser avant de se lancer et quatre cas d'usage réellement déployés. ## **Plongée dans le moteur du RAG : comment ça marche vraiment ?** *Pour aller plus loin, consultez notre [documentation sur le traitement des données et le RAG](https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag).* ### **Étape 1 : Le découpage intelligent (chunking)** Avant tout, vos documents doivent être convertis en texte exploitable : - extraction des paragraphes - récupération du texte des tableaux - interprétation de schémas, graphiques, etc. (cette partie-là est importante, car ils contiennent souvent des informations utiles et exploitables) Puis vient le **découpage en chunks**. Un bon chunk doit être : - **court** → pour tenir dans la fenêtre de contexte - **cohérent** → une idée claire par bloc - **isolé** → pas de mélange de concepts > Vous ne donnez pas tout un document à l'IA. Vous lui donnez le paragraphe *qui répond exactement* à la question. > ### **Étape 2 : Le mécanisme de recherche (la magie des embeddings)** Pour comparer les textes, le RAG transforme : - votre question - vos chunks ...en **vecteurs numériques** : ce sont les **embeddings**. Deux chunks proches en sens → leurs vecteurs sont proches. ### **Deux types de recherche indispensables** 1. **Recherche sémantique (par le sens)** Idéale pour les questions conceptuelles : « Comment demander un congé ? » 2. **Recherche par mots-clés (par la précision)** Essentielle pour les termes spécifiques sans signification universelle : - « Référence produit XYZ-123 » - « Procédure PNC-V4 » - « Jean-Pierre Dubreuil » Car une IA ne connaît pas Jean-Pierre Dubreuil du service compta... **Les deux mécanismes sont complémentaires. Un RAG uniquement "sémantique" (pourtant fréquent) échouera sur ce type de recherches.** --- ### **Le schéma d’un RAG, étape par étape** Voici le schéma RAG complet, avec ses deux phases : la préparation des sources d'un côté, le traitement de chaque question de l'autre. La première ne se rejoue qu'à l'ajout ou à la mise à jour de documents ; la seconde se rejoue à chaque fois qu'un utilisateur pose une question. 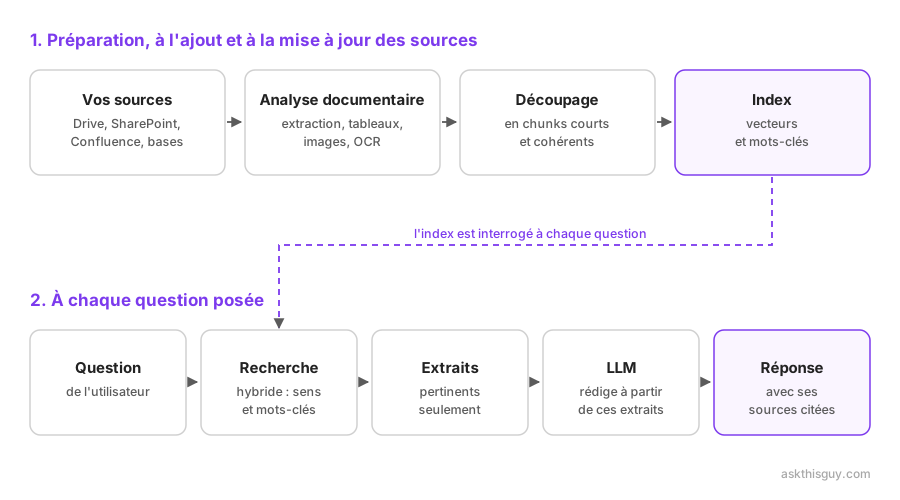 Ce schéma décrit le RAG tel qu'il est enseigné et tel qu'il est implémenté dans la majorité des démonstrations : une question, une recherche, une réponse. C'est une bonne façon de comprendre le principe. Ce n'est plus la façon dont les systèmes sérieux fonctionnent aujourd'hui. ## **Du RAG linéaire au RAG agentique** Le schéma ci-dessus a un présupposé fort : **une seule recherche suffit pour répondre**. Dans la vraie vie des entreprises, c'est rarement vrai. Prenez une question comme un manager la pose vraiment : « Tient-on nos engagements avec Durand sur la période ? » Rien dans cette phrase ne dit où chercher. Ni quels engagements, ni quelle période, ni dans quel système. C'est au système de le découvrir. Il doit d'abord trouver ce qui matérialise nos obligations envers Durand, un contrat, un avenant, une convention de service, puis y lire ce qui est engagé : un délai de prise en charge, un nombre d'interventions incluses, un taux de disponibilité. C'est seulement en lisant ces documents qu'il apprend que la période d'engagement est l'année civile. Il peut alors aller chercher, dans l'outil de ticketing, les tickets de l'année rattachés aux bons contrats, et les comparer aux seuils qu'il vient de découvrir. Deux sources de nature différente, et surtout : **la seconde requête ne peut pas être formulée avant d'avoir lu le résultat de la première**. C'est exactement ce que fait un **RAG agentique**. Au lieu d'exécuter une recherche unique, un **agent orchestrateur** mène une enquête : - il analyse la question et la reformule, parfois en plusieurs sous-questions - il choisit la ou les sources à interroger - il lit ce qu'il obtient, et **décide s'il en sait assez** - si ce n'est pas le cas, il relance une recherche mieux ciblée, avec ce qu'il vient d'apprendre - il ne rédige la réponse qu'une fois les éléments réunis, en citant ses sources 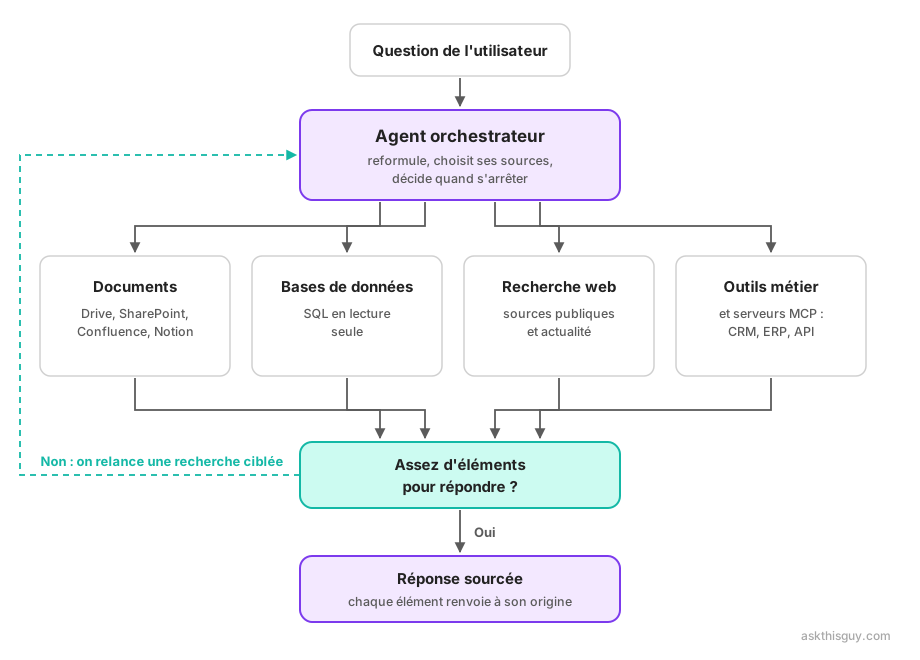 La différence avec le schéma précédent tient dans une seule flèche : celle qui revient vers l'agent. Trois conséquences pratiques, souvent sous-estimées. **La connaissance n'est plus seulement documentaire.** Un agent peut interroger dans la même conversation vos documents, une base SQL en lecture seule, le web, et vos outils métier exposés via des [serveurs MCP](https://www.askthisguy.com/fr/doc/admin-console/tools-management/mcp-servers) ou des [outils sur mesure](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-tools). L'utilisateur, lui, pose une seule question et n'a pas à savoir où vit l'information. **Les allers-retours coûtent du temps et des tokens.** Un agent qui enquête consomme plus qu'une recherche unique. Il faut donc borner le nombre d'itérations, savoir quand s'arrêter, et surveiller les coûts. Un système agentique mal cadré est un système lent et cher. **La traçabilité devient indispensable.** Quand une réponse résulte de quatre appels à trois sources, l'utilisateur doit pouvoir vérifier d'où vient chaque élément. Sans citations, un RAG agentique est une boîte noire, et personne ne fait confiance à une boîte noire pour décider. **Si vous ne devez retenir qu'une chose de cette section :** la qualité d'un RAG moderne ne se joue plus seulement sur la qualité de la recherche, mais sur la qualité de l'enquête. Savoir quoi chercher, où, dans quel ordre, et quand s'arrêter. ## **IA et analyse de documents : ce qui se joue avant la recherche** On parle beaucoup des modèles et des agents. Dans les projets réels, ce qui fait échouer un RAG se situe presque toujours en amont : dans **l'analyse des documents**. Vos connaissances ne sont pas du texte propre. Ce sont des PDF scannés, des présentations, des tableaux Excel, des plans, des contrats avec des annexes, des comptes rendus rédigés à la va-vite. Chaque format pose son problème. - **Les PDF scannés** demandent une reconnaissance de caractères (OCR). Une OCR médiocre produit du texte truffé d'erreurs, et un chunk illisible ne sera jamais retrouvé. - **Les tableaux** perdent leur structure quand ils sont convertis naïvement en texte. Une colonne mal alignée, et le chiffre du trimestre 2 se retrouve attribué au trimestre 3. - **Les schémas et graphiques** contiennent souvent l'information la plus dense d'un document. Les ignorer revient à jeter la moitié de la valeur d'une présentation commerciale. - **Les documents longs et hétérogènes** (un manuel qualité de 200 pages, par exemple) doivent être découpés en respectant leur structure logique, pas tous les 500 caractères. - **Les versions multiples** posent une question qui n'est pas technique : quel document fait foi ? Un RAG qui indexe trois versions d'une procédure répondra parfois avec la mauvaise. C'est pour cette raison que l'analyse documentaire par IA ne se réduit pas à « brancher un dossier ». Chaque entreprise a des formats, des conventions et des exceptions qui lui sont propres, et le traitement doit s'y adapter. C'est le travail le moins visible d'un projet RAG, et de loin le plus déterminant. ## **Un exemple de RAG de bout en bout** Reprenons « Tient-on nos engagements avec Durand sur la période ? », dans un système agentique. 1. **Réception.** La question ne désigne ni document, ni système, ni dates. Trois inconnues : de quels engagements parle-t-on, sur quelle période, et où sont les faits qui permettent de les mesurer. 2. **Première recherche.** Recherche hybride sur les documents. La recherche par mots-clés retrouve « Durand », un nom propre qu'aucune recherche sémantique ne saurait cibler seule ; la recherche sémantique remonte en parallèle les passages parlant de niveaux de service et de délais d'intervention. L'agent obtient un contrat-cadre, un avenant et une convention de service. 3. **Lecture et décision.** L'avenant remplace deux clauses du contrat-cadre. L'agent retient la version en vigueur et y lit les engagements chiffrés : délai de prise en charge, nombre d'interventions incluses, et une **période d'engagement annuelle**. Il vient d'apprendre ce qu'il ne savait pas au départ. 4. **Deuxième source, formulée à partir de la première.** Maintenant seulement, l'agent peut interroger le ticketing via l'outil de [requête en base de données](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/database-query) : les tickets de l'année, rattachés à ces contrats précis, avec leurs délais de prise en charge réels. 5. **Comparaison.** L'agent confronte les chiffres obtenus aux seuils qu'il a lus, et repère les écarts. 6. **Génération.** Réponse structurée engagement par engagement, avec le lien vers l'article contractuel correspondant et le détail des tickets concernés. Une seule question posée, deux sources, et une chaîne où **l'étape 4 était impossible à écrire avant l'étape 3**. C'est cette mécanique que l'utilisateur ne voit pas, et c'est elle qui fait la différence entre un gadget et un outil de travail. ## **RAG avec ChatGPT, Gemini, Claude ou Copilot : ce que ça change** Question fréquente : « Nous avons déjà ChatGPT Entreprise (ou Copilot, ou Gemini). Est-ce que ça ne fait pas déjà du RAG ? » En partie, oui. Ces outils savent lire des fichiers que vous leur donnez, et certains se connectent à un espace de travail (Microsoft 365 pour Copilot, Google Workspace pour Gemini). Pour de la recherche simple dans un périmètre déjà couvert par l'éditeur, c'est souvent suffisant. Les limites apparaissent vite dès qu'on sort de ce périmètre. - **Le périmètre est celui de l'éditeur.** Copilot est excellent sur SharePoint et Teams. Il ne connaît pas votre GED métier, votre ERP maison ni votre base PostgreSQL. - **Vous ne maîtrisez pas la chaîne de traitement.** Le découpage, le modèle d'embeddings et la stratégie de recherche sont des choix de l'éditeur. Si vos documents sortent du cas standard, vous n'avez pas de levier. - **Le modèle est imposé.** Vous utilisez celui du fournisseur, sans possibilité d'en changer si un autre est meilleur ou moins cher sur votre cas d'usage. - **La localisation des données dépend du fournisseur.** C'est un point structurant pour beaucoup d'organisations européennes. Le vrai critère n'est donc pas « RAG ou pas RAG », mais : **jusqu'où pouvez-vous adapter la chaîne à vos données, et gardez-vous la main sur les choix techniques ?** Nous avons développé ce point dans notre article sur les [erreurs de RAG en entreprise après le POC](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/). ## **Tous les RAG ne se valent pas : l'art de bien choisir sa solution** Le marché est rempli de RAG "rapides à intégrer", mais... **comme les chasseurs des Inconnus :** [il y a les bons et les mauvais](https://www.youtube.com/watch?v=bQUhM3yf8p8)**.** Ce qui fait la différence : - **Qualité de la conversion** → ne pas savoir extraire les données d'un graphique = perdre une info importante - **Qualité du découpage** → chunks trop gros ou incohérents = IA confuse - **Choix des modèles d'embeddings** → ils n'excellent pas tous dans les mêmes domaines - **Recherche hybride** → sémantique seule = erreurs sur les noms propres - **Capacité d'enquête** → un moteur qui ne sait faire qu'une passe échouera sur toute question un peu composée - **Traçabilité** → sans citations vérifiables, les utilisateurs cessent d'utiliser l'outil au premier doute Un mauvais RAG peut rendre l'IA floue, approximative, incapable de retrouver des informations pourtant bien présentes. Ce n'est pas théorique. Sur le benchmark que nous opérons en continu depuis un serveur situé en France, plus de 95 % des appels d'embeddings passaient sous la seconde en janvier 2026, mais certaines journées sortaient complètement des clous, au point de faire échouer une démo client en direct. Nous racontons l'épisode et ce que nous en avons tiré dans [notre stratégie d'embeddings](https://www.askthisguy.com/fr/blog/embedding-strategy/). Sur la génération de texte, notre benchmark Q1 2026 montre des écarts de taux de succès entre fournisseurs assez marqués pour qu'un RAG d'entreprise ne repose jamais sur un seul modèle : c'est la deuxième des [5 erreurs qui arrivent après le POC](https://www.askthisguy.com/fr/blog/enterprise-rag-production-mistakes/). Un autre point capital est l'intégration **d'outils complémentaires**. Si votre besoin concerne uniquement la recherche interne, un RAG suffit. Mais généralement, vous voudrez également rechercher sur le Web, interroger des données en base de données, déclencher des actions, etc. L'intégration de ces outils décuple la puissance de votre IA. ### **Le RAG, c’est de l’ingénierie** Il y a clairement des best practices et des choix "génériques" qui marchent plutôt bien. Mais il n'y a pas de recette magique. Chaque entreprise a des formats et des données spécifiques qui nécessitent des traitements particuliers pour obtenir de bonnes performances. ## **L'approche Ask This Guy (ATG) : le meilleur du RAG, sans les tracas** Chez **Ask This Guy**, nous avons passé des milliers d'heures à benchmarker, tester, casser puis améliorer des pipelines RAG. Notre [solution RAG entreprise](https://www.askthisguy.com/fr/solutions/knowledge-rag/) industrialise ces briques pour vos équipes. ### **Nous offrons :** - **Conversion et découpage optimisés** [Nombreux connecteurs](https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/connectors), [gestion des documents complexes](https://www.askthisguy.com/fr/doc/customizing-atg-to-you/tailored-processing), tableaux, slides, [images](https://www.askthisguy.com/fr/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg), etc. - **Recherche hybride intelligente** Sémantique + mots-clés pour une précision maximale. - **Un agent orchestrateur, pas une simple recherche** L'assistant décide quelles sources interroger, relance ses recherches quand il lui manque un élément, et croise documents, bases de données et outils métier dans une même conversation. - **Personnalisation poussée** Nous adaptons les conversions à *vos* documents et pouvons développer des algorithmes spécifiques. Nous pouvons utiliser un modèle d'embeddings adapté à votre activité. - **Flexibilité totale** Vous gardez la main sur vos données. Et si vous souhaitez un jour internaliser la solution, vous récupérez vos développements spécifiques. - **Un seul RAG pour tous vos usages** Déployez la même intelligence sur plusieurs interfaces : console d'administration, [chatbots sur votre site web](https://www.askthisguy.com/fr/doc/atg-embedded), widget intégré dans votre produit SaaS, API pour vos outils internes, etc. - [Un logiciel qui combine plusieurs outils, pas seulement le RAG](https://www.askthisguy.com/fr/doc/admin-console/tools-management) - recherche dans vos drives - recherche web - intégration avec vos outils internes - traitement documentaire avancé **L'objectif** : une IA qui connaît votre entreprise aussi bien qu'un collaborateur expérimenté. ## **Questions fréquentes sur le RAG** ### **Qu'est-ce que le RAG en IA ?** Le RAG (Retrieval Augmented Generation) est une approche qui connecte un modèle d'IA à vos propres sources. À chaque question, le système recherche les passages pertinents dans vos documents, vos bases ou vos outils, puis les transmet au modèle qui rédige une réponse appuyée sur ces éléments, avec ses sources. ### **Quelle différence entre un LLM et un RAG ?** Un LLM est le modèle de langage qui rédige la réponse. Le RAG est ce qui l'entoure : la chaîne qui va chercher la bonne information avant de le solliciter. Le RAG ne remplace pas le LLM et ne le modifie pas, il lui donne de quoi répondre juste. ### **Comment le RAG augmente-t-il un LLM ?** Le RAG n'augmente pas les capacités du modèle, il augmente ce qu'il a sous les yeux. À chaque question, la chaîne retrouve les passages pertinents dans vos sources et les insère dans le contexte du LLM avant l'appel. Le modèle rédige alors sa réponse à partir de ces extraits plutôt que de sa seule mémoire d'entraînement, et peut indiquer d'où vient chaque élément. ### **Quel LLM choisir pour un RAG ?** Privilégiez un modèle discipliné plutôt que le plus puissant : il doit s'en tenir aux extraits fournis, reconnaître qu'il ne sait pas quand l'information est absente, et savoir citer ses sources. Les autres critères sont la fenêtre de contexte, le coût par requête, la latence attendue, la qualité en français et la juridiction dans laquelle les requêtes sont traitées. Un modèle de milieu de gamme bien cadré bat souvent un modèle haut de gamme mal cadré. ### **Faut-il réentraîner le LLM sur ses documents ?** Non, dans la très grande majorité des cas. Un LLM utilisé dans une chaîne RAG lit vos documents à chaque requête sans les mémoriser, ce qui rend les mises à jour immédiates et évite d'exposer vos contenus dans les poids du modèle. Le fine-tuning reste utile pour imposer un style ou un format de sortie, pas pour transmettre de la connaissance. ### **Le RAG remplace-t-il le fine-tuning ?** Non, les deux répondent à des besoins différents. Le fine-tuning agit sur le style, le format et le vocabulaire. Le RAG apporte la connaissance, à jour et vérifiable. Pour répondre à partir de documents d'entreprise, c'est le RAG qu'il faut. ### **Combien de temps pour mettre en place un RAG en entreprise ?** Un prototype se monte en quelques jours. Un système fiable en production demande davantage, parce que l'essentiel du travail porte sur vos formats documentaires, les droits d'accès, l'évaluation de la qualité des réponses et le suivi des coûts. C'est précisément l'écart entre les deux qui fait échouer beaucoup de projets. ### **Peut-on héberger un RAG en Europe ou on-premise ?** Oui, et c'est un critère fréquent dans les organisations européennes. Attention toutefois à ne pas confondre hébergement local et souveraineté réelle : nous détaillons cette nuance dans notre article sur [l'illusion du LLM local](https://www.askthisguy.com/fr/blog/llm-local-enterprise-sovereignty-illusion/). ## **Conclusion : donnez une voix à vos données d'entreprise avec le RAG** Le RAG n'est pas qu’une technologie : c’est une **stratégie d’intelligence documentaire**. Il transforme une IA générique en **véritable expert interne**, capable de : - répondre précisément aux questions - synthétiser des documents complexes - fluidifier les processus - aider à la prise de décision Mais la barre a monté. Un RAG qui se contente d'une recherche unique dans un dossier de PDF ne suffit plus. Ce qui fait la différence aujourd'hui, c'est la capacité à analyser correctement vos documents, à enquêter sur plusieurs sources, et à justifier chaque réponse. Si vous voulez une IA qui comprend vraiment votre entreprise, c'est de ce côté-là qu'il faut regarder. Et nous pouvons vous aider à le mettre en place. **[Réservez une démo](https://www.askthisguy.com/fr/demo/)** pour en discuter sur vos propres documents. --- # L’Open Source dans l’IA : le grand malentendu ? URL: https://www.askthisguy.com/fr/blog/open-source-vs-open-weights-ai/ Language: fr Section: Blog ## Introduction Il ne se passe pas une semaine sans que l’on lise dans les médias ou sur LinkedIn [des annonces de sorties](https://www.zdnet.fr/actualites/la-derniere-version-open-source-de-mistral-montre-bien-que-les-petits-modeles-lemportent-sur-les-grands-voici-pourquoi-485967.htm) de modèles d’IA open source… alors qu’en réalité ils ne le sont pas ! Je joue sur les mots ? La différence me semble assez fondamentale au contraire. **L'open source est transparent.** **L'IA restera opaque.** "Open source" et "open weight" (weight = poids) sont deux termes souvent utilisés de façon interchangeable dans les débats sur l'IA. Pourtant, ils recouvrent des réalités fondamentalement différentes. Cet article explore les vraies différences entre ces deux concepts et pourquoi l'IA générative a du mal à suivre le modèle open source traditionnel. ## L'Open Source : la transparence totale comme fondement ## Qu'est-ce que l'open source ? L'open source, c'est la **transparence totale** : accès au code source complet, possibilité de le modifier, de l'auditer et de le comprendre exactement. Prenons Linux. Chaque ligne de code est visible. Vous pouvez compiler votre propre version, l'adapter, l'améliorer ou faire auditer le code pour détecter des failles. Cette transparence permet : - **La confiance** : n'importe quel expert peut vérifier qu'il n'y a pas de failles cachées - **La sécurité collective** : des milliers d'yeux détectent et corrigent les bugs rapidement - **L'indépendance** : aucun risque de dépendre d'une entreprise unique C'est cette philosophie qui a donné Git, Apache, Firefox, PostgreSQL, Python... Des projets parmi les plus fiables au monde, massivement utilisés en entreprise, y compris dans un cadre commercial. [Google et Microsoft](https://jisom.rau.ro/Vol.17%20No.2%20-%202023/JISOM%2017.2_1-22.pdf) comptent même parmi les plus gros contributeurs de l’open source. ## Les LLM : une architecture fondamentalement différente ## Les poids ne sont pas du code source Un LLM (modèle de langage) comme GPT-5.2, Mistral 3 ou Gemini 3 n'est pas un programme classique. C'est une **architecture mathématique** avec des milliards de "poids" (”weight”) - les connexions dans le réseau de neurones, résultat d'un entraînement qui coûte plusieurs millions d'euros. La différence cruciale : **avoir les poids d'un LLM, ce n'est pas comme avoir le code source d'un logiciel.** C'est plutôt comme recevoir un logiciel déjà compilé : vous pouvez l'exécuter, mais vous ne voyez pas : - Les données d'entraînement utilisées - Les choix méthodologiques (algorithmes, hyperparamètres) - Les stratégies d'optimisation - Les erreurs corrigées en chemin Résultat : une machine performante... mais opaque. ## Qu'est-ce qu'un modèle "open weight" ? Face aux géants qui gardent leurs grands modèles fermés, certains acteurs comme Mistral AI ou DeepSeek publient les **poids** de leurs modèles sur [Hugging Face](https://huggingface.co/models). Même [OpenAI](https://openai.com/fr-FR/index/introducing-gpt-oss/) et [Google](https://deepmind.google/models/gemma/) s'y sont mis pour certains modèles.  Cette ouverture apporte des avantages réels : - Tester le modèle sur vos serveurs sans dépendre d'une API externe - L'affiner pour vos besoins spécifiques (vocabulaire juridique, médical...) - Garder vos données sur votre infrastructure - Contrôler vos coûts - Permettre à la communauté d'innover ## Pourquoi un vrai open source est si difficile pour les LLM ### 1. Les données d'entraînement : le casse-tête légal Les données utilisées pour entraîner les LLM proviennent largement [d'œuvres protégées par le droit d'auteur](https://www.hinckleyallen.com/publications/industry-today-ai-training-data-the-copyright-controversy/) : livres, articles, contenus web, publications scientifiques. Ces données ont été collectées massivement sans consentement explicite des auteurs. Publier ces données pose des risques légaux. Les litiges se multiplient aux États-Unis et en Europe. Révéler précisément quels contenus ont été utilisés ouvrirait des fronts juridiques massifs. C'est un problème structurel qui demande une évolution du cadre légal. Même si l’on trouve des [centaines de milliers de jeux de données](https://huggingface.co/datasets) sur Hugging Face, les datas les plus intéressantes ne sont pas libres de droit. ### 2. La reproductibilité est extrêmement difficile Avec Linux, si vous avez le code, vous pouvez recompiler exactement la même version. Pour les LLM, c'est beaucoup plus compliqué, même avec tout (code, données, poids) : - Les processus d'apprentissage intègrent de l'aléatoire par design - Le résultat obtenu sur des processeurs distincts sera différent - Reproduire l'entraînement coûte plusieurs millions d'euros La reproductibilité parfaite est donc hors de portée pratique, même si elle reste théoriquement possible. ### 3. Les biais et hallucinations : impossible à détecter dans les poids seuls Les hallucinations d’un modèle d’IA et leurs biais sont l’équivalent des failles et bugs des logiciels. Même avec accès aux poids, **on ne peut pas "lire" les biais ou hallucinations dans le modèle**. Ils sont invisiblement distribués dans des milliards de paramètres. La seule façon de les détecter : tester le modèle en situation réelle avec des benchmarks. Les biais se révèlent à l'usage, pas à l'inspection. ## Les initiatives véritablement transparentes sont des exceptions Quelques projets tentent de se rapprocher d'une vraie transparence. **[LLM360](https://www.llm360.ai/)** en est un exemple notable : ils publient non seulement les poids finaux, mais aussi les points de vérification intermédiaires, le code d'entraînement complet, et partagent les données de manière responsable. Ces initiatives restent rares car elles demandent de résoudre d'abord les problèmes légaux, ce qui exige une mobilisation politique. ## Quelle approche adopter pour vous ? Pour une entreprise investissant dans l'IA, la réalité n'est ni "tous les modèles propriétaires" ni "tous les open weights". La bonne approche combine les deux. Les modèles **open weight** offrent un intérêt stratégique réel pour la **diversification** : utiliser une combinaison de modèles open weight (Mistral, Qwen...) et de modèles commerciaux (GPT, Gemini...) peut réduire la dépendance à un seul fournisseur et améliore la continuité et qualité de service. Chez [Ask This Guy](https://askthisguy.com), par exemple, nous utilisons à la fois des modèles open weight (que nous pouvons héberger sur une ou plusieurs infrastructures européennes) et des modèles commerciaux selon les besoins. Nous suivons les performances en temps réel de chaque fournisseur. C'est justement cette **diversité même de fournisseurs** qui garantit un meilleur niveau de service à nos clients. *(Crédit de l'image d'accueil : [Peter Adams, faces of Open Source](https://www.facesofopensource.com/))* --- # Et si les États-Unis vous fermaient le robinet numérique ? URL: https://www.askthisguy.com/fr/blog/souverainete-numerique-dependance-americaine/ Language: fr Section: Blog  Si aujourd'hui ce scénario peut vous paraître alarmiste, il repose pourtant sur une tendance claire : l'**administration américaine actuelle est de plus en plus hostile envers l'Europe**, dans un contexte où cette dernière reste **fortement dépendante des infrastructures numériques américaines**. Ce qui était autrefois perçu comme improbable apparaît désormais comme un **risque plausible** dans les 5-10 prochaines années. Le moment d'agir est venu... avant d'être pris de court. La récente publication de la **[National Security Strategy 2025](https://www.whitehouse.gov/wp-content/uploads/2025/12/2025-National-Security-Strategy.pdf)** par l'administration Trump vient confirmer cette tendance : les États-Unis affirment clairement leur intention d'utiliser tous les leviers - y compris technologiques et économiques - pour défendre leurs intérêts stratégiques, avec une approche **"America First"** assumée qui ne cache plus sa dimension unilatérale. Dans un contexte où des personnalités politiques montantes aux États-Unis - comme **[JD Vance](https://fr.wikipedia.org/wiki/J._D._Vance)** ou **[Marjorie Taylor Greene](https://fr.wikipedia.org/wiki/Marjorie_Taylor_Greene)** - incarnent un courant plus nationaliste, plus isolationniste, et plus explicitement critique vis‑à‑vis de l'Europe, l'adoption de **mesures unilatérales**, y compris des restrictions ciblant des acteurs ou secteurs étrangers, semble plus crédible que jamais. ## Au‑delà du Cloud Act et du Patriot Act, les décrets & lois d’urgence Le **Cloud Act** (2018) et le **Patriot Act** (2001) sont aujourd'hui bien connus : ils permettent aux autorités américaines d'accéder aux données stockées par des entreprises américaines, **même si ces données sont physiquement hébergées à l'étranger**. Ces lois autorisent la surveillance et les demandes d'accès aux données dans un cadre juridique établi. Mais le problème ne se limite pas à ces classiques lois de surveillance ou de demande de données - ce sont des **mécanismes d'urgence juridique** qui menacent potentiellement les infrastructures numériques utilisées par les acteurs européens. Ainsi, en **février 2025**, Trump a signé le **[Executive Order 14203](https://www.presidency.ucsb.edu/documents/executive-order-14203-imposing-sanctions-the-international-criminal-court)**, s'appuyant notamment sur le **[International Emergency Economic Powers Act](https://en.wikipedia.org/wiki/International_Emergency_Economic_Powers_Act) (IEEPA)**, pour imposer des **sanctions à l'encontre de membres et collaborateurs de la Cour Pénale Internationale (CPI)**, sans procédure judiciaire préalable, simplement sur décision exécutive. **Concrètement**, cela signifie que du jour au lendemain, une personne visée par ces sanctions peut **se retrouver coupée de ses accès Microsoft 365, Google Workspace, ou tout autre service cloud américain** - sans recours immédiat, sans procès, uniquement sur décision exécutive. Le cas du [magistrat français Nicolas Guillou, sanctionné par les États-Unis](https://www.dalloz-actualite.fr/flash/l-enfer-du-juge-nicolas-guillou-magistrat-francais-sous-sanctions-americaines), illustre cette réalité : imaginez votre entreprise, vos emails professionnels, vos fichiers, vos outils de collaboration... inaccessibles du jour au lendemain. Ce mécanisme de "pouvoir d'urgence" montre à quel point des décisions discrétionnaires peuvent **bloquer des actifs, restreindre l'accès, ou geler des biens** d'acteurs étrangers - US‑based ou non. Autrement dit : l'État américain dispose d'un **arsenal juridique** lui permettant, en temps de "menace" ou de "crise", d'agir vite - avec des **effets immédiats** - sur des cibles perçues comme sensibles, économiques, judiciaires ou technologiques. Cela dépasse largement le cadre des lois de surveillance classique. Pour une entreprise européenne dépendante d'un fournisseur américain, même si les serveurs sont en Europe, c'est la **nationalité juridique du fournisseur** - pas la localisation physique - qui peut décider de l'accès ou du blocage. Ce type de droit d'urgence ou d'extraterritorialité transforme la notion d'hébergement "en Europe" en un **pseudo‑bouclier** : quand le prestataire est soumis au droit américain, il reste potentiellement vulnérable à des décisions venant de Washington - **même si vos données sont physiquement stockées à Francfort, Dublin ou Paris**. ## Que se passe-t-il en cas de coupure ? De nombreuses entreprises en Europe reposent sur des **clouds, services SaaS, APIs, infrastructures critiques** fournies par des acteurs américains - IaaS, PaaS, SaaS, stockage, API IA, etc. Si ces services ferment ou sont restreints, votre infrastructure peut devenir **inutilisable en quelques heures**. Si votre produit repose sur une **API d'IA, ou tout service externe critique** : une décision externe peut vous arrêter net, **sans préavis**. Cela met en lumière un point essentiel : **la dépendance technologique**, surtout lorsqu'elle est centralisée chez un ou quelques fournisseurs américains, devient une **vulnérabilité stratégique** - non seulement technique, mais économique et opérationnelle. Ce risque paraît improbable aujourd’hui, mais dans une période de regain des tensions internationales, il va aller croissant. ## Le cas emblématique Gemplus, une leçon d'intelligence économique  [L'histoire de **Gemplus / Gemalto**](https://www.youtube.com/watch?v=2wMxldl3Alk) illustre concrètement **la capacité des administrations américaines à atteindre des objectifs stratégiques via un entremêlement de l'économique et du sécuritaire** : - **Gemplus**, leader mondial de la carte à puce dans les années 1990-2000 (cartes SIM, cryptographie, sécurité), a progressivement perdu son contrôle stratégique après l'entrée d'investisseurs étrangers, dont le fonds américain **Texas Pacific Group**. - En **2015**, les révélations d'**Edward Snowden** montrent que la **NSA et le GCHQ** auraient piraté les infrastructures de Gemalto pour **voler les clés de chiffrement des cartes SIM**, permettant l'interception massive des communications mondiales. Ce **précédent concret** montre comment leviers économiques et impératifs sécuritaires peuvent converger pour servir des intérêts stratégiques nationaux, au détriment d'acteurs technologiques européens dans des domaines sensibles. ## Réduire le risque progressivement, via une approche pragmatique Alors, comment se protéger contre ce risque ? Ne tombons pas dans la peur ou le tout‑ou‑rien, mais adoptons une **stratégie progressive et maîtrisée.** Il convient de prendre certaines mesures : 1. **Inventaire des dépendances** : cloud, SaaS, API, stockage, hébergement, fournisseurs, localisation des services et des données. 2. **Évaluation de la criticité** : données sensibles ? propriété intellectuelle ? données personnelles ? cœur du business ? 3. **Priorisation** : mettre en priorité les **éléments les plus sensibles** pour migration éventuelle vers des solutions locales ou européennes. 4. **Architecture modulaire & multi‑fournisseurs** : s’il y a une dépendance à un acteur américain, concevoir le code & l'infrastructure pour pouvoir **basculer d'un fournisseur à un autre**. 5. **Itération continue** : à chaque nouvelle version, nouveau service, nouveau client, se poser la question de la dépendance “critique ou non”, pour sortir progressivement du cercle de dépendance. Cette démarche - **pas à pas** - permet de diminuer la vulnérabilité, sans sacrifier l'innovation ou la performance. ## Comment Ask This Guy (ATG) s’inscrit dans cette vision Chez **Ask This Guy**, nous avons fait le choix clair de la **[souveraineté numérique](https://www.askthisguy.com/fr/doc/infrastructure-and-security)** : - Toutes nos infrastructures sont hébergées auprès d’acteurs **européens**, sur le territoire européen. - Sur la partie **IA / LLM**, notre architecture est **agnostique** : aujourd'hui, nous supportons **sept providers différents**, dont **quatre européens**. [Vous avez le choix](https://www.askthisguy.com/fr/doc/admin-console/organization-settings/choosing-the-right-ai-policy) : soit une approche **100 % européenne**, soit une approche "Europe + US", selon votre tolérance au risque, vos besoins, et votre stratégie. Vous pouvez basculer de l’une à l’autre en quelques secondes. - Le code que nous produisons pour nos clients - tout ce qui est spécifique à leur projet - est **partagé et reste entièrement sous le contrôle du client** : vous gardez la main, et pouvez changer de stratégie, d'hébergement, ou de fournisseur à tout moment. - Cette **flexibilité** fait partie intégrante de notre credo : la souveraineté n'est pas un dogme, mais un **critère stratégique**. En adoptant cette posture dès le début, nous construisons la **résilience technique et économique** de nos clients. Votre fournisseur d’IA est-il dans cette démarche ? Quel LLM et quel fournisseur de cloud utilise-t-il ? Pour aller au bout du sujet, notre page [IA souveraine](https://www.askthisguy.com/fr/ia-souveraine/) détaille la définition que nous retenons, les trois couches à maîtriser (droit, infrastructure, modèles) et les sept questions à poser à un fournisseur avant de signer. ## Conclusion : la souveraineté numérique, un pari sur 2030 Aujourd'hui, l'attrait des géants du cloud, des APIs et des services "prêts à l'emploi" pour lancer vite un produit est puissant. Mais cette commodité a un coût - invisible, souvent ignoré : la **perte de contrôle stratégique** sur ce qu'on pourrait demain considérer comme un de vos actifs les plus précieux : **vos données, votre IP, votre souveraineté**. Ce n'est pas un risque abstrait. C'est une **vulnérabilité structurelle** - juridique, technique, économique. Et plus vous attendez, plus il sera **difficile et coûteux** d'en sortir. Chez **Ask This Guy**, nous croyons que la **résilience numérique** - construite avec des choix conscients et transparents - doit devenir un **critère de compétitivité**. Si vous bâtissez aujourd'hui un nouveau service, une startup ou un produit IA, posez-vous cette question : **“Quel est l’actif critique que je ne peux pas me permettre de perdre ?”** - et construisez autour de lui une architecture fidèle à ce que vous entendez par “souveraineté”. --- # How AI works: the 10 concepts to understand before you sign URL: https://www.askthisguy.com/en/blog/how-ai-works-key-concepts/ Language: en Section: Blog This article is for anyone who takes an interest in AI and sees its potential, but has neither the time nor the inclination to make it their profession. You will most likely want to delegate your AI needs to an internal team or to outside providers. That is a reasonable choice. But you will not be able to skip challenging them, and to do that you need to understand a few key concepts, and above all what they imply for a company project. So here are ten notions to know. No maths, no more jargon than the minimum. Enough to follow what people are talking about, and handle the business side of an AI project. *The content of this article was first published [on LinkedIn](https://www.linkedin.com/posts/budin_internet-%C3%A7a-ne-marchera-jamais-cette-activity-7486371581913456640-wWIV) over the summer, one concept a day.* ## If you only remember one thing There is nothing magical in any of this. Numerical weights tuned by example, text chopped into fragments, tools wired around the outside, your documents placed on the model's desk at the right moment, and a great deal of engineering to keep the whole thing standing. What these ten concepts teach you fits into two sentences. **Your invoice almost never depends on which model you pick, but on how you use it.** And **the proof of concept, the demo that convinced you, accounts for roughly 20 % of the project's total cost.** None of this justifies overselling. None of it justifies waiting either. --- ## Part 1: what a model is made of ### 1. The neural network Conventional software is a sequence of instructions written by a human. "If the customer has more than three orders, apply a 10 % discount." A rule, applied blindly, with a predictable result. To write it, you first have to be able to formulate it. Now write me the rule that recognises whether a photo shows a cat. You will not manage it. A brain does it effortlessly, so computer scientists took their inspiration from that. A **neural network** is an input that travels through millions or billions of numerical weights and comes out as an output. Those weights were not programmed: they tuned themselves from examples. If you open them up, you will find no logic inside.  A cat in a photo, a sentence to complete, a contract to summarise: always the same principle. **Weights, not rules.** The consequence is considerable, and it concerns you directly. Nobody, not even the people who built the model, can tell you precisely why it answered one thing rather than another. This is not a manufacturing defect, it is the nature of the thing. On a cat, who cares. On a loan refusal, a diagnosis or a quote, rather less so. That is the whole reason why the way you govern AI in a company is not an implementation detail. ### 2. Parameters Those weights go by another name: **parameters**. They are the famous "8B", "70B" and "405B" you see attached to model names. For a sense of scale: recognising a cat in a photo takes around 2.5 million parameters. Understanding and writing human language is another matter, and the largest models now exceed a trillion. By way of comparison, the biological equivalent of a weight would be the synapse: a fly has 50 million, a mouse a trillion, a human 100 trillion. What those weights contain, nobody can read. You can think of them as two things blended together: knowledge, and a capacity for reasoning. The second matters more, and it comes mainly from how the model is refined after its initial learning phase. That is why **the race for size has cooled**. In 2020, GPT-3's 175 billion parameters were a record. Today an 8-billion-parameter model beats it on most tasks. Better trained, but smaller.  At comparable training, a large model remains more capable than a small one. But look at where the curve flattens: past a few tens of billions of parameters, each tenfold increase in size buys only a few more points. **Size alone no longer decides who wins.** Why this concerns you: bigger means more expensive, slower, hungrier for energy. Reckon on €0.35 per million generated tokens for a Mistral Small on Scaleway, against $50 for Anthropic's most expensive model. More than a hundredfold difference, when for summarising meeting notes or flagging negative reviews the small model does the job. The smallest ones even run locally, on a laptop or a phone, without your data ever leaving. In an AI project, the point is not to pick the best model. It is to pick the right model for each task. You do not need a human to find the way out of the maze. The mouse can do it too. ### 3. Training If nobody knows what those billions of weights contain, how were they determined? They were not written: they were made to emerge, through **training**. This is an industrial undertaking mobilising billions of dollars in compute, energy and expertise. It happens in two stages. **Pre-training** starts from random parameters. The model is fed an enormous corpus, all of the internet, books and more, and asked to predict the next word. "The doctor examines the patient with his…" yields "stethoscope". At each prediction the error is measured and the weights corrected. Billions of times over. Little by little, the model builds internal representations of the structures of language. **Post-training** then refines that base: verifiable results, imitation of a stronger model, human judgements of the "do you prefer answer A or answer B" kind. What comes out at the end is a model with **frozen weights**. Remember that word, frozen. It is what makes the most widespread sales promise on the market false, the one you hear in just about every pre-project meeting: > "We are going to train an AI on your company's data." The model you use does not change as you use it, and it learns nothing from your documents.  Two countries dominate this stage today, the United States and China, and Europe has lost this particular battle for now. It matters less than it looks: many Chinese models and a few American ones are open, meaning downloadable and runnable on your own infrastructure. We spell out what "open" really covers in our article on [open source versus open weights](https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/). Given the choice, losing the battle for models matters less than losing the one for inference, that is, the moment you actually use them. --- ## Part 2: what you are really paying for ### 4. The token A neural network needs inputs expressed in a closed alphabet, a finite set of values the machine can manipulate. To make it read our language, our texts have to be cut up. But how? By characters? Workable, but an isolated "c" means nothing and the model would take an eternity to compute the meaning of a paragraph. By whole words? Impossible: between languages, conjugations, typos, code and punctuation, you would have to store tens of millions of entries. The compromise that was found is called the **token**. Picture a box of language Lego: instead of every word in the world, a dictionary of 100,000 to 200,000 fragments. A very common word like "hello" is worth a single token. A longer word is assembled like a puzzle, and in a heavily inflected language one of those fragments can carry a whole grammatical tense on its own. That cutting-up is the job of the *tokenizer*, a translator that turns your text into a sequence of codes before sending it to the model. **Why this word shows up on all your invoices.** Two things matter. First, **the bill depends on the language**. Since models were trained predominantly on English, their dictionary favours that language.  The same text, at near-identical character length, costs **14 % more in French than in English**, and close to 40 % more in Swahili. You pay a tax on your working language, and it is not negotiable. Second, **input and output both count**. You pay for the tokens you send, your question but also the instructions, the conversation history and any attached documents, and for those the model generates. A ten-page document is not "one file", it is roughly 5,000 input tokens to process, every single time. ### 5. Inference Training a large model cost someone more than a billion. You will never pay a cent of it. You will, however, pay for every answer. That on-demand computation is called **inference**. Unlike conventional software running on ordinary processors, inference is extremely resource-hungry and requires specialised chips, GPUs above all. That is what allowed Nvidia to multiply its value tenfold in five years. The larger the model, the heavier the infrastructure. A very small model fits on a PC. A mid-sized one needs servers costing a few tens of thousands of euros, still conceivable in-house. A large model is out of reach: you have to rent, and in practice go through an inference provider paid by the token. This is where your costs concentrate, and not where you think. **Picking the right model for the right task, and not recomputing the same thing twice.** Those two decisions weigh far more than the advertised price per million tokens. It is also where sovereignty is decided, since whoever you send your data to sees that data, and answers to their own government. On this layer, though, the gap is not only political, it is technical.  The model is identical in all six cases. Only the party running it changes, and the ratio between the fastest American provider and the best European one exceeds a factor of eight. Worth knowing before you promise your users a sovereign AI as responsive as the one they use at home. The subject deserves more than a paragraph: we have set out what running [an LLM locally in a company](https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/) really costs, and what it does and does not buy you in sovereignty. ### 6. The context window The **context window** is the model's working memory: everything it can read in one go, your instructions, attached documents, the conversation history and your question. It is measured in tokens and currently ranges from 128,000 to around a million. That fast-rising figure gives rise to a now-regular genre of post: "RAG is dead, you can just put everything in the context window." It is wrong, for three reasons. - **The fuller the window, the more you pay.** Every exchange re-reads everything that came before. A single request can cost several euros. - **The fuller it gets, the less precise the model.** A piece of information buried in the middle of 500 pages is missed far more often than one at the start or the end. - **A million tokens is not much** against the real document volumes of a company. A large window is therefore not an invitation to dump everything into it. That is precisely why RAG exists: five good passages beat two thousand pages in bulk. --- ## Part 3: what makes the model useful at your company ### 7. Tools A model is frozen and has never seen a scrap of your data. Yet your AI can comment on this morning's news, answer questions about a confidential contract and analyse your commercial quarter. How? Think back to late 2022: the original ChatGPT could not tell you the weather. In 2023 web search arrives, then other **tools**, and everything changes. Concretely, when you send a request to a model equipped with tools, it has two options: answer you directly, or trigger a tool. The tool runs and returns its result. The model reads it, then chooses again: answer, or call more tools. And so on. 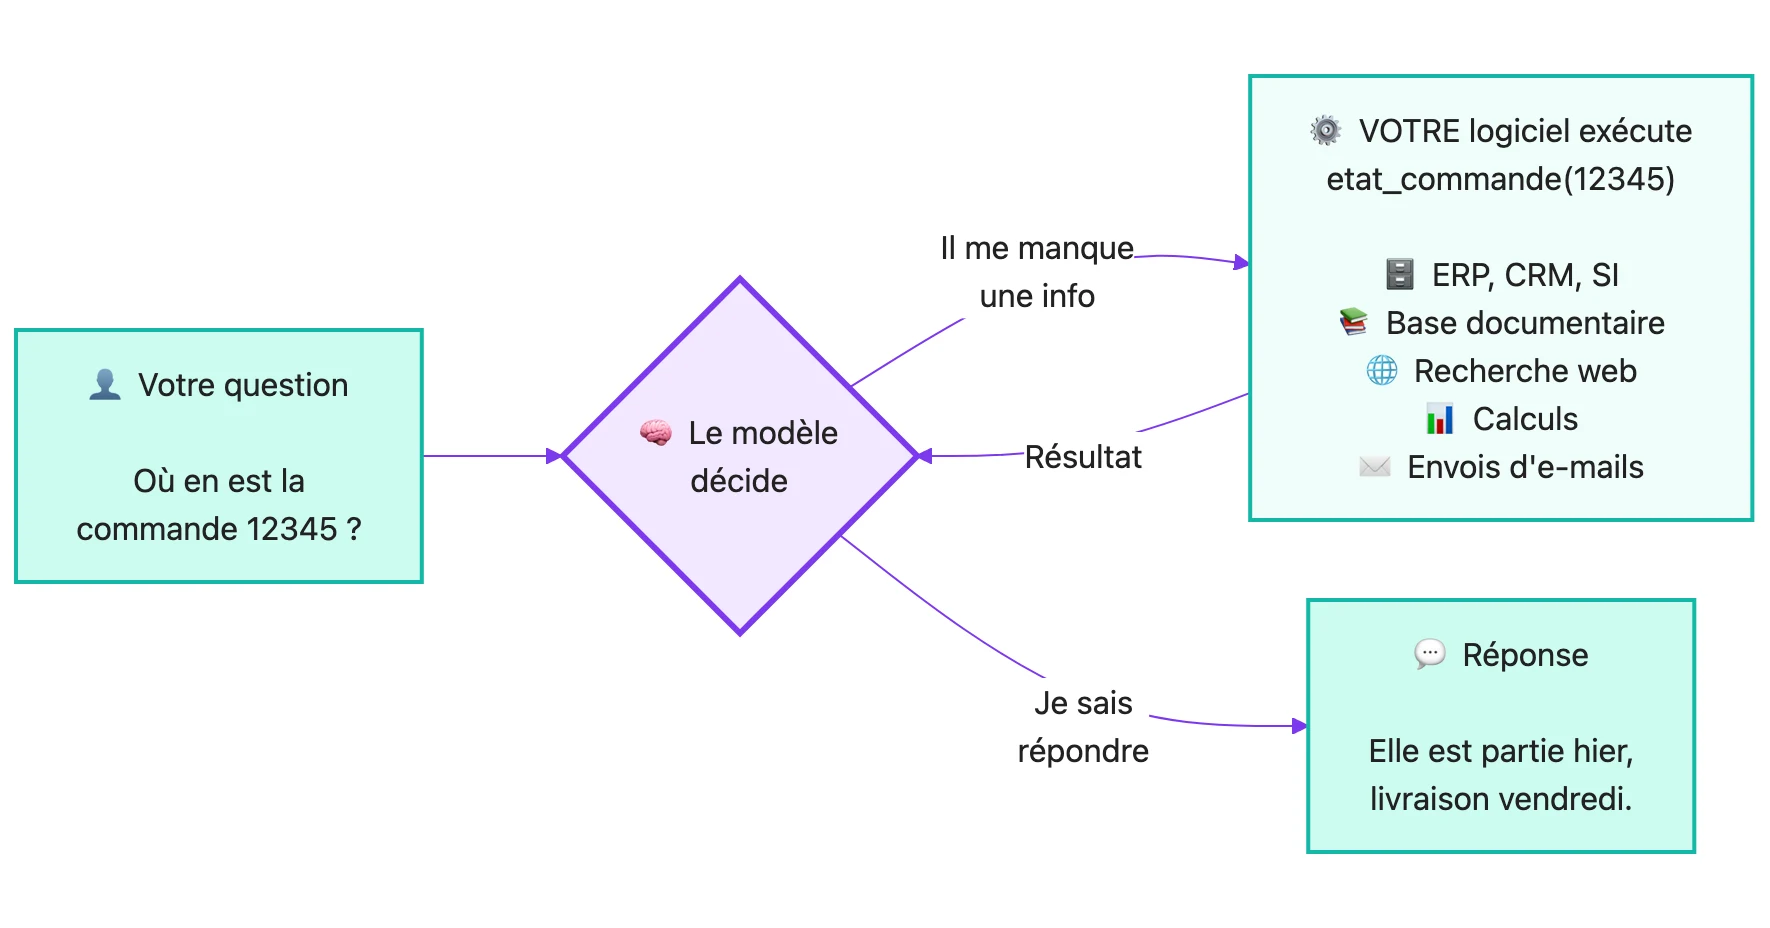 The roles are clear-cut. **The model decides, the software executes.** That execution goes through conventional software, sometimes called the harness, and that is where access rights, logs and approvals are handled. The strong idea, the one that changes how you assess a provider: you add software and neural network together. The model understands, reasons, orchestrates. The software computes, reaches the real data and acts reliably and traceably. **In a serious AI project, the software now counts as much as the model, often more.** Two approaches to these tools coexist. Proprietary tools, built for one piece of software and working only there. And standard tools, foremost among them [MCP](https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/): you expose your system once, and any compatible AI can plug into it. The difference is not technical, it is contractual. With the large vendors, your connectors and your automations stay with them. The day you leave, you start again from scratch. ### 8. RAG A model knows nothing of your contracts, your procedures or your customer history. So it has to be given the information at the moment you ask the question. That is the principle of **RAG**, for Retrieval-Augmented Generation. In its classic form it comes down to four steps. You select your documents and convert them into a usable format. You cut them into chunks, stored in a database suited to semantic search, that is, search by proximity of meaning. When a user asks a question, the system retrieves the most useful passages and appends them to the question. The model answers from those elements. **Nothing has been trained or modified in the model.** Your documents are consulted at the moment of the question, that is all. Hold on to that sentence: it will come back when we reach fine-tuning. An example to grasp why semantic search matters: if you ask "how many days of remote work?", a keyword search may miss a passage headed "working from home". Search by meaning understands that the two are probably talking about the same thing. But keywords remain indispensable, because a product reference like XR-4471B has to be found character for character. That is the whole point of [hybrid search](https://www.askthisguy.com/en/blog/hybrid-search-retrieval-methods/). The word RAG suggests a simple recipe. In production it has become a complete system: connectors, document preparation, access rights, choice of search method, citations, evaluation, monitoring. We have written a [complete guide to enterprise RAG](https://www.askthisguy.com/en/blog/rag-tutorial/) for those who want the detail. ### 9. Agentic AI An AI that can call a tool is not yet an agent. **Agentic AI** is the next step: when the model breaks an objective into several steps, orchestrates them, and corrects itself to reach its goal. The difference shows in use. With a conventional AI you ask "analyse this file and give me the three least profitable products", the AI calls the tool that reads the file and answers. With an agentic AI you ask "prepare this week's commercial review", and it pulls the figures from the CRM, compares them with the previous week, spots unusual variances, looks for explanations in the meeting notes, drafts a summary, asks for human approval, then sends it out. An agent is therefore not a new kind of model. It is a model placed at the centre of a system that supplies it with tools, a working memory, rules, permissions, sometimes a budget, and an objective. We cover the use cases, costs and ROI of an [AI agent in the enterprise](https://www.askthisguy.com/en/blog/enterprise-ai-agents/) in a dedicated article. **The limit to know before you sign.** A model remains probabilistic, and so less reliable than simple software. Take an agent chaining ten steps, each succeeding 95 % of the time. The probability that all ten succeed is 0.95 to the power of ten, or about 60 %. The calculation is deliberately simplistic, but the idea is essential: **the more actions you chain, the more you have to verify intermediate results.** Good automation uses AI only where it is needed, a principle we develop in our article on [minimal AI automation](https://www.askthisguy.com/en/blog/use-minimal-ai-automation/). And since it is very hard to tell a good agent from a bad one from the outside, if you outsource this development, ask for a fixed price and a commitment to results. --- ## Part 4: the two confusions that cost money ### 10. Fine-tuning Here we are. **Fine-tuning** means taking an already-trained model and slightly adjusting its weights on a few thousand of your examples. It is a small resumption of training, not training. And it is the most oversold concept on the market, the one providers present to you while promising to "train an AI on your company's data". What you need to remember fits in one sentence. > Fine-tuning changes behaviour, not knowledge. You want the model to always answer in a precise format, adopt your house tone, handle your sector's jargon? Fine-tuning. You want to improve its success rate on a well-defined task, a classification or code generation? Fine-tuning. You want it to know your 40,000 documents? RAG. Not fine-tuning. One last point not to forget: **fine-tuning has to be redone every time you change model**. Which is to say, often. ### 11. Hallucination A **hallucination** is a false answer produced with all the confidence of a true one. A piece of case law that does not exist, an invented contract clause, a plausible but wrong figure. The common mistake is to treat this as a bug some vendor will eventually fix. It is not one. Go back to concept number 1: a model does not apply rules, it produces the most probable continuation from weights tuned by example. When it lacks the information, nothing in how it works pushes it to say "I don't know" rather than produce something plausible. **Hallucination is structural, not accidental.** Which means you do not eliminate it. You reduce it and you make it detectable, through measures that are all architectural choices rather than model settings: supplying the right documents at the right moment instead of relying on the model's memory, requiring verifiable citations on every answer, having intermediate results checked by deterministic software, and measuring continuously. When a vendor announces an AI "without hallucination", they are selling you either a figure of speech or a misunderstanding of their own product. The right question is not "does it hallucinate", but **"how will I see it when it does"**. --- ## What decides whether the project survives: LLMOps The least saleable concept on the list, and by far the most decisive. **LLMOps** covers everything needed around the model for a project to hold up in production. Conventional software, we have known how to do for forty years. With an agent, nothing works the same way any more. **Tests are no longer binary.** Ask the same question twice, get two different answers. And your users do not follow ten signposted paths, they phrase their request however they like. "I click here, that happens" no longer suffices: you need a set of questions with expected answers, validated by your business experts. **You will not be buying the infrastructure.** An H100 rented continuously comes to nearly €2,000 a month for a single card. So you will depend on third-party providers. **And those providers go down.** Their status pages show 99 to 99.5 % availability, which is up to several days of outage a year. Either you pay a great deal for a contractual commitment, or you connect several and switch as soon as one falters. That is the whole point of an [SLA on an AI service](https://www.askthisguy.com/en/blog/enterprise-ai-sla/). **The bill is counted in tokens** and it drifts fast, since an agent looping fifteen times re-reads its whole history at each turn. Steer by cost per useful request, not by the price per million tokens. **Models change all the time.** Your provider releases a better one, deprecates the old one with a few months' notice, and your finely tuned prompt no longer behaves the same. You need to be able to test, switch and roll back without rewriting the application. **Behaviour has to be steered weekly**: tracing the questions asked, the tools called, the sources used. Otherwise, when a user tells you "it talked nonsense at me", you are debating a perception and improving nothing. What we see in the field: the internal AI projects that do not fail at the proof of concept fail at the run stage. Nobody is really in charge any more, answers degrade, usage drops, and eighteen months later the tool is switched off. **The proof of concept is often 20 % of the total cost. A provider who has only priced the demo has not priced the project.** The proof of concept almost always succeeds. That is precisely the problem. --- ## Frequently asked questions about AI concepts ### What is an LLM? An LLM, for large language model, is a neural network trained to predict the continuation of a text. It consists of billions of numerical weights, called parameters, which were tuned automatically on vast text corpora rather than programmed by humans. Once that training is finished, those weights are frozen: the model no longer changes and learns nothing from the questions put to it. That is what sets it radically apart from conventional software, where every rule was written explicitly and can be read back. ### How does generative AI work? A generative AI produces text by predicting, fragment by fragment, the most probable continuation of what precedes. Your question is first cut into tokens, the word fragments the model knows how to manipulate. Those tokens then travel through the network's billions of weights, which compute the most likely next fragment, then the next, until the answer ends. No knowledge base is consulted and no business rule is applied: only a probability calculation over frozen weights. That is why the same question can produce two different answers. ### Can an AI learn from my company's documents? Not in the sense usually meant. A model's weights are frozen after training and do not change as you use it. For an AI to answer questions about your documents, the model is not modified: it is supplied with the relevant extracts at the moment of the question, a technique called RAG. Your documents are consulted on demand and then forgotten. The phrase "train an AI on your data", common in commercial proposals, therefore describes poorly what actually happens and deserves to be clarified before signing. ### What is a token in AI? A token is the unit of text an AI model actually manipulates: a short word, or a fragment of a longer one. Models hold a dictionary of 100,000 to 200,000 fragments, and text is cut according to that dictionary before being processed. It is the billing unit of almost every AI service, counting separately what you send and what the model generates. A French text consumes about 14 % more tokens than the same text in English, because the dictionaries are built predominantly on English. ### Why does AI cost more in French than in English? Because the token dictionaries of large models were built predominantly from English text. Common English words occupy a single token there, whereas their French equivalents often have to be reassembled from several fragments. At comparable text length, French consumes about 14 % more tokens than English, and some under-represented languages exceed 40 %. Since billing is per token, that difference lands directly on your invoice, and no commercial negotiation can remove it. ### What do 8B, 70B or 405B mean in an AI model's name? These figures indicate the model's parameter count in billions: 8B means eight billion numerical weights. The number gives an order of magnitude for the model's size, and therefore its running cost, its speed and the hardware needed. It does not directly measure quality: since 2023, a well-trained 8-billion-parameter model beats GPT-3 and its 175 billion on most tasks. Beyond a few tens of billions, each tenfold increase in size adds only a few points of performance. ### What is the context window of an AI model? The context window is the amount of text a model can read in one go: your instructions, attached documents, the conversation history and your question. It is measured in tokens and currently runs from 128,000 to around a million depending on the model. Two limits make it less useful than it appears: the fuller it gets, the more each exchange costs since all the content is re-read every turn, and the lower the precision becomes, as information buried in the middle of hundreds of pages is frequently ignored. ### What is the difference between fine-tuning and RAG? Fine-tuning adjusts the model's weights on your examples and changes its behaviour: answer format, tone, business jargon, success rate on a specific task. RAG does not touch the model: it retrieves the useful passages from your documents and supplies them at the moment of the question. For an AI to know your internal documents, that is RAG. For it to always answer in a certain way, that is fine-tuning. Confusion between the two is the source of the commercial promise to "train an AI on your data", which correctly describes neither. ### Why does an AI hallucinate? Because a language model does not consult a database of facts: it produces the most probable continuation from weights tuned statistically on examples. When it lacks the information, nothing in how it works pushes it to answer "I don't know" rather than generate plausible content. Hallucination is therefore structural and cannot be removed by a fix. It is reduced and detected: by supplying the right documents at the moment of the question, by requiring verifiable citations, and by having intermediate results checked by deterministic software. ### Should you choose the most powerful model for an enterprise AI project? No, and doing so is often an expensive mistake. The price gap between a small model and a very large one exceeds a factor of a hundred per million generated tokens, while many enterprise tasks such as summarising meeting notes or classifying messages are handled correctly by a small model. Since 2023, size alone no longer determines quality: a well-trained 8-billion-parameter model beats GPT-3 and its 175 billion on most tasks. Good practice is to assign the right model to each task rather than choosing a single one for everything. ### What is LLMOps? LLMOps covers the practices needed to keep a language-model-based system running in production: building a set of questions with expected answers to test quality, tracing the questions asked, the tools called and the sources used, steering the cost per useful request, and being able to change model or provider without rewriting the application. The discipline differs from conventional DevOps because a model is not deterministic, because providers regularly deprecate their models, and because quality degrades silently rather than causing a visible outage. ### Can an AI be guaranteed never to hallucinate? No. Hallucination follows from the very way language models work, producing a probable continuation rather than a verified fact, and no vendor can eliminate it completely. What can be controlled is its frequency and its detectability: supplying the relevant documents at the moment of the question, requiring verifiable citations on every answer, having intermediate results checked by deterministic software, and measuring quality continuously. A commercial promise of AI "without hallucination" signals either a misunderstanding of the product or a figure of speech. ### How many steps can an AI agent chain reliably? The number of steps is limited by how success rates compound. If each step succeeds 95 % of the time, ten chained steps only succeed together about 60 % of the time, since 0.95 to the power of ten equals 0.60. The calculation is a simplification, but it explains why reliable agents are not the ones chaining the most actions: they are the ones that verify their intermediate results and use the model only where deterministic software would not suffice. ### How much does an AI project cost once the proof of concept is done? The proof of concept generally accounts for around 20 % of the project's total cost over its lifetime. The remaining 80 % is spread across inference billed per token, maintenance of the system around the model, model changes imposed by providers, continuous evaluation of answer quality, and steering the agent's behaviour. A quote covering only the demonstration phase is not a project quote, and this is the main reason internal AI projects are abandoned after eighteen months. --- ## Conclusion Ten concepts, and at bottom a single idea: there is nothing magical in any of this. Weights tuned by example. Text cut into tokens. Tools wired around the outside. Your documents placed on the desk at the right moment. And a great deal of engineering work to keep it standing in production. What these notions give you is not a technical skill. It is the ability to ask the three or four questions that separate a provider who knows from a provider who recites. The next time someone offers to "train an AI on your company's data", you know what to say. Ask whether they mean RAG or fine-tuning. The answer will tell you a great deal. If you are preparing a project and want to test your use case against these trade-offs: **[book a demo](https://www.askthisguy.com/en/demo/)**. --- # Hybrid search: the 6 ways to find a piece of information URL: https://www.askthisguy.com/en/blog/hybrid-search-retrieval-methods/ Language: en Section: Blog An ordinary Tuesday morning, in a 300-person company. Six colleagues are looking for information. None of them wants the same thing, and none of their questions is solved by the same mechanism. - "Can we work from home three days a week?" - "Where do we stand on JP Dupont's order, reference XOD1132?" - "Does this client have an open support ticket right now?" - "How many orders are late at the Lyon site?" - "How many contracts sit in the Clients 2026 folder, and which ones?" - "Which options are included in the Horizon range?" These six questions look alike. Technically they have almost nothing in common: understanding meaning, matching an exact string, calling a third-party system, computing a result, reading a folder tree. The sixth one, as we will see, is not even settled at question time. And they are still the easy ones, since each is solved by a single path. A manager asks questions that combine several of them, in an order nobody knows in advance. Hence **hybrid search**. An assistant that masters only one of these paths will only ever answer a fraction of your teams' questions. Here are the six, then what happens when they have to be chained. ## 1. The information is buried in a document: semantic search "Can we work from home three days a week?" The answer exists. It is on page 34 of a 60-page company agreement, in a paragraph that contains neither the word "three" nor the phrase "work from home", but the wording "remote working arrangements, up to 60% of monthly working time". No exact-match search will find that passage. Semantic search will, because it compares meaning rather than words: documents are chunked and converted into vectors, and the question goes through the same conversion. Two phrasings that mean the same thing end up as neighbours in that space. This is the founding block of [RAG](https://www.askthisguy.com/en/blog/rag-tutorial/), and the one everyone wires up first. Rightly so, it is spectacular. The trouble starts when you stop there. ## 2. The information is a name or a reference: keyword search "Where do we stand on JP Dupont's order, reference XOD1132?" `XOD1132` is a key, not a concept. Same for `JP Dupont`, `Project Atlas` or `PRD-19-B`. These strings have no semantic neighbourhood: an embedding model has no idea that XOD1132 is closer to XOD1133 than to the leave policy, and no reason to know it. On this kind of query, vector search alone brings back plausible noise. You need lexical search, which finds the exact string wherever it appears. Yet your teams use that vocabulary all day long. A company speaks in client references, project codes and in-house acronyms far more than it speaks in concepts. Which is why we file "vector only" among the [mistakes that catch up with a RAG after the POC](https://www.askthisguy.com/en/blog/enterprise-rag-production-mistakes/): the demo works, production breaks. > Semantic search finds what you meant. Keyword search finds what you wrote. You need both. ## 3. The information is in no document at all: the connected business tool "Does this client have an open support ticket right now?" Here neither meaning nor keywords help: the information exists in no document. It lives in the ticketing tool, in the CRM, in the ERP. And since it changes within the hour, indexing it would be a bad idea anyway. So you have to **call the system that holds the data**, at question time. Through an [MCP server](https://www.askthisguy.com/en/doc/admin-console/tools-management/mcp-servers) when the vendor provides one, or through a [tailored tool](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools) when you need to plug into an internal API. The [MCP protocol](https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/) has made that plumbing far cheaper than it was two years ago. ## 4. The information does not exist yet, it has to be computed: the database query "How many orders are late at the Lyon site, and which clients are affected?" That answer is written nowhere. It is computed, by crossing order lines, promised dates and a site code. That is the job of a [database query](https://www.askthisguy.com/en/doc/customizing-atg-to-you/database-query) tool: the assistant turns the question into SQL, runs it read-only on an authorised scope, and returns the result. Your most reliable and most current data often sits there, in structured databases nobody queries because it means filing a ticket with the data team. We covered this in [Your databases are a gold mine](https://www.askthisguy.com/en/blog/databases-gold-mine-ai-shovels/). ## 5. The question is about the documents themselves: the document catalog "How many contracts sit in the Clients 2026 folder, and which ones?" A trap for a classic RAG. Semantic search will bring back ten passages that *mention* contracts, without being able to count them or guarantee it has seen everything. On an inventory question, a system that answers "around fifteen or so" is worse than a system that does not answer. The question is about the **document base itself**: its tree, its paths, its sources, its dates. You need a tool that queries the catalog deterministically rather than the text. That is what our [document catalog query](https://www.askthisguy.com/en/doc/admin-console/tools-management/chat-tools) does. It answers the "how many", the "list the subfolders of", the "which documents come from this SharePoint", and it also serves to locate a specific file before reading its content. ## 6. The information is there, but unreadable: tailored processing "Which options are included in the Horizon range?" The answer is in a file you have already indexed. It is in a 40-column spreadsheet where each row is a reference and each column an option, with crosses, merged cells and three header rows. Or in a floor plan, or in a product catalog exported from an ERP. None of the five previous methods will save that file. Chunked as plain text like an ordinary document, a spreadsheet produces chunks along the lines of `Horizon ; X ; ; X ; 2 ; ; yes`. Syntactically text, semantically noise. The passage may well be retrieved, but it will mean nothing, neither to the model nor to the user reading the citation. This sixth path is of a different nature: **it makes searchable what was not**. It happens at indexing time, not at question time. In practice, our [tailored processing](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-processing) pairs a trigger (a file type, a pattern in the name, a recognisable structure) with extraction rules written for that specific format: what each column means, which rows are totals, which unit applies. The file goes in as a spreadsheet and comes out as usable knowledge, with its citations. We deliberately apply no generic processing to every Excel file. A spreadsheet without its business context is raw data: the "Amount" column may be in euros or dollars, the "Status" may be the order's or the project's. Automatic parsing produces noise that looks like an answer, and that is the worst possible outcome. 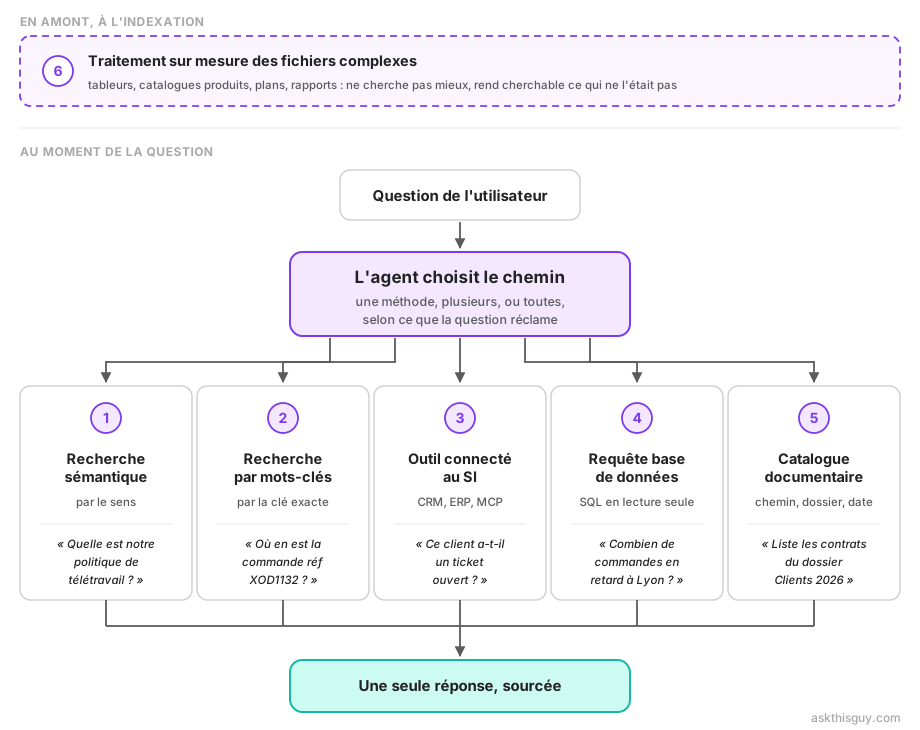 ## When a single question calls for several paths My six examples have one flaw: they are too clean. Each points at its own path almost by itself. An operations director asks something more like this: > "Are we meeting our commitments with Durand this year?" Nothing in that sentence says where to look, which commitments are meant, or over what period. None of the six paths is enough on its own, and **you cannot decide in advance in which order to take them**. The assistant first has to find what sets out the commitment: a contract, an amendment, a service agreement. Path 1, plus path 5 if the right file has to be located in the right folder tree. There it reads the thresholds, response time, number of included interventions, availability rate. And it learns along the way that the period runs on the calendar year, not on a rolling twelve months. Only then does it know what to ask the ticketing tool. Path 3 fires, with a filter it has just discovered in the contract. If the volumes sit in a database rather than in ticketing, path 4 takes over. Then it compares, and it answers. **The second query could not have been written before reading the result of the first.** An agent runs an investigation where a simple router merely dispatches: it weighs what it gets back and decides whether it knows enough to answer, or whether it should go looking again. The principle is detailed in our article on [agentic RAG](https://www.askthisguy.com/en/blog/rag-tutorial/). Two consequences, usually discovered too late. First, it has to know when to stop: an investigation burns time and tokens, and without limits on the number of round trips the system becomes slow and expensive, hence unusable even when its answers are good. Second, it has to be traceable. When an answer comes out of four calls to three sources, the user must be able to check where each element came from. Without citations nobody grants their trust, and an answer you do not trust is worth nothing. ## What you probably have today The test is simple. Take the six questions from the start and put them to the assistant you already use. With **Copilot**, you are well served on questions 1, 2 and 5, as long as the information sits in Microsoft 365. You stop at the boundary of your business systems and your databases: questions 3 and 4 go unanswered, or come back as an approximation. And your unusual business files are treated like ordinary files. With a **RAG built in-house**, you almost certainly have path 1, sometimes path 2. That is the natural route, vector search is what you wire up first and what makes a good demo. The other paths need integrations, access rights and operations, so work after the POC. With a **classic enterprise search engine**, you have paths 2 and 5, with filters. It is fast and solid, but you have to know what to type. Nobody finds the remote work policy by searching "remote work" when the document says "working from home". None of these tools is bad, and I want to be clear about that. They cover part of the need, properly. The problem is that your teams discover the other part by running into it, question after question, and they soon stop asking. ## The Ask This Guy approach We took the problem from the other end. Rather than optimising one search method, we wired up five, plus a sixth that prepares the ground, and we put an agent on top. The agent decides. It rephrases the question, picks the path or paths to take, reads what comes back, and judges whether it knows enough. If not, it goes again, better targeted, with what it has just learned. On the Durand case above, it chains documents then ticketing without anyone telling it in which order. And if the contract lives in an in-house tracking spreadsheet, it is the tailored processing, configured once, that let it read the file properly. The [documentation](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag) covers the mechanics. Every element of the answer points back to its source, whichever path found it. On the user side, none of this needs to be known. They ask their question in plain language. That is the least we can do: asking a salesperson to choose between "semantic search" and "SQL query" before typing a sentence would be handing them an engineering problem. **If you remember one thing.** The quality of an enterprise assistant comes down to how many paths it can take, and above all to its ability to chain them without being told the order. The model it runs on matters far less than people think. A single search method mechanically means a majority of questions with no reliable answer. ## Frequently asked questions about hybrid search ### What is hybrid search? Hybrid search means combining several complementary search methods instead of relying on one. Strictly speaking, it pairs semantic search (by meaning, through embeddings) with keyword search (by exact match). More broadly, it also covers calls to business tools, database queries and document catalog queries, to handle questions whose answer is in no document at all. On top of that sits an upstream path: tailored processing of complex files, which makes spreadsheets and catalogs usable when standard chunking would turn them into noise. ### What is the difference between semantic search and keyword search? Semantic search compares meaning: it finds "remote working arrangements" from the question "can we work from home?". Keyword search compares character strings: it finds the exact reference `XOD1132` or the name `JP Dupont`, which semantic search misses because those strings carry no meaning of their own. Both are needed, because a company handles as many internal references as it does concepts. ### Why is vector search alone not enough? Because a large share of enterprise questions involve identifiers with no semantic value (product references, project codes, client names), live data held in business systems, figures that have to be computed in a database, or the structure of the document base itself. It also fails on files where structure carries the meaning, such as spreadsheets, which text chunking reduces to strings of cells. None of these cases is handled properly by vector proximity, which nonetheless remains the only mechanism in many RAG projects. ### How does an assistant know which search method to use? The agent decides, based on how the question is phrased and on the descriptions of the tools available to it. A conceptual question triggers semantic search, an explicit reference triggers keyword search, a counting request triggers a catalog query. On complex questions it chains several of them, using the result of the first to formulate the next, until it judges that it knows enough to answer. ### Why does a classic RAG handle Excel files badly? Because in a spreadsheet, meaning is carried by structure as much as by text. A cell means nothing without its column header, its unit and its reference row. Chunking into pieces of text, which works well on a contract or a procedure, produces strings of values with no context here. You need processing adapted to the format, which reconstructs what each column means before indexing. --- ## Conclusion Everyone can answer the easy question, the one whose answer sits in a well-written paragraph of a well-filed document. An assistant is judged on the other five: the ones where the information is somewhere else, where it does not yet exist as text, or where it sleeps in a file nobody has bothered to make readable. If you want to see how your own questions fare, the ones your teams actually ask, **[book a demo](https://www.askthisguy.com/en/demo/)**: we will start from your real sources. The approach is detailed on the [turnkey enterprise RAG](https://www.askthisguy.com/en/solutions/knowledge-rag/) page, and querying your databases on [Talk to Data](https://www.askthisguy.com/en/solutions/talk-to-data/). --- # French AI for enterprises: what sits behind the word “sovereign” URL: https://www.askthisguy.com/en/blog/ia-francaise-souverainete/ Language: en Section: Blog **Foreword: a note on method** This work is based on **public sources only**: vendor websites, legal notices, privacy policies, DPA annexes, subprocessor lists, the national company register, EDGAR, the trade press. Legal data comes from the official API `recherche-entreprises.api.gouv.fr`. The scope is **AI products sold as SaaS to companies**: assistants, RAG, AI suites. Collaborative platforms and enterprise social networks are excluded, even when they ship an AI layer, because it is neither the same product nor the same buyer. We did not interview any vendor. When a piece of information is not public, we say so, and **no conclusion is drawn from an absence of information**. We publish Ask This Guy, which appears in this panel and was put through the same criteria as the others. An error, an inaccuracy, a fact that has changed, a missing vendor: write to **bonjour@askthisguy.com**. We correct and we date the correction. We notice (and we welcome it) that more and more companies care about the sovereignty of their tools, especially in AI. And France has a particularly rich ecosystem of services firms and software vendors. Since Snowden, we have known that any data within their reach is watched by the US administration. Since Trump's second term, the executive has chosen to [cut access in a targeted way to US services](https://www.askthisguy.com/en/blog/souverainete-numerique-dependance-americaine/). That trend is likely to intensify, and from then on it puts companies at significant risk. Choosing a vendor founded by French people inside a US structure does not protect you. Likewise, if your company's data is hosted on a US cloud or sent to a US AI provider, the problem remains the same. So we wanted to check which French companies were in a position to guarantee the sovereignty of their products and protect their customers. ## The three questions that matter, and what they cost you ### Who you contract with, and who owns the capital Two checks, in that order, because the first one is eliminatory. **First, which company signs the contract.** A French team, French founders and an office in Paris say nothing about the entity that sells you the service. A group can perfectly well have a French subsidiary that employs the staff, and a US company that commercialises the product and declares itself the data controller. In that case, you contract with a company under US law, and the rest of the analysis becomes irrelevant: it does not matter where the servers sit, the company that holds your data falls under a foreign jurisdiction. That takes three minutes to check on the legal notice or the `/legal` page. **Then, who owns the capital.** Here, a company can be perfectly French, incorporated, with no foreign parent, and still have majority extra-European capital after a few funding rounds. What that changes for you: nothing today, on your data. But whoever controls the capital controls what comes next. A sale, a change of headquarters, dropping the sovereign line if it costs too much, shifting the infrastructure to a provider the new shareholders know better: these are decisions taken at the board, not in the product team. The risk therefore sits on a three-to-five-year horizon, and it is worth knowing without turning it into a drama. ### Who hosts your data This one is the most important of the three, and by far the most damaging. A host under US law remains subject to US law, including when its servers are in Paris or Frankfurt. The CLOUD Act, adopted in 2018, lets US authorities demand from a US company the data it holds, including when that data is stored abroad. Server location is not a defence. The other risk took longer to become credible: the service being cut off. Since 2025, several unilateral US decisions have suspended access for political reasons, with no useful notice for the European customer. What makes this criterion frustrating is that it is **entirely avoidable and it brings the user nothing**. OVHcloud, Scaleway and 3DS Outscale host databases and application servers as well as AWS or Google Cloud. Nobody in your company will ever see the difference in use. A French vendor that hosts with a US hyperscaler has made an engineering-comfort choice, not a product choice. ### Who runs inference Inference is the moment when the AI is executed, and turns an *input* (a query, documents, and so on) into an *output* (a reply to a message, generated documents, generated content, and so on). Concretely: company data that travels with your query goes to whoever runs the model. Here the vendor has a mitigating circumstance. The best models on the market are American, and the one that plugs in GPT or Claude often delivers a better service to its users. The choice is entirely defensible. It is simply rarely written in black and white on the product pages. **Location is not jurisdiction.** GPT, Claude and Gemini are closed models. Nobody other than OpenAI, Anthropic and Google holds the weights, so nobody else can run them without a strategic partnership (they have to protect their intellectual property). In practice, it is US actors who run these models (Microsoft, Amazon, and so on). Whether the server is in Paris, Dublin or Virginia, **the processing is performed by a company under US law**. A European region satisfies a localisation clause in a contract. It does not change who can be compelled to produce the data. The only genuinely European inference goes through open-weight models operated by a European actor, or through a vendor that produces its own models. And one question remains, the one almost nobody asks. **“Of your choice”, but whose choice?** Almost all of these products are multi-model. Some let you pick the model or the model family, others do not. If the trade-off sits with an **administrator**, it is a company decision: taken once, it applies to everyone. If the trade-off sits with the **user**, everything rests on each person's discipline. It is therefore unlikely that all of them will apply the sovereignty criteria. ## The table Fourteen vendors, in alphabetical order. **Legend.** ✅ the criterion is met by default. 🟠 it is reachable, but it takes a move: a written request, a contractual clause, a manual opt-out provider by provider. ❌ it is not met. ? the information is not public. | Vendor | Entity and capital | Data hosting | Inference controllable by the company | |---|---|---|---| | **Ask for the Moon** | ✅ FR entity, FR and DE capital | ❌ Microsoft Azure, Paris | ? | | **Ask This Guy** | ✅ FR entity, 100% FR capital | ✅ OVHcloud, Gravelines | ✅ “EU only” setting in the admin console | | **Cominty** | ✅ FR entity, capital not published | ? | ? | | **Craft AI** | ✅ FR entity, controlled by a FR holding | 🟠 AWS in production, 3 FR clouds allowed by contract | 🟠 2 European providers out of 8 (Mistral, Scaleway) | | **Delos** | ✅ FR entity, capital not published | ✅ Scaleway, Paris region | ❌ closed US models, choice left to the user | | **Dust** | 🟠 FR entity, majority US capital | ❌ Google Cloud mandatory | 🟠 opt-out provider by provider | | **IA-Souveraine.fr (DRI)** | ✅ FR entity, FR holding | ✅ DRI is its own host, datacenter in Le Mans | ✅ open models run on DRI's machines, in France | | **LightOn** | ✅ FR entity, listed in Paris | ? | ✅ own models, on-premise and air-gapped | | **Limova** | ✅ FR entity, capital not published | ? | ? | | **Mistral AI** | ✅ FR entity, majority-European capital and voting rights after the €3bn round led by Samsung in September 2026 | 🟠 own datacenters, Microsoft cited for Studio EU | 🟠 EU lock on written request | | **Outmind** | ✅ FR entity, capital not published | ❌ AWS EMEA, Paris | ? | | **Prisme.ai** | ✅ FR entity, capital not published | 🟠 deployed at the customer, the vendor guarantees nothing | ? | | **Slite** | ❌ **US entity**, Slite, Inc. (Delaware) | ❌ Google Cloud, Belgium | ? | | **Wikit** | ✅ FR entity, capital not published | ✅ OVHcloud, France | 🟠 configuration at the project level | ## The vendors, one by one We sorted them into five groups. A useful clarification before we get into the details: these three criteria say nothing about product quality or the seriousness of the team. A vendor can be excellent at its job and still end up in the last group. We also found no lies in the commercial claims: vendors that did not make sovereign choices do not pretend they did, and they own their positioning. ### Group 1: European hosting and European inference **Ask This Guy.** ATGU SAS, 100% of the shareholding held by French individuals or personal holding companies. Data on dedicated OVHcloud servers in Gravelines, redundancy in Frankfurt, plus our own GPUs at Verda, a Finnish company. Two organisation-level inference policies, “EU only” or “Worldwide”, changeable from the admin console. This is our product; we come back to it below.
*Sources: [our approach to sovereign AI](https://www.askthisguy.com/en/doc/infrastructure-and-security/sovereign-ai/), [managing AI providers](https://www.askthisguy.com/en/doc/infrastructure-and-security/ai-providers/).*
**IA-Souveraine.fr.** Published by **DRI (Digital Rural Informatique)**, a SAS created in 2001 in Le Mans, controlled by a French holding company. This is the most vertically integrated file in the panel: DRI is not a software vendor that rents cloud, it is a twenty-five-year-old host that added an AI layer. The independence sits on the infrastructure, not on the models, which remain open weights published by others, Google, Meta or Mistral depending on the case. Its legal notice says it in so many words: it is “publisher **and** host” of the platform. Own datacenter in Le Mans, own network and autonomous system number, ISO 27001 and ISO 14001 certifications, HDS compliance available, hosting exclusively in France for the sovereign offer.
On inference, the sovereign offer is clear: open-weight models are run on DRI's machines, in France, therefore by a French company. And unlike the multi-model platforms in this list, there is nothing to lock down, because there is nothing to exclude. Sovereignty is the product, not an option to switch on. One reservation, though: the platform advertises more than 80 models in total, including “reference commercial models” that are never named. We read those as a distinct offer from the sovereign one, which is consistent with how DRI presents the two, but the question is worth asking if you subscribe.
*Sources: [legal notice](https://www.ia-souveraine.fr/mentions-legales), [privacy policy](https://www.ia-souveraine.fr/confidentialite), [sovereignty page](https://www.ia-souveraine.fr/souverainete), [DRI launch press release](https://www.dri.fr/communique-de-presse-national-ia-souveraine).*
**LightOn.** A public limited company listed on Euronext Growth Paris since November 2024. Models developed in-house, deployment possible on-premise and as far as air-gap for classified environments. Information we could not find: LightOn nowhere names the host of its SaaS offer, presented as a “sovereign European cloud” with no further detail.
*Sources: [developer privacy policy](https://developers.lighton.ai/legal/privacy-policy), [deployment options](https://lighton.ai/deployment-options), [Euronext Growth IPO sheet](https://live.euronext.com/en/ipo-showcase/lighton).*
**Mistral AI.** The only vendor in the panel that produces its own models and operates its own datacenters: Bruyères-le-Châtel and Les Ulis in Essonne, Borlänge in Sweden, with an Île-de-France campus announced at 1.4 GW at full capacity. In September 2026 the company raised €3 billion, the largest round ever closed by a European tech company, taking its valuation to around €21 billion. The round is led by South Korea's Samsung, the single largest contributor, alongside the European Commission's Scale-up Europe fund, PSG Equity, ASML, Nvidia and BNP Paribas CIB. The proceeds are earmarked for own datacenters and for doubling, within five years, the compute capacity the company owns. On capital, Mistral claims a majority-European shareholder base: according to franceinfo, European investors account for roughly half of this round, and after the deal Europe keeps about two-thirds of the capital and three-quarters of the voting rights on the board. Shareholders include ASML, which came in at around 11% in late 2025, Bpifrance, US funds and the Emirati sovereign wealth fund MGX.
Two nuances, which take nothing away from the industrial depth of the file. And let's say up front that **we only know them because Mistral publishes them**: its Trust Center is one of the most complete in the panel, with a tab that names its subprocessors. Many vendors on this list expose nothing comparable, and that is precisely why their write-ups are shorter. That Trust Center therefore cites **two US companies in the chain**: Microsoft as the cloud infrastructure provider for European Studio customers, and CoreWeave as an inference compute provider. And the European lock **goes through a written request**: Enterprise customers have the features that involve a transfer outside the EU disabled at organisation level, by asking Mistral.
*Sources: [where is my data stored?](https://help.mistral.ai/en/articles/347629-where-do-you-store-my-data-or-my-organization-s-data), [regional inference documentation](https://docs.mistral.ai/inference/regional-inference), [Trust Center, Subprocessors tab](https://trust.mistral.ai/subprocessors), [infrastructure and open models announcement](https://mistral.ai/news/regional-inference-open-models-new-compute/), [September 2026 funding round, franceinfo](https://www.franceinfo.fr/internet/intelligence-artificielle/la-start-up-francaise-mistral-annonce-une-nouvelle-levee-de-fonds-de-trois-milliards-d-euros-portant-sa-valorisation-a-plus-de-21-milliards-d-euros_8182583.html), [investor breakdown, Clubic](https://www.clubic.com/actualite-628704-mistral-ai-boucle-la-plus-grosse-levee-de-fonds-jamais-realisee-par-une-tech-europeenne.html).*
**Wikit.** Wikit SAS, Lyon, specialist in the internal support assistant. Hosting on OVHcloud in France. Wikit names **seven third parties in total**, which is already rare, and above all it publishes **the best documentation in the panel on the model layer**: a table that states, provider by provider, whether data stays in the EU, with a row that frankly answers “no” for OpenAI. Nobody else does that. Provider choice is set at the project level; no customer-facing admin console is documented.
*Source: [privacy and security, Wikit documentation](https://docs.wikit.ai/privacy_and_security/).*
### Group 2: The infrastructure is there, the door stays open
**Craft AI.** Craft.ai SAS, chaired by a French holding company. The file illustrates the “listed is not mandated” trap: the annex to its DPA authorises five clouds, including 3DS Outscale, OVHcloud and Scaleway, while production runs on AWS and Scaleway. In other words, the French building block exists, contractually, but it is never presented as a catalogue option. On the model side, of the eight authorised providers, **five are American** (AWS Bedrock, Google Vertex AI, Microsoft AI Foundry, OpenAI, Voyage AI), one is Canadian (Cohere), and **only two are European**: Mistral AI and Scaleway. A fully European inference setup is therefore possible on paper, but it means sticking to those two lines.
*Sources: [DPA annexes](https://www.craft.ai/en/cgu-craft-ai/annexes), annex B for actual hosting and annex C for authorised subprocessors, [additional terms on foundation models](https://www.craft.ai/en/cgu-craft-ai/conditions-complementaires-relatives-a-lutilisation-des-modeles-de-fondation-ccmf).*
**Delos.** The most frustrating file in the panel. Delos Intelligence hosts **all data with Scaleway in the Paris region**, with triple replication, ISO 27001 certification and a trust center. On hosting, nothing to criticise, and this is the standard offer, not a paid option.
Then it gets more complicated. The security page states that models are “hosted exclusively in the European Union”. But the catalogue on display is GPT 5.2, Claude Opus 4.5, Gemini 3 Pro and Mistral Large 3: **three closed models out of four, therefore necessarily operated by their US publishers**, wherever the server runs. And the interface lets the **user** pick their model, with nothing documenting the ability for an administrator to restrict the list. To its credit, and this is the only serious mitigation when models are closed: the security page mentions **processing on pseudonymised data** before transmission to the model. What remains is to get a precise answer on what is pseudonymised, and at which point in the chain.
If that administrator setting existed, Delos would become one of the most sovereign solutions on the market without touching its infrastructure.
*Sources: [security page](https://www.delos.so/fr/security), [privacy policy](https://www.delos.so/fr/politique-de-confidentialite), [Assistant product page](https://www.delos.so/fr/applications/assistant) for the model list, [fundraising, FrenchWeb](https://www.frenchweb.fr/delos-leve-25-millions-deuros-pour-imposer-un-os-francais-de-lia-dans-lentreprise/453448).*
### Group 3: Backed by a US hyperscaler
**Ask for the Moon.** Franco-German capital, €2.5m raised in March 2024 from Matterwave Ventures and UI Investissement, with no extra-European investor identified: that is the strength of the file. Services are hosted on **Microsoft Azure in Paris**, and inference is not documented publicly. One point to have confirmed in writing: their own data-protection page states that data at rest is not encrypted, which is unusual.
*Sources: [protecting your data](https://askforthemoon.com/fr/protectingYourData), [profile and fundraising, Maddyness](https://www.maddyness.com/2024/03/13/cette-startup-dune-ancienne-dg-de-la-sncf-utilise-lia-pour-relier-les-intelligences-humaines/).*
**Dust.** Permutation Labs SAS, a French company. The capital, however, is majority American. **Hosting rests exclusively on Google Cloud**, only the region varies, and no documented alternative exists: that is the one point in the file that cannot be fixed with a setting.
Two things to put to their credit. Dust is very transparent: legal notice, group entities page, security measures, dated subprocessor list, specific terms for foundation models, everything is public. And it is the only one to have publicly contractualised a per-provider opt-out right, self-serve for inference. The mechanism is nevertheless a blacklist, not a whitelist: compliance is obtained by disabling five providers to keep one, and in a strictly European mode, only Mistral remains.
*Sources: [security measures](https://dust-tt.notion.site/816d4ef898364ba180973a2c883b6d32), [subprocessor list](https://dust-tt.notion.site/Sub-Processors-cb656ff3093c4aee9e080e3021e71f9c), [foundation model terms](https://dust-tt.notion.site/9ed7e35633084d5fa03ebb02286de0da), [entities and affiliates](https://dust-tt.notion.site/20f5657d59a34c38a40e2567ec59db25).*
**Outmind.** Outmind SAS, Palaiseau. Processing by default in the EEA, host **AWS EMEA in Paris**, dedicated instance per customer with its own encryption key. Inference is not documented. Another point of attention: user authentication goes through Clerk, a San Francisco company, and nothing indicates that it is optional.
*Sources: [security page](https://www.outmind.ai/security), [privacy policy](https://www.outmind.ai/data-privacy).*
### Group 4: Too little public information to conclude
For these three, we simply did not find enough public material. A thirty-minute conversation would move all three write-ups, one way or the other.
**Cominty.** Cominty SAS. The product is presented as “agnostic”: Docker, GCP, AWS, OVH. That is likely a choice left to the customer, but default hosting is not documented, and no model provider is named. On security, by contrast, Cominty says more than the group average: **SOC 2 Type II**, GDPR compliance, AES-256 encryption at rest and TLS 1.2+ in transit. Be careful not to conclude too fast: agnosticism can just as well cover an organisation setting as a free user choice.
*Sources: [cominty.ai website](https://www.cominty.ai/), [trust center](https://trust.cominty.ai).*
**Limova.** Brand operated by Kainotom.ia SAS, in Nice. The privacy policy claims hosting “exclusively on servers located within the European Union”, but the only subprocessor named in the entire documentation is Google Firebase, a Google LLC service. The documentation describes neither a model provider nor a processing chain, for a product whose agents read emails and take phone calls. Also worth noting, on form: the legal notice publishes neither the SIREN, nor the RCS number, nor the host, even though the law requires them.
*Sources: [legal notice](https://www.limova.ai/legal/mentions-legales), [privacy policy](https://www.limova.ai/legal/politique-de-confidentialite), [the Limova model, Maddyness](https://www.maddyness.com/2026/01/29/agents-ia-entreprises/).*
**Prisme.ai.** Prisme.ai SAS. The distinctive point changes the whole reading: the platform is deployed in **self-hosting or the customer's private cloud**, via Kubernetes, on OVHcloud as well as on AWS or Azure. Sovereignty is therefore entirely delegated to the customer: whoever deploys on OVHcloud gets a French stack, whoever deploys on AWS does not, and the vendor guarantees neither. No model provider is named, no certification is mentioned, and the capital is not published.
*Sources: [Prisme.ai documentation](https://docs.prisme.ai/), [product pages](https://www.pages.prisme.ai/fr).*
### Group 5: The false friend
**Slite.** Slite is regularly listed among the French alternatives: French founders, French team, Paris office, a knowledge-management product with AI search. Its own legal page is nevertheless unambiguous.
> The contracting entity and data controller is **Slite, Inc., a Delaware company**, based in San Francisco. Slite France SAS “does not market the Service and does not act as the contracting entity for customers: it provides employment and support services within the group”.
Production data is hosted on Google Cloud, in Saint-Ghislain, Belgium. A European customer therefore contracts with a US company, on US infrastructure, with servers in Belgium. That is perfectly legal, the company does not hide it, and its security is solid, with SOC 2 Type II. Slite does not promise sovereignty.
It is also, among fourteen vendors, **the only case of a company controlled from abroad**.
*Sources: [legal information](https://slite.com/legal), [privacy policy](https://slite.com/privacy), [security page](https://slite.com/security).*
## A small extra reality check: where their own website is hosted
This one has no operational bearing. A marketing site does not hold your data, and handing it to a US provider commits nothing about the product architecture. But it is the only test you can run yourself, in thirty seconds, before the first meeting. And it says a little about the house mindset.
Here is what we were able to determine:
| Institutional website host | Vendors |
|---|---|
| **French host** | Ask This Guy and Wikit (OVHcloud, Scaleway); IA-Souveraine.fr on its own network |
| **AWS (United States)** | Prisme.ai |
| **Webflow (United States)** | Ask for the Moon, Cominty, Craft AI, Delos, LightOn, Limova, Outmind |
| **Google Cloud or Netlify (United States)** | Dust, Mistral AI, Slite |
## The three questions to ask in a demo
If you take only one thing from this article, it should be these three questions. They take ten minutes to ask and they call for verifiable answers.
1. **“Who hosts our data, by name, and is there a European alternative to your standard offer?”** A serious vendor names its host. Refusing to name it is an answer in itself.
2. **“Can we choose, lastingly and simply, never to use non-European inference providers?”**
3. **“If we switch to a fully European setup, how many providers do we have left?”** Compliance that rests on a single provider is a single point of failure.
## What we did with this, at Ask This Guy
We built our product by trying to answer these questions in advance, and that is also why we wanted to write this article. Our offer is laid out in detail on our [sovereign AI](https://www.askthisguy.com/en/sovereign-ai/) page.
Concretely: infrastructure and databases sit on dedicated OVHcloud servers in Gravelines, with redundancy in Frankfurt, and we operate our own GPUs at Verda, in Finland and Iceland, to run open-weight models ourselves. On inference, an administrator switches the whole organisation between two policies from a console menu: “EU only”, which allows only European providers and our self-hosted models, or “Worldwide”, which opens the model layer without ever moving the hosting. The setting can be changed at any time.
We do not claim this is the only good architecture. Several vendors on this list made different, perfectly defensible choices. We simply think a buyer should be able to observe, lock and prove, without having to negotiate.
The detail of our processing chain is documented publicly in our [approach to sovereign AI](https://www.askthisguy.com/en/doc/infrastructure-and-security/sovereign-ai/) and in our [AI provider management](https://www.askthisguy.com/en/doc/infrastructure-and-security/ai-providers/).
## Frequently asked questions about French and sovereign AI
### What is sovereign AI for a company?
Sovereign AI is a solution whose vendor company, data host and inference operator all fall under European law, so that no foreign authority can demand access to the data or interrupt the service. The term has no legal definition and no official label: you therefore have to check the three links separately, in the vendor's public documents.
### Is AI hosted in France necessarily sovereign?
No. Hosting in France with AWS, Microsoft Azure or Google Cloud is still operated by a company under US law, subject to the CLOUD Act regardless of where the servers sit. Data residency satisfies a contractual localisation clause, but it does not change the jurisdiction that applies to the provider. That is the distinction most often skipped in commercial pitches.
### Is Mistral AI a French company?
Yes. Mistral AI is a simplified joint-stock company under French law, registered under SIREN 952 418 325, with no parent company outside the European Union identified. In September 2026 it closed a €3 billion round led by South Korea's Samsung, at a valuation of around €21 billion. Despite the arrival of non-European investors (Samsung, Nvidia), the company claims a majority-European shareholder base: according to franceinfo, roughly two-thirds of the capital and three-quarters of the board voting rights remain European after the deal. Shareholders include Dutch ASML, which came in at around 11% in late 2025, Bpifrance, US funds and the Emirati sovereign wealth fund MGX.
### Is Dust a French company?
Yes on the legal plane. The contracting entity is Permutation Labs SAS, a French company registered under SIREN 949 205 314, with no foreign parent, which its legal notice and group entities page confirm. Its capital, however, is majority American after two rounds led by Sequoia, and its infrastructure rests exclusively on Google Cloud.
### Can you use ChatGPT or Claude and stay sovereign?
No, in the strict sense. GPT and Claude are closed models whose weights only OpenAI and Anthropic hold: they alone can run them, and the processing therefore falls under US law even on a European server. Genuinely European setups rely on models (open-weight or not) operated by a European actor, or on a vendor that produces its own models.
### How do you check for yourself whether an AI vendor is actually French?
Open three pages, it takes about ten minutes. The legal notice or the `/legal` page gives the contracting entity and lets you spot a foreign parent. The privacy policy or the DPA annex names the host and the subprocessors. The SIREN number can be cross-checked for free on `annuaire-entreprises.data.gouv.fr`. If any of those three pieces of information is missing, that is already a result.
---
## In short
Of fourteen vendors, thirteen are indeed European companies. Good news, but it is also the least discriminating point on the market. Everything turns on two engineering decisions.
**Hosting**, where only four vendors rely by default on a provider under European law, even though the choice costs the end user nothing. And **control of inference**, where almost nobody lets an administrator impose a European setup on the whole organisation, without a written request or a manual opt-out.
The word “sovereign” is defined nowhere and protected by nothing.
Ask for the names of the hosts and AI providers so you know exactly where your data goes.
If you are preparing an enterprise AI project and you want to put these criteria against your own context: **[book a demo](https://www.askthisguy.com/en/demo/)**.
---
# AI Inference: the 7 ways to run your models in the enterprise
URL: https://www.askthisguy.com/en/blog/enterprise-ai-inference/
Language: en
Section: Blog
"We buy GPUs and host everything ourselves." "No, we plug in an API and move on."
That argument is a classic clash of philosophies over enterprise AI inference. It shows up early in an AI project, usually when the budget gets costed. On one side, the people who want AI in-house: buy the cards, install the models, nothing leaves the company. On the other, the people who want to consume a service: an API key or a subscription, pay as you go, no hardware to manage.
Both camps have good arguments. The trouble is that they are debating two options out of seven.
What they are arguing about has a name: **inference**.
## What inference actually is
Inference is the moment an AI model answers a question. Not its training, which already happened and cost someone else millions: just the act of submitting a request and getting text back.
Inference recurs every day. It scales with your usage, for as long as your service runs. It is what determines the speed, the bill and the confidentiality level of your project.
A **token** is a small unit of text, a word or a fragment of a word. Providers bill per million tokens, counting input and output separately.
**Input tokens** are everything you send to the model: the user's question, but also the instructions, the conversation history, the document excerpts and the description of the available tools. **Output tokens** are what the model generates in response. At equal volume, output usually costs three to five times more, because every token produced requires a full pass through the model, whereas input is processed in one block.
The ratio between the two depends heavily on your use case, and it is what shapes your bill. A general-purpose assistant sends little and receives a lot: short question, developed answer. An [agentic AI](https://www.askthisguy.com/en/blog/enterprise-ai-agents/) does the opposite. At each step, the agent sends back all the accumulated context, the results of its tool calls and the history of its attempts, to produce maybe three lines of decision. Input balloons on every turn of the loop. That is why providers offer reduced rates on the portion of context that is reused from one call to the next.
That leaves speed, measured in **tokens per second**. For simple chat or completion, 100 tokens/s gives an answer that feels fluid. For agentic work, where the model chains several calls before showing anything, aim closer to 500 tokens/s. We detail these thresholds in our article on [local LLMs](https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/).
## If you remember only one thing
The world is not binary. Between "buy everything" and "consume everything", the market offers a range of valid solutions, all with good reasons to exist, and most companies running in production mix several of them. The right choice depends on your context, not on a matter of principle.
Two reasonable ways to approach the subject. The first: don't overthink it, take a solution from a provider, and focus your vigilance on one thing, its billing metric. An offer billed per message, per user or per flat rate stays predictable. An offer billed per token, much less so.
The second: spend a few days on it, because the cost gap between the seven approaches is measured in orders of magnitude, not percentages.
Either way, what you are trying to avoid is called *bill shock*, and it happens regularly. In June 2025, [Cursor](https://cursor.com/blog/june-2025-pricing) moved its individual subscriptions to usage-based billing without its users understanding that the advertised "unlimited" only covered a single model; the company published its apology on July 4 and refunded three weeks of overages. On the [Gemini CLI](https://github.com/google-gemini/gemini-cli/discussions/4472) repository, developers convinced they were staying within a 1,000-requests-per-day limit discovered bills of 2,000, 6,400, sometimes 10,000 dollars: their API key billed per token, and the model's reasoning loops consumed hundreds of millions of them.
Same root cause in both cases. The user was thinking in requests, the provider was billing in tokens.
## Four things are decided at the inference layer
### Your users compare with ChatGPT
They arrive with a reference in mind, and that reference is called ChatGPT, Gemini or Mistral. They have grown used to text that streams instantly. If your internal assistant takes fifteen seconds to start its answer, nobody will say the infrastructure is undersized. They will say your tool doesn't work, and they will go back to the one they used before.
Plenty of B2B solutions run at that pace today. The product does what it promises, the demo goes well, and nobody opens it a second time.
That latency plays out almost entirely at the inference level, and it is by far the leading reason for abandonment we see on internal assistants. A technically sound project dies just fine from fifteen seconds too many.
### Nobody holds 99.9% on their own
The large AI providers run around 99 to 99.5% availability, meaning several cumulative days of downtime per year. Your users, meanwhile, are used to four nines on their office tools. The gap shows.
We published the real figures by provider in [Enterprise AI SLA](https://www.askthisguy.com/en/blog/enterprise-ai-sla/). The most common design flaw we come across has not changed in two years: a single provider, no fallback.
### You are sending your documents to someone
Running inference means passing a third party your user's question and the document excerpts used to answer it. Contracts, internal notes, customer data. Better to know to whom, under which law, with what retention policy and what no-training commitment.
There is no universal right answer here, only a slider to position. We documented ours on the [sovereign AI](https://www.askthisguy.com/en/sovereign-ai/) page.
### The model at the top of the leaderboard costs a lot for nothing
It is almost never the one you need. To classify a ticket, extract a field or rephrase an answer from supplied documents, a smaller, faster model does the job.
Above all, the price gap has nothing to do with the capability gap. Here are four market offers, placed by their average cost per million tokens and their intelligence index:

**GPT-5.6 Sol costs €7.35 per MTok for an "intelligence" index of 56. DeepSeek V4 Flash served by Umans costs €0.11 for an index of 50.** Six points of difference, a factor of 69 on the bill.
Now look at GPT-5.6 Luna, at the bottom of the cloud: nearly three times the price of the Umans offer, for an index four points lower. Paying more does not even guarantee getting better. The leaderboard tells you what a model can do, never what it will cost you.
One last point, and it is the one we repeat most often: a benchmark ranks models on generic tasks, never on yours. An intelligence index says nothing about how a model behaves on your domain jargon, your documents, your language or the output format you expect. Take two days to run three or four candidates on a representative sample of your real cases, and compare what comes out. That is the only ranking that matters for you, and it regularly upends the official order.
*Intelligence index: [Artificial Analysis](https://artificialanalysis.ai/), August 2026 readings. Average cost computed on a mix of 40% cached input, 40% fresh input and 20% output, at €1 = $1.15. The max and high labels refer to the model's reasoning effort level.*
## The seven approaches
### 1. Buy your GPUs and run them yourself
You buy the cards, you install them, you deploy the models, you maintain the whole thing. Maximum control: your data never leaves, you choose everything, and nobody changes your terms overnight.
Maximum CAPEX too. For a genuinely fast and capable model, expect six figures, plus the skills to hire to operate the machine. Your AI infrastructure becomes a project in its own right, with its own budget and team. We ran the numbers in detail in [On-premises RAG: what can you do with €60k?](https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/).
Reserve this for absolute regulatory constraints, massive and stable volumes, and companies that already have an infrastructure team. Or for those planning to resell their capacity when it is idle, which we come back to in approach 4.
### 2. Rent dedicated GPUs from a cloud provider
Same architecture, same deployment work, but the hardware is no longer yours. The CAPEX becomes predictable OPEX, electricity and cooling included, and hardware failures are your provider's problem.
Be wary of the hourly headline price. A service available around the clock runs 730 hours a month, so that hourly price is really a monthly rent. An H100 at [Scaleway](https://www.scaleway.com/fr/tarifs/gpu/) is €2.73 an hour, which goes down well in a meeting, and costs **nearly €2,000 a month, €24,000 a year, for a single card**. At [Verda](https://verda.com/pricing), a Finnish operator whose data centers are in Finland and Iceland, the H100 SXM5 is $3.25 an hour, with an 8% discount over one year and 25% over two.
The next reflex is to compare with buying. An H100 PCIe [trades](https://www.cloudzero.com/blog/h100-gpu-cost/) between $25,000 and $33,000 on the market, an H100 SXM5 between $35,000 and $40,000. Renting a card around the clock therefore costs its purchase price in twelve to seventeen months depending on the model and provider. And one card is rarely enough: a server with eight H100s, sized to serve a large model properly, runs around $19,000 a month, or $228,000 a year, while the equivalent machine costs upwards of $350,000 to buy. Eighteen months to break even.
On paper, that is excellent. Except the comparison pits a card against a service. The purchase price includes neither the data center, nor the electricity, nor the cooling, nor the network, nor the teams that operate the whole thing. And the asset depreciates fast: a used H100 resells for 60 to 70% of new while the B200s and B300s arrive and pull rental prices down. You are amortizing over three years a piece of hardware whose equivalent rent will have dropped before the period is out.
At that scale, renting does not make the six figures of approach 1 disappear: it turns them into an annual rent.
{/* PARTNER SLOT: Verda. Factual mention in place (public pricing grid + EU/EEA location). Slot ready for an enriched partner quote after agreement. */}
### 3. Spin up GPUs only when you need them
You turn the machine on, or rather a container in most cases, you do the work, you turn it off. Some providers bill by used time slice, ten minutes at Verda for example, which means a job that finishes in 45 minutes costs 50. Many also offer *spot* rates, on available capacity, at half price.
Two hours of processing per night make around sixty hours a month, roughly $98 on spot, where the same card held continuously costs $2,370. Factor of twenty-four. It is the best deal on the market for background processing: document reindexing, embedding computation, bulk classification, extraction over a stock of PDFs.
For a service open during the day, forget it. Starting a machine and loading a model takes minutes, and a spot instance can be reclaimed from you mid-run. Nobody waits five minutes for their assistant to wake up.
{/* PARTNER SLOT: Verda (spot / on-demand offer). Slot ready after agreement. */}
### 4. Rent surplus capacity from those who have too much
The people who chose approach 1 have GPUs sitting idle part of the time. A market has grown to resell those off-peak hours, often well below the prices of the large providers, since the hardware is already paid off anyway.
This category covers two very different realities. At one end, players who have turned it into an enterprise service: capacity reserved by contract, an availability commitment, an identified operator, hardware hosted in known data centers. You access it as you would with any cloud provider, with a bill and a point of contact, but at a rate pulled down by the fact that the cards already existed.
{/* PARTNER SLOT: Hexa Compute. Main slot for this section, to insert here after agreement: it is the "enterprise service" end of the spectrum. */}
At the other end, the peer-to-peer market. [Darkbloom](https://www.darkbloom.dev/), out of Eigen Labs, runs inference on idle Apple Silicon Macs, with encryption designed so that the machine's owner cannot read what passes through it. The project is still experimental and we would not put a critical service on it today. The idea holds up: tens of millions of recent Macs sit dormant much of the day with plenty of memory available.
In both cases, look at who operates the machine, what they can see, and what availability commitment they sign. That is what separates a good deal from a gamble.
### 5. Go through an inference provider
No more machines to manage. You call an API, you pay per token, and someone else keeps GPUs warm around the clock for you.
Two families coexist. The inference pure players serve [open weights](https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/) models and compete on speed and price: Cerebras, Groq, DeepInfra, Nebius. The consumer players, OpenAI, Anthropic, Google, Mistral, serve their own models.
The difference shows on the bill. At comparable quality on many tasks, the former are noticeably cheaper, because the latter also bill for their reputation and the exclusivity of their models. Since the same open model runs at a dozen providers, you can change your mind without touching your prompts.
Choose a player that publishes a real service commitment, not just a status page. And plan a fallback from day one.
{/* PARTNER SLOT: Umans. Slot ready, to insert after agreement, in the "pure players" family. */}
### 6. Put a gateway in front of several providers
You plug several of them in behind a single layer, which measures their health, arbitrates on speed and price, and switches automatically when one falls behind. This is what is called a multi-provider gateway, or *AI gateway*.
No provider reaches 99.9% on its own. Stacked behind a gateway that tests and switches, you get there. We devoted a whole article to the subject, market figures and products included: [Enterprise AI SLA](https://www.askthisguy.com/en/blog/enterprise-ai-sla/).
{/* PARTNER SLOT: Eden AI. To insert after discussion on the scope of reciprocity. Eden AI is already cited in blog/enterprise-ai-sla. */}
### 7. Let your platform handle it
You buy an enterprise AI product and inference becomes someone else's problem. No GPUs to run, no gateway to build, and keeping up with the models no longer concerns you.
In exchange, you inherit your provider's choices. Hence the question to ask before signing: **can they describe their inference chain?** Which providers, in which jurisdiction, with what fallback, under what no-training commitment. Anyone who stays vague about that part is asking you to trust them on the most sensitive link.
## The seven AI inference approaches compared
*Reading: green is favorable, red unfavorable. The ± sign marks a criterion that depends on the provider you pick.*
| # | Approach | Cost model | Operational lightness | Reliability | Sovereignty | Time to start | When it's the right choice |
| --- | --- | --- | --- | --- | --- | --- | --- |
| 1 | Buy the GPUs | High CAPEX | −−− | ++ | +++ | Months | Absolute regulatory constraint, massive volume |
| 2 | Rent dedicated GPU | High, predictable OPEX | −− | ++ | ++ | Days | Stable volume, location requirement |
| 3 | On-demand GPU | Usage-based OPEX | − | −− | ++ | Hours | Background processing, batch, occasional peaks |
| 4 | Surplus capacity | Very low OPEX | − | − | ± | Hours | Tight budget, verified operator |
| 5 | Inference provider | Per token | ++ | − | ± | Minutes | The majority of projects |
| 6 | Multi-provider gateway | Per token, plus the layer | ++ | +++ | ± | Days | As soon as a real service level is expected |
| 7 | Turnkey platform | Subscription | +++ | +++ | ± | Minutes | You are buying a business outcome |
## In practice, a company often combines several solutions
A single approach can be perfectly enough, and often is when the scope is clear and usage is homogeneous. But as soon as use cases diversify, companies regularly end up with two or three different regimes. Either way, start from your hardest constraint and let the rest organize itself around it.
A regulatory constraint almost never applies to your entire scope. Isolate the genuinely sensitive use case on dedicated infrastructure, leave the rest on shared. It is often that split that unlocks a budget, because it brings the strong requirement back down to the part of the project it really concerns.
When latency is what dictates, it dictates only the interactive part. A company we work with runs its nightly document reindexing on on-demand GPU, for a few dozen euros a month, and serves its assistant during the day through a fast inference provider. Two cost regimes, one project.
And if it is the budget, start with approach 5 or 7, without hesitation. Six months of real usage will tell you whether bringing it in-house makes any sense. It is almost always more expensive than expected, and nobody realizes it until they have the figures in front of them.
To set the orders of magnitude, here is the same H100 seen from three angles:
| Access to an H100 | Cost | Basis |
| --- | --- | --- |
| Purchase | ~$30,000, i.e. ~€26,000, the card alone | Market price PCIe and SXM5 |
| Dedicated rental, 24/7 | ~€2,000 a month | Scaleway, €2.73/h × 730 h |
| On demand, 2 h per night | ~$98 a month | Verda spot, $1.63/h × 60 h |
The hardware is identical in all three cases, only the usage regime changes.
How long do you have to rent before you have spent the price of the card? Continuously, at €2,000 a month, it takes you **thirteen months** to reach the €26,000 purchase price. On the on-demand regime, at €85 a month, it takes you **more than twenty-five years**.
That is where the decision is made, and nowhere else. Buying only becomes worthwhile if you know the machine will genuinely run around the clock, for several years, on volumes you have already measured.
## At Ask This Guy
Today, our clients are in case 7. They operate no GPUs, build no gateway, and inference does not appear in their budget.
That only holds because we ourselves mix approaches 2, 3 and 5. We build our own GPU infrastructure at Verda, in Finland and Iceland, where we deploy and operate certain models, and in parallel we consume selected inference providers behind our [AI provider gateway](https://www.askthisguy.com/en/doc/infrastructure-and-security/ai-providers/). You then position the slider, EU-only policy or worldwide, changeable at any time from the console. Everything is public in our [approach to sovereign AI](https://www.askthisguy.com/en/doc/infrastructure-and-security/sovereign-ai/).
If we are writing this article, it is because the trade-offs described here, we have paid for them.
### Bring Your Own AI: plug in your own inference
Case 7 should not be a dead end. If you already have GPUs, a contract with an inference provider or your own gateway, you should be able to plug them in rather than scrap them.
That is what our **Bring Your Own AI** mode enables: connecting your own models, providers or inference endpoints to the platform. It is available **today on request**, and will soon be offered as standard.
Concretely, the other six approaches stay open. GPUs bought last year plug in. A rate negotiated with an inference provider carries over. And if you prefer to start turnkey and bring it in-house in eighteen months, once your volumes are genuinely known, you will not have to switch tools along the way.
## Frequently asked questions about AI inference
### What is inference in AI?
Inference is the phase where an already-trained AI model processes a request and produces a response. It contrasts with training, which is the model's learning phase. For a company, training is a rare and often nonexistent cost, whereas inference is a recurring cost proportional to the service's real usage.
### How much does LLM inference cost in the enterprise?
The cost of LLM inference depends entirely on the approach chosen. With dedicated GPU rental, an H100 held continuously comes to about €2,000 to €2,400 a month, or nearly €24,000 a year for a single card, and a server with eight cards exceeds €200,000 a year. Going through an inference provider billed per token, an internal assistant for a few hundred users most often runs into the hundreds of euros a month. The gap between the two models justifies measuring your real volumes before bringing it in-house.
### Do you need to buy GPUs to do AI in the enterprise?
In the vast majority of cases, no. Buying GPUs is justified when a regulatory constraint forbids any data from leaving, when the volume is massive and stable, and when an infrastructure team already exists to operate the hardware. Outside those conditions, renting or using an inference provider costs less and is set up in minutes rather than months.
### What is AI infrastructure?
AI infrastructure covers everything needed to run artificial intelligence models: the GPUs, the servers that host them, the network, the storage, and the software layer that serves the models. In the enterprise, the question is not only which components to choose, but who operates them: you, a cloud provider, an inference provider, or your platform's vendor.
### What is the difference between an inference provider and an API gateway?
An inference provider runs the models itself on its own GPUs and bills you for the tokens consumed. An API gateway, or multi-provider gateway, runs no model: it sits in front of several providers, measures their availability and speed, and switches automatically from one to another. The two are generally used together, the gateway serving to reach a service level no single provider achieves on its own.
---
## Conclusion
Your AI project will force you to settle the question of inference, and probably as soon as the budget is costed. You can build your own AI infrastructure, delegate everything, or assemble something in between.
The projects that hold up in production are not the ones that picked the right camp. They are the ones that knew there were seven.
Inference is paid every month, for the entire life of the service.
Start from your hardest constraint, the rest organizes itself around it.
If you are preparing an AI project and want to test your use case against these trade-offs: **[book a demo](https://www.askthisguy.com/en/demo/)**.
---
# Enterprise AI agents: use cases and real costs
URL: https://www.askthisguy.com/en/blog/enterprise-ai-agents/
Language: en
Section: Blog
For the past eighteen months, everyone has been talking to you about **AI agents**. The demos are impressive: you ask a question, the AI checks three tools, cross-references, acts, and returns a clean result. Then you try to reproduce that on your own processes, and the ground gives way.
It is not that the technology does not work. It is that the gap between a demo and an **enterprise AI agent** running every day comes down to things nobody discusses at the kick-off: the agent's exact mission, the edge cases, the share of the work you must never hand to a model, how you verify the result, and who gets called when the agent gets it wrong on a Friday at 6 p.m.
This article lays out what you need in order to decide: what an agent is, the method that separates a demo from a production system, what we actually put into service for our clients, and what it costs.
**In one sentence.** An AI agent is a language model placed in a loop, equipped with tools and an objective, which decides for itself the sequence of actions to take, observes the result of each one, and repeats until it reaches its goal.
## What people mean by an AI agent
The definition commonly accepted across the industry rests on four building blocks. An agent is:
1. **A language model**, which understands the request and reasons about it.
2. **Tools**, meaning functions the model can trigger: `find_customer`, `read_invoice`, `create_ticket`, `send_report`. Each tool is described to the model, which picks which one to call and with which parameters.
3. **A loop.** On each turn, the agent looks at where it stands, decides on the next action, runs it, observes the result, and starts again. That iteration is what lets it correct itself.
4. **A scope**: what it is allowed to do, on which data, with which limits, and possibly a budget in time or tokens.
```mermaid
flowchart LR
O[Objective] --> M[Modelpicks the next action] M --> T[Tools
read, compute, write, send] T --> R[Observed result] R --> V{Objective reached?} V -- No --> M V -- Yes --> F[Final answer or action] P[Scope
permissions, limits, budget] --- M ```
The diagram shows an agent's loop: starting from an objective, the model picks an action, runs it through a tool, observes the result, and starts over until the objective is reached. The scope, attached to the model, constantly bounds what the agent is allowed to do.
So it is not a new kind of model. It is a model placed at the centre of a software system that frames it. The **MCP** protocol (Model Context Protocol) has greatly simplified the tools layer: instead of rebuilding every integration for every agent, you expose a server once and any agent can consume it. We cover that mechanism in our article on [MCP and tool integration](https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/). > An agent is no smarter than the model alone. It is simply allowed to act several times, with tools. All its value comes from what you plug in at the far end. ## An agent is a chatbot equipped with tools Chatbots and agents are often presented as opposites. An agent is a chatbot you gave tools to. The rest is a matter of degree: the nature of the tools, and what they are allowed to do. At Ask This Guy, **everything is an agent**. The same foundation carries the assistant answering an HR question and the one updating a customer record in your SaaS. | Level | What the agent can do | Typical tools | | --- | --- | --- | | Answer | General questions, rewriting, drafting | None | | Answer from your data | Procedures, contracts, project history | Document search ([RAG](https://www.askthisguy.com/en/blog/rag-tutorial/)), read-only SQL | | Query your systems | Real status of a case, a stock level, a ticket | Read-only business APIs, MCP servers | | Act | Create, update, send, close | Write-enabled business APIs, email sending | | Orchestrate | Chain several steps towards an objective | A combination of the above, human approval | That table is a gradation, not a product taxonomy. An [internal assistant](https://www.askthisguy.com/en/blog/internal-company-chatbot/) often starts at the second level, then works its way down over the months as trust builds and tools are added. And tools need not be generic. They can be highly specialised, and contain intelligence of their own: an extractor tuned to your contract documents, a consistency checker applying your business rules, a report generator producing exactly the format your clients expect. We build these regularly, and the code for those [tailored tools](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools) belongs to you. What really changes between the top and the bottom of the table is the nature of the risk. An agent that gets an answer wrong produces an imprecise sentence the user can ignore. An agent that gets an action wrong creates a line in your ERP or sends an email to a customer. **That shift in the nature of the risk should govern the whole design, not the label on the product.** ## AI is never deterministic, and that is where design starts Here is the most important idea in this article, and the one you hear least. A language model is **probabilistic**. The same input twice can produce two different outputs. An algorithm is deterministic: the same input always gives the same output, and you can prove it. On any given task, conventional software will always be more reliable than a model, especially when the task is simple. The consequence is direct: **any task an algorithm can handle should be handled by the algorithm.** Not by the model. - Checking that an email address is valid, or that a postal address exists: that is a regex and a lookup against an address database, not a question for an AI. - Computing a total, applying a rate schedule, checking that the line items match the invoice footer: code. - Querying a database: rather than a model writing free-form SQL, use a parameterised tool with bounded queries, explicit permissions, and a set of parameters the model merely fills in. You gain in reliability, security and cost. The model keeps what only it can do: understanding language, reading unstructured documents, choosing between paths based on context, and writing. This discipline is not cosmetic, it is arithmetic. Picture an agent chaining ten steps. If each step succeeds 95 % of the time, the probability that all ten succeed is 0.9510, roughly **60 %**. The calculation is deliberately simplistic, but the point matters: every step handed to the model multiplies the risk, whereas a step handed to code leaves it untouched. We develop that logic in our article on [minimal AI automation](https://www.askthisguy.com/en/blog/use-minimal-ai-automation/). ## The real work: defining the agent's mission This is where success or failure is decided, long before the choice of model. A successful agent is almost always an agent whose mission was written properly. **An objective, not an intention.** "Process supplier invoices" is not an objective. "For every invoice received in the accounting inbox, extract the ten listed fields, check the match against the purchase order, create the ledger entry if everything reconciles, and otherwise place it in the human queue" is one. **Edge cases, written down explicitly.** What does the agent do if the document is unreadable, if the supplier is unknown, if the invoice is a credit note, if the amount exceeds a threshold, if two purchase orders match? These questions have no sensible default answer: they have your answer. An agent that was never asked them will invent a plausible average, which is worse than a clean error. **Real examples, not clean ones.** We systematically ask for around twenty real cases, taken as they are, including the ugly ones: the crooked scan, the contract with a handwritten amendment, the badly filled customer record. That is what the agent gets designed against, not the ideal sample. **A verifiable expected output.** For each case, someone must be able to say whether the output is right or wrong. If nobody can settle that, you will be able neither to evaluate the agent nor to let it run on its own. Understanding the process and the expected output properly is the key. The rest is execution. ## Evaluate, verify, monitor An agent is not delivered, it is put under control. Three levels, to plan for from the design stage. **Checks inside the loop.** At every sensitive step, a deterministic control: does the extracted field have the right format, does the reference actually exist in the database, does the total reconcile. When a check fails, the agent retries or hands over. That is what lifts the 60 % above back to a usable level. **Evaluation before every release.** A reference set of cases with expected results, replayed on every change of prompt, tool or model. That is what lets you evolve the agent without going back to manual testing, and catch a regression before your users do. **Production monitoring.** Straight-through processing rate, human fallback rate, cost per run, latency, and cases the agent itself flags as uncertain. An agent nobody monitors does not fail loudly: it quietly becomes less accurate, while your file formats change and models shift under your feet. Add a human in the loop at the right place. Not everywhere, or the point disappears: on irreversible actions, and on cases the agent flags as doubtful. ## Six agents we put into production Here is what we actually deliver, and what keeps running. ### Acting inside a SaaS from the conversation A business tool is equipped with an agent that can modify it. The user writes "create this customer with these details" or "move the case to completed, I have just finished the intervention", and the agent performs the action in the application, with the permissions of the person speaking. You remove ten clicks and three screens, and you capture the information the moment it exists rather than three days later. ### Processing specialised documents Business documents arrive: purchase orders, administrative forms, contracts, technical files, reports, regulatory paperwork. The agent extracts the relevant information, applies your control rules, enriches it against your reference data, feeds the database, and flags anything outside the rules. This is the most profitable use case, because the volume is there and the rule is explicit. A customer purchase order or a government form is a perfect fit: the layout varies from one issuer to the next, but the expected fields are precisely defined. ### Generating tailored reports from input files Your clients or your teams drop off files. The agent analyses them, applies your calculation rules and your reading grid, produces a report in the expected format, and emails it to the right recipients. What used to take half a day becomes a twenty-minute review. ### Qualifying a lead and alerting sales It starts with an ordinary conversation on your [website chatbot](https://www.askthisguy.com/en/solutions/website-chatbot/). A visitor asks about an offer, the agent answers from your content, and naturally extends the exchange: context, company size, timeline. Once the signals of a genuine lead line up, it does not just save the record: it immediately emails the sales team with the conversation verbatim, the qualification and the recommended next step, so the callback happens within the hour rather than two days later. We cover this mechanism in our article on [qualified leads from a website chatbot](https://www.askthisguy.com/en/blog/qualified-leads-website-chatbot/). The same pattern applies to a support ticket or an internal request: the agent cross-references the CRM or the knowledge base, classifies, prioritises, and routes to the right person with a summary already written. ### Reconciliation and monitoring Comparing two reference systems that should agree, spotting the gaps, producing the list of anomalies with a diagnosis. Nobody enjoys doing that by hand, and nobody does it as regularly as they should. ### Anticipating, by combining machine learning and monitoring Not every agent is reactive. Some exist to forecast, and that is where the complementarity between software and AI really pays off. Take stock and flow management, in retail or manufacturing. The forecast itself belongs to **classic machine learning**: a statistical model trained on your sales history, your seasonality and your supplier lead times predicts demand far better than a language model, and reproducibly so. The agent adds two things the statistical model cannot do: it factors in unstructured context (a watch on your suppliers, an announced strike, adverse weather, a regulatory update, a competitor launch) and it turns the forecast into a readable action, flagging the references at risk of stockout or overstock with the reasoning attached. This is exactly the split argued above: the deterministic side computes, the model interprets and writes. ## The use cases that fail, and why Let us be blunt: some projects should not start. - **The process is not written down.** If nobody can describe it in ten lines, the agent will not invent it. - **The result is not verifiable.** Without a success criterion, no evaluation, and therefore no possible autonomy. - **Low volume and every case is different.** Twenty files a month, all atypical: the design cost will never be recovered. - **The action is irreversible and unsupervised.** Payments, customer emails, data deletion. Technically possible, operationally unwise until the agent has proven itself. ## What does an enterprise AI agent cost? The **cost of an AI agent** breaks down into three items. ### 1. Design and development This is the dominant item. It covers formalising the mission, building the tools, the connectors into your systems, permission handling, testing on real cases, the evaluation set, and going live. At Ask This Guy, a **production-ready** agent typically lands **between €2,000 and €5,000** in development. Not a demo POC: an agent wired into your systems, with its permissions, its checks, its logging and its monitoring, processing your real cases from day one. The price depends heavily on complexity, but it stays in that range because we never start from scratch: the platform already provides connectors, document ingestion, permission handling, an MCP tool catalogue, logging, monitoring, and the LLMOps foundation. The specific work goes into your business rule, not the plumbing. Two useful comparisons: - **Rebuilding everything from scratch** runs into tens of thousands of euros, most of it spent on things that carry no business value for you. - **Having your automation built on a mainstream third-party platform** (the no-code orchestration tools) costs less upfront but creates a real durability problem. Those platforms move very fast. The day one of them changes how it works, your automation stops and you pay the provider again. And by construction, a provider who does not control the platform they build on cannot commit to an SLA. ### 2. Runtime cost This is the token cost, and it follows no general rule: everything depends on what the agent does. An agent processing 500 files a month, at roughly 30,000 tokens per file including tool round-trips, costs a few tens of euros a month on a mid-range model. Conversely, long-context analysis, heavy reasoning or high volume change the order of magnitude entirely, and a poorly designed agent looping without guardrails can multiply the bill by ten. So it is an item to estimate case by case, never to assume. With us it is **fixed and known upfront**: you know what the agent costs before it goes live, and a consumption drift is our problem, not yours. ### 3. Maintenance and industrialisation The item everyone forgets, and the one that kills the most projects. Your tools change, your rules change, a supplier alters a file format, a model is deprecated and its replacement does not behave quite the same. So you need LLMOps, monitoring, a replayable evaluation set, and a watch on model obsolescence. We build those into our offer rather than billing them case by case, because an agent delivered without them is not an industrialised agent: it is a demo with an expiry date. It is also what makes a service commitment sustainable over time, a subject we cover in our article on [SLAs for enterprise AI](https://www.askthisguy.com/en/blog/enterprise-ai-sla/). ### ROI, calculated every time We do not start a project without doing the maths: monthly time saved against total cost of ownership over a year. **Aim for a return on investment in under six months, ideally under three.** With development in the €2,000 to €5,000 range and automations that routinely save the team around twenty hours a month, that is usually very comfortably achievable. If it is not achievable on your case, better to know before you start than six months in. ## Committing to the outcome One last point, which is as much a criterion for picking a provider as it is a position of ours. We commit to the outcome, at a fixed price. Not blindly: first we look at your real examples, we understand your process and your expected output, and only then do we commit. That is the natural order of things, and it is also the only honest way to do it. **Favour a company that works the same way.** A provider selling an agent on a time-and-materials basis, without having seen your real cases and without committing to a measurable result, is transferring the entire risk to you. From the outside, a good agent and a bad one look very similar in a demo. They look nothing alike three months later. ## The Ask This Guy approach We build agents on a platform that already carries the common building blocks, which lets us spend the budget on your business instead. Three choices guide our practice: - **Start small and measurable.** One workflow, a quantified gain, a fast go-live. Ambition comes after proof. - **Stay sovereign.** European hosting, the option to restrict processing to European-law providers, no training on your data. The subject is covered on our [sovereign AI](https://www.askthisguy.com/en/sovereign-ai/) page. - **Let you leave.** The work built for you, your configurations and your connectors belong to you. Reversibility is a condition, not an option. To see what this looks like in practice, our [agentic AI and automation](https://www.askthisguy.com/en/solutions/agentic-automation/) page details the typical workflows and their costs. ## Frequently asked questions about enterprise AI agents ### What is an enterprise AI agent? An enterprise AI agent is a language model placed in a loop, equipped with tools and a business objective. It chooses the sequence of actions itself, performs those actions in your systems through its tools, observes the result, and repeats until it reaches its goal or establishes that it cannot. It is not a new kind of model, it is a model framed by software. ### What is the difference between an AI agent and a chatbot? It is a difference of equipment, not of nature: an agent is a chatbot that was given tools. A chatbot without tools can only answer. As soon as you plug in document search, a database or a business API, it can look things up and then act. The real boundary is not chatbot versus agent but read versus write: the moment the AI changes something in your systems, the requirements for reliability, permissions and traceability change scale. ### Which tasks should never be handed to the model inside an agent? Every task an algorithm can handle. A model is probabilistic, an algorithm is deterministic and therefore more reliable. Validating an email format, checking that an address exists, computing a total, applying a rate schedule, running a database query: all of that should go through code or a parameterised tool. The model keeps language understanding, unstructured document reading, contextual judgement and writing. ### How much does an AI agent cost a company? Development of a production-ready agent typically lands between €2,000 and €5,000 when building on an existing platform, and well beyond that when starting from scratch. On top of that come runtime token costs, which vary widely with the task and must be estimated case by case, and maintenance: LLMOps, monitoring, a replayable evaluation set, and handling model obsolescence. At Ask This Guy the whole thing is fixed and known before go-live. ### How long does it take for an AI agent to pay for itself? The target to set before starting is a return on investment in under six months, and it is frequently reached in under three. The calculation is simple: monthly hours saved multiplied by the loaded hourly cost, compared with development and maintenance costs over a year. If the maths does not work, the project should not start. ### Can an AI agent access our sensitive data? It only accesses what you give it. Best practice is to have the agent inherit the permissions of the user who triggers it, or to give it a service account with an explicitly limited scope, and to log every access. An agent with blanket access to your information system is a risk, not a feature. ### How long does it take to get an agent into production? A few days for a first simple workflow on an existing platform. A few weeks if connectors need building, if business rules need formalising, or if the process involves irreversible actions requiring human approval. --- ## What to take away An AI agent is not superior intelligence: it is a chatbot equipped with tools, allowed to act within a scope you define. Its value comes not from the model but from the quality of its mission, its tools and its checks. Successful projects share the same profile: a written mission with its edge cases, real examples from the design stage, everything an algorithm can do handed to an algorithm, a replayable evaluation set, production monitoring, and an ROI calculated before starting. Have a manual process in mind? [Book a demo](https://www.askthisguy.com/en/demo/): in 30 minutes we will tell you whether it can be automated, at what cost, and with what expected gain. --- # Internal company chatbot: how to scope the project right URL: https://www.askthisguy.com/en/blog/internal-company-chatbot/ Language: en Section: Blog In most companies, the information exists. It is written down, somewhere. The problem is not that it is missing, it is that **nobody knows where it is**, or that the only person who knows is on leave. So employees do what they have always done: they ask a colleague. A question that would have taken thirty seconds with an effective search engine ties up two people for ten minutes, and the answer they get is not necessarily the current version. That is the problem an **internal company chatbot** sets out to solve. But you have to be clear about what you are building: half the projects carrying that name actually produce something else. **In one sentence.** An internal chatbot is a conversational assistant reserved for employees, connected to the company's document sources, that answers internal questions while citing the documents its answer comes from. ## Internal chatbot and website chatbot: same tool, two different projects This is the first confusion to clear up, because it drives everything else: budget, corpus, success criteria. A **website chatbot** talks to your visitors. It answers public questions, qualifies prospects, routes people to a salesperson. Its corpus is small and controlled, its answers are validated in advance, and the main risk is commercial: a bad answer loses a lead. An **internal chatbot** talks to your employees. It answers from your procedures, contracts, meeting notes, technical documentation and HR policies. Its corpus is large, heterogeneous, badly organised, and above all **subject to differentiated access rights**. The main risk is confidentiality: a bad answer exposes a document to someone who should not have seen it. | | Website chatbot | Internal chatbot | | --- | --- | --- | | Audience | Visitors, prospects | Employees | | Corpus | Small, public, curated | Large, private, heterogeneous | | Access rights | Uniform | Differentiated per person | | Objective | Convert, route | Find, decide, save time | | Main risk | Lost revenue | Internal information leak | | Success metric | Qualified leads | Search time avoided | The technical architecture, on the other hand, can perfectly well be shared: same engine, same RAG foundation, same interface. We even recommend using the same tool for both, to avoid maintaining and administering two platforms. What must differ is **the document corpus, the instructions given to the model and the monitoring you put in place**. A vendor proposing the same corpus and the same instructions for both use cases, however, has misunderstood the project. We cover the first case in our article on [website chatbots and lead generation](https://www.askthisguy.com/en/blog/qualified-leads-website-chatbot/). ## What makes an internal chatbot work: RAG A general-purpose language model knows the world, not your company. Asked about your expense policy, it will produce a plausible and wrong answer, which is the worst possible outcome. The technical answer is called **RAG** (Retrieval Augmented Generation). On every question, the system first searches for the relevant passages in your own sources, then hands them to the model, which writes its answer from those excerpts and cites where they came from. The model "knows" nothing about your company: it reads, on demand, whatever you give it to read. 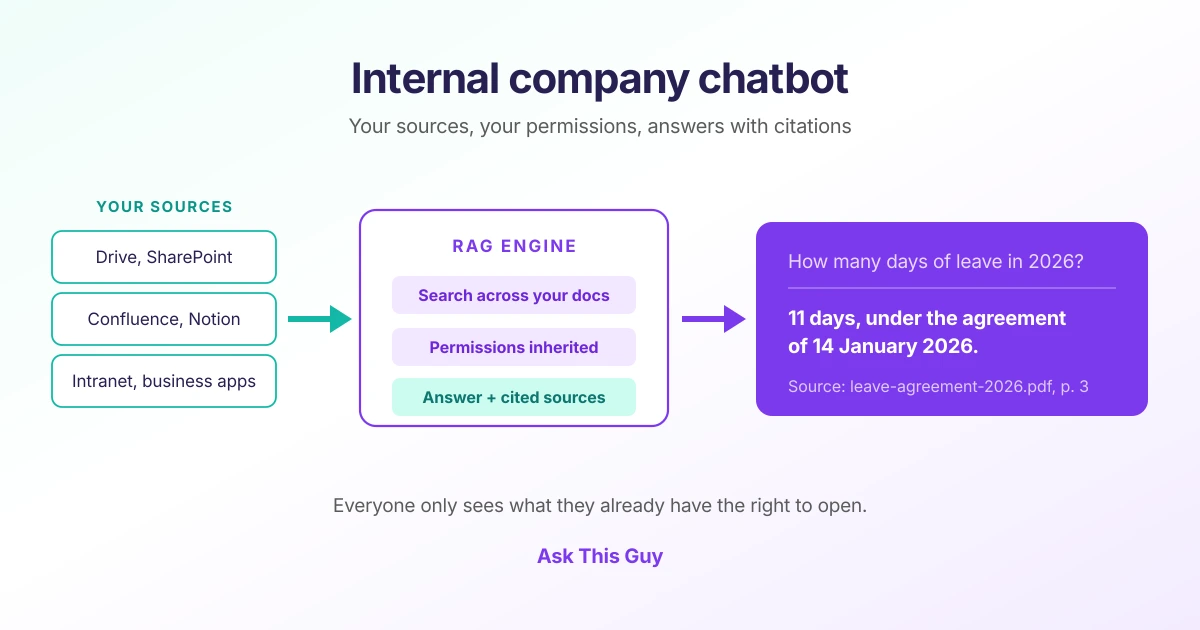 We detail the mechanism in our [RAG guide](https://www.askthisguy.com/en/blog/rag-tutorial/). Three practical consequences are worth keeping in mind here: - **Answer quality depends first on ingestion**, not on the model. A scanned PDF that is badly converted or badly chunked will produce mediocre answers with any LLM. - **Cited sources are not a display detail.** They are what lets the user verify, and therefore trust. An internal chatbot without citations will not be used for long. - **Access rights must be applied at retrieval**, not at display time. If the system finds a confidential document and then decides not to show it, the information has already leaked into the generated answer. ### Widening what each person actually consults The least anticipated benefit is often the one users value most: **RAG widens the corpus each employee actually works with**. Day to day, everyone uses the few dozen documents they know and keeps returning to the same folders. The rest exists but is never opened: the legal note written by another entity, the report from a neighbouring project, the product sheet updated last month. An assistant that searches the whole corpus the user is entitled to brings those documents into the answer, with their source. People discover what they did not know they should look for. The same reasoning applies to data. Some of the useful information does not live in documents but in the CRM, the ERP, the ticketing system or the project management tool, which most employees never open: too many screens, too many access requests, too much time for a single question. By connecting the assistant to those systems through a [database query](https://www.askthisguy.com/en/doc/customizing-atg-to-you/database-query), [tailored tools](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools) or [MCP servers](https://www.askthisguy.com/en/doc/admin-console/tools-management/mcp-servers), a single answer can combine the written procedure and the real state of the customer account, without anyone having to open the ERP. ## The use cases that pay for an internal chatbot The projects that last share one trait: they target **frequent, written and repetitive** questions. ### Support for shared services HR, legal, procurement, IT. These are the teams most often asked questions whose answer already exists in a document. Leave, expenses, purchasing procedure, standard clauses, access resets: an internal chatbot absorbs a meaningful share of that flow and gives time back to teams that are structurally understaffed. ### Onboarding new joiners An employee's first three months are a long series of questions they do not always dare to ask. An internal assistant shortens the path to autonomy without tying up a mentor full time. ### Technical and product documentation Engineering, presales, support. Finding the right section of the docs, the applicable version of a specification, or the history of a technical decision inside a wiki of several thousand pages. ### Answering RFPs and questionnaires Security, compliance, customer references: the same questions come back, and the answers exist in earlier documents. This is one of the uses where time saved is easiest to quantify. ### Project memory Meeting notes, decisions, trade-offs. "Why did we choose that supplier in 2024?" is a question a well-fed internal chatbot answers better than collective memory does. ## Five mistakes that sink an internal chatbot project **1. Connecting everything at once.** The "let's index the whole information system" ambition produces an assistant that is mediocre everywhere. Start with a perimeter where you can judge answer quality: one domain, one team, one corpus. **2. Leaving access rights until acceptance testing.** This is the topic that kills projects late in the game, when IT discovers the assistant answers everyone from everything. Permissions must be inherited from the sources from the design stage. **3. Neglecting document quality.** Three versions of the same procedure, two of them obsolete, and the assistant will confidently cite the wrong one. An internal chatbot project is almost always also a document housekeeping project. **4. Not measuring.** Two complementary measurements are almost always missing. The first is a **reference set of questions** replayed on every model change or new source: without it, you will not know whether the assistant is improving or degrading. That is what [agent evaluation](https://www.askthisguy.com/en/doc/admin-console/agent-evaluation) is for. The second is **user feedback**: thumbs up or down, free-text comments, sentiment automatically detected in conversations, all tracked over time and broken down by theme or tag to spot the topics that are slipping. That is what our [Insights](https://www.askthisguy.com/en/doc/admin-console/insights) console makes visible. **5. Neglecting the user experience.** An assistant that is excellent on paper but that nobody opens a second time is useless. Adoption comes down to very concrete things: an interface people use without training or a manual, and answers that arrive in a few seconds. An employee who has to wait, who has to learn how to phrase questions, or who does not know what to do with the answer goes back to searching the drive alone, and does not come back. ## Build or buy? Building an internal chatbot from a model and a vector database is easy for a demo. That is what makes the subject deceptive. What costs money is everything else: connectors to Google Drive, SharePoint, Confluence and Notion, incremental synchronisation, correct extraction of tables and scanned PDFs, permission propagation, hybrid search, reliable source citation, quality evaluation, cost monitoring and user support. We detail those pitfalls in our article on [classic mistakes when taking RAG to production](https://www.askthisguy.com/en/blog/enterprise-rag-production-mistakes/). A full internal build is counted in person-months and maintained indefinitely. A platform that already provides those building blocks typically reduces total cost of ownership by around **80%** compared with an end-to-end internal project, and above all shortens the time to first real usage. The real decision criterion is not technical: it is whether the value of your project sits in the plumbing or in the fit with your business. In almost every case, it sits in the second. ## What about sovereignty? An internal chatbot reads your most sensitive documents: contracts, HR files, financial material, intellectual property. Where that content is processed, and by whom, is not a theoretical question. Three things to check before signing: - **Where** documents, vector indexes, logs and backups are hosted. - **Which model providers** are called, from which jurisdiction, and whether you can restrict processing to European providers only. - **What is actually sent** to the model on each question: the relevant excerpts, or the whole document. We have devoted a full page to those trade-offs: [sovereign AI, definition and criteria](https://www.askthisguy.com/en/sovereign-ai/). ## The Ask This Guy approach We deploy internal assistants on a platform that already provides connectors to your sources, document ingestion, hybrid search, permission inheritance, source citation and monitoring. The custom work then goes into your vocabulary, your rules and your use cases, not into rebuilding a technical stack. Three principles guide our deployments: - **A narrow perimeter first**, chosen so that quality can be judged within the first few weeks. - **Permissions inherited from your sources**, so the assistant never shows an employee anything they could not open themselves. - **European hosting** and a configurable AI policy, up to an on-premise option depending on your constraints. Our [turnkey enterprise RAG](https://www.askthisguy.com/en/solutions/knowledge-rag/) page details the available connectors and how a deployment unfolds. ## Frequently asked questions about internal company chatbots ### What is an internal company chatbot? An internal chatbot is a conversational assistant reserved for a company's employees. Connected to internal document sources (drives, intranet, wikis, business tools), it answers work questions from those documents and cites its sources, rather than relying on general knowledge scraped from the web. ### What is the difference between an internal chatbot and a website chatbot? A website chatbot addresses external visitors, on a small public corpus, with a commercial objective. An internal chatbot addresses employees, on a large private corpus, with access rights that differ per person. The tool can be the same, but the corpus, the instructions, the risks and the success criteria are completely different. ### Can an internal chatbot respect each employee's access rights? Yes, provided permissions are inherited from the sources and applied at retrieval time, rather than filtered afterwards at display time. Each user should only get answers built from documents they could open themselves in the original tool. ### How long does it take to deploy an internal chatbot? A few days for a first perimeter on an existing platform with standard connectors. A few weeks if the sources are heterogeneous, if document quality needs cleaning up, or if custom connectors have to be built. A full internal build is counted in months. ### Which sources can an internal chatbot draw on? The usual ones are Google Drive, SharePoint and OneDrive, Confluence, Notion, Slack, websites and intranets, file or FTP shares, and business databases. What matters is not the number of connectors but the quality of ingestion: chunking, table extraction, handling of scanned PDFs and synchronisation of updates. ### What is the return on investment of an internal chatbot? It is measured in search time avoided and in interruptions avoided for shared-service teams. The most reliable approach is to pick a narrow perimeter, measure the number of questions handled and the share of answers rated useful, then expand on that basis rather than on a theoretical estimate made before you started. ## What to take away An internal company chatbot is not a website chatbot moved behind authentication. It is a **document retrieval project with differentiated access rights**, whose success rests on ingestion, permissions and source citation far more than on the choice of model. Start small, on a perimeter where you can judge quality. Measure. Then expand. Projects that fail are almost always the ones that tried to index everything before proving anything. Have a corpus in mind and a team losing time searching? [Book a demo](https://www.askthisguy.com/en/demo/): we will quickly tell you what can be connected, how long it takes, and at what level of quality. --- # Knowledge management: why your initiatives fail, and what AI changes URL: https://www.askthisguy.com/en/blog/knowledge-management-why-it-fails/ Language: en Section: Blog In a lot of companies, two things coexist without ever meeting. On one side, a Confluence space, a SharePoint or a Notion. Four hundred pages. A tree structure carefully designed three years ago, with naming conventions and a page template. The last meaningful edit is eighteen months old. On the other, fifteen metres away, the person everyone goes to see. They answer the same questions ten times a week: where to find the latest version of the master agreement, why this customer is not billed like the others, which clause turned out to be expensive back in 2023. So the company has a repository and it has knowledge. They are simply not in the same place. The reflex at this point is to blame the tool. We picked Confluence, we should have picked Notion. We picked Notion, we should have picked something else. That is almost always a dead end: **the tool was never the cause of the failure**, and replacing it fixes nothing. **Knowledge management is the set of practices through which an organization captures, structures, retrieves and reuses what it knows.** Four distinct operations: an initiative is never worth more than the weakest of the four. The company above structured very well, and missed the other three. ## Knowledge management is not documentation Capturing means getting knowledge out of people's heads and informal exchanges. Structuring means giving it a reusable form. Retrieving means putting it back in front of someone at the moment the question comes up. Reusing is the only one of the four that pays anything back. The other three cost. The classic distinction is still the most useful one. **Explicit knowledge** is what has been written down: procedures, meeting notes, specifications, contracts, formalized lessons learned. **Tacit knowledge** lives in people's heads: why that customer was lost, which supplier actually meets deadlines, which clause must never be accepted, how you recover a situation when the official process does not apply. A document repository only handles the first, and only once it has been written down. Yet nearly every corporate knowledge management initiative has concentrated its effort on a single one of the four operations: structuring. A tree, templates, a naming charter, an editorial committee. Capturing remained an act of goodwill. Retrieving was delegated to a mediocre internal search engine. Reusing was never measured. That imbalance is enough to explain everything that follows. ### And your written knowledge is not where you think it is There is one more framing error, quieter, that skews most diagnoses: believing that explicit knowledge sits in the document tool. It is almost never all there, and often it is not even mostly there. Take an honest inventory of your company. You will find: - **the Excel file with the pricing rules**, maintained by one person, which carries far more authority than the official sales procedure; - **the "comments" column of the customer tracking file**, where the real story of the account lives, the one the CRM does not tell; - **the ticketing tool**, and its thousands of resolved cases that make up the company's actual troubleshooting knowledge; - **the ERP reference tables**, item codes, business rules and settings, which encode decisions nobody can justify any more; - **the shared drive**, with twelve versions of the same proposal and no way to tell which one was signed; - **the email threads and the Teams or Slack channels**, where the trade-off was actually made, before being summarized nowhere. None of this was ever called "knowledge". These are production tools, and knowledge settles in them as a by-product of the work. That is why no knowledge management initiative ever brought them into scope. This is not a sign of disorder. It is how an organization that works normally behaves: people leave information where they produce it, not where a committee decided it should live. **Every company works this way, and there is no reason to think yours is the exception.** Two consequences follow, and they explain the rest. First, an initiative limited to the document tool only covers a fraction of explicit knowledge, often a minority of it: replacing that tool with another one could never have changed anything. Second, the goal of "putting everything in one place" was never reachable, because it assumed migrating information that only makes sense inside the tool where it is produced. ## Why knowledge management initiatives fail Five causes come back, and they are structural. None of them is settled by a software choice. ### 1. The effort is asymmetric The person who documents is not the person who benefits. Writing a page takes forty minutes, today, out of time that is already short. The benefit shows up in six months, for someone else, and nobody will ever know it came from you. An immediate, certain cost against a deferred, uncertain and unattributed benefit: that trade-off is lost before it starts. Employees who do not document are not careless, they are rational. ### 2. Obsolescence is silent A page that is wrong raises no alert. It stays online, filed under the right heading, with the right template, and it inspires exactly the same confidence as the day it was written. This is the point most initiatives underestimate: **outdated documentation costs more than no documentation at all**. Faced with a gap, people ask. Faced with an obsolete page, people apply it. And it only takes a few bad surprises for teams to stop trusting the repository for good, including the parts that are still correct. ### 3. Searching costs more than asking again This is the most decisive cause, and the one least often named. Finding the information in the repository means opening the tool, guessing the vocabulary the author used, sorting through results, opening three pages, then checking which one is current. Fifteen to twenty minutes, with no guarantee of success. Messaging the colleague who knows takes thirty seconds, and the answer comes back reliable and in context. As long as that cost ratio holds, the repository loses every time. Not because it is badly built, but because it is more expensive to use than the human alternative. And that alternative has a hidden price, paid by the three or four people everyone turns to. ### 4. KM was treated as a project, not as a flow A budget, a steering committee, a migration phase, an acceptance test, a launch, an internal communication campaign. Then the end of the project, and the team scattering onto something else. A company's knowledge is not a stock to be built once, it is a flow that renews itself continuously. A flow whose supply you cut runs dry. The first six months keep up appearances, because the initial base is still fresh. The decay becomes visible around month eighteen, when nothing matches reality any more. ### 5. Storing was confused with making findable A three-terabyte SharePoint is not a **knowledge management system**. It is a warehouse. Storing has been solved for twenty years and costs almost nothing. Making findable, in the sense of "the right answer, to the right person, at the moment they need it, with the source", was never solved by document management tools. They index words, not questions. An employee searching for "can we push back billing for this type of customer" has no keyword that appears in the document holding the answer. ## What AI actually changes Four things have moved, and none of them deserves the word "revolution". ### It flips the effort The classic model asked you to file things upfront in order to find them later. All the rigour had to be invested at writing time, by the author, without knowing the future questions. Natural language search grounded in the company's documents flips that contract. The interpretation effort is paid at question time, by the machine, and for a real question. The author no longer has to anticipate the vocabulary of whoever will be searching. ### It makes an imperfect base usable This is the most underestimated change. A classic engine needed a clean base to return good results. A **RAG** (*Retrieval-Augmented Generation*) setup reads what is badly filed: meeting notes, scanned PDFs, support tickets, discussion threads, old sales proposals. We cover the mechanism in our [RAG guide](https://www.askthisguy.com/en/blog/rag-tutorial/). This is not an implementation detail, it is what changes the economics of the subject. The entry condition is no longer "have a clean repository", a prerequisite nobody ever met. It becomes "have accessible sources", which almost every company already has. ### It breaks the economics that killed the repository Go back to cause 3. If getting a sourced answer takes thirty seconds instead of twenty minutes, the trade-off between searching and asking again tips over. For the first time, the system becomes cheaper to use than the colleague. That is the only mechanism we know of that actually brings teams back to formalized knowledge. Not the charter, not the committee, not the internal communication: the fact that it has become the shortest path. ### It finally tells you what is missing This is the least known point, and probably the most interesting one over time. A classic repository is blind. It knows how many pages it holds, never what people looked for and failed to find. So you steer documentation by opinion: the committee decides that "the purchasing processes should be documented", because someone said so in a meeting. As soon as an assistant is connected to your sources, every question asked becomes a usable signal. And the questions arrive in natural language, the way people actually ask them. Analyzing them surfaces three things nobody could see: - **The gaps.** A question that comes back twenty times a month with no source answering it correctly points precisely at the page to write. That is no longer an opinion, it is a measurement. - **The contradictions.** When two documents say the opposite on the same subject, the assistant runs into it on every relevant query. Those conflicts, invisible as long as nobody read both pages side by side, become a list. - **Useful obsolescence.** Not all outdated pages are equal. The one nobody has ever requested can wait. The one that sources thirty answers a week has to be fixed this week. Real questions rank the update effort for you. That is what closes the loop. Causes 2 and 4 above, silent obsolescence and KM treated as a project, both came down to the same blindness: no way to know where the repository was slipping, therefore no way to maintain anything but a frozen stock. Usage becomes the source of truth about what needs documenting, and maintenance becomes a flow steered by facts. An honest recap: | Cause of failure | What AI changes | What stays on you | | --- | --- | --- | | Asymmetric effort | Sharply reduces the need for upfront formatting and filing | Someone still has to write it down at least once | | Silent obsolescence | Answers cite their source and its date, and real questions reveal the pages that are slipping | Deciding what to archive and what to maintain | | Searching costs more than asking again | Flips the cost ratio, this is the main lever | Guaranteeing answer quality over time | | Project rather than flow | Live sources are re-indexed continuously, and usage continuously indicates what to write or fix | Steering remains a permanent function | | Storing instead of making findable | Solves the "findable" part | The "reliable" part stays human | ## What AI does not change An article that stopped there would be dishonest. Four limits hold. **Knowledge that was never written down stays out of reach.** No model will recover why you walked away from that supplier in 2021 if it only exists in two people's memory. AI substantially improves "retrieving" and "reusing". It does nothing for "capturing". That is what remains the real knowledge management work, and the fact that it is now the only hard point is good news: you can concentrate your effort there instead of spreading it thin. **Access rights become more critical, not less.** An assistant that crosses silos also crosses the partitions those silos were quietly providing. A poorly protected HR folder was not a problem as long as nobody knew it existed. It becomes one as soon as a natural language question can surface it. A serious assistant inherits the permissions of the source tools and only answers within the scope of the person asking. **Contradictions still require a human decision.** When two documents say the opposite, a good system cites both and flags the conflict. It does not arbitrate, and it should not. That is a governance point, not a technology one. **Confidentiality remains an architecture choice.** Feeding internal documents into a consumer AI means handing their content to a third party, with no traceability and no way back. We cover that point and its practical consequences in [Contextual AI for your business](https://www.askthisguy.com/en/blog/contextual-ai-rag-use-cases/). ## What a knowledge management system looks like in 2026 No longer a single tool everyone is supposed to file into, but five layers built on what you already have. ```mermaid flowchart LR A[Existing sourcesSharePoint, Confluence, Drive,
CRM, tickets, PDFs] --> B[Continuous ingestion
and indexing] B --> C[Semantic search
filtered by permissions] C --> D[Assistant
Natural language answer] D --> E[Cited sources
with dates] E --> F[Human review
and fix at the source] F --> A ```
The diagram reads as a closed circuit: documents stay in the tools where they already live, continuous indexing and permission-filtered search feed the assistant, and human review sends corrections back to the source rather than to a copy. That return arrow is what separates an ongoing flow from a one-off project.
The layers, in order: **sources where they already are**, **continuous ingestion** rather than a one-off migration, **semantic search** filtered by permissions, **answers that cite their sources** with dates, and a **correction loop** that lets a user flag a wrong answer and get the original document fixed. That last layer is the one people forget, and it is the one that answers cause 4. It turns every use into an opportunity to improve, and turns the setup into a flow rather than a project. Add light governance: who owns which source, how often you prune, who arbitrates contradictions. Three rules are enough, as long as they have an owner. ### Do you still need a dedicated knowledge management tool? This question comes up every single time, and our answer is probably the opposite of what you expect: the storage layer matters far less than it used to, the access layer matters far more. In other words, do not replace your Confluence or your SharePoint. Connect them. Migrating to new **knowledge management software** eats six to twelve months, mobilizes exactly the people whose knowledge you want to capture, and reproduces all five causes of failure in a more recent environment. You will have a prettier warehouse, with the same problem. The only case where changing **knowledge management tool** is justified is when the current source is technically closed, meaning no API and no usable export. That is rare, and it can be checked in half a day. For everything else, **enterprise knowledge management** has shifted from the choice of tool to the quality of the access layer: does it cover all your sources, does it respect your permissions, does it cite, is it still accurate in six months. The first of those four criteria is the one that disqualifies the most solutions. An access layer that only reads your document tool takes you back to square one: it ignores the pricing file, the resolved tickets and the ERP tables, which is a large share of what your teams are actually looking for. ## When knowledge management starts paying off A few orders of magnitude to help you decide, to be weighed against your own situation rather than taken literally. The trigger is almost never the volume of documents. It is **the concentration of knowledge**. Put the question differently: how many people in your company get interrupted more than five times a day for questions whose answer exists somewhere? If the answer is two or three, you already have an expensive problem, and growth is making it worse. The other signals that matter: - **Onboarding longer than three months** before a new joiner is autonomous on routine questions. - **An upcoming departure** on a key role, with knowledge concentrated in a single head. - **More than three or four different sources of truth**, with nobody knowing which one wins. - **Recurring mistakes** caused by working from an outdated version of a document. Below fifteen to twenty people, informal collective memory is usually enough and the subject can wait. Between fifty and three hundred, that is the zone where the cost becomes real without being visible in a budget yet, because it is paid in interruptions and delays rather than in invoices. ## A concrete example: IT maintenance Take an IT equipment maintenance provider, a case we know well. Their technicians work on customer sites. Some are employees, others are external subcontractors brought in depending on workload and geographic coverage. On site, a technician needs three things at once: the applicable procedure, the customer history, and the context of the previous visit. That knowledge is of two different natures, and that is what makes the case interesting. There are **documents** first: the generic procedures, but also every particularity specific to a given customer. This piece of equipment must be shut down in a precise sequence. That site imposes an intervention window. This customer has a network configuration unlike any other. Those specifics are written down, but scattered across sheets, contract annexes and visit reports. Then there is a **database**: the history of tickets and interventions. Who came, when, what was replaced, what failed again three weeks later. That is structured data, with dates, references and statuses, not documents. No document repository covers both. This is exactly cause 5: the provider was not missing information, they had no single path to reach it. As a result, the rational behaviour for a technician on site was to call support, who would query the ticketing tool while the customer waited. Every call cost two people instead of one. The subcontractor case added a constraint that classic repositories handle badly. An external technician needs access to the procedures of the customer they are working at that day, and nothing else. Broad access is unacceptable, no access at all makes them less effective than their internal colleagues. On top of that comes a third use, in the office this time. Support and management need to query those same operational databases for analytical questions: profitability per contract, recurring failures across a fleet, adherence to response times. Same data assets, completely different question. We cover that specific angle in [Your databases are a gold mine](https://www.askthisguy.com/en/blog/databases-gold-mine-ai-shovels/). What this case shows: as soon as a company outgrows the wiki stage, its knowledge is mixed, both documentary and structured, and addressed to populations with different permissions. A knowledge management system that only handles one of the two natures leaves the problem intact. ## How we approach the subject at Ask This Guy Our position follows directly from the above: **no migration**. Ask This Guy connects to your existing sources, whatever they are, and indexes them continuously. Your teams do not change where they put things, and you do not pay for six months of document overhaul before getting the first useful result. We handle both natures of knowledge in the same assistant: **documents**, through RAG, and business **databases**, queried in natural language as described on our [Talk to data](https://www.askthisguy.com/en/solutions/talk-to-data/) page. That is what makes it possible to answer "what is the procedure on this site" and "how many interventions on this fleet since January" without switching tools. Three points we do not compromise on, because they decide whether usage lasts: - **Every answer cites its sources**, with dates. A user who cannot verify will not trust it, and a user who does not trust it goes back to their inbox and their colleague. - **Permissions are inherited from the source tools.** The assistant never answers beyond what the person already had access to. - **Hosting is European**, with an on-premise option when document sensitivity requires it. Finally, we do not stop at go-live. Once the assistant is in place, your users produce every week the raw material all your previous initiatives were missing: the real questions. Our [Insights](https://www.askthisguy.com/en/doc/admin-console/insights) console tracks volumes, tags, sentiment and answers rated unsatisfactory; we help you turn that into a concrete documentation work plan, the list of topics to write, contradictions to arbitrate and pages to fix first. **Want to know what your users are looking for and not finding?** That is exactly the diagnosis we can run from your sources and your teams' real questions. [Let's talk](https://www.askthisguy.com/en/demo/), or write to us at [bonjour@askthisguy.com](mailto:bonjour@askthisguy.com). The detail of the approach, the available connectors and the cost model are on the [turnkey enterprise RAG](https://www.askthisguy.com/en/solutions/knowledge-rag/) page, and the technical workings in our [documentation](https://www.askthisguy.com/en/doc/customizing-atg-to-you/). ## Frequently asked questions about knowledge management ### What is knowledge management? Knowledge management is the set of practices through which an organization captures, structures, retrieves and reuses what it knows. It covers explicit knowledge, what has been written down, as well as tacit knowledge, what lives in people's heads. The weakest of the four operations decides the value of the whole. ### What is the difference between knowledge management and document management? Document management organizes files: versions, filing, lifecycle, archiving. Knowledge management targets the use of knowledge, including when it does not take the form of a document. A pricing file, a ticket history or an ERP settings table carry knowledge without being documents in the document management sense. That is why a purely documentary project only covers a fraction of the subject. ### What is the difference between tacit and explicit knowledge? Explicit knowledge has been formalized: procedures, meeting notes, contracts, specifications. Tacit knowledge was never written down: why a supplier was ruled out, which clause must never be accepted, how you recover a situation when the official process does not apply. Repositories only handle the first, and only once it has been put in writing. ### What is a knowledge management system? In 2026, it comes down to five layers. Sources stay where they are. Ingestion runs continuously, instead of a migration done once. Search is semantic and filtered by each person's permissions. Answers cite their sources with dates. And a user who hits a wrong answer can flag it and get the original document fixed. The single tool everyone was supposed to file into is no longer part of it. ### What are the knowledge management tools? The historical tools are wikis and intranets (Confluence, SharePoint, Notion, Jalios), alongside support knowledge bases and document management systems. The important point is elsewhere: the storage layer matters far less than it used to, the access layer far more. Knowledge management software that only reads its own content leaves out the pricing spreadsheet, the resolved tickets and the business databases. That is where a good share of the answers actually sit. ### Why does knowledge management matter for a company? The volume of documents matters little. What triggers the subject is knowledge concentrated in the two or three people everyone turns to. The other signals: onboarding that runs past three months, an announced departure on a key role, three or four competing sources of truth, mistakes that keep coming back because someone worked from an outdated version. The cost is paid in interruptions and delays, rarely in invoices, and stays invisible for a long time as a result. ### Does AI replace knowledge management? No. It moves where the effort is paid. It clearly improves "retrieving" and "reusing", and makes an imperfect base usable where a classic engine required a clean one. It does nothing for "capturing": knowledge that was never written down stays out of reach. Access rights, arbitrating contradictions and the hosting choice remain human decisions. ## Conclusion Knowledge management initiatives of the last twenty years were not absurd. They were right about the intent and wrong about the method: they demanded upfront filing effort from people who got no benefit from it, to feed a system that was more expensive to consult than a message to a colleague. What AI changes is not the ability to store, which was never the problem. It is where the effort gets paid. **If you only remember one thing.** AI does not save an empty repository. It finally makes an imperfect repository usable, which is what every repository is. So the question is no longer "how do we convince teams to file things better", but "how do we make access cheaper than asking a colleague". If the project takes the shape of an assistant your teams can query, our guide to the [internal company chatbot](https://www.askthisguy.com/en/blog/internal-company-chatbot/) covers the use cases that pay off, the classic pitfalls and the conditions for success. If you recognize your company in the first scene of this article, the subject is ripe: **[book a demo](https://www.askthisguy.com/en/demo/)**, we will start from your real sources. --- # Enterprise AI SLA: one AI provider for your agents is not enough URL: https://www.askthisguy.com/en/blog/enterprise-ai-sla/ Language: en Section: Blog Open [Anthropic's status page](https://status.claude.com/). You will likely land on an averaged availability rate between 99% and 99.5%. "Two" nines.
We went from an era where people aimed for *four nines* (99.99%) to one where **99.3% uptime** barely raises an eyebrow (not enough).
"Vibe coders" using Claude are fine with that, but is it enough for your company?
Probably not...
Is Anthropic an outlier? No. Operationally, it is very hard to keep a high service level for AI inference on large models.
## If you remember only one thing
Pointing your production stack (RAG, internal assistant, agents) at a **single** AI provider (for example Claude, ChatGPT, Gemini, Mistral) means accepting that your system could experience several cumulative days of downtime per year, depending on how availability is measured. For a business-critical service, that risk deserves to be treated as an infrastructure dependency.
## A reminder of what the nines mean
Orders of magnitude for unavailability, all causes included, over one year:
| Nines | Uptime | Approx. downtime |
| --- | --- | --- |
| Two nines | 99% | ~3.6 days |
| Three nines | 99.9% | ~8.8 hours |
| Four nines | 99.99% | ~52 minutes |
Are you ready for several days of downtime per year on your AI project?
Your users are used to "four nines" on everyday services. Here, for example, is Microsoft 365's real-world availability:

## What about Anthropic's competitors?
[OpenAI](https://status.openai.com/) and [Mistral](https://status.mistral.ai/) also publish their availability. The figures are not directly comparable: each page covers different components and periods. As of July 31, 2026, Mistral displayed **99.4%** over the previous three months.
A status page is not a financial SLA. Some specific offers do publish a commitment, such as [Gemini Online Inference](https://cloud.google.com/vertex-ai/generative-ai/sla) at **99.5%** or [OpenAI Scale Tier](https://openai.com/api-scale-tier/) at **99.9%** (a specific option).
Hyperscalers can offer stronger commitments on some managed inference services, for example **99.9%** on [Azure AI](https://azure.microsoft.com/en-us/products/ai-foundry/models/openai). That covers endpoint availability, not necessarily latency, answer quality, or the availability of the full RAG chain.
That remains far from the usual guarantees of productivity SaaS, where three nines are a standard with no surcharge.
## The open-weights revolution and LLM gateways
[Open models](https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/) change the equation. They can run on many inference providers, which makes it possible to provide a fallback path when one of them becomes unavailable.
The answer: a **multi-provider gateway**, or *LLM gateway*. In practice, the software must be able to call several models and providers based on current performance, cost, availability, and failover rules.
Those providers do not all show 99.9%. Used with a gateway, health checks, and a fallback mechanism, they can reach it. Here is a snapshot of what we see in production at Ask This Guy, measuring call success over the last 30 days:

Products exist for this need. For example, [OpenRouter](https://openrouter.ai/) provides a single access point to many providers, with fallback rules to configure. On the European side, [Eden AI](https://www.edenai.co/), a French vendor, exposes more than 500 models behind a single API, with built-in fallback, a European endpoint and zero data retention. Enough to pool availability without moving your context outside the GDPR perimeter.
You can also build the gateway yourself: connect to many providers, measure their performance, and implement priority and fallback logic.
And some platforms bake it in natively, as we do at Ask This Guy.
An **enterprise RAG SLA** is not only about LLM uptime either: sources, retrieval, tools, and measurement matter just as much. For the pitfalls after the POC, see [Enterprise RAG: 5 production mistakes](https://www.askthisguy.com/en/blog/enterprise-rag-production-mistakes/).
## Frequently asked questions about enterprise AI SLAs
### What is an enterprise AI SLA?
An enterprise AI SLA defines the expected availability of an AI service, along with its measurement scope, exclusions, and any service credits. A status page helps you observe incidents, but it does not replace a contractual commitment.
### What SLA should an enterprise RAG target?
An **enterprise RAG SLA** should cover more than the model API: source ingestion, retrieval, tools, the gateway, latency, and service quality. **99.9%** can be a useful availability baseline, but the figure only means something when the scope and measurement method are explicit.
### How can you improve an AI assistant SLA?
To improve an AI assistant SLA, avoid a single point of failure: use a multi-provider gateway, several models, health checks, automatic failover, and monitoring for errors and latency. Also plan a degraded mode for times when generation is unavailable.
## At Ask This Guy
Our [AI provider gateway](https://www.askthisguy.com/en/doc/infrastructure-and-security/ai-providers/) selects available, performing models. Client-side goal: to target a service level **above 99.9%** within the defined scope, without depending on a single frontier model. EU-only or worldwide policy depending on your [sovereignty](https://www.askthisguy.com/en/doc/infrastructure-and-security/sovereign-ai/) constraint; details on [AI providers](https://www.askthisguy.com/en/doc/infrastructure-and-security/ai-providers/).
No miracle. An architecture that assumes cloud LLMs fail, and is designed for that. It underpins our [enterprise RAG solution](https://www.askthisguy.com/en/solutions/knowledge-rag/), and the same gateway powers a [product support assistant](https://www.askthisguy.com/en/solutions/product-assistant/) when your users are your customers.
**A useful enterprise AI SLA** = multi-provider + automatic failover.
If you are industrializing a RAG or an internal assistant and want to see this gateway in real conditions: **[book a demo](https://www.askthisguy.com/en/demo/)**.
---
# SaaS chatbot: product support, data, and AI actions
URL: https://www.askthisguy.com/en/blog/chatbot-produit-saas/
Language: en
Section: Blog
A customer who pays their subscription **isn't necessarily an engaged customer**: an account can stay billed for months while the user behind it has already checked out, opens the product less and less, never reaches the features that justify the price, and quietly prepares to leave.
A SaaS company's permanent job isn't selling the subscription, it's **continuously maximizing the value each customer actually gets out of the product**. Without usage, without satisfaction, without customers growing more capable with the product, cancellation is only a matter of time.
That risk has gotten sharper with a recent shift: pretty much anyone can now **vibe code an internal tool with AI**, no development skills required. The barrier that used to protect an average product, the cost of rebuilding it yourself, is collapsing for a growing share of use cases. A dissatisfied customer no longer just has the option of shopping a competitor: increasingly, they can simply recreate the part of your product they actually use.
A chatbot properly built into a SaaS product attacks this problem head-on. Not as a gadget parked on the homepage, but as a piece of the product that increases the value actually extracted from every interaction, and that finally makes visible what used to play out, unseen, between two billing statements.
This article walks through three levels of integration, from the fastest to the most ambitious, and the piece that ties them together: visibility into what's actually happening in the conversations, the one place where real engagement becomes visible before it's too late.
## Three levels, one chatbot
"Building a product chatbot" is often treated as a single, binary project: you build it, or you don't. In practice, the value stacks up in layers, and each layer has a different cost and a different level of complexity.
- **Level 1 (answer generic requests):** the chatbot draws on product documentation and the user's context.
- **Level 2 (answer with customer-specific data):** it queries the account's business data to provide a personalized response.
- **Level 3 (act on the customer's behalf):** it triggers authorized actions in the product through APIs and workflows.
### Level 1: answering generic requests
**Nobody reads product documentation anymore.** Your users are looking for a menu, trying to understand a feature, or checking their configuration, and they don't have time to dig through twenty pages to find the answer. When they can't find it, they open a ticket, even when the answer already exists.

The difference with a simple search bar bolted onto the product is **context**. A good support assistant knows which plan the user is on, which version of the product they're using, what role they have, sometimes their recent history, and even which page they're on and what they're in the middle of doing. The answer to "how do I export my data" isn't the same for a free-plan user and an enterprise-plan admin, and the assistant should know that without being told every time.
This is also, by far, the fastest level to set up. It doesn't require a technical overhaul: access to your documentation, and sometimes a bit of read-only account data, is enough to get started. This is literally what our own admin console does, itself a SaaS product: an admin asks "how do I configure SharePoint?" from the Knowledge page, and the widget answers with a sourced walkthrough instead of pointing them to a separate doc article to go dig up themselves. On deployments like this, **40 to 60% of tickets are about content that's already documented**. That's the volume this first level absorbs.
One detail worth not overlooking: this level serves **both of your audiences**. The customer gets a sourced, contextualized answer. Your support team sees what's actually left: bugs, complex cases, the product signals that deserve a human.
Every bit of friction removed is a little more value genuinely extracted from the product, and a little less reason to go looking for an alternative, whether homemade or from a competitor.
See the solution page: [product support assistant](https://www.askthisguy.com/en/solutions/product-assistant/).
### Level 2: letting users query their own data
Data presentation in a SaaS product is almost always a compromise. You design dashboards and information-access menus around the most common use case, and they never quite match what's needed in the moment. A user who wants to cross two filters you didn't anticipate goes back to your team, exports a file, or gives up.
A chatbot connected to your data flips the question. Instead of adapting their need to the existing dashboard, the user asks their question directly, in plain language, and gets a numeric answer, a chart, sometimes an export.
Take a concrete example: a fleet management SaaS.
*"How have my breakdowns in the Lyon area trended over the last 12 months?"*
The assistant returns the trend, with a visible spike in July. The user follows up, without switching tools or restating their question from scratch:
*"Is this seasonal? Is it always the same models? Maybe the 308?"*
That's the kind of follow-up no static dashboard allows, because you'd have had to anticipate the question in advance. On deployments like this, we typically see **twice as many users actually making use of the data**, precisely because the channel no longer requires technical skill or a back-and-forth with a data team.
This level is also relatively simple to implement once the chatbot has access to your databases or APIs: it doesn't invent anything, it reads and surfaces what already exists in your system.
It doesn't replace your dashboard, it complements it: the dashboard tracks how your metrics evolve over time, the conversation explains why a number moved and explores the factors behind it, without having to build a new report for every question.
This is also the level where the gap with a homegrown tool widens. A pivot table on an export, anyone can vibe code that in an hour. A conversation that understands an account's business context and answers with real production data is a lot harder to improvise.
See the solution page: [Talk to Data](https://www.askthisguy.com/en/solutions/talk-to-data/).
### Level 3: triggering actions
**A chatbot answers. An agent acts.** That's the shift that really sets this third level apart from the first two, and it's also what changes the complexity calculation.
Two families of actions make sense in a SaaS product. The first covers **everyday actions**, simple but repetitive: changing an account setting, adding a user, updating a configuration, things the user would do in three clicks anyway, but can now ask for in one sentence. The second is where **AI genuinely adds value**: pulling in a relevant piece of public data to enrich a record, generating content from the account's context, analyzing a customer's recent usage to recommend a configuration or plan change before they even ask.
It's this second family that really differentiates a product, because it goes beyond simply answering a question that was asked.
This level changes the nature of the project. Read access to documentation or data is no longer enough: you need an **authorization system** that precisely defines what the agent can do for which user profile, **adapted APIs** for every possible action, and often **specific workflows** for actions with real consequences (billing, personal data, contractual commitments). It's a real investment, but concentrated on a small number of high-leverage actions rather than spread across the whole product, and it's also the hardest level to recreate without a technical team, which makes it, once in place, the most durable of the three advantages.
## Finally understand your customers and their unspoken needs
Most product chatbot projects stop at the answer: the bot answers well, everyone moves on to the next project. That misses the point: **the revenue dashboard says nothing about a customer's real engagement, but their conversations with the chatbot do**. Every exchange is a signal, and most of those signals never surface anywhere else.

Concretely, two building blocks turn these conversations into something you can act on.
**Tag and alert rules, described in plain language.** Instead of a fixed list of keywords, you describe a condition the way you'd explain it to a colleague: "the customer is asking about advanced features or plans above their current tier," "the customer is signaling they want to end a service." When a conversation matches, it gets tagged automatically and, if you turn it on, an email alert goes to the right team. That's the mechanism that turns a hunch ("we should be catching cancellation signals") into a process that runs on its own.
**A dashboard that tracks all this over time.** Conversation volume, automatically detected sentiment, thumbs-up or thumbs-down reactions, breakdowns by tag and by agent, comparison against the previous period. Enough to answer simple questions that rarely get measured: is sentiment slipping on a given feature since the last release? Which agent is concentrating the most frustration? Where should attention go this week?
This is where anti-churn and upsell stop being intentions and become active rules. A customer signaling they want to end a service, or asking about advanced features, triggers an alert before the issue surfaces through another channel, or doesn't surface at all.
Documentation: [tags and alerts](https://www.askthisguy.com/en/doc/admin-console/tags-alerts) and [Insights](https://www.askthisguy.com/en/doc/admin-console/insights).
## Should you build it or buy it?
In the vast majority of cases, the answer is buy, and that holds across all three levels, from support to triggering actions.
Building a minimal chatbot from a model and a vector database is doable in a few days for a demo. But **the expensive part is never the demo, it's everything around it**: managing user context by plan and profile, search that actually finds the right information in your sources, reliable citation of those sources, ongoing evaluation of answer quality, inference cost monitoring, orchestration and permissions once you touch actions, and the whole visibility and alerting layer described above. That part accounts for **roughly 90% of the work**. It's generic, in the sense that it doesn't depend on your business, but it's far from simple: it's what separates a chatbot that impresses in a demo from one your customers are still using six months later. A full in-house build is measured in person-months, and then it needs maintaining for as long as it runs: we cover these pitfalls in our article on [common enterprise RAG mistakes](https://www.askthisguy.com/en/blog/enterprise-rag-production-mistakes/).
That's the **90/10** logic we apply at Ask This Guy: that 90% (chat, our [six-way hybrid search](https://www.askthisguy.com/en/blog/hybrid-search-retrieval-methods/), permission management, oversight and alerting, hosting) is a platform that's already built and keeps evolving without you having to do it. That's the foundation of our [turnkey enterprise RAG](https://www.askthisguy.com/en/solutions/knowledge-rag/). The remaining 10% (your documents, your user context, your APIs, your action workflows) is what actually makes the difference for your customers, and **it's the only place where custom work is worth it**.
Two situations break this rule. The first is when AI isn't a feature bolted onto your product but its actual core: at that point, owning the stack becomes your differentiation, and building it in-house is justified. The second is when your business volume is very large, a big B2C product, say: the cost of an in-house build then amortizes over a user base large enough to change the math.
| Criteria | Full in-house build | Existing platform |
| --- | --- | --- |
| First useful scope | Several months if the team starts from scratch | A few days to a few weeks |
| User context (plan, role, history) | To design and maintain | Standard building block, wired to your data model |
| Oversight and alerting | Has to be built from scratch | Already available, rule-based configuration |
| Actions and permissions | Authorization system to design | Existing framework, specific workflows to define |
| Maintenance | On your product team | Carried by the vendor |
| Makes sense when… | AI is the core of the product, or business volume is very large | In every other case |
On the projects we run, TCO drops by roughly **80%** compared to a build carried out entirely in-house, with a first useful scope in weeks rather than months.
## Ask This Guy's approach
We deploy product assistants on a platform that already provides the chat, user context, oversight, and alerting. The specific work goes into your documentation, your APIs, and the actions that genuinely make sense for your product.
Our approach always starts at level 1: a narrow scope, connected documentation, a first use case you can measure within a few weeks. The next levels, data and actions, get added once the first one has proven itself with your users, without starting over on the technical stack.
Running a SaaS product and want to work out what a chatbot would change for your customers? [Book a call with us](https://www.askthisguy.com/en/demo/).
## Frequently asked questions about chatbots in SaaS products
### Isn't recurring revenue enough to measure account health?
No. A customer can stay billed for months after they've stopped getting real value from the product: they open the app less often, stop exploring new features, and quietly prepare to leave. MRR is a lagging indicator, it confirms a problem after the fact rather than announcing it. Real engagement signals, such as usage frequency, sentiment expressed in exchanges with an assistant, or repeated questions about the same friction point, are visible much earlier, provided you're watching for them.
### Can a product chatbot actually reduce churn?
Indirectly, but measurably. The chatbot doesn't retain a customer by itself: it picks up, in the conversations, the signals that often precede a cancellation (a question about ending a subscription, repeated frustration with a feature) and alerts the right team before the customer leaves. It's the combination of contextualized answers, which reduce upstream frustration, and automated alerts, which buy time to act downstream, that makes the difference.
### How long does it take to deploy a chatbot in a SaaS product?
For the first level, a support assistant connected to your documentation, a few days to a few weeks is enough on an existing platform, versus several months for a full in-house build. The next levels, querying data and then triggering actions, get added progressively and require more scoping work, particularly around permissions and business workflows.
### Do you need to connect the chatbot to all your data from day one?
No. The fastest lever is almost always the quality of the instructions and scenarios, not how exhaustive the connected sources are. A narrow scope, where you can actually judge answer quality, gives better results than a full but poorly scoped rollout. You widen the scope once the first use case has proven itself with your users.
### How does a chatbot detect an upsell opportunity?
Through tag rules defined in plain language rather than fixed keywords: for example, "the customer is asking about advanced features or plans above their current tier." When a conversation matches that condition, it gets tagged automatically and can trigger an email alert to the sales or customer success team, in real time rather than after the fact in a monthly export.
### Does a product chatbot replace human customer support?
No, it absorbs the repetitive, already-documented share, generally 40 to 60% of ticket volume, so support teams can focus on complex cases, bugs, and issues that require real human judgment. The goal isn't to remove human contact but to reserve it for the situations where it adds the most value.
## The bottom line
A customer's recurring revenue says nothing about their real engagement, and that's precisely what makes disengagement dangerous: it stays silent until cancellation. A chatbot in a SaaS product can stay a simple documentation assistant, or it can become the instrument that continuously maximizes the value each customer extracts and makes visible what would otherwise only show up at the moment they leave, for a competitor or, increasingly, for whatever they end up building themselves.
---
# Data analysis tools: which family for which need in 2026?
URL: https://www.askthisguy.com/en/blog/data-analysis-tools/
Language: en
Section: Blog
There has never been so many tools for analyzing data. Excel, Power BI, Python, MATLAB, ChatGPT, not to mention the wave of "text-to-SQL" tools and conversational assistants that have shown up in the last two years.
**Which family of tools for which type of need?**
Here's a clear breakdown!
## 1. Spreadsheets: Excel, Google Sheets

**In short.** The universal starting point of data analysis.
**Examples:** Microsoft Excel, Google Sheets.
**Who, when.** Anyone — everybody knows how to open an Excel file. Widely used by business teams and CFOs, who rely on it daily to model, simulate, and run a well-controlled one-off calculation from start to finish. For management control specifically, we detailed this trade-off in our guide [Excel, Power BI dashboards and AI](https://www.askthisguy.com/en/blog/financial-analysis-without-excel).
**What they do best.** Modelling. Building a budget, simulating a scenario, laying out assumptions and making them visible. Unmatched flexibility, and above all: everyone knows how to use it.
**Their limits.** As soon as it's used for **recurring** analysis, the weaknesses show up: no automatic connection to sources, formulas that pile up and become fragile, files that are hard to reproduce and depend on whoever built them. On top of that, validating each assumption by manually tweaking numbers can be very time-consuming.
## 2. Business intelligence platforms: Power BI, Tableau, Qlik

**In short.** Tracking indicators over time.
**Examples:** Microsoft Power BI, Tableau, Qlik, Looker.
**Who, when.** Usually set up by IT for business teams. Ideal for recurring financial or operational reporting, and tracking shared indicators over time.
**What they do best.** The **dashboard** and **data visualization**: revenue, margin, cash, receivables. You follow the trend in a stable, shared, automatically updated visual format. It's the reference tool for regular reporting.
**Their limits.** The dashboard is rigid by nature: as soon as a question falls outside the grain planned by the report designer, the dashboard itself has to be modified. The answer will wait. As for the built-in conversational AI (Power BI's Copilot, for instance), it's generally not very capable, and in Microsoft's case, particularly expensive.
## 3. Languages and notebooks: Python, R, SQL

**In short.** Tailor-made analysis, with no limit on power. **Reserved for technical profiles.** The notebook lets you write code and see the results directly.
**Examples:** Jupyter notebooks, with Python code and the Pandas library (or, more modern and performant, Polars).
**Who, when.** Exclusively technical teams, for advanced analyses. Not a self-service tool.
**What they do best.** Almost everything. Large volumes, complex processing, advanced statistical analyses, reproducible and versioned pipelines. It's a key tool for data teams.
**Their limits.** They require the ability to code and strong mathematical logic. A business user can't be autonomous here: they depend on a data engineer or developer to ask their question and get an answer.
## 4. Scientific and statistical computing: MATLAB, SAS, SPSS

**In short.** When analysis becomes a full-fledged scientific discipline. **Out of reach for business users.**
**Examples:** MATLAB, SAS, SPSS, Stata.
**Who, when.** Researchers, engineers, biostatisticians, quants. This family is mentioned here for completeness: for a common business question, it's never the right tool.
**What they do best.** Advanced statistics, numerical modelling, signal processing, quantitative research: areas where these specialized suites remain references.
**Their limits.** Expensive, highly specialized, with a long learning curve. Business autonomy is simply not possible here: these are tools for specialists, not for decision-makers or functional analysts.
## 5. Conversational AI: talking to your data
**In short.** The newest family: **querying your data in natural language**, the way you'd ask a colleague, and getting a figure, a chart, an export.
It's also the most fragmented family, precisely because it's the most recent. Three main approaches stand out.
### General-purpose AIs: Mistral, ChatGPT, Claude
**Who, when.** One-off analysis of a single file you already have on hand.
**What they do best.** Analyzing a file you give them. You import an Excel or CSV, ask your question, and get an impressive analysis in seconds. Zero setup, accessible to anyone, even simpler than Excel.
**Their limits.** It's **one-shot**: you feed the tool by hand, every time. These assistants are starting to offer connectors, but they aren't built to query your connected enterprise sources (ERP, CRM, SQL database) with your business context in a **recurring, governed, permissioned** way. By default, your data leaves your environment. And the risk of hallucination is high.
### Pure-play data tools: Vanna, Wren AI
**Who, when.** Technical teams who want to build their own custom conversational layer.
**What they do best.** Turning a question into a SQL query (the "text-to-SQL" approach). Connected to your database, often open-source, they're powerful on **structured** data.
**Their limits.** They're focused on SQL and structured data, and ignore your documents. Above all, they're **building blocks to assemble**: you have to host them, train them on your schema, manage connectors, governance and maintenance. It's a data project, not an off-the-shelf tool.
### Business platforms: Ask This Guy

**What they do best.** Combine the advantages of the two previous approaches, fully managed. **Ask This Guy**, through its Talk to Data solution, is a data pure-player **and more**: it connects to your live sources, cross-references a structured query with your documents, applies your business context and permissions, without you having to build anything.
Thanks to **RAG**, a single question can fetch an answer from your **SQL database**, from **another system** (CRM, ERP), from your **office documents** (Excel, Word, PDF, SharePoint), and even from the **web**, then combine it all into a single response.
We'll come back to this below.
## Summary table
| Family | Example | Connection to sources | Skills required | Best for |
| --- | --- | --- | --- | --- |
| **Spreadsheets** | | Manual import | Low | Modelling, simulating |
| **BI platforms** | | Connected | Low in daily use (initial setup) | Tracking recurring KPIs |
| **Languages / notebooks** | | Connected | High in daily use | Advanced, industrialized analyses |
| **Scientific computing** | | Import / connected | High in daily use | Statistics, research |
| **General-purpose AI** | | Manual import | Low | One-off analysis of a file |
| **Pure-play data tool** | | Connected | Low in daily use (initial setup) | Custom text-to-SQL building block |
| **Business platform** | | Multi-source | Low in daily use (initial setup) | Querying and cross-referencing your data |
## How to choose: the right family for your need
Rather than looking for a single winner, start from your need:
- **Track recurring indicators** (revenue, margin, cash) → a BI platform.
- **Build a model or a budget** → a spreadsheet.
- **Analyze an isolated file, once** → a general-purpose AI.
- **Process large volumes, industrialize an analysis** → languages and notebooks.
- **Run scientific statistics** → a specialized suite.
- **Query your connected sources in natural language, cross-reference data and documents, without coding** → a business conversational platform.
A single team often juggles several families. For the specific case of management control (where Excel, dashboards and AI complement each other), we wrote a [dedicated decision guide](https://www.askthisguy.com/en/blog/financial-analysis-without-excel).
## Talk to Data: the conversational layer in practice
Most of the families above share a common blind spot: the **unplanned question**, the one with no dedicated slot in a report, which today ends up in an Excel file or in IT's queue. That's precisely what a business conversational platform fills.
**Talk to Data**, Ask This Guy's solution, connects to your real sources (**SQL database, ERP and CRM such as Sage or Salesforce, Excel, SharePoint, documents via RAG, MCP, API**) and answers your questions **in natural language, with your business context**. Concretely, it brings what no spreadsheet, dashboard, or general-purpose chatbot combines on its own:
- **understanding of business context** (your terms, your rules, your reference data);
- **cross-referencing heterogeneous sources thanks to RAG**: a single question can query your **SQL database**, **another system** (ERP, CRM), your **office documents** (Excel, Word, PDF, SharePoint), and a **web search**, combining it all into one coherent answer — as we explain in our article on [accessing enterprise data with AI](https://www.askthisguy.com/en/blog/databases-gold-mine-ai-shovels);
- **chart generation** and **Excel/CSV export** to rework the results;
- respect for **permissions** and **read-only** operation, under IT control.
Where an open-source pure-player asks you to build and maintain everything yourself, a managed platform makes analysis directly accessible to your business teams.
**If you only remember one thing…** Don't pick a tool out of habit, but based on the nature of the need.
- KPIs to track over time: BI platform.
- Model to build: spreadsheet.
- Open question on your connected data: natural-language conversation.
These families complement each other far more than they replace one another.
## Frequently asked questions
### What are the tools for doing data analysis?
There are five main families: **spreadsheets** (Excel, Google Sheets) for modelling; **BI platforms** (Power BI, Tableau, Qlik) for tracking KPIs; **languages and notebooks** (Python, R, SQL) for advanced analysis; **scientific computing** (MATLAB, SAS, SPSS) for research; and **conversational AI** (ChatGPT, Wren AI, Ask This Guy) for querying your data in natural language. Each answers a different need — see the summary table above.
### What tool should I use to analyze data without knowing how to code?
A spreadsheet for a simple calculation, a BI platform to track indicators, and a **conversational platform** (like Ask This Guy) to ask open-ended questions about your connected data. Languages like Python or suites like MATLAB, on the other hand, require real technical skills.
### Can Power BI answer questions in natural language?
Partly, through Copilot. But this conversational AI remains limited on open-ended questions, and it relies on a paid **Fabric or Premium capacity** at the organization level, which is particularly expensive.
### What is conversational business intelligence?
It's a layer that sits **on top** of your data, letting you query it in natural language rather than through a fixed dashboard or a SQL query. The dashboard tracks your KPIs over time; the conversation explains the gaps and explores the drivers. The two are complementary.
### What data analysis tool is right for an SME or mid-market company?
It depends on the need, but two criteria matter a lot for an organization without a large data team: **connection to real sources** without a heavy technical project, and **control over access rights**. A managed platform that queries your existing data in natural language often offers the best value-to-effort ratio.
---
The landscape of data analysis tools has never been richer, and it's not about to get simpler. The right strategy isn't to pick a single camp, but to put **each family in its place**, and plug the new conversational layer in wherever the others reach their limits.
**[Book a demo](https://www.askthisguy.com/en/demo/)** to see **Ask This Guy** answer, live, a real question about your data.
---
# Management control: how to combine Excel, Power BI dashboards and AI?
URL: https://www.askthisguy.com/en/blog/financial-analysis-without-excel/
Language: en
Section: Blog
*"Why did margin drop in the Western region this quarter?"*
A CEO asks this in thirty seconds. Answering it — with proper analysis and clean formatting — takes several hours. **Management control** teams know this gap well: between the question and the figure, there's a connection to a system, an export, VLOOKUPs and SUMIFs, a file to reconcile, and a polished slide or email to explain the results.
Faced with this kind of request, two reflexes come naturally:
- dig into the **Power BI** dashboard (or Tableau, or similar) to see whether the answer is already there;
- reopen an analysis **Excel** and rebuild the calculation.
When all you'd really like is to ask the question in a chatbot and get the inputs you need for the analysis. That's what Ask This Guy's **[Talk to Data](https://www.askthisguy.com/en/solutions/talk-to-data)** solution enables, for example.
The three tools remain complementary, though. This article offers a simple framework to know which one to use, and when.
## Three families of tools, three uses
Before choosing, you need to see clearly what each tool does best — and where it falls short.
### Excel: the Swiss Army knife of analysis
Excel is unbeatable for **modelling**: building a budget, simulating a scenario, presenting it with maximum transparency on assumptions and inputs. That's why it's everywhere in finance.
But as soon as it's used for **recurring data analysis**, the limits show up fast:
- no automated mechanism to import up-to-date data;
- every new question requires new processing and formulas;
- formulas pile up, become fragile, and one misaligned cell throws everything off;
- the result is **hard to reproduce**: six months later, nobody knows how the file was built (because it's rarely documented);
- the analysis depends on whoever masters the workbook. The day they're away, the information is too (same root cause).
Excel remains essential and will for a long time — and it even has [its own e-sport](https://www.youtube.com/watch?v=M0qha4l3Tls).
### Dashboards (Power BI, for example): tracking KPIs over time
A **dashboard** is built for one precise thing: tracking indicators **over time**. Revenue, margin, cash, receivables. You see the trend, in a stable, shared visual format. That's exactly what regular **financial reporting** needs.
Its main advantage over Excel is that it updates automatically, and offers a more intuitive, guided interface for its users.
But as soon as a question falls outside the grain modelled by the report developer ("rank sales reps by order loss this quarter vs. Y-1"), you have to go back to them for an answer — maybe right away, maybe in a week.
### Conversation with AI: querying your data in natural language
This is the newest tool. The idea: **query your data in natural language**, the way you'd ask a colleague, and get a figure, a chart, even an export, right away.
It replaces neither Excel nor dashboards. It fills the gap between the two: **one-off, unplanned questions**, the ones that have no dedicated slot in a report and that, today, end up in an Excel or in IT's queue.
## The real question: "track" or "understand"?
It all comes down to a simple distinction.
A dashboard answers the **"what?"** question: *what* is revenue, *what* is margin, *how* is cash evolving. It shows what's moving.
Conversation answers the **"why?"** question: *why* did margin drop, *which* customers slipped, *what* combination of factors explains the gap. It helps you understand.
> The dashboard tracks your KPIs over time; the conversation explains the gaps and explores the drivers.
Recurring **financial reporting** clearly belongs to the dashboard world. One-off **financial analysis** questions are still handled in Excel today. But they can already be handled more efficiently with AI.
## A simple decision framework
Rather than pitting the tools against each other, ask yourself one question: **is my need recurring and structured, or one-off and exploratory?**
| Your need | Right tool | Why |
| --- | --- | --- |
| Track a recurring KPI (revenue, margin, cash) | Dashboard | Stable, shared, time-comparable visual format |
| Build a complex model or budget | Excel | Unmatched modelling flexibility |
| Think through product pricing | Excel | Unmatched modelling flexibility |
| Redo the same calculation every month | Excel or dashboard | Reproducible once the model is set |
| Answer a one-off, precise question | Conversation (AI) | No new report to build |
| Cross several sources (ERP + CRM + Excel) | Conversation (AI) | Avoids manual exports and VLOOKUPs |
| Understand *why* a figure moves | Conversation (AI) | Explores the drivers, not just the totals |
## The same question, three paths
Let's take a concrete case. *Atelier Norca*, a fictional industrial SME, sees its margin fall in the Western region in Q3. The management controller has to understand why. Here are the three possible paths.
**Excel path.** They export sales from the ERP, the customer base from the CRM, paste it all into a workbook, build a model and reconstruct the impact of the different factors. Thirty-odd minutes later, they have a lead — provided they didn't pick the wrong tab or period.
**Dashboard path.** They open the dashboard. They **see** the drop, clearly, on the regional curve. But the report is built by region, not by customer or product. To dig deeper, they have to request a new view from the report designer. The answer will wait.
**Conversation path.** They ask the question in natural language: *"Western region margin in Q3 vs Q2, explore each factor that could explain the gap."* They get the figure, a chart, the **Excel/CSV export** if they want to rework the data, and a summary email. In under a minute they identify the key causes.
When visitors can express themselves freely, you capture a much richer signal than a checked box. They spontaneously tell you what interests them, what blocks them, and what brought them to your website.
A good chatbot must achieve three goals:
- First, **satisfy the visitor** by answering their immediate need.
- Then, **understand their deeper need**.
- Finally, **book a meeting** if it is relevant for you.
## The ideal conversational journey
The most effective journey is not a funnel. It is a conversation with a clear intent.
The diagram traces a visitor's typical path: an open question, a useful answer, then a light qualification that leads to a meeting when the profile fits, or to a useful resource when the timing is not right yet. Only the first path reaches the CRM.
Lead capture happens after value. The visitor has received an answer, the chatbot has understood their context, and the meeting becomes the logical next step. ## Example: from a vague question to a qualified lead A visitor reads an [article about deploying an LLM locally in an enterprise](https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/). They open the chatbot and ask: > *"I am trying to understand whether deploying our own AI infrastructure is really a prerequisite, as my CIO colleague keeps telling me."* The first step is to answer the customer's question, not dodge it, while digging deeper to learn more about their context. After a few messages, the real issue becomes clear: the user is a customer service manager who wants to reduce the number of incoming requests, and wants to understand whether the internal objections are legitimate. Before booking a meeting, they need a presentation they can circulate internally. That is it: the relationship between the visitor and your company has begun. Now it is the sales team's turn. They have all the context and information they need. This exchange is illustrated in this [demo video](https://www.youtube.com/watch?v=QbZBn3GnCFI). ## Is it complicated to implement? No. Most companies know their website could be improved and want to clean up their content first before getting started. That is a mistake. The better your source content, the more precise the answers will be, of course. But it is not a blocking prerequisite. The fastest lever is often the quality of the **instructions** and **conversational scenarios**. In one well-run hour of work, you can already define: - what the chatbot needs to know; - which offers to suggest depending on the need; - useful qualification questions; - the signals of a warm prospect; - the right moment to suggest a meeting; - the minimum information to collect. Even with average source content, the chatbot can clarify the offer, guide visitors to the right pages, ask the right questions, and send a clean summary to the sales team. With excellent source content, it naturally becomes even more relevant. ## Timing matters as much as the message You should not wait for visitors to actively look for the chatbot. Some signals show that they may need help: they stay on a page for a long time, read a technical article, return several times to an offer, or hesitate on a contact page. In those moments, displaying a discreet invitation automatically can make the difference: > *"Do you have a question about this approach? I can help you see whether it applies to your context."* The right chatbot does not constrain. It offers useful help at the right time. ## The Ask This Guy approach At **Ask This Guy**, our approach starts from a simple idea: the conversation with the visitor must be useful and valuable, not restrictive. The ATG chatbot relies on your website, your sales arguments, and your tone. It answers questions, qualifies the visitor, collects contact details naturally, then notifies your sales team with a summary of the exchange. The information can also be sent to your CRM or calendar tool. Implementation is deliberately simple: define the instructions, configure the chatbot, then add a few lines of code. On B2B company websites, we generally see **30 to 50% more leads** when the chatbot is well positioned and properly instructed. You can discover the solution here: [ATG website chatbot](https://www.askthisguy.com/en/solutions/website-chatbot), or watch the video [Finally turn your B2B website into a business channel](https://www.youtube.com/watch?v=QbZBn3GnCFI). ## Want to learn more? Chat with our bot or [book a meeting with us](https://www.askthisguy.com/en/demo/)! --- # Contextual AI for your company: 6 concrete productivity gains URL: https://www.askthisguy.com/en/blog/contextual-ai-rag-use-cases/ Language: en Section: Blog General-purpose AI tools have become part of everyday business life. They can write, rephrase, summarize, generate ideas, or prepare documents. Used well, they increase **individual productivity**. Contextual AI for the company goes further. Everyone works from the same knowledge base: procedures, offers, contracts, customer history, studies, technical files, internal rules, business vocabulary and tools. Technically, one of the key building blocks for this is called **RAG** (*Retrieval-Augmented Generation*): a method that lets AI search your internal sources before answering. We explain it in our article [How RAG transforms your AI into an expert on your company](https://www.askthisguy.com/en/blog/rag-tutorial/). In this article, we focus instead on usage. ## Individual AI can make fragmentation worse The first instinct is often to let every employee use a general-purpose AI tool. Everyone saves time, everyone tests their prompts, everyone works with their own documents. But this can reinforce a problem that is already very common in companies: **information fragmentation**. One salesperson starts from an old proposal. Another keeps their own sales pitch. A new employee learns the rules in fragments. A key person is asked ten times a week to share the same information. General-purpose AI then accelerates each individual bubble, but it does not create **shared knowledge**. ## Why not let employees use a public AI tool? Public AI tools remain useful for thinking or writing. But they have three limits for a company. - **Confidentiality.** In practical terms, internal documents will be used to train AI models. In other words, your confidential information may very well be given to a competitor making a request to the same model in six months or a year. **An untraceable and irreversible data leak.** - **Time lost loading context.** Each employee has to find the right files, check versions, attach them, explain the context, then verify the answer. - **No mutualization.** Employees generally keep using the files and resources they already know, even when they are not the most up to date or relevant. This prevents good practices from spreading: everyone stays within their own logic, duplicates and version errors persist, and truly useful information circulates poorly from one team to another. Contextual AI addresses this limit. It connects to useful sources, respects permissions, cites its sources and helps shared knowledge emerge. ## The hidden cost of interruptions The problem is not only the time lost searching for information. It is the **time lost giving information** that becomes expensive: messages, follow-ups, quick calls, improvised meetings, requests to the same internal experts. The [ActivTrak State of the Workplace](https://www.activtrak.com/resources/state-of-the-workplace/) reminds us that interruptions are the top productivity barrier across all categories of employees, cited by **53% of workers**. Information that cannot be found does not only slow down the person searching. It also interrupts the person who provides it. In a company, this mechanism becomes costly because it repeats several times per hour. A good contextual AI does not only answer faster. It also helps **avoid disturbing the wrong person to find the right information**. **Here are some concrete productivity gains from deploying contextual AI** ## 1. Reduce time lost searching for or transmitting information **Key gains:** ⏱️ time saved. Where is the latest pricing grid? Which rule applies to this customer case? Who worked on this topic before? Which version of the procedure is still valid? Contextual AI answers by relying on your documents, histories, knowledge bases and business tools. It does not replace internal experts. It prevents them from being interrupted for **repetitive questions**. ## 2. Accelerate training and change management **Key gains:** ⏱️ time saved; 🎓 better training. Every major change consumes a lot of energy: new rules, new tools, new doctrine, new regulatory obligations. Take the e-invoicing reform. The classic approach is to produce materials, organize training sessions, distribute general documents, adapt them to the company, then answer questions one by one. This takes time from those who prepare, those who present and those who attend. A contextual chatbot can be configured quickly with official documents, company-specific rules, internal procedures and business vocabulary. Each employee asks their questions when they need to: *"Is this customer affected?"*, *"Which procedure should I apply for this case?"*, *"Where can I find the right template?"* The result is more effective than a single training session: less passive information, more useful answers, and a **more consistent doctrine**. ## 3. Prepare customer meetings and detect opportunities **Key gains:** ⏱️ time saved; 📈 increased sales. A salesperson does not only lose time selling. They lose time preparing: account history, contracts, support tickets, offers already sent, past objections, incidents, open opportunities. Contextual AI can prepare an actionable summary before the meeting and surface **weak signals**: an option never proposed, a recurring need in support tickets, a contract nearing expiry, a similar customer case to reuse. AI then goes beyond being a simple writing assistant. It becomes a commercial capitalization tool. ## 4. Give management direct access to real information **Key gains:** ⏱️ time saved; 🎯 better strategic decisions. In many organizations, information moves upward through successive layers: summary, spreadsheet, meeting, rephrasing, arbitration. The leader receives a useful version, but one that is already filtered. These **management filters** can sometimes distort information, intentionally or not. A field issue may be minimized. A sales objection may be rephrased. A weak signal may disappear because it does not fit the usual reporting format. Contextual AI gives management more direct access to the company's real knowledge. A CEO, sales director or business unit leader can ask: - *"Which complaint reasons have increased over the past three months?"* - *"Which customers have already asked for this feature?"* - *"Which objections come up most often for this offer?"* Management gains autonomy and reduces the need for coordination: fewer meetings to get a first view, fewer ad hoc requests, fewer successive rework steps. Above all, managers stay better connected to the field, with less distortion between operational reality and decision-making. Some people even think that with AI, management becomes obsolete. That is probably excessive, but the time saving is real. Managers can then focus on higher-value tasks than transmitting information. ## 5. Reduce errors caused by outdated document versions **Key gains:** 🛡️ lower costs from errors. Wrong versions are expensive: an old sales proposal, a replaced quality procedure, a contractual clause copied from an old customer, an obsolete product sheet. A general-purpose AI uses what it is given. If an employee attaches the wrong file, it will produce a clean, convincing, but potentially false answer. Contextual AI can prioritize **official sources**, recent documents, validated spaces, access rights and approved content. Avoiding one error in an offer, a procedure, a customer commitment or a quality decision can fund a large part of the project. ## 6. Reuse existing work: R&D, proposals, studies, content **Key gains:** ⏱️ time saved; 🧠 higher technical level. A company produces far more knowledge than it imagines: R&D studies, benchmarks, prototypes, technical notes, competitive analyses, sales proposal content, RFP responses, training materials. The problem is rarely a lack of content. The problem is knowing that this content exists. Contextual AI helps teams **never start from scratch**: find a study, reuse a paragraph from an old proposal, identify a similar benchmark, retrieve an already validated technical answer, mutualize work across teams. For a proposal, this avoids rewriting what already exists. In R&D, it avoids redoing a study or losing a hypothesis that has already been tested. ## What to measure to talk about ROI A contextual AI project should start from a clear operational pain point: information search, training, sales preparation, management coordination, version errors or content reuse. Measure simple things: search time avoided, requests to internal experts, training speed, sales preparation time, documents reused, errors avoided, meetings shortened. ROI does not come from a grand magical effect. It comes from **hundreds of micro-frictions removed**. ## Ask This Guy's approach At **Ask This Guy**, we approach contextual AI as knowledge infrastructure, not as a simple chatbot connected to a drive. ATG can connect [knowledge connectors](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors), process [complex documents](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-processing), and add [custom business tools](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools). General-purpose AI tools can remain useful for individual uses. But if your goal is collective productivity, information quality, sovereignty, content reuse and consistent practices, you need an approach adapted to your company. ## Conclusion: productive AI is AI that knows your company Public AI has shown what models can do for an individual: write faster, summarize faster, think faster. The next step is different: making AI itself make the company more productive. That requires AI capable of understanding your sources, rules, formats, history, doctrine and vocabulary. AI that does not leave each employee inside their own document bubble, but helps the whole organization share and reuse its knowledge better. **[Book a demo](https://www.askthisguy.com/en/demo/): we will help you identify the first contextual AI use case capable of producing a measurable productivity gain in your company.** --- # Enterprise RAG: 5 mistakes that show up after the POC URL: https://www.askthisguy.com/en/blog/enterprise-rag-production-mistakes/ Language: en Section: Blog A **RAG** (*Retrieval-Augmented Generation*) is an architecture that lets an AI search your internal sources before answering: documents, knowledge bases, procedures, contracts, sometimes databases or the web. If the topic is new to you, start with our doc page on [Data and RAG](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag). Enterprise RAG is often deceptively easy to set up. In a few hours you can have a compelling first demo. You pick ten well-chosen documents, run them through a pipeline, and the assistant already answers questions that feel like real use cases. Picture an HR team testing an internal assistant. You give it the staff handbook, the collective agreement, three leave policies, two notes on remote work, and an FAQ. An employee asks: "How many remote-work days can I take per week?" The assistant finds the right passage, synthesizes the answer, cites the source. Everyone smiles. The POC is approved. Then comes production. You are no longer answering ten questions over ten clean documents. You have to absorb thousands of files, multiple conflicting versions, access rights, product names, customer references, tables, scanned documents, internal jargon, and busy users who rarely phrase requests like in a demo. No wonder [95% of enterprise AI projects fail](https://fortune.com/2025/08/18/mit-report-95-percent-generative-ai-pilots-at-companies-failing-cfo/). A RAG almost never fails because the idea is bad. It fails because **the company mistakes a successful demo for a production-ready system.** Here are five mistakes we see regularly with our customers. ## Mistake #1: treating the POC as reality RAG’s first trap is how easy it looks. For a demo the path is short: pick a small corpus, convert files, chunk text, compute embeddings, retrieve relevant snippets, then generate an answer. That chain works fast when documents are clean and the topic is narrow. A production system does not work in a staged setting. In a real company, documents are rarely uniform. You have PDFs exported from Word, slide decks, Excel spreadsheets, screenshots, tickets, contracts, meeting notes, and often files no one can really trace. The problem is not just volume. It is diversity, document status, and inconsistency across sources. A 2023 procedure can still be semantically relevant but superseded by a 2026 note. A client contract can include an exception that contradicts the general rule. A sales slide can simplify a product that technical documentation describes differently. You also have to "teach" the model the company vocabulary: internal acronyms, product nicknames, project names, business abbreviations, old names people still use. Without that work, the assistant may search the wrong place or miss information that is actually there. > Enterprise knowledge is not a pile of files. It is a set of sources, versions, rights, priorities, and shared vocabulary. To go to production, you need to decide which version is authoritative, which files to ignore, which rights to apply, how to handle contradictions, and how to cite sources. That sounds like admin work. In practice, it drives trust. ## Mistake #2: depending on a single AI vendor Companies expect an internal tool to be available, fast, and stable. The implicit reference is often mature SaaS: 99.99% uptime, predictable response times, few visible glitches. With AI models, that expectation collides with a harsher reality. Vendors are powerful, but they do not always behave like classic infrastructure. Latency varies, some requests fail, models can be temporarily unavailable, performance shifts with load, region, or internal updates. At ATG we continuously measure API response times across many AI providers. The benchmark below compares success rates for several providers on text-generation tasks.  Caution: this chart only shows success rate. It says nothing about latency. A provider can show an excellent success rate but still be too slow for a good user experience (notably OpenAI). The takeaway is simple: if your RAG depends on a single AI vendor and a single model, the whole user experience depends on that one layer. A better approach is to design for rerouting: - several AI providers for the same class of task; - several models depending on question complexity; - fallback paths when a request fails; - monitoring for latency, errors, and quality; - dynamic selection of the best-fit model. **The right goal is not to find the perfect vendor. It is never to depend on just one.** ## Mistake #3: thinking you can just deploy your own AI model Then the fix sounds simple: deploy your own model. On paper it is appealing. You reduce external dependency, you control infrastructure, you keep a tighter grip on your data. And if RAG returns the right snippets, the model only has to write the answer—right? Not really. Real user queries are rarely clean. A user does not ask: > What is the procedure for validating paid leave? They ask something more like: > uhh so Sophie on support wants to take 3 days off right before the rush, she’s already kind of maxed it this quarter no? can we say no or how do we even handle that The system must understand the request, find the right texts, tell general policy from edge cases, avoid rubber-stamping a biased management take, and produce wording people can use. Search brings the sources. The model still has to reason. On-prem can make sense for narrow cases: simple extraction, rephrasing, classification, factual RAG in a small domain. But as soon as the assistant must handle ambiguous business questions, cross several sources, or use tools, stronger models are hard to avoid. We covered this in our article on [on-prem LLMs](https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/). The key point: running a robust model with good performance is expensive, especially with many concurrent users. So the right strategy is not a one-time choice of cloud vs. on-prem, small vs. large model. It is **smart routing**: a light model for simple tasks, a heavier one for complex reasoning, a specialized model for embeddings or vision, an alternate provider when the first is slow. ## Mistake #4: relying on vector search alone Many RAG projects start with pure vector search. That makes sense: embeddings are at the heart of modern RAG, and semantic search is impressive. It can find a passage even when the user’s words do not match the document. "Remote work policy" can match "arrangements for working from home." "How do I report an absence?" can match "sick leave procedure." But companies handle huge amounts of information that does not have a universal semantic meaning. A customer name, a product code, a project ID, a contract number, an internal acronym, or a colleague’s name does not "mean" much to an embedding. `ACME-0427`, `Project Atlas`, `PRD-19-B`, `John Smith`, or `Horizon Pack` are keys—not concepts. If your RAG is built only on semantic proximity, you risk missing exactly what users are looking for. That is why a solid RAG combines (at least) semantic search, keyword search, metadata, and source prioritization by reliability. The RAG must also learn to arbitrate between conflicting documents: date, owner, status, scope, official source, contractual exception. Otherwise it is not answering from "enterprise knowledge." It is answering from a pile of files. > A good RAG does not just find a nearby passage. It finds the right passage, in the right document, with the right level of authority. ## Mistake #5: thinking users only want to search The last trap is often discovered too late: users do not only want to search. At first they are impressed by an assistant that answers from internal documents. Then, very quickly, they want more: - "Can you draft a Word summary for me?" - "Go check if this is still true on the internet." - "Compare this procedure with the client’s contract." - "Email me the summary." - "Search the CRM." - "Give me a usable table." In other words, they do not see the tool as "just a RAG." They see it as a **work interface**. If your solution can only do document search, usage will hit a ceiling fast. That is where agentic architectures, tools (web search, document generation, etc.), and protocols like [MCP](https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/) matter. But adding tools is not enough. You also need a smooth interface, integrated with existing habits where possible, and clear enough that users know what the assistant can do. Finally, you need measurement. A RAG system is not validated with five questions in a project meeting. It is validated with hundreds, then thousands, of representative questions: simple, ambiguous, out of scope, with proper names, on old documents, with conflicting sources, or requiring a tool. You generate realistic questions, review user feedback, track failures, analyze cited sources, measure response time, and rerun test suites after every change. ## If you remember one thing A RAG is easy to start and hard to industrialize. The demo shows potential. Production exposes constraints: document governance, business jargon, inconsistencies across sources, AI vendor availability, model routing, hybrid search, tools, interface, and quality measurement. The real challenge is not plugging an AI into your documents. **It is building a reliable system that knows what to search, where, for whom, with which model, and with what level of confidence.** ## The Ask This Guy approach At Ask This Guy we treat RAG as a production building block, not as plain vector search. We connect the company’s document sources, adapt processing to real-world formats, combine semantic search, keywords, metadata, and reranking, use several models and AI vendors as needs dictate, integrate tools or MCP servers when the use case calls for it, and track performance and user feedback. The goal is not to promise a magic assistant. The goal is a reliable, explainable, useful system that can improve with how you work. If you are planning enterprise RAG, start with the right question: not "can we do a demo?" but "what has to hold when 500 users ask real questions on real data?" **[Book a demo](https://www.askthisguy.com/en/demo/)** to see how Ask This Guy can help you move from promising RAG to RAG that is actually usable in the enterprise. --- # Getting AI automation right: use as little AI as possible URL: https://www.askthisguy.com/en/blog/use-minimal-ai-automation/ Language: en Section: Blog Do you want to **automate** repetitive tasks with **artificial intelligence**? The real question is not only *what AI can do*, but **what it actually should do**. Because yes, AI now makes it possible to build automations faster. But in production, the best strategy is often still the simplest one: > **Use AI only when there is no reliable solution without it.** This article answers a very practical question: **how can you build AI automation without making your system more fragile, more expensive, and harder to maintain?** ## If you remember only one thing... If a task can be **fixed**, **ruled**, and **tested**, it should usually be automated in a traditional way. If a task requires **understanding context**, **rephrasing**, **personalizing**, or **structuring fuzzy information**, then AI becomes relevant. In other words: - **traditional code** handles the predictable; - **AI** handles the unpredictable; - **humans** keep control where mistakes are costly. ## The real trap: trying to put AI everywhere Since the arrival of ChatGPT and other AI assistants, one reflex has appeared in many companies: *“With AI, we should obviously be able to automate this.”* The reflex is understandable. The demos are impressive, use cases keep multiplying, and the **benefits of artificial intelligence for business automation** are easy to see. But there is a common bias: people start with the **AI solution** before defining the **business problem**. So the right question is not: > *“How do we add AI to this process?”* The right question is: > *“Which part of this process truly requires AI?”* And very often, the answer is: **only a small part of it**. ## Yes, AI changes the game... especially for building faster Saying that you should use as little AI as possible in production does not mean minimizing its impact. Quite the opposite: **AI has already transformed the way automation systems are built**. Where teams previously had to: - code everything by hand; - assemble sometimes fragile no-code scenarios in Make, n8n, or Zapier; - or give up because the project seemed too expensive; it is now possible to build systems faster that are: - **robust**; - **maintainable**; - **cheaper to run**; - and therefore profitable for use cases that were not viable before. In short, AI is excellent as a **design accelerator**. It becomes much less interesting when you delegate **every execution** to it for operations that could be handled deterministically. ## Two types of automation to distinguish To make good decisions, you need to separate two different logics. ### 1. Deterministic automation (handled with scripts / workflows) The same input always gives the same output. This is the world of rules, templates, calculations, mappings, scripts, and well-defined workflows. In practice, this is what you should favor whenever possible, for three reasons: - **Reliability**: behavior is predictable. - **Efficiency**: execution costs stay low. - **Speed**: you avoid unnecessary checks. ### 2. Probabilistic automation (handled with AI) Even with the same instruction, the result may vary slightly. That does not mean it is bad. It means this approach should be used **where variability is useful**, not where it becomes a risk. In general, AI is relevant when you need to: - understand rich context; - analyze varied documents (PDFs, scans, attachments, etc.) to retrieve information that appears in different forms; - summarize unstructured content; - write personalized text; - classify or rephrase ambiguous information; - transform raw data into an exploitable structure. ## The practical rule When a task is **repetitive**, **stable**, and **clearly defined**, try it first **without AI**. When a task depends on **context**, **language**, **nuance**, or **poorly structured** data, AI can bring real value. > **AI is not here to replace rules. It is here to handle what rules alone do not capture well.** ## Practical example: automating purchase orders Let us take a very simple example: generating **purchase orders**. You start with a Word template for the final document and data that must be injected into it. In some cases, that data is already in an Excel file. In others, it is scattered across emails, meeting notes, or several files. ### Case 1: when the input is messy Before generating the document, you sometimes need to **create the input** itself. The information may be spread across: - an email exchange with the client; - a scoping meeting; - quickly written notes; - a PDF sent by the client. At this stage, AI is very useful. It can read these sources, extract the right information, and produce a **draft Excel file** or an equivalent structured output. That output is then **validated** by a human before the rest of the process is triggered. In other words, AI is used here to **bring order to ambiguity**. ### Case 2: everything that can be fixed should be fixed Once the data has been validated, the logic changes. Fields such as: - `{{CUSTOMER_NUMBER}}` - `{{ORDER_DATE}}` - `{{ITEM_COUNT}}` - `{{TOTAL_AMOUNT}}` do not require any artificial intelligence. A script can fill the document reliably, instantly, and reproducibly. This is exactly where you should avoid calling a model. And this is not limited to simple fields. Entire **text blocks** can also be handled deterministically. For example: - if the client is in France, keep legal clause A; - if the client is outside the EU, insert export clause B; - if the amount exceeds a certain threshold, add the internal validation paragraph; - if the product is a subscription, keep the renewal terms; - otherwise, keep a simpler version of the document. In other words, even the choice of a **paragraph**, a **clause**, or a **full section** can often be driven by very clear business rules, with no AI at all. ### Case 3: where AI becomes truly useful Now imagine that your sales team loses time manually writing a short personalized introduction for each client. The need is not to fill a field, but to produce a text such as: *“Dear [Client Name], we are delighted to have been supporting you since [Date of First Order]. Your loyalty means a lot to us, and we hope this new batch of [Product Type] will meet your expectations for [Current Project].”* Here, you need to take into account the right tone, the relationship history, the product type, the commercial context, and the client’s current project, while integrating this information naturally into the text. In this case, AI can prepare a first draft from well-structured context. The user reviews it, corrects it, adds their own touch, and validates it. ### Workflow summary ```mermaid flowchart LR A[Raw sourcesEmails, meeting audio, PDF, etc.] --> B[AI
Extraction and structuring
Excel generation] B --> C[Human validation] C --> D[Deterministic automation
fields, clauses, conditional paragraphs] C --> E[Contextual AI
personalized introduction] D --> F[Word document assembly] E --> F F --> G[Finalization] ```
The diagram summarizes a document's path: raw sources (emails, meeting audio, PDFs) go through AI extraction that produces a structured file, which a human validates before anything is produced. From there the flow splits in two, deterministic automation for whatever is settled in advance and contextual AI for the few passages that call for judgment, before the Word document is assembled.
## Why not just hand everything to your favorite AI? On paper, the promise is appealing: *“I provide the template and the data, and the AI generates the whole document.”* But a generative model tends to modify things it should not touch: layout, numbers, certain labels, or sensitive wording. A few small mistakes are enough to wipe out the time savings. And above all, a prompt that works today may behave differently tomorrow. That is why good automation rarely relies on one big prompt alone. It relies on a **clear architecture**, with a precise role assigned to AI. ## The first question is not technical: it is ROI Before talking about tools, workflows, or prompts, you need to measure the **actual time your team is losing**. Without a serious estimate of the human time involved, it is hard to know whether the automation is worth it. These are the right questions to ask: 1. How many hours does the team spend on this task? 2. How often does it come up? 3. What is the full cost of the automation? 4. What will the maintenance cost be in 6 months, 12 months, and 24 months? 5. Is the cost of an error low or high? Some simple benchmarks: - If you **outsource** the project, aiming for **at least 2x** is a reasonable minimum. - If you build it **internally**, it is better to aim for **at least 4x**, because the gain is often less direct and more diffuse. - In every case, include **maintenance** in the calculation. It is often the most underestimated part. If you miss this point, you may end up funding a nice demo instead of a real, lasting gain. ## What to remember **AI automation** is not a question of how much AI you use. It is a question of **where you place it**. The more you manage to: - fix what can be fixed; - reserve AI for what is truly contextual; - and keep targeted human control; the more likely your automation is to remain useful over time. ## How this connects to ATG At **Ask This Guy**, this is exactly the approach we promote with **ATG**: using **agents** and **tools** to connect AI intelligently to your data and systems, without turning your whole process into a probabilistic black box. To go further: - [Customize ATG](https://www.askthisguy.com/en/doc/customizing-atg-to-you) - [Build tailored tools](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools) - [Process your data and workflows in a tailored way](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-processing) - [Configure agents](https://www.askthisguy.com/en/doc/admin-console/how-to-configure-the-agents) - [Connect tools and MCP](https://www.askthisguy.com/en/doc/admin-console/tools-management) **[Book a demo](https://www.askthisguy.com/en/demo/)** if you want to identify, in your own processes, what should remain deterministic and what truly deserves AI. --- # Your databases are a gold mine, AI gives you the shovels URL: https://www.askthisguy.com/en/blog/databases-gold-mine-ai-shovels/ Language: en Section: Blog  ## The day-to-day reality: when finding information turns into an obstacle course You’ve probably seen this scene. A manager needs a simple piece of information: - How many orders are late at the Lyon plant, and which customers are impacted? - Who are our top 10 customers this quarter? - How many people are currently on sick leave? Which departments are affected? In theory, they should open the company systems and find the answer themselves. In practice, they’ll often “ping” a colleague, or go hunting for an existing Excel or PowerPoint report — even if it means working with outdated or distorted numbers. The result: time wasted, an answer that’s often incomplete and often **wrong**. **The real cost isn’t the tool: it’s the detour.** Every ping to the “person who knows” and every recycled file without querying the source is time and decision quality going up in smoke. ## Documents vs databases: two worlds that don’t talk to each other When a company launches its AI project, what does it do first? **It ingests documents.** It connects SharePoint to Copilot, or it sets up [a RAG system](https://www.askthisguy.com/en/blog/rag-tutorial/) to query internal procedures, Confluence articles, PDFs. That’s logical: documents carry the company’s complexity — its nuances, its know-how. And before AI, no information system could really process them. But there’s a problem. Those documents are often outdated, contradictory, sometimes flat-out **wrong**. They aren’t updated regularly. They reflect a theoretical view of the company, not its operational reality. Meanwhile, **the true reference data**, the data that carries all the operational value, stays in the shadows. Your customer base, manufacturing orders, orders in progress, HR data, the state of industrial devices… all of that lives in structured systems: SQL databases, Salesforce, SAP, vertical business tools, in-house applications. **Documents tell a story. Databases carry today’s truth.** As long as you only plug your AI into documents, you only have part of the truth. This is the **most underestimated pool of value**. This data is reliable, up to date, and precise. But it’s often only accessible through complex interfaces or technical queries. The result: almost nobody looks at it. ## AI as an ultra-contextual assistant: precise answers at every step Let’s take a concrete situation: a manager wants to drive contract renewals for her business unit: - *“Which contracts are expiring this quarter for my BU?”* The AI understands the question, targets the contracts database, applies the right filters, and answers. One contract catches her attention: - *“What does contract X cover? What amount is at stake?”* The AI fetches the detailed information from the contracts database and returns a concise summary: scope of the service, subscribed options, financial commitment. - *“Remind me what the product they subscribed to is for.”* Here, the AI queries up-to-date reference documents (RAG: internal brochures, product sheets, past RFPs). - *“Who is the main point of contact on this account?”* The AI checks the CRM, identifies the right person, and answers. - *“Give me some info about them — I’m going to call.”* The AI then searches the CRM and the web: LinkedIn profile, recent news, everything that helps prepare the conversation effectively. - *“What’s the latest on this customer’s company?”* The AI analyzes web sources: recent articles, press releases, weak signals about the company’s health or news. - *“By the way, we don’t offer product X anymore, I think?”* The AI crosses all its sources: internal structured data confirms the product is no longer in the catalog; RAG on internal documents explains why; and given the customer’s market context, it adds: *“You’d be better off proposing Y, better suited to their current priorities. Here are the main sales talking points.”* With each question, the AI navigates between structured databases, expert documents, CRM, and market intelligence — delivering usable answers without juggling five windows. **One conversation, multiple connected worlds.** Contracts, CRM, internal docs, web: the point isn’t to replace your tools, but to orchestrate them as questions unfold — like a colleague who knows the entire information system. ## No more preconceived ideas: factual information, one question away When information is hard to access, companies live off preconceived ideas. *“This product takes a lot of time, but it brings high margin.”* Often, those are impressions — not facts. With an assistant connected to your databases, you get accurate answers, not approximations. Direct database queries return reliable, up-to-date numbers. Each answer is instant and factual, and you can drill down through follow-up questions. **No more** time wasted jumping between interfaces. **No more** dependency on the “people who know”. **No more** decisions based only on intuition. ## How Ask This Guy can help unlock your data **Ask This Guy** is built for this step: making structured data as accessible as your documents.  We connect your assistant to your [SQL databases](https://www.askthisguy.com/en/doc/customizing-atg-to-you/database-query), [APIs](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools), and business tools through secure [tailored tools](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-tools). Every integration is designed **security first**: the AI only executes what you authorize, with the right permissions. Rollout is progressive: start with the data that carries the most value (customers, orders, production), then expand. In a few weeks: one assistant — RAG on documents + direct database querying. **The result?** Teams become autonomous in seconds. Experts are freed from recurring extracts. Decisions get faster and more factual. Your databases are no longer a closed gold mine: they work for everyone who needs them, every day. --- # LLM On-Premises for Your Enterprise: What Can You Do with €60k? URL: https://www.askthisguy.com/en/blog/llm-local-enterprise-sovereignty-illusion/ Language: en Section: Blog Running [**open AI**](https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/) models on your own servers gives you [**control**](https://www.askthisguy.com/en/blog/souverainete-numerique-dependance-americaine/): your data stays in-house, and you're independent from providers. For enterprise AI projects - agents, RAG, internal assistants - this is attractive. Sometimes essential. But AI infrastructure costs are massive. The usual "Make or Buy" thinking doesn't quite work the same way here. This article gives you the benchmarks to decide with full knowledge of the facts. ## A few definitions to read the rest calmly - **LLM** (Large Language Model): the “brain” of the system. This is what you will deploy on your server. - **Number of parameters**: a measure of the model’s “size”. The higher this number, the more capable the model is at fine reasoning (and the more compute and memory it requires). - **Inference**: the moment when the model answers your request. We are not talking about training (which has already happened), but simply asking it a question and getting an answer. - **Token**: a small unit of text (a word or part of a word). When we say “100 tokens per second”, it means the model produces about 100 of these units each second: the higher this number, the faster the response. - **RAG** (Retrieval-Augmented Generation): a [technique](https://www.askthisguy.com/en/blog/rag-tutorial/) that gives the model access to your documents (PDFs, internal wikis, etc.) so it can answer using *your* data rather than its memory alone. Often the trigger for an enterprise AI project. - **Agentic AI**: an AI that does not just answer once; it chains steps (calling a tool, searching, reasoning, retrying) to accomplish a complex task, like an [assistant that takes initiative](https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/).  ## Not one but several models to deploy First important point: an enterprise AI project, as soon as it gets a bit advanced, does not rely on **one** model but on **several** models running in parallel: - **Main LLM**: text generation, complex reasoning, dialogue. - **Lightweight or specialised models**: fast, simple tasks (routing, extraction, naming). - [**Embeddings model**](https://www.askthisguy.com/en/blog/embedding-strategy/): essential for semantic search (RAG). - **Vision model**: if you analyse images or screenshots. - **Image generation model**: if your use case requires it. In short, in all likelihood you will start with 1 or 2 models, and over time you will end up with 5 or 6. ## Users are demanding They have become impatient: used to "consumer" services like ChatGPT that deliver near-instant responses. Speed matters. It's often what makes users accept or reject the tool. It is hard to give a single reference threshold, but below **100 tokens generated per second**, it is likely to feel slow. If the AI is **agentic** and calls multiple tools and "reasons", you should aim for **500 tokens/second** or more for a fast response. > **Reference thresholds:** > > - **~500 tokens/s**: multi-step projects, tool calls, reasoning, complex agents. > - **~100 tokens/s**: simple tasks without reflection (basic chat, completion). Users are also used to **many additional services**. For example, attaching documents to messages (e.g. PDFs) and having them processed immediately. Cloud LLM services excel at this (Gemini, ChatGPT, etc.). On-premises, you can offer it by converting the document to images and using a vision model, but that will be much slower and often limited (e.g. in terms of number of pages per document). ## Key questions to ask before deciding ### 1) What are your real use cases? - **Simple** tasks (extraction, reformulation, naming) or **complex** ones (reasoning, multi-document synthesis, tool chains)? - **Expected request volume** (peak, average, growth). - **Level of reasoning** required: is a factual answer enough, or do you need chained reasoning steps? - Need for **multi-step** and **tool-calling** (agents)? This strongly pushes toward larger models (for the orchestrator) and higher inference speed. ### 2) What response quality is acceptable? On complex queries, the gap between a medium-sized and a large model is clear: depth of reasoning, nuance, consistency. For an internal assistant or business agent, this difference can mean **users accepting or rejecting the solution.** Conversely, for very focused use cases (simple RAG, well-defined repetitive tasks), a smaller model may be enough with much lighter infrastructure. ### 3) What is your long-term vision? - **Hardware obsolescence**: will the GPUs you buy today be suited to tomorrow’s models (size, formats, frameworks)? - **Evolving needs**: will your project grow in complexity (more tools, more reasoning, more users)? - **Flexibility vs commitment**: on-premises commits you for 3–5 years; a provider lets you evolve without changing your hardware estate. ## When “small” models are enough  Several use cases are fine with lighter models: - **Simple, precise** tasks: e.g. generating a conversation name, extracting a field, reformulating a sentence. - **Simple retrieval**: basic document search, RAG with little reasoning. - **Strongly RAG-oriented** use cases with factual queries and little logical chaining. - Tasks with **fine-tuning** on a narrow domain. Models around 20 billion parameters (e.g. **mistral-small** or **gpt-oss-20b**) can be enough for this, if you accept some hallucinations and the fact that the model "won't reason". The upside: very light infrastructure, making the *Make* scenario feasible. If your use case is focused and doesn't need complex reasoning, a 20B model can work. The investment stays reasonable. But honestly? This scenario is rare. Most projects quickly grow beyond this. ## When medium or large models are essential As soon as complexity increases, **a model around 100 billion parameters becomes the minimum**. *gpt-oss-120b* from OpenAI is often deployed, both because of its vendor’s reputation and its solid performance for its size. Models above 300 billion parameters (Mistral Large, GLM, DeepSeek, etc.) are recommended when use cases include for example: - **Complex** queries with deep reasoning. - **Multi-step agents** with tool calls and chaining. - **Multi-document analysis** with nuanced synthesis and decision-making. - Tasks requiring **fine understanding** of context and implicits. The quality difference shows as soon as the query demands real reasoning or complexity. > **In short**: as soon as you target advanced agents, advanced RAG, or demanding business reasoning, large models become hard to replace without significantly degrading the experience. ## Let’s talk money ### "Make" scenario: deploying gpt-oss-120b on-premises Let's look at a 120 billion parameter model—medium-sized, good for simple scenarios. A realistic setup: **2× NVIDIA H100** GPUs. That's about **€60k** up front. According to the [Clarifai benchmark](https://www.clarifai.com/blog/comparing-sglang-vllm-and-tensorrt-llm-with-gpt-oss-120b), inference speed is: - **~200 tokens/s** for 1 user. - **~40 tokens/s** for 100 concurrent users. For multi-step and agent usage, the **500 tokens/s** target is far from reached: user experience can suffer, especially under load. Moreover, a model of this size remains insufficient for advanced use cases and complex reasoning: for those, you need to aim at larger models, which further increases on-premises infrastructure. ### “Buy” scenario: using an inference provider According to [Cerebras documentation](https://inference-docs.cerebras.ai/models/overview), advertised throughput on the same model is on the order of **~3,000 tokens/s**. At ATG we observe **1,000 to 2,000 tokens/s**, which is still **5 to 50 times** faster than the on-premises setup above. With €60k investment, you can therefore deploy a first building block of your AI project. Not very fast, not very powerful, but it still covers a few low-complexity use cases. ### Break-even calculation To choose between Make and Buy: 1. **Estimate how many tokens you'll process per year** (tricky to predict). 2. **Compare total hardware costs** (purchase, power, maintenance, aging) to API costs over the same period. 3. **Remember: hardware ages fast.** What works today might not fit tomorrow's models. APIs evolve without you buying new hardware. In theory, **Buy** can be cheaper. In practice, it rarely is—but it buys you flexibility. ## Conclusion **On-premises** makes sense for simple, well-defined use cases with strict sovereignty needs—or when you're processing huge volumes. For ambitious projects with agents and complex reasoning, **Buy** usually wins on speed and simplicity. **On-premises is often a conviction-driven choice.** Nothing wrong with that. But it's easier to implement once you've already learned what your project needs. Our recommendation at **Ask This Guy**: **start with a provider** to gain maturity, validate your use cases and volumes, then consider on-premises only if volume and specific requirements (sovereignty, long-term cost) justify it. --- *Want to deploy a high-performance AI assistant without managing infrastructure? [Book a 20-minute demo](https://www.askthisguy.com/en/demo/), we’ll show you how.* --- # How MCP accelerates agentic AI URL: https://www.askthisguy.com/en/blog/how-mcp-accelerate-agentic-ai/ Language: en Section: Blog ### Why MCP? To understand MCP (Model Context Protocol) and why it emerged, we need to look at the recent evolution of Large Language Models (LLM) like ChatGPT, Gemini, or Mistral. In late 2022, OpenAI launched its GPT-3.5 model, which achieved massive success with the general public. The model can understand complex queries, synthesize information, and produce quality content. But at this stage, it cannot act on tools or access external systems. For example, it is not yet able to fetch recent information from the web. A few months later, OpenAI introduced the concept of tools in ChatGPT, which they called "function calling". Very quickly, this concept was adopted and integrated by other market players. Today, most modern LLMs allow the use of external tools. The principle is simple: you describe to the LLM what a tool does, what information it needs as input, and what it returns as output (or what actions it can trigger, such as canceling an order). Based on the user's question and context, the model can decide to use this tool at the right time. For example: - Tool: `get_order_status(order_id)` - User asks: "Where is my order?" - The LLM understands that it should call this tool. Here's how it works :  For businesses, the ability to create dedicated tools for their AI agents open up so many time saving and automation opportunities. For example, an agent can rely on tools to check the status of a quote or order, analyze operational indicators, update a logistics status, or validate invoicing. But as tools multiply, a new difficulty appears: each tool must be specifically integrated for each agent. This is precisely the problem that MCP was designed to solve. Introduced by Anthropic (the creator of Claude) in 2024, MCP standardizes how tools and data are exposed, so that agents can: - discover them dynamically, - understand how to use them, - and call them without specific integration We move from custom integrations to AIs that can discover data and tools dynamically, truly accelerating the agentic promise for businesses. ### How does MCP work in practice? A server that implements MCP describes which tools are available, what data can be accessed, and how to use them: here's an example of a tool's input and output schema. An MCP-compatible client can then connect to this server and automatically retrieve the list of proposed tools to make them available to the agent. From there, the LLM can decide which tool to use based on the user's request and the conversation context. Let's take a simple example: an agent that helps with travel planning. To enrich this agent with surf data, the administrator doesn't need to develop a new integration. They simply need to enter the web address of an MCP server providing surf forecasts. The platform automatically retrieves the list of available tools on this server and presents them to the administrator, who can choose which ones to activate for their agent. Here's the tool discovery and selection process:  And here's how it looks in the Ask This Guy interface:  Once activated, the tools are made available to the agent on the fly, without any development. When a user chats with the agent and asks "where could I surf next week around Bordeaux", the LLM understands that it can call the find_best_session tool to answer the user:  With MCP, no application code modification is necessary; the server's tools are discovered and used dynamically. This is where the real breakthrough lies and why MCP is often presented as a universal connector, giving the ability to plug in anywhere. ### MCP and skills: their role in agentic architectures One of the main challenges for agents is knowing how to orchestrate tools to respond well to complex questions. The more tools an agent has, the more important it becomes to organize them well and guide their use, to avoid unnecessary or poorly adapted calls. Skills were introduced to meet this need. They combine tools with a reasoning layer and, sometimes, user-specific preferences. For example, a user asks "I want to surf in Bordeaux next week for less than €500". A "Surf Trip Planner" skill could call multiple tools (surf forecasts, weather, accommodation), apply business rules (user level, budget constraints), and return a tailored structured proposal. In an agentic architecture, skills operate one level above MCP. MCP exposes tools and data; skills define how to use them intelligently. The two are complementary. ### The latest evolution: MCP Apps and the future of AI interfaces Until now, the user experience in the SaaS world and that of AI agents lived in two parallel worlds. On one side, we have SaaS applications with rich but rigid graphical interfaces (UI), where each action requires navigating between menus, tabs, and forms. On the other, AI agents capable of reasoning, but limited to a text chat window: to act on your software, the agent had to either "describe" raw data to you or execute invisible commands in the background. This disconnect forced the user to constantly switch between chat and their applications to verify or validate the AI's actions. This is precisely the problem that MCP Apps solve. Launched in early 2026, this evolution of the protocol allows agents to no longer just exchange text, but to directly host interactive mini-applications within the conversation. For example, rather than reading a text summary of your sales, the agent displays an interactive graph from your CRM directly in the chat. You can filter the data with your mouse, and the agent, observing your clicks in real-time (bidirectionality), adapts its analysis as you go. This convergence between agents, tools, and interfaces will shape the future of business applications. ### Ask This Guy's approach At ATG, our approach is pragmatic. Our clients can rely on MCP servers when they help accelerate integration while developing more deeply integrated tools when these are required to improve agent performance. Skills, introduced in the Anthropic and Google ecosystems, are beginning to be adopted by certain players, particularly in the world of IDEs and developer assistants. Their trajectory is promising, but still consolidating. We already offer an approach to meet this need: each agent can be finely configured from the admin console, defining: - its instructions, - accessible tools: platform tools, client-specific tools, or any MCP tool - authorized knowledge sources, - and other options to improve the user experience in their conversation with the assistant. We support our clients in: - defining tools that are truly useful for their business, - writing specifications for their MCP server, - implementation and orchestration best practices that are fully managed on the Ask This Guy platform. If what you are really after is which use cases to hand to an agent, what one actually costs and the conditions under which it holds up in production, we have written a dedicated guide: [enterprise AI agents](https://www.askthisguy.com/en/blog/enterprise-ai-agents/). **Ready to discover how Ask This Guy enables you to create integrated intelligent assistants?** **[Book a demo!](https://www.askthisguy.com/en/demo/)** --- # How a Failed Demo Forced Us to Rethink Our Embedding Strategy URL: https://www.askthisguy.com/en/blog/embedding-strategy/ Language: en Section: Blog *Note: all the data below comes from a benchmark run on the Ask This Guy platform, and covers the period from January 5th to 25th, 2026. Requests are sent at regular intervals from an ATG server located in France, which measures response times.* ## A Tough Moment Sales call with a prospect. We’re here to present **Ask This Guy**, our AI solution that (among other things) relies on a company’s internal documents. Everything is ready, the demo is well rehearsed. I type a simple query into the interface. And then… silence. Three seconds. Ten seconds. We try to move on to another topic, we mumble a bit, but we can guess what’s going on in the client’s head and the question they’re not asking out loud: *“Does your solution actually work?”* When the meeting ends, we take a look at the logs, and the verdict is immediate: we hit the wrong moment. That day, the Mistral API took almost a full minute to respond. A one-off anomaly? Not really. As we’ll see, this is a structural problem. This embarrassing moment forced us to ask a simple but crucial question: **how do you guarantee reliable performance in production when you depend on external AI providers?** What we’ve learned since then is what we’re going to share with you. ## Back to Basics Before we dive in, a quick reminder. If you deploy an AI in your company that relies on your internal documents via a [RAG architecture](https://www.askthisguy.com/en/blog/rag-tutorial/) (*Retrieval-Augmented Generation*), you’ll need embeddings for semantic search. **What is an embedding?** Imagine that the meaning of every sentence in your documents is turned into a numerical vector - a mathematical representation of its meaning. That’s an embedding. It lets you very quickly find the piece of information that best matches a user’s need. In theory, the mechanism is simple: 1. A user sends a message 2. The system formulates one or more search queries 3. These queries are converted into embeddings (vectors) 4. These vectors are compared with those of your documents 5. The closest document snippets are retrieved 6. The answer is generated from those snippets **You see where this is going.** Every time a user sends a request, you need to compute an embedding. If that computation is slow, the user waits. If the embedding fails, there is no answer at all. That’s why embedding performance is not a technical detail: it *is* the user experience. For example, we can define an acceptable performance target like this: - **Target**: response time under 300 ms in the vast majority of cases - **Critical limit**: never exceed one second And we mustn’t forget another crucial point: **not all embedding models are equal**. The differences in answer quality can be huge - we saw this firsthand when we experimented with “average” models. If you want to compare models, HuggingFace’s [MTEB leaderboard](https://huggingface.co/spaces/mteb/leaderboard) is a very good starting point. ## Our Initial Path: The "Big Names" When we started building Ask This Guy, the choice seemed obvious: the big players in the market - Mistral, OpenAI. That’s more or less what everyone does, right? That’s indeed where we began. How good is this approach? The answer is… mixed. OpenAI’s performance sits on average around one second for the *large* model (and about half a second for the *small* model). Not catastrophic, but far from our target. Mistral, for its part, shows a better median performance around 300 ms, but with a high failure rate:  Let’s zoom in on the day‑to‑day variability, especially on Mistral’s side:  Most of the time, more than 95% of requests are processed in under a second. On paper, that’s fine. But on some days, performance is simply catastrophic. That’s what happened during our demo. And that’s exactly what our data shows, relentlessly. ## Second Problem: Lock-In Let’s assume you’ve found the perfect provider (even if we’re not quite there yet in this article). Great. But what happens tomorrow if their performance degrades? Or if their prices go up? Or if the company disappears? The natural answer is: *“We’ll just switch providers!”* Except… it’s not that simple. **Here’s the core technical problem:** comparing embeddings generated by different models doesn’t work. The vectors are not compatible. Once you’ve used a model to index your documents, you are stuck using the *same* model for queries (or you need to re‑index all your documents). That’s where model choice becomes strategic: - **If you use a proprietary model** (such as OpenAI’s), you are completely dependent on that provider. There’s no easy way out. - **If you use an open‑weights model**, you can use several providers for the same model. And that’s where things get interesting. ## The Inference Specialists Back to our benchmark results. A clear trend emerges: some providers perform significantly better than the traditional giants. These are “inference” specialists - they excel at running AI models quickly and reliably. They rely on [open‑weights models](https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/).  For embeddings specifically, **[Scaleway](https://www.scaleway.com/) and [Nebius](https://nebius.com/)** (both European!) clearly stand out among the providers we tested. And their consistency is better, especially for Scaleway, where it is remarkable:  Why is that? Probably because they are cloud infrastructure and inference specialists, whereas OpenAI and Mistral are primarily model creators. Specialization pays off. ## Is That Enough? Not quite. As good as some providers’ performance may be, there are still periods of underperformance. And the risk of vendor lock‑in remains if their performance worsens or their prices rise. To solve both problems, we chose a particularly strong open‑weights embedding model that is available from several high‑performing providers: Qwen 3 Embedding 8B. From there, two strategies are possible: 1. **The dynamic approach**: you monitor performance in real time and send each request to the best‑performing provider at that moment. If a request fails with one, you resend it to another. 2. **The “all‑out” approach**: given how low the economic and environmental cost of embeddings is (you can get below one cent per million tokens - in other words, generating an embedding is about 200 times cheaper than sending the same document to GPT 5.2 in a request), why hold back? You send the request to several providers simultaneously and take the first answer that comes back. At Ask This Guy, we went with this second approach. The result? Ultra‑stable performance, no critical dependency on a single provider, and a cost that remains very reasonable. ## A Lesson Every IT Professional Knows… But That Is Even More True With AI Building a POC is easy. Running production is a different story. In a POC, variability doesn’t really show. With a handful of queries, everything appears to work. But in production, with real users, real volumes, and high expectations, every weakness becomes obvious. The good news is that **with engineering and patience, you can work your way through any of these challenges**. Our failed demo? It cost us a few awkward minutes, but it earned us a far more robust architecture. And that is priceless. --- *Want to learn more about our RAG approach or our other real‑world AI production lessons? Feel free to [book a demo](https://www.askthisguy.com/en/demo/)!* --- # How RAG Transforms Your AI into an Expert on Your Business URL: https://www.askthisguy.com/en/blog/rag-tutorial/ Language: en Section: Blog ## **Introduction** You're using a consumer AI (ChatGPT, Mistral Le Chat, Gemini, etc.) and you're amazed by its capabilities? There's good reason to be. But have you tried asking it questions about your company's latest financial report or an internal procedure? As soon as the sources aren't public, it's powerless.  ### **The Problem: An AI That Knows Everything... Except You** AIs like ChatGPT are trained on astronomical amounts of public data. They're experts on the *world*, but not on *your* world. For an AI to be truly useful internally, it needs access to: - your internal documents - your HR policies - your business processes - your tools (CRM, ERP, drive) - your databases In short: everything that makes up your company's DNA. ### **The Limits of the "Copy-Paste" Approach** Manually adding documents to ChatGPT might seem like a quick and pragmatic solution (if we set aside confidentiality issues). But in practice: - it's time-consuming - you don't always know which files are actually relevant - you send too many documents or files that are too large, making the AI less effective - you forget documents or don't use the right versions - it doesn't integrate information from a CRM or drive **Result**: internal knowledge is never complete or structured. ## **The Context Window: The Achilles' Heel of Our Favorite AIs** AI has a very powerful working memory... but limited. This is its **context window**: it can only process a certain amount of information at once. ### **Concrete, Quantified Limits** Today, depending on the models, this window generally ranges between **400,000 and 1 million tokens**. At best, 1,500 pages. That seems like a lot. But if you send 10 documents of 300 pages, you've already far exceeded this context. ➡️ **Well beyond what an AI can digest at once.** And the more you send it, the less precise it becomes. It forgets passages or gets the context wrong. It's better to "pre-sort" what you send so that only relevant information reaches it. ## **This is Where RAG Comes In: The Solution for an "Intelligently Informed" AI** **RAG (Retrieval Augmented Generation)** is an approach where: 1. The tool connects to your sources and pre-processes documents for future searches 2. For each query, it searches for relevant "chunks" of documents *("Retrieval")* 3. It sends the AI the query enriched with these relevant documents *("Augmented")* 4. The AI then generates an accurate response based on these elements *("Generation")* It's like adding an ultra-fast and ultra-precise **librarian assistant** to your AI.  Note that RAG does not modify the model. The LLM stays the same: what changes is what you give it to read before it answers. ## **RAG and LLM: Who Does What in the Chain?** People often talk about **RAG LLM** as if it were a single technology. They are in fact two distinct building blocks, and knowing which does what avoids most design mistakes. The **LLM** (Large Language Model) is the generator. It understands the question, reasons over what it is given, and writes the answer. It knows nothing about your company and has no access to your systems. **RAG** is the layer around it. It prepares your documents, retrieves the useful passages at question time, and places them in the LLM's context before calling it. In a RAG chain, every call to the LLM unfolds like this: | Step | Who does it | What happens | | --- | --- | --- | | 1. Preparation | RAG | Your documents are chunked, embedded and indexed, ahead of any question | | 2. Retrieval | RAG | The question becomes a query, relevant passages are retrieved | | 3. Assembly | RAG | Question, excerpts and instructions are assembled into a single context | | 4. Generation | LLM | The model writes the answer from that context | | 5. Attribution | RAG | The matching sources are attached to the answer | Three practical consequences follow. **The LLM learns nothing from your documents.** It reads them on every request, then forgets them. That is good news for confidentiality, and it means an update to your sources is taken into account immediately, with no retraining. **RAG quality is decided mostly outside the LLM.** If step 2 returns the wrong passages, no model will save the day: it will write a fluent, wrong answer. In our projects, most relevance gains come from chunking, retrieval and filtering, not from the choice of model. **You can swap the LLM without rebuilding the RAG.** That is the point of a multi-model architecture: the same document foundation can be served by a fast, cheap model for simple questions and by a stronger one for complex analysis. ### **Which LLM Should You Choose for a RAG?** The answer is not "the biggest model available". Five criteria actually matter: - **Instruction following.** A good RAG LLM sticks to the excerpts provided and says it does not know when the information is missing. A brilliant but talkative model that fills the gaps from general knowledge is a poor choice. - **Citation ability.** Tying each statement back to the excerpt it came from is a skill that varies widely between models. - **Context window.** Large enough for a dozen excerpts plus conversation history, but no more: beyond that, precision degrades and cost climbs. - **Cost and latency.** An internal assistant queried a hundred times a day has a different economic profile from a monthly batch analysis. - **Language and jurisdiction.** Quality varies by language, and where requests are processed is a criterion in its own right as soon as the documents are sensitive. We cover that trade-off on our [sovereign AI](https://www.askthisguy.com/en/sovereign-ai/) page. In practice, a disciplined mid-range model outperforms a poorly framed top-tier one on an enterprise RAG. **The LLM is a replaceable component; your document chain is not.** ## **Diving into the RAG Engine: How Does It Really Work?** *To go further, check out our [detailed article on RAG](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/how-is-my-companys-data-processed-what-is-rag).* ### **Step 1: Intelligent Chunking** First, your documents must be converted into usable text: - extraction of paragraphs - retrieval of text from tables - interpretation of diagrams, charts, etc. (this part is important, as they often contain useful and exploitable information) Then comes **chunking**. A good chunk must be: - **short** → to fit in the context window - **coherent** → one clear idea per block - **isolated** → no mixing of concepts > You don't give the entire document to the AI. You give it the paragraph *that exactly answers* the question. > ### **Step 2: The Search Mechanism (The Magic of Embeddings)** To compare texts, RAG transforms: - your question - your chunks ...into **numerical vectors**: these are **embeddings**. Two chunks close in meaning → their vectors are close. ### **Two Essential Types of Search** 1. **Semantic Search (by meaning)** Ideal for conceptual questions: "How do I request time off?" 2. **Keyword Search (by precision)** Essential for specific terms without universal meaning: - "Product reference XYZ-123" - "Procedure PNC-V4" - "Jean-Pierre Dubreuil" Because an AI doesn't know Jean-Pierre Dubreuil from the accounting department... **➡️ The two mechanisms are complementary. A purely "semantic" RAG (which is nevertheless common) will fail on this type of search.** --- ### **Simplified RAG Workflow**  ## **Not All RAGs Are Created Equal: The Art of Choosing the Right Solution** The market is full of RAGs that are "quick to integrate," but... there are good ones and bad ones. What makes the difference: - **Quality of conversion** → not knowing how to extract data from a chart = losing important information - **Quality of chunking** → chunks too large or incoherent = confused AI - **Choice of embedding models** → they don't all excel in the same domains - **Hybrid search** → semantic alone = errors on proper nouns A bad RAG can make the AI vague, approximate, unable to find information that's actually present. Another crucial point is the integration **of complementary tools**. If your need is only internal search, a RAG is enough. But generally, you'll also want to search the Web, query database data, trigger actions, etc. Integrating these tools multiplies the power of your AI. ### **RAG is Engineering** There are clearly best practices and "generic" choices that work quite well. But there's no magic recipe. Each company has specific formats and data that require particular treatments to achieve good performance. ## **The Ask This Guy (ATG) Approach: The Best of RAG, Without the Hassle** At **Ask This Guy**, we've spent hundreds of hours benchmarking, testing, breaking, and then improving RAG pipelines. ### **We Offer:** - **Optimized Conversion and Chunking** [Numerous connectors](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/connectors), [management of complex documents](https://www.askthisguy.com/en/doc/customizing-atg-to-you/tailored-processing), tables, slides, [images](https://www.askthisguy.com/en/doc/admin-console/knowledge-management/how-documents-images-are-processed-by-atg), etc. - **Intelligent Hybrid Search** Semantic + keywords for maximum precision. - **Advanced Personalization** We adapt conversions to *your* documents and can develop specific algorithms. We can use an embedding model adapted to your business. - **Total Flexibility** You keep control of your data. And if you want to internalize the solution one day, you get back your specific developments. - **One RAG for All Your Use Cases** Deploy the same intelligence across multiple interfaces: admin console, [chatbots on your website](https://www.askthisguy.com/en/doc/atg-embedded), widget integrated into your SaaS product, API for your internal tools, etc. - [Software that combines multiple tools, not just RAG](https://www.askthisguy.com/en/doc/admin-console/tools-management) - search in your drives - web search - integration with your internal tools - advanced document processing **The Goal**: an AI that knows your company as well as an experienced employee. ## **Conclusion: Give Voice to Your Enterprise Data with RAG** RAG isn't just a technology: it's a **document intelligence strategy**. It transforms a generic AI into a **true internal expert**, capable of: - answering questions precisely - synthesizing complex documents - streamlining processes - aiding decision-making If you want an AI that truly understands your company... ➡️ RAG is essential. ➡️ And we can help you implement it. **Ready to transform how your company uses its data?** **[Book a quick demo!](https://www.askthisguy.com/en/demo/)** --- # Open-Source in AI: The Big Misunderstanding URL: https://www.askthisguy.com/en/blog/open-source-vs-open-weights-ai/ Language: en Section: Blog ## Introduction Hardly a week goes by without seeing headlines in the press or on LinkedIn [announcing the release](https://www.bitget.com/news/detail/12560605111847) of "open-source" AI models… when in reality, they aren't. Am I nitpicking words? The distinction is actually fundamental. **Open-source is transparent.** **AI will remain opaque.** "Open-source" and "open-weight" are often used interchangeably in AI discussions. Yet they refer to fundamentally different things. This article explains the real differences between these two concepts and why generative AI struggles to follow the traditional open-source model. ## Open-Source: total transparency as a foundation ## What is open-source? Open-source means **total transparency**: access to the full source code, the ability to modify it, audit it, and understand exactly how it works. Take Linux. Every line of code is visible. You can compile your own version, adapt it, contribute improvements, or have the code audited to detect vulnerabilities. This transparency enables: - **Trust**: any expert can verify there are no hidden backdoors - **Collective security**: thousands of eyes find and fix bugs quickly - **Independence**: no risk of being locked into a single company This philosophy gave us Git, Apache, Firefox, PostgreSQL, Python… Some of the most reliable projects in the world, widely used in companies, including commercially. [Google and Microsoft](https://jisom.rau.ro/Vol.17%20No.2%20-%202023/JISOM%2017.2_1-22.pdf) are even among the biggest open-source contributors. ## LLMs: a fundamentally different architecture ## Weights are not source code An LLM (large language model) like GPT-5.2, Mistral 3, or Gemini 3 is not a traditional program. It’s a **mathematical architecture** with billions of “weights” - the neural network connections - produced by training that can cost millions of euros. The crucial difference: **having an LLM’s weights is not like having a software project’s source code.** It’s more like receiving a compiled binary: you can run it, but you don’t see: - The training data used - The methodological choices (algorithms, hyperparameters) - The optimization strategies - The mistakes corrected along the way Result: a powerful machine… but opaque. ## What is an "open-weight" model? While major players keep their top models closed, some actors like Mistral AI or DeepSeek publish **model weights** on [Hugging Face](https://huggingface.co/models). Even [OpenAI](https://openai.com/fr-FR/index/introducing-gpt-oss/) and [Google](https://deepmind.google/models/gemma/) have joined in.  This kind of openness brings real benefits: - Run the model on your own servers without relying on an external API - Fine-tune it for your specific needs (legal, medical vocabulary…) - Keep your data on your own infrastructure - Control costs - Enable the community to innovate ## Why "true" open-source is so hard for LLMs ### 1. Training data: the legal nightmare The data used to train LLMs largely comes from [copyright-protected works](https://www.hinckleyallen.com/publications/industry-today-ai-training-data-the-copyright-controversy/): books, articles, web content, scientific publications. This data has often been collected at scale without explicit author consent. Publishing this data creates legal risk. Lawsuits are multiplying in the US and Europe. Revealing precisely which content was used would open massive legal fronts. This is a structural problem that requires changes in the legal framework. Even though you can find [hundreds of thousands of datasets](https://huggingface.co/datasets) on Hugging Face, the most valuable data is not copyright-free. ### 2. Reproducibility is extremely difficult With Linux, if you have the source code, you can recompile the exact same version. For LLMs, it’s far more complicated, even if you had everything (code, data, weights): - Training processes include randomness by design - Results differ across separate runs - Reproducing training can cost millions of euros Perfect reproducibility is therefore practically out of reach, even if it’s theoretically possible. ### 3. Biases and hallucinations can’t be detected from weights alone An AI model’s hallucinations and biases are the equivalent of software vulnerabilities and bugs. Even with access to weights, **you can’t “read” biases or hallucinations directly from the model**. They are invisibly distributed across billions of parameters. The only way to detect them is to test the model in real settings with benchmarks. Biases show up in use, not through inspection. ## Truly transparent initiatives are the exception A few projects try to get closer to real transparency. **[LLM360](https://www.llm360.ai/)** is a notable example: they publish not only final weights, but also intermediate checkpoints, full training code, and share data responsibly. These initiatives remain rare because they first have to solve legal problems - which requires political action. ## What approach should you adopt? For a company investing in AI, reality is neither "all proprietary models" nor "all open-weight." The right approach combines both. **Open-weight** models have real strategic value for **diversification**: using a mix of open-weight models (Mistral, Qwen…) and commercial models (GPT, Gemini…) can reduce dependency on a single provider and improve continuity and service quality. At [Ask This Guy](https://askthisguy.com), for example, we use both open-weight models (that we can host on one or more European infrastructures) and commercial models depending on needs. We monitor each provider's performance in real time. It’s precisely this **diversity of providers** that helps ensure a better level of service for our customers. *(Cover image credit: [Peter Adams, faces of Open-Source](https://www.facesofopensource.com/))* --- # What if the United States Turned Off Your Digital Tap? URL: https://www.askthisguy.com/en/blog/souverainete-numerique-dependance-americaine/ Language: en Section: Blog  If this scenario sounds alarmist today, it rests on a clear trend: the **current U.S. administration is increasingly hostile toward Europe**, while Europe remains **heavily dependent on American digital infrastructure**. What used to seem unlikely now looks like a **plausible risk** over the next 5 to 10 years. The time to act is now… before you’re caught off guard. The recent publication of the **[National Security Strategy 2025](https://www.whitehouse.gov/wp-content/uploads/2025/12/2025-National-Security-Strategy.pdf)** by the Trump administration confirms this trajectory: the United States clearly states its intention to use every lever, including technological and economic ones, to defend its strategic interests, with an openly **“America First”** approach that no longer hides its unilateral dimension. In a context where rising U.S. political figures, such as **[JD Vance](https://fr.wikipedia.org/wiki/J._D._Vance)** or **[Marjorie Taylor Greene](https://fr.wikipedia.org/wiki/Marjorie_Taylor_Greene)**, embody a more nationalist, more isolationist movement, and one that is more explicitly critical of Europe, the adoption of **unilateral measures**, including restrictions targeting foreign actors or sectors, seems more credible than ever. ## Beyond the Cloud Act and the Patriot Act: executive orders & emergency laws The **Cloud Act** (2018) and the **Patriot Act** (2001) are well known today: they allow U.S. authorities to access data held by U.S. companies, **even if that data is physically hosted abroad**. These laws authorize surveillance and data-access requests within an established legal framework. But the problem isn’t limited to these classic surveillance or data-request laws - what also threatens the digital infrastructure used by European actors are **legal emergency mechanisms**. For example, in **February 2025**, Trump signed **[Executive Order 14203](https://www.presidency.ucsb.edu/documents/executive-order-14203-imposing-sanctions-the-international-criminal-court)**, relying in particular on the **[International Emergency Economic Powers Act](https://en.wikipedia.org/wiki/International_Emergency_Economic_Powers_Act) (IEEPA)**, to impose **sanctions against members and collaborators of the International Criminal Court (ICC)** - with no prior judicial procedure, simply by executive decision. **Concretely**, this means that overnight, a sanctioned person can **lose access to Microsoft 365, Google Workspace, or any other U.S. cloud service** - with no immediate remedy, no trial, purely by executive decision. The case of [French magistrate Nicolas Guillou, sanctioned by the United States](https://www.dalloz-actualite.fr/flash/l-enfer-du-juge-nicolas-guillou-magistrat-francais-sous-sanctions-americaines), illustrates this reality: imagine your company - your professional emails, files, collaboration tools… inaccessible overnight. This “emergency power” mechanism shows how discretionary decisions can **block assets, restrict access, or freeze property** of foreign actors - U.S.-based or not. In other words: the U.S. state has a **legal arsenal** that allows it, in times of “threat” or “crisis”, to act fast - with **immediate effects** - against targets perceived as sensitive: economic, judicial, or technological. This goes well beyond the scope of traditional surveillance laws. For a European company dependent on a U.S. provider, even if the servers are in Europe, it’s the **provider’s legal nationality** - not the physical location - that can determine access or shutdown. This kind of emergency law or extraterritorial reach turns “hosting in Europe” into a **pseudo-shield**: when the provider is subject to U.S. law, it remains potentially vulnerable to decisions made in Washington - **even if your data is physically stored in Frankfurt, Dublin, or Paris**. ## What happens if there’s a cutoff? Many companies in Europe rely on **clouds, SaaS services, APIs, critical infrastructure** provided by U.S. players - IaaS, PaaS, SaaS, storage, AI APIs, etc. If those services are shut down or restricted, your infrastructure can become **unusable within hours**. If your product relies on an **AI API, or any other critical external service**, an external decision can stop you dead - **without notice**. This highlights a key point: **technological dependence**, especially when centralized around one or a handful of U.S. providers, becomes a **strategic vulnerability** - not only technical, but also economic and operational. This risk may feel unlikely today, but in a period of renewed international tensions, it will only grow. ## Reducing risk progressively, with a pragmatic approach So how do you protect yourself against this risk? Let’s avoid fear-mongering or all‑or‑nothing thinking, and adopt a **progressive, controlled strategy.** Some measures are worth taking: 1. **Inventory dependencies**: cloud, SaaS, APIs, storage, hosting, vendors, location of services and data. 2. **Assess criticality**: sensitive data? intellectual property? personal data? core business? 3. **Prioritize**: prioritize the **most sensitive elements** for potential migration to local or European solutions. 4. **Modular, multi‑vendor architecture**: if there’s dependence on a U.S. player, design code and infrastructure so you can **switch from one provider to another**. 5. **Continuous iteration**: with each new release, service, or customer, ask whether the dependency is “critical or not”, and gradually break out of the dependency loop. This step‑by‑step approach reduces vulnerability without sacrificing innovation or performance. ## How Ask This Guy (ATG) fits into this vision At **Ask This Guy**, we’ve made a clear choice in favor of **[digital sovereignty](https://www.askthisguy.com/en/doc/infrastructure-and-security)**: - All our infrastructure is hosted with **European** providers, on European soil. - For **AI / LLM**, our architecture is **agnostic**: today we support **seven different providers**, including **four European ones**. [You have the choice](https://www.askthisguy.com/en/doc/admin-console/organization-settings/choosing-the-right-ai-policy): either a **100% European** approach, or a “Europe + US” approach, depending on your risk tolerance, needs, and strategy. You can switch from one to the other in seconds. - The code we produce for our clients - everything specific to their project - is **shared and remains fully under the client’s control**: you stay in charge, and you can change strategy, hosting, or provider at any time. - This **flexibility** is part of our credo: sovereignty isn’t a dogma, it’s a **strategic criterion**. By adopting this posture from day one, we build our clients’ **technical and economic resilience**. Is your AI provider taking this approach? Which LLM and which cloud provider are they using? To go all the way on the topic, our [sovereign AI](https://www.askthisguy.com/en/sovereign-ai/) page sets out the definition we use, the three layers to control (applicable law, infrastructure, models) and the seven questions to ask a vendor before signing. ## Conclusion: digital sovereignty is a bet on 2030 Today, the appeal of cloud giants, APIs, and “ready-to-use” services for launching a product quickly is powerful. But that convenience comes with a cost - often invisible, often ignored: the **loss of strategic control** over what could tomorrow be considered one of your most precious assets: **your data, your IP, your sovereignty**. This isn’t an abstract risk. It’s a **structural vulnerability** - legal, technical, economic. And the longer you wait, the **harder and more expensive** it becomes to get out of it. At **Ask This Guy**, we believe **digital resilience** - built on conscious and transparent choices - must become a **competitiveness criterion**. If you’re building a new service, a startup, or an AI product today, ask yourself: **“What is the critical asset I can’t afford to lose?”** - and build around it an architecture aligned with what you mean by “sovereignty”.