RAG pipeline: 5 errores que llegan después del POC
Un RAG pipeline se prototipa rápido; convertirlo en un producto útil y estable es otra historia. Los 5 errores más habituales en producción y cómo anticiparlos.

Un RAG (Retrieval-Augmented Generation) es una arquitectura que permite a una IA buscar en tus fuentes internas antes de responder: documentos, bases de conocimiento, procedimientos, contratos y, a veces, bases de datos o la web. Si el tema es nuevo para ti, puedes empezar por nuestra página de documentación Datos y RAG.
Montar un RAG empresarial suele dar una impresión engañosa.
En pocas horas se puede obtener una primera demo convincente. Se toman diez documentos bien elegidos, se pasan por un RAG pipeline y el asistente ya responde a preguntas que se parecen a casos de uso reales.
Pongamos el caso de una dirección de RR. HH. que prueba un asistente interno. Se le da el reglamento interno, el convenio colectivo, tres procedimientos de vacaciones, dos notas sobre el teletrabajo y unas preguntas frecuentes. Un empleado pregunta: «¿Cuántos días de teletrabajo puedo hacer por semana?». El asistente encuentra el pasaje correcto, sintetiza la respuesta y cita la fuente. Todo el mundo sonríe. La prueba de concepto queda validada.
Después llega la producción.
Ya no se trata de responder a diez preguntas sobre diez documentos limpios. Hay que absorber miles de ficheros, varias versiones contradictorias, derechos de acceso, nombres de productos, referencias de clientes, tablas, documentos escaneados, jerga interna y usuarios con prisa que rara vez formulan sus peticiones como en una demo.
No es de extrañar que el 95 % de los proyectos de IA fracasen en las empresas.
Estos son cinco errores que observamos con regularidad en nuestros clientes.
Error n.º 1: tomar el POC por la realidad
La primera trampa del RAG es su aparente facilidad.
Para una demo, el camino es corto: elegir un corpus pequeño, convertir los ficheros, trocear el texto, calcular los embeddings, buscar los fragmentos pertinentes y, después, generar una respuesta.
Esta cadena funciona rápido si los documentos están limpios y el tema bien acotado. Pero un sistema de producción no trabaja en un decorado preparado.
En una empresa, los documentos rara vez son homogéneos. Hay PDF exportados desde Word, presentaciones, hojas de Excel, capturas de pantalla, tickets, contratos, actas y, a menudo, ficheros cuyo origen nadie conoce realmente.
El problema no es solo el volumen. Es la diversidad, el estado de los documentos y las incoherencias entre fuentes. Un procedimiento de 2023 puede ser técnicamente pertinente pero haber quedado sustituido por una nota de 2026. Un contrato de cliente puede contener una excepción que contradice la regla general. Una diapositiva comercial puede simplificar un producto que la documentación técnica describe de otra forma.
También hay que «educar» a la IA en el vocabulario de la empresa: siglas internas, apodos de productos, nombres de proyectos, abreviaturas del oficio, denominaciones antiguas que los equipos siguen usando. Sin ese trabajo, el asistente puede buscar en el sitio equivocado o pasar por alto una información que sí estaba presente.
El conocimiento de una empresa no es un montón de ficheros. Es un conjunto de fuentes, versiones, permisos, prioridades y vocabulario compartido.
Esta distancia entre lo que está archivado y lo que la empresa sabe realmente no tiene nada de nuevo: es el fracaso clásico de los proyectos de gestión del conocimiento, y un RAG mal acotado lo hereda tal cual.
Para pasar a producción, hay que decidir, por tanto, qué versión prevalece, qué ficheros ignorar, qué permisos aplicar, cómo gestionar las contradicciones y cómo citar las fuentes. Son temas que parecen administrativos. En realidad, condicionan la confianza.
Error n.º 2: depender de un solo proveedor de IA
Una empresa espera que una herramienta interna esté disponible y sea rápida y estable. En muchos contextos, la referencia implícita es la de las aplicaciones SaaS maduras: un 99,99 % de disponibilidad, tiempos de respuesta previsibles, pocas interrupciones visibles.
Con los modelos de IA, esta expectativa choca con una realidad más dura. Los proveedores de IA son potentes, pero no siempre se comportan como piezas de infraestructura clásicas. Las latencias varían, algunas peticiones fallan, hay modelos que dejan de estar disponibles temporalmente, el rendimiento cambia según la carga, las regiones o las actualizaciones internas.
En ATG medimos de forma permanente la velocidad de respuesta de las API de numerosos proveedores de IA. El benchmark siguiente compara la tasa de éxito de varios proveedores en tareas de generación de texto.
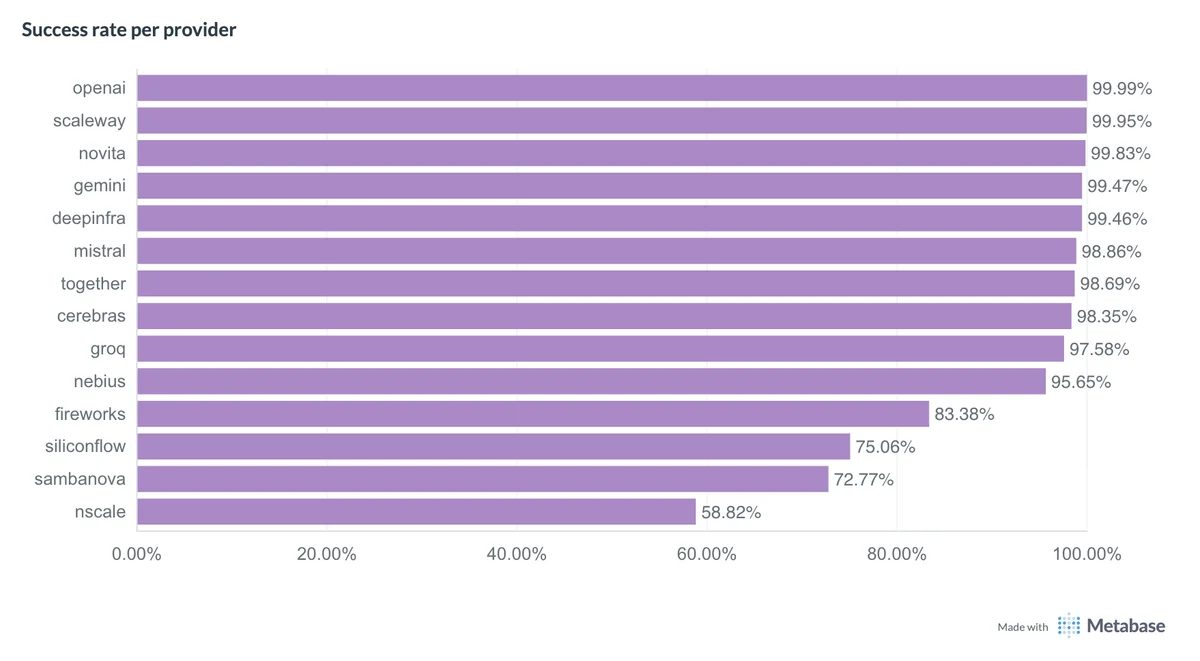 Benchmark de ATG del primer trimestre de 2026 sobre las tasas de éxito de los proveedores de generación de texto
Ojo: este gráfico solo mide la tasa de éxito. No dice nada de la latencia. Un proveedor puede mostrar una tasa de éxito excelente y, aun así, responder demasiado despacio para ofrecer una buena experiencia de usuario (es el caso de OpenAI, en particular).
La conclusión es sencilla: si tu RAG depende de un solo proveedor de IA y de un solo modelo, toda la experiencia de usuario depende de esa pieza.
El enfoque correcto consiste más bien en diseñar una arquitectura capaz de cambiar de ruta:
- varios proveedores de IA para un mismo tipo de tarea;
- varios modelos según la complejidad de la pregunta;
- mecanismos de fallback cuando una petición falla;
- monitorización de la latencia, los errores y la calidad;
- una selección dinámica del modelo más adecuado.
Error n.º 3: creer que basta con desplegar un modelo de IA propio
La solución parece entonces sencilla: basta con desplegar un modelo de IA propio.
Sobre el papel, la idea es seductora. Se reduce la dependencia externa, se domina la infraestructura, se controlan mejor los datos. Y si el RAG aporta los fragmentos correctos, al modelo solo le queda redactar la respuesta, ¿no?
No exactamente.
Las peticiones reales rara vez son limpias. Un usuario no pregunta:
¿Cuál es el procedimiento de aprobación de las vacaciones retribuidas?
Más bien pregunta:
eh lo de sofía de soporte q quiere cogerse 3 días justo antes del pico, este trimestre ya se ha pasado bastante no? podemos decirle q no o cómo se lo planteo??
El sistema debe entender la petición, encontrar los textos correctos, distinguir entre la regla general y el caso particular, evitar validar un sesgo del responsable y, después, proponer una formulación aprovechable.
La búsqueda aporta las fuentes. El modelo todavía tiene que razonar.
Lo local puede tener sentido para casos acotados: extracción sencilla, reformulación, clasificación, RAG factual sobre un ámbito estrecho. Pero en cuanto el asistente tiene que tratar preguntas de negocio ambiguas, cruzar varias fuentes o usar herramientas, los modelos más potentes vuelven a ser difíciles de evitar.
Hemos tratado este tema en detalle en nuestro artículo sobre los LLM en local. La idea clave es sencilla: hacer funcionar un modelo robusto con buen rendimiento sale caro, sobre todo con varios usuarios simultáneos.
Este error suele esconder otro: confundir RAG on premise con un LLM alojado en casa. Un RAG on premise se descompone en tres capas independientes: los datos y el retrieval (índice, derechos de acceso, citas), la plataforma (conectores, ingesta, evaluación, monitorización) y la inferencia. Las dos primeras pueden quedarse en tus instalaciones, donde ya están tus documentos y tus permisos, sin comprar una sola GPU. Muchos proyectos «on premise» se atascan porque abordan primero la inferencia, cuando el plazo y el coste reales están en las otras dos capas. Hemos cifrado esta disyuntiva en nuestro análisis del RAG on premise.
La estrategia correcta no es, por tanto, elegir de una vez por todas entre nube, local, modelo pequeño o modelo grande. Es orientar las peticiones con inteligencia: un modelo ligero para las tareas sencillas, un modelo más potente para los razonamientos complejos, un modelo especializado para los embeddings o la visión, un proveedor alternativo si el primero va lento.
Error n.º 4: limitar el RAG pipeline a la búsqueda vectorial
Muchos proyectos RAG empiezan con una búsqueda vectorial pura. Es lógico: los embeddings están en el corazón del RAG moderno, y la búsqueda semántica impresiona.
Permite encontrar un pasaje aunque el usuario no emplee las mismas palabras que el documento. «Política de teletrabajo» puede encontrar «modalidades de trabajo a distancia». «¿Cómo se comunica una ausencia?» puede encontrar «procedimiento de ausencia por enfermedad».
Pero una empresa maneja muchísima información que no tiene un sentido semántico universal.
Un nombre de cliente, una referencia de producto, un código de proyecto, un identificador de contrato, una sigla interna o el nombre de un empleado no «significan» gran cosa para un embedding. ACME-0427, Proyecto Atlas, PRD-19-B, Jean Martin o Pack Horizon son claves. No conceptos.
Si tu RAG se basa únicamente en la proximidad semántica, corre el riesgo de pasar por alto precisamente la información que buscan los usuarios.
Por eso un buen RAG combina (como mínimo) búsqueda semántica, búsqueda por palabras clave, metadatos y priorización de las fuentes según su fiabilidad.
El RAG también debe aprender a arbitrar entre documentos contradictorios: fecha, responsable, estado, perímetro, fuente oficial, excepción contractual. Si no, no responde a partir del «conocimiento de la empresa». Responde a partir de un montón de ficheros.
Un buen RAG no se limita a encontrar un pasaje parecido. Encuentra el pasaje correcto, en el documento correcto, con el nivel de autoridad correcto.
Error n.º 5: creer que los usuarios solo quieren buscar
La última trampa se descubre a menudo demasiado tarde: los usuarios no solo quieren buscar.
Al principio, les impresiona un asistente capaz de responder a partir de los documentos internos. Luego, muy pronto, piden otra cosa:
- «¿Puedes redactarme una nota de síntesis en formato Word?»
- «Comprueba si esta información sigue siendo cierta en internet.»
- «Compara este procedimiento con el contrato del cliente.»
- «Envíame la síntesis por correo.»
- «Busca en el CRM.»
- «Hazme una tabla que se pueda usar.»
Dicho de otro modo, no perciben la herramienta como un simple RAG. La perciben como una interfaz de trabajo.
Si tu solución solo sabe hacer búsqueda documental, alcanzará muy pronto su techo de uso. Ahí es donde las arquitecturas agénticas, las herramientas (búsqueda web, generación de documentos, etc.) y protocolos como MCP cobran importancia.
Pero añadir herramientas no basta. También hace falta una interfaz fluida, integrada en los usos existentes cuando es posible, y lo bastante clara como para que el usuario entienda lo que el asistente sabe hacer.
Por último, hay que medir. Un sistema RAG no se valida con cinco preguntas en un comité de proyecto. Se valida con cientos, y después miles, de preguntas representativas: sencillas, ambiguas, fuera de perímetro, con nombres propios, sobre documentos antiguos, con fuentes contradictorias o que requieren una herramienta.
Hay que generar preguntas realistas, analizar las valoraciones de los usuarios, seguir los fallos, analizar las fuentes citadas, medir los tiempos de respuesta y volver a ejecutar los juegos de pruebas tras cada cambio.
Si solo hay que quedarse con una idea
Un RAG es fácil de lanzar, pero difícil de industrializar.
La demo muestra el potencial. La producción revela las restricciones: gobernanza documental, jerga del oficio, incoherencias entre fuentes, disponibilidad de los proveedores de IA, enrutamiento de los modelos, búsqueda híbrida, herramientas, interfaz y medición de la calidad.
El enfoque de Ask This Guy
En Ask This Guy abordamos el RAG como una pieza de producción, no como una simple búsqueda vectorial.
Conectamos las fuentes documentales de la empresa, adaptamos el tratamiento a los formatos reales, combinamos búsqueda semántica, palabras clave, metadatos y reranking, utilizamos varios modelos y proveedores de IA según las necesidades, integramos herramientas o servidores MCP cuando el caso de uso lo justifica, y medimos tanto el rendimiento como las valoraciones de los usuarios.
El objetivo no es prometer un asistente mágico. El objetivo es construir un sistema fiable, explicable y útil, capaz de progresar con tus usos.
Si tu proyecto toma la forma de un chatbot interno de empresa, los mismos escollos se aplican, con la cuestión añadida de los derechos de acceso.
Si estás preparando un RAG empresarial, la buena pregunta de partida no es «¿podemos hacer una demo?», sino «¿qué tendrá que aguantar cuando 500 usuarios hagan preguntas reales sobre datos reales?».
Reserva una demo para ver cómo Ask This Guy puede ayudarte a pasar de un RAG prometedor a un RAG realmente utilizable en la empresa.