RAG-Pipeline: 5 Fehler, die nach dem POC auftreten
Ein RAG-System ist schnell als Prototyp gebaut, ein nützliches und stabiles Produkt daraus zu machen, ist schwer. Die 5 häufigsten Fehler in Produktion.

Ein RAG-System (Retrieval-Augmented Generation) ist eine Architektur, mit der eine KI vor der Antwort in Ihren internen Quellen sucht: Dokumente, Wissensdatenbanken, Verfahrensanweisungen, Verträge, manchmal Datenbanken oder das Web. Wenn das Thema neu für Sie ist, können Sie mit unserer Dokumentationsseite Daten und RAG beginnen.
Ein RAG im Unternehmen aufzusetzen, vermittelt oft einen trügerischen Eindruck.
In wenigen Stunden lässt sich eine erste überzeugende Demo bauen. Sie nehmen zehn gut ausgewählte Dokumente, schicken sie durch eine Pipeline, und der Assistent beantwortet schon Fragen, die echten Use Cases ähneln.
Stellen Sie sich eine Personalabteilung vor, die einen internen Assistenten testet. Man gibt ihm die Betriebsordnung, den Tarifvertrag, drei Urlaubsregelungen, zwei Notizen zum Homeoffice und eine FAQ. Ein Mitarbeiter fragt: „Wie viele Tage Homeoffice darf ich pro Woche nehmen?“ Der Assistent findet die richtige Passage, fasst die Antwort zusammen, nennt die Quelle. Alle lächeln. Der POC ist abgenommen.
Dann kommt die Produktion.
Es geht nicht mehr darum, zehn Fragen zu zehn sauberen Dokumenten zu beantworten. Das System muss Tausende Dateien verarbeiten, mehrere widersprüchliche Versionen, Zugriffsrechte, Produktnamen, Kundenreferenzen, Tabellen, gescannte Dokumente, interne Fachsprache und eilige Nutzer, die ihre Anfragen selten so formulieren wie in einer Demo.
Kein Wunder, dass 95 % der KI-Projekte in Unternehmen scheitern.
Hier sind fünf Fehler, die wir bei unseren Kunden regelmäßig beobachten.
Fehler Nr. 1: den POC für die Realität halten
Die erste Falle eines RAG-Systems ist seine scheinbare Einfachheit.
Für eine Demo ist der Weg kurz: ein kleines Korpus auswählen, die Dateien konvertieren, den Text zerlegen, die Embeddings berechnen, die relevanten Auszüge suchen und dann eine Antwort generieren.
Diese Kette funktioniert schnell, wenn die Dokumente sauber und das Thema klar abgegrenzt ist. Ein Produktionssystem arbeitet aber nicht in einer vorbereiteten Kulisse.
In einem Unternehmen sind die Dokumente selten einheitlich. Es gibt aus Word exportierte PDFs, Präsentationen, Excel-Tabellen, Screenshots, Tickets, Verträge, Protokolle und oft Dateien, deren Herkunft niemand so genau kennt.
Das Problem ist nicht nur die Menge. Es sind die Vielfalt, der Status der Dokumente und die Widersprüche zwischen Quellen. Eine Verfahrensanweisung von 2023 kann fachlich zutreffend, aber durch eine Notiz von 2026 ersetzt worden sein. Ein Kundenvertrag kann eine Ausnahme enthalten, die der allgemeinen Regel widerspricht. Eine Vertriebsfolie kann ein Produkt vereinfachen, das die technische Dokumentation anders beschreibt.
Die KI muss auch das Vokabular des Unternehmens „lernen“: interne Akronyme, Spitznamen von Produkten, Projektnamen, fachliche Abkürzungen, alte Bezeichnungen, die die Teams noch verwenden. Ohne diese Arbeit kann der Assistent an der falschen Stelle suchen oder eine Information verpassen, die eigentlich vorhanden ist.
Unternehmenswissen ist kein Haufen Dateien. Es ist ein Gefüge aus Quellen, Versionen, Rechten, Prioritäten und gemeinsamem Vokabular.
Diese Lücke zwischen dem, was abgelegt ist, und dem, was das Unternehmen tatsächlich weiß, ist nicht neu: Sie ist das klassische Scheitern von Initiativen im Wissensmanagement, und ein schlecht abgegrenztes RAG erbt sie unverändert.
Für den Schritt in die Produktion muss man also entscheiden, welche Version maßgeblich ist, welche Dateien ignoriert werden, welche Rechte gelten, wie mit Widersprüchen umzugehen ist und wie Quellen zitiert werden. Diese Themen wirken administrativ. In Wirklichkeit entscheiden sie über das Vertrauen.
Fehler Nr. 2: von einem einzigen KI-Anbieter abhängen
Ein Unternehmen erwartet von einem internen Werkzeug, dass es verfügbar, schnell und stabil ist. In vielen Kontexten ist der stillschweigende Maßstab der von ausgereiften SaaS-Anwendungen: 99,99 % Verfügbarkeit, vorhersehbare Antwortzeiten, kaum sichtbare Unterbrechungen.
Bei KI-Modellen stößt diese Erwartung auf eine raue Wirklichkeit. KI-Anbieter sind leistungsstark, verhalten sich aber nicht immer wie klassische Infrastrukturbausteine. Latenzen schwanken, manche Anfragen schlagen fehl, Modelle sind zeitweise nicht verfügbar, die Leistung ändert sich je nach Last, Region oder internen Updates.
Bei ATG messen wir laufend die Antwortgeschwindigkeit der APIs zahlreicher KI-Anbieter. Der folgende Benchmark vergleicht die Erfolgsquote mehrerer Anbieter bei Aufgaben der Textgenerierung.
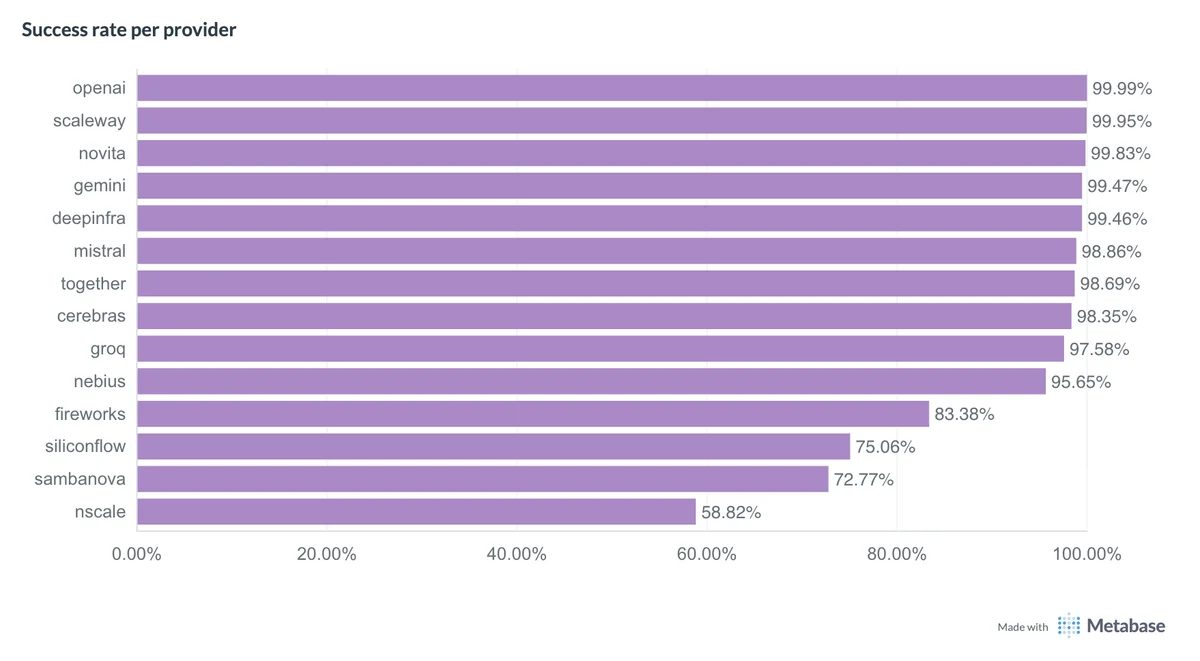 ATG-Benchmark Q1 2026 der Erfolgsquoten von Anbietern für Textgenerierung
Achtung: Diese Grafik misst nur die Erfolgsquote. Über die Latenz sagt sie nichts. Ein Anbieter kann eine ausgezeichnete Erfolgsquote haben und trotzdem zu langsam für eine gute Nutzererfahrung antworten (das ist etwa bei OpenAI der Fall).
Die Schlussfolgerung ist einfach: Hängt Ihr RAG von einem einzigen KI-Anbieter und einem einzigen Modell ab, hängt die gesamte Nutzererfahrung an diesem Baustein.
Der bessere Ansatz ist eine Architektur, die die Route wechseln kann:
- mehrere KI-Anbieter für denselben Aufgabentyp;
- mehrere Modelle je nach Komplexität der Frage;
- Fallback-Mechanismen, wenn eine Anfrage fehlschlägt;
- Monitoring von Latenz, Fehlern und Qualität;
- eine dynamische Auswahl des jeweils passendsten Modells.
Fehler Nr. 3: glauben, es genüge, ein eigenes KI-Modell zu betreiben
Die Lösung scheint dann einfach: Man betreibt eben sein eigenes KI-Modell.
Auf dem Papier ist die Idee verlockend. Sie verringern die externe Abhängigkeit, beherrschen die Infrastruktur, kontrollieren Ihre Daten besser. Und wenn das RAG die richtigen Auszüge liefert, muss das Modell doch nur noch die Antwort formulieren, oder?
Nicht wirklich.
Echte Anfragen sind selten sauber. Ein Nutzer fragt nicht:
Wie läuft die Genehmigung von bezahltem Urlaub ab?
Er fragt eher:
äh wegen Sophie vom Support die will 3 T direkt vor dem Ansturm nehmen, sie hat dieses quartal schon ziemlich übertrieben oder? können wir ablehnen oder wie formulier ich das am besten?
Das System muss die Anfrage verstehen, die richtigen Texte finden, allgemeine Regel und Einzelfall unterscheiden, vermeiden, eine Voreingenommenheit der Führungskraft zu bestätigen, und dann eine brauchbare Formulierung vorschlagen.
Die Suche liefert die Quellen. Das Modell muss trotzdem noch denken.
Lokal kann für klar abgegrenzte Fälle sinnvoll sein: einfache Extraktion, Umformulierung, Klassifikation, faktenbasiertes RAG in einem engen Fachgebiet. Sobald der Assistent aber mehrdeutige Fachfragen bearbeiten, mehrere Quellen abgleichen oder Werkzeuge nutzen muss, sind leistungsstärkere Modelle kaum zu umgehen.
Dieses Thema haben wir in unserem Artikel über lokale LLM ausführlich behandelt. Der Kernpunkt ist einfach: Ein robustes Modell mit guter Leistung zu betreiben, ist teuer, vor allem bei mehreren gleichzeitigen Nutzern.
Hinter diesem Fehler steckt oft ein zweiter: RAG on premise mit einem selbst gehosteten LLM zu verwechseln. Ein RAG on premise zerfällt in drei unabhängige Schichten: Daten und Retrieval (Index, Zugriffsrechte, Zitate), die Plattform (Konnektoren, Ingestion, Evaluierung, Monitoring) und die Inferenz. Die ersten beiden können bei Ihnen bleiben, dort, wo Ihre Dokumente und Rechte bereits liegen, ohne eine einzige GPU zu kaufen. Viele „On-Prem“-Projekte bleiben stecken, weil sie zuerst die Inferenz angehen, obwohl Zeitaufwand und Kosten tatsächlich bei den beiden anderen Schichten liegen. Diese Abwägung haben wir in unserer Analyse zu RAG on premise beziffert.
Die richtige Strategie ist also nicht, sich ein für alle Mal zwischen Cloud, lokal, kleinem oder großem Modell zu entscheiden. Sie besteht darin, die Anfragen klug zu leiten: ein leichtes Modell für einfache Aufgaben, ein stärkeres Modell für komplexes Denken, ein spezialisiertes Modell für Embeddings oder Bildverarbeitung, ein alternativer Anbieter, wenn der erste langsam ist.
Fehler Nr. 4: nur auf Vektorsuche setzen
Viele RAG-Projekte beginnen mit reiner Vektorsuche. Das ist folgerichtig: Embeddings stehen im Zentrum des modernen RAG, und die semantische Suche ist beeindruckend.
Sie findet eine Passage auch dann, wenn der Nutzer nicht dieselben Wörter verwendet wie das Dokument. „Homeoffice-Regelung“ kann „Modalitäten der Telearbeit“ finden. „Wie melde ich eine Abwesenheit?“ kann „Verfahren bei krankheitsbedingter Abwesenheit“ finden.
Doch ein Unternehmen arbeitet mit sehr vielen Informationen, die keine allgemeingültige semantische Bedeutung haben.
Ein Kundenname, eine Produktreferenz, ein Projektcode, eine Vertragskennung, ein internes Akronym oder der Name eines Mitarbeiters „bedeutet“ für ein Embedding nicht viel. ACME-0427, Projekt Atlas, PRD-19-B, Jean Martin oder Pack Horizon sind Schlüssel. Keine Konzepte.
Stützt sich Ihr RAG nur auf semantische Nähe, droht es genau die Informationen zu verfehlen, die die Nutzer suchen.
Deshalb kombiniert ein gutes RAG (mindestens) semantische Suche, Stichwortsuche, Metadaten und eine Priorisierung der Quellen nach ihrer Zuverlässigkeit.
Das RAG muss auch lernen, zwischen widersprüchlichen Dokumenten abzuwägen: Datum, Verantwortlicher, Status, Geltungsbereich, offizielle Quelle, vertragliche Ausnahme. Sonst antwortet es nicht auf Grundlage des „Wissens des Unternehmens“. Es antwortet auf Grundlage eines Haufens Dateien.
Ein gutes RAG findet nicht nur eine ähnliche Passage. Es findet die richtige Passage, im richtigen Dokument, mit dem richtigen Maß an Verbindlichkeit.
Fehler Nr. 5: glauben, die Nutzer wollten nur suchen
Die letzte Falle wird oft zu spät entdeckt: Die Nutzer wollen nicht nur suchen.
Anfangs sind sie beeindruckt von einem Assistenten, der auf Basis interner Dokumente antworten kann. Dann verlangen sie sehr schnell etwas anderes:
- „Kannst du mir eine Zusammenfassung als Word-Dokument schreiben?“
- „Prüf mal, ob diese Information im Internet noch stimmt.“
- „Vergleich dieses Verfahren mit dem Vertrag des Kunden.“
- „Schick mir die Zusammenfassung per E-Mail.“
- „Such im CRM.“
- „Mach mir eine brauchbare Tabelle.“
Mit anderen Worten: Sie sehen das Werkzeug nicht als einfaches RAG. Sie sehen es als Arbeitsoberfläche.
Kann Ihre Lösung nur Dokumente durchsuchen, stößt die Nutzung schnell an ihre Decke. Hier werden agentische Architekturen, Werkzeuge (Websuche, Dokumentenerstellung usw.) und Protokolle wie MCP wichtig.
Werkzeuge hinzuzufügen, reicht aber nicht. Es braucht auch eine flüssige Oberfläche, wo möglich in bestehende Arbeitsabläufe integriert und klar genug, damit der Nutzer versteht, was der Assistent kann.
Und schließlich muss man messen. Ein RAG-System wird nicht mit fünf Fragen im Projektlenkungsausschuss abgenommen. Es wird mit Hunderten, dann Tausenden repräsentativer Fragen validiert: einfache, mehrdeutige, außerhalb des Geltungsbereichs, mit Eigennamen, zu alten Dokumenten, mit widersprüchlichen Quellen oder solche, die ein Werkzeug erfordern.
Man muss realistische Fragen erzeugen, das Feedback der Nutzer auswerten, Fehlschläge verfolgen, die zitierten Quellen analysieren, Antwortzeiten messen und nach jeder Änderung Testsätze erneut durchlaufen lassen.
Wenn Sie sich nur eines merken
Ein RAG-System ist leicht gestartet, aber schwer zu industrialisieren.
Die Demo zeigt das Potenzial. Die Produktion offenbart die Zwänge: Dokumenten-Governance, Fachjargon, Widersprüche zwischen Quellen, Verfügbarkeit der KI-Anbieter, Routing der Modelle, hybride Suche, Werkzeuge, Oberfläche und Qualitätsmessung.
Der Ansatz von Ask This Guy
Bei Ask This Guy behandeln wir RAG als Produktionsbaustein, nicht als bloße Vektorsuche.
Wir binden die Dokumentenquellen des Unternehmens an, passen die Verarbeitung an die tatsächlichen Formate an, kombinieren semantische Suche, Stichwörter, Metadaten und Reranking, setzen je nach Bedarf mehrere KI-Modelle und -Anbieter ein, integrieren Werkzeuge oder MCP-Server, wenn der Use Case es rechtfertigt, und messen die Leistung ebenso wie das Feedback der Nutzer.
Das Ziel ist nicht, einen magischen Assistenten zu versprechen. Das Ziel ist, ein zuverlässiges, nachvollziehbares und nützliches System zu bauen, das mit Ihrer Nutzung mitwächst.
Nimmt Ihr Projekt die Form eines internen Unternehmens-Chatbots an, gelten dieselben Fallstricke, zusätzlich mit der Frage der Zugriffsrechte.
Wenn Sie ein RAG im Unternehmen vorbereiten, beginnen Sie mit der richtigen Frage: nicht „Können wir eine Demo machen?“, sondern „Was muss halten, wenn 500 Nutzer echte Fragen zu echten Daten stellen?“
Buchen Sie eine Demo, um zu sehen, wie Ask This Guy Ihnen helfen kann, vom vielversprechenden RAG zum im Unternehmen wirklich nutzbaren RAG zu kommen.