Lokales LLM im Unternehmen: Was 60.000 € wirklich bringen
Lokales LLM und RAG on premise 2026: GPU-Preise, Speicherbedarf pro Modell, Gesamtkosten und Break-even gegenüber demselben Modell per API, in Zahlen.

Ein lokales LLM (auch On-Premise-LLM) ist ein Sprachmodell, das auf Hardware läuft, die das Unternehmen besitzt oder kontrolliert, im eigenen Netz und ohne fremde API auf dem Weg der Daten. Konkret heißt das: ein Open-Weight-Modell herunterladen, es auf den eigenen GPUs bereitstellen und die eigenen Anwendungen daran anbinden.
Das Versprechen heißt Kontrolle: Die Daten bleiben im Haus, und man hängt von keinem Anbieter mehr ab. Für ein KI-Projekt im Unternehmen (Agenten, RAG, interne Assistenten) ist diese Option verlockend, manchmal sogar unverzichtbar.
Doch KI-Infrastruktur ist teuer, und die üblichen Überlegungen zu „Make or Buy“ funktionieren hier anders. Dieser Artikel liefert die Zahlen vom Oktober 2026, um fundiert zu entscheiden: was die Hardware kostet, welche Modelle darauf passen, wie hoch die jährlichen Gesamtkosten sind und vor allem, ab wann sich der Betrieb gegenüber demselben Modell per API rechnet. Den Überblick über alle Optionen, vom GPU-Kauf bis zum schlüsselfertigen Anbieter, gibt unser Leitfaden zur KI-Inferenz im Unternehmen.
RAG on premise: was oft verwechselt wird
Viele Teams formulieren ihren Bedarf als RAG on premise (oder RAG on-prem): ein Assistent, der aus Ihren Dokumenten antwortet und bei Ihnen gehostet wird. Ein RAG on premise bedeutet aber nicht zwingend, „alles neu zu bauen und das LLM selbst zu hosten“. Es lassen sich drei Schichten unterscheiden:
- Daten und Retrieval: Dokumente, Zugriffsrechte, Index, Quellenangaben. Das ist der fachliche Kern von RAG.
- Die Plattform: Konnektoren, Ingestion, Evaluierung, Monitoring. Das ist der Teil, dessen Industrialisierung am meisten kostet.
- Die LLM-Inferenz: das Modell, das die Antwort erzeugt (souveräne Cloud, europäischer Anbieter oder GPUs on-prem).
Viele „On-Prem“-Projekte scheitern, weil sie bei Punkt 3 anfangen (H100 kaufen), obwohl der eigentliche Zeitaufwand und die eigentlichen Gesamtkosten (TCO) in den Punkten 1 und 2 stecken. Eine schlüsselfertige RAG-Lösung für Unternehmen kann bereits in europäischem Hosting laufen, mit On-Premise-Option je nach Ihren Vorgaben, ohne dass Sie den GPU-Stack allein dimensionieren müssen.
Ein paar Begriffe vorab
- LLM (Large Language Model): das „Gehirn“ des Systems. Das ist es, was Sie auf Ihrem Server bereitstellen.
- Anzahl der Parameter: ein Maß für die „Größe“ des Modells. Je höher diese Zahl, desto feiner kann das Modell schlussfolgern (und desto mehr Rechenleistung und Speicher braucht es).
- Inferenz: der Moment, in dem das Modell auf Ihre Anfrage antwortet. Gemeint ist hier nicht das Training (das bereits stattgefunden hat), sondern schlicht das Stellen einer Frage und der Erhalt einer Antwort.
- Token: eine kleine Texteinheit (ein Wort oder ein Wortteil). „100 Token pro Sekunde“ bedeutet, dass das Modell etwa 100 dieser Einheiten pro Sekunde erzeugt: Je höher die Zahl, desto schneller kommt die Antwort.
- RAG (Retrieval-Augmented Generation): eine Technik, die dem Modell Zugriff auf Ihre Dokumente gibt (PDFs, interne Wikis usw.), damit es sich bei der Antwort auf Ihre Daten stützt statt nur auf sein Gedächtnis. Oft der Auslöser eines KI-Projekts im Unternehmen.
- Agentische KI: eine KI, die nicht nur einmal antwortet, sondern Schritte verkettet (ein Tool aufrufen, suchen, schlussfolgern, es erneut versuchen), um eine komplexe Aufgabe zu erledigen, wie ein Assistent, der selbst die Initiative ergreift.
 Agentische KI: Verkettung von Schritten und Tool-Aufrufen
Nicht ein Modell, sondern ein ganzer Stack
Ein KI-Projekt im Unternehmen stützt sich, sobald es etwas anspruchsvoller wird, nicht auf ein Modell, sondern auf mehrere Modelle, die parallel laufen: ein Haupt-LLM, leichte Modelle für einfache Aufgaben (Routing, Extraktion, Benennung), ein Embedding-Modell für die semantische Suche, ein Vision-Modell, wenn Sie Bilder oder gescannte PDFs auswerten. Sie beginnen wahrscheinlich mit 1 oder 2 Modellen und landen bei 5 oder 6.
Rund um diese Modelle besteht ein RAG on premise, das „wie ein Cloud-Dienst“ funktioniert, aus mindestens sieben Bausteinen, die betrieben werden wollen:
| Baustein | Selbst hostbare Open-Source-Optionen | Worauf zu achten ist |
|---|---|---|
| Inferenz-Engine | vLLM, SGLang, TensorRT-LLM | Hugging Face TGI ist seit März 2026 archiviert; Ollama verarbeitet standardmäßig eine Anfrage nach der anderen |
| Embeddings | Qwen3-Embedding, BGE-M3, multilingual-e5 | manche Modelle (jina-embeddings-v5) verbieten die kommerzielle Nutzung |
| Reranker | bge-reranker-v2-m3, Qwen3-Reranker | wie das Reranking die Textabschnitte vor dem LLM sortiert |
| Parsing und OCR | Docling, PaddleOCR, olmOCR | das Parsing wiegt schwer für die Qualität der Antworten (unser OCR-Vergleich) |
| Vektordatenbank | Qdrant, Milvus, Weaviate, pgvector | pgvector reicht für den Anfang oft aus |
| Gateway und Kontingente | LiteLLM | SSO und Audit-Logs gibt es nur in der kostenpflichtigen Version |
| Observability | Prometheus und Grafana (in vLLM integriert), Langfuse | die Prompt-Traces enthalten Ihre Daten |
Hinzu kommt die Zugriffskontrolle pro Dokument: Jeder Textabschnitt trägt die Rechte seines Quelldokuments (SharePoint, DMS), und die Suche filtert danach, bevor irgendetwas das LLM erreicht. Genau das trennt die Ollama-Demo vom Produktivdienst, und genau das wird am häufigsten unterschätzt.
Bei der Engine ist der Abstand zwischen einem Arbeitsplatz-Tool und einem Server alles andere als marginal: In einem Benchmark von Red Hat erreicht vLLM unter Last 793 Token/s, Ollama dagegen 41, auf derselben GPU mit demselben Modell.
Welche Open-Weight-Modelle lassen sich 2026 lokal betreiben?
Das Modell bestimmt die Hardware. Hier die wichtigsten Open-Weight-Modelle, die ein Unternehmen im Oktober 2026 bereitstellen kann, mit der Größe ihrer Gewichte auf Hugging Face:
| Modell | Parameter (gesamt / aktiv) | Gewichte | Lizenz | Empfohlene Hardware |
|---|---|---|---|---|
| gpt-oss-20b (OpenAI) | 21B / 3,6B | 13,8 GB | Apache 2.0 | passt in 16 GB Speicher |
| Mistral Small 3.2 | 24B dense | 48 GB | Apache 2.0 | etwa 55 GB GPU-Speicher |
| Gemma 4 31B (Google) | 30,7B dense | 62,5 GB | Apache 2.0 | eine GPU mit 80 bis 96 GB |
| gpt-oss-120b (OpenAI) | 117B / 5,1B | 65,2 GB | Apache 2.0 | eine GPU mit 80 GB, zwei für mehrere Nutzer |
| Mistral Small 4 | 119B / 6,5B | 121 GB (FP8) | Apache 2.0 | zwei GPUs |
| Nemotron 3 Super (NVIDIA) | 120B / 12B | 128 GB (FP8) | NVIDIA Open Model License | 2× H100 in FP8 |
| DeepSeek V4 Flash | 284B / 13B | etwa 160 GB | MIT | 8 GPUs (vLLM-Rezept auf 8× RTX PRO 6000) |
| Mistral Large 3 | 675B / 41B | 682 GB (FP8) | Apache 2.0 | ein Knoten mit 8× H200 oder B200 |
Drei Punkte sollte man im Kopf behalten:
- Claude, GPT-5 und die neuesten Gemini-Modelle lassen sich nicht herunterladen. Man kann sie nur in der Cloud ihres Herstellers oder eines Hyperscalers nutzen. Die Open-Weight-Modelle von OpenAI (gpt-oss) dagegen lassen sich frei installieren.
- Offene Modelle, die mit den besten geschlossenen Modellen mithalten (300 Milliarden bis über eine Billion Parameter), brauchen mindestens einen Server mit 8 GPUs. Die Stufe „60.000 €“ reicht für die Klasse von gpt-oss-120b, nicht darüber hinaus.
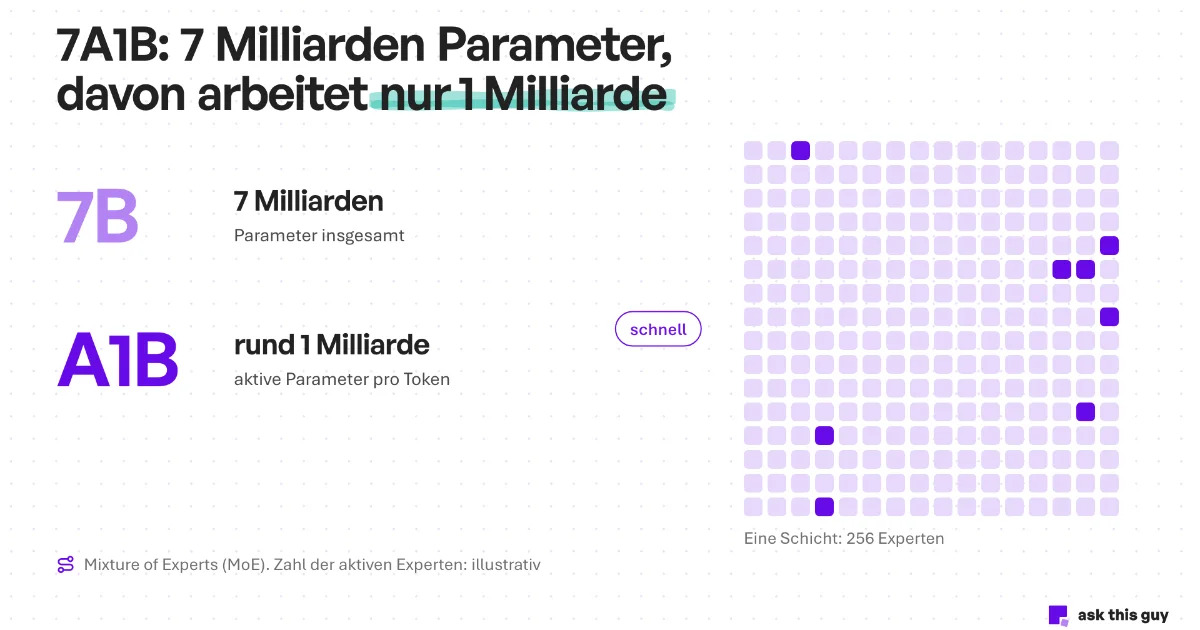
- Zwei Parameterangaben deuten auf ein Mixture of Experts (MoE) hin. Nur die aktiven Parameter arbeiten an jedem Token, aber alle müssen in den Speicher passen: Die Gesamtzahl bestimmt die GPU-Ausstattung. Unser Leitfaden zu Mixture of Experts erklärt den Unterschied zu einem Dense-Modell.
Wann „kleine“ Modelle genügen
 Wann kleine Modelle genügen
Mehrere Use Cases kommen mit leichten Modellen aus: einfache und präzise Aufgaben (eine Unterhaltung benennen, ein Feld extrahieren, einen Satz umformulieren), einfaches Retrieval, RAG mit faktischen Anfragen und wenig logischer Verkettung, Aufgaben mit Fine-Tuning auf einen engen Fachbereich.
Modelle mit 20 bis 30 Milliarden Parametern (gpt-oss-20b, Mistral Small 3.2, Gemma 4) können ausreichen, wenn Sie einige Halluzinationen in Kauf nehmen und akzeptieren, dass das Modell wenig „nachdenkt“. Der Vorteil: eine schlanke Infrastruktur, die das Make-Szenario erreichbar macht.
In der Praxis: Dieses Szenario ist selten und dient meist nur als Pilot vor einem umfassenderen Projekt.
Wann mittlere oder große Modelle unverzichtbar sind
Sobald die Komplexität steigt, wird ein Modell mit rund 100 Milliarden Parametern zum Minimum. gpt-oss-120b wird häufig eingesetzt, wegen der Bekanntheit seines Herstellers ebenso wie wegen seiner guten Leistung in dieser Größe. Größere Modelle (Mistral Large 3, DeepSeek, GLM usw.) empfehlen sich für komplexe Anfragen mit tiefem Schlussfolgern, mehrstufige Agenten mit Tool-Aufrufen, die Analyse mehrerer Dokumente und Aufgaben, die ein feines Kontextverständnis verlangen.
Kurz gesagt: Sobald Sie ausgereifte Agenten, fortgeschrittenes RAG oder anspruchsvolles fachliches Schlussfolgern anstreben, lassen sich große Modelle kaum ersetzen, ohne das Nutzererlebnis stark zu verschlechtern.
Welche Hardware braucht ein lokales LLM? Die Frage des GPU-Speichers
Laut NVIDIA passt die Regel in eine Zeile: Speicher = Modellgewichte + KV-Cache + Puffer. Die Gewichte hängen von der Anzahl der Parameter und ihrem Format ab (2 Byte in BF16, 1 in FP8, etwa 0,5 in 4 Bit). Der KV-Cache ist der Arbeitsspeicher des Modells für jede Unterhaltung: Er wächst mit der Länge des Kontexts und der Zahl gleichzeitiger Nutzer.
Ein Rechenbeispiel mit gpt-oss-120b (berechnet aus seiner veröffentlichten Konfiguration) für 32 gleichzeitige Nutzer mit je 32.000 Token Kontext (ein typisches RAG):
| Posten | Speicher |
|---|---|
| Modellgewichte | 65,2 GB |
| KV-Cache, 32 Nutzer × 32K Token | 38,7 GB |
| Gesamt, vor Puffer | etwa 104 GB |
OpenAI sagt zu Recht, dass das Modell „auf eine einzelne GPU mit 80 GB passt“. Auf einer H100 mit 80 GB bleiben aber nur etwa 10 GB für den KV-Cache, also ungefähr 7 lange Unterhaltungen gleichzeitig. Für rund dreißig Nutzer im RAG braucht es zwei H100 oder eine GPU mit 141 GB (H200) oder mehr.
| Hardware-Stufe | GPU-Speicher | Was mit Platz für die Nutzer hineinpasst |
|---|---|---|
| 1 GPU mit 24 bis 32 GB | 24 bis 32 GB | gpt-oss-20b, Gemma 4 oder Mistral Small in 4 Bit, wenige Nutzer |
| 1 GPU mit 80 bis 96 GB (H100, RTX PRO 6000) | 80 bis 96 GB | gpt-oss-120b mit wenigen langen Sitzungen; Gemma 4 31B |
| 2 GPUs | 160 bis 192 GB | gpt-oss-120b für einige Dutzend Nutzer; Mistral Small 4 |
| 8 GPUs (HGX H200, B200) | 768 GB bis 1,5 TB | DeepSeek V4 Flash, Mistral Large 3 |
Anspruchsvolle Nutzer: Tempo pro Nutzer gegen Gesamtdurchsatz
Die Nutzer sind ungeduldig geworden, verwöhnt von Consumer-Diensten wie ChatGPT, die fast sofort antworten. Die Geschwindigkeit entscheidet oft darüber, ob ein Tool angenommen oder abgelehnt wird. Unter 100 erzeugten Token pro Sekunde wird es leicht als langsam empfunden. Ist die KI agentisch, ruft mehrere Tools auf und „denkt nach“, sollte man eher 500 Token/Sekunde oder mehr anpeilen.
Richtwerte:
- ~500 Token/s: mehrstufige Projekte, Tool-Aufrufe, Schlussfolgern, komplexe Agenten.
- ~100 Token/s: einfache Aufgaben ohne Nachdenken (einfacher Chat, Vervollständigung).
Ein lokaler Server hat zwei Grenzen, die sich nicht gleichzeitig ausreizen lassen: die von jedem Nutzer gefühlte Geschwindigkeit und das Gesamtvolumen, das er erzeugt. Die veröffentlichten Benchmarks zeigen es:
- Auf 2× RTX PRO 6000 fällt gpt-oss-120b laut den Messungen von Millstone AI von 230 Token/s für einen einzelnen Nutzer mit kurzem Kontext auf 14,5 Token/s pro Nutzer bei 6 Nutzern mit langen Kontexten. Die Wartezeit bis zum ersten Wort steigt von 50 ms auf 18 Sekunden bei 128.000 Token Kontext.
- Auf 2× H100, die auf maximalen Durchsatz eingestellt sind, erreicht dasselbe Modell laut den Leistungstests von GPUStack 16.042 Token/s insgesamt (Eingabe und Ausgabe, davon 7.649 in der Ausgabe), doch jeder Nutzer erhält dann rund 12 Token/s, nach 4,6 Sekunden Wartezeit.
Hinter den „16.000 Token/s“ der Verkaufsbroschüren stehen Nutzer, die mit 12 Token/s bedient werden. Hinter den „200 Token/s“ steht ein einzelner Nutzer.
Zum Vergleich: Cerebras gibt für dasselbe Modell rund 3.000 Token/s an. Bei ATG beobachten wir 1.000 bis 2.000 Token/s: 4- bis 13-mal schneller als der lokale Server mit einem einzigen Nutzer, und unter Last noch weit mehr.
Die Nutzer sind außerdem an viele Zusatzfunktionen gewöhnt, etwa ein PDF an eine Nachricht anzuhängen und es sofort verarbeitet zu sehen. Cloud-Dienste sind darin hervorragend. Lokal lässt sich das anbieten, indem man das Dokument für ein Vision-Modell in Bilder umwandelt, doch das ist langsamer und oft eingeschränkt (etwa bei der Seitenzahl).
Hardwarepreise 2026: Die H100 ist verschwunden, der Speicher wird teurer
Die Größenordnung „2× H100 ≈ 60.000 €“ gilt für die Karten allein weiterhin, aber die Landschaft hat sich verändert:
- Die H100 wird nicht mehr neu verkauft. Laut dem Händler nelpx erfolgte die letzte Distributorenlieferung der H100 NVL am 15. Juni 2026; andere Händler wie Prostor führen sie noch für rund 28.446 € netto pro Karte. Ihre natürliche Nachfolgerin, die H200 NVL (141 GB), kostet gleich viel: ab 26.500 € netto, mit 50 % mehr Speicher.
- Die „erschwingliche“ Karte hat ihren Preis verdoppelt. Laut Tom's Hardware stieg die RTX PRO 6000 von NVIDIA (96 GB) von 8.565 Dollar im März 2025 auf 16.000 Dollar im August 2026, getrieben von der Speicherknappheit: Laut TrendForce hat sich Server-DRAM allein im dritten Quartal 2026 um 13 bis 18 % verteuert.
- Ein kompletter Server kostet mehr als seine Karten. Gehäuse, Prozessoren, RAM, Speicher und Netzwerk: Rechnen Sie mit 70.000 bis 90.000 € netto für einen Server mit 2 GPUs (unsere Schätzung). Zur Orientierung: Ein Server mit 3× RTX PRO 6000 wird bei LDLC Pro für 89.562 € netto angeboten, ein Lenovo mit 2× RTX PRO 6000 für 68.011 Dollar laut Lenovo Press.
- Die Veralterung ist messbar. Laut dem Prüfstand InferenceX von SemiAnalysis erzeugt eine B200 bei gleicher Geschwindigkeit pro Nutzer 5-mal mehr Token als eine H100 mit gpt-oss-120b. Heute gekaufte GPUs liegen zwei Generationen zurück, bevor sie abgeschrieben sind.
Die Miete ist der andere Anhaltspunkt. Eine H100 kostet 2,80 € pro Stunde bei OVHcloud und 2,87 € bei Scaleway, gegenüber 6,88 Dollar bei AWS und 12,29 Dollar bei Azure, laut dem Vergleichsportal Vantage. Zwei dauerhaft gemietete H100 bei OVHcloud kommen auf etwa 49.000 € pro Jahr: Ein Server mit 2 GPUs kostet so viel wie anderthalb Jahre Dauermiete, noch vor Energie, Hosting, Wartung und Personal.
Gesamtbetriebskosten: Der Kaufpreis ist nur eine Zeile
Unsere Schätzung für einen Server mit 2 GPUs zum Kaufpreis von 80.000 € netto, ausgelegt für gpt-oss-120b. Annahmen: 1,8 kW Leistungsaufnahme, Rechenzentrumseffizienz (PUE) von durchschnittlich 1,42 in Frankreich laut der französischen Regulierungsbehörde Arcep, Strom zu 0,20 € pro kWh (französische KMU, 2026), Colocation zu 100 bis 150 € pro kW und Monat, Wartung von 10 bis 12 % pro Jahr, LLMOps-Ingenieur mit 120.000 € Vollkosten pro Jahr (etwa 85.000 € brutto). Die Lizenz NVIDIA AI Enterprise (4.500 Dollar pro GPU und Jahr) ist bei den Karten H100 NVL und H200 NVL fünf Jahre lang inbegriffen.
| € pro Jahr | Niedrig (nur Hardware) | Mittel (¼ Ingenieur) | Hoch (½ Ingenieur, Abschreibung über 3 Jahre) |
|---|---|---|---|
| Abschreibung (4 Jahre) | 20.000 | 20.000 | 26.667 |
| Strom | 4.478 | 4.478 | 4.478 |
| Hosting | 0 | 2.400 | 3.600 |
| Wartung | 8.000 | 8.000 | 9.600 |
| Personal | 0 | 30.000 | 60.000 |
| Gesamt pro Jahr | ≈ 32.500 | ≈ 64.900 | ≈ 104.300 |
Der Strom ist nicht das Thema: 4 bis 14 % der Gesamtkosten. Personal und Abschreibung machen im mittleren und hohen Szenario 77 bis 83 % der Kosten aus. Und diese Tabelle enthält weder den Rest des RAG-Stacks noch eine zweite Maschine für die Redundanz noch die Projektkosten (Integration, Sicherheit, Tests).
Ab wann rechnet sich ein lokales LLM gegenüber derselben API?
Der ehrliche Vergleich erfolgt mit demselben Modell per API, nicht mit einem leistungsfähigeren geschlossenen Modell. gpt-oss-120b kostet beim französischen Anbieter Scaleway 0,15 € pro Million Eingabe-Token und 0,60 € pro Million Ausgabe-Token. Für ein RAG (etwa 8 Eingabe-Token auf 1 Ausgabe-Token) ergibt das im Schnitt 0,20 € pro Million Token.
Bei der Kapazität erzeugt eine H100 mit 100 Token/s pro Nutzer laut InferenceX bestenfalls 5.863 Token/s mit diesem Modell (gemessen auf stark optimierten Knoten, eine für On-Premise günstige Annahme). Ein Server mit 2 GPUs liefert also maximal 370 Milliarden Token pro Jahr im Dauerbetrieb und 93 Milliarden während der Geschäftszeiten.
| TCO-Szenario | Jährliche Kosten | Schwelle (Token pro Jahr) | Nötige Auslastung rund um die Uhr |
|---|---|---|---|
| Niedrig (nur Hardware) | 32.500 € | 162 Milliarden | 44 % |
| Mittel (¼ Ingenieur) | 64.900 € | 324 Milliarden | 88 % |
| Hoch (½ Ingenieur) | 104.300 € | 522 Milliarden | 141 % (unmöglich) |
So ist die Tabelle zu lesen:
- Bei gleichem Modell schlägt der Server die API nur, wenn er Tag und Nacht läuft, mit über 44 % seiner Kapazität ohne Personalkosten, mit 88 % bei einer Viertelstelle Ingenieur. Von 8 bis 18 Uhr ausgelastet und nachts leer, erzeugt er den Gegenwert von 18.600 € API-Kosten pro Jahr: weniger als allein seine Abschreibung.
- In Nutzern ausgedrückt entspricht die mittlere Schwelle rund 11.000 intensiven Nutzern eines RAG-Assistenten (20 Anfragen pro Tag). Der Server, während der Geschäftszeiten ausgelastet, bedient bestenfalls etwa 3.250.
- Erreichbar wird die Schwelle nur mit Massenverarbeitung im Hintergrund (Dokumente klassifizieren oder extrahieren, indexieren, Agenten im Batch), die Nächte und Wochenenden füllt.
- Warum andere Analysen auf „9 bis 18 Monate“ kommen: Sie vergleichen mit einer geschlossenen API. Gegenüber einem Modell der Klasse GPT-5, etwa zehnmal teurer, sinkt die mittlere Schwelle auf 34 Milliarden Token pro Jahr. Dann vergleicht man aber zwei Modelle unterschiedlicher Qualität. Die veröffentlichten Studien rechnen entweder nur den Strom oder die On-Demand-Miete von GPUs bei einem US-Hyperscaler.
Und die Schwelle verschiebt sich zuungunsten von On-Premise: Der Preis der Inferenz bei gleicher Leistung sinkt um etwa den Faktor 10 pro Jahr, während die gekaufte Hardware auf ihren Kosten von 2026 stehen bleibt.
Kurz gesagt: Allein bei den Kosten und bei gleichem Modell gewinnt Buy in fast allen interaktiven Anwendungen. On-Premise rechnet sich bei enormen, kontinuierlich verarbeiteten Volumen oder wenn eine andere Vorgabe als die Kosten es erzwingt.
Fünf Optionen zwischen „alles on premise“ und „öffentliche API“
Die Wahl ist nicht binär. Von der am stärksten kontrollierten bis zur am weitesten ausgelagerten:
| Option | Beispiel | Preisgrößenordnung | Souveränität |
|---|---|---|---|
| 1. On premise, im eigenen Haus oder in Colocation | Server mit 2 bis 8 GPUs | 70.000 bis 90.000 € + 32.000 bis 104.000 € pro Jahr | hängt nur von Ihnen ab |
| 2. Appliance „AI in a box“ | HPE Private Cloud AI, Dell AI Factory, NVIDIA DGX | mehrere Hunderttausend Euro | Hardware bei Ihnen, US-amerikanischer oder chinesischer Hersteller für den Support |
| 3. Dedizierte GPUs bei einem europäischen Hoster | Scaleway Managed Inference, OVHcloud | 6,68 € pro Stunde für 2× H100 bei Scaleway | ja, wenn der Hoster aus dem EWR kontrolliert wird |
| 4. API eines europäischen Anbieters | Scaleway, OVHcloud AI Endpoints | 0,15 € / 0,60 € pro Million Token für gpt-oss-120b | ja, unter derselben Bedingung |
| 5. Modell im privaten Netz eines US-Hyperscalers | AWS Bedrock, Azure OpenAI, Gemini auf Google Distributed Cloud | nach Nutzung | nein: Die Muttergesellschaft unterliegt dem CLOUD Act |
Option 3 ist der ehrlichste Vergleich zum Kauf: dieselbe Software, dasselbe Modell, dieselbe Isolation, aber ohne Investition und ohne Veralterung. Zwei dedizierte H100 bei Scaleway kosten im Dauerbetrieb etwa 58.500 € pro Jahr, oder etwa 14.700 €, wenn Sie sie nur während der Geschäftszeiten nutzen.
Souveränität: Was On-Premise löst und was nicht
On-Premise garantiert, dass nur Sie Zugriff auf die Daten im Klartext haben. Aber Souveränität setzt kein On-Premise voraus: Ein Open-Weight-Modell, das ein aus dem EWR kontrollierter europäischer Anbieter bereitstellt, bietet denselben rechtlichen Schutz, ohne Investition in Hardware. Unsere Regel ist streng: Ein Anbieter, dessen Muttergesellschaft außerhalb des EWR sitzt, fällt beim Kriterium Souveränität durch, auch mit europäischer Tochtergesellschaft und Rechenzentren in Europa, weil der CLOUD Act unabhängig vom Speicherort gilt.
Umgekehrt „telefoniert“ ein selbst gehostetes Open-Weight-Modell nicht nach Hause zu seinem Hersteller: Dessen Herkunft (OpenAI bei gpt-oss, Alibaba bei Qwen, DeepSeek) setzt Ihre Daten keinem Risiko aus. Sie wirkt sich auf die Kontinuität aus (keine garantierten Updates) und auf die Verzerrungen des Modells.
On-Premise bleibt gerechtfertigt für Systeme, die vom Internet getrennt sind (Verteidigung, Industriegeheimnisse), für vertragliche Vorgaben eines Kunden oder für eine Richtlinie, die jede Auslagerung untersagt. Das ist die Illusion, um die es in diesem Artikel geht: der Glaube, nur On-Premise sei souverän.
Checkliste für die Entscheidung
On-Premise verdient eine genauere Prüfung, wenn die meisten dieser Punkte zutreffen:
- die Pflicht, vom Internet getrennt zu arbeiten, oder ein Vertrag, der jeden Drittanbieter-Hoster ausschließt;
- ein Volumen, das die Maschine Tag und Nacht auslastet, dank Massenverarbeitung, nicht nur mit Chat während der Geschäftszeiten;
- ein Team, das GPUs, eine Inferenz-Engine und einen RAG-Stack betreiben kann, mit mindestens zwei Personen für die Kontinuität;
- Use Cases, die ein Modell der Klasse 120 Milliarden Parameter gut bewältigt, oder ein Budget für einen Server mit 8 GPUs;
- ein Budget von 70.000 bis 90.000 € für die Anschaffung, plus 30.000 bis 70.000 € pro Jahr für den Betrieb;
- Use Cases und Volumen, die bereits bei einem Anbieter validiert wurden.
Treffen weniger als drei Punkte zu, ist ein europäischer Anbieter der bessere Einstieg.
Häufige Fragen zum lokalen LLM
Was ist ein lokales LLM?
Ein Sprachmodell, das auf Hardware läuft, die das Unternehmen besitzt oder kontrolliert, im eigenen Netz und ohne fremde API auf dem Weg der Daten. In der Praxis ist es ein Open-Weight-Modell (gpt-oss, Mistral, Gemma, Qwen, DeepSeek), das eine Inferenz-Engine wie vLLM auf den GPUs des Unternehmens bereitstellt, im eigenen Rechenzentrum oder in Colocation.
Was kostet ein lokales LLM?
Für ein Modell wie gpt-oss-120b rechnen Sie mit etwa 60.000 € für zwei GPUs und 70.000 bis 90.000 € netto für den kompletten Server. Der Betrieb kostet 32.000 bis 104.000 € pro Jahr, je nach eingesetzter Personalzeit, wobei Abschreibung und Personal weit stärker ins Gewicht fallen als der Strom.
Ab welchem Volumen ist ein lokales LLM günstiger als eine API?
Bei gleichem Modell schlägt ein Server mit 2 GPUs für gpt-oss-120b den API-Preis eines europäischen Anbieters ab 160 bis 520 Milliarden Token pro Jahr. Das setzt voraus, dass er Tag und Nacht mit 44 bis 88 % seiner Kapazität läuft. Interaktive Nutzung während der Geschäftszeiten erreicht das nie, Massenverarbeitung im Hintergrund schon.
Wie viel GPU-Speicher braucht ein LLM?
Addieren Sie die Modellgewichte (Parameter × Byte pro Parameter), den KV-Cache (der mit der Kontextlänge und der Zahl gleichzeitiger Nutzer wächst) und einen Sicherheitspuffer. gpt-oss-120b wiegt 65 GB, doch 32 Nutzer mit je 32.000 Token Kontext zu bedienen, erfordert etwa 104 GB, also zwei GPUs mit 80 GB.
vLLM oder Ollama in der Produktion?
Ollama ist für einen Arbeitsplatzrechner gedacht: Es verarbeitet standardmäßig eine Anfrage nach der anderen. Für einen Dienst, den sich mehrere Nutzer teilen, braucht es eine Engine wie vLLM oder SGLang, die Anfragen bündelt und auf derselben GPU einen weit höheren Durchsatz liefert.
Was braucht ein RAG on premise?
Neben dem LLM: ein Embedding-Modell, einen Reranker, ein Parsing- und OCR-Tool für die Dokumente, eine Vektordatenbank, ein Gateway mit Authentifizierung und Kontingenten, Observability und eine Zugriffskontrolle pro Dokument, damit jeder Nutzer nur findet, was er lesen darf. Das sind mindestens sieben Bausteine, die betrieben werden wollen.
Braucht man On-Premise für DSGVO-Konformität oder Souveränität?
Nein. Ein aus dem Europäischen Wirtschaftsraum kontrollierter Anbieter, der Open-Weight-Modelle in Europa bereitstellt, bietet denselben rechtlichen Schutz ohne Hardwarekauf. On-Premise bleibt sinnvoll, wenn die Systeme vom Internet getrennt sein müssen oder ein Vertrag jeden Drittanbieter-Hoster ausschließt.
Kann man Claude, GPT-5 oder Gemini on premise installieren?
Claude und GPT-5 nicht: Ihre Gewichte lassen sich nicht herunterladen, und sie sind nur in der Cloud ihres Herstellers oder eines Hyperscalers verfügbar. Gemini gibt es auf Google Distributed Cloud, auch im getrennten Modus, aber der Hersteller bleibt US-amerikanisch. Die Open-Weight-Modelle von OpenAI, gpt-oss-20b und gpt-oss-120b, lassen sich frei installieren.
Ist ein lokales LLM so gut wie ChatGPT?
Nicht bei gleichem Hardwarebudget. Offene Modelle der Klasse 120 Milliarden Parameter, die auf einem Server mit 2 GPUs laufen, bleiben beim komplexen Schlussfolgern hinter den besten geschlossenen Modellen zurück. Offene Modelle, die an diese heranreichen (300 Milliarden bis über eine Billion Parameter), brauchen mindestens einen Server mit 8 GPUs.
Fazit
On-Premise ist sinnvoll für klar abgegrenzte Use Cases mit strengen Vorgaben (vom Internet getrennte Systeme, vertragliche Pflichten) oder mit sehr großen, kontinuierlich verarbeiteten Volumen. Für ein ambitioniertes Unternehmensprojekt (Agenten, komplexes RAG, Schlussfolgern) gewinnt Buy in der Regel bei Geschwindigkeit, Einfachheit und, bei gleichem Modell, bei den Kosten.
On-Premise ist oft eine Überzeugungsfrage, und das ist völlig legitim. Umsetzen lässt es sich aber leichter, wenn man weiß, was das eigene Projekt wirklich braucht.
Unsere Empfehlung bei Ask This Guy: mit einem europäischen Anbieter beginnen, um Erfahrung zu sammeln und Use Cases und Volumen zu validieren, und On-Premise erst dann prüfen, wenn Volumen und besondere Anforderungen es rechtfertigen. Wenn Ihre Priorität ein einsatzfähiges RAG on premise ist, ohne den ganzen Stack neu zu bauen, lohnt zuerst ein Blick auf unsere RAG-Lösung für Unternehmen (europäisches Hosting, On-Prem-Option).
Und wenn Ihr Hauptmotiv eher die Souveränität als die Kosten ist, lohnt es sich, zuerst zu klären, was dieser Begriff genau umfasst: Souveräne KI, Definition und Kriterien. Das Modell selbst zu hosten ist nur eine der drei Schichten, um die es geht, und selten die dringendste.
Um sich in KI weiterzubilden
Zwischen lokalem Betrieb und Inferenzanbieter abwägen, GPUs dimensionieren, die Kosten eines Modells in der Produktion im Griff behalten: Diese Abwägungen lassen sich lernen. Für Fachleute, die sich in MLOps und LLMOps weiterbilden wollen, bietet Jedha einen 150-stündigen Lehrgang zur Industrialisierung von KI an: verteilte Infrastruktur (GPUs, Kubernetes), Data Governance, Konformität mit DSGVO und AI Act sowie Kostenkontrolle. Nach heutigem Stand ist es die einzige Ausbildung in Frankreich, die beides zugleich abdeckt. Sie richtet sich an Profile mit bereits zwei Jahren Erfahrung in Data oder KI.
Sie möchten einen leistungsfähigen KI-Assistenten einsetzen, ohne die Infrastruktur zu verwalten? Buchen Sie eine 20-minütige Demo, wir zeigen Ihnen, wie.