DeepSeek V4.1 Pro vs. DeepSeek V4 Pro: Was ist zu erwarten?
DeepSeek V4.1 Pro ist am 16. November nicht erschienen. Was bestätigt ist, was Gerüchte taugen und was DeepSeek V4 Pro heute bietet: Preis, Lizenz, Datenschutz.

Am 16. November 2026 gibt es DeepSeek V4.1 Pro nicht. Das Änderungsprotokoll der DeepSeek-API erwähnt es nicht, und die DeepSeek-Organisation auf Hugging Face hat kein Repository unter diesem Namen. Das chinesische Labor hat den Namen genau einmal geschrieben, am 10. September in der Ankündigung von V4.1 Flash: Anfragen an V4 Pro sollten auf das neue Flash-Modell umgeleitet werden, „until V4.1-Pro launches“, also bis zum Erscheinen von V4.1 Pro. Das Pro-Modell, das man heute nutzen kann, heißt DeepSeek V4 Pro, in der Version V4-Pro-0813, erschienen am 13. August.
Der Name ist also offiziell, sonst nichts: kein Datum, keine Größe, kein Preis, kein Benchmark. Und selbst diese eine Erwähnung wurde am nächsten Tag korrigiert. Am 11. September verzichtete DeepSeek auf die Umleitung, „in response to user demand“, und ließ V4 Pro weiterlaufen. Seitdem sind 67 Tage ohne V4.1 Pro vergangen, gegenüber 13 Tagen zwischen den finalen Versionen von V4 Flash und V4 Pro im vergangenen Sommer.
Für ein Unternehmen lohnt sich das Warten aus unserer Sicht nicht. Das kleine Modell der neuen Generation ist schon besser als das alte große: Laut DeepSeek liegt V4.1 Flash „ahead of V4-Pro on performance, cost, speed & total runtime“, und Artificial Analysis misst 32,6 Punkte gegenüber 23,1 für V4 Pro. Es ist günstiger, und Scaleway bietet es bereits aus Frankreich an, was für keine Version von V4 Pro gilt.
Zur Einordnung: DeepSeek ist ein chinesisches KI-Labor, 2023 in Hangzhou gegründet und vom Hedgefonds High-Flyer finanziert. Es veröffentlicht seine Modelle als Open Weights: Die Gewichte, also die Dateien mit dem trainierten Modell, lassen sich herunterladen, bei V4 Pro unter der MIT-Lizenz, einer der freizügigsten Lizenzen. Bei DeepSeek steht „Pro“ für das große Modell und „Flash“ für das schnelle, günstige.
Ist DeepSeek V4.1 Pro schon erschienen? Was bestätigt ist
Nein. Die Tabelle zeigt den Stand am 16. November 2026, getrennt nach Gesichertem und Gerüchten.
| Information | Status |
|---|---|
| Der Name „V4.1 Pro“ | Einmal von DeepSeek geschrieben, am 10. September, ohne Datum oder Eigenschaften |
| Umleitung von V4 Pro auf V4.1 Flash „bis zum Erscheinen von V4.1 Pro“ | Am 10. September angekündigt, am 11. zurückgenommen, bevor sie galt; die Ankündigungsseite wurde nie korrigiert |
| Gewichte auf Hugging Face | Kein Repository V4.1 Pro, weder bei DeepSeek noch bei Dritten; das jüngste Repository von DeepSeek ist V4.1 Flash 1017 vom 17. Oktober |
| API-Kennung, Preis | Keine: die Preisliste von DeepSeek führt nur deepseek-flash und deepseek-v4-pro |
| Größe, Architektur, Lizenz, Benchmarks | Unbekannt |
| Leak vom 11. November | Daten eines Unit-Tests in einem Coding-Agenten von Vercel Labs, keine Ankündigung |
| Jüngste Ankündigung von DeepSeek | Am 13. November: APIs für Suche, OCR und Sprachsynthese, nur für das Flash-Modell |
Gerüchte und Leaks: Was sie wert sind
Das meistgeteilte stammt vom 11. November. Eine Kennung deepseek/deepseek-v4.1-pro tauchte in der Modellauswahl eines Open-Source-Coding-Agenten auf. Es handelt sich um fx von Vercel Labs, und die Zeichenkette steht in einem Unit-Test dieses Commits, neben anderen Modellen mit einem von Hand gesetzten Sortierschlüssel. Der Test brauchte ein Pro-Modell, das neuer ist als das Flash-Modell. OrcaRouter bringt es auf den Punkt: „the fixture is not a schedule“, ein Testdatensatz ist kein Zeitplan.
Am 31. Oktober hatte ein Labor der Renmin-Universität bereits --model deepseek-v4.1-pro in das Startbeispiel seines Werkzeugs FlashRSI geschrieben und es danach wieder entfernt. Dutzende GitHub-Repositorys enthalten dieselbe Zeichenkette, oft auf deepseek-v4-pro abgebildet: Entwickler, die vorausplanen, keine Leaks.
Auf X folgen die Ankündigungen seit September aufeinander: ein Erscheinen „in den nächsten zwei Wochen“, ein versteckter Vorabzugang, ein Zeitfenster „zweite Oktoberhälfte bis erste Novemberhälfte“. kie.ai hat sie gesammelt, und alle Termine sind ohne Veröffentlichung verstrichen. Keine der kursierenden Zahlen, etwa „mindestens 2,6 Billionen Parameter“, nennt eine Quelle.
Wann erscheint DeepSeek V4.1 Pro?
Niemand weiß es, und der Präzedenzfall macht wenig Hoffnung. Bei V4 veröffentlichte DeepSeek Flash und Pro am selben Tag, dem 24. April, und die finalen Versionen mit 13 Tagen Abstand: Flash 0731 am 31. Juli, mit dem Hinweis „The official release of DeepSeek-V4-Pro will follow soon“, dann Pro 0813 am 13. August. Bei V4.1 erschien Flash am 10. September, das Update V4.1 Flash 1017 am 17. Oktober, und auf das Pro-Modell wartet man seit 67 Tagen.
Auf Polymarket, einem Prognosemarkt, gaben die Wettenden am 16. November einem neuen DeepSeek-Pro-Modell bis zum 30. November eine Chance von 10 % und bis Jahresende von 17 %. Sie erwarten eher ein neues Flash-Modell als ein Pro-Modell, und DeepSeek hat im Oktober tatsächlich ein Flash-Update veröffentlicht, nicht das Pro-Modell. Eine Quote ist keine Information, aber sie zeigt, dass nichts Belastbares auf ein baldiges Erscheinen hindeutet.
DeepSeek V4 Pro heute: Was das verfügbare Modell taugt
Ein MoE mit 1,6 Billionen Parametern unter MIT-Lizenz
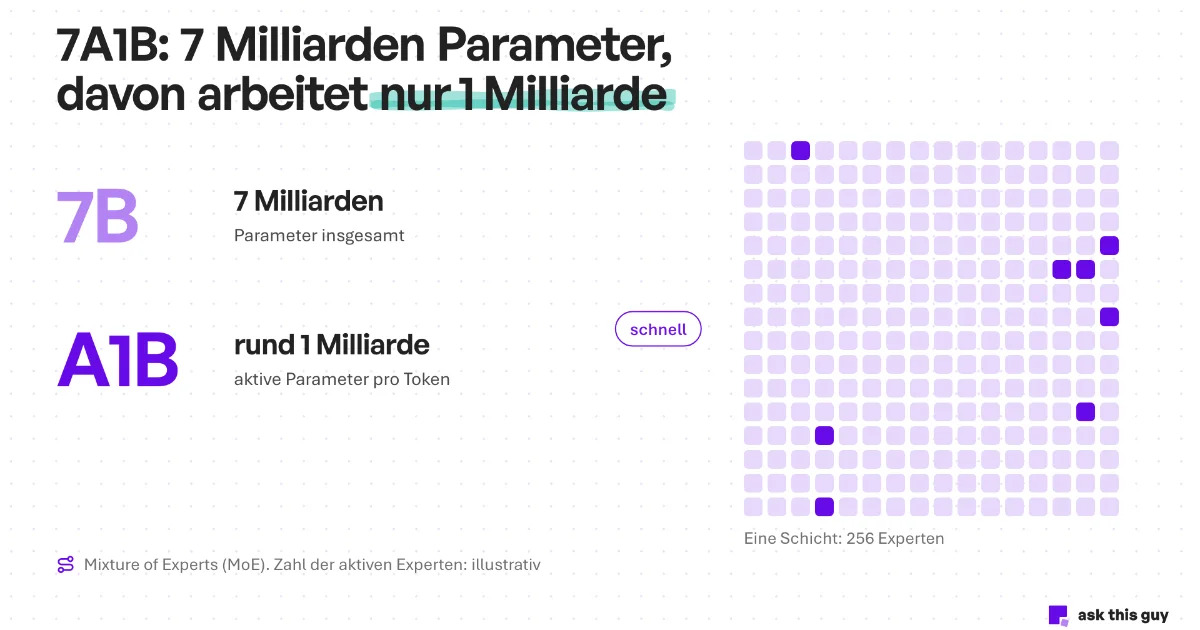
DeepSeek V4 Pro ist ein Mixture of Experts (MoE): Das Modell ist in „Experten“ aufgeteilt, und für jedes Token, das Wortstück, das das Modell liest oder schreibt, arbeiten nur wenige davon. Laut DeepSeek hat es 1,6 Billionen Parameter, davon 49 Milliarden aktiv pro Token, und liest bis zu eine Million Tokens Kontext. Die Version 0813, erschienen am 13. August, ersetzt die Vorschau vom April, bringt drei Stufen für den Denkaufwand (low, high, max) und bleibt unter MIT-Lizenz: kommerzielle Nutzung, Änderung und Betrieb als Dienst sind frei.
Die Größe ist die erste Hürde. Die Dateien von V4-Pro-0813 wiegen auf Hugging Face 892,7 GB, obwohl die Experten in FP4 gespeichert sind, einem Format mit 4 Bit pro Parameter. Das Rezept von vLLM, der Referenz-Inferenzsoftware, geht von einem Server mit acht H200 aus und begrenzt den Kontext auf 800.000 Tokens, damit Platz für den Arbeitsspeicher bleibt. Acht H100 mit je 80 GB, zusammen 640 GB, reichen nicht einmal, um die Gewichte zu laden. V4 Pro ist ein Modell fürs Rechenzentrum, nicht für einen lokalen KI-Server.
Was DeepSeek angibt, was andere messen
Die Zahlen von DeepSeek sehen gut aus. Auf der Modellkarte von V4-Pro-0813 erreicht das Modell 87,9 auf Terminal Bench 2.1 gegenüber 85,0 für Claude Opus 4.8 und 62,7 auf DeepSWE gegenüber 58,0. Diese Werte wählt der Hersteller selbst aus, misst sie mit seinem eigenen Agenten-Werkzeug, DeepSeek Harness, und vergleicht sie mit Modellen, die inzwischen ersetzt sind. Auch die Benchmarks wechseln von Karte zu Karte: SWE-bench, für die Vorschau veröffentlicht, fehlt bei Version 0813.
Unabhängige Messungen fallen bescheidener aus. Im Intelligence Index von Artificial Analysis (Version 5.0.1, 16. November) erreicht V4 Pro 0813 bei maximalem Aufwand 23,1 Punkte, den Median seiner Kategorie. Damit liegt es unter Mistral Large 4 mit 26,1 und weit hinter Kimi K3.1 Pro, dem besten Open-Weights-Modell der Rangliste mit 46,5. Im Mai bescheinigte CAISI, die Evaluierungsstelle des US-amerikanischen NIST, der Vorschau „about 8 months“ Rückstand auf die Spitze, fand sie aber kostengünstiger als Modelle vergleichbarer Leistung.
V4.1 Flash ist schon besser als V4 Pro
DeepSeek sagt es selbst. Am 10. September stellte es V4.1 Flash als „ahead of V4-Pro on performance, cost, speed & total runtime“ vor und kündigte an: „We're phasing out V4-Pro“. Auf der Modellkarte von V4.1 Flash steigt das neue Modell gegenüber V4 Pro 0813 auf DeepSWE von 62,7 auf 74,2 und auf Terminal-Bench 4.0 von 12,4 auf 31,2. Das Oktober-Update V4.1 Flash 1017 legt noch zu, auf 77,0 und 42,3.
Artificial Analysis bestätigt die Reihenfolge, mit kleineren Abständen. V4.1 Flash 1017 erreicht 32,6 Punkte, das zweitbeste Open-Weights-Modell der Rangliste, gegenüber 23,1 für V4 Pro. Es erzeugt 173 Tokens pro Sekunde statt 93 und kostet 0,60 Dollar pro Indexaufgabe, gegenüber 1,77 Dollar für V4 Pro. Auf Terminal-Bench 4.0 misst Artificial Analysis 33,8 %, wo DeepSeek 42,3 angibt: Der Wert hängt vom Agenten-Werkzeug ab.
Der Einwand betrifft das Wissen. Laut DeepSeeks eigenen Tabellen behält das Basismodell von V4 Pro bei Faktenfragen (55,2 gegenüber 42,3 auf SimpleQA-Verified) und langen Dokumenten (51,5 gegenüber 45,2 auf LongBench-V2) die Nase vorn. Das ist folgerichtig: Wissen steckt in der Gesamtzahl der Parameter, und V4 Pro hat dreimal so viele. V4.1 Flash ist zudem gesprächig, mit 174 Millionen erzeugten Tokens für den Index gegenüber einem Median von 104 Millionen. Bei Wissen und langen Dokumenten hätte ein V4.1 Pro am meisten zu bieten.
Preis der API von DeepSeek V4 Pro: Spitzenzeiten am europäischen Vormittag
Die Preisliste von DeepSeek unterscheidet Spitzen- und Nebenzeiten, Letztere zum halben Preis. In Dollar pro Million Tokens, Stand 16. November:
| Modell | Eingabe (ohne Cache), Neben- / Spitzenzeit | Ausgabe, Neben- / Spitzenzeit |
|---|---|---|
deepseek-v4-pro (V4 Pro 0813) | 0,66 / 1,32 | 1,98 / 3,96 |
deepseek-flash (V4.1 Flash 1017) | 0,15 / 0,30 | 0,60 / 1,20 |
Die Spitzenzeiten laufen von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC, montags bis freitags, außer an chinesischen Feiertagen: 9 bis 12 Uhr und 14 bis 18 Uhr in Peking. In Mitteleuropa entspricht das 7 bis 11 Uhr im Winter und 8 bis 12 Uhr im Sommer, dazu ein Zeitfenster in der Nacht: Der europäische Arbeitsvormittag zahlt den vollen Preis.
Der Preis hat sich in sieben Monaten stark bewegt. Zum Start kostete V4 Pro 1,74 Dollar für die Eingabe und 3,48 für die Ausgabe. Ein Rabatt von 75 % wurde am 22. Mai dauerhaft, also 0,435 und 0,87 Dollar. Am 12. August kündigte DeepSeek „a significant increase“ an, gültig ab dem 16. August. Gegenüber dem Juni-Preis kostet die Eingabe zu Spitzenzeiten das Dreifache und die Ausgabe das 4,6-Fache, mehr noch als zum Start.
Flash ging den umgekehrten Weg. Am 10. September senkte DeepSeek den Preis mit V4.1 Flash: „We're passing the savings on to you“. Zu Spitzenzeiten kostet V4 Pro bei der Eingabe 4,4-mal und bei der Ausgabe 3,3-mal so viel wie V4.1 Flash, bei niedrigerem Wert. Verständlich, dass DeepSeek den Verkehr umlenken wollte. Seine Kunden haben trotzdem durchgesetzt, V4 Pro zu behalten: ein Zeichen, dass das große Modell für manche Aufgaben nützlich bleibt.
Was ist von DeepSeek V4.1 Pro zu erwarten?
Zur Leistung ist nichts veröffentlicht. Zur Form gibt die Ankündigung von V4.1 Flash Hinweise. DeepSeek stellt Flash dort als „the smallest model in our new architecture family“ vor, ausgelegt auf „scaling to larger models“. V4.1 Pro wäre demnach das große Modell derselben Familie.
Diese Familie bricht mit V4. Laut der Modellkarte von V4.1 Flash beruht sie auf einer Architektur „Causal Encoder-Decoder“. Das Modell mit 552 Milliarden Parametern aktiviert nur 8 Milliarden, um die Anfrage zu lesen, und 16 Milliarden, um die Antwort zu schreiben. Sein Arbeitsspeicher pro Token, der KV-Cache, sinkt auf 890 Byte, etwa ein Viertel dessen von V4 Flash: Dieselbe GPU hält mehr lange Unterhaltungen gleichzeitig.
Die angegebene Größe täuscht allerdings. Flash ergänzt seine 552 Milliarden Parameter um einen bedingten Speicher namens Engram mit 196 Milliarden, und seine Dateien wiegen 510 GB. Ein V4.1 Pro, das größer ist als Flash, wird vermutlich mehr als 510 GB wiegen: mindestens ein Server mit acht High-End-GPUs, vielleicht mehr. Das ist eine Schlussfolgerung, keine Information: DeepSeek hat keine Größe veröffentlicht.
Zur Lizenz: DeepSeek hat die Gewichte aller Versionen von V4 und V4.1 bisher unter MIT veröffentlicht, wie seine Hugging-Face-Organisation zeigt. Garantiert ist das für V4.1 Pro nicht: Keine Erklärung bezieht sich darauf. Am Tag des Erscheinens prüfen wir sechs Punkte:
- ob die Gewichte veröffentlicht werden, und unter welcher Lizenz;
- ihre tatsächliche Größe auf der Festplatte, Engram-Speicher eingeschlossen, und die von DeepSeek oder vLLM angegebene Mindest-Hardware;
- den Preis der API, zu Spitzen- und Nebenzeiten;
- den Wert bei Artificial Analysis, verglichen mit V4.1 Flash (32,6) und Kimi K3.1 Pro (46,5);
- die Ergebnisse bei Wissen und langen Dokumenten, wo V4 Pro vorn liegt;
- wann ein europäischer Hoster es anbietet.
DeepSeek im Unternehmen: die API nein, die Gewichte ja?
Der Name „DeepSeek“ steht für zwei Dinge, die eine IT-Abteilung auseinanderhalten sollte: den Dienst von DeepSeek und die Gewichte seiner Modelle.
API und App speichern Daten in China
Die Datenschutzerklärung von DeepSeek, aktualisiert im Februar 2026, ist eindeutig: „we directly collect, process and store your Personal Data in People's Republic of China“. Eingaben können zum Training verwendet werden, mit Widerspruch per E-Mail. Zwei europäische Behörden haben bereits reagiert. Die italienische Datenschutzbehörde Garante ordnete am 30. Januar 2025 eine sofortige Einschränkung der Verarbeitung der Daten italienischer Nutzer an. Im Juni 2025 meldete die Berliner Datenschutzbeauftragte die App bei Apple und Google als rechtswidrigen Inhalt. In den USA schließt eine am 20. Oktober 2026 im Federal Register veröffentlichte Mitteilung DeepSeek-Produkte aus den zivilen Bundesbehörden aus.
Unser Souveränitätstest ist einfach: Ein Anbieter, dessen Muttergesellschaft außerhalb des Europäischen Wirtschaftsraums sitzt, fällt durch, egal wo seine Server stehen. Die API von DeepSeek fällt schon bei dieser ersten Prüfung durch, und ein Unternehmen, das personenbezogene Daten dorthin schickt, richtet eine Übermittlung nach China ein, die es nach der DSGVO rechtfertigen muss.
MIT-Gewichte, in Europa gehostet, senden nichts an DeepSeek
Ein Open-Weights-Modell „telefoniert“ nicht mit seinem Hersteller. Einmal heruntergeladen, sind die Gewichte Dateien, die auf Servern Ihrer Wahl laufen. Von einem europäischen Betreiber gehostet, sendet ein DeepSeek-Modell nichts nach Hangzhou. Die Souveränität hängt davon ab, wer die Rechenleistung betreibt, nicht von der Herkunft der Gewichte. Dasselbe haben wir für Qwen, das Modell von Alibaba, festgestellt.
In der Praxis gilt das für V4.1 Flash, nicht für V4 Pro. Scaleway bietet V4.1 Flash 1017 an, serverlos mit einem während der Vorschau auf 256.000 Tokens begrenzten Kontext, oder auf einem dedizierten Server mit acht H100. Umans, ein französischer Inferenzanbieter und Partner von Ask This Guy, bietet V4.1 Flash ebenfalls an, zu 0,15 Dollar für die Eingabe und 0,60 für die Ausgabe. Für V4 Pro haben wir am 16. November keinen souveränen europäischen Hoster gefunden, und der Katalog von OVHcloud enthält kein DeepSeek-Modell. Man müsste es also selbst betreiben, auf einem Server mit acht H200.
Zwei Fragen bleiben offen, und sie gelten auch für US-Modelle: die vom Training geerbten Verzerrungen, die an den eigenen Anwendungsfällen zu testen sind, und die Abhängigkeit von einem Hersteller, dessen Zeitplan sich von einem Tag auf den anderen ändert. Unsere Seite zur souveränen KI beschreibt diese Kriterien, und unser Artikel zu Open-Source-KI-Lizenzen vergleicht MIT mit den Lizenzen von Mistral und Qwen.
Was eine IT-Abteilung daraus mitnehmen kann
Auf V4.1 Pro zu warten, um ein Projekt zu starten, ergibt keinen Sinn: Nichts deutet auf ein Erscheinen hin, und das Modell, das V4 Pro schon übertrifft, ist verfügbar. Wenn ein DeepSeek-Modell zum Anwendungsfall passt, würden wir mit V4.1 Flash 1017 bei einem europäischen Hoster beginnen, nicht mit V4 Pro über die API von DeepSeek. V4 Pro kostet mehr, erreicht einen niedrigeren Wert und schickt über die API Daten nach China.
Für reine Wissensaufgaben und sehr lange Dokumente behält V4 Pro seinen Nutzen, denn dort liegt es vorn. Man muss es aber hosten können: 893 GB Gewichte bedeuten einen Server mit acht H200, eine Investition, die sich nur bei dauerhaftem Volumen und Daten lohnt, die das Unternehmen nicht verlassen dürfen.
Der Modellwechsel wird am besten von Anfang an vorbereitet. Europäische Hoster bieten eine zu OpenAI kompatible API, und ein LLM-Gateway erlaubt den Modellwechsel per Konfiguration, ohne den Code anzufassen. Mit 100 bis 300 echten Fragen und den erwarteten Antworten, wie in unserem Leitfaden zum RAG-Audit beschrieben, bewertet ein Team V4.1 Pro am Tag des Erscheinens in einem halben Tag und wechselt, wenn der Gewinn real ist.
Häufige Fragen zu DeepSeek V4.1 Pro und V4 Pro
Ist DeepSeek V4.1 Pro schon erschienen?
Nein. Am 16. November 2026 hat DeepSeek für V4.1 Pro weder Gewichte noch API-Kennung, Preis oder Benchmarks veröffentlicht. Das einzige verfügbare Pro-Modell ist DeepSeek V4 Pro in der Version 0813, erschienen am 13. August 2026. Der Name V4.1 Pro taucht nur in der Ankündigung von V4.1 Flash vom 10. September auf.
Wann erscheint DeepSeek V4.1 Pro?
Es gibt kein offizielles Datum. DeepSeek hat keinen Zeitplan genannt, und alle seit September in sozialen Netzwerken genannten Termine sind ohne Veröffentlichung verstrichen. Bei V4 folgte die finale Pro-Version der Flash-Version nach 13 Tagen; bei V4.1 erschien Flash am 10. September, und das Pro-Modell fehlt 67 Tage später noch immer. Am 16. November gaben die Wettenden auf Polymarket einem neuen Pro-Modell bis zum 30. November eine Chance von 10 %.
Was unterscheidet DeepSeek V4 Pro von V4.1 Flash?
V4 Pro ist das große Modell der Generation V4: 1,6 Billionen Parameter, davon 49 Milliarden aktiv pro Token, 893 GB Gewichte. V4.1 Flash, erschienen am 10. September, ist das kleinste Modell einer neuen Architektur: 552 Milliarden Parameter, 8 bis 16 Milliarden aktiv, 510 GB Gewichte. Laut DeepSeek und laut Artificial Analysis ist V4.1 Flash bei Code und Agenten besser und günstiger; V4 Pro liegt bei Faktenwissen und langen Dokumenten vorn.
Was kostet die API von DeepSeek V4 Pro?
Am 16. November 2026 kostet sie zu Nebenzeiten 0,66 Dollar pro Million Eingabe-Tokens und 1,98 Dollar pro Million Ausgabe-Tokens, zu Spitzenzeiten das Doppelte. Die Spitzenzeiten laufen werktags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC, im Winter also von 7 bis 11 Uhr in Mitteleuropa. Der Ausgabepreis zu Spitzenzeiten, 3,96 Dollar, ist das 4,6-Fache des Preises vom Juni 2026, vor der Erhöhung vom 16. August.
Ist DeepSeek V4 Pro Open Source?
DeepSeek V4 Pro ist ein Open-Weights-Modell: Seine Gewichte lassen sich auf Hugging Face unter der MIT-Lizenz herunterladen, die kommerzielle Nutzung, Änderung und Betrieb als Dienst erlaubt. Trainingsdaten und Trainingscode sind nicht veröffentlicht, was es von Open-Source-Software im strengen Sinn unterscheidet.
Welche Hardware braucht man, um DeepSeek V4 Pro lokal zu betreiben?
Die Gewichte von V4 Pro 0813 wiegen 892,7 GB. Das Rezept von vLLM geht von einem Server mit acht H200-GPUs aus, mit auf 800.000 Tokens begrenztem Kontext; DeepSeek nennt auch ein Beispiel auf einem Knoten mit vier GB300. Acht H100 mit je 80 GB können die Gewichte nicht laden. Für Arbeitsplatzrechner oder kleine Server ist das Modell nicht gedacht.
Lässt sich DeepSeek im Unternehmen DSGVO-konform nutzen?
Über die API oder die App von DeepSeek ist das schwierig: Laut Datenschutzerklärung speichert DeepSeek die Daten in China, und zwei europäische Behörden, in Italien und in Berlin, haben diese Übermittlungen beanstandet. Mit MIT-Gewichten bei einem europäischen Betreiber gehen keine Daten an DeepSeek. Scaleway bietet V4.1 Flash aus Frankreich an; V4 Pro bot am 16. November 2026 kein europäischer Hoster an.
DeepSeek wollte sein großes Modell zugunsten des kleinen abschaffen, und die Kunden haben es verhindert. Bis auf Weiteres kostet das Spitzenmodell der vorigen Generation mehr als ein neueres Modell mit besserem Wert. Wenn V4.1 Pro erscheint, wird sein Ergebnis gegen Kimi K3.1 Pro die Schlagzeilen machen. Für ein europäisches Unternehmen liegt die nützliche Frage woanders: Wer betreibt es in Europa, auf welcher Hardware, und zu welchem Preis?