Lokaler KI-Server: Welche Hardware braucht ein LLM?
KI-Server lokal betreiben: Workstation, RTX PRO 6000 oder H200. Was jede Hardware-Stufe mit Qwen 3.8 27B leistet, Durchsätze und Preise vom 16. November 2026.

Ein lokaler KI-Server ist eine Maschine im Besitz des Unternehmens, die ein Sprachmodell (ein lokales LLM) betreibt, ohne Daten an eine externe API zu schicken. Das Referenzmodell dieses Artikels, Qwen 3.8 27B, passt auf eine Grafikkarte mit 24 GB und erzeugt dort 40 bis 75 Tokens pro Sekunde für einen Nutzer. Auf einer Server-GPU vom Typ H100 erhält bei 50 gleichzeitigen Anfragen jeder Nutzer 35 Tokens pro Sekunde mit SGLang und weniger als eins mit Ollama.
Anders gesagt: Die Zahl der gleichzeitigen Anfragen bestimmt, welche Hardware man kaufen muss, und damit das Budget, zusammen mit der Länge der gesendeten Dokumente. Dasselbe Modell läuft auf einer Karte für 2.333 € netto und auf einer H200 NVL für 32.533 € netto; nur die zweite versorgt ein ganzes Unternehmen.
Wir haben die veröffentlichten Messungen für drei Stufen zusammengetragen (Workstation, Server mit einer Karte, H100 oder H200), mit Preisen, die wir am 16. November 2026 bei französischen Händlern erhoben haben, und für zwei Einsätze, die von einem lokalen LLM nicht dasselbe erwarten: Softwareentwicklung, wo Claude Code die Referenz ist, und Chatbots oder Fach-Agenten, wo das Tempo eines Chat-Assistenten die Referenz ist. Ob sich der Eigenbetrieb überhaupt lohnt, mit Gesamtkosten und Break-even gegenüber einer API, behandelt unser Artikel über lokale LLMs im Unternehmen.
Warum Qwen 3.8 27B als Referenz?
Weil es nach unserem Kenntnisstand das am besten bewertete offene Modell ist, das auf eine einzige Karte passt. Qwen 3.8 27B ist ein dichtes Modell mit 27 Milliarden Parametern, von Alibaba unter der Lizenz Apache 2.0 veröffentlicht. Im Index von Artificial Analysis erreicht es etwa das Fünffache von gpt-oss-120b, einem viermal größeren Modell: Unser Artikel Qwen 4 27B vs. Qwen 3.8 27B beschreibt Leistung und Architektur. Bei ATG schreibt dieses Modell die Antworten auf Nachrichten und läuft in unserem FinanceBench-Benchmark.
Warum ein dichtes Modell statt eines MoE, also eines „Mixture of Experts“, das pro Token nur einen Teil seiner Parameter aktiviert? Das MoE ist schneller: Auf derselben Consumer-Karte hat ein Entwickler 31 Tokens pro Sekunde für das dichte Qwen 3.6 27B und 98 für das MoE Qwen 3.6 35B-A3B gemessen. Doch ein MoE muss alle Experten im Speicher halten, weil jeder beim nächsten Token gebraucht werden kann: Dieses MoE belegt 71,9 GB in BF16, das dichte Modell 55,6. Und das dichte Modell antwortet besser, laut Qwen 77,2 gegenüber 73,4 bei SWE-bench Verified. Auf einem Server mit einer Karte zählen Speicher und Qualität mehr als das Tempo eines einzelnen Nutzers: Unser Mixture-of-Experts-Leitfaden erklärt den Unterschied.
Das verändert die Hardware-Rechnung. In unserem Artikel über lokale LLMs galt ein Modell mit etwa 100 Milliarden Parametern noch als Minimum, sobald die Aufgaben anspruchsvoller werden, mit zwei Server-GPUs. Ein Modell mit 27 Milliarden Parametern, das es übertrifft, bringt die Frage auf eine einzige Karte zurück. Seine Gewichte belegen 55,6 GB in BF16 und 30,9 GB in FP8 und etwa 17 GB in 4 Bit (die Version Q4_K_S wiegt 16,68 GiB).
Qwen 4 27B ist von Alibaba angekündigt, aber nicht veröffentlicht: Am 16. November hat die Qwen-Organisation auf Hugging Face kein einziges Qwen-4-Repository. Hardware für Qwen 3.8 27B wird es wahrscheinlich betreiben, wenn es seine Größe behält, doch sein tatsächlicher Speicherbedarf ist unbekannt. Etwas Reserve lohnt sich.
Entwicklung oder Chatbot: Reicht Qwen 3.8 27B?
Die beiden Einsätze verlangen nicht dieselbe Qualität. Im Index von Artificial Analysis erreicht Qwen 3.8 27B 20 Punkte, auf dem Niveau von Claude Haiku 5.5 mit niedrigem Effort (19), aber weit hinter Claude Sonnet 5.5 (55), Claude Opus 5.5 (59) und Claude Fable 5.2 (65).
In der Softwareentwicklung bleibt Claude die Referenz, mit deutlichem Abstand. Bei Terminal-Bench 2.1, einer Reihe von Programmieraufgaben auf der Kommandozeile, misst Vals.ai unter gleichen Bedingungen 87,6 % für Claude Opus 5.5, 83,2 % für Claude Sonnet 5.5 und 58,4 % für Qwen 3.8 27B. Qwen meldet in eigenen Tests bessere Werte: 61,7 bei SWE-bench Pro gegenüber 53,4 für Claude Opus 4.6, ein Claude-Modell der vorigen Generation. Wir würden Claude Code nicht durch ein lokales Qwen ersetzen, um einen Agenten an einer großen Codebasis arbeiten zu lassen; eine lokale Workstation eignet sich eher für Code, der das Unternehmen nicht verlassen darf, und für einfache Aufgaben.
Für einen Chatbot oder einen Fach-Agenten ist Qwen 3.8 27B sehr gut, außer in sehr komplexen Fällen. Das ist unsere Sicht als Nutzer: Bei ATG schreibt es die Antworten auf Nachrichten, und unser FinanceBench-Benchmark erreicht damit 92 % richtige Antworten, bei 150 Analystenfragen zu 368 Finanzberichten. Es durch Gemini 3.8 Flash zu ersetzen oder ihm mehr Denkzeit zu geben, ändert den Wert nicht nennenswert, wie wir in unserem Artikel zum RAG-Audit erklären: Die Qualität hängt zuerst davon ab, die richtigen Passagen zu finden. Ein Spitzenmodell lohnt sich bei langem Schlussfolgern über mehrere Dokumente und bei Agenten mit vielen Schritten.
Welche Hardware braucht ein lokales LLM?
Der Speicherbedarf folgt einer Regel: die Gewichte des Modells plus der KV-Cache, das Arbeitsgedächtnis jeder Unterhaltung, das mit der Länge des gelesenen Textes und der Zahl der Nutzer wächst. Unser Artikel über lokale LLMs zeigt die Rechnung. Qwen 3.8 27B hat einen kleinen KV-Cache: Nur 16 seiner 64 Schichten halten einen, etwa 2,1 GB für eine Unterhaltung mit 32.000 Tokens.
Drei Fragen entscheiden dann über die Stufe:
- Wie viele Anfragen gleichzeitig eintreffen, zu Spitzenzeiten. Eine gleichzeitige Anfrage ist kein Mitarbeiter: Ein Nutzer verbringt die meiste Zeit mit Lesen oder Schreiben, nicht mit Warten auf eine Antwort.
- Wie viel Text das Modell pro Anfrage liest. Eine Chat-Frage hat ein paar hundert Tokens; ein RAG-System oder ein Agent, der Verträge liest, schickt Zehntausende.
- Welches Tempo für jeden Nutzer akzeptabel ist. Weil Qwen 3.8 27B vor der Antwort nachdenkt, erzeugt es deutlich mehr Text als vergleichbare Modelle im Schnitt: Unter 20 bis 30 Tokens pro Sekunde wird das Warten aus unserer Sicht spürbar. Die folgenden Anhaltspunkte zeigen, was Nutzer bereits gewohnt sind.
Welches Tempo erwarten Nutzer?
Zwei Referenzen prägen die Erwartungen. Für Entwickler, die Claude Code gewohnt sind, ist es die API von Anthropic, die Claude Code aufruft. Für Chat-Nutzer ist es das Tempo der großen Assistenten, und das hat eine andere Größenordnung erreicht: Le Chat von Mistral antwortet seit Februar 2025 mit Mistral Large 2 mit über 1.100 Tokens pro Sekunde, auf Chips von Cerebras, und OpenAI hat im Januar 2026 750 Megawatt Rechenleistung bei Cerebras gebucht, für „faster responses, more natural interactions“.
| Dienst | Modell | Tempo für einen Nutzer | Art der Zahl |
|---|---|---|---|
| API von Anthropic (Claude Code) | Claude Opus 5.5 | 105 bis 116 Tokens/s | Messung Artificial Analysis |
| API von Anthropic | Claude Sonnet 5.5 | 126 bis 152 Tokens/s | Messung Artificial Analysis |
| API von Anthropic | Claude Haiku 5.5 | 209 bis 257 Tokens/s | Messung Artificial Analysis |
| API von Mistral | Mistral Large 4 | 81 bis 88 Tokens/s | Messung Artificial Analysis |
| API von Alibaba | Qwen 3.8 27B | etwa 40 Tokens/s | Messung Artificial Analysis |
| Groq | Qwen 3.8 27B | 450 Tokens/s | Angabe von Groq |
| Cerebras | Qwen 3.8 27B | etwa 1.850 Tokens/s | Angabe von Cerebras |
| Lokale Workstation (RTX 3090 bis 5090) | Qwen 3.8 27B | 40 bis 75 Tokens/s | Messung Hardware Corner |
Messungen von Artificial Analysis vom 16. November 2026 (Mittel über fünf Tage), je nach Effort-Stufe des Modells.
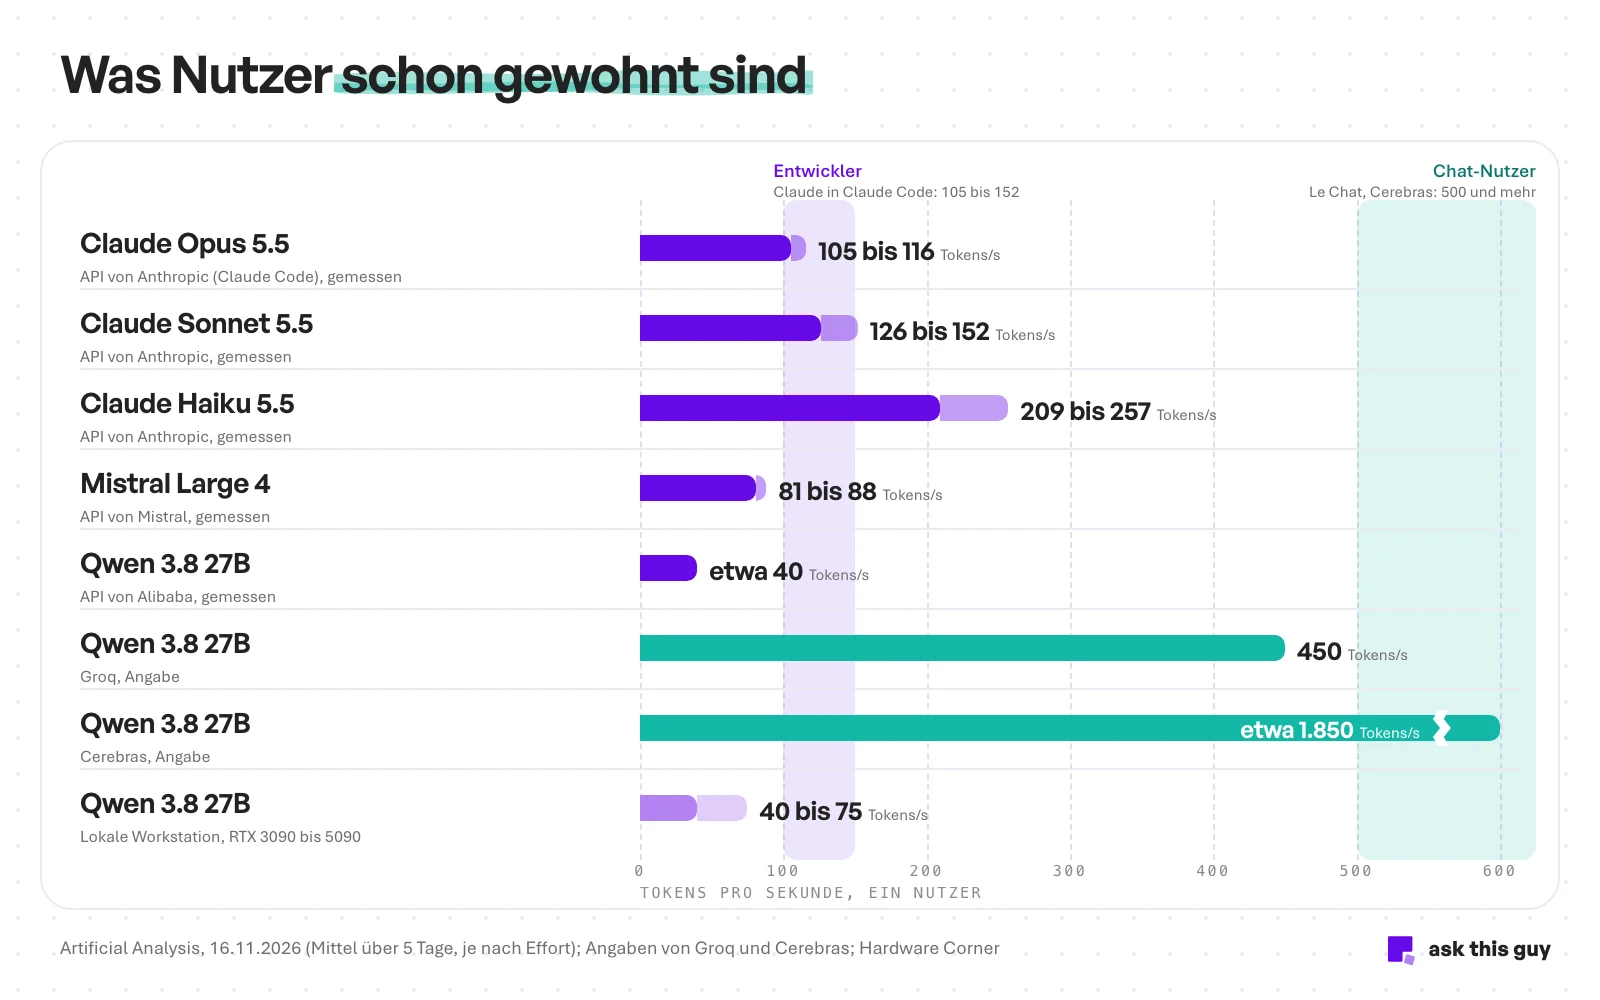 Grafik: Tempo für einen Nutzer, in Tokens pro Sekunde, der Dienste, die Nutzer schon kennen. Claude Opus 5.5 auf der API von Anthropic, die Claude Code nutzt: 105 bis 116. Claude Sonnet 5.5: 126 bis 152. Claude Haiku 5.5: 209 bis 257. Mistral Large 4 auf der API von Mistral: 81 bis 88. Qwen 3.8 27B auf der API von Alibaba: etwa 40, bei Groq: 450 (Angabe), bei Cerebras: etwa 1.850 (Angabe), auf einer lokalen Workstation: 40 bis 75. Referenzbänder: Entwickler 100 bis 150, Chat-Nutzer 500 und mehr
Daraus leiten wir zwei Richtwerte ab: 100 bis 150 Tokens pro Sekunde für Entwickler, 500 und mehr für Chat-Nutzer, die Schwelle, die wir für anspruchsvolle Einsätze schon in unserem Artikel über lokale LLMs im Unternehmen ansetzen. Eine lokale Workstation ist also halb so schnell wie Claude Opus 5.5 und fünfundzwanzig- bis fünfundvierzigmal langsamer als dasselbe Modell bei Cerebras. Ein geteilter Server unter Last liefert mit 32 bis 42 Tokens pro Sekunde je Nutzer etwa ein Drittel des Tempos von Claude. Der Fast Mode von Claude Code verspricht sogar bis zum 2,5-Fachen. Ein Entwickler, der von Claude Code auf einen eigenen Server wechselt, merkt den Unterschied; ein Chat-Nutzer, der Le Chat gewohnt ist, noch mehr.
Der Gesamtdurchsatz eines Servers teilt sich auf die Anfragen auf: Ein Server, der 1.600 Tokens pro Sekunde für 50 Anfragen erzeugt, gibt jeder etwa 32 Tokens pro Sekunde. Die folgenden Zahlen trennen beides immer.
Eine Workstation für einen Nutzer: welcher PC für lokale KI?
Für einen Entwickler, ein Pilotprojekt oder den persönlichen Einsatz reicht eine Grafikkarte mit 24 oder 32 GB. Hardware Corner hat Qwen 3.8 27B in 4 Bit mit llama.cpp gemessen, aktualisiert am 17. August, bei 4.000 Tokens Kontext:
| Rechner | Speicher | Gemessenes Tempo (ein Nutzer) | Preis am 16.11.2026 (Frankreich) |
|---|---|---|---|
| RTX 5090 | 32 GB | 75 Tokens/s | 7.750 € netto die Karte, 10.833 € netto als komplette Workstation |
| RTX 4090 | 24 GB | 46 Tokens/s | nicht mehr produziert |
| RTX 3090 | 24 GB | 40 Tokens/s | nur gebraucht |
| Apple M5 Max | 128 GB | 31 Tokens/s | 5.616 € netto für einen Mac Studio mit 128 GB |
| GB10 (Basis des DGX Spark) | 128 GB | 12 Tokens/s | 6.548 € brutto (ASUS Ascent GX10) |
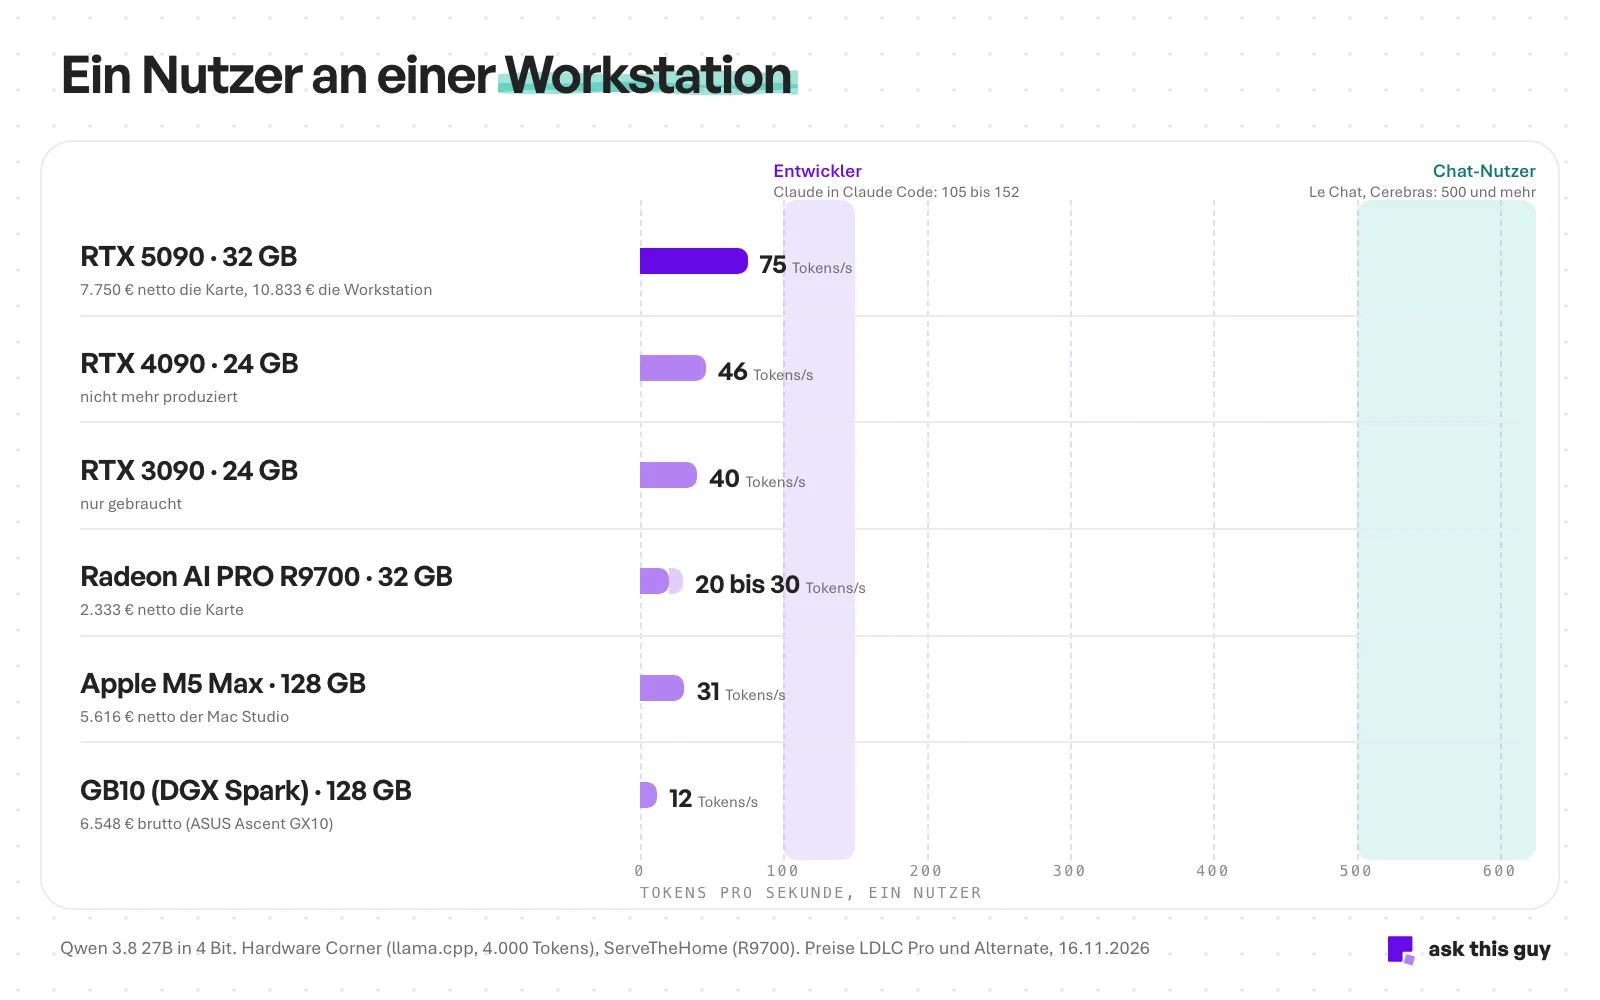 Grafik: Tempo von Qwen 3.8 27B in 4 Bit für einen Nutzer an einer Workstation, im Vergleich zum gewohnten Tempo. RTX 5090 32 GB: 75 Tokens pro Sekunde (7.750 € netto die Karte, 10.833 € die Workstation). RTX 4090 24 GB: 46. RTX 3090 24 GB: 40. Radeon AI PRO R9700 32 GB: 20 bis 30 (2.333 €). Apple M5 Max 128 GB: 31 (5.616 € der Mac Studio). GB10, die Basis des DGX Spark, 128 GB: 12 (6.548 € brutto). Alle Balken bleiben unter dem Band der Entwickler, 100 bis 150 Tokens pro Sekunde, und weit unter dem der Chat-Nutzer, 500 und mehr
Die Karte von AMD, die Radeon AI PRO R9700 mit 32 GB, ist mit 2.333 € netto die günstigste. ServeTheHome hat sie mit 20 bis 30 Tokens pro Sekunde für einen einzelnen Nutzer gemessen; AMD nennt bis zu 51,8 mit spekulativem Decoding, einer Technik, die mehrere Tokens auf einmal errät und danach prüft.
Rechner mit 128 GB Unified Memory kaufen Kapazität, nicht Tempo. Der DGX Spark von NVIDIA, der Mac Studio oder Mini-PCs mit Ryzen AI Max+ laden ein Modell mit 27 Milliarden Parametern mühelos, doch ihr Speicher ist für ein dichtes Modell langsam, das bei jedem Token alle Parameter liest. Auf dem DGX Spark hat ein Entwickler 11,2 Tokens pro Sekunde ohne spekulatives Decoding gemessen, 19 bis 28 mit. Schlimmer noch: Ein Dokument mit 128.000 Tokens braucht dort 150 Sekunden bis zum ersten Wort. Diese Rechner passen besser zu MoE-Modellen, die pro Token nur einen Teil ihrer Parameter lesen.
Die Preise sind der Speicherknappheit gefolgt. NVIDIA hat den DGX Spark im Februar von 3.999 auf 4.699 Dollar angehoben, mit Verweis auf „worldwide constraints in memory supply“, dann im Oktober auf 6.950 Dollar. In Frankreich erreichte die RTX 5090 laut dem Preisbeobachter GinjFo am 3. November 8.899,95 €, bevor sie laut Pro-gamer am 14. November auf 5.609,90 € fiel. Auf dieser Stufe hält ein Preis vom Montag nicht immer bis zum nächsten Montag.
4 Bit kosten kaum Qualität. Die INT4-Version von Red Hat behält je nach Aufgabe 98,5 bis 101 % der Werte des Originalmodells (87,9 gegenüber 89,2 bei GPQA Diamond). Quesma hat keinen nennenswerten Verlust in Q4_K_M gemessen und einen deutlichen Einbruch erst bei 2 Bit. Wir bevorzugen die von Qwen, NVIDIA oder Red Hat veröffentlichten Versionen: Einige Community-Versionen zeigten Denkschleifen.
Ohne Grafikkarte kommt nur ein kleines Modell für einfache Aufgaben in Frage. Für Olala mini 7A1B, sein erstes LLM, vorgestellt am 17. November 2026, nennt OVH 50 Tokens pro Sekunde auf einem einfachen Prozessor: Es ist ein Mixture-of-Experts-Modell, das pro Token nur eine Milliarde seiner 7 Milliarden Parameter arbeiten lässt. Die Zahl ist eine Herstellerangabe ohne Testbedingungen, und ein Modell dieser Größe spielt nicht in der Klasse von Qwen 3.8 27B: Es zielt auf Klassifizieren oder Extrahieren, nicht auf Verfassen von Texten oder Code. Wir analysieren es in unserem Artikel über Olala mini.
Eine Workstation hat weder Redundanz noch Zugriffskontrolle und bedient nur eine Person gut: Sie ist ein Werkzeug für Pilotprojekte.
Ollama, vLLM oder SGLang: Welche Inferenz-Software?
Die Software, die das Modell betreibt, die Inferenz-Engine, verdient so viel Aufmerksamkeit wie die Karte: Nicht alle sind gleich gut, auf derselben GPU liegt der Unterschied bei eins zu fünfzig. Ollama und LM Studio sind Desktop-Werkzeuge: Sie bedienen eine Person sehr gut. Für mehrere Nutzer braucht es eine Server-Engine, die Anfragen bündelt und gemeinsam verarbeitet. Phil Winder (Winder.AI) hat fünf Engines auf derselben gemieteten H100 verglichen, mit Qwen 3.8 27B in 8 Bit und Anfragen von etwa 900 Tokens. Hier das Tempo, das jeder Nutzer erhält, in Tokens pro Sekunde; in Klammern der Gesamtdurchsatz der GPU, den wir durch die Zahl der Anfragen teilen:
| Engine | 1 Anfrage | 10 gleichzeitig | 50 gleichzeitig | Median-Wartezeit bei 50 |
|---|---|---|---|---|
| SGLang 0.5.20 | 81 | 63 (627 gesamt) | 35 (1.725 gesamt) | 1,5 s |
| vLLM 0.30.0 | 76 | 59 (589) | 32 (1.610) | 2,1 s |
| llama.cpp | 56 | 14 (138) | 1,9 (97) | 8,2 s |
| Ollama 0.34.4 | 33 | 3,3 (33) | 0,7 (33) | 381 s |
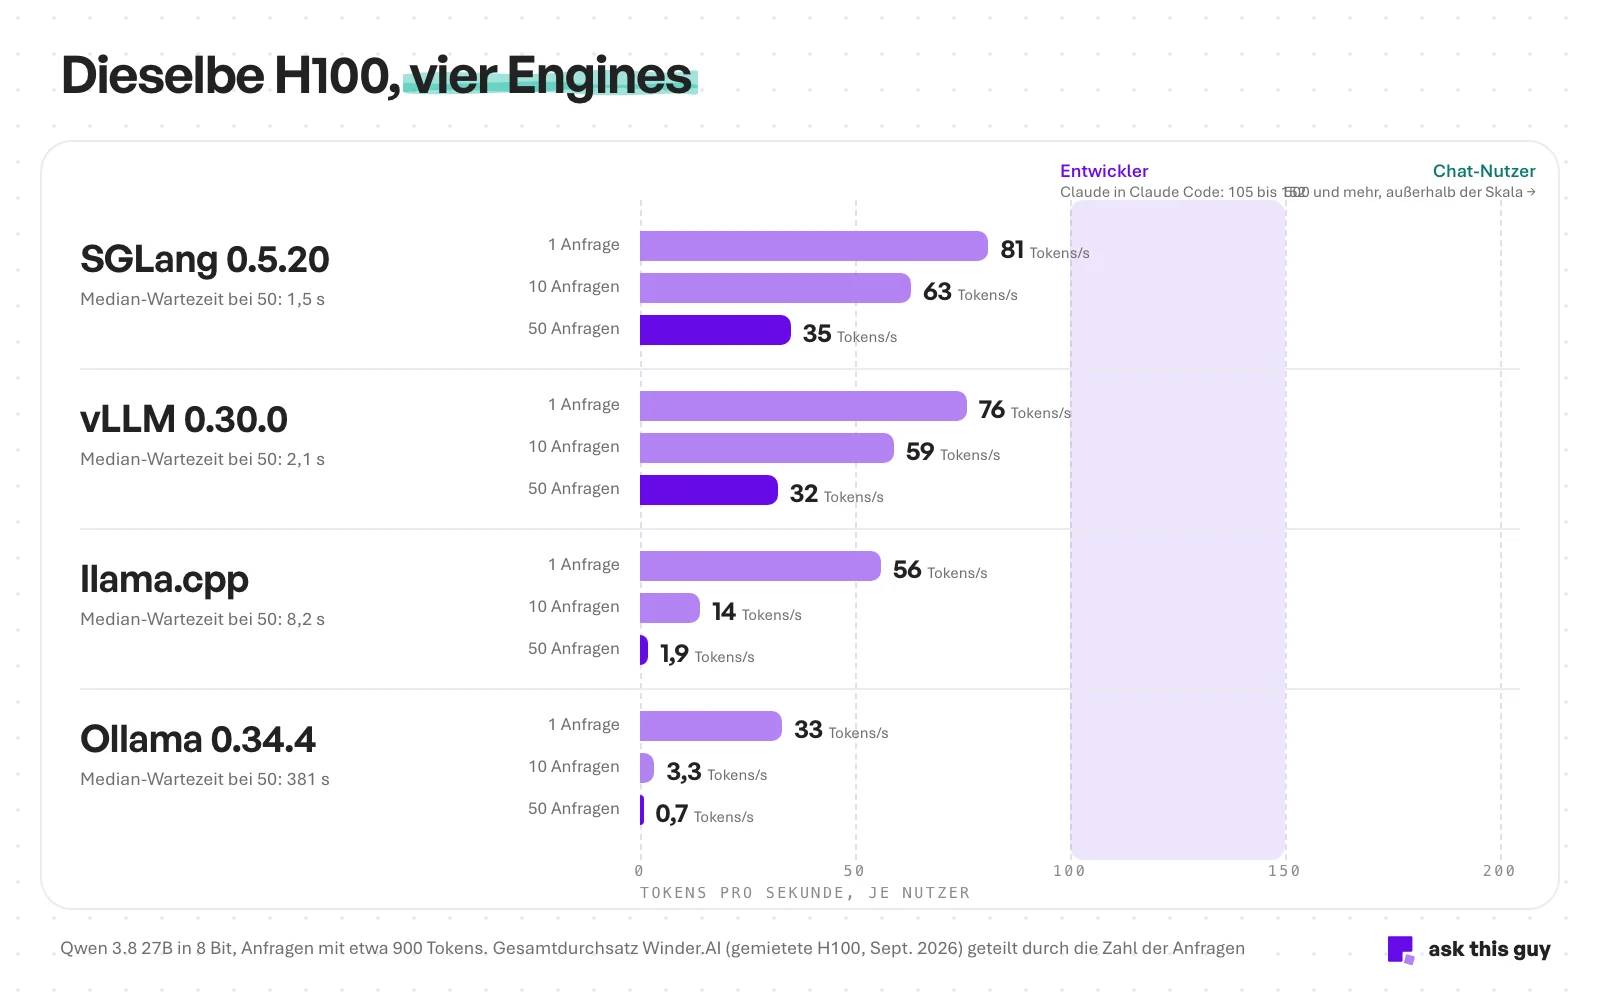 Grafik: Tempo von Qwen 3.8 27B in 8 Bit je Nutzer auf derselben H100, je nach Engine, bei 1, 10 und 50 gleichzeitigen Anfragen. SGLang 0.5.20: 81, 63 und 35 Tokens pro Sekunde, Median-Wartezeit 1,5 s bei 50. vLLM 0.30.0: 76, 59 und 32, 2,1 s. llama.cpp: 56, 14 und 1,9, 8,2 s. Ollama 0.34.4: 33, 3,3 und 0,7, 381 s. Gesamtdurchsatz gemessen von Winder.AI im September 2026, geteilt durch die Zahl der Anfragen
„Ollama served 33“, fasst Winder.AI zusammen: Bei dieser Architektur verarbeitet Ollama die Anfragen nacheinander. Aus Sicht jedes Nutzers liefert SGLang bei 50 gleichzeitigen Anfragen 35 Tokens pro Sekunde und Ollama 0,7: fünfzigmal weniger, auf derselben Karte. Ein Ollama-Pilot, der für eine Person passt, wird für alle langsam, sobald das Team einsteigt, und die Karte ist nicht schuld. Auch die Konfiguration zählt: Mit den Standardeinstellungen begrenzte sich SGLang auf 20 Anfragen gleichzeitig, und die Wartezeit bis zum ersten Wort stieg auf 10 Sekunden.
Ein KI-Server mit einer Karte für ein Team
Die nächste Stufe ist eine Server-Karte in einem gehosteten Rechner. Die RTX PRO 6000 von NVIDIA hält mit 96 GB Speicher das Modell und viele Unterhaltungen im Speicher. Paralon Cloud hat sie mit vLLM in 4 Bit und Antworten von 256 Tokens gemessen: 106 Tokens pro Sekunde für eine Anfrage, 636 insgesamt für 8 gleichzeitige Anfragen, 1.342 für 32. Pro Nutzer sind das etwa 80 Tokens pro Sekunde bei 8 und 42 bei 32 (unsere Rechnung).
Eine solche Karte bedient also rund dreißig gleichzeitige Anfragen im Tempo der API des Herstellers. Sie kostet zwischen 16.142 und 16.600 € netto bei LDLC Pro, je nach Version, anderswo mehr. Kein französischer Integrator veröffentlicht den Preis eines Rack-Servers mit einer Karte: Der einzige GPU-Server im Katalog von LDLC Pro, mit drei RTX PRO 6000, steht bei 89.562 € netto. Ein Paradox, auf das Pause Hardware hinweist: In den USA verkauft Dell eine komplette Workstation mit dieser Karte für etwa 12.600 Euro, weniger als die Karte allein im europäischen Handel.
Die ältere Server-Karte L40S mit 48 GB kostet bei OVHcloud 1,40 € pro Stunde Miete, doch wir haben keine veröffentlichte Messung von Qwen 3.8 27B darauf gefunden.
H100 und H200: KI-Server für das ganze Unternehmen
Jenseits einiger Dutzend gleichzeitiger Anfragen übernehmen Rechenzentrums-GPUs. Auf einer H100 mit 80 GB misst Winder.AI bei 50 gleichzeitigen Anfragen 1.610 bis 1.725 Tokens pro Sekunde, also etwa 32 bis 35 Tokens pro Sekunde je Nutzer, mit 1,5 bis 2,1 Sekunden bis zum ersten Wort. Die H100 wird nicht mehr neu verkauft, lässt sich aber bei OVHcloud für 2,80 € pro Stunde mieten, also 1.940 € pro Monat im Dauerbetrieb.
Ihre Nachfolgerin, die H200 NVL mit 141 GB, kostet 32.533 € netto bei LDLC Pro. In 4 Bit mit vLLM misst Paralon Cloud 3.342 Tokens pro Sekunde insgesamt für 128 Anfragen, etwa 26 je Nutzer; bei 64 Anfragen etwa 48. Die neuere B200 schneidet bei diesem Modell unter Last nicht besser ab: Laut Paralon liegt sie zwischen 32 und 128 Anfragen 12 bis 14 % hinter der H200.
Die Dokumentlänge zählt so viel wie die Nutzerzahl. Auf einer H200 mit SGLang in FP8 ergeben Messungen aus dem Repository des Projekts für Anfragen mit 1.000 Tokens 98 Tokens pro Sekunde für einen Nutzer allein, 83 bei 16 Nutzern und 50 bei 64. Mit 8.000 Tokens Eingabe sinkt das Tempo bei 64 Nutzern auf 29 Tokens pro Sekunde, und die Wartezeit bis zum ersten Wort steigt von 2,6 auf 19 Sekunden. Ein Chat-Assistent und ein RAG-System, das Verträge liest, brauchen nicht denselben Server, selbst bei gleicher Nutzerzahl.
Und für das Tempo eines Chats?
Keine veröffentlichte Messung von Qwen 3.8 27B auf einer GPU erreicht 500 Tokens pro Sekunde je Nutzer, nicht einmal für einen einzelnen Nutzer. Spekulatives Decoding, das mehrere Tokens auf einmal errät und danach prüft, kommt näher heran: Auf einer H200 mit SGLang hebt es einen einzelnen Nutzer von 98 auf 196 Tokens pro Sekunde, und DataPacket meldet bis zu 360 Tokens pro Sekunde auf einer RTX PRO 6000 mit der Methode DFlash2. Unter Last schwindet der Vorteil jedoch: Auf derselben H200 bleiben bei 32 Nutzern nur 66 Tokens pro Sekunde je Nutzer. Die Autoren von HyperQwen fassen es so zusammen: „speculation wins below ~8 concurrent users, plain batching above“.
Ein schneller lokaler Chat kostet also Karten: Um 200 bis 360 Tokens pro Sekunde zu erreichen, bedient jede GPU nur wenige Nutzer gleichzeitig, und das Budget folgt der Zahl der gleichzeitigen Nutzer statt der Zahl der Mitarbeiter. Darüber hinaus braucht es Spezial-Hardware: Das Tempo von Le Chat oder Cerebras stammt von Chips, die für Inferenz gebaut sind und per API bereitstehen, nicht von einem klassischen GPU-Server. Für einen internen Chatbot halten wir eine Antwort mit 40 bis 80 Tokens pro Sekunde für angenehm: Eine Antwort mit 300 Wörtern, etwa 400 Tokens, steht in fünf bis zehn Sekunden (unsere Rechnung).
Was ein Unternehmen daraus mitnehmen kann
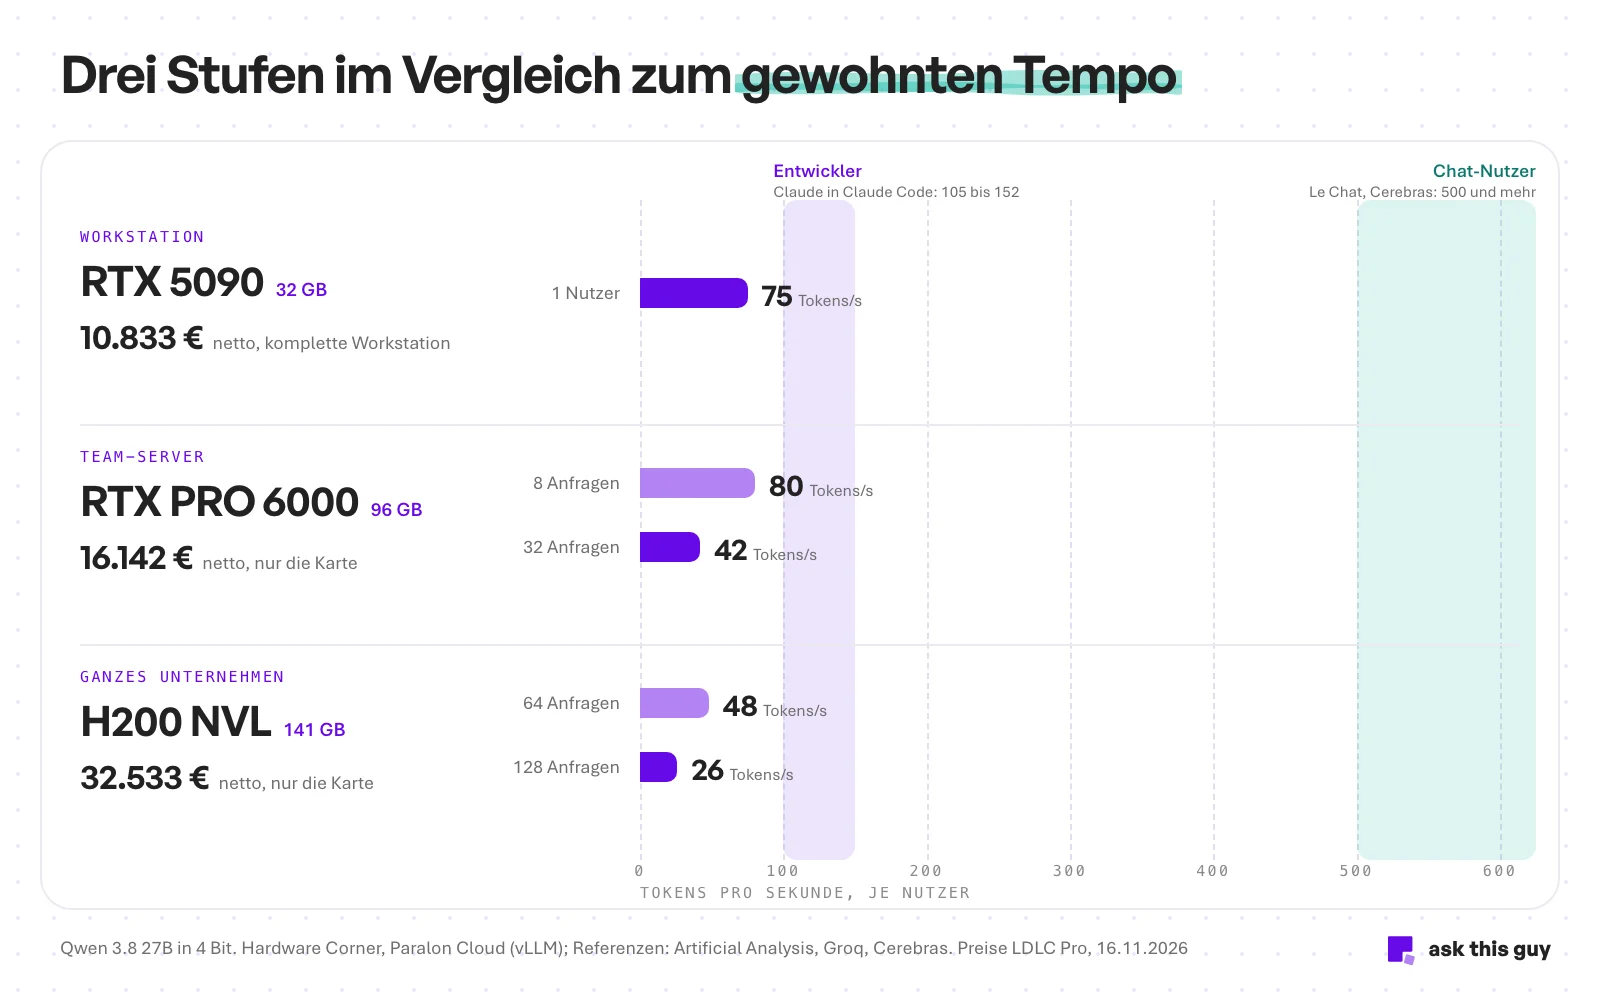 Grafik: drei Hardware-Stufen für Qwen 3.8 27B in 4 Bit im Vergleich zum gewohnten Tempo. Workstation mit RTX 5090 (10.833 € netto, komplette Workstation): 75 Tokens pro Sekunde für einen Nutzer. Team-Server mit RTX PRO 6000, 96 GB (16.142 € netto, nur die Karte): 80 Tokens pro Sekunde je Anfrage bei 8 gleichzeitigen Anfragen, 42 bei 32. H200 NVL mit 141 GB (32.533 € netto, nur die Karte): 48 bei 64 Anfragen, 26 bei 128. Alle Balken bleiben unter dem Band der Entwickler, 100 bis 150 Tokens pro Sekunde (Claude in Claude Code), und weit unter dem der Chat-Nutzer, 500 und mehr (Le Chat, Cerebras)
| Stufe | Hardware | Preis am 16.11.2026 (Frankreich) | Gemessene gleichzeitige Anfragen | Tempo je Nutzer |
|---|---|---|---|---|
| Workstation | RTX 5090, komplette Workstation | 10.833 € netto | 1 | 75 Tokens/s |
| Workstation | Radeon AI PRO R9700, Karte | 2.333 € netto | 1 | 20 bis 30 Tokens/s |
| Team-Server | RTX PRO 6000 96 GB, Karte | 16.142 bis 16.600 € netto | 8 / 32 | 80 / 42 Tokens/s |
| Unternehmen | H100 80 GB, Miete | 2,80 € pro Stunde | 50 | 32 bis 35 Tokens/s |
| Unternehmen | H200 NVL 141 GB, Karte | 32.533 € netto | 64 / 128 | 48 / 26 Tokens/s |
Messungen in 4 Bit, außer H100 (8 Bit); kurze Anfragen; Werte je Nutzer von ATG aus den veröffentlichten Gesamtdurchsätzen berechnet.
Unsere Lesart dieser Zahlen: Die Last wird vor dem Kauf gemessen. Zahl der gleichzeitigen Anfragen und Länge der Dokumente lassen sich in einem Pilotprojekt erfassen, und sie entscheiden über die Stufe viel mehr als der Name des Modells. Eine für einige Tage bei OVHcloud gemietete H100 reicht, um diese Last mit vLLM nachzuspielen, bevor man eine Karte bestellt, deren Lieferzeit manchmal über zwei Wochen liegt. Ein Ollama-Pilot zeigt die Qualität der Antworten, aber nichts über das Verhalten unter Last.
Die Karte ist nur eine Zeile im Budget. Hosting, Strom, Wartung und vor allem Personal wiegen schwerer: Unser Artikel über lokale LLMs im Unternehmen beziffert die Gesamtkosten und den Break-even gegenüber einer API.
Dasselbe Modell gibt es auch als API mit Hosting in Frankreich: OVHcloud betreibt Qwen 3.8 27B, und Scaleway bietet es an, was ein Pilotprojekt ganz ohne Hardware erlaubt. Unsere Seite über souveräne KI beschreibt, was europäisches Hosting löst und was nicht.
Häufige Fragen zum lokalen KI-Server
Welche Hardware braucht ein lokaler KI-Server?
Für ein Modell wie Qwen 3.8 27B in 4 Bit reicht für einen Nutzer eine Grafikkarte mit 24 oder 32 GB: Hardware Corner misst 40 Tokens pro Sekunde auf einer RTX 3090, 46 auf einer RTX 4090 und 75 auf einer RTX 5090. Für ein Team braucht es eine Server-Karte wie die RTX PRO 6000 mit 96 GB und eine Server-Engine wie vLLM oder SGLang.
Kann Qwen 3.8 27B Claude beim Programmieren ersetzen?
Nicht für agentisches Programmieren an einer großen Codebasis. Bei Terminal-Bench 2.1 misst Vals.ai 87,6 % für Claude Opus 5.5, 83,2 % für Claude Sonnet 5.5 und 58,4 % für Qwen 3.8 27B, und der Index von Artificial Analysis sieht es bei 20 Punkten gegenüber 59 für Opus 5.5. Ein lokales Qwen eignet sich eher für Code, der das Unternehmen nicht verlassen darf, und für einfache Aufgaben. Für einen Chatbot oder einen Fach-Agenten reicht es dagegen meistens.
Wie viele Nutzer kann ein lokaler KI-Server bedienen?
Das hängt von GPU, Engine und Dokumentlänge ab. Mit vLLM und Qwen 3.8 27B in 4 Bit bedient eine RTX PRO 6000 laut Paralon Cloud 32 gleichzeitige Anfragen mit je etwa 42 Tokens pro Sekunde; eine H200 NVL bedient 128 mit je etwa 26. Die Zahl der bedienten Mitarbeiter liegt höher, weil die meisten lesen oder schreiben, während andere auf eine Antwort warten.
Ist ein lokales LLM so schnell wie Claude oder Le Chat?
In der Regel nicht. Auf einer Workstation läuft Qwen 3.8 27B mit 40 bis 75 Tokens pro Sekunde; Artificial Analysis misst Claude Opus 5.5 auf der API von Anthropic mit etwa 110 Tokens pro Sekunde, und Cerebras gibt für Qwen 3.8 27B etwa 1.850 Tokens pro Sekunde an. Cerebras stellt auch die Rechenleistung für Le Chat von Mistral, das mit über 1.100 Tokens pro Sekunde antwortet, und OpenAI hat dort 750 Megawatt gebucht. Ein geteilter Server unter Last sinkt auf 30 bis 40 Tokens pro Sekunde je Nutzer.
Was kostet die Hardware für einen KI-Server?
Am 16. November 2026 beim französischen Händler LDLC Pro: 2.333 € netto für eine Radeon AI PRO R9700 mit 32 GB, 10.833 € für eine komplette Workstation mit RTX 5090, 16.142 bis 16.600 € für eine RTX PRO 6000 mit 96 GB und 32.533 € für eine H200 NVL, jeweils nur die Karte. Ein Server mit drei RTX PRO 6000 steht bei 89.562 €. Eine H100 kostet bei OVHcloud 2,80 € pro Stunde Miete.
Reicht ein DGX Spark für ein lokales LLM?
Zum Testen von Modellen ja, um Qwen 3.8 27B schnell bereitzustellen nein. Seine 128 GB Speicher laden große Modelle, doch er erzeugt dieses dichte Modell mit 11 oder 12 Tokens pro Sekunde ohne spekulatives Decoding und braucht 150 Sekunden, um ein Dokument mit 128.000 Tokens zu lesen. Sein Preis stieg in einem Jahr von 3.999 auf 6.950 Dollar.
Sollte man ein lokales LLM auf 4 Bit quantisieren?
Für Qwen 3.8 27B ist der Verlust gering: Die INT4-Version von Red Hat behält 98,5 bis 101 % der Werte des Originalmodells, und Quesma misst in Q4_K_M keinen nennenswerten Verlust. Ab 2 Bit sinkt die Qualität deutlich. Die von Qwen, NVIDIA oder Red Hat veröffentlichten Versionen sind sicherer als manche Community-Versionen, die Denkschleifen zeigten.
Sollte man vor dem Hardware-Kauf auf Qwen 4 warten?
Qwen 4 27B ist am 16. November 2026 nicht veröffentlicht, und sein tatsächlicher Speicherbedarf ist unbekannt. Hardware für Qwen 3.8 27B wird es wahrscheinlich betreiben, wenn es seine Größe behält, doch die Vorschau der Qwen-4-Architektur bringt große Embedding-Tabellen mit: Speicherreserve ist vorsichtiger als Warten.
Vor der Wahl einer Karte lohnt eine Woche Messung für eine Frage: Wie viele Anfragen kommen wirklich gleichzeitig, und wie viel Text schicken sie? Erst die Auswertung der Logs eines Pilotprojekts liefert eine Antwort, die Ihnen mehrere Zehntausend Euro sparen kann!
Qwen 3.8 27B ohne eigenen Server, mit ATG
Mit ATG ist all das bereits erledigt. Wahl der Karte, der Inferenz-Engine und der Quantisierung, Messung der Last, Wartung: Unser Unternehmens-RAG kommt schlüsselfertig, gehostet bei OVHcloud in Frankreich. Das Modell, das dort die Antworten schreibt, ist eben Qwen 3.8 27B, und diese Antworten kommen schnell und bleiben treffend, wie eine Demo mit Ihren eigenen Fragen zeigt.