Qwen 3.8 27B vs. Qwen 4 27B: Was ist zu erwarten?
Qwen4-Max ist seit dem 16. November da, ohne Gewichte; Qwen 4 27B lässt auf sich warten. Was bestätigt ist und was Qwen 3.8 27B gegen Mistral taugt.

Am 16. November hat Alibaba Qwen4-Max vorgestellt, das erste Modell der Generation Qwen 4, nach fünf Tagen Vorschau im Abonnement. Es ist ein MoE mit 2.400 Milliarden Parametern, nur über die API von Alibaba zugänglich: Seine Gewichte sind nicht veröffentlicht. Artificial Analysis gibt ihm 43 Punkte, neun mehr als seinem Vorgänger. In derselben Ankündigung verspricht Alibaba kleinere Qwen-4-Modelle mit offenen Gewichten, die „soon“ erscheinen sollen, ohne Größe und Datum. Qwen 4 27B dagegen ist am 16. November noch immer nicht auf Hugging Face. Das Modell, das man heute herunterladen kann, heißt Qwen 3.8 27B und wurde am 14. August unter der Lizenz Apache 2.0 veröffentlicht. Für seine Größe liefert es außergewöhnliche Ergebnisse, deshalb setzen wir es bei Ask This Guy intensiv ein.
Zur Einordnung: Qwen (kurz für Tongyi Qianwen) ist die KI-Modellfamilie von Alibaba, dem chinesischen E-Commerce-Riesen (Taobao, Tmall, AliExpress), der zugleich der größte Anbieter von High-End-Cloud in China ist. Qwen startete im April 2023 und veröffentlicht seit August 2023 den Großteil seiner Modelle als Open Weights: Jeder kann sie herunterladen und auf eigenen Rechnern betreiben. Die Palette reicht von weniger als einer Milliarde Parametern bis zu 2.400 Milliarden. Das „27B“ in Qwen 3.8 27B steht für 27 Milliarden Parameter, die internen Stellgrößen, deren Anzahl einen Eindruck von der Größe eines Modells vermittelt.
Qwen 3.8 27B ist ein dichtes Modell (Dense), während fast alle großen offenen Modelle, die von Mistral eingeschlossen, inzwischen MoE-Modelle sind. Es passt auf eine einzige GPU. Im Ranking von Artificial Analysis vom 14. November erreicht es 20 Punkte, etwa fünfmal so viel wie Gemma 4 31B oder gpt-oss-120b und viermal so viel wie Mistral Medium 3.5, ein dichtes Modell mit 128 Milliarden Parametern.
Was ist von Qwen 4 27B zu erwarten? Zur Leistung ist nichts veröffentlicht. Zur Bauart gibt der Name einen Hinweis: Bei Qwen enthalten die Namen der MoE-Modelle zwei Zahlen, etwa „35B-A3B“, die der dichten Modelle nur eine. Ein „Qwen4-27B“ wäre also dicht, sofern Alibaba bei seiner Konvention bleibt. Doch die Vorschau auf die Architektur von Qwen 4, im August veröffentlicht, fügt Embedding-Tabellen mit 51 Milliarden Parametern hinzu, die im Namen nicht auftauchen, und Qwen4-Max hat 328 Milliarden zusätzlich zu seinen 2.400 Milliarden: Der tatsächliche Speicherbedarf eines künftigen „27B“ könnte über dem liegen, was der Name erwarten lässt. Die Vorschau zeigt auch, was die neue Architektur leistet: Artificial Analysis gibt ihr 29 Punkte, mehr als Mistral Large 4, mit 6 Milliarden aktiven Parametern pro Token. Zwei weitere Signale mahnen zur Vorsicht. Diese Vorschau steht unter einer hauseigenen Lizenz, nicht unter Apache 2.0: Unter diesem Regime bräuchte jeder, der Qwen 4 27B als Inferenzdienst anbietet, eine separate Lizenz von Qwen, unabhängig von seinem Umsatz. Und die Generation 3.7 hatte nie eine offene Version: Nichts verpflichtet Alibaba, ein herunterladbares Qwen 4 27B zu veröffentlichen.
Qwen 4 und Qwen 4 27B: Was ist bestätigt?
Qwen4-Max, ein geschlossenes Modell, und das Versprechen kleiner offener Modelle. Der Name „Qwen4-27B“ kursiert seit Alibabas Apsara-Konferenz, stammt aber aus Folien und Keynote-Berichten, nicht aus der offiziellen Pressemitteilung, und auch die Ankündigung von Qwen4-Max nennt ihn nicht. Der Informationsstand am 16. November 2026:
| Information | Status |
|---|---|
| Qwen 4 ist im Training | Von Alibaba am 22. September bestätigt, mit einer Roadmap hin zu Qwen 4.5 und Qwen 5 |
| Eine Reihe Max, Plus, Flash und 27B | Namen auf Folien, in keinem Text von Alibaba; erschienen ist nur Qwen4-Max |
| „Qwen4 next week“ | Dem CTO am 29. Oktober zugeschriebener Satz, von einem einzigen Teilnehmer berichtet, unbestätigt; die Woche verging ohne Veröffentlichung |
| Teaser „The becoming begins“ | Am 6. November vom offiziellen Qwen-Account veröffentlicht, ohne Modellnamen, Datum oder Größe |
| Vorschau auf Qwen4-Max | Am 11. November von Qwen angekündigt; bis zum 25. November zugänglich über das Abonnement Token Plan von Alibaba Cloud |
| Veröffentlichung von Qwen4-Max | Am 16. November, per API und in den Apps von Alibaba; MoE mit 2.400 Milliarden Parametern, davon 71 Milliarden aktiv; Gewichte nicht veröffentlicht |
| Kleinere Qwen-4-Modelle mit offenen Gewichten | Von Alibaba am 16. November „soon“ versprochen, ohne Größe, Datum oder Lizenz |
| Gewichte auf Hugging Face | Kein Qwen-4-Repository in der Qwen-Organisation |
| Lizenz, tatsächliche Größe, Architektur von Qwen 4 27B | Unbekannt |
Qwen4-Max: Was Alibaba am 16. November veröffentlicht hat
Qwen4-Max ist ein MoE mit 2.400 Milliarden Parametern, davon 71 Milliarden pro Token aktiv, gegenüber 95 Milliarden bei Qwen 3.8 Max. Es liest Text, Bild und Video, und seine Dokumentation nennt einen Kontext von einer Million Token, bis zu 262.144 Ausgabe-Token einschließlich Reasoning und drei Reasoning-Stufen: low, high als Standard und xhigh. Es kostet in Singapur 1,50 Dollar pro Million Token Eingabe und 4,50 Dollar Ausgabe, gegenüber 2 und 6 Dollar für Qwen 3.8 Max, und etwas weniger in den anderen Regionen von Alibaba Cloud, darunter Frankfurt. Weder Fine-Tuning noch eigener Betrieb sind möglich: Es läuft nur auf den Servern von Alibaba, über dessen API und in dessen Apps (QwenWork, QwenStudio, Qoder).
Alibaba stellt vor allem die Effizienz heraus. Auf Work360, einem hauseigenen Benchmark beruflicher Aufgaben, verbraucht Qwen4-Max je nach Reasoning-Stufe 24 bis 35 % weniger Token als sein Vorgänger, und die durchschnittlichen Kosten pro Aufgabe sinken von 4,43 auf 1,67 Dollar, also um 62 %. Der Blogbeitrag von Qwen vergleicht es in sechzehn Benchmarks mit Qwen 3.8 Max, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra und Kimi K3.1: In vier liegt es vorn, darunter DeepSWE beim Code (75,7 gegenüber 74,2 für Opus 5.5), in anderen liegt es weit zurück, etwa bei Terminal-Bench 4.0 (48,5 gegenüber 59,6 für Opus 5.5 und 67,2 für Kimi K3.1) oder ProgramBench (31,5 gegenüber 65,0 für Opus 5.5). Ein Teil dieser Werte stammt aus Ranglisten Dritter (Artificial Analysis, Arena, Vals), der Rest aus Messungen des Herstellers.
Unabhängige Messungen kamen schnell. Artificial Analysis gibt Qwen4-Max 43 Punkte in seinem Index, gegenüber 34 für Qwen 3.8 Max, doch Kimi K3.1 Pro, das Open-Weight-Modell von Moonshot, bleibt mit 46 vorn. Qwen4-Max bleibt gesprächig: 127 Millionen erzeugte Token für den Index, gegenüber einem Median von 78,6 Millionen, etwa so viel wie Qwen 3.8 27B. Im Webentwicklungs-Ranking von Code Arena steigt es auf Platz 6 ein, mit vorläufiger Note, hinter den besten Modellen von Anthropic, Google und OpenAI.
Die am 11. November geöffnete Vorschau bleibt bis zum 25. November über das Abonnement Token Plan zugänglich und wird danach zurückgezogen. Wer Gewichte sucht, für den ändert Qwen4-Max nichts: Es ist ein geschlossenes Modell, wie zuvor Qwen 3.7 Max und Plus. Die Vorgängergeneration hatte mehr erhoffen lassen: Qwen 3.8 2.4T-A95B, die offene Version von Qwen 3.8 Max, erschien am 12. August, neun Tage nach dem API-Modell. Diesmal verspricht Alibaba Gewichte nur für die kleineren Modelle.
Erscheinungstermin von Qwen 4 27B: was der Präzedenzfall nahelegt
Bald, wenn man Alibaba beim Wort nimmt. Die Ankündigung vom 16. November besagt, dass „open-weight, smaller-scale models from the Qwen4 series will soon be released to developers worldwide“, ohne eine Größe zu nennen. Der Blogbeitrag von Qwen ergänzt, sie würden „built on the same lineage and trained with the same generation of techniques“, also auf derselben Architektur wie Qwen4-Max. Der Präzedenzfall weist in dieselbe Richtung: Qwen 3.8 Max erschien am 3. August, Qwen 3.8 27B folgte etwa zehn Tage später. Auf der Code-Seite tauchte Ende Oktober ein „qwen4-27b“ in einer Änderung an Compute-Kernels für Intel-GPUs auf, in einem Repository eines Dritten, was umgehend eine Support-Anfrage bei llama.cpp auslöste, ohne ein Datum zu bestätigen. Auf Manifold, einem Prognosemarkt mit Spielgeld, gaben die Wettenden am 16. November Qwen-4-Gewichten auf Hugging Face bis zum 25. November eine Chance von 78 %, gegenüber 62 % zwei Tage zuvor. Eine Wette ersetzt keine Ankündigung.
Bis dahin zählt Hugging Face bereits 51 Repositories mit dem Namen „Qwen4-27B“, angelegt von rund zehn Drittkonten seit dem 9. November. Die von uns geöffneten enthalten nur eine Beschreibungsdatei, ohne jegliche Gewichte: Es sind im Hinblick auf die Veröffentlichung reservierte Namen. Alibaba veröffentlicht seine Modelle in der Qwen-Organisation, und nirgendwo sonst.
Qwen 3.8 27B und die Qwen-27B-Familie: drei Versionen in sechs Monaten
Qwen 27B ist das mittelgroße Modell der Qwen-Familie von Alibaba: ein dichtes Sprachmodell mit 27 Milliarden Parametern, multimodal (Text, Bild, Video), als Open Weights unter der Lizenz Apache 2.0 veröffentlicht. 2026 erschien es in drei Versionen, alle auf derselben Architektur:
| Version | Veröffentlichung | Lizenz | Kumulierte Downloads auf Hugging Face (Stand 14.11.) |
|---|---|---|---|
| Qwen 3.5 27B | Februar 2026 | Apache 2.0 | 22,6 Millionen |
| Qwen 3.6 27B | 22. April 2026 | Apache 2.0 | 31,2 Millionen |
| Qwen 3.8 27B | 14. August 2026 | Apache 2.0 | 22,5 Millionen, davon 7,0 Millionen in 30 Tagen |
Ein Qwen 3.7 27B gab es nicht. Die Generation 3.7, Qwen 3.7 Max im Mai und Qwen 3.7 Plus am 1. Juni, erschien nur als API, ohne veröffentlichte Gewichte: Es gibt kein Qwen-3.7-Repository auf Hugging Face. Tracking-Seiten erwarteten offene Versionen mit 27B und 35B, die nie kamen. Das offene 27B sprang direkt von Version 3.6 auf 3.8. Das vorherige dichte Qwen-Modell dieser Größe war Qwen 3 32B, erschienen im April 2025, mit klassischer Architektur.
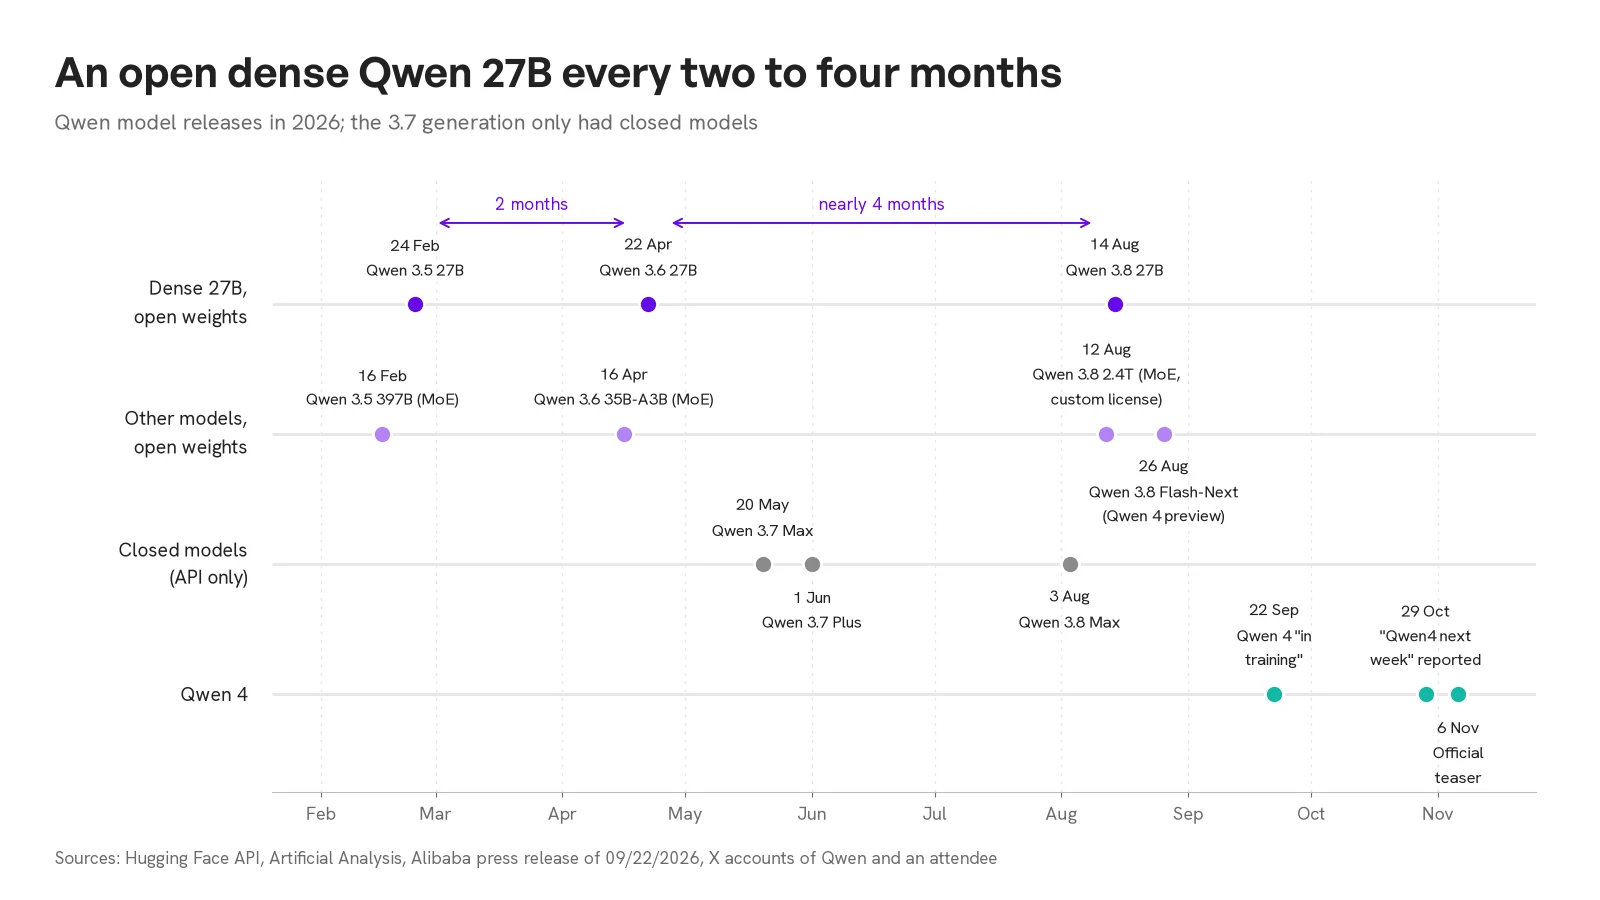 Zeitleiste der Qwen-Veröffentlichungen 2026 in vier Zeilen. Dichtes 27B mit offenen Gewichten: Qwen 3.5 27B am 24. Februar, Qwen 3.6 27B am 22. April (zwei Monate später), Qwen 3.8 27B am 14. August (fast vier Monate später). Weitere offene Modelle: Qwen 3.5 397B am 16. Februar, Qwen 3.6 35B-A3B am 16. April, Qwen 3.8 2.4T unter hauseigener Lizenz am 12. August, Qwen 3.8 Flash-Next, Vorschau auf Qwen 4, am 26. August. Geschlossene Modelle: Qwen 3.7 Max am 20. Mai, Qwen 3.7 Plus am 1. Juni, Qwen 3.8 Max am 3. August, Qwen4-Max am 16. November nach einer am 11. geöffneten Vorschau. Qwen 4: am 22. September als im Training angekündigt, „Qwen4 next week“ am 29. Oktober berichtet, offizieller Teaser am 6. November
Daten: Hugging Face, Artificial Analysis und Alibaba.
Seit Qwen 3.5 sind diese Modelle hybrid: Von den 64 Schichten des Netzes nutzen drei von vier eine sogenannte lineare Attention (Gated DeltaNet), die sparsamer mit Speicher umgeht, und eine von vier eine vollständige Attention. Die Modellkarte von Qwen 3.8 27B nennt einen Kontext von 262.144 Token, erweiterbar auf eine Million, und einen Reasoning-Modus, der standardmäßig aktiviert ist und sich abschalten lässt, mit drei Aufwandsstufen: low, medium und xhigh. Qwen präsentiert es als „compact, deployment-friendly dense model“, ein kompaktes, leicht einsetzbares dichtes Modell.
Was Qwen angibt
Von Version zu Version ändert Qwen nicht die Architektur, sondern das Training, und die angegebenen Zuwächse sind beträchtlich. Eine Auswahl der von Qwen veröffentlichten Werte:
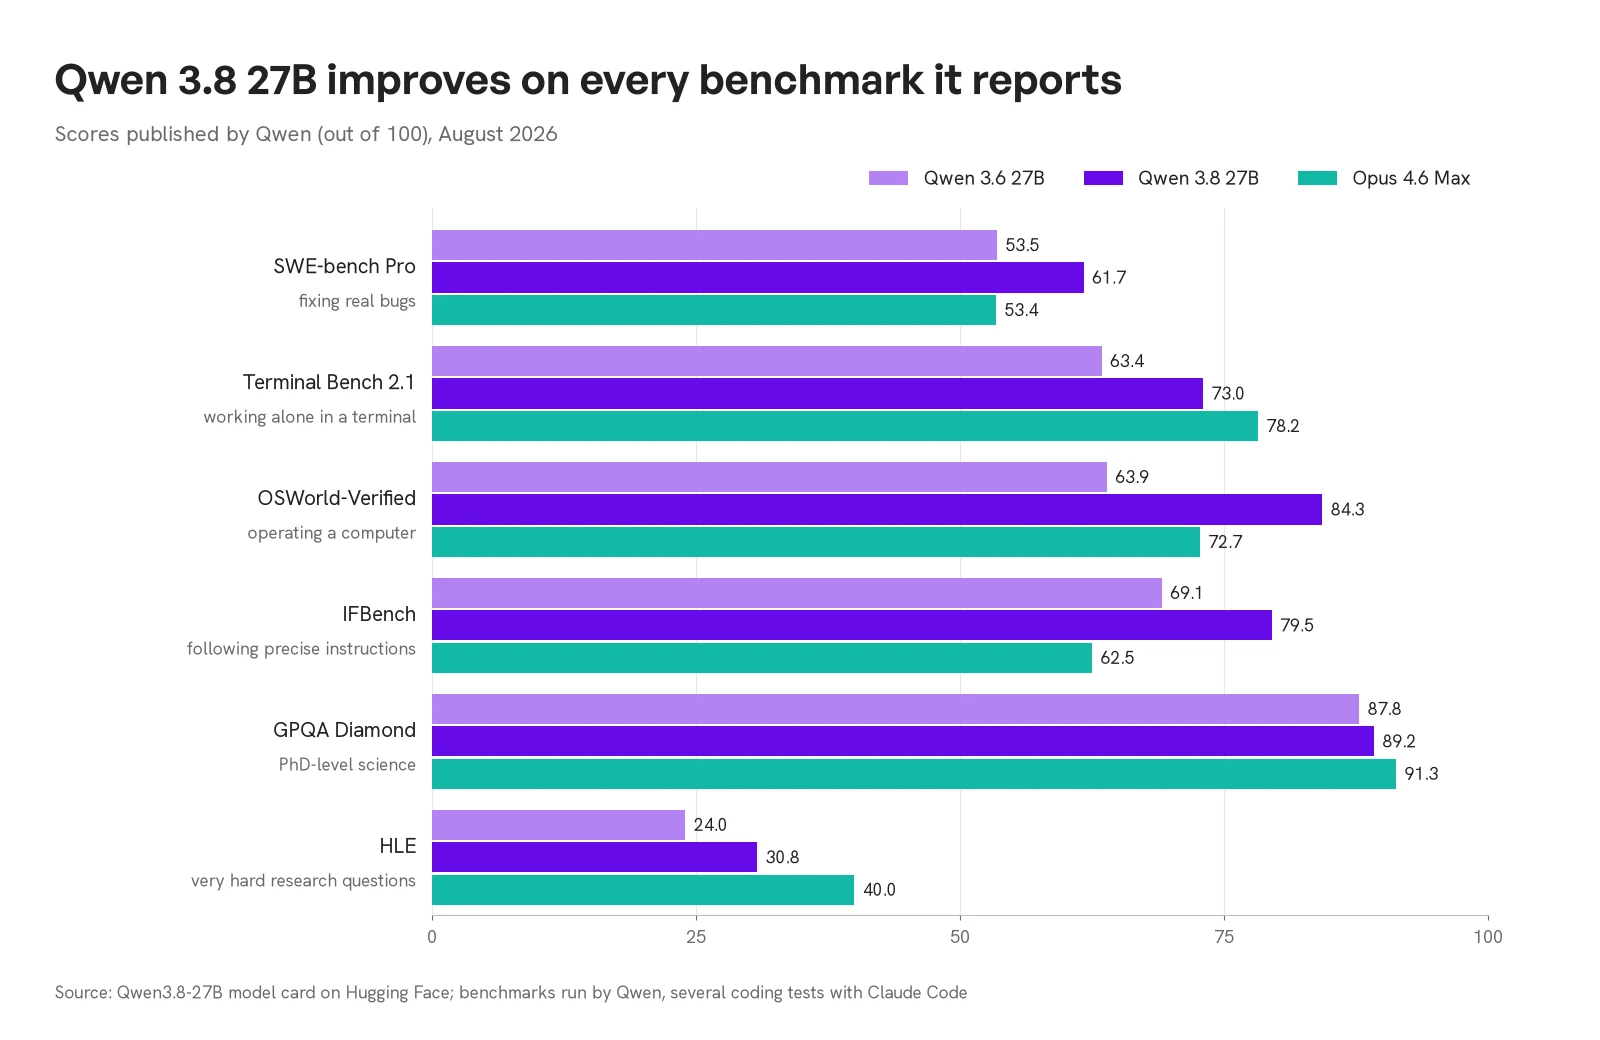 Balkendiagramm der von Qwen veröffentlichten Werte, von 100, für Qwen 3.6 27B, Qwen 3.8 27B und Opus 4.6 Max: SWE-bench Pro 53,5, 61,7 und 53,4; Terminal Bench 2.1 63,4, 73,0 und 78,2; OSWorld-Verified 63,9, 84,3 und 72,7; IFBench 69,1, 79,5 und 62,5; GPQA Diamond 87,8, 89,2 und 91,3; HLE 24,0, 30,8 und 40,0
Das sind Zahlen des Herstellers, gemessen mit eigenen Einstellungen, und mehrere Coding-Benchmarks, darunter SWE-bench Pro, liefen mit Claude Code als Umgebung. Die Schlagzeilen „Qwen 3.8 27B schlägt Opus“, die auf YouTube kursieren, übertreiben: In dieser Tabelle liegt es bei SWE-bench Pro vorn, nicht bei Terminal Bench und nicht bei HLE.
Die interessanteste Zahl steht in der vorherigen Tabelle, der von Qwen 3.6 27B. Dort vergleicht Qwen sein dichtes Modell mit dem eigenen MoE der Vorgängergeneration, Qwen 3.5 397B, fünfzehnmal schwerer. Bei SWE-bench Verified erreicht das dichte Modell 77,2 gegenüber 76,2, bei Terminal-Bench 2.0 59,3 gegenüber 52,5. Beim agentischen Coding zog ein dichtes 27B mit einem MoE von 397 Milliarden Parametern gleich. Beim Wissen (MMLU-Pro, GPQA, HLE) behält das große Modell die Oberhand, was logisch ist: Wissen wird in den Parametern gespeichert, und davon hat es fünfzehnmal mehr.
Was unabhängige Messungen zeigen
Artificial Analysis unterzieht jedes Modell derselben Testbatterie. In Version 4.3.2 seines Index, erhoben am 21. Oktober, kam Qwen 3.8 27B auf 34 Punkte, gegenüber 21 für Qwen 3.6 27B, 18 für Qwen 3.5 397B, 15 für Gemma 4 31B von Google und 12 für gpt-oss-120b von OpenAI. Inzwischen ist die Seite auf Version 5.0.1 umgestiegen, mit strengerer Skala: Dort steht Qwen 3.8 27B bei 20 Punkten, der Median vergleichbarer Modelle bei 8. Im Ranking vom 14. November ist das etwa die fünffache Note von Gemma 4 31B oder gpt-oss-120b, die bei jeweils 4 Punkten liegen.
Dieselbe Seite zeigt die Kehrseite. Für den Index hat Qwen 3.8 27B 128 Millionen Token erzeugt, gegenüber einem Median von 77,7 Millionen, und 44,1 Minuten pro Aufgabe gebraucht statt 14,9. Das Modell denkt lange nach, bevor es antwortet. Bei 42 Token pro Sekunde bei Alibaba bezahlt man das mit Wartezeit, und in Euro, wenn pro erzeugtem Token abgerechnet wird.
Was wir bei ATG beobachten
Bei ATG ist Qwen 3.8 27B das Modell, das die Antworten auf die Nachrichten der Nutzer formuliert. Es kommt zum Beispiel in unserem FinanceBench-Benchmark zum Einsatz, in dem unser Recherche-Agent 92 % der Analystenfragen zu 368 Finanzberichten richtig beantwortet. Als wir es durch Gemini 3.8 Flash ersetzten, sahen wir keinen signifikanten Unterschied im Ergebnis, ebenso wenig bei einem höheren Reasoning-Budget. In einem RAG entscheidet zuerst die Suche über das Ergebnis. Ein gut ausgestattetes Modell mit 27 Milliarden Parametern reicht aus, um Dokumente zu lesen und daraus eine belegte Antwort abzuleiten.
Wir haben auch seine Grenzen gesehen. Bei einer Temperatur von 1,5 (eine Einstellung, die Antworten zufälliger macht) liefert es in 15 bis 27 % der Fälle keine gültige Antwort mehr: Sein Reasoning gerät außer Kontrolle und überschreitet die maximale Länge. Mit den von Qwen empfohlenen Einstellungen haben wir dieses Problem nicht beobachtet.
Qwen 27B im Vergleich mit Mistral, der europäischen Referenz
Für ein französisches Unternehmen, und für viele europäische Käufer, bleibt Mistral die Referenz bei Open Weights. Der Vergleich ist nützlich, sofern man die Modelle richtig einordnet, denn die beiden Produktreihen decken nicht dieselben Stufen ab.
| Modell | Architektur | Parameter (gesamt / aktiv) | Lizenz | Index Artificial Analysis v5.0.1 | Kumulierte Downloads |
|---|---|---|---|---|---|
| Qwen 3.8 27B | dicht, hybrid | 27B | Apache 2.0 | 20 | 22,5 Millionen |
| Mistral Small 3.2 (Juni 2025) | dicht | 24B | Apache 2.0 | nicht gemessen | 5,6 Millionen |
| Mistral Small 4 (März 2026) | MoE | 119B / 6,5B | Apache 2.0 | 4 | 0,7 Millionen |
| Mistral Medium 3.5 (April 2026) | dicht | 128B | modifizierte MIT, mit Umsatzobergrenze | 5 | 1,1 Millionen |
| Mistral Large 3 (Dezember 2025) | MoE | 675B / 41B | Apache 2.0 | nicht gemessen | 18.100 |
| Mistral Large 4 (Oktober 2026) | MoE | etwa 1.000B / 49B | Mistral Ecosystem Open-Weight License | 26 | 14.100 |
| Qwen 3.8 Flash-Next (August 2026, Vorschau auf Qwen 4) | MoE | 125B / 6B, plus 51B Embeddings | Qwen Community License 1.0 | 29 | 6,1 Millionen |
| Qwen 3.8 2.4T-A95B (August 2026) | MoE | 2.400B / 95B | Qwen3.8-Max License | nicht bewertet (API-Version Qwen 3.8 Max: 34) | 123.200 |
Die Downloadzahlen stammen aus der API von Hugging Face, Stand 14. November 2026.
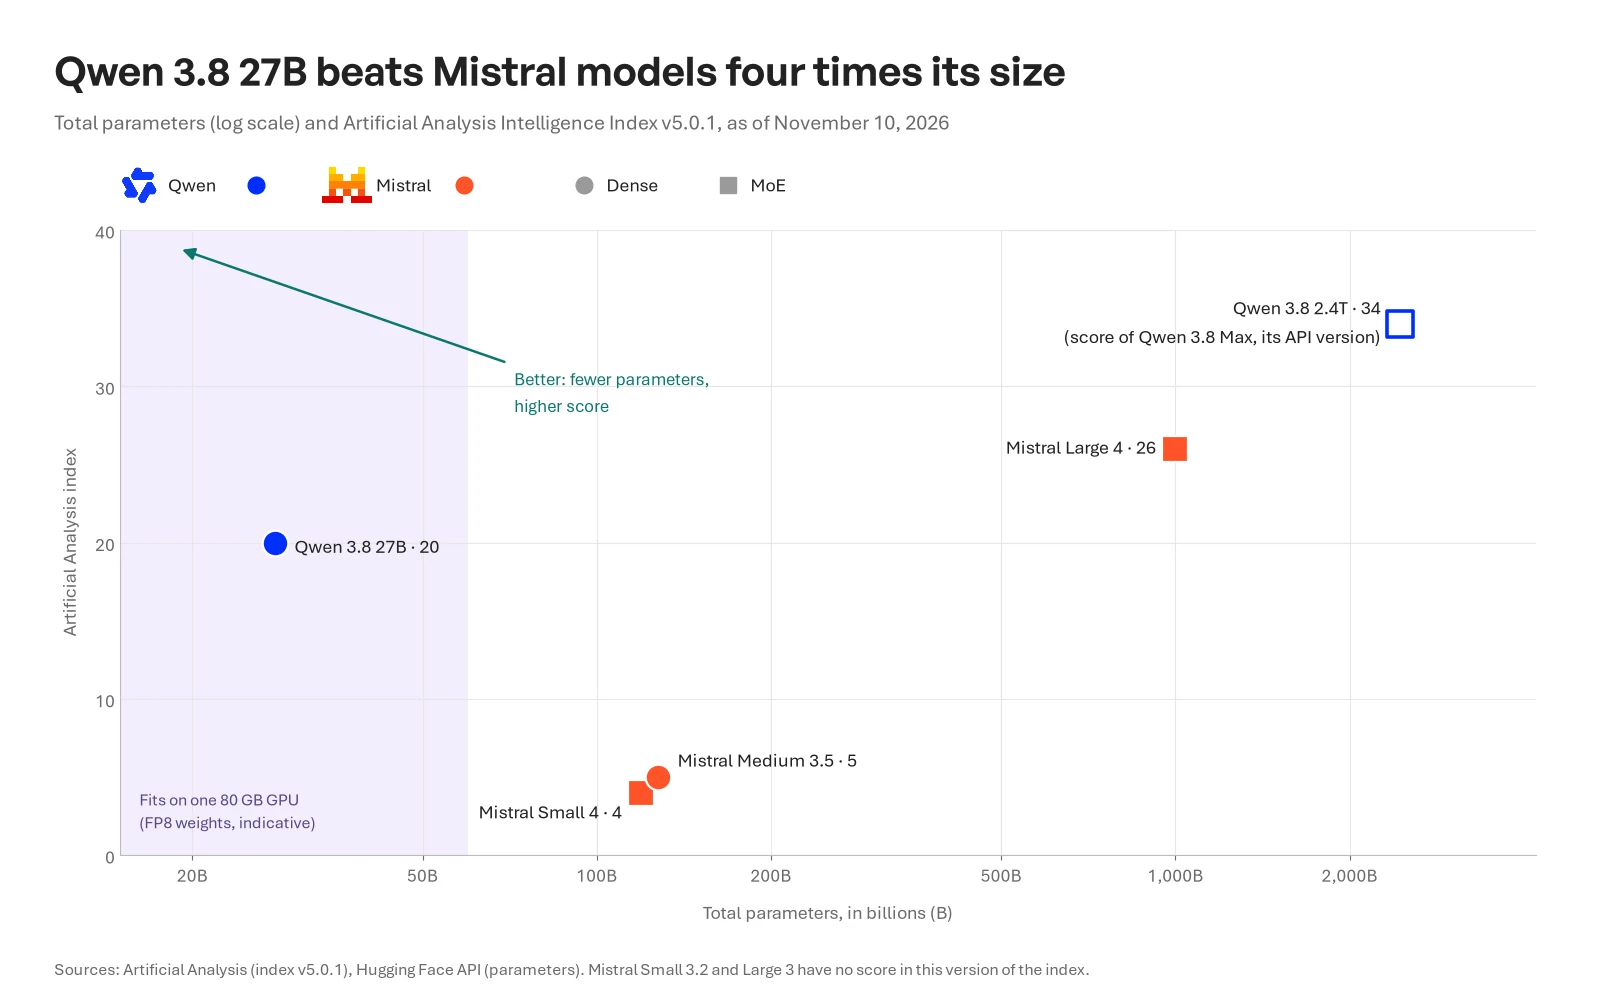 Streudiagramm mit den Gesamtparametern auf logarithmischer Skala und dem Index von Artificial Analysis v5.0.1. Qwen 3.8 27B, dicht, 27 Milliarden Parameter, Note 20, einziges Modell im Bereich, der auf eine GPU mit 80 GB passt. Mistral Small 4, MoE mit 119 Milliarden, Note 4. Mistral Medium 3.5, dicht mit 128 Milliarden, Note 5. Qwen 3.8 Flash-Next, Vorschau auf die Architektur von Qwen 4, MoE mit 180 Milliarden einschließlich seiner Embedding-Tabellen, Note 29. Mistral Large 4, MoE mit etwa 1.000 Milliarden, Note 26. Qwen 3.8 2.4T, MoE mit 2.400 Milliarden, bei 34 eingetragen, der Note seiner API-Version Qwen 3.8 Max. Ein Pfeil zeigt, dass oben links am besten ist: weniger Parameter, bessere Note
Auf der Stufe einer einzigen GPU hat Mistral keine aktuelle Antwort. Seine jüngsten Allzweckmodelle unter 30 Milliarden Parametern, Ministral 3 und Devstral Small 2 für Code, stammen von Ende 2025. Mistral Small 3.2, das dichte Modell mit 24 Milliarden Parametern und 5,6 Millionen Downloads, stammt vom Juni 2025. 2026 hat Mistral große Modelle und Spezialmodelle (Sprache, Zeitreihen, mathematische Beweise) veröffentlicht, aber keinen Nachfolger für Small 3.2. Die Qwen-27B-Linie hatte im selben Zeitraum drei Versionen.
Mistral Medium 3.5 ist das andere dichte Modell der Reihe, wiegt aber 128 Milliarden Parameter, und seine Deployment-Beispiele nutzen acht GPUs. Mistral gibt 77,6 bei SWE-bench Verified an, auf dem Niveau der 77,2, die Qwen für sein 27B angibt, mit Protokollen, die nicht unbedingt vergleichbar sind. Vor allem schließt seine Lizenz Unternehmen aus, deren konsolidierter Monatsumsatz 20 Millionen Dollar übersteigt: Darüber muss man bei Mistral eine kommerzielle Lizenz beantragen, die „at its sole discretion“ erteilt wird, oder auf die gehosteten Dienste zurückgreifen. Ein großer Mittelständler oder ein Konzern kann Medium 3.5 ohne Vertrag nicht auf eigenen Servern betreiben.
Mistral Small 4 wiederum ist ein MoE mit 119 Milliarden Parametern, davon 6,5 Milliarden aktiv, unter Apache 2.0, und das von Mistral angegebene Deployment-Beispiel nutzt zwei GPUs. Es ist schnell (137 Token pro Sekunde bei Mistral laut Artificial Analysis) und sparsam: Mistral schreibt auf seiner Modellkarte, dass Qwen-Modelle 3,5- bis 4-mal mehr Ausgabetext für vergleichbare Ergebnisse brauchen, was die oben gemessene Ausführlichkeit von Qwen 3.8 27B bestätigt. Im Index liegt es weit zurück.
In der Oberklasse ist es umgekehrt. Mistral Large 4, Ende Oktober erschienen, erreicht 26 Punkte im Index von Artificial Analysis, mehr als die 20 von Qwen 3.8 27B, und Mistral präsentiert es als das beste westliche offene Modell dieses Index. Es zählt aber rund tausend Milliarden Parameter, seine Deployment-Beispiele nutzen acht GPUs, und seine Lizenz verlangt von jedem, der es als Inferenzdienst anbieten will, eine separate kommerzielle Lizenz: ein anderes Projekt, mit anderem Budget.
Auch Alibaba hat sein Gegenstück, noch größer: Qwen 3.8 2.4T-A95B, die Version seines Flaggschiffs mit offenen Gewichten, zählt 2.400 Milliarden Parameter, davon 95 Milliarden aktiv, und belegt 4,9 TB auf Hugging Face. Artificial Analysis bewertet es noch nicht, obwohl fünf Anbieter es bereitstellen, aber Qwen 3.8 Max, die darauf aufbauende kommerzielle Version, erreicht 34 Punkte, mehr als die 26 von Mistral Large 4. Sein Nachfolger Qwen4-Max kommt auf 43 Punkte, allerdings ohne veröffentlichte Gewichte. Seine Lizenz ist nicht die Apache 2.0 des 27B: Die „Qwen3.8-Max License“ verlangt ab 100 Millionen monatlichen Nutzern oder 20 Millionen Dollar Monatsumsatz die Nennung des Modellnamens und ab 50 Millionen Dollar Umsatz über zwölf Monate eine separate Lizenz, um es als Inferenzdienst oder in einem Coding- oder Office-Assistenten anzubieten. Bei Qwen wie bei Mistral kommt das sehr große offene Modell mit einer hauseigenen Lizenz. Dazwischen erreicht Qwen 3.8 Flash-Next, die Vorschau auf die Architektur von Qwen 4, 29 Punkte mit 6 Milliarden aktiven Parametern, mehr als Mistral Large 4. Seine Qwen Community License geht weiter als die von Qwen 3.8 Max: Die separate Lizenz ist für jeden Inferenzdienst und jeden Coding- oder Office-Assistenten nötig, ohne Umsatzschwelle; die interne Nutzung bleibt frei. Größenmäßig näher an Mistral Large 3 bleibt Qwen 3.5 397B unter Apache 2.0, hat in der aktuellen Version des Index aber keine Note.
Unsere Einschätzung: Zwischen Qwen und Mistral würden wir nach GPU-Budget und Lizenz entscheiden. Für ein Modell, das auf eine Karte passt, hat Mistral kein aktuelles Gegenstück zu Qwen 3.8 27B. Für die beste offene Qualität verlangen Mistral Large 4 und Qwen 3.8 2.4T beide einen Server mit mehreren GPUs und eine hauseigene Lizenz; Mistral hat den Vorteil, ein europäischer Anbieter zu sein. Die Frage der Souveränität entscheidet sich anderswo, dazu weiter unten.
Dense oder MoE: Warum ein dichtes 27B, wenn alle auf MoE umsteigen?
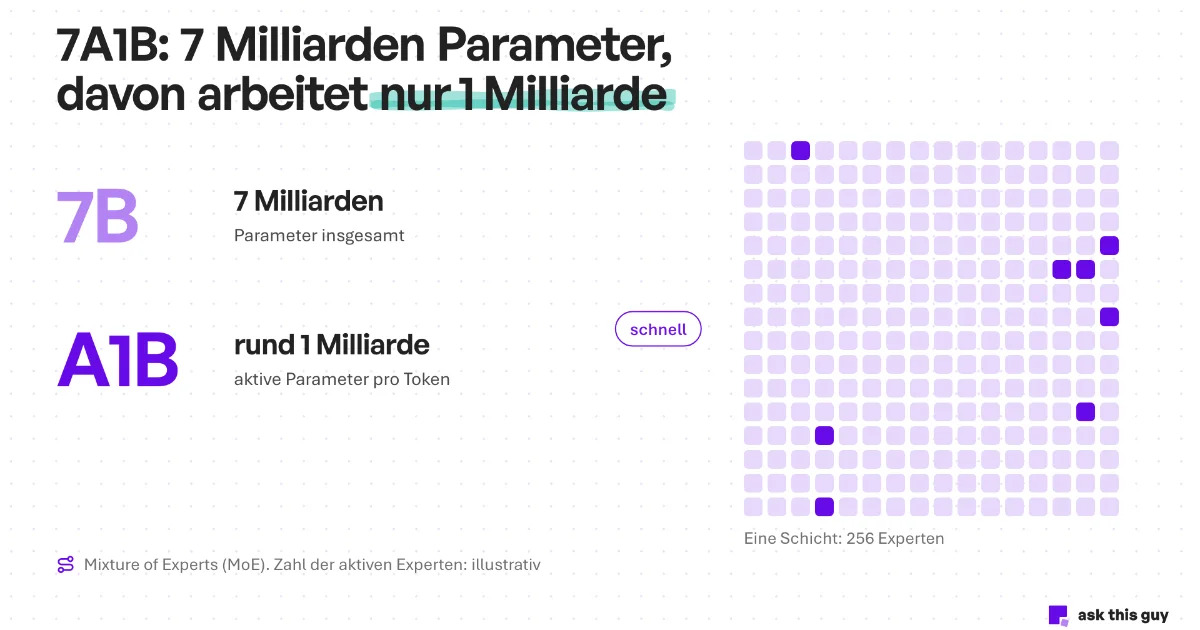
Ein dichtes Modell lässt für jedes erzeugte Token alle seine Parameter arbeiten. Ein MoE (Mixture of Experts) ist in Teilnetze aufgeteilt, die Experten, und ein Router aktiviert für jedes Token nur einige davon. Unser Leitfaden zu Mixture of Experts erklärt den Unterschied Schritt für Schritt. Die Größe wird mit zwei Zahlen angegeben: Qwen 3.6 35B-A3B zählt 35 Milliarden Parameter, davon 3 Milliarden pro Token aktiv.
MoE ist zum Standard der großen offenen Modelle geworden. Alibabas Flaggschiff Qwen 3.8 Max zählt 2.400 Milliarden Parameter, davon 95 Milliarden aktiv. Mistral Small 4 und Large 4, DeepSeek V4 und gpt-oss sind ebenfalls MoE-Modelle. Aktuelle dichte Modelle lassen sich an einer Hand abzählen: Qwen 27B, Gemma 4 31B von Google, Mistral Medium 3.5.
Ein MoE muss alles im Speicher halten
Ein MoE rechnet wenig, muss aber alle Experten geladen halten, denn der Router kann beim nächsten Token jeden von ihnen aufrufen. Hugging Face fasst es so zusammen: „all parameters need to be loaded in RAM, so memory requirements are high“, alle Parameter müssen im Speicher liegen. Für die Größe der in BF16, dem Referenzformat, veröffentlichten Gewichte liefert die API von Hugging Face:
| Modell | Architektur | Gewichte in BF16 |
|---|---|---|
| Qwen 3.8 27B | dicht, 27B | 55,6 GB (30,9 GB in FP8) |
| Qwen 3.6 35B-A3B | MoE, 3B aktiv | 71,9 GB |
| Qwen 3.5 397B-A17B | MoE, 17B aktiv | 806,8 GB |
In FP8 passt Qwen 3.8 27B in eine GPU mit 80 GB und lässt Platz für Konversationen. In 4 Bit wiegt es laut Runpod etwa 17 bis 18 GB und passt damit auf eine 24-GB-Karte wie eine RTX 4090. Bei vergleichbarer Code-Qualität braucht es fünfzehnmal weniger Speicher als das MoE mit 397 Milliarden Parametern.
AMD hat es schon am Tag der Veröffentlichung auf zwei Desktop-Systemen gemessen: bis zu 24,5 Token pro Sekunde auf einem Mini-PC mit Ryzen-AI-Max+-395-Prozessor und 128 GB Speicher, bis zu 51,8 auf einer einzigen Radeon AI PRO R9700 mit 32 GB, mit llama.cpp und aktiviertem spekulativem Decoding. Das sind vorläufige Zahlen, vom Hersteller für einen einzelnen Nutzer gemessen. AMD erinnert selbst daran, dass Qwen 3.8 27B als dichtes Modell „places substantial demands on memory capacity and compute“ und etwa 24 GB Grafikspeicher braucht, um komfortabel zu laufen. Eine Workstation reicht für einen Entwickler oder ein Pilotprojekt, nicht für ein ganzes Unternehmen. Für jede Stufe (Workstation, Server mit einer Karte, H100 oder H200) nennt unser Artikel zum lokalen KI-Server gemessene Durchsätze und im November 2026 erhobene Preise. Die Grafik am Anfang dieses Artikels stammt aus diesem Blogbeitrag von AMD.
Das MoE ist schneller, das dichte Modell antwortet besser
Der Preis dafür ist die Geschwindigkeit. Für jedes Token liest ein MoE nur seine aktiven Parameter, ein dichtes Modell dagegen alle. Auf derselben Consumer-Grafikkarte hat ein Entwickler 31 Token pro Sekunde für Qwen 3.6 27B und 98 für Qwen 3.6 35B-A3B gemessen, mit leicht unterschiedlichen Quantisierungen. Bei Alibaba misst Artificial Analysis 59 Token pro Sekunde für das dichte Modell und 118 für das MoE.
Derselbe Entwickler stellt fest, dass das dichte Modell „scores higher on every coding benchmark“. Die Zahlen von Qwen weisen in dieselbe Richtung: 77,2 bei SWE-bench Verified für das dichte 27B, 73,4 für das 35B-A3B. Das MoE antwortet zwei- bis dreimal schneller, das dichte Modell antwortet besser. Für einen Coding-Assistenten, den ein Entwickler den ganzen Tag nutzt, kann die Geschwindigkeit den Ausschlag geben. Für einen Agenten, der Schritte aneinanderreiht, ohne dass ein Mensch wartet, zählt die Genauigkeit mehr.
Ein viermal kleinerer KV-Cache
Der KV-Cache ist das Arbeitsgedächtnis eines Modells für jede Konversation: Er hält jedes bereits gelesene Token fest und wächst mit der Kontextlänge und der Zahl gleichzeitiger Nutzer. Auf einem gemeinsam genutzten Server begrenzt oft er, mehr als die Gewichte, die Zahl der Nutzer.
Die hybride Architektur von Qwen 27B senkt diesen Posten deutlich: Nur 16 seiner 64 Schichten halten einen KV-Cache, die 48 anderen begnügen sich mit einem kleinen Zustand fester Größe. Auf Basis der veröffentlichten Konfigurationsdateien von Qwen 3.8 27B und Qwen 3 32B ergibt unsere Rechnung 64 KiB pro Token für Qwen 3.8 27B, gegenüber 256 KiB für Qwen 3 32B, ein klassisches dichtes Modell ähnlicher Größe. Eine Konversation mit 32.000 Token, in einem RAG üblich, belegt 2,1 GB statt 8,4 GB. Runpod kommt zum selben Schluss: Jede Konversation kostet „roughly a quarter“ dessen, was sie auf einem klassischen 27B kosten würde.
In der Praxis ergibt unsere Rechnung auf einer einzigen H100 mit 80 GB, mit Gewichten in FP8 und Sicherheitsreserve, etwa 18 parallele Konversationen zu 32.000 Token, und etwa 35 mit einem KV-Cache in FP8. Wie man einen Server über dieses Beispiel hinaus dimensioniert, beschreibt unser Artikel über LLM on premise.
Einfacher anzupassen
Ein dichtes Modell lässt sich auch einfacher anpassen. Hugging Face merkt an, dass MoE-Modelle sich nach einem Fine-Tuning lange schwer taten zu generalisieren, mit einem Risiko der Überanpassung. Ein dichtes Modell mit 27 Milliarden Parametern lässt sich mit einem LoRA-Adapter auf einer einzigen Karte anpassen. Am 14. November zählt Hugging Face 896 feinabgestimmte Versionen von Qwen 3.8 27B und mehr als 1.000 quantisierte Versionen, gegenüber 523 feinabgestimmten Versionen für das MoE Qwen 3.6 35B-A3B. Nous Research hat am 6. November Arete-27B veröffentlicht, ein Nachtraining von Qwen 3.8 27B.
Wann ein MoE vorzuziehen ist
Das MoE bleibt in drei Fällen die richtige Wahl: wenn die von jedem Nutzer empfundene Geschwindigkeit Vorrang hat, wenn die Aufgabe viel Allgemeinwissen verlangt, und wenn die beste offene Qualität angestrebt wird, die es heute nur als MoE mit mehreren hundert Milliarden Parametern gibt. Auch ein dichtes Modell mit 27 Milliarden Parametern hat Grenzen: Es weiß weniger und denkt zum Ausgleich lange nach, was Token kostet.
Was ist von Qwen 4 27B zu erwarten?
Ein leistungsfähigeres Modell, wenn man dem Rhythmus der Linie traut, aber seine Form kennt noch niemand. Erstes Signal, die Generation 3.7: Alibaba hat gezeigt, dass es eine ganze Qwen-Version ohne offenes Modell veröffentlichen kann. Bei Qwen 4 hat es sich schriftlich auf kleinere Modelle mit offenen Gewichten festgelegt, was es bei 3.7 nie getan hat. Zweites Signal: Qwen 3.8 Flash-Next, Ende August veröffentlicht und von Qwen als „experimental preview of the architecture that will underpin Qwen4“ vorgestellt, eine Vorschau auf die Architektur von Qwen 4. Es ist ein MoE mit 125 Milliarden Parametern, davon 6 Milliarden aktiv, hinzu kommen 51 Milliarden Parameter „n-gram embedding“, Zuordnungstabellen, die in der angegebenen Größe nicht mitzählen. Im Index von Artificial Analysis erreicht es 29 Punkte, gegenüber 20 für Qwen 3.8 27B. Es hat weder die Größe noch die Bauart eines dichten 27B, und nichts erlaubt uns, daraus die Note eines künftigen Qwen 4 27B abzuleiten, aber die neue Architektur startet auf hohem Niveau. Seine Lizenz heißt „qwen-community-1.0“, nicht die Apache 2.0 der 27B-Linie, und für jeden Inferenzdienst, der Dritten offensteht, ist eine separate Lizenz nötig.
Dass die Vorschau ein MoE ist, sagt fast nichts über das 27B: Bei Qwen sind die großen Modelle seit Qwen 3 MoE-Modelle, während das 27B dicht bleibt. Der Name zählt mehr. Bei MoE-Modellen von Qwen enthält der Name zwei Zahlen („35B-A3B“: 35 Milliarden Parameter, davon 3 Milliarden aktiv), bei dichten Modellen eine. Ein unter dem Namen „Qwen4-27B“ veröffentlichtes Modell wäre also dicht, sofern die Konvention hält; dieser Name stammt allerdings aus Folien, nicht aus einer Pressemitteilung. Die eigentliche Unbekannte ist der Speicher. Qwen4-Max übernimmt die Architektur der Vorschau: Laut dem Blogbeitrag von Qwen wechseln sich drei Schichten linearer Attention mit einer Schicht Sparse Attention ab, und hinzu kommen 328 Milliarden N-Gram-Embedding-Parameter zusätzlich zu den 2.400 Milliarden. Da Qwen kleinere Modelle „built on the same lineage“ ankündigt, könnte auch das 27B schwerer wiegen, als sein Name sagt. Bleibt die Lizenz: Alibaba spricht von offenen Gewichten, ohne die Bedingungen zu nennen, und seine beiden jüngsten großen offenen Sprachmodelle, Qwen 3.8 2.4T und Flash-Next, erschienen unter hauseigenen Lizenzen. Am Tag der Veröffentlichung sind vor einem Wechsel vier Punkte zu prüfen:
- Die Lizenz: Apache 2.0 oder hauseigene Lizenz, mit möglichen Einschränkungen der kommerziellen Nutzung.
- Die Architektur: dicht oder MoE, Zahl der gesamten und aktiven Parameter.
- Der Speicher: Größe der Gewichte in FP8 und in 4 Bit sowie KV-Cache pro Token, berechenbar aus der Konfigurationsdatei.
- Unabhängige Messungen: der Index von Artificial Analysis oder eigene Tests; die Benchmarks des Herstellers reichen nicht.
Wir aktualisieren diesen Artikel, sobald Qwen 4 27B erscheint, mit dem bezifferten Vergleich.
Kann ein chinesisches Modell souverän sein?
Ein Modell mit offenen Gewichten „telefoniert“ nicht zu seinem Hersteller: Sind die Gewichte einmal heruntergeladen, sind es Dateien, die auf Servern Ihrer Wahl laufen. Von einem europäischen Betreiber in Frankreich gehostet, sendet Qwen 3.8 27B nichts an Alibaba. OVHcloud bietet es seit dem 24. August an, in FP8, in einem französischen Rechenzentrum, für 0,40 € pro Million Token Eingabe und 2,70 € Ausgabe. Scaleway bietet es für 0,60 € und 3,30 € an (Preise erhoben am 21. Oktober).
Die Souveränität hängt vom Hoster und vom Betreiber der Rechenleistung ab; die Nationalität der Gewichte ändert daran nichts. Qwen4-Max zeigt den umgekehrten Fall: Alibaba bietet es in seiner Region Frankfurt an, aber Alibaba betreibt es, und ohne veröffentlichte Gewichte kann kein europäischer Hoster es bereitstellen. Ein Rechenzentrum in Deutschland ändert nichts an der Nationalität des Betreibers. Bei offenen Gewichten bleiben zwei Fragen offen, und sie stellen sich auch bei amerikanischen Modellen: die aus dem Training geerbten Verzerrungen, die an den eigenen Use Cases zu testen sind, und die Abhängigkeit von einem Hersteller bei den nächsten Versionen, wofür die noch unbekannte Lizenz von Qwen 4 ein gutes Beispiel ist. Hier liegt das eigentliche Argument für Mistral: ein europäischer Anbieter, mit dem man nach europäischem Recht Verträge schließen kann. Unsere Seite zu souveräner KI und unser Artikel über Open-Weight-Lizenzen beschreiben diese Kriterien im Detail.
Was die IT-Abteilung daraus mitnehmen kann
Wenn ein Modell, das auf eine einzige GPU passt, für den Use Case ausreicht, würden wir mit Qwen 3.8 27B beginnen, über die API von OVHcloud oder Scaleway oder auf einer eigenen Karte. Auf Qwen 4 zu warten, ist nur für ein Projekt sinnvoll, das nicht vor mehreren Wochen startet. Qwen4-Max ändert an dieser Rechnung nichts: Es existiert nur auf den Servern von Alibaba. Die versprochenen kleineren Modelle könnten sie ändern, sofern sie unter einer Lizenz erscheinen, die zur geplanten Nutzung passt.
Den Modellwechsel bereitet man am besten von Anfang an vor. OVHcloud und Scaleway bieten eine mit OpenAI kompatible API: Der Modellname gehört in die Konfiguration, wo er sich ändern lässt, ohne den Code anzufassen. Mit einem Satz von 100 bis 300 echten Fragen und den erwarteten Antworten, wie ihn unser RAG-Audit-Raster beschreibt, misst ein Team Qwen 4 27B am Tag seines Erscheinens in einem halben Tag und wechselt, wenn der Gewinn real ist.
Ein LLM-Gateway geht noch einen Schritt weiter: eine einzige API und ein einziger Schlüssel vor mehreren Anbietern, mit Ausweichen auf einen anderen Anbieter, wenn der erste nicht antwortet. Am meisten bringt das bei einem offenen Modell, das mehrere Hoster gleichzeitig anbieten. Am 18. November bietet der europäische Endpunkt von Eden AI, einem französischen Gateway, Qwen 3.8 27B bei sechs Anbietern an, darunter OVHcloud und Scaleway. Die Wahl des Gateways zählt so viel wie die Wahl des Modells: Es entscheidet, an welche Anbieter die Anfragen gehen, also wo die Daten verarbeitet werden, und wie schnell ein neues Modell wie Qwen 4 27B verfügbar wird. Die Optionen, SaaS, Open Source oder Eigenbau, vergleichen wir in LLM-Gateway: OpenRouter, LiteLLM oder Eigenbau?
Der Reasoning-Aufwand sollte sich nach der Aufgabe richten. Qwen 3.8 27B denkt standardmäßig auf der höchsten Stufe; um eine E-Mail zu klassifizieren oder ein Feld zu extrahieren, reichen die Stufe low oder ein deaktiviertes Reasoning, und das Modell erzeugt weniger Token. Für Aufgaben, die ein Algorithmus lösen kann (Berechnung, Sortierung, Geschäftsregel), würden wir ganz auf KI verzichten: Das ist zuverlässiger, günstiger und sparsamer.
Häufige Fragen zu Qwen 4 und Qwen 3.8 27B
Ist Qwen 4 erschienen?
Teilweise. Qwen4-Max, das Flaggschiff der Generation, ist am 16. November 2026 erschienen, nach einer am 11. November geöffneten Vorschau. Es ist über die API von Alibaba Cloud und in den Apps von Qwen zugänglich. Kein Qwen-4-Modell lässt sich herunterladen: Weder Qwen4-Max noch Qwen 4 27B hat am 16. November Gewichte auf Hugging Face.
Ist Qwen4-Max Open Source?
Nein. Qwen4-Max ist ein geschlossenes Modell: Seine Gewichte sind nicht veröffentlicht, und es lässt sich nur über die API von Alibaba Cloud oder dessen Apps nutzen. Am 16. November hat Alibaba angekündigt, dass kleinere Qwen-4-Modelle mit offenen Gewichten bald erscheinen, ohne Größe, Datum oder Lizenz zu nennen.
Wann erscheint Qwen 4 27B?
Stand 16. November 2026 gibt es kein offizielles Datum. Alibaba verspricht kleinere Qwen-4-Modelle mit offenen Gewichten „soon“, ohne ein 27B zu nennen. Bei Qwen 3.8 kam das Modell mit 27 Milliarden Parametern etwa zehn Tage nach dem Flaggschiff. Die „Qwen4-27B“-Repositories, die schon auf Hugging Face stehen, stammen von Dritten und enthalten keine Gewichte.
Welche Benchmarks gibt es für Qwen4-Max?
Artificial Analysis gibt ihm 43 Punkte in seinem Index, gegenüber 34 für Qwen 3.8 Max und 46 für Kimi K3.1 Pro. Code Arena führt es in der Webentwicklung auf Platz 6, mit vorläufiger Note. Laut Qwen erreicht es 75,7 bei DeepSWE, vor Claude Opus 5.5, aber 48,5 bei Terminal-Bench 4.0, hinter Opus 5.5 und Kimi K3.1, und senkt die durchschnittlichen Kosten pro Aufgabe in seinem Benchmark Work360 um 62 %.
Ist Qwen 3.8 27B Open Source?
Qwen 3.8 27B ist ein Open-Weight-Modell: Seine Gewichte sind unter der Lizenz Apache 2.0 frei herunterladbar, die kommerzielle Nutzung, Änderung und Weiterverbreitung erlaubt. Trainingsdaten und Trainingscode sind nicht veröffentlicht, was es von Open-Source-Software im strengen Sinn unterscheidet.
Welche GPU braucht man für Qwen 3.8 27B?
In 4 Bit wiegt Qwen 3.8 27B laut Runpod etwa 17 bis 18 GB und passt für einen Nutzer auf eine 24-GB-Karte wie eine RTX 4090. AMD gibt bis zu 51,8 Token pro Sekunde auf einer Radeon AI PRO R9700 mit 32 GB an. In FP8 wiegen die Gewichte 30,9 GB: Eine H100 mit 80 GB bedient dann etwa 18 parallele Konversationen zu 32.000 Token. In BF16 braucht man 55,6 GB allein für die Gewichte. Für ein ganzes Team vergleicht unser Artikel zur Hardware eines lokalen KI-Servers drei Stufen mit ihren Preisen.
Qwen 3.8 27B oder Mistral: Welches Modell wählen?
Das hängt von der Infrastruktur ab. Für ein Modell, das auf eine einzige GPU passt, hat Mistral kein aktuelles Gegenstück zu Qwen 3.8 27B; sein dichtes Modell mit 24 Milliarden Parametern, Mistral Small 3.2, stammt vom Juni 2025. Für die beste offene Qualität von einem europäischen Anbieter übertrifft Mistral Large 4 Qwen 3.8 27B im Index von Artificial Analysis, läuft in den Beispielen von Mistral aber auf acht GPUs und verlangt eine kommerzielle Lizenz, wenn es als Dienst weiterverkauft werden soll.
Warum gibt es kein Qwen 3.7 27B?
Die Generation Qwen 3.7 erschien nur als API: Qwen 3.7 Max im Mai 2026 und Qwen 3.7 Plus am 1. Juni 2026, ohne veröffentlichte Gewichte auf Hugging Face. Die von der Community erwarteten offenen Versionen mit 27B und 35B kamen nie. Das offene Modell mit 27 Milliarden Parametern ging von Qwen 3.6 27B im April direkt zu Qwen 3.8 27B im August über.
Ist Qwen 3.8 27B besser als Qwen 3.6 27B?
Ja, laut Qwen wie laut Artificial Analysis. Bei gleicher Architektur steigt Qwen 3.8 27B nach Herstellerangaben bei SWE-bench Pro von 53,5 auf 61,7 und bei OSWorld-Verified von 63,9 auf 84,3, in Version 4.3.2 des Index von Artificial Analysis von 21 auf 34 Punkte. Es ist auch gesprächiger: Mit mehr Reasoning-Token ist zu rechnen.
Im Februar 2026 brauchte es ein MoE mit 397 Milliarden Parametern, um zu erreichen, was ein Modell mit 27 Milliarden Parametern im April beim Code leistete. Hält dieser Rhythmus, passt das Modell, das für die meisten Unternehmensanwendungen ausreicht, bald auf die Grafikkarte einer Workstation. Im Vorteil sind die Teams, die das Modell an einem Tag wechseln können: Jede neue Version kommt ihnen ohne Großbaustelle zugute, während die anderen auf der installierten Version sitzen bleiben.