
 KI
Olala mini: Was das erste OVH-LLM ohne GPU wirklich taugt
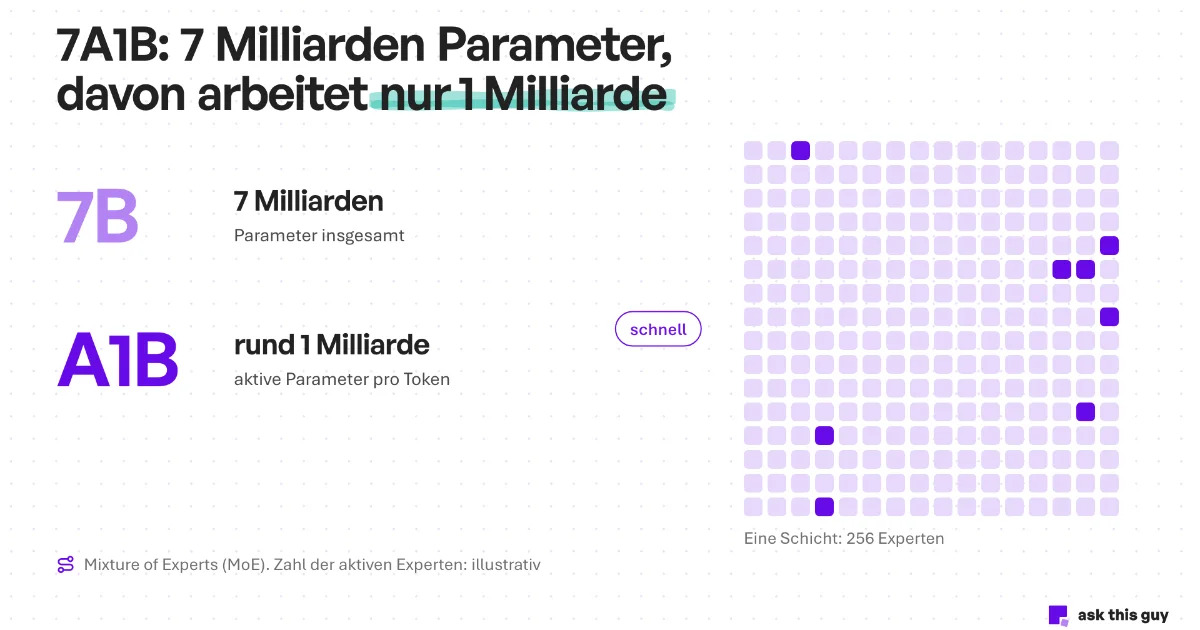
Olala mini 7A1B, das erste OVH-LLM, läuft ohne Grafikkarte. Was 7A1B bedeutet, was die Zahlen verschweigen und wofür sich das Modell im Unternehmen eignet.
KIOlala mini 7A1B, das erste OVH-LLM, läuft ohne Grafikkarte. Was 7A1B bedeutet, was die Zahlen verschweigen und wofür sich das Modell im Unternehmen eignet.
 KI
DeepSeek V4.1 Pro ist am 16. November nicht erschienen. Was bestätigt ist, was Gerüchte taugen und was DeepSeek V4 Pro heute bietet: Preis, Lizenz, Datenschutz.
 KI
KI-Server lokal betreiben: Workstation, RTX PRO 6000 oder H200. Was jede Hardware-Stufe mit Qwen 3.8 27B leistet, Durchsätze und Preise vom 16. November 2026.
 Digitale Souveränität
KI-Rechenzentren prägten die US-Midterms: 76 % der Wähler wollen keins in ihrer Gemeinde. Frankreich hat den Strom, der den USA fehlt, doch der Protest wächst.
 KI
Qwen4-Max ist seit dem 16. November da, ohne Gewichte; Qwen 4 27B lässt auf sich warten. Was bestätigt ist und was Qwen 3.8 27B gegen Mistral taugt.
 Konzepte
Mixture of Experts (MoE) oder dichtes Modell: wie beide Architekturen funktionieren, was sie für GPUs, Tempo und Preis bedeuten und welche passt.
 Digitale Souveränität
OVHcloud kündigt ein eigenes LLM an und will die ganze KI-Kette. Was AI Endpoints und die GPUs heute leisten, was offen bleibt, was CIOs daraus lernen.
 Digitale Souveränität
Für alle Produkte nennt Mistral AI nur zwei Compute-Betreiber: die eigenen Server und CoreWeave, dessen Schulden beunruhigen. Was ein Ausfall ändern würde.
 Leitfaden
LLM-Gateway oder AI Gateway: was ein KI-Gateway wie OpenRouter oder LiteLLM leistet, was es kostet und wo Ihre Daten durchlaufen. Mit unseren Preismessungen.
 Leitfaden
KI-Inferenz im Unternehmen: 7 Ansätze im Vergleich, vom GPU-Kauf bis zum schlüsselfertigen Anbieter. Echte Kosten, Souveränität, Latenz, Auswahlkriterien.
 Leitfaden
Warum ein Anbieter für ein KI-SLA im Unternehmen nicht reicht: Zusagen im Vergleich, LLM-Gateway mit mehreren Anbietern, Fallback für RAG und Assistenten.
 KI
Lokales LLM und RAG on premise 2026: GPU-Preise, Speicherbedarf pro Modell, Gesamtkosten und Break-even gegenüber demselben Modell per API, in Zahlen.