
 KI
Olala mini: Was das erste OVH-LLM ohne GPU wirklich taugt
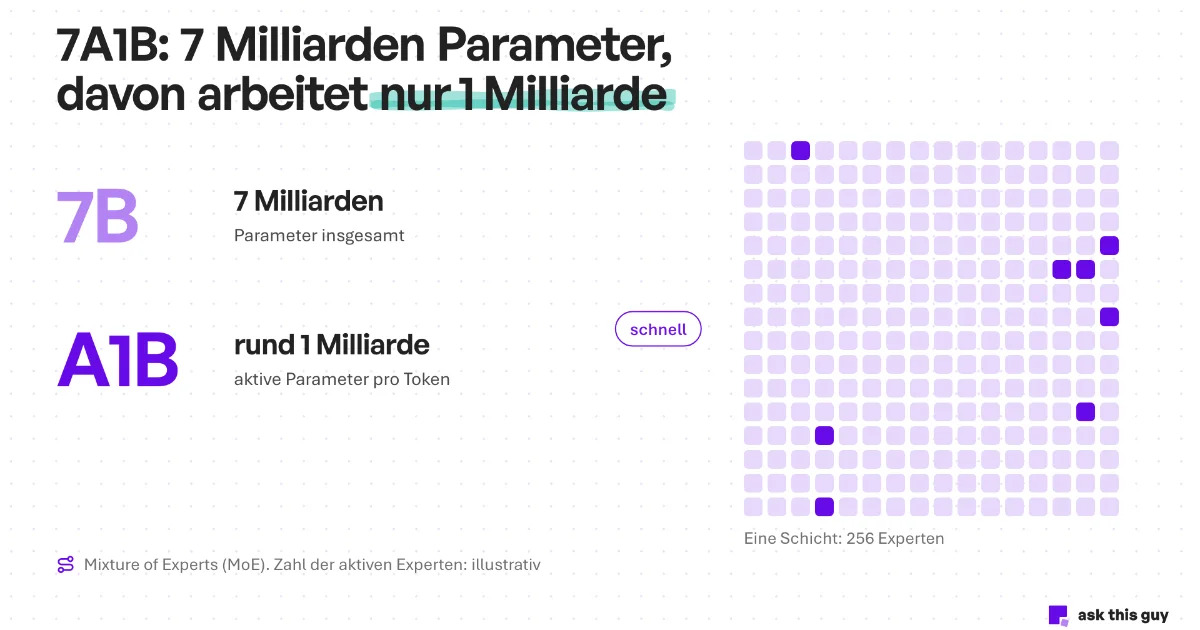
Olala mini 7A1B, das erste OVH-LLM, läuft ohne Grafikkarte. Was 7A1B bedeutet, was die Zahlen verschweigen und wofür sich das Modell im Unternehmen eignet.
KIOlala mini 7A1B, das erste OVH-LLM, läuft ohne Grafikkarte. Was 7A1B bedeutet, was die Zahlen verschweigen und wofür sich das Modell im Unternehmen eignet.
 KI
DeepSeek V4.1 Pro ist am 16. November nicht erschienen. Was bestätigt ist, was Gerüchte taugen und was DeepSeek V4 Pro heute bietet: Preis, Lizenz, Datenschutz.
 KI
KI-Server lokal betreiben: Workstation, RTX PRO 6000 oder H200. Was jede Hardware-Stufe mit Qwen 3.8 27B leistet, Durchsätze und Preise vom 16. November 2026.
 KI
Qwen4-Max ist seit dem 16. November da, ohne Gewichte; Qwen 4 27B lässt auf sich warten. Was bestätigt ist und was Qwen 3.8 27B gegen Mistral taugt.
 Konzepte
Open-Source-KI im Unternehmen: was jede Lizenz offener Modelle erlaubt, wie viel sie gegenüber APIs spart und warum ihre Regeln strenger werden.
 Konzepte
Wir haben sieben KI-Modelle 14.000-mal nach einer Zahl zwischen 1 und 10 gefragt. Fünf antworten fast immer 7, bei jeder Temperatur. Woher kommt der Bias?
 Konzepte
Mixture of Experts (MoE) oder dichtes Modell: wie beide Architekturen funktionieren, was sie für GPUs, Tempo und Preis bedeuten und welche passt.
 Konzepte
Kann sich eine KI selbst kopieren? Was Anthropic auf vernetzten Geräten getestet hat, KI-Wurm oder KI-Virus, die Grenzen der Studie und die Folgen.
 Konzepte
OpenAI und Anthropic werfen chinesischen Laboren Model Distillation vor. Doch Meta, Google, Mistral und sogar xAI destillieren auch. Was wirklich bekannt ist.
 Leitfaden
LLM-Gateway oder AI Gateway: was ein KI-Gateway wie OpenRouter oder LiteLLM leistet, was es kostet und wo Ihre Daten durchlaufen. Mit unseren Preismessungen.
 Leitfaden
Mistral OCR kostet 4 $ pro 1.000 Seiten. Ein Open-Weight-OCR auf einer europäischen GPU kostet 0,15 $ und bleibt souverän. Benchmark, Break-even, Fallstricke.
 Leitfaden
KI-Inferenz im Unternehmen: 7 Ansätze im Vergleich, vom GPU-Kauf bis zum schlüsselfertigen Anbieter. Echte Kosten, Souveränität, Latenz, Auswahlkriterien.
 Leitfaden
Warum ein Anbieter für ein KI-SLA im Unternehmen nicht reicht: Zusagen im Vergleich, LLM-Gateway mit mehreren Anbietern, Fallback für RAG und Assistenten.
 Konzepte
Langsame Embedding-APIs, Abhängigkeit vom Anbieter: unsere Erfahrung aus der Produktion und warum ATG das Embedding-Modell Qwen3 Embedding 8B parallel aufruft.
 Konzepte
Open Weights oder Open Source: Definition, Unterschiede, Lizenzen und Einsatz im Unternehmen. Warum ein LLM fast nie so Open Source ist wie Linux.