KI-SLA im Unternehmen: Ein einziger KI-Anbieter reicht nicht
Warum ein Anbieter für ein KI-SLA im Unternehmen nicht reicht: Zusagen im Vergleich, LLM-Gateway mit mehreren Anbietern, Fallback für RAG und Assistenten.

Öffnen Sie die Statusseite von Anthropic. Dort finden Sie meist eine Verfügbarkeit zwischen 99 und 99,5 %. „Two Nines“. Für ein KI-SLA im Unternehmen ist das wenig.
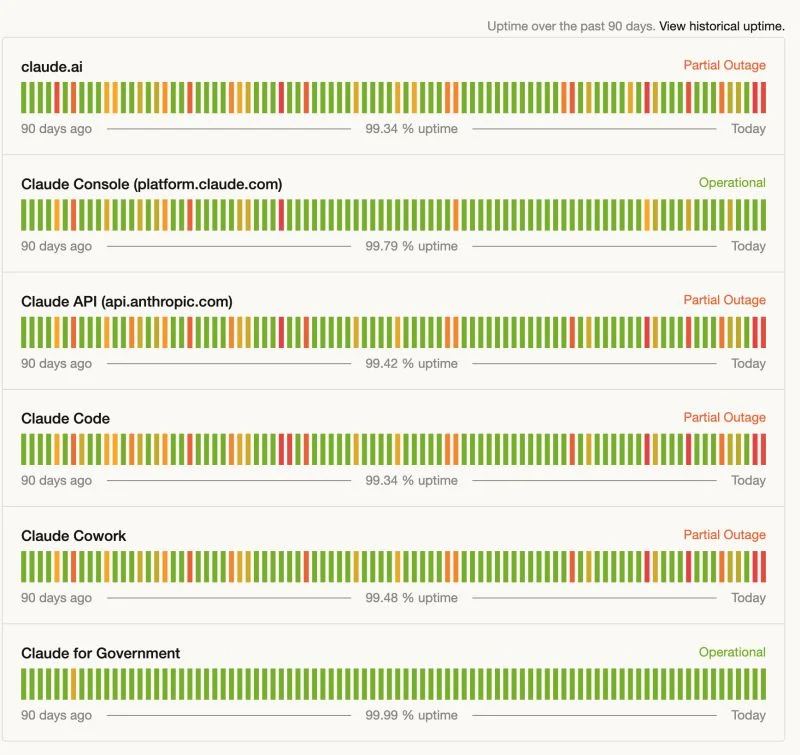
Wir sind von einer Zeit, in der man Four Nines (99,99 %) anstrebte, in eine Zeit gekommen, in der 99,3 % Uptime niemanden mehr schockiert (nicht mehr genug). „Vibe Coder“, die Claude nutzen, geben sich damit zufrieden, aber reicht das für Ihr Unternehmen? Wahrscheinlich nicht...
Ist Anthropic ein Einzelfall? Nein. Ein hohes Serviceniveau bei Inferenz im großen Maßstab zu halten, ist für alle schwierig.
Wenn Sie sich nur eines merken
Wer seine Produktion (RAG, interner Assistent, Agenten) an einen einzigen KI-Anbieter hängt, ob Claude, ChatGPT, Gemini oder Mistral, nimmt mehrere Tage kumulierte Nichtverfügbarkeit pro Jahr in Kauf. Für einen geschäftskritischen Dienst ist dieses Risiko wie jede andere Infrastrukturabhängigkeit zu behandeln.
Was die Nines bedeuten
Größenordnungen der Nichtverfügbarkeit über ein Jahr, alle Ursachen zusammengenommen:
| Nines | Uptime | Ausfallzeit ungefähr |
|---|---|---|
| Two Nines | 99 % | ~3,6 Tage |
| Three Nines | 99,9 % | ~8,8 Stunden |
| Four Nines | 99,99 % | ~52 Minuten |
Kann Ihr KI-Projekt mehrere Tage Stillstand pro Jahr verkraften?
Ihre Nutzer sind bei ihren Alltagswerkzeugen an „Four Nines“ gewöhnt. So sieht die tatsächliche Verfügbarkeit von Microsoft 365 aus:
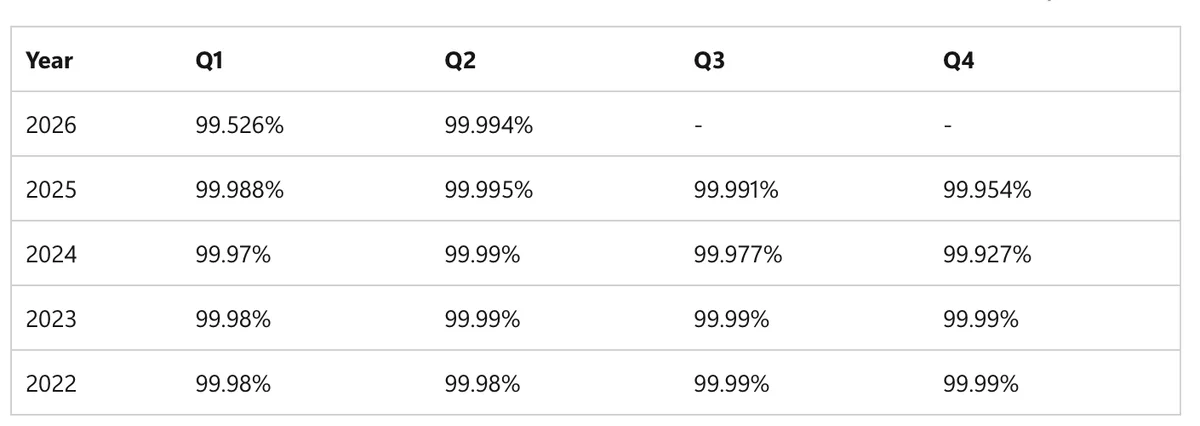 Weltweite Verfügbarkeit von Microsoft 365 pro Quartal, um 99,9 % und darüber (Quelle: Microsoft Learn)
Und bei den Wettbewerbern von Anthropic?
OpenAI und Mistral veröffentlichen ebenfalls ihre Verfügbarkeit. Die Zahlen sind nicht direkt vergleichbar: Jede Seite deckt andere Komponenten und Zeiträume ab. Am 31. Juli 2026 zeigte Mistral 99,4 % über die letzten drei Monate.
Eine Statusseite ist kein finanziell abgesichertes SLA. Einige spezifische Angebote veröffentlichen allerdings eine Zusage, etwa Gemini Online Inference mit 99,5 % oder OpenAI Scale Tier mit 99,9 %, als kostenpflichtige Option.
Die Hyperscaler können bei bestimmten verwalteten Inferenzdiensten höhere Zusagen machen, zum Beispiel 99,9 % bei Azure AI. Die Zusage gilt für den Endpoint. Latenz, Antwortqualität und der Rest Ihrer RAG-Kette sind darin nicht enthalten.
Das ist weit entfernt von den üblichen Garantien von Produktivitäts-SaaS, bei denen drei „Nines“ ohne Aufpreis Standard sind.
Open Weights machen den Fallback möglich
Ein und dasselbe offene Modell läuft bei rund zehn Inferenzanbietern. Das ist eine der sieben Arten, Inferenz im Unternehmen bereitzustellen, die wir in unserem Leitfaden zur KI-Inferenz vergleichen. Fällt einer aus, wechseln Sie zu einem anderen, ohne das Modell zu ändern, also ohne Ihre Prompts anzufassen.
Daher das Multi-Provider-Gateway, auch LLM-Gateway genannt: eine Schicht, die mehrere Modelle bei mehreren Anbietern aufrufen kann und zwischen ihnen danach entscheidet, wer antwortet, wie schnell und zu welchem Preis.
Keiner dieser Anbieter erreicht allein 99,9 %. Hintereinandergeschaltet hinter einem Gateway, das ihren Zustand prüft und umschaltet, sobald einer ausfällt, schafft man es. Das messen wir bei Ask This Guy in der Produktion über die letzten 30 Tage:
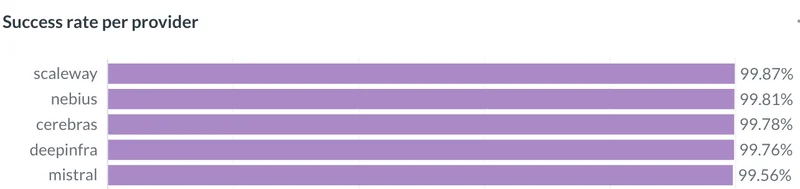 Erfolgsquote pro Inferenzanbieter: Scaleway 99,87 %, Nebius 99,81 %, Cerebras 99,78 %, DeepInfra 99,76 %, Mistral 99,56 %
Ein solches Gateway kauft man als SaaS (OpenRouter, Eden AI), hostet es als Open Source selbst (LiteLLM), entwickelt es selbst oder bekommt es integriert in eine Plattform, so wie bei uns bei Ask This Guy. Diese Optionen, ihre Kosten und was sie mit Ihren Daten machen, vergleichen wir in LLM-Gateway: OpenRouter, LiteLLM oder Eigenbau?
Ein RAG-SLA im Unternehmen endet übrigens nicht bei der Uptime des LLM. Die Aufnahme der Quellen, die Suche und die Tool-Aufrufe können ausfallen, ohne dass sich am Modell etwas rührt. Zu den Fallstricken nach dem POC siehe RAG im Unternehmen: 5 Fehler in der Produktion.
Häufige Fragen zum KI-SLA im Unternehmen
Was ist ein KI-SLA im Unternehmen?
Ein KI-SLA im Unternehmen legt das erwartete Verfügbarkeitsniveau eines KI-Dienstes fest, seinen Messumfang, seine Ausschlüsse und die Gutschriften, die fällig werden, wenn die Zusage nicht eingehalten wird. Eine Statusseite dient dazu, Störungen zu beobachten, sie verpflichtet niemanden.
Welches SLA für ein RAG im Unternehmen?
Ein RAG-SLA im Unternehmen muss mehr abdecken als die API des Modells: die Aufnahme der Quellen, die Suche, das Gateway und die Latenz von Ende zu Ende. 99,9 % gilt als gängiger Richtwert, aber die Zahl sagt nichts aus, solange Umfang und Messmethode nicht schwarz auf weiß festgehalten sind.
SLA für KI-Assistenten: Wie lässt sich die Verfügbarkeit verbessern?
Beseitigen Sie zuerst den Single Point of Failure: ein Multi-Provider-Gateway, mehrere Modelle, Health Checks und ein automatischer Fallback. Ergänzen Sie ein Monitoring von Fehlern und Latenz sowie einen eingeschränkten Betriebsmodus für Momente, in denen gar nichts mehr generiert wird.
Bei Ask This Guy
Unser Gateway für KI-Anbieter wählt laufend die Modelle aus, die antworten, und zwar schnell. Ziel für unsere Kunden: ein Serviceniveau über 99,9 % im definierten Umfang, ohne von einem einzigen Spitzenmodell abzuhängen. Richtlinie „EU“ oder „weltweit“, je nach Ihren Anforderungen an die Souveränität.
Keine Zauberei: eine Architektur, die davon ausgeht, dass Cloud-LLM ausfallen. Sie ist die Grundlage unserer RAG-Lösung für Unternehmen, und dasselbe Gateway versorgt einen Produkt-Support-Assistenten, wenn die Nutzer Ihre Kunden sind.
Wenn Sie ein RAG oder einen internen Assistenten in den Regelbetrieb bringen und dieses Gateway unter realen Bedingungen sehen möchten: Demo buchen.