Wie funktioniert KI? 10 Konzepte vor der Unterschrift
Wie funktioniert KI? Neuronales Netz, Token, Training, Fine-Tuning, Halluzination, LLMOps: zehn Konzepte, die zeigen, wohin Ihr KI-Budget fließt.

Wie funktioniert KI, und was folgt daraus für ein Unternehmensprojekt? Dieser Artikel richtet sich an alle, die sich für KI interessieren und ihr Potenzial sehen, aber weder die Zeit noch die Lust haben, daraus ihren Beruf zu machen.
Vermutlich werden Sie Ihren KI-Bedarf an ein internes Team oder an externe Dienstleister delegieren. Das ist legitim. Aber Sie werden nicht darum herumkommen, diese kritisch zu hinterfragen, und dafür muss man einige Schlüsselkonzepte verstehen, vor allem aber, was sie für ein Unternehmensprojekt bedeuten.
Hier also zehn Begriffe, die man kennen sollte. Keine Mathematik, nicht mehr Fachjargon als nötig. Genug, um zu verstehen, worüber gesprochen wird, und um den fachlichen Teil eines KI-Projekts zu steuern.
Der Inhalt dieses Artikels erschien zuerst im Sommer auf LinkedIn, ein Konzept pro Tag.
Wie funktioniert KI? Das Wichtigste in Kürze
Darin steckt keine Magie. Numerische Gewichte, die anhand von Beispielen eingestellt wurden, Text, der in Fragmente zerlegt wird, Werkzeuge, die rundherum angeschlossen sind, Ihre Dokumente, die dem Modell im richtigen Moment auf den Schreibtisch gelegt werden, und viel Engineering, damit das Ganze trägt.
Was diese zehn Konzepte lehren, passt in zwei Sätze. Ihre Rechnung hängt fast nie davon ab, welches Modell Sie wählen, sondern davon, wie Sie es einsetzen. Und der POC, also die Demonstration, die Sie überzeugt hat, macht rund 20 % der Gesamtkosten des Projekts aus.
Nichts davon rechtfertigt es, zu viel zu versprechen. Nichts davon rechtfertigt es aber auch, abzuwarten.
Teil 1: Woraus ein Modell besteht
1. Das neuronale Netz
Klassische Software ist eine Abfolge von Anweisungen, die ein Mensch geschrieben hat. „Wenn der Kunde mehr als drei Bestellungen hat, gewähre 10 % Rabatt.“ Eine Regel, stur angewendet, mit vorhersehbarem Ergebnis. Um sie zu schreiben, muss man sie allerdings formulieren können.
Schreiben Sie mir jetzt die Regel, die erkennt, ob ein Foto eine Katze zeigt. Das wird Ihnen nicht gelingen. Ein Gehirn schafft es mühelos, also haben sich die Informatiker davon inspirieren lassen.
Ein neuronales Netz ist eine Eingabe, die Millionen oder Milliarden numerischer Gewichte durchläuft und als Ausgabe wieder herauskommt. Diese Gewichte wurden nicht programmiert: Sie haben sich anhand von Beispielen von selbst eingestellt. Wenn Sie sie öffnen, erkennen Sie darin keinerlei Logik.
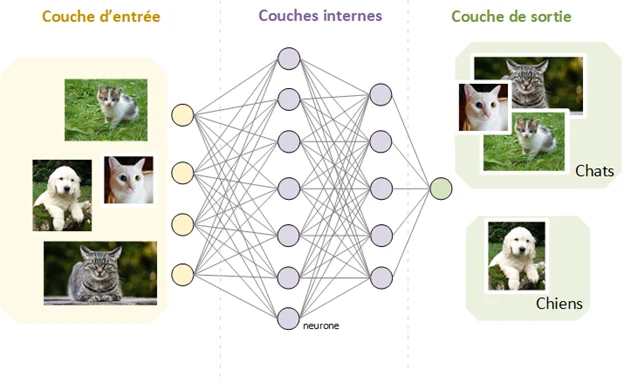 Schema eines neuronalen Netzes: Eine Eingabeschicht erhält Fotos von Katzen und Hunden, die Signale durchlaufen mehrere innere Schichten miteinander verbundener Neuronen, und die Ausgabeschicht sortiert die Bilder in zwei Kategorien, Katzen und Hunde
Eine Katze auf einem Foto, ein Satz, der zu vervollständigen ist, ein Vertrag, der zusammengefasst werden soll: immer dasselbe Prinzip. Gewichte, keine Regeln.
Die Konsequenz ist enorm, und sie betrifft Sie direkt. Niemand, nicht einmal die Entwickler des Modells, kann Ihnen genau sagen, warum es dies und nicht jenes geantwortet hat. Das ist kein Fabrikationsfehler, das liegt in der Natur der Sache. Bei einer Katze ist das egal. Bei einer Kreditablehnung, einer Diagnose oder einem Angebot schon weniger. Genau deshalb ist die Art, wie KI im Unternehmen eingerahmt wird, kein Implementierungsdetail.
2. Die Parameter
Diese Gewichte haben noch einen anderen Namen: Parameter. Das sind die berühmten „8B“, „70B“, „405B“, die Sie hinter Modellnamen sehen.
Zur Einordnung: Eine Katze auf einem Foto zu erkennen, erfordert etwa 2,5 Millionen Parameter. Menschliche Sprache zu verstehen und zu schreiben, ist etwas ganz anderes, und die größten Modelle überschreiten heute 1.000 Milliarden. Zum Vergleich: Das biologische Gegenstück zum Gewicht wäre die Synapse. Eine Fliege hat 50 Millionen davon, eine Maus 1.000 Milliarden, ein Mensch 100.000 Milliarden.
Was diese Gewichte enthalten, kann niemand lesen. Man kann sie als zwei vermischte Dinge betrachten: Wissen und Denkfähigkeit. Die zweite zählt mehr, und sie entsteht vor allem dadurch, wie das Modell nach seinem anfänglichen Lernen verfeinert wird.
Aus diesem Grund hat sich das Wettrennen um die Größe beruhigt. 2020 waren die 175 Milliarden Parameter von GPT-3 ein Rekord. Heute schlägt ein Modell mit 8 Milliarden es bei den meisten Aufgaben. Besser trainiert, aber kleiner.
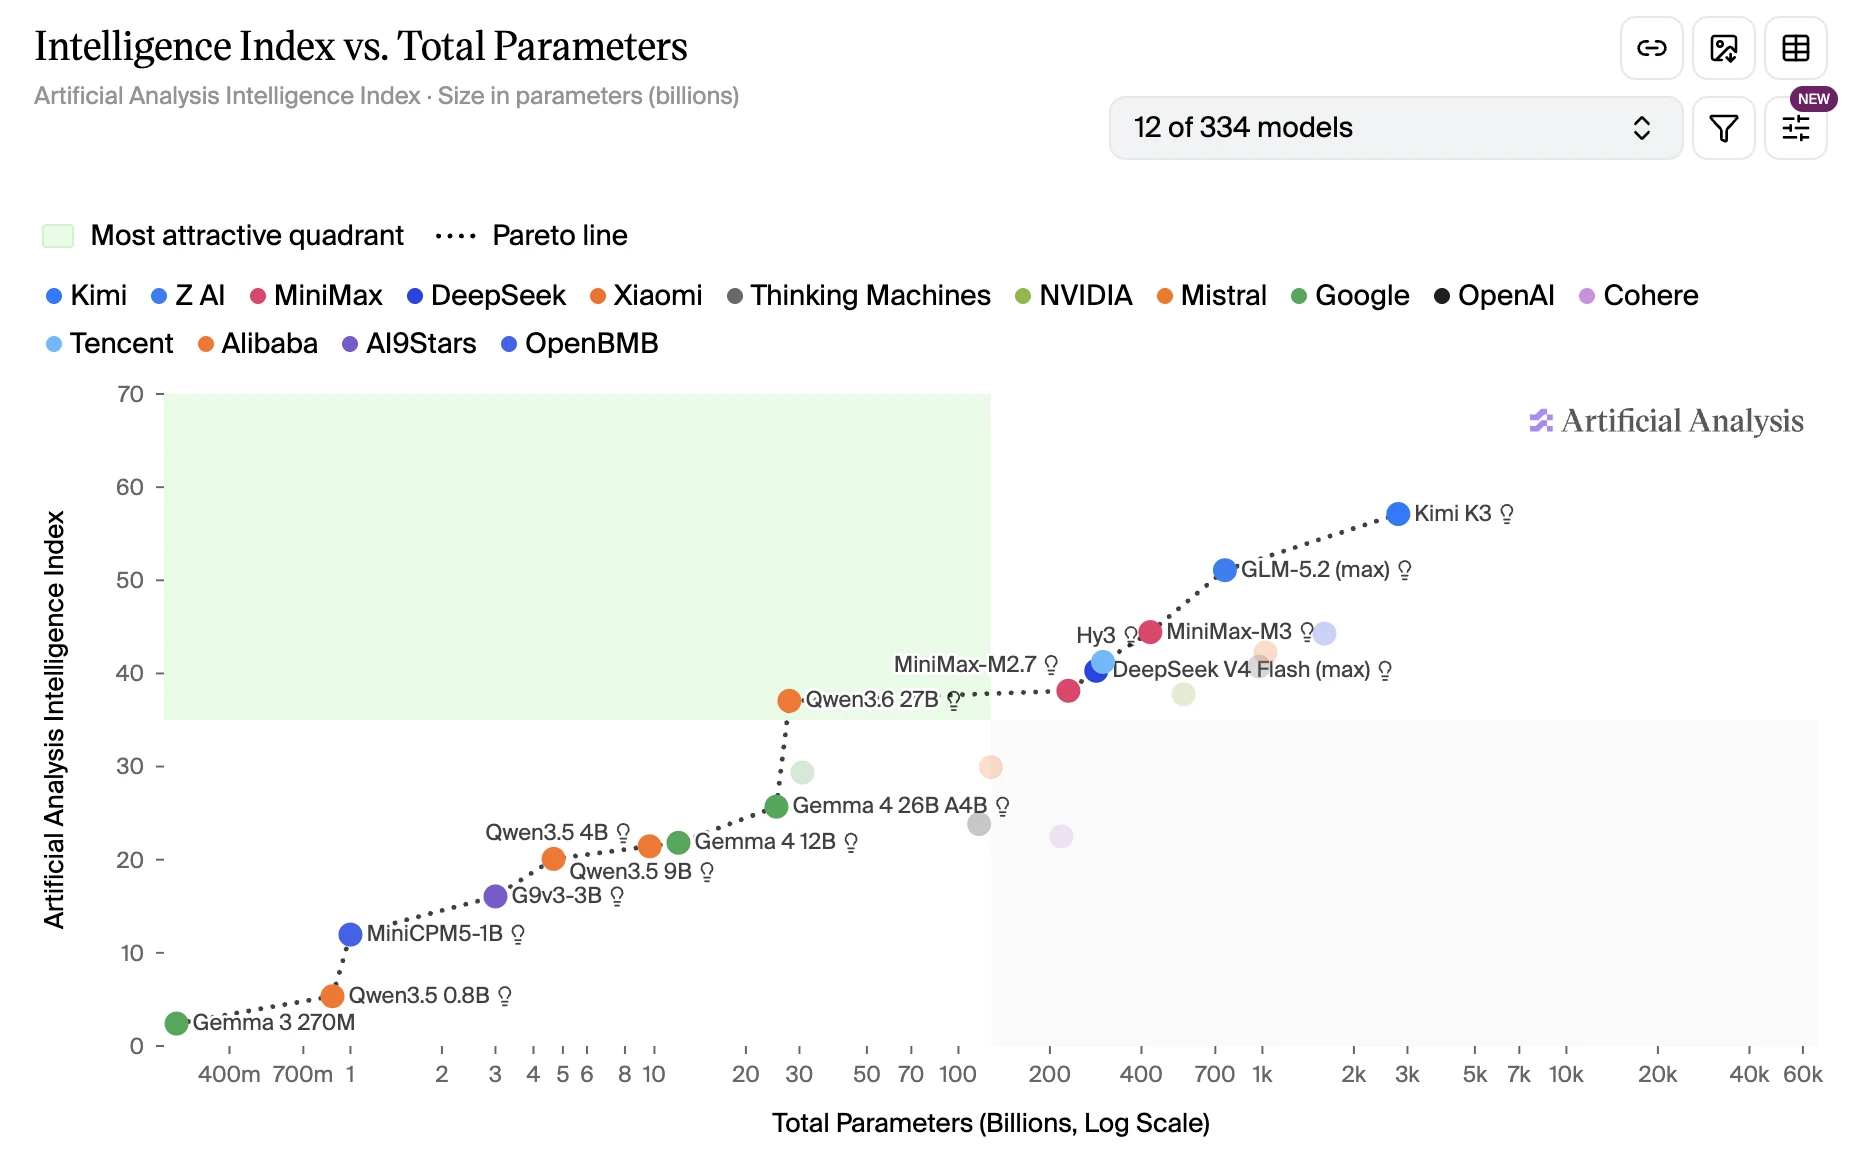 Punktwolke, die das Leistungsniveau offener Modelle mit ihrer Parameterzahl auf logarithmischer Skala vergleicht. Die Kurve steigt bis etwa dreißig Milliarden Parameter steil an und flacht dann ab: Darüber hinaus bringt eine Verhundertfachung der Größe nur noch wenige Punkte
Bei vergleichbarem Training bleibt ein großes Modell leistungsfähiger als ein kleines. Aber sehen Sie, wo die Kurve abflacht: Ab einigen Dutzend Milliarden Parametern bringt jede Verzehnfachung der Größe nur noch wenige Punkte. Die Größe allein entscheidet nicht mehr, wer gewinnt.
Warum Sie das betrifft: Größer heißt teurer, langsamer, energiehungriger. Rechnen Sie mit 0,35 € pro Million generierter Token für ein Mistral Small bei Scaleway, gegenüber 50 $ für das teuerste Modell von Anthropic. Mehr als das Hundertfache, obwohl für die Zusammenfassung eines Besprechungsprotokolls oder das Erkennen negativer Bewertungen das kleine Modell die Arbeit erledigt. Die kleinsten laufen sogar lokal, auf einem Laptop oder Smartphone, ohne dass Ihre Daten das Gerät verlassen.
3. Das Training
Wenn niemand weiß, was diese Milliarden Gewichte enthalten, wie hat man sie dann bestimmt? Man hat sie nicht geschrieben: Man hat sie durch Training entstehen lassen.
Das ist ein industrielles Großprojekt, das Milliarden Dollar an Rechenleistung, Energie und Expertise bindet. Es läuft in zwei Phasen ab.
Das Pre-Training beginnt mit zufälligen Parametern. Man lässt das Modell einen riesigen Korpus verschlingen, das gesamte Internet, Bücher, und fordert es auf, das nächste Wort vorherzusagen. „Der Arzt untersucht den Patienten mit seinem …“ ergibt „Stethoskop“. Bei jeder Vorhersage misst man den Fehler und korrigiert die Gewichte. Milliarden Mal. Nach und nach baut das Modell interne Repräsentationen der Strukturen der Sprache auf.
Das Post-Training verfeinert diese Basis anschließend: überprüfbare Ergebnisse, die Nachahmung eines leistungsfähigeren Modells, menschliche Abwägungen nach dem Muster „Bevorzugen Sie Antwort A oder Antwort B?“. Am Ende steht ein Modell mit eingefrorenen Gewichten.
Merken Sie sich dieses Wort: eingefroren. Genau dieses Wort entlarvt das am weitesten verbreitete Verkaufsversprechen des Marktes, das man in so gut wie jedem Vorprojekt-Meeting hört:
„Wir trainieren eine KI auf den Daten Ihres Unternehmens.“
Das Modell, das Sie nutzen, verändert sich nicht, wenn Sie es verwenden, und es lernt nichts aus Ihren Dokumenten.
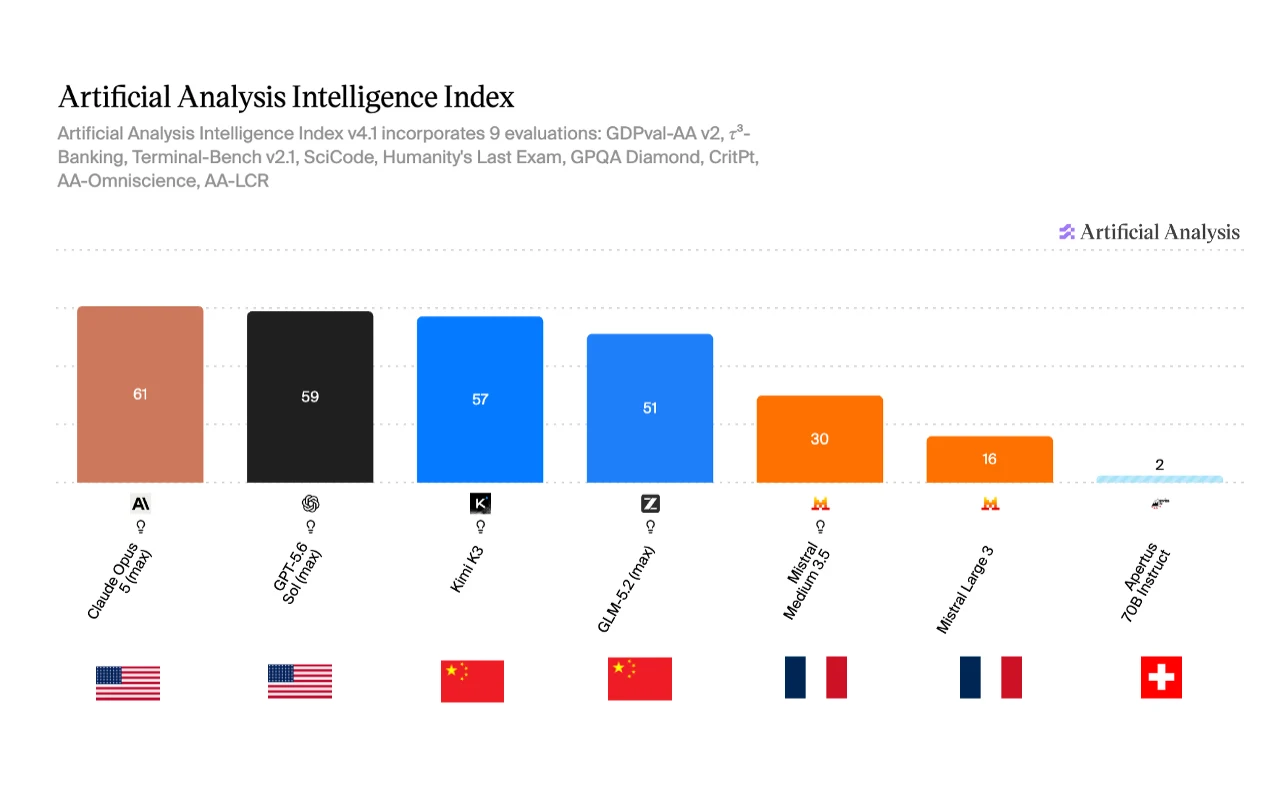 Rangliste der Modelle nach einem allgemeinen Leistungsindex, mit der Flagge des Herkunftslandes. Die ersten beiden sind amerikanisch, die nächsten beiden chinesisch und sehr nah dran, die französischen Modelle folgen deutlich dahinter, und das Schweizer Modell bildet das Schlusslicht
Zwei Länder dominieren heute diese Phase, die USA und China, und Europa hat diese Schlacht vorerst verloren. Das ist weniger schlimm, als es scheint: Viele chinesische und einige amerikanische Modelle sind offen, also herunterladbar und bei Ihnen ausführbar. Was „offen“ wirklich bedeutet, erläutern wir in unserem Artikel über Open Source und Open Weights. Wenn man wählen muss, ist es weniger schlimm, die Schlacht um die Modelle zu verlieren als die um die Inferenz, also den Moment, in dem man sie nutzt.
Teil 2: Wofür Sie wirklich bezahlen
4. Das Token
Ein neuronales Netz braucht Eingaben in einem geschlossenen Alphabet, einer endlichen Anzahl von Werten, die die Maschine verarbeiten kann. Damit es unsere Sprache lesen kann, muss man unsere Texte also zerlegen. Aber wie?
Nach Zeichen? Machbar, aber ein einzelnes „c“ bedeutet nichts, und das Modell bräuchte eine Ewigkeit, um den Sinn eines Absatzes zu berechnen. Nach ganzen Wörtern? Unmöglich: Zwischen Sprachen, Konjugationen, Tippfehlern, Code und Satzzeichen müsste man Dutzende Millionen Einträge speichern.
Der gefundene Kompromiss heißt Token. Stellen Sie sich einen Lego-Kasten der Sprache vor: statt aller Wörter der Welt ein Wörterbuch mit 100.000 bis 200.000 Fragmenten. Ein sehr häufiges Wort wie das französische „bonjour“ ist ein einziges Token. Ein längeres Wort setzt sich wie ein Puzzle zusammen: „développerait“ (französisch für „würde entwickeln“) kann zu [dé] + [velop] + [per] + [ait] werden, wobei das vierte Fragment allein die Information des Konditionals trägt.
Diese Zerlegung ist die Aufgabe des Tokenizers, eines Übersetzers, der Ihren Text in eine Folge von Codes umwandelt, bevor er ihn an das Modell schickt.
Warum dieses Wort auf all Ihren Rechnungen auftaucht. Zwei Punkte zählen.
Erstens: Die Rechnung hängt von der Sprache ab. Da die Modelle überwiegend mit englischen Texten trainiert wurden, bevorzugt ihr Wörterbuch diese Sprache.
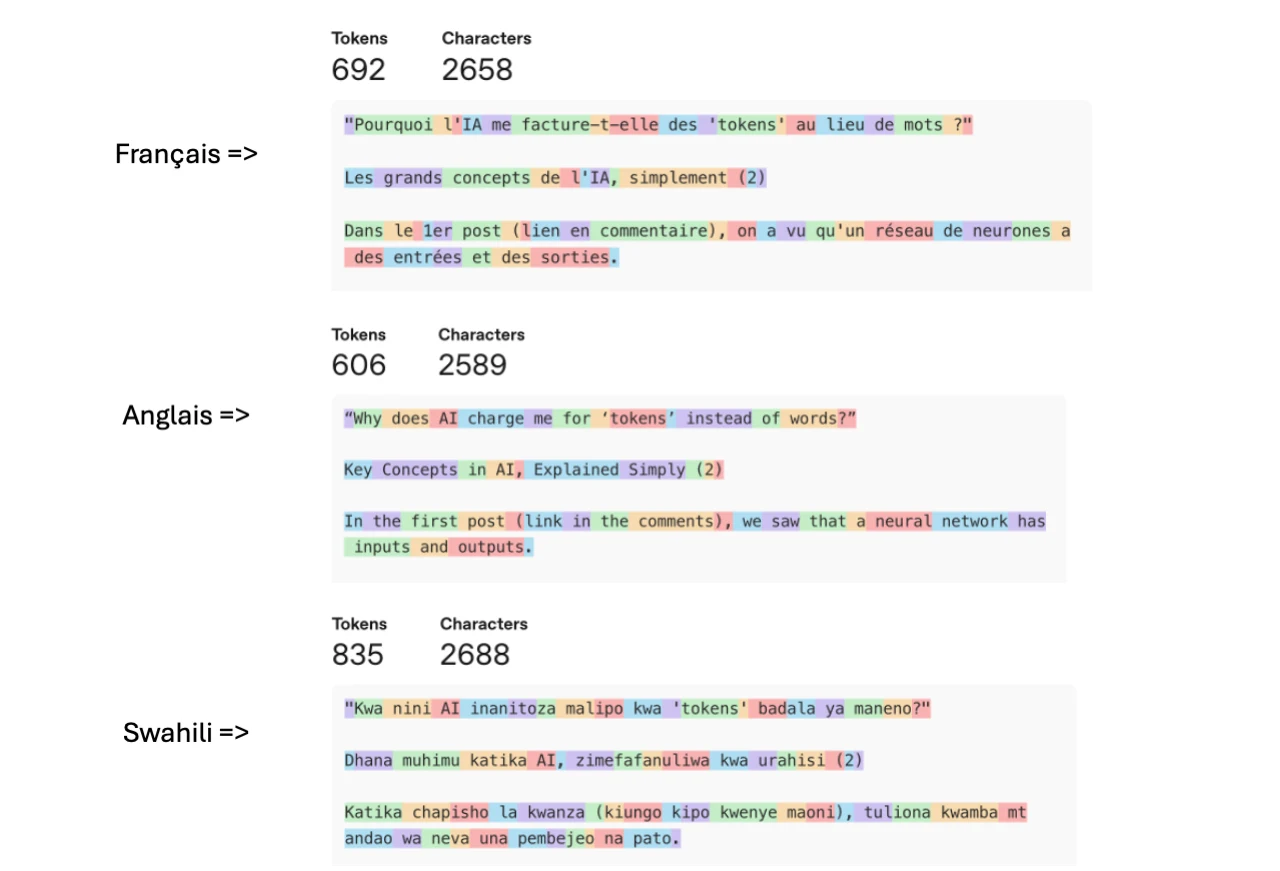 Derselbe Text in drei Sprachen in Token zerlegt. Auf Französisch ergeben 2.658 Zeichen 692 Token. Auf Englisch ergeben 2.589 Zeichen nur 606. Auf Swahili erzeugen 2.688 Zeichen 835
Derselbe Text kostet bei nahezu identischer Zeichenzahl auf Französisch 14 % mehr als auf Englisch, auf Swahili fast 40 % mehr. Sie zahlen eine Steuer auf Ihre Arbeitssprache, und die ist nicht verhandelbar.
Zweitens: Eingabe und Ausgabe zählen beide. Sie bezahlen die Token, die Sie senden, also Ihre Frage, aber auch die Anweisungen, den Verlauf und die angehängten Dokumente, und die Token, die das Modell erzeugt. Ein zehnseitiges Dokument ist nicht „eine Datei“, sondern etwa 5.000 Eingabe-Token, die jedes Mal verarbeitet werden müssen.
5. Die Inferenz
Ein großes Modell zu trainieren, hat jemanden mehr als eine Milliarde gekostet. Davon zahlen Sie nie einen Cent. Dafür bezahlen Sie jede Antwort.
Diese Berechnung auf Abruf heißt Inferenz. Anders als klassische Software, die auf gewöhnlichen Prozessoren läuft, ist Inferenz sehr rechenintensiv und verlangt spezialisierte Chips, die GPUs. Das hat es Nvidia ermöglicht, seinen Wert in fünf Jahren zu verzehnfachen.
Je größer das Modell, desto schwerer die Infrastruktur. Ein ganz kleines Modell passt auf einen PC. Ein mittleres Modell braucht Server für einige Zehntausend Euro, intern noch denkbar. Ein großes Modell ist außer Reichweite: Man muss mieten und in der Praxis über einen Inferenzanbieter gehen, der pro Token abrechnet.
Hier konzentrieren sich Ihre Kosten, und zwar nicht dort, wo Sie es vermuten. Für die richtige Aufgabe das richtige Modell wählen und dieselbe Berechnung nicht zweimal ausführen lassen. Diese beiden Entscheidungen wiegen weit schwerer als der ausgewiesene Preis pro Million Token.
Und hier entscheidet sich auch die Souveränität, denn wer Ihre Daten erhält, sieht sie, und er gehorcht seiner Regierung. Auf dieser Ebene ist der Abstand aber nicht nur politisch, sondern auch technisch.
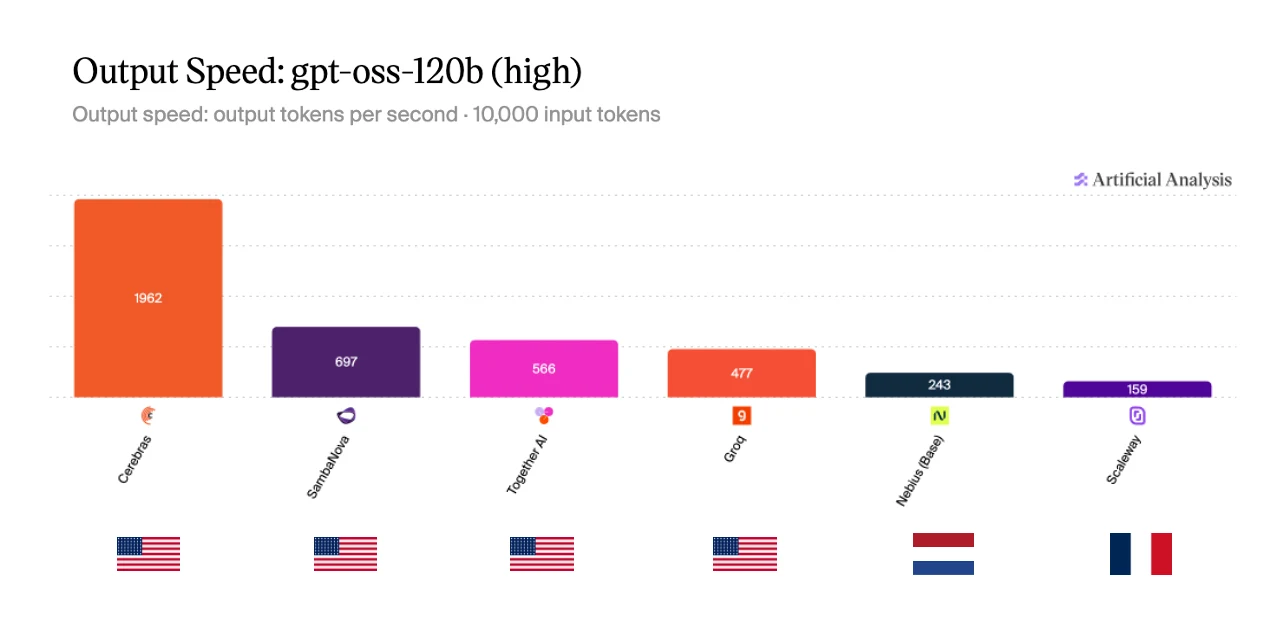 Generierungsgeschwindigkeit desselben offenen Modells je nach Anbieter, der es ausführt, mit der Flagge des jeweiligen Landes. Die ersten vier sind amerikanisch, der schnellste liegt über 1.900 Token pro Sekunde; die beiden europäischen Anbieter bilden das Schlusslicht, mit 243 und 159 Token pro Sekunde
Das Modell ist in allen sechs Fällen dasselbe. Es ändert sich nur, wer es betreibt, und der Abstand zwischen dem schnellsten amerikanischen Anbieter und dem besten europäischen übersteigt den Faktor acht. Das sollte man wissen, bevor man seinen Nutzern eine souveräne KI verspricht, die genauso reaktionsschnell ist wie die, die sie privat nutzen.
Das Thema verdient mehr als einen Absatz: Wir haben die sieben Wege, ein Modell im Unternehmen zu betreiben, und ihre tatsächlichen Kosten ausführlich beschrieben.
6. Das Kontextfenster
Das Kontextfenster ist das Arbeitsgedächtnis des Modells: alles, was es auf einmal lesen kann, Ihre Anweisungen, die angehängten Dokumente, den Gesprächsverlauf und Ihre Frage. Es wird in Token gemessen und liegt heute zwischen 128.000 und 1.000.000.
Diese stark steigende Zahl hat eine inzwischen regelmäßige Gattung von Beiträgen hervorgebracht: „RAG ist vorbei, man kann alles ins Kontextfenster packen.“
Das ist falsch, aus drei Gründen.
- Je voller das Fenster, desto mehr zahlen Sie. Jeder Austausch liest alles Vorherige erneut. Eine einzige Anfrage kann mehrere Euro kosten.
- Je voller es ist, desto ungenauer wird das Modell. Eine Information, die mitten in 500 Seiten untergeht, fällt viel häufiger unter den Tisch als am Anfang oder Ende eines Dokuments.
- Eine Million Token ist nicht viel, gemessen an den realen Dokumentenmengen eines Unternehmens.
Ein großes Fenster ist also keine Einladung, alles hineinzukippen. Genau deshalb gibt es RAG: Fünf gute Passagen sind besser als zweitausend Seiten durcheinander.
Teil 3: Was das Modell bei Ihnen nützlich macht
7. Die Werkzeuge
Ein Modell ist eingefroren und hat nie auch nur eines Ihrer Daten gesehen. Trotzdem kann Ihre KI die Nachrichten vom Morgen kommentieren, Fragen zu einem vertraulichen Vertrag beantworten und Ihr Vertriebsquartal analysieren. Wie?
Erinnern Sie sich an Ende 2022: Das ChatGPT der Anfangszeit konnte Ihnen nicht einmal das Wetter sagen. 2023 kommt die Websuche, dann weitere Werkzeuge (Tools), und alles ändert sich.
Konkret: Wenn Sie eine Anfrage an ein Modell mit Werkzeugen schicken, hat es zwei Optionen. Es antwortet direkt, oder es löst ein Werkzeug aus. Das Werkzeug wird ausgeführt und liefert sein Ergebnis zurück. Das Modell liest es und entscheidet erneut: antworten oder weitere Werkzeuge aufrufen. Und so weiter.
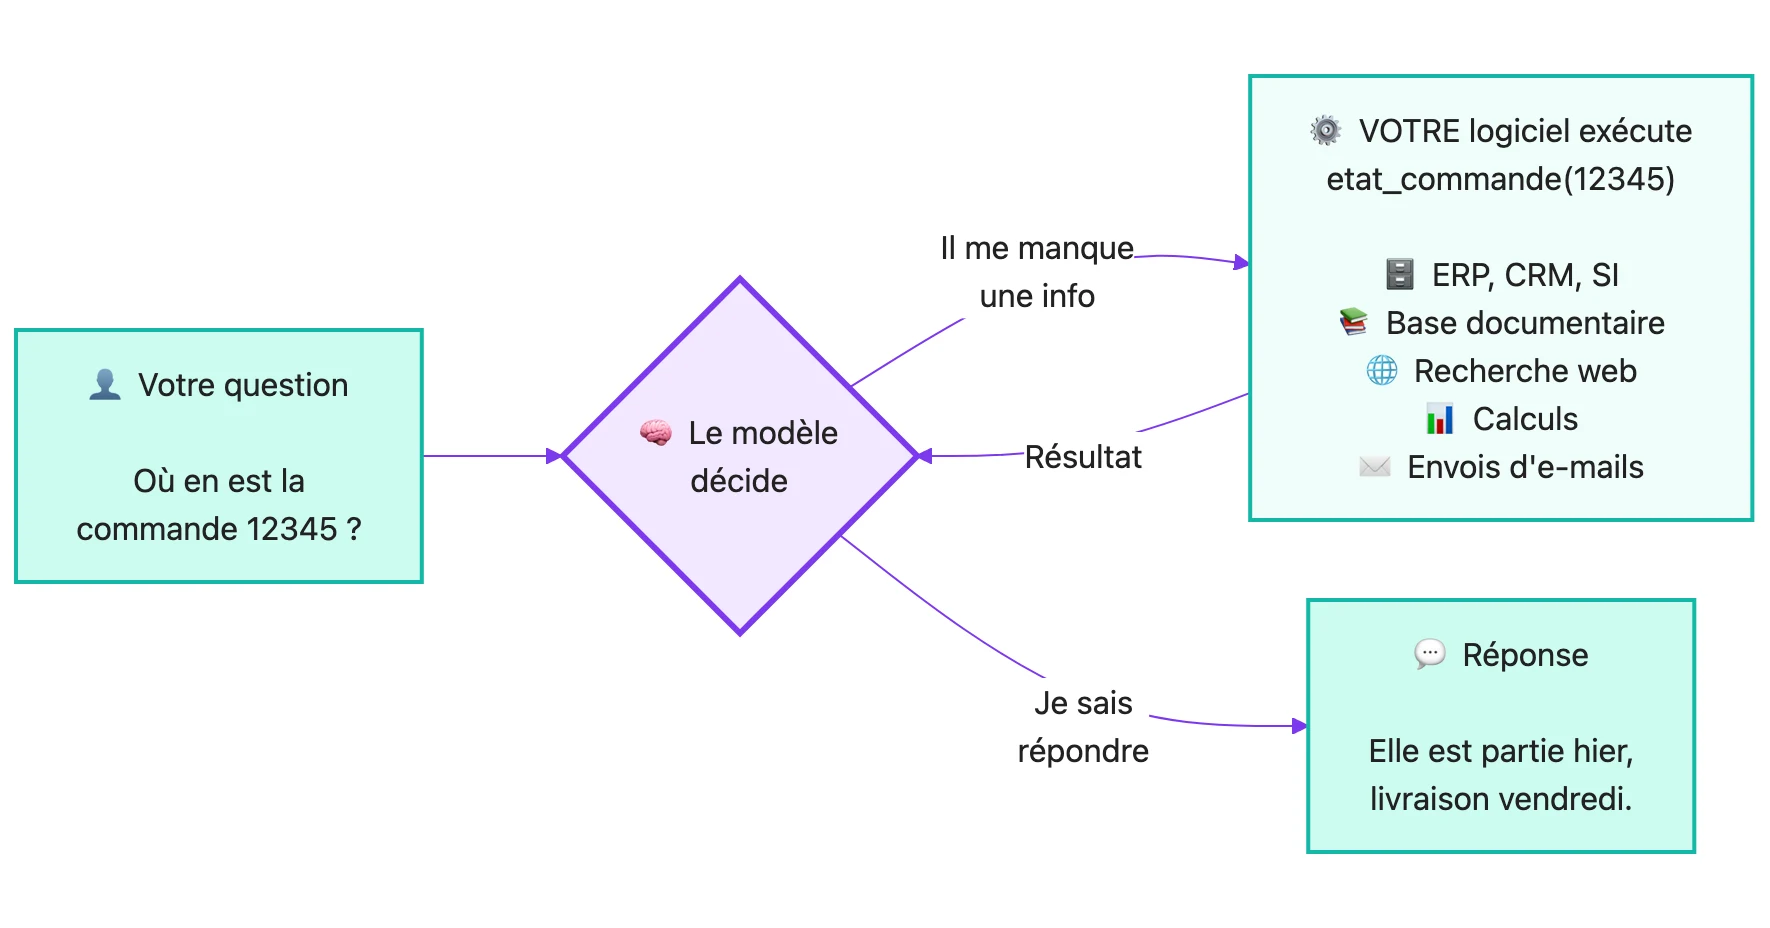 Schema eines Werkzeugaufrufs: Die Frage des Nutzers erreicht das Modell, das entweder direkt antwortet oder ein Werkzeug auslöst, das von der Unternehmenssoftware ausgeführt wird (ERP, CRM, Dokumentenbasis, Websuche, Berechnungen, E-Mail-Versand), bevor es seine Antwort formuliert
Die Rollen sind klar verteilt. Das Modell entscheidet, die Software führt aus. Diese Ausführung läuft über klassische Software, die man manchmal Harness nennt, und dort werden Zugriffsrechte, Protokolle und Freigaben verwaltet.
Die zentrale Idee, die die Art verändert, wie man einen Dienstleister bewertet: Man addiert Software und neuronales Netz. Das Modell versteht, denkt nach, orchestriert. Die Software rechnet, greift auf die echten Daten zu und handelt zuverlässig und nachvollziehbar. In einem ernsthaften KI-Projekt zählt die Software heute so viel wie das Modell, oft mehr.
Für diese Werkzeuge gibt es zwei Ansätze. Proprietäre Werkzeuge, die für eine bestimmte Software entwickelt wurden und nur dort funktionieren. Und Standardwerkzeuge, allen voran MCP: Sie stellen Ihr System einmal bereit, und jede kompatible KI kann sich anschließen.
Der Unterschied ist nicht technisch, sondern vertraglich. Bei den großen Anbietern bleiben Ihre Konnektoren und Automatisierungen bei ihnen. An dem Tag, an dem Sie wechseln, fangen Sie bei null an.
8. RAG
Ein Modell weiß nichts über Ihre Verträge, Ihre Prozesse oder Ihre Kundenhistorie. Man muss ihm die Information also in dem Moment geben, in dem Sie die Frage stellen. Das ist das Prinzip von RAG, kurz für Retrieval-Augmented Generation.
In seiner klassischen Form umfasst es vier Schritte. Sie wählen Ihre Dokumente aus und bringen sie in ein verwertbares Format. Sie zerlegen sie in Stücke, die in einer Datenbank für semantische Suche gespeichert werden, also für die Suche nach Bedeutungsnähe. Wenn ein Nutzer eine Frage stellt, findet das System die nützlichsten Passagen und fügt sie der Frage hinzu. Das Modell antwortet auf Grundlage dieser Elemente.
Am Modell wurde nichts trainiert oder verändert. Ihre Dokumente werden zum Zeitpunkt der Frage konsultiert, das ist alles. Merken Sie sich diesen Satz: Er wird beim Fine-Tuning wieder wichtig.
Ein Beispiel, um den Nutzen der semantischen Suche zu erfassen: Wenn Sie fragen „Wie viele Tage Homeoffice?“, kann eine Stichwortsuche eine Passage mit der Überschrift „mobiles Arbeiten“ verfehlen. Die Suche nach Bedeutung versteht, dass beide wahrscheinlich von derselben Sache sprechen. Stichwörter bleiben aber unverzichtbar, denn eine Produktreferenz wie XR-4471B muss zeichengenau gefunden werden. Genau darum geht es bei der hybriden Suche.
Das Wort RAG klingt nach einem einfachen Rezept. In der Produktion ist daraus ein komplettes System geworden: Konnektoren, Dokumentenaufbereitung, Zugriffsrechte, Wahl der Suchmethode, Quellenangaben, Evaluierung, Überwachung. Wir haben einen umfassenden Leitfaden zu RAG im Unternehmen geschrieben, für alle, die ins Detail gehen möchten.
9. Agentische KI
Eine KI, die ein Werkzeug aufrufen kann, ist noch kein Agent. Agentische KI ist der nächste Schritt: wenn das Modell ein Ziel in mehrere Schritte zerlegt, sie orchestriert und sich selbst korrigiert, um sein Ziel zu erreichen.
Der Unterschied zeigt sich in der Nutzung. Bei einer klassischen KI fragen Sie: „Analysiere diese Datei und nenne mir die drei am wenigsten rentablen Produkte“, und die KI ruft das Werkzeug auf, das die Datei liest, und antwortet. Bei einer agentischen KI bitten Sie: „Bereite das Vertriebsreview der Woche vor“, und sie holt die Zahlen aus dem CRM, vergleicht sie mit der Vorwoche, erkennt ungewöhnliche Abweichungen, sucht Erklärungen in den Besprechungsprotokollen, verfasst eine Zusammenfassung, bittet um menschliche Freigabe und verschickt sie dann.
Ein Agent ist also kein neuer Modelltyp. Es ist ein Modell im Zentrum eines Systems, das ihm Werkzeuge, ein Arbeitsgedächtnis, Regeln, Berechtigungen, manchmal ein Budget und ein Ziel zur Verfügung stellt. Use Cases, Kosten und Return on Investment eines KI-Agenten im Unternehmen beschreiben wir in einem eigenen Artikel.
Die Grenze, die man vor der Unterschrift kennen sollte. Ein Modell bleibt probabilistisch, also weniger zuverlässig als einfache Software. Nehmen Sie einen Agenten, der zehn Schritte aneinanderreiht, von denen jeder in 95 % der Fälle gelingt. Die Wahrscheinlichkeit, dass alle zehn gelingen, beträgt 0,95 hoch 10, also etwa 60 %.
Die Rechnung ist bewusst vereinfacht, aber der Gedanke ist zentral: Je mehr Aktionen man verkettet, desto mehr muss man die Zwischenergebnisse prüfen. Eine gute Automatisierung setzt KI nur dort ein, wo sie nötig ist, ein Prinzip, das wir in unserem Artikel über minimale KI-Automatisierung ausführen.
Und da es von außen sehr schwer ist, einen guten Agenten von einem schlechten zu unterscheiden, sollten Sie bei einer Auslagerung dieser Entwicklungen einen Festpreis und eine Ergebniszusage verlangen.
Teil 4: Die zwei Verwechslungen, die teuer werden
10. Fine-Tuning
Da sind wir. Fine-Tuning bedeutet, ein bereits trainiertes Modell zu nehmen und seine Gewichte anhand einiger Tausend Ihrer Beispiele leicht nachzujustieren. Das ist eine kleine Wiederaufnahme des Trainings, kein Training.
Und es ist das am stärksten überverkaufte Konzept des Marktes, das Dienstleister Ihnen mit dem Versprechen präsentieren, „eine KI auf den Daten Ihres Unternehmens zu trainieren“.
Was man sich merken muss, passt in einen Satz.
Fine-Tuning verändert das Verhalten, nicht das Wissen.
Sie möchten, dass das Modell immer in einem bestimmten Format antwortet, den Ton Ihres Hauses trifft, den Jargon Ihrer Branche beherrscht? Fine-Tuning. Sie möchten seine Erfolgsquote bei einer klar umrissenen Aufgabe verbessern, einer Klassifizierung oder der Code-Generierung? Fine-Tuning.
Sie möchten, dass es Ihre 40.000 Dokumente kennt? RAG. Nicht Fine-Tuning.
Ein letzter Punkt, den man nicht vergessen sollte: Fine-Tuning muss bei jedem Modellwechsel wiederholt werden. Also oft.
11. KI-Halluzination
Eine KI-Halluzination ist eine falsche Antwort, die mit der Sicherheit einer richtigen Antwort vorgetragen wird. Ein Urteil, das es nicht gibt, eine erfundene Klausel in einem Vertrag, eine plausible, aber falsche Zahl.
Der übliche Fehler besteht darin, das als Bug zu behandeln, den ein Anbieter irgendwann beheben wird. Es ist keiner. Denken Sie an Konzept Nummer 1: Ein Modell wendet keine Regeln an, es erzeugt die wahrscheinlichste Fortsetzung auf Basis von Gewichten, die anhand von Beispielen eingestellt wurden. Wenn ihm die Information fehlt, bringt es nichts in seiner Funktionsweise dazu, „Ich weiß es nicht“ zu sagen, statt etwas Plausibles zu erzeugen. Die Halluzination ist strukturell, nicht zufällig.
Das heißt: Man beseitigt sie nicht. Man reduziert sie und macht sie erkennbar, mit Mitteln, die allesamt Architekturentscheidungen sind und keine Modelleinstellungen: die richtigen Dokumente im richtigen Moment bereitstellen, statt auf das Gedächtnis des Modells zu setzen, überprüfbare Quellenangaben zu jeder Antwort verlangen, Zwischenergebnisse von deterministischer Software prüfen lassen und laufend messen.
Wenn ein Anbieter Ihnen eine KI „ohne Halluzinationen“ ankündigt, verkauft er Ihnen entweder eine sprachliche Übertreibung oder Unkenntnis seines eigenen Produkts. Die richtige Frage lautet nicht „Halluziniert das?“, sondern „Woran erkenne ich es, wenn es passiert?“
Was über das Überleben des Projekts entscheidet: LLMOps
Das am wenigsten verkaufsfördernde Konzept der Liste und mit Abstand das entscheidendste. LLMOps umfassen alles, was rund um das Modell nötig ist, damit ein Projekt in der Produktion besteht.
Klassische Software beherrscht man seit vierzig Jahren. Mit einem Agenten funktioniert nichts mehr auf die gleiche Weise.
Tests sind nicht mehr binär. Zweimal dieselbe Frage, zwei verschiedene Antworten. Und Ihre Nutzer folgen nicht zehn vorgezeichneten Pfaden, sie formulieren ihr Anliegen, wie sie wollen. Das „Ich klicke hier, dann passiert das“ reicht nicht mehr: Sie brauchen einen Satz von Fragen mit erwarteten Antworten, der von Ihren Fachexperten validiert wurde.
Die Infrastruktur werden Sie nicht kaufen. Eine dauerhaft gemietete H100 kostet fast 2.000 € pro Monat, für eine einzige Karte. Sie werden also von Drittanbietern abhängen.
Und diese Anbieter fallen aus. Ihre Statusseiten zeigen 99 bis 99,5 % Verfügbarkeit, also bis zu mehrere Tage Ausfall pro Jahr. Entweder Sie bezahlen viel Geld für eine vertragliche Zusage, oder Sie schließen mehrere an und schalten um, sobald einer ausfällt. Genau darum geht es bei einem SLA für einen KI-Dienst.
Die Rechnung wird in Token gezählt, und sie gerät schnell aus dem Ruder, wenn ein Agent fünfzehnmal in einer Schleife läuft und bei jeder Runde seinen gesamten Verlauf neu liest. Gesteuert wird über die Kosten pro nützlicher Anfrage, nicht über den Preis pro Million Token.
Die Modelle ändern sich ständig. Ihr Anbieter bringt ein besseres heraus, kündigt das alte mit wenigen Monaten Vorlauf ab, und Ihr millimetergenau abgestimmter Prompt liefert nicht mehr dasselbe. Man muss testen, umschalten und zurückwechseln können, ohne die Anwendung neu zu schreiben.
Das Verhalten wird jede Woche gesteuert: Fragen, aufgerufene Werkzeuge und genutzte Quellen protokollieren. Sonst diskutieren Sie, wenn ein Nutzer sagt „Der hat mir Unsinn erzählt“, über eine Wahrnehmung und verbessern nichts.
Der POC gelingt fast immer. Genau das ist das Problem.
Häufige Fragen: Wie funktioniert KI?
Was ist ein LLM?
Ein LLM, kurz für Large Language Model oder großes Sprachmodell, ist ein neuronales Netz, das darauf trainiert wurde, die Fortsetzung eines Textes vorherzusagen. Es besteht aus Milliarden numerischer Gewichte, Parameter genannt, die automatisch an riesigen Textkorpora eingestellt und nicht von Menschen programmiert wurden. Nach Abschluss dieses Trainings sind die Gewichte eingefroren: Das Modell verändert sich nicht mehr und lernt nichts aus den Fragen, die man ihm stellt. Das unterscheidet es grundlegend von klassischer Software, deren Regeln einzeln ausformuliert wurden und nachgelesen werden können.
Wie funktioniert generative KI?
Generative KI erzeugt Text, indem sie Stück für Stück die wahrscheinlichste Fortsetzung des Vorangehenden vorhersagt. Ihre Frage wird zunächst in Token zerlegt, die Wortfragmente, die das Modell verarbeiten kann. Diese Token durchlaufen dann die Milliarden Gewichte des Netzes, die das wahrscheinlichste nächste Fragment berechnen, dann das nächste, bis zum Ende der Antwort. Es wird weder eine Wissensdatenbank konsultiert noch eine Geschäftsregel angewendet: nur eine Wahrscheinlichkeitsberechnung auf eingefrorenen Gewichten. Deshalb kann dieselbe Frage zwei verschiedene Antworten ergeben.
Kann eine KI aus den Dokumenten meines Unternehmens lernen?
Nein, jedenfalls nicht in dem Sinne, wie man es meist versteht. Die Gewichte eines Modells sind nach dem Training eingefroren und ändern sich nicht, wenn Sie es nutzen. Damit eine KI zu Ihren Dokumenten antworten kann, verändert man nicht das Modell: Man liefert ihm im Moment der Frage die richtigen Auszüge, eine Technik namens RAG. Ihre Dokumente werden bei Bedarf konsultiert und dann wieder vergessen. Die in Angeboten verbreitete Formulierung „eine KI auf Ihren Daten trainieren“ beschreibt also schlecht, was tatsächlich passiert, und sollte vor der Unterschrift geklärt werden.
Was ist ein Token in der KI?
Ein Token ist die Texteinheit, die ein KI-Modell tatsächlich verarbeitet: ein kurzes Wort oder ein Fragment eines längeren Wortes. Die Modelle verfügen über ein Wörterbuch mit 100.000 bis 200.000 Fragmenten, und der Text wird vor der Verarbeitung nach diesem Wörterbuch zerlegt. Es ist die Abrechnungseinheit fast aller KI-Dienste, wobei getrennt gezählt wird, was Sie senden und was das Modell erzeugt. Ein französischer Text verbraucht etwa 14 % mehr Token als derselbe Text auf Englisch, weil die Wörterbücher überwiegend auf Englisch aufgebaut sind.
Warum kostet KI auf Französisch mehr als auf Englisch?
Weil die Token-Wörterbücher der großen Modelle überwiegend aus englischen Texten aufgebaut wurden. Häufige englische Wörter belegen dort ein einziges Token, während ihre französischen Entsprechungen oft aus mehreren Fragmenten zusammengesetzt werden müssen. Bei vergleichbarer Textlänge verbraucht Französisch etwa 14 % mehr Token als Englisch, und manche wenig vertretene Sprachen liegen über 40 %. Da pro Token abgerechnet wird, schlägt sich dieser Unterschied direkt auf Ihrer Rechnung nieder, ohne dass eine kommerzielle Verhandlung ihn beseitigen könnte.
Was bedeuten 8B, 70B oder 405B im Namen eines KI-Modells?
Diese Angaben bezeichnen die Anzahl der Parameter des Modells in Milliarden (englisch billions): 8B bedeutet acht Milliarden numerische Gewichte. Die Zahl gibt eine Größenordnung des Modells an, also seiner Betriebskosten, seiner Geschwindigkeit und der nötigen Hardwareleistung. Sie misst die Qualität nicht direkt: Seit 2023 übertrifft ein gut trainiertes Modell mit 8 Milliarden Parametern GPT-3 und seine 175 Milliarden bei den meisten Aufgaben. Ab einigen Dutzend Milliarden bringt jede Verzehnfachung der Größe nur noch wenige Leistungspunkte.
Was ist das Kontextfenster eines KI-Modells?
Das Kontextfenster ist die Textmenge, die ein Modell auf einmal lesen kann: Ihre Anweisungen, die angehängten Dokumente, den Gesprächsverlauf und Ihre Frage. Es wird in Token gemessen und reicht heute je nach Modell von 128.000 bis etwa einer Million. Zwei Grenzen machen es weniger nützlich, als es scheint: Je voller es ist, desto teurer wird jeder Austausch, weil der gesamte Inhalt in jeder Runde neu gelesen wird, und desto stärker sinkt die Präzision, da eine Information mitten in Hunderten von Seiten häufig übersehen wird.
Was ist der Unterschied zwischen Fine-Tuning und RAG?
Fine-Tuning justiert die Gewichte des Modells anhand Ihrer Beispiele nach und verändert sein Verhalten: Antwortformat, Ton, Fachjargon, Erfolgsquote bei einer bestimmten Aufgabe. RAG verändert das Modell nicht: Es findet die nützlichen Passagen in Ihren Dokumenten und liefert sie ihm im Moment der Frage. Damit eine KI Ihre internen Dokumente kennt, braucht es RAG. Damit sie immer auf eine bestimmte Weise antwortet, braucht es Fine-Tuning. Aus der Verwechslung der beiden stammt das Verkaufsversprechen „eine KI auf Ihren Daten trainieren“, das keines von beiden korrekt beschreibt.
Warum halluziniert KI?
Weil ein Sprachmodell keine Faktendatenbank konsultiert: Es erzeugt die wahrscheinlichste Fortsetzung auf Basis von Gewichten, die statistisch an Beispielen eingestellt wurden. Wenn ihm die Information fehlt, bringt es nichts in seiner Funktionsweise dazu, „Ich weiß es nicht“ zu antworten, statt einen plausiblen Inhalt zu erzeugen. Die Halluzination ist also strukturell und lässt sich nicht durch einen Patch beseitigen. Man kann sie reduzieren und erkennen: indem man im Moment der Frage die richtigen Dokumente bereitstellt, überprüfbare Quellenangaben verlangt und Zwischenergebnisse von deterministischer Software prüfen lässt.
Sollte man für ein KI-Projekt im Unternehmen das leistungsstärkste Modell wählen?
Nein, und das ist oft ein teurer Fehler. Der Preisunterschied zwischen einem kleinen und einem sehr großen Modell übersteigt den Faktor hundert pro Million generierter Token, obwohl viele Unternehmensaufgaben wie die Zusammenfassung von Protokollen oder die Klassifizierung von Nachrichten von einem kleinen Modell korrekt erledigt werden. Seit 2023 bestimmt die Größe allein nicht mehr die Qualität: Ein gut trainiertes Modell mit 8 Milliarden Parametern übertrifft GPT-3 und seine 175 Milliarden bei den meisten Aufgaben. Bewährt hat sich, jeder Aufgabe das passende Modell zuzuordnen, statt ein einziges für alles zu wählen.
Was sind LLMOps?
LLMOps bezeichnen die Gesamtheit der Praktiken, die nötig sind, um ein System auf Basis eines Sprachmodells in der Produktion zu betreiben: einen Satz von Fragen mit erwarteten Antworten aufbauen, um die Qualität zu testen, die gestellten Fragen, aufgerufenen Werkzeuge und genutzten Quellen protokollieren, die Kosten pro nützlicher Anfrage steuern und Modell oder Anbieter wechseln können, ohne die Anwendung neu zu schreiben. Diese Disziplin unterscheidet sich vom klassischen DevOps, weil ein Modell nicht deterministisch ist, weil Anbieter ihre Modelle regelmäßig abkündigen und weil die Qualität schleichend nachlässt, statt einen sichtbaren Ausfall zu verursachen.
Kann man garantieren, dass eine KI nie halluziniert?
Nein. Die Halluzination folgt aus der Funktionsweise von Sprachmodellen selbst, die eine wahrscheinliche Fortsetzung statt einer geprüften Tatsache erzeugen, und kein Anbieter kann sie vollständig beseitigen. Beherrschbar sind ihre Häufigkeit und ihre Erkennbarkeit: die relevanten Dokumente im Moment der Frage bereitstellen, überprüfbare Quellenangaben zu jeder Antwort verlangen, Zwischenergebnisse von deterministischer Software prüfen lassen und die Qualität laufend messen. Ein Verkaufsversprechen einer KI „ohne Halluzinationen“ zeugt von Unkenntnis des Produkts oder von sprachlicher Übertreibung.
Wie viele Schritte kann ein KI-Agent zuverlässig aneinanderreihen?
Die Zahl der Schritte wird durch die Verkettung der Erfolgsquoten begrenzt. Wenn jeder Schritt in 95 % der Fälle gelingt, gelingen zehn verkettete Schritte zusammen nur in etwa 60 % der Fälle, da 0,95 hoch 10 gleich 0,60 ist. Diese Rechnung vereinfacht, aber sie erklärt, warum zuverlässige Agenten nicht diejenigen sind, die die meisten Aktionen verketten: Es sind diejenigen, die ihre Zwischenergebnisse prüfen und das Modell nur dort einsetzen, wo deterministische Software nicht ausreichen würde.
Was kostet ein KI-Projekt nach dem POC?
Der POC macht in der Regel rund 20 % der Gesamtkosten des Projekts über seine Lebensdauer aus. Die übrigen 80 % verteilen sich auf die pro Token abgerechnete Inferenz, die Wartung des Systems rund um das Modell, die von den Anbietern erzwungenen Modellwechsel, die laufende Evaluierung der Antwortqualität und die Steuerung des Agentenverhaltens. Eine Kalkulation, die nur die Demonstrationsphase abdeckt, ist keine Projektkalkulation, und genau das ist der Hauptgrund, warum interne KI-Projekte nach achtzehn Monaten aufgegeben werden.
Fazit
Zehn Konzepte, und im Grunde eine einzige Idee: Darin steckt keine Magie.
Gewichte, die anhand von Beispielen eingestellt wurden. Text, der in Token zerlegt wird. Werkzeuge, die rundherum angeschlossen sind. Ihre Dokumente, im richtigen Moment auf den Schreibtisch gelegt. Und viel Engineering, damit das in der Produktion trägt.
Was Ihnen diese Begriffe geben, ist keine technische Kompetenz. Es ist die Fähigkeit, die drei oder vier Fragen zu stellen, die einen Dienstleister, der etwas weiß, von einem unterscheiden, der etwas aufsagt.
Wenn Sie ein Projekt vorbereiten und Ihren Use Case an diesen Abwägungen messen möchten: Demo buchen.