Hybrid Search: 6 Wege, eine Information zu finden
Hybrid Search erklärt: semantische Suche, Keywords, Fachtools, Datenbankabfrage, Katalog und Sonderverarbeitung. Die sechs Wege, die ein KI-Agent kombiniert.

Warum es Hybrid Search braucht, zeigt ein gewöhnlicher Dienstagmorgen in einem Unternehmen mit 300 Beschäftigten. Sechs Mitarbeitende suchen eine Information. Keiner sucht dasselbe, und keine ihrer Fragen lässt sich mit demselben Mechanismus lösen.
- „Darf ich drei Tage pro Woche im Homeoffice arbeiten?“
- „Wie ist der Stand der Bestellung von JP Dupont, Referenz XOD1132?“
- „Hat dieser Kunde gerade ein offenes Support-Ticket?“
- „Wie viele Bestellungen sind am Standort Lyon im Verzug?“
- „Wie viele Verträge liegen im Ordner Kunden 2026, und welche?“
- „Welche Optionen sind in der Produktreihe Horizon enthalten?“
Diese sechs Fragen scheinen sich zu ähneln. Technisch haben sie fast nichts gemeinsam: eine Bedeutung verstehen, eine exakte Zeichenkette wiederfinden, ein Drittsystem aufrufen, ein Ergebnis berechnen, eine Ordnerstruktur lesen. Die sechste entscheidet sich, wie wir sehen werden, nicht einmal im Moment der Frage.
Und dabei sind sie noch einfach, denn jede lässt sich über einen einzigen Weg lösen. Eine Führungskraft stellt dagegen Fragen, die mehrere kombinieren, in einer Reihenfolge, die man vorher nicht kennt.
Daher die Hybrid Search, die hybride Suche. Ein Assistent, der nur einen dieser Wege beherrscht, beantwortet nur einen Bruchteil der Fragen Ihrer Teams. Hier also die sechs Wege und danach das, was passiert, wenn man sie verketten muss.
1. Die Information steckt in einem Dokument: die semantische Suche
„Darf ich drei Tage pro Woche im Homeoffice arbeiten?“
Die Antwort existiert. Sie steht auf Seite 34 einer 60-seitigen Betriebsvereinbarung, in einem Absatz, der weder das Wort „drei“ noch das Wort „Homeoffice“ enthält, sondern die Formulierung „Regelungen zur mobilen Arbeit, begrenzt auf 60 % der monatlichen Arbeitszeit“.
Keine Suche nach exakten Wörtern wird diese Stelle finden. Die semantische Suche findet sie, weil sie Bedeutung statt Wörter vergleicht: Die Dokumente werden zerlegt und in Vektoren umgewandelt, und die Frage durchläuft dieselbe Umwandlung. Das ist das Prinzip der dichten Suche, beschrieben von Karpukhin et al. 2020, die damals ein gut eingestelltes BM25 auf mehreren Frage-Antwort-Datensätzen schlug. Zwei Formulierungen, die dasselbe meinen, liegen in diesem Raum nah beieinander.
Das ist der Grundbaustein von RAG: Der Artikel von Lewis et al., der RAG eingeführt hat, stützte sich bereits auf einen Vektorindex. Es ist auch der Baustein, den alle zuerst anschließen. Zu Recht, er ist spektakulär. Das Problem beginnt, wenn man dort stehen bleibt.
2. Die Information steckt in einem Namen oder einer Referenz: die Keyword-Suche
„Wie ist der Stand der Bestellung von JP Dupont, Referenz XOD1132?“
XOD1132 ist ein Schlüssel, kein Konzept. Ebenso JP Dupont, Projekt Atlas oder PRD-19-B. Diese Zeichenketten haben keine semantische Nachbarschaft: Ein Embedding-Modell weiß nicht, dass XOD1132 näher an XOD1133 liegt als an der Urlaubsregelung, und es hat keinen Grund, das zu wissen.
Bei dieser Art von Anfrage liefert die reine Vektorsuche plausibles Rauschen. Anthropic kommt zum selben Befund: Ein Embedding-Modell kann den exakten Treffer verfehlen, etwa bei einem Code wie „TS-999“. Es braucht eine lexikalische Suche wie das von Robertson und Zaragoza formalisierte BM25, das die exakte Zeichenkette dort findet, wo sie vorkommt.
Ihre Teams verwenden dieses Vokabular jedoch den ganzen Tag. Ein Unternehmen spricht weit mehr in Kundenreferenzen, Projektcodes und hauseigenen Abkürzungen als in Konzepten. Deshalb zählen wir „alles vektoriell“ zu den Fehlern, die ein RAG nach dem POC einholen: Die Demo läuft, die Produktion bricht.
Die semantische Suche findet, was Sie gemeint haben. Die Keyword-Suche findet, was Sie geschrieben haben. Sie brauchen beide.
Bleibt, zwei Ergebnislisten zusammenzuführen, deren Scores sich nicht vergleichen lassen: Das ist die Aufgabe von RRF-Fusion und Reranking. Die RRF-Fusion, 2009 von Cormack, Clarke und Büttcher vorgeschlagen, ordnet jedes Dokument nach seinem Rang in jeder Liste statt nach seinem Score.
3. Die Information steht in keinem Dokument: das an die IT-Systeme angebundene Tool
„Hat dieser Kunde gerade ein offenes Support-Ticket?“
Hier helfen weder Bedeutung noch Keywords: Die Information existiert in keinem Dokument. Sie lebt im Ticketsystem, im CRM, im ERP. Und da sie sich stündlich ändert, wäre es ohnehin keine gute Idee, sie zu indexieren.
Man muss also das System aufrufen, das die Daten hält, im Moment der Frage. Über einen MCP-Server, wenn der Hersteller einen bereitstellt, oder über ein maßgeschneidertes Tool, wenn eine interne API angebunden werden muss. Das MCP-Protokoll, im November 2024 von Anthropic veröffentlicht, hat diese Anbindung deutlich günstiger gemacht als noch vor zwei Jahren.
4. Die Information existiert noch nicht, sie wird berechnet: die Datenbankabfrage
„Wie viele Bestellungen sind am Standort Lyon im Verzug, und welche Kunden sind betroffen?“
Diese Antwort steht nirgendwo geschrieben. Sie wird berechnet, indem man Bestellpositionen, zugesagte Termine und einen Standortcode verknüpft.
Das ist die Aufgabe eines Tools für die Datenbankabfrage: Der Assistent übersetzt die Frage in eine SQL-Abfrage, führt sie lesend auf einem freigegebenen Bereich aus und gibt das Ergebnis zurück. Ihre verlässlichsten und aktuellsten Daten liegen oft dort, in strukturierten Datenbanken, die niemand abfragt, weil man dafür ein Ticket beim Datenteam aufmachen muss. Diesen Punkt haben wir in Ihre Datenbanken sind eine Goldmine ausgeführt.
5. Die Frage betrifft die Dokumente selbst: der Dokumentenkatalog
„Wie viele Verträge liegen im Ordner Kunden 2026, und welche?“
Eine Fangfrage für ein klassisches RAG. Eine semantische Suche liefert zehn Passagen, die von Verträgen handeln, ohne sie zählen zu können oder zu garantieren, dass sie alles gesehen hat. Bei einer Bestandsfrage ist ein System, das „etwa fünfzehn“ antwortet, schlechter als eines, das gar nicht antwortet.
Die Frage betrifft den Dokumentenbestand selbst: seine Ordnerstruktur, seine Pfade, seine Quellen, seine Datumsangaben. Es braucht ein Tool, das den Katalog deterministisch abfragt, nicht den Text.
Genau das leistet unsere Abfrage des Dokumentenkatalogs. Sie beantwortet „wie viele“, „liste die Unterordner von“ oder „welche Dokumente stammen aus diesem SharePoint“, und sie dient auch dazu, eine bestimmte Datei zu lokalisieren, bevor ihr Inhalt gelesen wird.
6. Die Information ist da, aber unlesbar: die maßgeschneiderte Verarbeitung
„Welche Optionen sind in der Produktreihe Horizon enthalten?“
Die Antwort steht in einer Datei, die Sie bereits indexiert haben. Sie steht in einer Tabelle mit 40 Spalten, in der jede Zeile eine Referenz und jede Spalte eine Option ist, mit Kreuzen, verbundenen Zellen und drei Kopfzeilen. Oder in einem Aufstellungsplan, oder in einem aus dem ERP exportierten Produktkatalog.
Keine der fünf bisherigen Methoden rettet diese Datei. Wie ein gewöhnliches Dokument in Textstücke zerlegt, erzeugt eine Tabelle Chunks wie Horizon ; X ; ; X ; 2 ; ; ja. Syntaktisch ist das Text, semantisch Rauschen. Die Passage wird vielleicht gefunden, bedeutet aber nichts, weder für das Modell noch für den Nutzer, der das Zitat liest.
Dieser sechste Weg ist anderer Natur: Er macht durchsuchbar, was es vorher nicht war. Er greift bei der Indexierung ein, nicht im Moment der Frage.
Konkret verbindet unsere maßgeschneiderte Verarbeitung ein Auslösekriterium (ein Dateityp, ein Muster im Namen, eine erkennbare Struktur) mit Extraktionsregeln, die für genau dieses Format geschrieben sind: was jede Spalte bedeutet, welche Zeilen Summen sind, welche Einheit gilt. Die Datei geht als Tabelle hinein und kommt als nutzbares Wissen heraus, mit ihren Zitaten.
Wir wenden bewusst keine generische Verarbeitung auf alle Excel-Dateien an. Eine Tabelle ohne ihren fachlichen Kontext bleibt Rohdaten: Ist die Spalte „Betrag“ in Euro oder in Dollar, ist der „Status“ der der Bestellung oder des Projekts? Ein automatisches Parsing erzeugt Rauschen, das wie eine Antwort aussieht, und das ist das schlechteste mögliche Ergebnis.
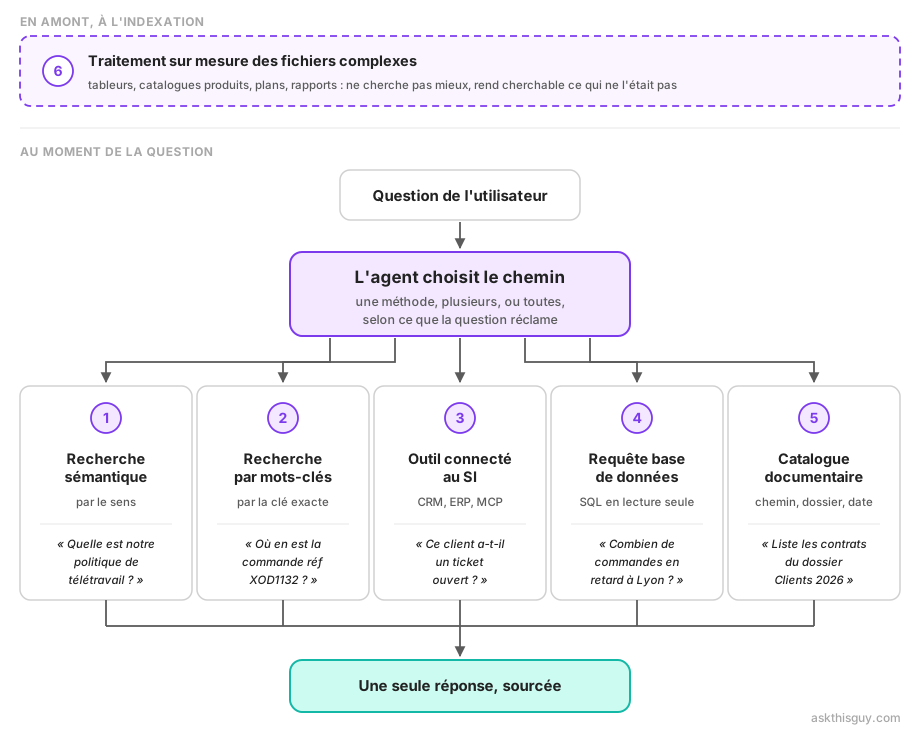
Schema der sechs komplementären Wege, eine Information zu finden: vorgelagert, bei der Indexierung, die maßgeschneiderte Verarbeitung komplexer Dateien; dann, im Moment der Frage, die semantische Suche, die Keyword-Suche, das an die IT-Systeme angebundene Tool, die Datenbankabfrage und die Abfrage des Dokumentenkatalogs, die ein und derselbe Agent einsetzt, um eine einzige Antwort mit Quellenangaben zu erzeugen
Wenn eine einzige Frage mehrere Wege verlangt
Unsere sechs Beispiele haben einen Mangel: Sie sind zu sauber. Jedes zeigt fast von allein auf seinen Weg.
Ein Betriebsleiter fragt eher so:
„Halten wir dieses Jahr unsere Zusagen gegenüber Durand ein?“
Nichts in diesem Satz sagt, wo zu suchen ist, welche Zusagen gemeint sind oder für welchen Zeitraum. Keiner der sechs Wege genügt, und man kann nicht im Voraus festlegen, in welcher Reihenfolge sie zu gehen sind.
Der Assistent muss zuerst finden, was die Zusage konkret festhält: einen Vertrag, einen Nachtrag, eine Service-Vereinbarung. Weg 1, dazu Weg 5, wenn die richtige Datei in der richtigen Ordnerstruktur gefunden werden muss. Dort liest er die Schwellen, Reaktionszeit, Zahl der inbegriffenen Einsätze, Verfügbarkeitsquote. Und erfährt nebenbei, dass der Zeitraum dem Kalenderjahr folgt, nicht zwölf rollierenden Monaten.
Erst dann weiß er, was er das Ticketsystem fragen muss. Weg 3 wird ausgelöst, mit einem Filter, den er gerade im Vertrag entdeckt hat. Liegen die Mengen eher in einer Datenbank als im Ticketsystem, ist es Weg 4. Dann vergleicht er und antwortet.
Die zweite Abfrage ließ sich nicht formulieren, bevor das Ergebnis der ersten gelesen war. Ein Agent führt eine Recherche, wo eine einfache Weiche nur weiterleitet: Er bewertet, was er erhält, und entscheidet, ob er genug weiß, um zu antworten, oder ob er weitersuchen muss. Das Prinzip erklären wir in unserem Artikel über agentisches RAG.
Zwei Konsequenzen, die man meist zu spät entdeckt. Erstens muss man aufhören können: Eine Recherche kostet Zeit und Token, und ohne Grenze für die Zahl der Durchläufe wird das System langsam und teuer, also unbrauchbar, selbst wenn seine Antworten gut sind. Zweitens muss man nachverfolgen. Wenn eine Antwort aus vier Aufrufen an drei Quellen entsteht, muss der Nutzer prüfen können, woher jedes Element stammt. Ohne Quellenangaben vertraut niemand, und eine Antwort, der man nicht traut, ist nutzlos.
Was Sie heute vermutlich haben
Der Test ist einfach: die sechs Fragen vom Anfang dem Assistenten stellen, den Sie bereits nutzen.
Mit Copilot sind Sie bei den Fragen 1, 2 und 5 gut bedient, solange die Information in Microsoft 365 liegt: Die Lizenz für Microsoft 365 Copilot stützt ihre Antworten auf Microsoft Graph (E-Mails, Dateien, Besprechungen). Darüber hinaus müssen Copilot-Konnektoren, indexiert oder live abgefragt, Quelle für Quelle konfiguriert werden. Ohne sie endet es an der Grenze Ihrer Fachsysteme und Datenbanken: Die Fragen 3 und 4 bleiben unbeantwortet oder liefern eine Annäherung. Und Ihre ungewöhnlichen Fachdateien werden wie gewöhnliche Dateien behandelt.
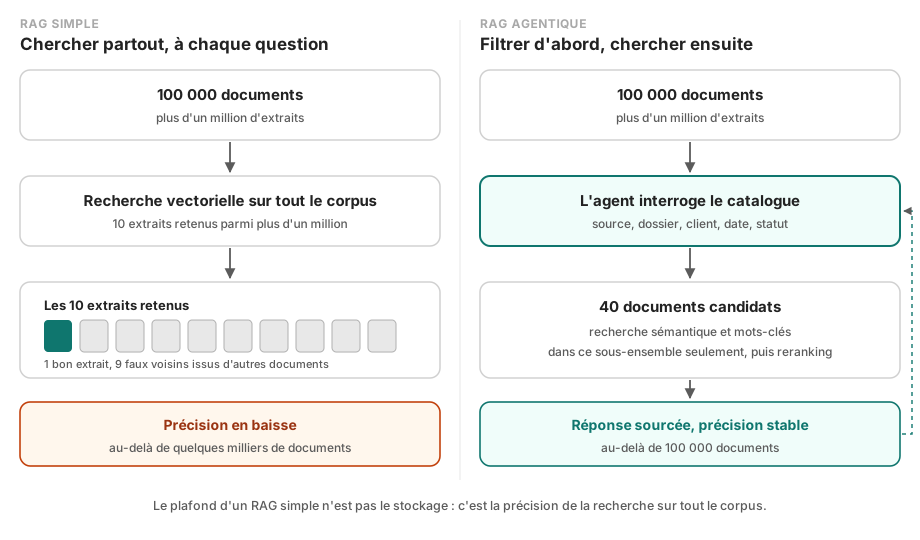
Mit einem intern entwickelten RAG haben Sie fast sicher die 1, manchmal die 2. Das ist der naheliegende Weg, die Vektorsuche ist das, was man zuerst anschließt und was eine schöne Demo ergibt. Die anderen Wege erfordern Integrationen, Zugriffsrechte und Betrieb, also Arbeit nach dem POC. Das ist auch der Grund, warum es bei einigen Tausend Dokumenten an seine Grenze stößt.
Mit einer klassischen Enterprise-Suchmaschine haben Sie die 2 und die 5, mit Filtern. Das ist schnell und solide, aber man muss wissen, was man eintippt. Niemand findet die Homeoffice-Regelung mit der Suche nach „Homeoffice“, wenn im Dokument „mobile Arbeit“ steht.
Keines dieser Tools ist schlecht, das möchten wir betonen. Sie decken einen Teil des Bedarfs ab, und zwar ordentlich. Das Problem ist, dass Ihre Teams den anderen Teil entdecken, indem sie dagegen laufen, Frage für Frage, und dass sie schnell aufhören zu fragen.
Der Ansatz von Ask This Guy
Wir haben das Problem vom anderen Ende her angepackt. Statt eine Suchmethode zu optimieren, haben wir fünf verdrahtet, dazu eine sechste, die das Terrain vorbereitet, und einen Agenten darübergesetzt.
Er entscheidet. Er formuliert die Frage um, wählt den oder die Wege, liest, was er erhält, und beurteilt, ob er genug weiß. Wenn nicht, startet er neu, gezielter, mit dem, was er gerade gelernt hat. Im Fall Durand oben verkettet er Dokumente und dann Ticketsystem, ohne dass ihm jemand die Reihenfolge vorgegeben hat. Und wenn der Vertrag in einer hauseigenen Tracking-Tabelle lebt, hat ihm die einmal konfigurierte maßgeschneiderte Verarbeitung ermöglicht, ihn korrekt zu lesen.
Die Dokumentation beschreibt die Mechanik im Detail. Jedes Element der Antwort verweist auf seine Quelle, egal über welchen Weg es gefunden wurde.
Auf Nutzerseite muss man von alldem nichts wissen. Man stellt seine Frage in ganz normalen Worten. Das ist das Mindeste: Von einem Vertriebsmitarbeiter zu verlangen, vor dem Eintippen zwischen „semantischer Suche“ und „SQL-Abfrage“ zu wählen, hieße, ihm ein Engineering-Problem zuzuschieben.
Häufige Fragen zu Hybrid Search
Was ist Hybrid Search?
Hybrid Search (hybride Suche) kombiniert mehrere komplementäre Suchmethoden statt nur einer. Im engen Sinn verbindet sie die semantische Suche (nach Bedeutung, über Embeddings) mit der Keyword-Suche (nach exakter Übereinstimmung). Im weiteren Sinn umfasst sie auch den Aufruf von Fachtools, die Datenbankabfrage und die Abfrage des Dokumentenkatalogs, um Fragen abzudecken, deren Antwort in keinem Dokument steht. Hinzu kommt ein vorgelagerter Weg: die maßgeschneiderte Verarbeitung komplexer Dateien, die Tabellen oder Kataloge nutzbar macht, die eine klassische Zerlegung in Rauschen verwandeln würde.
Semantische Suche vs. Keyword-Suche: Was ist der Unterschied?
Die semantische Suche vergleicht Bedeutung: Sie findet „Regelungen zur mobilen Arbeit“ auf die Frage „Darf ich im Homeoffice arbeiten?“. Die Keyword-Suche vergleicht Zeichenketten: Sie findet die exakte Referenz XOD1132 oder den Namen JP Dupont, die die semantische Suche verfehlt, weil diese Zeichenketten keine eigene Bedeutung haben. Beide sind nötig, denn ein Unternehmen hantiert ebenso mit Konzepten wie mit internen Referenzen.
Warum genügt die Vektorsuche allein nicht?
Weil ein großer Teil der Fragen im Unternehmen Kennungen ohne semantischen Wert betrifft (Produktreferenzen, Projektcodes, Kundennamen), lebendige Daten in den IT-Systemen, Zahlen, die in der Datenbank berechnet werden müssen, oder die Struktur des Dokumentenbestands selbst. Sie scheitert auch an Dateien, deren Struktur die Bedeutung trägt, etwa Tabellen, die eine Zerlegung in Text auf Zellfolgen reduziert. Keiner dieser Fälle wird von der Vektornähe korrekt behandelt, und doch ist sie in vielen RAG-Projekten der einzige Mechanismus.
Woher weiß ein Assistent, welche Suchmethode er nutzen soll?
Der Agent entscheidet, anhand der Formulierung der Frage und der Beschreibung der Tools, über die er verfügt. Eine konzeptuelle Frage löst eine semantische Suche aus, eine explizite Referenz eine Keyword-Suche, eine Zählfrage eine Abfrage des Katalogs. Bei komplexen Fragen verkettet er mehrere, nutzt das Ergebnis der ersten, um die nächste zu formulieren, bis er meint, genug zu wissen, um zu antworten.
Warum wird eine Excel-Datei von einem klassischen RAG schlecht genutzt?
Weil in einer Tabelle die Bedeutung ebenso von der Struktur getragen wird wie vom Text. Eine Zelle bedeutet nichts ohne ihre Spaltenüberschrift, ihre Einheit und ihre Bezugszeile. Eine Zerlegung in Textstücke, die bei einem Vertrag oder einem Verfahren gut funktioniert, erzeugt hier Wertefolgen ohne Kontext. Es braucht eine formatgerechte Verarbeitung, die vor der Indexierung rekonstruiert, was jede Spalte bedeutet.
Fazit
Die einfache Frage kann jeder beantworten, die, deren Antwort in einem gut geschriebenen Absatz eines gut abgelegten Dokuments steht. Ein Assistent muss sich an den fünf anderen messen lassen: an denen, bei denen die Information woanders liegt, noch nicht als Text existiert oder in einer Datei schlummert, die niemand lesbar gemacht hat.
Wenn Sie sehen möchten, was Ihre eigenen Fragen ergeben, die Ihre Teams wirklich stellen, buchen Sie eine Demo: Wir gehen von Ihren tatsächlichen Quellen aus. Einzelheiten zum Ansatz stehen auf der Seite RAG für Unternehmen, schlüsselfertig, die Abfrage Ihrer Datenbanken auf Talk to Data.