Wie viele Dokumente schafft ein RAG? Agentic RAG skaliert
Ein selbst gebautes RAG stößt bei einigen Tausend Dokumenten pro Agent an Grenzen, bei ähnlichen früher. Agentic RAG filtert zuerst und schafft über 100.000.

Wie viele Dokumente kann ein RAG verarbeiten? Das hängt von seiner Architektur ab. Ein einfaches RAG, wie man es intern mit einer Vektordatenbank und einer Suche über den gesamten Korpus aufbaut, bleibt bis zu einigen Hundert, bestenfalls einigen Tausend Dokumenten pro Agent zuverlässig. Darüber hält der Speicher stand, aber die Präzision der Suche bricht ein. Und die Schwelle sinkt weiter, wenn die Dokumente einander ähneln: Einige Hundert Verträge, die nach derselben Vorlage für verschiedene Kunden erstellt wurden, reichen aus, um ein einfaches RAG aus dem Tritt zu bringen. Ein Agentic RAG, das den Korpus filtert, bevor es die Vektorsuche startet, verkraftet mehr als 100.000 Dokumente. Bei mehreren unserer Kunden arbeiten die ATG-Agenten in der Produktion mit mehr als 100.000 Dokumenten, also mehr als einer Million Seiten.
Beide Zahlen kursieren, und beide stimmen. Sie beschreiben zwei verschiedene Systeme.
Woher kommt die Zahl von „einigen Hundert Dokumenten“?
Sie hat zwei Ursprünge, und keiner sagt viel über die RAG-Technologie selbst aus.
Der erste sind die Obergrenzen der Tools für Endverbraucher. Wer sucht, „wie viele Dokumente man einer KI geben kann“, stößt auf die Limits, die die allgemein bekannten Produkte angeben. Im Oktober 2026 akzeptiert NotebookLM in der kostenlosen Version 50 Quellen pro Notizbuch und in den kostenpflichtigen Angeboten einige Hundert. ChatGPT-Projekte und Custom GPTs akzeptieren je nach Abonnement einige Dutzend Dateien. Das sind Produktentscheidungen, zugeschnitten auf eine Person, die an einem Vorgang arbeitet.
Der zweite sind die Erfahrungsberichte zu selbst gebauten RAG-Systemen. Das klassische Tutorial (Dokumente zerlegen, Embeddings berechnen, die zehn ähnlichsten Auszüge suchen, sie dem Modell übergeben) liefert bei fünfzig Dokumenten eine verblüffende Demo. Dann fügen die Teams Dateien hinzu, und die Qualität sinkt, ohne dass etwas kaputtgeht. Daraus entsteht ein empirischer Konsens: „Ab einigen Tausend Dokumenten funktioniert es nicht mehr richtig.“
Dieser Konsens stimmt, für genau diese Architektur.
Warum ein einfaches RAG mit wachsendem Korpus an Präzision verliert
Ein einfaches RAG funktioniert so: Die Frage wird in einen Vektor umgewandelt, das System sucht im gesamten Korpus die Auszüge mit dem ähnlichsten Vektor, behält eine feste Anzahl davon (oft zwischen 5 und 20), und das Modell antwortet nur auf Basis dieser Auszüge.
Bei 50 Dokumenten ist das trivial. Bei einer Million Seiten muss derselbe Mechanismus zehn Auszüge aus mehr als einer Million auswählen. Jedes hinzugefügte Dokument bringt seine Passagen mit, die ungefähr vom Thema der Frage handeln, ohne sie zu beantworten, und am Ende belegen sie die zehn Plätze.
Alte Versionen verschärfen das Problem. Je größer die Datenbank, desto mehr Entwürfe und Kopien enthält sie. Die Verfahrensanweisung von 2022 und die von 2026 ähneln sich stark, und das System hat keinen Grund, die richtige vorzuziehen.
Eigennamen ebenso. Ein Kundenname, eine Produktreferenz oder ein Projektcode ist oft das einzige Wort, das in einer Frage zählt, und genau das bildet ein Embedding am schlechtesten ab: Es sind Schlüssel ohne allgemeine Bedeutung. Wir haben das in unserem Artikel über die hybride Suche ausgeführt.
Das Ergebnis ist tückisch: Der Assistent antwortet weiterhin selbstsicher und nennt Quellen. Nur immer seltener die richtige.
Ähnliche Dokumente: der schlimmste Fall für ein einfaches RAG
Aus unserer Sicht ist das der am meisten missverstandene Punkt des Themas. Man spricht über Volumen und vergisst die Ähnlichkeit. Zwei gleich große Korpora können sich jedoch völlig gegensätzlich verhalten.
Nehmen Sie 5.000 heterogene Dokumente: Betriebsordnung, Produktdatenblätter, Qualitätsverfahren, juristische Notizen. Eine Frage zum Urlaub landet ganz natürlich bei den HR-Dokumenten, weil sich ihre Bedeutung von allem anderen abhebt. Das einfache RAG schlägt sich recht gut.
Nehmen Sie nun 500 Kundenverträge, die nach derselben Vorlage verfasst wurden. Ein Vertriebsmitarbeiter fragt: „Wie lang ist die Kündigungsfrist im Vertrag Müller?“ Alle 500 Verträge haben eine Kündigungsklausel, fast wortgleich. Für die Vektorsuche sind das 500 gleichwertige Passagen. Was sie unterscheidet, ist ein einziges Wort, Müller, und genau das erfasst sie am schlechtesten. Die zehn ausgewählten Auszüge stammen von zehn zufälligen Kunden, und das Reranking ändert daran nichts: Es sortiert die Auszüge neu, die man ihm gibt, und der richtige ist wahrscheinlich nicht darunter.
Je ähnlicher die Dokumente einander sind, desto schlechter funktioniert ein einfaches RAG, und desto früher. Die Obergrenze von „einigen Tausend“ sinkt dann auf einige Hundert.
Dieser Fall ist alles andere als eine Randerscheinung. Verträge, Prüfberichte, Due-Diligence-Unterlagen, Besuchsberichte, Antworten auf Ausschreibungen: Das ist der Alltag von Beratungsgesellschaften, Wirtschaftsprüfern und Anwaltskanzleien, von M&A-Teams, Versicherern und Ingenieurbüros. Diese Branchen erstellen dieselbe Art von Arbeitsergebnis für Dutzende oder Hunderte von Kunden, und genau diese Dokumente sind für sie am wertvollsten. Ein Due-Diligence-Datenraum ist das Paradebeispiel: drei Jahresabschlüsse, mehrere Versionen eines Vertrags, ein Abschlusspaket pro Tochtergesellschaft, und es ist die Suche nach dem richtigen Dokument, mehr als das Modell, die über die Präzision einer KI entscheidet.
Die Lösung besteht darin, den Kundennamen als Filter zu behandeln, der vor jeder Bedeutungssuche angewendet wird, und nicht als Wort, das in einem Vektor untergeht. Das ist das Prinzip von Agentic RAG.
Was die Forschung über die Skalierung sagt
Eine im Juli 2026 veröffentlichte Studie, BM25 Wins at Scale, hat mehrere RAG-Architekturen an einem schrittweise vergrößerten Korpus gemessen, über einen Faktor von 450, mit denselben Fragen von Anfang bis Ende. Zwei Ergebnisse interessieren uns.
Die reine Vektorsuche bleibt schnell, verliert aber bei wachsendem Korpus an Genauigkeit gegenüber der Stichwortsuche. Man findet die oben beschriebenen Passagen wieder, die „ungefähr zum Thema“ passen.
Ein Agent, der die Dateien ohne Index durchsucht, wie jemand, der die Ordner einen nach dem anderen öffnet, ist bei einem kleinen Korpus hervorragend und bricht im großen Maßstab ein: Er verbraucht 39-mal mehr Token und landet fast 20 Punkte zurück. Die Autoren folgern, dass agentisches Reasoning sein Bestes nach einer ersten gerankten Suche gibt.
Es braucht also beides: Indizes, die schnell finden, und einen Agenten, der über das Gefundene nachdenkt.
Agentic RAG: filtern, bevor man sucht
Ein Dokumentar, den man nach der Kündigungsfrist im Vertrag Müller fragt, liest nicht alle 500 Verträge. Er geht in den Ordner Kunden, öffnet den Unterordner Müller, nimmt die neueste Version des Vertrags und sucht die Klausel.
Ein Agentic RAG macht dasselbe. Vor jeder Vektorsuche grenzt der Agent den Suchraum ein.
- Er versteht, worauf sich die Frage bezieht: ein bestimmtes Dokument (den Vertrag), einen Kunden (Müller), einen Begriff (die Kündigungsfrist).
- Er fragt den Dokumentenkatalog ab. Quellen, Ordner, Pfade, Daten, Status: Der Katalog antwortet deterministisch, ohne semantische Annäherung. Der Suchraum schrumpft von 100.000 Dokumenten auf eine Handvoll.
- Er sucht nur in dieser Teilmenge, indem er semantische Suche und Stichwortsuche kombiniert, und sortiert die Auszüge dann per Reranking. Die 499 anderen Kündigungsklauseln sind nicht einmal mehr Kandidaten.
- Er prüft. Reichen die Auszüge nicht aus, liest er das Dokument vollständig oder sucht mit dem, was er gerade erfahren hat, erneut.
Die Vektorsuche wählt nicht mehr zehn Auszüge aus einer Million aus, sondern aus einigen Hundert, wo sie sehr zuverlässig ist. Die Gesamtgröße des Korpus ist nicht mehr der begrenzende Faktor, da sich die Feinsuche nie auf den gesamten Korpus erstreckt.
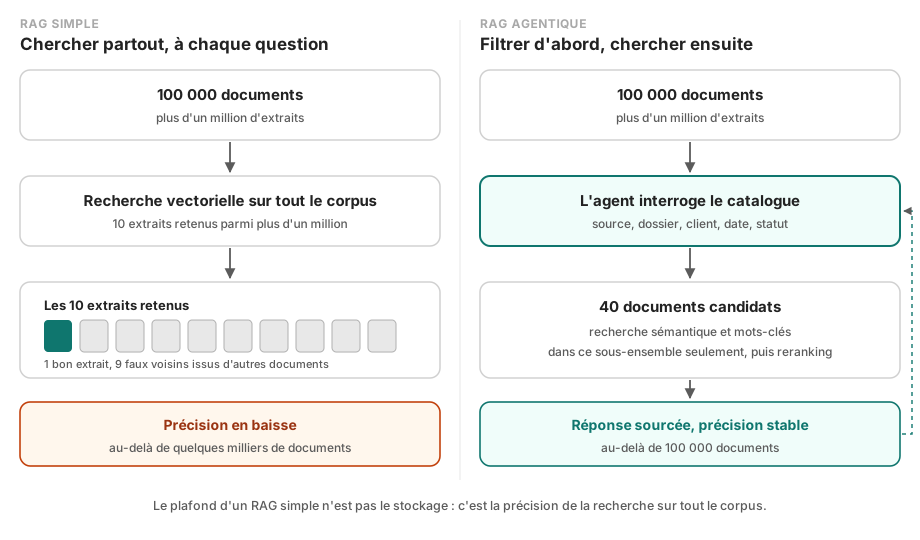
Schema, das zwei RAG-Architekturen bei 100.000 Dokumenten vergleicht. Links startet das einfache RAG eine Vektorsuche über den gesamten Korpus und behält zehn Auszüge, darunter viele falsche Nachbarn aus anderen Dokumenten. Rechts fragt das Agentic RAG zuerst den Dokumentenkatalog ab, um den Suchraum auf rund vierzig Dokumente einzugrenzen, startet dann in dieser Teilmenge eine hybride Suche mit Reranking und liefert eine Antwort mit Quellenangaben.
Einfaches RAG oder Agentic RAG: der Vergleich
| Einfaches RAG | Agentic RAG mit Filterung | |
|---|---|---|
| Zuverlässiges Volumen pro Agent | Einige Hundert bis einige Tausend Dokumente | Mehr als 100.000 Dokumente, mehr als eine Million Seiten |
| Suchraum | Der gesamte Korpus, bei jeder Frage | Vom Agenten gewählte Teilmenge |
| Gleichartige Dokumente für verschiedene Kunden | Der schlimmste Fall: versagt schon ab einigen Hundert | Der Kunde wird zum Filter, angewendet vor der Suche |
| Eigennamen und Referenzen | Schlecht gefunden | Über Stichwörter und den Katalog gefunden |
| Bestandsfragen („Wie viele Verträge …“) | Ungefähre oder falsche Antwort | Exakte Antwort, aus dem Katalog |
| Konkurrierende Versionen | Vermischt | Nach Datum, Status oder Ordner entschieden |
| Antwortzeit | Einige Sekunden | Einige Sekunden mehr, je nach Anzahl der Durchläufe |
Agentic RAG hat seinen Preis. Jeder Schritt verbraucht Token und Zeit, und ein Agent ohne Leitplanken kann sich im Kreis drehen. Die Zahl der Durchläufe muss begrenzt und jede Quelle protokolliert werden, sonst wird das System langsam und seine Antworten unüberprüfbar.
In mehrere Agenten aufteilen: eine Scheinlösung
Wenn ein einfaches RAG an seine Grenzen stößt, ist der Reflex, einen Agenten pro Abteilung, dann pro Thema, ja pro Kunde anzulegen, um jeden Korpus unter der Marke von einigen Tausend Dokumenten zu halten. Daher stammt die Vorstellung einer Grenze „pro Agent“.
Das funktioniert, aber die Last verlagert sich auf den Nutzer: Er muss wissen, welchen Agenten er fragen soll. Die Frage „Halten wir unsere Zusagen gegenüber Müller ein?“ betrifft zugleich Verträge, Support und Abrechnung, und drei abgeschottete Agenten können sie nicht beantworten. Und ein Agent pro Kunde wird bei 300 Kunden schnell unbeherrschbar.
Es gibt gute Gründe, Agenten zu trennen, und sie haben mit Zugriffsrechten zu tun: Ein HR-Agent hat in Kundenverträgen nichts zu suchen. Bei ATG wird dieser Bereich über die Wissenskategorien (auf Englisch) geregelt, die jedem Agenten zugewiesen werden.
Was es braucht, um 100.000 Dokumente in der Produktion zu bewältigen
Die agentische Architektur hebt die Präzisionsgrenze auf. In dieser Größenordnung tauchen andere Themen auf, und man kennt sie besser vorher.
Die Ingestion wird zum Industrieprojekt. Eine Million Seiten, das sind gescannte PDFs, Tabellen, Präsentationen und eine OCR-Rechnung, die alles andere als nebensächlich ist. Den Unterschied zwischen einer API und einem Open-Weight-Modell bei einer Million Seiten haben wir in unserem Vergleich von Mistral OCR und PaddleOCR beziffert: von 4.000 $ auf weniger als 200 $.
Die Filterung ist nur so gut wie die Metadaten. Der Agent stützt sich auf das, was der Katalog weiß: Quelle, Ordner, Datum, Autor, Status. Eine konsistente SharePoint-Ordnerstruktur hilft ihm weit mehr als ein Ordner „Sonstiges“ mit 40.000 Dateien.
Die Synchronisierung muss inkrementell sein. Man indiziert nicht jede Nacht eine Million Seiten neu, sondern nur die geänderten Dokumente.
Die Qualität misst man an echten Fragen. Ein RAG mit 100.000 Dokumenten lässt sich nicht mit zehn Fragen in einer Sitzung validieren. Es braucht Hunderte repräsentativer Fragen, darunter Fangfragen: ein bestimmtes Dokument unter Tausenden ähnlicher, eine interne Referenz, eine Bestandsfrage.
Wie man die Skalierbarkeit einer RAG-Lösung vor dem Kauf testet
Ein Anbieter, der „unbegrenzt“ verspricht, sagt gar nichts. Vier Tests genügen, um die Lösungen zu unterscheiden, und wir würden sie jedem stellen, uns eingeschlossen.
- Fragen Sie nach dem Volumen in der Produktion, nicht in der Demo: wie viele Dokumente und Seiten bei einem echten Kunden, und auf wie viele Agenten verteilt.
- Suchen Sie eine Nadel unter Zwillingsdokumenten. Wählen Sie ein Dokument, das unter Hunderten gleichartiger Dokumente verborgen ist (der Vertrag eines Kunden unter allen Verträgen, ein Prüfbericht unter allen Berichten), und stellen Sie eine Frage, deren Antwort nur in diesem einen steht. Das ist der aussagekräftigste Test.
- Stellen Sie eine Frage mit einem Eigennamen oder einer internen Referenz, die die semantische Suche allein schlecht findet.
- Stellen Sie eine Bestandsfrage wie „Wie viele Verträge wurden 2025 unterschrieben?“. Eine ungefähre Antwort verrät eine Suche ohne Katalog.
Der Ansatz von Ask This Guy
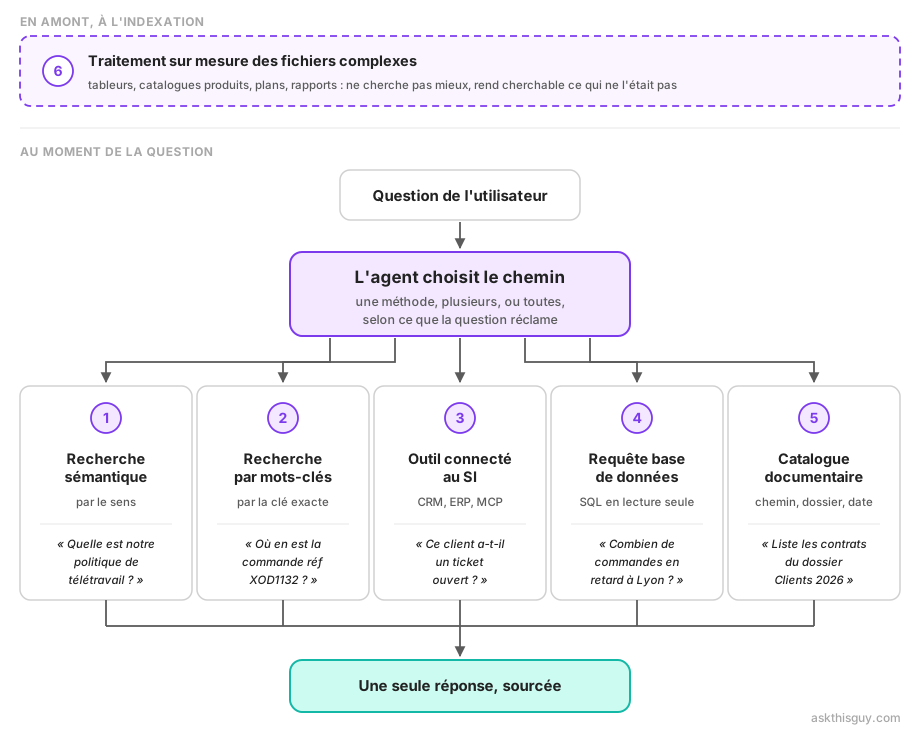
Bei Ask This Guy steuert der Agent die Suche. Er verfügt über mehrere sich ergänzende Werkzeuge: den Dokumentenkatalog (auf Englisch), um Dokumente zu verorten und zu zählen, die Suche nach relevanten Dokumenten, um eine Datei zu identifizieren, die hybride Suche (semantisch und per Stichwort), um die Passage zu finden, das Reranking, um die besten Auszüge zu behalten, und das vollständige Lesen, wenn ein Auszug nicht ausreicht.
So verbinden unsere Kunden mehr als 100.000 Dokumente, also mehr als eine Million Seiten, mit einem einzigen Agenten, ohne ihre Datenbank aufzuteilen, um unter einer Schwelle zu bleiben. Die Antworten nennen ihre Quellen, unabhängig von der Größe des Korpus.
Wenn Ihr Projekt an der Datenmenge scheitert, lernen Sie unser schlüsselfertiges Unternehmens-RAG kennen oder buchen Sie eine Demo, um es mit Ihren eigenen Dokumenten zu testen.
Häufige Fragen zur Anzahl der Dokumente in einem RAG
Wie viele Dokumente kann ein RAG verarbeiten?
Das hängt von seiner Architektur ab. Ein einfaches RAG, das bei jeder Frage eine Vektorsuche über den gesamten Korpus startet, bleibt bis zu einigen Hundert oder einigen Tausend Dokumenten pro Agent zuverlässig, und bei ähnlichen Dokumenten noch weniger. Ein Agentic RAG, das den Korpus filtert, bevor es sucht, verarbeitet mehr als 100.000 Dokumente, also mehr als eine Million Seiten: Dieses Volumen bewältigen Agenten von Ask This Guy in der Produktion. Die Grenze liegt in der Präzision der Suche; der Speicher hält problemlos mit.
Warum verliert ein RAG an Präzision, wenn die Zahl der Dokumente steigt?
Weil ein einfaches RAG eine feste Anzahl von Auszügen, oft zehn, aus dem gesamten Korpus auswählt. Je größer der Korpus, desto mehr Passagen enthält er, die der Bedeutung der Frage nahekommen, ohne die richtige Antwort zu sein: ähnliche Klauseln verschiedener Verträge, alte Versionen, Kopien. Eigennamen und interne Referenzen, die von Embeddings schlecht abgebildet werden, verschärfen das Problem. Die richtige Antwort ist am Ende nicht mehr unter den ausgewählten Auszügen.
Warum funktioniert ein RAG bei ähnlichen Dokumenten schlecht?
Weil die Vektorsuche die Bedeutung von Passagen vergleicht und gleichartige Dokumente (Verträge nach derselben Vorlage, Prüfberichte, Kundenakten) fast alle dieselbe Bedeutung haben. Was sie unterscheidet, ein Kundenname, ein Datum, ein Betrag, ist genau das, was ein Embedding am schlechtesten erfasst. Ein einfaches RAG liefert dann Passagen anderer Kunden. Die Lösung besteht darin, zuerst nach Kunde, Ordner oder Quelle zu filtern und dann nur in dieser Teilmenge zu suchen.
Was ist die Filterung vor der Vektorsuche in einem RAG?
Das ist der Schritt, in dem der Agent den Suchraum eingrenzt, bevor er nach Bedeutung sucht. Er fragt den Dokumentenkatalog ab (Quelle, Ordner, Datum, Status, Name des Kunden oder Projekts), um die wenigen betroffenen Dokumente zu isolieren, und startet dann die semantische Suche und die Stichwortsuche nur in dieser Teilmenge. Der Agent leitet diesen Filter aus der Frage ab, ohne dass der Nutzer ihn angeben muss.
Kann ein RAG eine Million Seiten verarbeiten?
Ja, sofern es nicht bei jeder Frage in der ganzen Million Seiten sucht. Ein Agentic RAG filtert zuerst den Korpus und sucht dann in einer verkleinerten Teilmenge, wodurch die Suche unabhängig von der Gesamtgröße präzise bleibt. Eine Million Seiten wirft vor allem Fragen der Ingestion auf: OCR-Kosten, inkrementelle Synchronisierung geänderter Dokumente, Qualität der Metadaten.
Sollte man mehrere Agenten anlegen, um eine große Zahl von Dokumenten zu verteilen?
Nicht aus Gründen des Volumens, wenn die Architektur filtert, bevor sie sucht. Die Dokumente auf mehrere Agenten zu verteilen, zwingt den Nutzer zu wissen, welchen er fragen soll, und verhindert Antworten auf Fragen, die mehrere Bereiche betreffen. Das richtige Kriterium für die Trennung von Agenten sind die Zugriffsrechte: Ein HR-Agent hat in Kundenverträgen nichts zu suchen.
Fazit
„Einige Hundert, höchstens einige Tausend Dokumente“: Die Antwort, die man online findet, stimmt für ein einfaches RAG, und sie erklärt, warum so viele interne Projekte nach dem POC stagnieren. Sie beschreibt eine bestimmte Architektur, nämlich die, die bei jeder Frage überall sucht.
Die Zahl der Dokumente ist übrigens nur die Hälfte des Problems. Bei gleichem Volumen bringen Dokumente, die einander ähneln, ein einfaches RAG viel früher zum Scheitern.
Ein Agent, der zuerst weiß, wo er suchen muss, bevor er sucht, was er sucht, lässt die Obergrenze verschwinden, auch bei Hunderten von Zwillingsdokumenten. Dann geht es von einigen Tausend Dokumenten auf mehr als 100.000, und das Unternehmen kann endlich seinen gesamten Dokumentenbestand anbinden statt einer sorgfältig ausgewählten Stichprobe.