Mistral OCR: Kosten mit Open Weights um Faktor 10 senken
Mistral OCR kostet 4 $ pro 1.000 Seiten. Ein Open-Weight-OCR auf einer europäischen GPU kostet 0,15 $ und bleibt souverän. Benchmark, Break-even, Fallstricke.

Im März 2025 kostete Mistral OCR 1 $ pro 1.000 Seiten. Im Dezember 2 $. Seit Juni 2026 4 $. Der Preis von Mistral OCR hat sich in fünfzehn Monaten vervierfacht.
Nehmen wir ein Unternehmen, das seinen Dokumentenbestand für eine KI abfragbar machen will: 10.000 Dokumente mit durchschnittlich 100 Seiten, also eine Million Seiten. Zum aktuellen Tarif kostet allein das OCR 4.000 $, bevor die erste Frage gestellt ist.
Wir haben dieselbe Last durch PaddleOCR-VL geschickt, ein Open-Weight-Modell, betrieben auf einer in Europa gemieteten GPU. Zum Listenpreis, bei durchgehend ausgelasteter GPU: 151 $. Sechsundzwanzigmal weniger.
Und ohne Abstriche bei der Souveränität: Die Maschinen gehören einem finnischen Betreiber, und keine Seite geht an den Herausgeber des Modells.
Eine GPU ist nie zu 100 % ausgelastet, daher die Zehn in unserem Titel statt der Sechsundzwanzig.
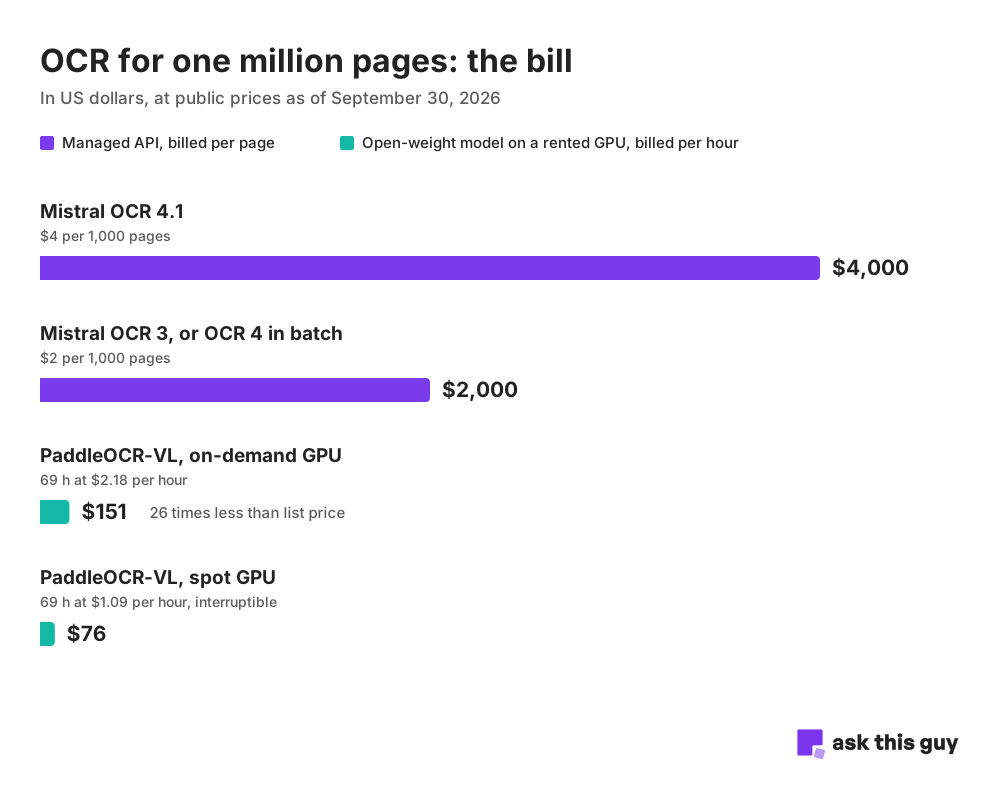 Balkendiagramm zu den OCR-Kosten für eine Million Seiten: 4.000 $ mit Mistral OCR 4.1, 2.000 $ mit Mistral OCR 3 oder OCR 4 im Batch, 151 $ mit PaddleOCR-VL auf einer RTX-PRO-6000-GPU on demand bei Verda, 76 $ auf derselben GPU zum Spot-Tarif
Annahmen: RTX-PRO-6000-GPU bei Verda, zu 100 % ausgelastet, bei 4 Seiten pro Sekunde (unsere Messung an 173 Seiten, eine Maschine).
Warum ein PDF-Parser nicht ausreicht
Ein PDF ist ein Druckformat. Es beschreibt, wo jedes Zeichen auf der Seite platziert wird. Die Datei weiß nicht, was eine Überschrift oder eine Tabelle ist: Sie enthält nur Glyphen und Koordinaten.
Ein PDF-Parser (PyMuPDF, pdfplumber, pypdf) liest diese Textebene und gibt sie Ihnen zurück. Das geht sofort und kostet nichts. Wenn die Ebene existiert, ist das Ergebnis sogar zeichengenau. Das Problem ist alles, was sie nicht enthält.
Das Dokument hat keine Textebene. Ein unterschriebener und dann gescannter Vertrag, ein Fax, ein Foto eines Lieferscheins: Das PDF enthält nur ein Bild. Der Parser liefert eine leere Seite.
Der Text steckt in den Bildern. In unserem Testset enthält eine Präsentation mit 25 Folien 148 Bilder bei 470 Wörtern extrahierbarem Text. In einem 34-seitigen technischen Handbuch voller Screenshots fand Mistral OCR 546 Wörter, die nirgends in der Textebene vorkommen.
Tabellen existieren nicht. In einem PDF ist eine Tabelle eine Reihe von Linien und Zahlen an bestimmten Koordinaten. Der Parser gibt Ihnen die Zahlen hintereinander zurück, ohne die Spalten. Eine Zahl, die von ihrem Spaltenkopf getrennt ist, nützt nichts: Das Sprachmodell, das sie erhält, muss raten, wozu sie gehört.
Lesereihenfolge und Rauschen. Zwei Spalten, ein Kasten, eine Fußnote: Der Parser folgt der Reihenfolge der Datei, die nicht unbedingt die Lesereihenfolge ist. Außerdem behält er alles, was sich wiederholt. In einem 28-seitigen Lastenheft aus unserem Testset waren 669 Wörter nichts als Kopf- und Fußzeilen, die sich von Seite zu Seite wiederholten.
Bei einem RAG zahlt man dafür weiter hinten in der Kette. Wenn ein Assistent danebenliegt, ist die Ursache oft ein Dokument, das schon beim Einlesen falsch gelesen wurde. Das ist einer der Fehler, die nach dem POC auftauchen.
Was ein KI-OCR leistet
Klassisches OCR, etwa mit Tesseract, erkennt Zeichen Zeile für Zeile. Es liest einen sauberen Scan und hört dort auf: keine Struktur, Tabellen durcheinander.
Die aktuelle Generation arbeitet in zwei Schritten. Ein erstes Modell zerlegt die Seite in Blöcke (Überschrift, Absatz, Tabelle, Abbildung, Kopfzeile) und bringt sie in die Lesereihenfolge. Ein zweites, ein Vision-Language-Modell, transkribiert jeden Block. Das Ergebnis ist eine Markdown-Datei mit Überschriften, Tabellen und Bildern, die ein LLM direkt verarbeiten kann. Genau das sucht man, wenn man „pdf to markdown“ eintippt.
Es gibt zwei Zugangswege. Der erste ist eine verwaltete API, für die Mistral OCR in Frankreich das bekannteste Beispiel ist: Sie senden ein PDF, erhalten das Markdown und bezahlen pro Seite.
Der zweite ist ein Open-Weight-Modell, das Sie selbst hosten. PaddleOCR-VL, von Baidu unter der Lizenz Apache 2.0 veröffentlicht, hat weniger als eine Milliarde Parameter und passt auf eine einzige GPU. Hier mieten Sie die Maschine und bezahlen pro Stunde.
Das Modell stammt aus China. Das schmälert die Souveränität des Aufbaus nicht, wir kommen nach den Zahlen darauf zurück.
Was Mistral OCR kostet
| Version | Erscheinen | Preis pro 1.000 Seiten |
|---|---|---|
| Mistral OCR | März 2025 | 1 $ |
| Mistral OCR 3 | Dezember 2025 | 2 $ |
| Mistral OCR 4, dann 4.1 | Juni und Juli 2026 | 4 $ (2 $ bei Batch-Verarbeitung) |
Quellen: Ankündigung vom März 2025, Modellseite OCR 4.1 und Silicon.fr (auf Französisch) für die Preisentwicklung.
Fairerweise: Jede Version kann mehr als die vorherige. OCR 4 liest 170 Sprachen, liefert die Position jedes Absatzes und nimmt sich Handschrift vor. Aber wenn Ihre Dokumente maschinengeschriebene Berichte auf Deutsch sind, bezahlen Sie diese Fortschritte, ohne sie zu nutzen. OCR 3 bleibt für 2 $ verfügbar, und nichts sagt, wie lange noch.
Unsere Million Seiten kostet also 4.000 $ zum Listenpreis, 2.000 $, wenn Sie Batch-Verarbeitung oder das ältere Modell akzeptieren.
Und dieser Betrag entspricht nur der ersten Rechnung. Neue Dokumente kommen hinzu, alte werden aktualisiert. Vor allem müssen Sie jedes Mal, wenn Sie Ihre Ingestion-Pipeline verbessern (ein neues Modell, eine andere Einstellung für Tabellen), den gesamten Bestand erneut durchlaufen lassen. Bei 4.000 $ pro Durchlauf zögert man, eine Verbesserung zu testen. Bei 150 $ testet man sie.
PaddleOCR-VL auf einer gemieteten GPU: dieselbe Million Seiten
Unser Deployment läuft bei Verda, einem finnischen Betreiber mit Rechenzentren in Finnland und Island. Die Maschine: eine RTX-PRO-6000-GPU, gemietet für 2,18 $ pro Stunde on demand und 1,09 $ zum Spot-Tarif (freie Kapazität, jederzeit unterbrechbar).
Am 30. September 2026 haben wir ihren Durchsatz an 9 echten PDFs mit insgesamt 173 Seiten gemessen. Eine einzelne Maschine schafft maximal etwa 4 Seiten pro Sekunde, also 14.400 Seiten pro Stunde.
Eine Million Seiten bei 14.400 Seiten pro Stunde sind 69 GPU-Stunden. Bei 2,18 $ pro Stunde: 151 $.
| Kosten pro 1.000 Seiten | Eine Million Seiten | |
|---|---|---|
| Mistral OCR 4.1 | 4 $ | 4.000 $ |
| Mistral OCR 3 oder OCR 4 im Batch | 2 $ | 2.000 $ |
| PaddleOCR-VL, GPU on demand | 0,15 $ | 151 $ |
| PaddleOCR-VL, Spot-GPU | 0,08 $ | 76 $ |
Warum wir zehn sagen und nicht sechsundzwanzig
Diese 0,15 $ setzen eine GPU voraus, die in jeder abgerechneten Sekunde arbeitet. Eine gemietete GPU wird aber pro Stunde bezahlt, ob sie Seiten umwandelt oder wartet.
Alles hängt also von ihrer Auslastung ab:
| Verarbeitete Seiten pro abgerechneter Stunde | GPU-Auslastung | Ergebnis gegenüber Mistral OCR 4.1 |
|---|---|---|
| 545 | 4 % | Gleiche Kosten |
| 1.090 | 8 % | Halb so teuer (der Preis von Mistral OCR 3) |
| 5.450 | 38 % | Zehnmal günstiger |
| 14.400 | 100 % | Sechsundzwanzigmal günstiger |
Ein abzuarbeitender Bestand ist der Idealfall: Sie füllen die Warteschlange, die Maschine läuft unter Volllast, und am Ende schalten Sie sie ab. Ein Rinnsal von drei Dokumenten pro Stunde ist der schlimmste Fall: Die GPU wartet, und Sie bezahlen das Warten.
Eine dauerhaft eingeschaltete GPU ergibt keinen Sinn
Der Fehler, der am leichtesten passiert: eine Maschine mieten, sie laufen lassen und am Monatsende die Rechnung entdecken. Eine GPU für 2,18 $ pro Stunde, die Tag und Nacht läuft, kostet 1.591 $ im Monat, ob sie eine Million Seiten umwandelt oder keine. Für diesen Preis verarbeitet Mistral OCR 4.1 fast 400.000 Seiten. Unterhalb dieses Monatsvolumens ist die dauerhaft eingeschaltete Maschine teurer als die API.
Nehmen wir 100.000 Seiten pro Monat:
| Aufbau | Monatliche Kosten |
|---|---|
| Mistral OCR 4.1 | 400 $ |
| Gemietete GPU, dauerhaft eingeschaltet | 1.591 $ |
| Gemietete GPU, 7 Stunden eingeschaltet, dann pausiert | 15 $, plus die Startminuten |
Es braucht also ein System, das den Container startet, wenn Dokumente eintreffen, und ihn pausiert, sobald die Warteschlange leer ist. Ohne dieses System kostet Open Weight mehr als das, was es ersetzt.
Verda macht das möglich. Seine Serverless Containers skalieren auf null Maschinen herunter, wenn nichts zu tun ist, und halten Anfragen in einer Warteschlange, während eine Maschine startet. Abgerechnet werden nur die Minuten, in denen sie lief, Start und Stopp inklusive.
Zwei Einstellungen bleiben Ihre Sache. Erstens die Startschwelle: Eine GPU für drei Dokumente zu wecken, kostet mehr, als sie an eine API zu schicken. Bei uns startet die Maschine ab 50 Dokumenten, die innerhalb einer Viertelstunde eingehen, und pausiert nach zehn Minuten ohne Aktivität. Zweitens das Schicksal der Dokumente, die während des Starts eintreffen, der einige Minuten dauert. Bei uns gehen sie ohne Wartezeit an die Fallback-Engine.
Günstiger und genauso souverän
Der Wechsel von der API eines französischen Anbieters zu einem von Baidu veröffentlichten Modell schmälert die Souveränität des Aufbaus nicht. Eine souveräne KI beurteilt man auf drei Ebenen: das für den Anbieter geltende Recht, die Infrastruktur, die Ihre Daten verarbeitet, und die Modelle, die sie lesen.
Der Anbieter. Verda ist ein finnisches Unternehmen nach europäischem Recht, so wie Mistral ein französisches Unternehmen ist.
Die Infrastruktur. Seine Rechenzentren stehen in Finnland und Island, in einem europäischen Raum, der unter die DSGVO fällt. Dort werden Ihre Dokumente umgewandelt.
Das Modell. PaddleOCR-VL steht unter der Lizenz Apache 2.0: Wir haben seine Gewichte einmal heruntergeladen, und es läuft in unserem eigenen Container. Keine Seite geht an seinen Herausgeber. Der Weg Ihrer Daten hängt davon ab, wo das Modell läuft und wer die Maschine betreibt. Das Land, in dem es trainiert wurde, ändert daran nichts.
In einem Punkt ist Open Weight sogar besser als eine API, ob französisch oder nicht: Niemand kann den Preis ändern. Gewichte unter Apache 2.0 verdoppeln ihren Tarif nicht im Dezember, und niemand nimmt sie aus dem Katalog. Souverän sein heißt auch, nicht von der Preisliste eines anderen abzuhängen.
Mistral OCR behalten wir als Fallback in unserer Pipeline. Diese Entscheidung ist eine Frage von Kosten und Risiko, nicht der Flagge.
Mehr als der Stundensatz
Der Preisunterschied ist real. Er hat seine Kehrseiten.
Mistral ist schneller
Bei einem einzelnen Dokument verarbeitet Mistral OCR 4.1 eine Seite in 0,20 Sekunden, gegenüber 0,43 bis 0,56 Sekunden bei unserem Deployment. Unter Last wächst der Abstand: Mit acht gleichzeitig gesendeten Dokumenten erreicht Mistral 18 bis 20 Seiten pro Sekunde, während unsere Maschine bei etwa 4 bleibt. Und auf einer ausgelasteten Maschine wartet ein einseitiges Dokument, das allein 2 Sekunden braucht, hinter den großen mehr als 20 Sekunden.
Diese Obergrenze gilt für eine einzelne Maschine. Wenn der Durchsatz wichtig ist, mieten Sie mehrere: Jede Maschine fügt ihre 4 Seiten pro Sekunde hinzu, und die Kosten pro Seite bleiben gleich, solange sie ausgelastet sind. Unsere Million Seiten braucht auf einer GPU 69 Stunden, also fast drei Tage. Auf vier GPUs geht es in 17 Stunden, für dieselben 151 $.
Mehrere Maschinen verkürzen die Umwandlung eines einzelnen Dokuments nicht. Für einen Nutzer, der ein PDF in einen Chat hochlädt und auf die Antwort wartet, bleibt die API schneller.
Spot oder API: Fallbacks sind Pflicht
Zum Spot-Tarif stellen wir regelmäßig fest, dass uns die Maschine mitten in der Arbeit entzogen wird. Nachts dagegen sehr selten, und nachts läuft der Großteil unserer Verarbeitung.
Die API ist nicht sicherer. Über zwei Monate Produktion sind 4,8 % unserer Aufrufe an Mistral OCR mit einem Fehler 404 gescheitert: 402 von 8.320 Aufrufen, also fast jeder zwanzigste.
In jedem Fall braucht es Fallbacks. Ob eine GPU verschwindet oder eine API einen Fehler zurückgibt, die Ingestion darf nicht stoppen: Das Dokument geht ohne manuellen Eingriff an eine andere Engine. Kein Glied hält allein, das gilt für OCR wie für den Rest der KI-Kette.
Die Qualität: bei der Durchsicht gleichwertig
Wir haben die Ausgaben beider Engines mit bloßem Auge durchgesehen. PaddleOCR-VL und Mistral OCR liefern sehr ähnliche Ergebnisse. Beide schneiden besser ab als das, was wir mit LightOnOCR und mit Docling beobachtet haben.
Eine automatische Messung ergänzt diese Durchsicht. Wir haben für jede Engine gezählt, welchen Anteil der Wörter aus der Textebene der PDFs sie wiederfindet: 93,6 % für PaddleOCR-VL, 97,7 % für Mistral OCR 3, 98,3 % für Mistral OCR 4.1. Der Großteil dieses Abstands ist gewollt, denn unsere Konfiguration entfernt Kopfzeilen, Fußzeilen und Fußnoten.
Zwei echte Unterschiede bleiben. Mistral transkribiert den Text in Screenshots, PaddleOCR-VL belässt diese größtenteils als Bilder. Und PaddleOCR-VL schreibt seine Tabellen in HTML, mit Entitäten anstelle von Apostrophen, was eine Bereinigung erfordert.
Die automatische Messung umfasst 9 Dokumente, von denen keines ein Scan ist. Lassen Sie vor einer Entscheidung beide Engines über fünfzig Ihrer eigenen Dokumente laufen.
Es muss betrieben werden
Ein Container-Image von mehr als 15 GB, etwa fünf Minuten Kaltstart, Abrechnung in Zehn-Minuten-Blöcken, der Controller, der die Maschine startet und pausiert, ein Fallback, wenn sie nicht antwortet. Nichts davon ist für sich genommen schwierig. Zusammen sind es einige Wochen Engineering-Arbeit, danach dauerhafte Überwachung.
Wann wechseln, wann bei der API bleiben
| Ihre Situation | Die richtige Wahl | Warum |
|---|---|---|
| Kleines, laufendes Volumen (einige Tausend Seiten pro Monat) | Die API | Es geht um einige Dutzend Dollar, eine GPU lohnt den Aufwand nicht |
| Großer Bestand oder regelmäßige Neuverarbeitung (Hunderttausende Seiten) | Open Weight auf gemieteter GPU | Die GPU läuft voll ausgelastet: 10- bis 26-mal günstiger |
| Ein Nutzer wartet vor dem Bildschirm auf die Antwort | Die API | Ein einzelnes Dokument ist dort schneller durch, ohne Startwartezeit |
| Volle Kontrolle über die Kette gefordert | Open Weight auf gemieteter GPU | Das Modell läuft bei Ihnen, und niemand kann den Preis ändern |
| Volumen und Interaktivität | Beides, hintereinandergeschaltet | Die GPU verarbeitet das Volumen, die API übernimmt, wenn sie gestoppt oder nicht verfügbar ist |
Der letzte Fall ist der häufigste. Er ist auch der einzige, bei dem man etwas bauen muss.
Bei Ask This Guy ist diese Arbeit schon erledigt
Unsere Ingestion-Pipeline verkettet drei Engines. PaddleOCR-VL auf unseren GPUs bei Verda kommt zuerst. Antwortet es nicht, geht das Dokument an Mistral OCR, ohne darauf zu warten, dass eine Maschine startet. Docling dient als letzte Rückfallebene. Ein Controller schaltet die GPU ein, wenn das Volumen es rechtfertigt, und pausiert sie nach zehn Minuten Inaktivität.
Das erste Glied läuft auf unseren GPUs in Finnland und Island, den Fallback stellt ein französischer Anbieter. Wir haben die Kosten gesenkt, ohne das Souveränitätsniveau anzutasten, das wir in unserem Ansatz für souveräne KI (auf Englisch) beschreiben.
Unsere Kunden sehen davon nichts. Sie laden ihre Dokumente hoch oder binden ihre Quellen an und fragen sie dann in ihrem Dokumentenassistenten ab. Die anderen Wege, Modelle zu betreiben, von der gekauften GPU bis zur schlüsselfertigen Plattform, beschreiben wir in unserem Leitfaden zur KI-Inferenz im Unternehmen.
Häufige Fragen zu Mistral OCR und Open-Source-OCR
Was kostet Mistral OCR?
Stand 30. September 2026 kostet Mistral OCR 4.1 4 $ pro 1.000 Seiten und 2 $ bei Batch-Verarbeitung. Das ältere Modell, Mistral OCR 3, bleibt für 2 $ pro 1.000 Seiten verfügbar. Beim Start im März 2025 lag der Tarif bei 1 $ pro 1.000 Seiten. Für eine Million Seiten sind also 2.000 bis 4.000 $ pro Durchlauf zu veranschlagen.
Was ist der Unterschied zwischen einem PDF-Parser und OCR?
Ein PDF-Parser liest den Text, der bereits in der Datei gespeichert ist: Er arbeitet sofort und kostenlos, sieht aber weder gescannte Dokumente noch Text in Bildern, und er rekonstruiert keine Tabellen. Ein OCR analysiert das Bild der Seite. KI-basierte OCR-Engines erkennen zusätzlich die Struktur des Dokuments (Überschriften, Tabellen, Lesereihenfolge) und erzeugen strukturierten Text, meist Markdown.
Gibt es eine Open-Source-Alternative zu Mistral OCR?
Ja, mehrere. PaddleOCR-VL, von Baidu unter der Lizenz Apache 2.0 veröffentlicht, ist die, für die wir uns entschieden haben: ein Modell mit weniger als einer Milliarde Parametern, das auf eine einzige GPU passt. LightOnOCR, Docling, MinerU und DeepSeek-OCR sind weitere Optionen. Alle erfordern, eine GPU zu mieten oder zu besitzen und das Deployment selbst zu betreiben.
Ist ein Open-Weight-OCR eines chinesischen Herausgebers souverän?
Ja, wenn es auf einer Infrastruktur läuft, die Sie kontrollieren. Ein Open-Weight-Modell wie PaddleOCR-VL, von Baidu unter der Lizenz Apache 2.0 veröffentlicht, wird einmal heruntergeladen und läuft dann in Ihrem eigenen Container: Kein Dokument wird an seinen Herausgeber übermittelt. Die Souveränität hängt dann vom Betreiber der Maschine und ihrem Standort ab. Bei einem Betreiber nach europäischem Recht, in Rechenzentren in Europa, ist ein solches OCR genauso souverän wie die API eines französischen Anbieters.
Ab welchem Volumen lohnt sich ein selbst gehostetes OCR?
Auf einer GPU, die für 2,18 $ pro Stunde gemietet ist, kostet selbst gehostetes OCR weniger als Mistral OCR 4.1 ab 545 verarbeiteten Seiten pro abgerechneter Stunde und weniger als Mistral OCR 3 ab 1.090 Seiten. Um die Rechnung durch zehn zu teilen, braucht es etwa 5.450 Seiten pro Stunde, also eine GPU mit 38 % Auslastung. Diese Rechnung setzt voraus, dass die Maschine pausiert wird, sobald sie nichts mehr zu tun hat: Dauerhaft eingeschaltet kostet sie 1.591 $ im Monat und lohnt sich erst ab 400.000 Seiten monatlich.
Ist PaddleOCR-VL so genau wie Mistral OCR?
Bei menschlicher Durchsicht liegen die Ergebnisse von PaddleOCR-VL und Mistral OCR sehr nah beieinander und sind besser als das, was wir mit LightOnOCR und Docling beobachtet haben. In einer automatischen Messung an 173 Seiten findet PaddleOCR-VL 93,6 % der Wörter aus der Textebene der PDFs wieder, gegenüber 97,7 % bei Mistral OCR 3 und 98,3 % bei Mistral OCR 4.1. Der größte Teil dieses Abstands stammt von Kopfzeilen, Fußzeilen und Fußnoten, die unsere Konfiguration bewusst entfernt.
Fazit
OCR wirkt wie ein unauffälliger Kostenposten. Es genügen eine Million Seiten und ein Tarif, der sich zweimal verdoppelt, damit er auffällig wird.
Ein Open-Weight-Modell auf einer in Europa gemieteten GPU drückt diesen Posten von 4.000 $ auf einige Hundert, ohne Abstriche bei Souveränität oder Qualität. Unter einer Bedingung: Die Maschine läuft nur, wenn sie Arbeit hat.
Wenn Sie einen Dokumentenbestand abfragbar machen wollen und all das lieber nicht selbst bauen: Demo buchen.
Messungen vom 30. September 2026: 9 PDFs, 173 Seiten, eine Maschine pro Deployment, ein bis zwei Durchläufe pro Engine. Öffentliche Preise von Mistral und Verda am selben Tag erhoben.