KI-Inferenz: 7 Wege, Modelle im Unternehmen zu betreiben
KI-Inferenz im Unternehmen: 7 Ansätze im Vergleich, vom GPU-Kauf bis zum schlüsselfertigen Anbieter. Echte Kosten, Souveränität, Latenz, Auswahlkriterien.

„Wir kaufen GPUs und hosten alles selbst.“ „Nein, wir binden eine API an und kommen voran.“
Diese Diskussion ist ein Klassiker unter den Philosophien, die bei der KI-Inferenz im Unternehmen aufeinanderprallen. Sie kommt früh in einem KI-Projekt auf, meist dann, wenn das Budget beziffert wird. Auf der einen Seite die, die KI im eigenen Haus wollen: Man kauft die Karten, installiert die Modelle, nichts verlässt das Unternehmen. Auf der anderen Seite die, die einen Dienst nutzen wollen: ein API-Schlüssel oder ein Abo, Abrechnung nach Nutzung, keine Hardware zu verwalten.
Beide Lager haben gute Argumente. Das Problem: Sie diskutieren über zwei von sieben Optionen.
Worüber sie streiten, hat einen Namen: Inferenz.
Was ist KI-Inferenz genau?
Inferenz ist der Moment, in dem ein KI-Modell eine Frage beantwortet. Nicht sein Training, das bereits stattgefunden und jemand anderen Millionen gekostet hat, sondern schlicht der Vorgang, ihm eine Anfrage zu schicken und einen Text zurückzubekommen.
Inferenz fällt jeden Tag an. Sie wächst proportional zu Ihrer Nutzung, solange Ihr Dienst läuft. Sie bestimmt Geschwindigkeit, Rechnung und Vertraulichkeitsniveau Ihres Projekts.
Ein Token ist eine kleine Texteinheit, ein Wort oder ein Wortteil. Anbieter rechnen pro Million Token ab und zählen Eingabe und Ausgabe getrennt.
Eingabe-Token sind alles, was Sie an das Modell schicken: die Frage des Nutzers, aber auch die Anweisungen, den Gesprächsverlauf, Dokumentauszüge und die Beschreibung der verfügbaren Tools. Ausgabe-Token sind das, was das Modell als Antwort erzeugt. Bei gleichem Volumen kostet die Ausgabe in der Regel drei- bis fünfmal mehr, weil jedes erzeugte Token einen vollständigen Durchlauf durch das Modell erfordert, während die Eingabe am Stück verarbeitet wird.
Das Verhältnis zwischen beiden hängt stark von Ihrem Use Case ab, und genau das prägt Ihre Rechnung. Ein Allzweck-Assistent schickt wenig und bekommt viel zurück: kurze Frage, ausführliche Antwort. Eine agentische KI macht es umgekehrt. Bei jedem Schritt schickt der Agent den gesamten angesammelten Kontext, die Ergebnisse seiner Tool-Aufrufe und den Verlauf seiner Versuche zurück, um manchmal drei Zeilen Entscheidung zu erzeugen. Die Eingabe wächst mit jedem Schleifendurchlauf. Deshalb bieten Anbieter reduzierte Preise für den Teil des Kontexts an, der von einem Aufruf zum nächsten wiederverwendet wird.
Bleibt die Geschwindigkeit, gemessen in Token pro Sekunde. Für einfachen Chat oder Vervollständigung ergeben 100 Token/s eine Antwort, die flüssig wirkt. Für agentische Anwendungen, bei denen das Modell mehrere Aufrufe aneinanderreiht, bevor überhaupt etwas angezeigt wird, sollten es eher 500 Token/s sein. Diese Schwellen erläutern wir in unserem Artikel über das lokale LLM.
Wenn Sie nur eines mitnehmen
Die Welt ist nicht binär. Zwischen „alles kaufen“ und „alles als Dienst beziehen“ bietet der Markt eine ganze Palette tragfähiger Lösungen, alle mit guten Gründen für ihre Existenz, und die meisten Unternehmen, die in Produktion sind, kombinieren mehrere davon. Die richtige Wahl hängt von Ihrem Kontext ab, nicht von einer Grundsatzposition.
Es gibt zwei vernünftige Herangehensweisen. Die erste: sich nicht den Kopf zerbrechen, eine Lösung bei einem Anbieter nehmen und die Aufmerksamkeit auf einen einzigen Punkt richten, seine Abrechnungsmetrik. Ein Angebot, das pro Nachricht, pro Nutzer oder pauschal abrechnet, bleibt planbar. Ein Angebot, das pro Token abrechnet, deutlich weniger.
Die zweite: ein paar Tage investieren, denn der Kostenunterschied zwischen den sieben Ansätzen bemisst sich in Größenordnungen, nicht in Prozent.
In beiden Fällen heißt das, was Sie vermeiden wollen, Bill Shock, also der Schock bei der Rechnung, und er kommt regelmäßig vor. Im Juni 2025 stellt Cursor seine Einzelabos auf nutzungsbasierte Abrechnung um, ohne dass die Nutzer verstehen, dass das angekündigte „Unbegrenzt“ nur ein einziges Modell abdeckte; der Hersteller entschuldigte sich am 4. Juli und erstattete drei Wochen Mehrkosten. Im Repository von Gemini CLI entdeckten Entwickler, die überzeugt waren, unter einem Limit von 1.000 Anfragen pro Tag zu bleiben, Rechnungen über 2.000, 6.400, manchmal 10.000 Dollar: Ihr API-Schlüssel rechnete pro Token ab, und die Reasoning-Schleifen des Modells verbrauchten Hunderte Millionen davon.
In beiden Fällen dieselbe Wurzel. Der Nutzer dachte in Anfragen, der Anbieter rechnete in Token ab.
Vier Dinge entscheiden sich auf der Inferenzebene
Ihre Nutzer vergleichen mit ChatGPT
Sie kommen mit einer Referenz im Kopf, und diese Referenz heißt ChatGPT, Gemini oder Mistral. Sie sind es gewohnt, dass sich ein Text sofort aufbaut. Wenn Ihr interner Assistent fünfzehn Sekunden braucht, um mit der Antwort zu beginnen, wird niemand sagen, die Infrastruktur sei unterdimensioniert. Man wird sagen, Ihr Tool funktioniere nicht, und zum vorherigen zurückkehren.
Viele B2B-Lösungen laufen heute in diesem Modus. Das Produkt hält, was es verspricht, die Demo läuft gut, und niemand öffnet es ein zweites Mal.
Diese Latenz entscheidet sich fast vollständig auf der Inferenzebene, und sie ist mit Abstand der häufigste Grund für die Aufgabe interner Assistenten, den wir beobachten. Ein technisch sauberes Projekt kann an fünfzehn Sekunden zu viel durchaus sterben.
Niemand schafft 99,9 % allein
Die großen KI-Anbieter liegen bei etwa 99 bis 99,5 % Verfügbarkeit, also mehreren Tagen Ausfall pro Jahr. Ihre Nutzer sind bei ihren Office-Tools vier Neunen gewohnt. Der Unterschied fällt auf.
Die realen Zahlen pro Anbieter haben wir in KI-SLA für Unternehmen veröffentlicht. Der häufigste Konstruktionsfehler, dem wir begegnen, hat sich seit zwei Jahren nicht verändert: ein einziger Anbieter, kein Fallback.
Sie schicken Ihre Dokumente an jemanden
Inferenz bedeutet, die Frage Ihres Nutzers und die Dokumentauszüge, die zur Antwort dienen, an einen Dritten zu übermitteln. Verträge, interne Notizen, Kundendaten. Man sollte besser wissen, an wen, unter welchem Recht, mit welcher Aufbewahrungsrichtlinie und welcher Zusage, dass nicht damit trainiert wird.
Eine allgemeingültige richtige Antwort gibt es hier nicht, nur einen Regler, den man einstellen muss. Unseren haben wir auf der Seite Souveräne KI dokumentiert.
Das Spitzenmodell im Ranking kostet viel für nichts
Es ist fast nie das, was Sie brauchen. Um ein Ticket zu klassifizieren, ein Feld zu extrahieren oder eine Antwort auf Basis bereitgestellter Dokumente umzuformulieren, erledigt ein kleineres, schnelleres Modell die Arbeit.
Vor allem hat der Preisunterschied nichts mit dem Leistungsunterschied zu tun. Hier vier Angebote vom Markt, eingeordnet nach ihren durchschnittlichen Kosten pro Million Token und ihrem Intelligenzindex:
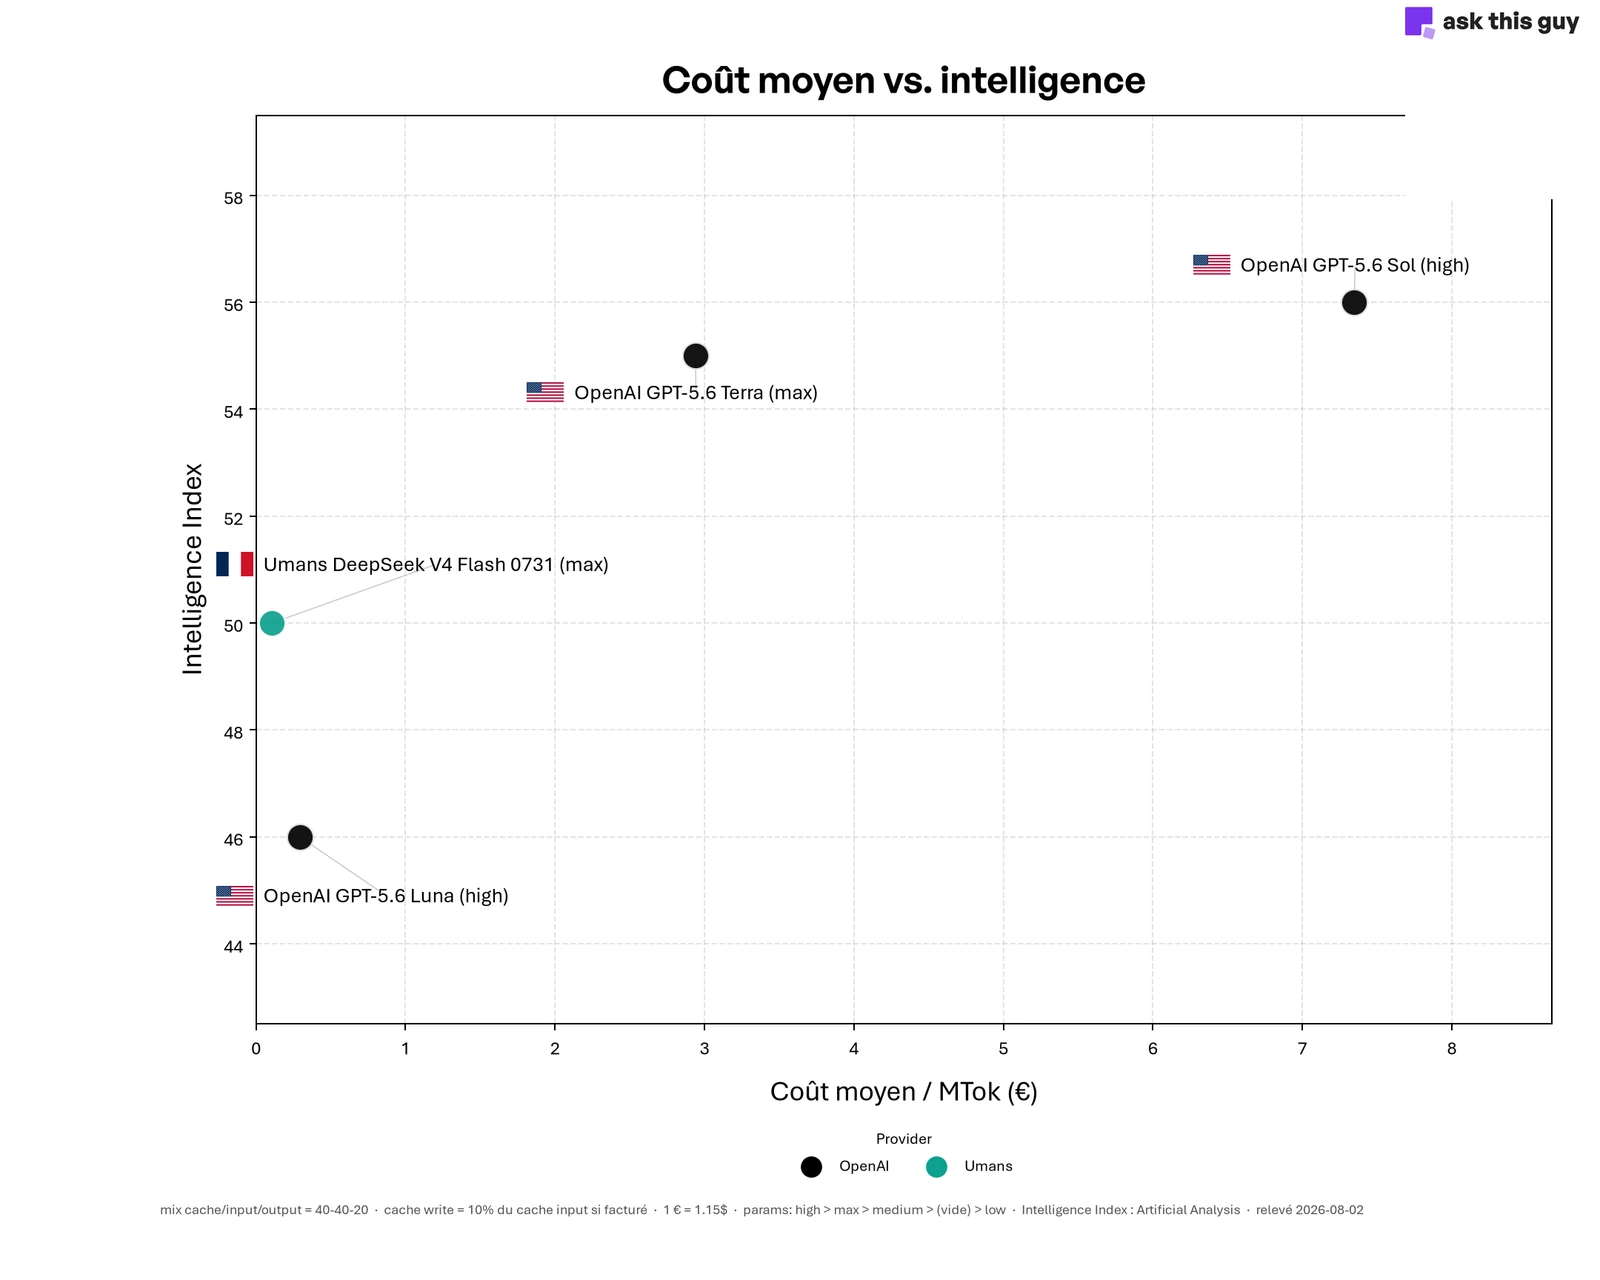 Streudiagramm, das Kosten pro Million Token und Intelligenzindex für vier Angebote vergleicht. DeepSeek V4 Flash, bereitgestellt vom französischen Anbieter Umans, erreicht einen Index von 50 für 0,11 € pro MTok, während GPT-5.6 Sol von OpenAI 56 für 7,35 € erreicht und GPT-5.6 Luna 46 für 0,29 €.
GPT-5.6 Sol kostet 7,35 € pro MTok bei einem „Intelligenz“-Index von 56. DeepSeek V4 Flash bei Umans kostet 0,11 € bei einem Index von 50. Sechs Punkte Unterschied, Faktor 69 auf der Rechnung.
Sehen Sie sich dann GPT-5.6 Luna unten in der Punktwolke an: fast der dreifache Preis des Umans-Angebots für einen um vier Punkte niedrigeren Index. Mehr zu zahlen garantiert nicht einmal, Besseres zu bekommen. Das Ranking sagt Ihnen, was ein Modell kann, nie, was es Sie kosten wird.
Ein letzter Punkt, den wir am häufigsten wiederholen: Ein Benchmark ordnet Modelle nach generischen Aufgaben, nie nach Ihrer. Ein Intelligenzindex sagt nichts darüber, wie sich ein Modell bei Ihrem Fachjargon, Ihren Dokumenten, Ihrer Sprache oder dem erwarteten Ausgabeformat verhält. Zwei Tage, in denen drei oder vier Kandidaten auf einer repräsentativen Stichprobe Ihrer echten Fälle laufen und deren Ergebnisse verglichen werden, sind gut investiert. Das ist das einzige Ranking, das für Sie zählt, und es stellt die offizielle Reihenfolge regelmäßig auf den Kopf.
Intelligenzindex: Artificial Analysis, Messungen vom August 2026. Durchschnittskosten berechnet auf einer Mischung aus 40 % gecachter Eingabe, 40 % neuer Eingabe und 20 % Ausgabe, bei 1 € = 1,15 $. Die Angaben max und high bezeichnen die Stufe des Reasoning-Aufwands des Modells.
Die sieben Ansätze
1. Eigene GPUs kaufen und selbst betreiben
Sie kaufen die Karten, installieren sie, stellen die Modelle bereit und warten das Ganze. Maximale Kontrolle: Ihre Daten verlassen nie das Haus, Sie entscheiden alles, und niemand ändert Ihre Bedingungen über Nacht.
Aber auch maximaler CAPEX. Für ein wirklich schnelles und leistungsfähiges Modell rechnen Sie mit einem sechsstelligen Betrag, dazu die Fachleute, die Sie für den Betrieb der Maschine einstellen müssen. Ihre KI-Infrastruktur wird zu einem eigenständigen Projekt, mit eigenem Budget und eigenem Team. Die Rechnung haben wir ausführlich in RAG on Premise: Was ist mit 60.000 € möglich? aufgemacht.
Das bleibt absoluten regulatorischen Vorgaben vorbehalten, massiven und stabilen Volumen sowie Unternehmen, die bereits ein Infrastrukturteam haben. Oder solchen, die ihre Kapazität weiterverkaufen wollen, wenn sie ungenutzt ist; darauf kommen wir bei Ansatz 4 zurück.
2. Dedizierte GPUs bei einem Cloud-Anbieter mieten
Dieselbe Architektur, dieselbe Bereitstellungsarbeit, aber die Hardware gehört Ihnen nicht mehr. Aus CAPEX wird planbarer OPEX, Strom und Kühlung inklusive, und Hardwareausfälle sind Sache Ihres Anbieters.
Vorsicht beim angezeigten Stundenpreis. Ein durchgehend verfügbarer Dienst läuft 730 Stunden im Monat, dieser Stundenpreis ist also in Wahrheit eine Monatsmiete. Eine H100 bei Scaleway kostet 2,73 € pro Stunde, was in der Besprechung gut ankommt, und knapp 2.000 € im Monat, 24.000 € im Jahr, für eine einzige Karte. Bei Verda, einem finnischen Betreiber mit Rechenzentren in Finnland und Island, kostet die H100 SXM5 3,25 $ pro Stunde, mit 8 % Rabatt bei einem Jahr und 25 % bei zwei Jahren Laufzeit.
Der nächste Reflex ist der Vergleich mit dem Kauf. Eine H100 PCIe wird am Markt für 25.000 bis 33.000 $ gehandelt, eine H100 SXM5 für 35.000 bis 40.000 $. Eine Karte im Dauerbetrieb zu mieten kostet also je nach Modell und Anbieter nach zwölf bis siebzehn Monaten ihren Kaufpreis. Und eine Karte reicht selten: Ein Server mit acht H100, dimensioniert, um ein großes Modell ordentlich bereitzustellen, liegt bei rund 19.000 $ im Monat, also 228.000 $ im Jahr, während die entsprechende Maschine im Kauf über 350.000 $ kostet. Achtzehn Monate bis zur Amortisation.
Auf dem Papier ist das hervorragend. Nur vergleicht man hier eine Karte mit einem Dienst. Der Kaufpreis enthält weder das Rechenzentrum noch Strom, Kühlung, Netzwerk oder die Teams, die das Ganze betreiben. Und der Vermögenswert verliert schnell an Wert: Eine gebrauchte H100 erzielt 60 bis 70 % des Neupreises, während B200 und B300 auf den Markt kommen und die Mietpreise nach unten ziehen. Sie schreiben über drei Jahre eine Hardware ab, deren entsprechende Miete vor Ende des Zeitraums gesunken sein wird.
In dieser Größenordnung lässt die Miete den sechsstelligen Betrag aus Ansatz 1 nicht verschwinden: Sie verwandelt ihn in eine Jahresmiete.
3. GPUs nur bei Bedarf hochfahren
Sie schalten die Maschine ein, in den meisten Fällen eher einen Container, erledigen die Arbeit und schalten sie wieder aus. Manche Anbieter rechnen nach genutzten Zeitblöcken ab, bei Verda zum Beispiel in Zehn-Minuten-Schritten, sodass eine Verarbeitung, die nach 45 Minuten fertig ist, 50 kostet. Viele bieten zudem Spot-Preise auf freie Kapazität zum halben Preis.
Zwei Stunden Verarbeitung pro Nacht ergeben rund sechzig Stunden im Monat, also etwa 98 $ zum Spot-Preis, während dieselbe Karte im Dauerbetrieb 2.370 $ kostet. Faktor vierundzwanzig. Für Hintergrundverarbeitung ist das das beste Angebot am Markt: Neuindexierung von Dokumenten, Berechnung von Embeddings, Massenklassifizierung, Extraktion aus einem PDF-Bestand.
Für einen Dienst, der tagsüber offen ist, kommt das nicht infrage. Eine Maschine zu starten und ein Modell zu laden dauert Minuten, und eine Spot-Instanz kann Ihnen mittendrin entzogen werden. Niemand wartet fünf Minuten, bis sein Assistent aufwacht.
4. Überschüssige Kapazität von denen mieten, die zu viel haben
Wer Ansatz 1 gewählt hat, hat zeitweise ungenutzte GPUs. Es hat sich ein Markt gebildet, um diese Leerlaufstunden weiterzuverkaufen, oft weit unter den Preisen der großen Anbieter, da die Hardware ohnehin bereits abgeschrieben ist.
Diese Kategorie umfasst zwei sehr unterschiedliche Realitäten. Am einen Ende Akteure, die daraus einen Unternehmensdienst gemacht haben: vertraglich reservierte Kapazität, Verfügbarkeitszusage, identifizierter Betreiber, Hardware in bekannten Rechenzentren. Sie greifen darauf zu wie bei jedem Cloud-Anbieter, mit Rechnung und Ansprechpartner, aber zu einem Preis, der dadurch sinkt, dass die Karten schon vorhanden waren.
Am anderen Ende der Markt von Privat zu Privat. Darkbloom, hervorgegangen aus Eigen Labs, lässt Inferenz auf ungenutzten Macs mit Apple Silicon laufen, mit einer Verschlüsselung, die so ausgelegt ist, dass der Besitzer der Maschine nicht lesen kann, was darüber läuft. Das Projekt ist noch experimentell, und wir würden heute keinen kritischen Dienst darauf setzen. Die Idee ist schlüssig: Zig Millionen neuere Macs schlafen einen guten Teil des Tages mit viel freiem Arbeitsspeicher.
In beiden Fällen kommt es darauf an, wer die Maschine betreibt, was er sehen kann und welche Verfügbarkeitszusage er unterschreibt. Das unterscheidet ein gutes Geschäft von einer Wette.
5. Einen Inferenzanbieter nutzen
Keine Maschine mehr zu verwalten. Sie rufen eine API auf, zahlen pro Token, und jemand anderes hält für Sie dauerhaft GPUs warm.
Zwei Familien existieren nebeneinander. Die reinen Inferenzanbieter stellen Open-Weights-Modelle bereit und konkurrieren über Geschwindigkeit und Preis: Cerebras, Groq, DeepInfra, Nebius. Die Publikumsanbieter, OpenAI, Anthropic, Google, Mistral, stellen ihre eigenen Modelle bereit.
Der Unterschied zeigt sich auf der Rechnung. Bei vergleichbarer Qualität für viele Aufgaben sind die Ersteren spürbar günstiger, weil die Letzteren auch ihre Bekanntheit und die Exklusivität ihrer Modelle in Rechnung stellen. Da dasselbe offene Modell bei rund zehn Anbietern läuft, können Sie umentscheiden, ohne Ihre Prompts anzufassen.
Wählen Sie einen Anbieter, der eine echte Servicezusage veröffentlicht, nicht nur eine Statusseite. Und planen Sie vom ersten Tag an ein Fallback ein.
6. Ein Gateway vor mehrere Anbieter schalten
Sie binden mehrere Anbieter hinter eine einzige Schicht an, die deren Zustand misst, nach Geschwindigkeit und Preis entscheidet und automatisch umschaltet, wenn einer ausfällt. Das nennt man ein Multi-Provider-Gateway oder AI Gateway.
Kein Anbieter erreicht allein 99,9 %. Hintereinandergeschaltet hinter einem Gateway, das testet und umschaltet, schafft man es. Die Verfügbarkeitszahlen stehen in KI-SLA für Unternehmen, der Vergleich der Gateways am Markt, von OpenRouter bis LiteLLM, in LLM-Gateway: OpenRouter, LiteLLM oder eigenes Gateway?
7. Ihre Plattform übernehmen lassen
Sie kaufen ein KI-Produkt für Unternehmen, und die Inferenz wird zum Problem eines anderen. Keine GPU zu betreiben, kein Gateway zu bauen, und die Beobachtung des Modellmarkts betrifft Sie nicht mehr.
Im Gegenzug übernehmen Sie die Entscheidungen Ihres KI-Anbieters. Daher die Frage, die Sie ihm vor der Unterschrift stellen sollten: Kann er seine Inferenzkette beschreiben? Welche Anbieter, in welcher Rechtsordnung, mit welchem Fallback, unter welcher Zusage, nicht mit Ihren Daten zu trainieren. Wer bei diesem Teil vage bleibt, verlangt Ihr Vertrauen beim sensibelsten Glied der Kette.
Die sieben Ansätze für KI-Inferenz im Vergleich
Lesehilfe: Grün ist günstig, Rot ungünstig. Das Zeichen ± markiert ein Kriterium, das vom gewählten Anbieter abhängt.
| # | Ansatz | Kostenmodell | Geringer Betriebsaufwand | Zuverlässigkeit | Souveränität | Inbetriebnahme | Wann es die richtige Wahl ist |
|---|---|---|---|---|---|---|---|
| 1 | GPUs kaufen | Hoher CAPEX | −−− | ++ | +++ | Monate | Absolute regulatorische Vorgabe, massives Volumen |
| 2 | Dedizierte GPUs mieten | Hoher, planbarer OPEX | −− | ++ | ++ | Tage | Stabiles Volumen, Standortanforderung |
| 3 | GPUs bei Bedarf | OPEX nach Nutzung | − | −− | ++ | Stunden | Hintergrundverarbeitung, Batch, punktuelle Spitzen |
| 4 | Überschüssige Kapazität | Sehr niedriger OPEX | − | − | ± | Stunden | Knappes Budget, geprüfter Betreiber |
| 5 | Inferenzanbieter | Pro Token | ++ | − | ± | Minuten | Die meisten Projekte |
| 6 | Multi-Provider-Gateway | Pro Token, plus die Schicht | ++ | +++ | ± | Tage | Sobald ein echtes Serviceniveau erwartet wird |
| 7 | Schlüsselfertige Plattform | Abonnement | +++ | +++ | ± | Minuten | Sie kaufen ein fachliches Ergebnis |
In der Praxis kombiniert ein Unternehmen oft mehrere Lösungen
Ein einziger Ansatz kann durchaus genügen, und das ist oft der Fall, wenn der Umfang klar und die Nutzung einheitlich ist. Sobald sich die Use Cases jedoch auffächern, landen Unternehmen regelmäßig bei zwei oder drei verschiedenen Betriebsmodellen. So oder so ist die härteste Vorgabe der richtige Ausgangspunkt, und der Rest ordnet sich darum herum.
Eine regulatorische Vorgabe betrifft fast nie Ihren gesamten Umfang. Der wirklich sensible Use Case lässt sich auf dedizierter Infrastruktur isolieren, der Rest bleibt auf geteilter. Oft ist es genau diese Aufteilung, die ein Budget freigibt, weil sie die hohe Anforderung auf den Teil des Projekts beschränkt, den sie wirklich betrifft.
Wenn die Latenz den Ausschlag gibt, betrifft sie nur das Interaktive. Ein Unternehmen, das wir begleiten, lässt seine nächtliche Dokumenten-Neuindexierung für ein paar Dutzend Euro im Monat auf GPUs bei Bedarf laufen und bedient seinen Assistenten tagsüber über einen schnellen Inferenzanbieter. Zwei Kostenmodelle, ein Projekt.
Und wenn es das Budget ist: Beginnen Sie ohne Zögern mit Ansatz 5 oder 7. Sechs Monate echter Nutzung zeigen Ihnen, ob eine Internalisierung überhaupt Sinn ergibt. Sie ist fast immer teurer als geplant, und niemand merkt es, bevor die Zahlen auf dem Tisch liegen.
Zur Einordnung der Größenordnungen hier dieselbe H100 aus drei Blickwinkeln:
| Zugang zu einer H100 | Kosten | Berechnungsgrundlage |
|---|---|---|
| Kauf | ~30.000 $, also ~26.000 €, nur die Karte | Marktpreis PCIe und SXM5 |
| Dedizierte Miete, 24/7 | ~2.000 € pro Monat | Scaleway, 2,73 €/h × 730 h |
| Bei Bedarf, 2 h pro Nacht | ~98 $ pro Monat | Verda Spot, 1,63 $/h × 60 h |
Die Hardware ist in allen drei Fällen identisch, nur das Nutzungsmodell ändert sich.
Wie lange muss man mieten, bis man den Preis der Karte ausgegeben hat? Im Dauerbetrieb, bei 2.000 € im Monat, brauchen Sie dreizehn Monate, um die 26.000 € des Kaufs zu erreichen. Im Bedarfsmodell, bei 85 € im Monat, brauchen Sie mehr als fünfundzwanzig Jahre.
Genau hier fällt die Entscheidung, nirgendwo sonst. Der Kauf lohnt sich erst, wenn Sie wissen, dass die Maschine wirklich durchgehend läuft, über mehrere Jahre, mit Volumen, die Sie bereits gemessen haben.
Bei Ask This Guy
Heute befinden sich unsere Kunden in Fall 7. Sie betreiben keine GPU, bauen kein Gateway, und die Inferenz taucht in ihrem Budget nicht auf.
Das funktioniert nur, weil wir selbst die Ansätze 2, 3 und 5 kombinieren. Wir bauen unsere eigenen GPU-Infrastrukturen bei Verda in Finnland und Island auf, wo wir bestimmte Modelle bereitstellen und betreiben, und nutzen parallel ausgewählte Inferenzanbieter hinter unserem Gateway für KI-Anbieter. Den Regler stellen dann Sie ein, Richtlinie „nur EU“ oder „weltweit“, jederzeit in der Konsole änderbar. Alles ist öffentlich in unserem Ansatz für souveräne KI beschrieben.
Wenn wir diesen Artikel schreiben, dann weil wir die hier beschriebenen Abwägungen selbst bezahlt haben.
Bring Your Own AI: Ihre eigene Inferenz anbinden
Fall 7 sollte keine Sackgasse sein. Wenn Sie bereits GPUs, einen Vertrag bei einem Inferenzanbieter oder Ihr eigenes Gateway haben, sollten Sie diese anbinden können, statt sie auszumustern.
Genau das ermöglicht unser Modus Bring Your Own AI: Ihre eigenen Modelle, Ihre Anbieter oder Ihre Inferenz-Endpunkte mit der Plattform verbinden. Er ist heute auf Anfrage verfügbar und wird bald standardmäßig angeboten.
Konkret bleiben die sechs anderen Ansätze offen. GPUs, die letztes Jahr gekauft wurden, lassen sich anbinden. Ein ausgehandelter Preis bei einem Inferenzanbieter bleibt erhalten. Und wenn Sie lieber schlüsselfertig starten, um in achtzehn Monaten zu internalisieren, sobald Ihre Volumen wirklich bekannt sind, müssen Sie unterwegs nicht das Tool wechseln.
Häufige Fragen zur KI-Inferenz
Was ist Inferenz in der KI?
Inferenz ist die Phase, in der ein bereits trainiertes Modell der künstlichen Intelligenz eine Anfrage verarbeitet und eine Antwort erzeugt. Sie steht im Gegensatz zum Training, der Lernphase des Modells. Für ein Unternehmen ist das Training ein seltener und oft gar nicht anfallender Kostenpunkt, während die Inferenz wiederkehrende Kosten verursacht, die proportional zur tatsächlichen Nutzung des Dienstes sind.
Was kostet LLM-Inferenz im Unternehmen?
Die Kosten der LLM-Inferenz hängen vollständig vom gewählten Ansatz ab. Bei der Miete einer dedizierten GPU kostet eine H100 im Dauerbetrieb etwa 2.000 bis 2.400 € im Monat, also knapp 24.000 € im Jahr für eine einzige Karte, und ein Server mit acht Karten übersteigt 200.000 € im Jahr. Über einen Inferenzanbieter mit Abrechnung pro Token kostet ein interner Assistent für einige Hundert Nutzer meist einige Hundert Euro im Monat. Der Abstand zwischen beiden Modellen spricht dafür, die eigenen Volumen zu messen, bevor man internalisiert.
Muss man GPUs kaufen, um im Unternehmen KI zu nutzen?
In den allermeisten Fällen nicht. Der Kauf von GPUs ist gerechtfertigt, wenn eine regulatorische Vorgabe jeden Datenabfluss verbietet, wenn das Volumen massiv und stabil ist und wenn bereits ein Infrastrukturteam für den Betrieb der Hardware existiert. Außerhalb dieser Bedingungen ist die Miete oder ein Inferenzanbieter günstiger und in Minuten statt Monaten eingerichtet.
Was ist eine KI-Infrastruktur?
Eine KI-Infrastruktur umfasst alles, was zum Ausführen von KI-Modellen nötig ist: die GPUs, die Server, auf denen sie laufen, Netzwerk, Speicher und die Softwareschicht, die die Modelle bereitstellt. Im Unternehmen geht es nicht nur darum, welche Komponenten man wählt, sondern wer sie betreibt: Sie selbst, ein Cloud-Anbieter, ein Inferenzanbieter oder der Hersteller Ihrer Plattform.
Was ist der Unterschied zwischen einem Inferenzanbieter und einem API-Gateway?
Ein Inferenzanbieter führt die Modelle selbst auf seinen eigenen GPUs aus und stellt Ihnen die verbrauchten Token in Rechnung. Ein API-Gateway oder Multi-Provider-Gateway führt kein Modell aus: Es sitzt vor mehreren Anbietern, misst deren Verfügbarkeit und Geschwindigkeit und schaltet automatisch von einem zum anderen um. In der Regel nutzt man beides zusammen, wobei das Gateway ein Serviceniveau ermöglicht, das kein Anbieter allein erreicht.
Fazit
Ihr KI-Projekt wird Sie zwingen, die Frage der Inferenz zu entscheiden, wahrscheinlich schon bei der Budgetplanung. Sie können Ihre eigene KI-Infrastruktur aufbauen, alles delegieren oder etwas dazwischen zusammenstellen.
Die Projekte, die sich in Produktion halten, sind nicht die, die das richtige Lager gewählt haben. Es sind die, die wussten, dass es sieben gibt.
Wenn Sie ein KI-Projekt vorbereiten und Ihren Use Case mit diesen Abwägungen abgleichen möchten: Buchen Sie eine Demo.