Olala mini: Was das erste OVH-LLM ohne GPU wirklich taugt
Olala mini 7A1B, das erste OVH-LLM, läuft ohne Grafikkarte. Was 7A1B bedeutet, was die Zahlen verschweigen und wofür sich das Modell im Unternehmen eignet.

Am 17. November 2026 hat OVH Olala mini 7A1B angekündigt, sein erstes LLM und den Auftakt einer Modellfamilie namens Olala. Die Gewichte sollen laut AFP ab Donnerstag, dem 19. November, auf Hugging Face verfügbar sein, unter der Lizenz Apache 2.0, am Tag des AI Summit von OVHcloud in Paris.
Das Modell, das Octave Klaba im Oktober in der französischen Wirtschaftszeitung La Tribune als „seiner Zeit weit voraus“ angekündigt hatte (eigene Übersetzung), ist ein kleines Modell: 7 Milliarden Parameter, von denen nur eine Milliarde für jedes erzeugte Wort arbeitet. Laut OVH läuft es auf einem einfachen Prozessor, ohne Grafikkarte. OVH zielt auf einfache Aufgaben zu sehr geringen Kosten und überlässt den Rest den großen Modellen.
Was es taugt, weiß noch niemand: OVH hat Geschwindigkeiten veröffentlicht, aber keinen einzigen Qualitätswert. Für ein Unternehmen liegt der Reiz in dem, was das Modell lokal auf gewöhnlichen Rechnern leisten könnte, und genau das wird ab der Veröffentlichung der Gewichte zu messen sein.
Was ist Olala mini, das LLM von OVH?
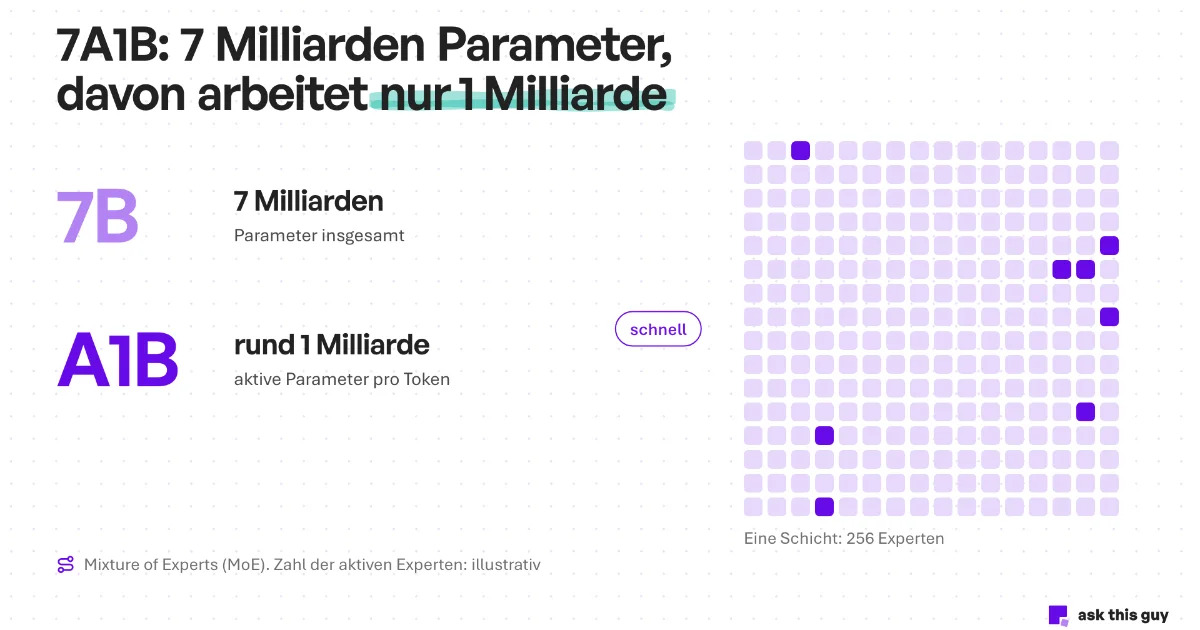
Olala mini 7A1B ist ein kompaktes Sprachmodell mit offenen Gewichten, von OVH von Grund auf trainiert. Der Name liest sich wie ein Datenblatt: 7 Milliarden Parameter insgesamt, davon eine Milliarde aktiv pro Token, also pro Wort oder Wortteil, das das Modell liest oder schreibt.
Der Unterschied zwischen Gesamt- und aktiven Parametern kommt von der Architektur. Olala mini ist ein Mixture-of-Experts-Modell (MoE): Jede Schicht des Modells ist in 256 kleine Teilnetze aufgeteilt, die Experten, und ein Router weckt für jeden Token nur einige davon. Das Modell speichert 7 Milliarden Parameter, rechnet aber pro Token nur mit einer Milliarde. Unser Leitfaden Mixture of Experts oder dichtes Modell erklärt diesen Kompromiss.
Der Rest des Datenblatts ist ungewöhnlich. OVH beschreibt eine hybride Attention „Differential-TPA“, kombiniert mit Mamba-3-Schichten. Dahinter stehen drei neuere Forschungsideen, von anderen veröffentlicht:
- der Differential Transformer von Microsoft Research (2024) berechnet die Attention als Differenz zweier Attention-Karten, um das Rauschen auf unwichtigen Wörtern zu dämpfen;
- die Tensor Product Attention (2025) komprimiert die Schlüssel und Werte, die das Modell beim Lesen eines Textes im Speicher hält;
- Mamba-3 (2026) von Albert Gu, Tri Dao und ihren Koautoren ersetzt einen Teil der Attention durch ein Zustandsraummodell, dessen Kosten nicht mit der Textlänge steigen.
Alle drei verfolgen dasselbe Ziel: weniger Speicher und mehr Tempo beim Antworten. Wie OVH sie kombiniert, ist nicht beschrieben; das französische Tech-Portal Next merkt an, dass der „neuartige“ Charakter der Architektur noch zu belegen ist. Der technische Bericht, angekündigt zusammen mit den Gewichten, dürfte es zeigen.
Die Ankündigung spricht von „Open Source“, doch OVH stellt die Gewichte, das Basismodell, einen technischen Bericht und eine Dokumentation zur Konformität mit dem AI Act in Aussicht, weder den Trainingscode noch die Daten. Olala mini ist also ein Open-Weights-Modell wie Llama oder Qwen; den Unterschied erklärt unser Artikel Open Weights vs. Open Source. Apache 2.0 gehört zu den freizügigsten Lizenzen: kommerzielle Nutzung, Änderung und Weitergabe ohne Schwelle und ohne Vertrag.
Warum läuft es ohne Grafikkarte?
Weil es wenig rechnet. Ein Grafikprozessor ist dafür gebaut, riesige Matrizen sehr schnell zu multiplizieren; ein klassischer Prozessor tut das langsam. Mit einer Milliarde aktiver Parameter pro Token verlangt Olala mini ungefähr den Rechenaufwand eines Modells, das siebenmal kleiner ist als seine Gesamtgröße, und das bleibt für einen aktuellen Server- oder Arbeitsplatzprozessor machbar.
Die angekündigten Zahlen passen dazu. Laut der Pressemitteilung von OVH erreicht das Modell 160 Tokens pro Sekunde auf einer RTX A4500, einer professionellen Grafikkarte, und 50 Tokens pro Sekunde ohne GPU, auf einem einfachen Prozessor. Das Kontextfenster, also die Textmenge, die das Modell auf einmal lesen kann, umfasst 32.000 Tokens, einige Dutzend Seiten.
Beim Speicher geht die Rechnung dagegen nicht auf. OVH nennt eine GPU mit mindestens 8 GB, doch ein MoE muss alle Experten im Speicher halten, auch die schlafenden: 7 Milliarden Parameter im Format BF16 wiegen rund 14 GB, bei zwei Byte pro Parameter. ActuIA weist auf die Lücke hin, ein französisches Fachportal für KI, und vermutet eine komprimierte Version oder ein teilweises Laden der Experten, was die Ankündigung nicht erklärt. Dasselbe Portal stellt fest, dass die RTX A4500 der Messung 20 GB Speicher hat, nicht 8, und der Prozessor der 50 Tokens pro Sekunde wird nicht genannt. Zu diesen Durchsätzen gibt es zudem keine Testbedingungen, weder Textlänge noch Zahl gleichzeitiger Anfragen, betont Next.
Ein Ausschlusskriterium ist das nicht: Auf 8 Bit komprimiert wiegen 7 Milliarden Parameter rund 7 GB, auf 4 Bit 3,5 GB, um den Preis eines Qualitätsverlusts, der zu messen sein wird. Die tatsächliche Konfiguration wird man aber in den am Donnerstag veröffentlichten Dateien ablesen, nicht in der Ankündigung.
Was taugt Olala mini im Vergleich zu anderen kleinen LLM aus Europa und China?
Heute lässt sich das nicht sagen, und das ist der wichtigste Vorwurf an diese Ankündigung. OVH hat Geschwindigkeiten veröffentlicht, aber keinen einzigen Qualitätswert. Dabei hatte Octave Klaba am 20. Oktober gegenüber La Tribune versprochen, die Kunden könnten „seine Geschwindigkeit, seinen Speicherverbrauch und die Qualität seiner Antworten sehen“ (eigene Übersetzung). Zwei von dreien, bisher.
Die Konkurrenz ist bekannt. In derselben Klasse veröffentlicht Mistral, das andere französische KI-Labor, Ministral 3 mit 3, 8 und 14 Milliarden Parametern, und Alibaba aus China Qwen 3.5 9B, alle unter Apache 2.0. OVH bietet Qwen 3.5 9B sogar schon über seinen API-Dienst AI Endpoints an, für 0,12 Dollar pro Million Input-Tokens. Olala mini muss zeigen, dass es mindestens ebenso gut ist, gerade in europäischen Sprachen, damit sich ein Modellwechsel lohnt.
Die einzige Erfahrung aus dem Einsatz kommt von Qwant, das das Modell laut der Pressemitteilung für seine „Flash-Antwort“ übernommen hat: 20 % schnellere Antworten und ein Drittel der Betriebskosten im Vergleich zum vorherigen Modell, laut Next ein Modell von Mistral. Die Zahl stammt von OVH, nicht von Qwant, und der Kunde ist nicht unabhängig: Qwant wird von Synfonium kontrolliert, zu 75 % im Besitz von Octave und Miroslaw Klaba, den Gründern von OVH. Ein erster Kunde aus dem eigenen Haus ist nichts Ungewöhnliches; er beweist aber nicht, dass das Modell auch für andere taugt.
Letzte Grenze: der Kontext. 32.000 Tokens reichen, um eine Frage zu beantworten oder ein kurzes Dokument zusammenzufassen. Um eine Dokumentenbasis abzufragen oder einen Agenten an einer langen Akte arbeiten zu lassen, ist das wenig: Qwen 3.8 27B liest im selben OVH-Katalog 262.144 Tokens. OVH kündigt 128.000 Tokens für Version 1.1 bis Jahresende an.
Hat OVH seine Wette geändert?
Ja, und das ist eher eine gute Nachricht. Im Juni 2026 wollte OVHcloud laut Reuters KI-Spitzenmodelle entwickeln. Im Oktober verengte sich der Anspruch auf drei Bereiche, Cybersicherheit, Code und Fach-Agenten, und das erste Modell sollte „nicht genau alle drei“ abdecken. Im November erscheint ein kleines Allzweckmodell; die spezialisierten Modelle sind auf eine Version 2.0 verschoben, die laut der Pressemitteilung mehr als 100 Milliarden Parameter haben wird, ohne Datum.
Der Zeitplan dagegen wurde eingehalten. Octave Klaba hatte La Tribune eine Veröffentlichung „Ende November“ angekündigt, während Reuters am selben Tag ein erstes Modell „in early 2027“ meldete. Recht hatte La Tribune. Unser Artikel über die KI-Strategie von OVHcloud beschreibt, was rund um dieses Modell schon existierte, von den GPUs bis zu AI Endpoints.
Die Mittel sind bescheiden, und OVH steht dazu. Trainiert wurde auf drei öffentlichen europäischen Supercomputern, Jupiter in Deutschland, MeluXina in Luxemburg und Jean Zay, dem nationalen Forschungsrechner in Frankreich, dank einer öffentlichen Förderung, die laut OVH dem Gegenwert von 7 Millionen Euro an Rechenzeit entspricht. Dieser Betrag sind nicht die Kosten des Modells, die niemand veröffentlicht hat. Beim Personal spricht Octave Klaba gegenüber der AFP von etwas weniger als hundert Personen für KI, verteilt auf drei Pariser Labore, gegenüber mehr als 1.000 Beschäftigten bei Mistral. „Wir wollen zeigen, dass man ein Modell mit wenig Mitteln trainieren kann“, fügt er hinzu (eigene Übersetzung).
Die Begründung ist in der Pressemitteilung dieselbe geblieben: Man könne sich nicht einfach auf die Großzügigkeit bestimmter Labs verlassen, die ihre LLM als Open Source teilen. „Das heutige Open Source ist chinesisch“, fasste er im September vor der französischen Nationalversammlung zusammen (eigene Übersetzung), und die Anbieter verschärfen bereits die Lizenzen ihrer Flaggschiffmodelle. Wir halten diese verkleinerte Wette für richtig. Ein veröffentlichtes kleines Modell ist mehr wert als ein versprochenes großes: Jeder kann es testen und vergleichen, und OVH lernt dabei das Trainieren, womit der Kauf von Dragon LLM im März begonnen hatte. Offen bleibt, ob ein Anbieter dieser Größe bei Version 2.0, wo die Kosten eine andere Größenordnung erreichen, mit dem Tempo der großen Labore mithalten kann.
Lagert OVH die Inferenz aus?
Für Olala mini selbst stellt sich die Frage nicht: Gewichte unter Apache 2.0 laufen dort, wo man sie installiert. Sie stellt sich für den Dienst, der das Modell bereitstellen wird, und OVH hat noch nicht gesagt, ob Olala in AI Endpoints aufgenommen wird. Für diesen Dienst lautet unsere Antwort: Nein, kein Dritter betreibt die Modelle, mit zwei Einschränkungen.
Das in der KI-Souveränität am häufigsten vergessene Kriterium ist der Betreiber, also das Unternehmen, das die Grafikprozessoren tatsächlich laufen lässt. Mistral schließt seine Verträge über eine französische Gesellschaft, doch seine Liste der Unterauftragsverarbeiter nennt CoreWeave als Inferenzanbieter und Microsoft und Google als Infrastruktur. Das sind US-Unternehmen, die dem US-Recht unterliegen, auch wenn ihre Server in Europa stehen, wie wir in unserem Artikel über CoreWeave erklärt haben.
Bei OVH verweist die Liste der Unterauftragsverarbeiter des Konzerns auf die Bedingungen jedes Dienstes, um externe Unternehmen zu benennen. Die Bedingungen von AI Endpoints nennen keines und halten fest, dass OVH die Wartung selbst übernimmt, während dasselbe Dokument für die verwalteten Datenbanken Aiven nennt. Vertragspartner ist die OVH SAS, und das Kapital wird zu fast 80 % von der Familie Klaba kontrolliert. Vertragspartner, Betreiber und Kontrolle sind also europäisch: AI Endpoints gehört damit neben Scaleway zur kleinen Gruppe der durchgängig europäischen Inferenzdienste, nach den Kriterien unserer Seite über souveräne KI. Es sind auch die beiden Inferenzanbieter, die ATG nutzt.
Erste Einschränkung: Der Standort steht nicht im Vertrag. Seit dem 10. November beschreibt die Dokumentation die Infrastruktur als „hosted in Europe“ und nennt Gravelines nicht mehr. Der Katalog gibt Frankreich für jedes der 21 Modelle an, und die Adresse des Dienstes zeigt auf einen Load Balancer von OVH in Gravelines: starke Indizien, aber keine Zusage. Auch die Tochtergesellschaften von OVH in Kanada und im Vereinigten Königreich stehen auf der Liste der Unterauftragsverarbeiter des Konzerns, für alle Dienste außer SecNumCloud und Trusted Cloud.
Zweite Einschränkung: SambaNova. Ein Teil von AI Endpoints läuft auf den Maschinen dieses US-Herstellers. Er ist nicht als Unterauftragsverarbeiter angegeben, verarbeitet also im Sinne des Vertrags keine Daten, aber nichts sagt, ob er seine Maschinen aus der Ferne verwaltet. Ein letztes Detail zählt für Entwickler: Wer OVH über Hugging Face aufruft, für das OVH seit November 2025 Inferenzanbieter ist, schickt seine Anfragen über ein US-Unternehmen.
Wofür kann Olala mini im Unternehmen dienen?
Kleine Modelle haben ein klares Terrain: einfache Aufgaben, die sich tausendfach wiederholen. Nachrichten einordnen, Felder aus einem Formular extrahieren, umformulieren, eine Sprache erkennen, kurz auf Basis eines vorgegebenen Textes antworten. Für solche Aufgaben kann ein Modell mit einer Milliarde aktiver Parameter genügen, und seine Kosten pro Anfrage werden vernachlässigbar.
Olala mini bringt zwei zusätzliche Argumente mit. Es läuft auf gewöhnlicher Hardware: einem vorhandenen Server, einer Workstation, vielleicht einem Laptop, ohne Kauf einer Grafikkarte. Und dank Apache 2.0 lässt es sich überall installieren, auch auf Rechnern ohne Internetverbindung, was die Frage, wer die Daten sieht, auf einen Schlag klärt. Unser Artikel über den lokalen KI-Server beziffert die nötige Hardware für ein größeres Modell.
Die Grenzen sind ebenso deutlich. Um ein Dokument zu verfassen, über eine Akte nachzudenken, zu programmieren oder einen Agenten zu steuern, bleibt aus unserer Sicht ein Modell mit 27 Milliarden Parametern oder mehr nötig, und 32.000 Tokens Kontext schließen lange Dokumente aus. Olala mini ist am 17. November auch nicht im Katalog von AI Endpoints verfügbar: Wer es nutzen will, muss es zumindest anfangs selbst hosten.
Was eine IT-Abteilung daraus mitnehmen kann
Nichts drängt, und nichts spricht gegen einen Versuch. Der richtige Reflex besteht aus unserer Sicht aus vier Punkten:
- Die Gewichte und den technischen Bericht vom 19. November abwarten, bevor man Schlüsse zieht: tatsächliche Dateigröße, komprimierte Versionen, veröffentlichte Werte, abgedeckte Sprachen.
- Das Modell mit den eigenen Daten testen, an einer einfachen Aufgabe mit großem Volumen, im Vergleich zum bereits eingesetzten kleinen Modell (Ministral 3, Qwen 3.5 9B oder ein kleines proprietäres Modell). Die angekündigte Geschwindigkeit sagt nichts über die Qualität in einem echten Anwendungsfall.
- Die Gewichte und die Lizenzdatei der getesteten Version archivieren: Eine unter Apache 2.0 veröffentlichte Version bleibt es, was auch immer OVH danach entscheidet.
- Kein Einheitsmodell daraus machen: Ein LLM-Gateway leitet einfache Aufgaben an ein kleines Modell und den Rest an ein größeres weiter und erlaubt den Modellwechsel, ohne die Anwendung neu zu schreiben.
Häufige Fragen zu Olala, dem LLM von OVH
Was ist Olala mini 7A1B?
Olala mini 7A1B ist das erste große Sprachmodell von OVH, angekündigt am 17. November 2026. Es ist ein Mixture-of-Experts-Modell mit 7 Milliarden Parametern, von denen rund 1 Milliarde pro Token aktiv ist, verteilt auf 256 Experten pro Schicht. Es kombiniert eine hybride Attention (Differential-TPA) mit Mamba-3-Schichten, liest 32.000 Tokens Kontext und wird unter der Lizenz Apache 2.0 veröffentlicht.
Wann ist Olala verfügbar?
OVH hat Olala mini am 17. November 2026 angekündigt. Die Gewichte, das Basismodell, ein technischer Bericht und eine Dokumentation zur Konformität mit dem AI Act werden am Donnerstag, dem 19. November, auf Hugging Face erwartet, dem Tag des OVHcloud AI Summit in Paris. Eine Version 1.1 mit 128.000 Tokens Kontext ist bis Ende 2026 geplant, eine Version 2.0 mit mehr als 100 Milliarden Parametern ohne Datum.
Ist Olala Open Source?
Nicht im strengen Sinn. OVH veröffentlicht die Gewichte des Modells unter Apache 2.0, einer Lizenz, die kommerzielle Nutzung, Änderung und Weitergabe erlaubt. Weder der Trainingscode noch die Trainingsdaten sind laut Next angekündigt: Olala mini ist ein Open-Weights-Modell wie Llama, Qwen oder Ministral.
Ist Olala ein europäisches LLM?
Ja, nach Herkunft und Training. Olala mini wurde von OVH trainiert, einem französischen Unternehmen, und zwar auf drei öffentlichen europäischen Supercomputern: Jupiter in Deutschland, MeluXina in Luxemburg und Jean Zay in Frankreich. Die Gewichte erscheinen unter Apache 2.0 und lassen sich damit auf eigenen Servern betreiben. In seiner Größenklasse ist das andere europäische Angebot Ministral 3 von Mistral, mit 3, 8 und 14 Milliarden Parametern; ein Qualitätsvergleich zwischen beiden ist noch nicht veröffentlicht.
Läuft Olala ohne Grafikkarte?
Laut OVH ja: Das Modell soll 50 Tokens pro Sekunde auf einem einfachen Prozessor erreichen und 160 Tokens pro Sekunde auf einer RTX A4500. Diese Durchsätze stammen aus der Ankündigung, ohne Testbedingungen. Die 7 Milliarden Parameter wiegen in BF16 rund 14 GB: Die angekündigten 8 GB Speicher setzen eine komprimierte Version voraus, was in den veröffentlichten Dateien zu prüfen ist.
Ist Olala bei OVHcloud AI Endpoints verfügbar?
Am 17. November 2026 nicht. Das Modell erscheint weder im Katalog von AI Endpoints noch in der Modellliste der API, und OVH hat keinen Nutzungspreis angekündigt. Zumindest anfangs muss man es also selbst hosten, auf Basis der auf Hugging Face veröffentlichten Gewichte.
Lagert OVH die Inferenz von AI Endpoints aus?
Nein, laut seinen Vertragsdokumenten. Die Bedingungen von AI Endpoints nennen keinen dritten Unterauftragsverarbeiter, obwohl die Liste der Unterauftragsverarbeiter von OVH für konzernfremde Unternehmen auf diese Bedingungen verweist, und OVH übernimmt die Wartung des Dienstes selbst. Zwei Einschränkungen: Der Hosting-Standort ist vertraglich nicht garantiert (die Dokumentation sagt „Europa“, der Katalog gibt für alle Modelle Frankreich an), und die Rolle von SambaNova, auf dessen Maschinen ein Teil des Dienstes läuft, ist nicht dokumentiert.
Ist Olala ein Konkurrent von Mistral?
Bei den kleinen Modellen ja, und schon bei einem Kunden: Qwant hat laut Next ein Modell von Mistral für seine „Flash-Antwort“ durch Olala mini ersetzt. Mit 7 Milliarden Parametern tritt Olala mini gegen die Ministral-3-Modelle von Mistral an (3, 8 und 14 Milliarden), alle unter Apache 2.0, ohne bisher veröffentlichten Qualitätsvergleich. Darüber hinaus spielen die beiden nicht dasselbe Spiel: Mistral verkauft auch große Modelle und begleitet die Unternehmen, die sie einsetzen, mit laut AFP mehr als 1.000 Beschäftigten, während OVH etwas weniger als hundert Personen für KI beschäftigt. Die Version 2.0 von Olala mit mehr als 100 Milliarden Parametern würde die beiden bei den großen Modellen annähern, hat aber noch keinen Termin.
Vorerst beweist Olala mini, dass OVH ein Modell trainieren und veröffentlichen kann; seine Qualität muss es noch zeigen. Die spannende Frage kommt am Donnerstag, mit den Gewichten: Kann ein kompaktes europäisches Modell ohne Lizenzbeschränkung bei den einfachen Aufgaben eines europäischen Unternehmens gegen Qwen und Ministral bestehen? Die Werte im technischen Bericht werden einen ersten Hinweis geben, und erst Tests an echten Anwendungsfällen werden zeigen, ob es einen Platz in der IT-Landschaft verdient.