OVHcloud AI Endpoints und LLM: Was Klabas KI-Strategie taugt
OVHcloud kündigt ein eigenes LLM an und will die ganze KI-Kette. Was AI Endpoints und die GPUs heute leisten, was offen bleibt, was CIOs daraus lernen.

Am 20. Oktober 2026, dem Tag der Jahreszahlen, kündigte Octave Klaba in La Tribune an, dass OVHcloud das Training seines ersten LLM abschließt: „Wir wollen es Ende November als Open Source veröffentlichen“. Am selben Tag zitiert ihn Reuters damit, dass das erste Modell „in early 2027“ erscheinen werde. Erschienen ist es am 17. November unter dem Namen Olala mini 7A1B, ein kleines Modell mit 7 Milliarden Parametern, das wir in einem eigenen Artikel analysieren. Das Modell ist nur ein Baustein: Bei KI will OVH die gesamte Kette beherrschen, vom Grafikprozessor bis zur Anwendung.
Ein guter Teil dieser Kette existiert bereits. OVHcloud vermietet GPUs, orchestriert das Training und verkauft mit seinem Dienst OVHcloud AI Endpoints Tokens, also den Zugang zu KI-Modellen, abgerechnet nach verarbeiteter Textmenge. Bei gpt-oss-120b ist das Angebot günstiger als Scaleway und IONOS. Die neuesten offenen Modelle bietet es jedoch erst mit Verzögerung an, und bei der Geschwindigkeit liegt es zurück.
Octave Klabas zentrales Argument, die Angst vor der Abhängigkeit von einem Modellanbieter, betrifft alle Unternehmen.
Was will OVHcloud mit KI erreichen?
Die KI-Strategie von OVHcloud besteht darin, KI durchgängig aus den eigenen Rechenzentren zu verkaufen, ohne von einem Zwischenhändler abzuhängen. Octave Klaba, seit dem 20. Oktober 2025 wieder an der Spitze des Unternehmens, beschreibt sie in La Tribune in fünf Schichten:
- die GPUs, installiert in den eigenen Rechenzentren;
- ihre Orchestrierung, für Training und Inferenz;
- „Tokens as a Service“, mit „der Frage nach ihrem Preis und ihrer Qualität“;
- die Werkzeuge, um mit KI entwickelte Anwendungen zu hosten;
- die Anwendungsfälle, mit OVHai workspace, einer KI-gesteuerten Suite für E-Mail, Speicher und Videokonferenzen.
Der Startvorteil ist physischer Natur. OVHcloud verfügt über 250 MW angeschlossene elektrische Leistung, davon 140 MW in Betrieb, in eigenen Gebäuden, und baut seine Server in eigenen Fabriken. In seinem Brief an die Aktionäre vom 20. Oktober geht Octave Klaba noch weiter: „Zum ersten Mal werden einige unserer neuen Produkte nicht mehr für Menschen bestimmt sein, sondern für KI-Agenten.“
Die Zahlen des Tages stützen ihn. Der Umsatz des am 31. August abgeschlossenen Geschäftsjahres 2026 erreicht 1.145,1 Millionen Euro, ein organisches Plus von 7,2 %, und die Public Cloud, zu der das KI-Angebot gehört, wächst um 18,9 %. Der freie Cashflow ist zum ersten Mal seit dem Börsengang positiv. Die Aktie legte am Vormittag fast 10 % zu.
Was gibt es bei OVHcloud schon?
GPUs und Orchestrierung
OVHcloud vermietet Nvidia-GPUs stundenweise: Eine H100 kostet 2,80 € netto pro Stunde, eine Instanz mit acht H200 kostet 42 € pro Stunde. Mit den Diensten AI Training, AI Notebooks und AI Deploy lässt sich ein Modell auf diesen GPUs trainieren oder bereitstellen, bei minutengenauer Abrechnung. Zwei Einschränkungen: Instanzen mit acht H200 gibt es nur in Paris (AI Training, AI Notebooks und AI Deploy bieten sie in Viererblöcken in Gravelines an), und Nvidias Blackwell-Generation ist noch nicht im Katalog. Im Juni vermerkte OVHcloud auf seiner öffentlichen Roadmap, seine H200 seien „fully allocated due to high demand“.
Die Tokens: AI Endpoints
AI Endpoints ist das Inferenzangebot von OVHcloud: eine OpenAI-kompatible API, die Zugang zu Open-Weight-Modellen bietet, gehostet in Gravelines in Nordfrankreich. Der Dienst startete im April 2025. Auf dieser Schicht misst sich OVHcloud direkt mit Scaleway, IONOS und den APIs der großen KI-Labore. Wir gehen weiter unten ausführlich darauf ein.
Die Anwendungsfälle: OVHai workspace
OVHai workspace wurde am 17. Juni 2026 auf der VivaTech als Vorschau vorgestellt: E-Mail, Speicher, Videokonferenz und eine von Agenten übernommene Suche, mit optionaler Ende-zu-Ende-Verschlüsselung. Eine Beta war für die Hausmesse von OVHcloud im November angekündigt. Das Unternehmen sagt, es nutze die Suite zunächst intern, um produktiver zu werden.
OVHcloud AI Endpoints: Was taugen die Tokens heute?
Günstiger als Scaleway und IONOS bei mehreren Modellen
Bei den Modellen, die auch die europäischen Wettbewerber anbieten, verlangt OVHcloud niedrige Preise, oft die niedrigsten. Preise erhoben am 20. Oktober 2026 auf den Preislisten von OVHcloud, Scaleway und IONOS:
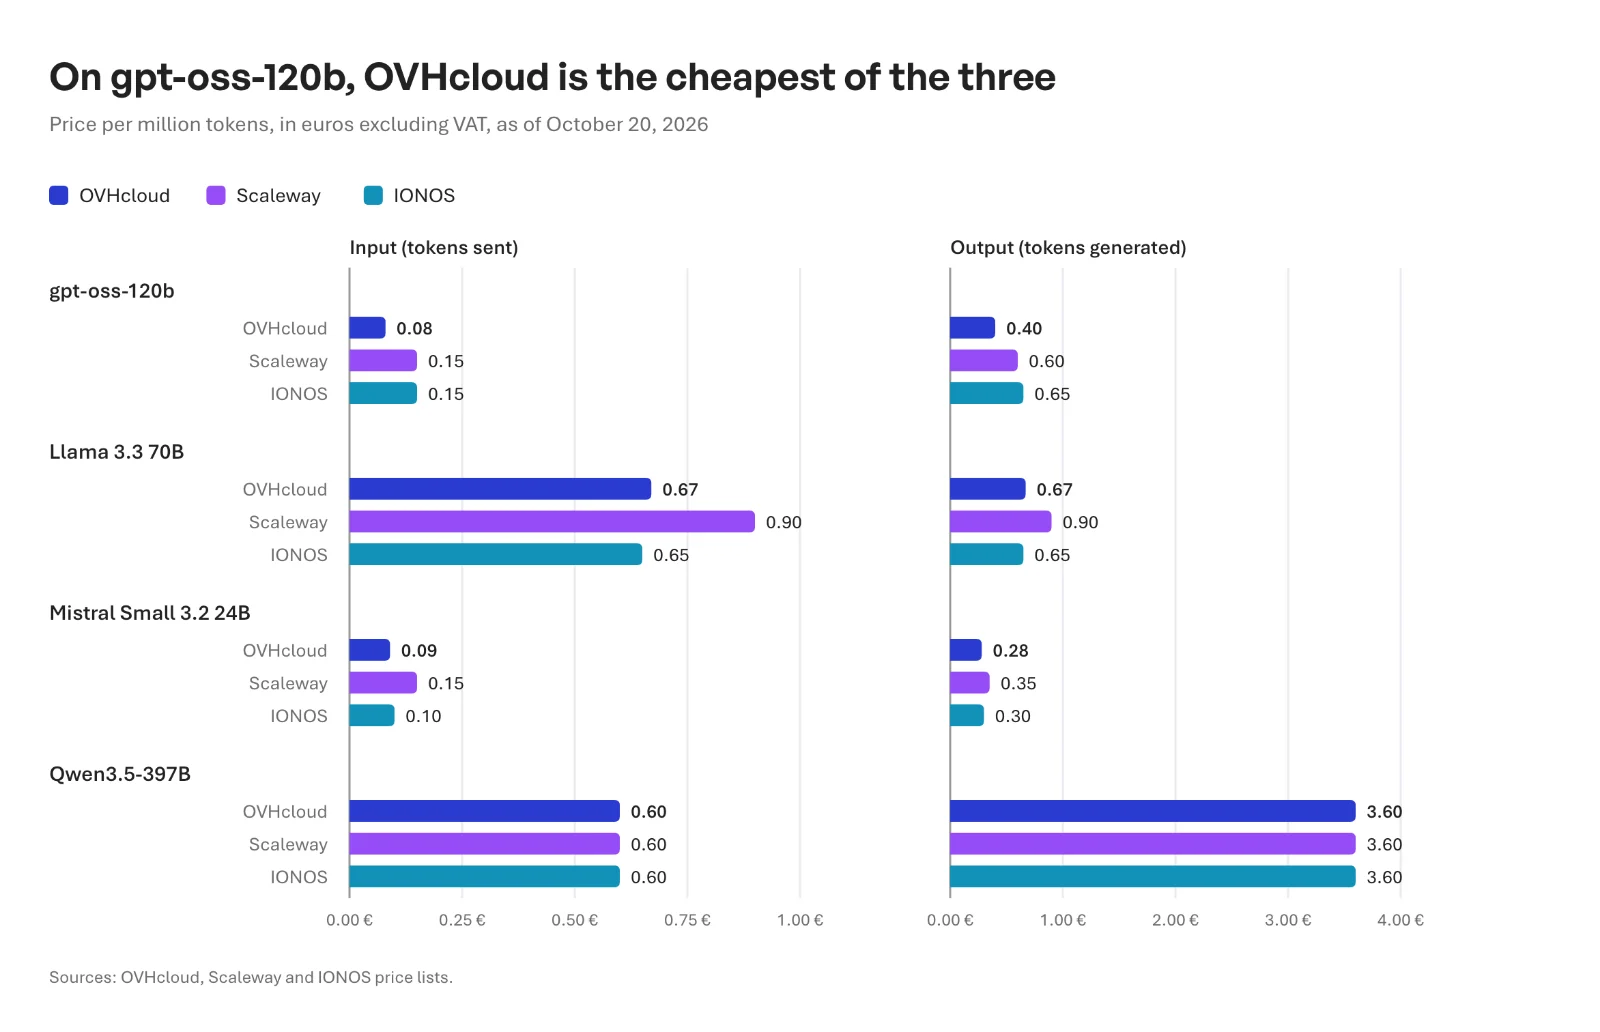 Preis pro Million Tokens in Euro netto am 20. Oktober 2026, erst Input, dann Output. gpt-oss-120b: OVHcloud 0,08 und 0,40, Scaleway 0,15 und 0,60, IONOS 0,15 und 0,65. Llama 3.3 70B: OVHcloud 0,67 und 0,67, Scaleway 0,90 und 0,90, IONOS 0,65 und 0,65. Mistral Small 3.2 24B: OVHcloud 0,09 und 0,28, Scaleway 0,15 und 0,35, IONOS 0,10 und 0,30. Qwen3.5-397B: 0,60 und 3,60 bei allen dreien
Eine Batch-API, seit Juni in der Beta, halbiert die Rechnung noch einmal für Verarbeitungen, die einen Tag oder länger warten können. Bei der Souveränität erfüllt AI Endpoints die vier Kriterien, die wir an einen Anbieter anlegen: Gesellschaft französischen Rechts, Betreiber des Dienstes, Kapital zu fast 80 % von der Familie Klaba kontrolliert, Hosting in Frankreich. Unsere Seite zu souveräner KI erläutert dieses Raster im Detail.
Ein schlanker Katalog, wie bei den anderen Anbietern
Der Katalog von AI Endpoints umfasst 20 Modelle, darunter acht LLM: gpt-oss von OpenAI, Llama von Meta und mehrere Qwen-Modelle von Alibaba. Beim Start 2025 hatte OVHcloud mehr als 40 angekündigt. Für die beiden letzten Mistral-Modelle, Mistral Small 3.2 und Mistral Nemo, war die Abschaltung zum 4. November 2026 angekündigt. Verschwunden ist nur Mistral Nemo: Am 17. November liefert die API von AI Endpoints weiterhin Mistral Small 3.2.
Diese Verschlankung folgt dem Trend des gesamten Inferenzmarkts. Die meisten angebotenen Modelle sind Generalisten: Ein Kunde ersetzt ein Qwen durch ein DeepSeek, ohne seine Anwendung umzuschreiben. Die Anbieter behalten deshalb die Modelle, die für ihre Größe am meisten Intelligenz bieten, und nehmen die anderen schnell vom Markt. Scaleway schreibt es in seiner Richtlinie: Ein Modell wird abgekündigt, „when a newer, more efficient version is available“. Der US-Anbieter Groq hat Llama 3.3 70B am 16. August 2026 aus seinen Free- und Developer-Angeboten genommen und gpt-oss-120b oder Qwen3.6-27B empfohlen, ein 2,6-mal kleineres Modell. Together AI hat 2026 Dutzende Modelle aus seinem Shared-Angebot genommen. Weniger Modelle, besser bedient: Das ist die Logik des Geschäfts.
Entscheidend ist dann, wie aktuell diese wenigen Modelle sind. OVHcloud hat Qwen3.8-27B Ende August aufgenommen, aber noch nicht die neuesten Modelle von DeepSeek, GLM oder Kimi: Auf der öffentlichen Roadmap wurden DeepSeek 3.2 und Kimi K2.5 im August als „not planned“ geschlossen, GLM-5.3 und DeepSeek-V4-Flash sind nur Nutzerwünsche. AI Endpoints bietet auch kein Context Caching, eine Funktion, die die Kosten von Agenten stark senkt, die immer wieder dieselben Dokumente lesen: Die Anfrage ist seit September offen.
Umans: die neuesten Modelle direkt zum Release
Umans, ein 2025 gegründetes französisches Unternehmen, treibt diese Logik auf die Spitze: sechs Modelle, alle auf Code und Agenten zugeschnitten, und nach eigenen Angaben die besten offenen Code-Modelle direkt zum Release.
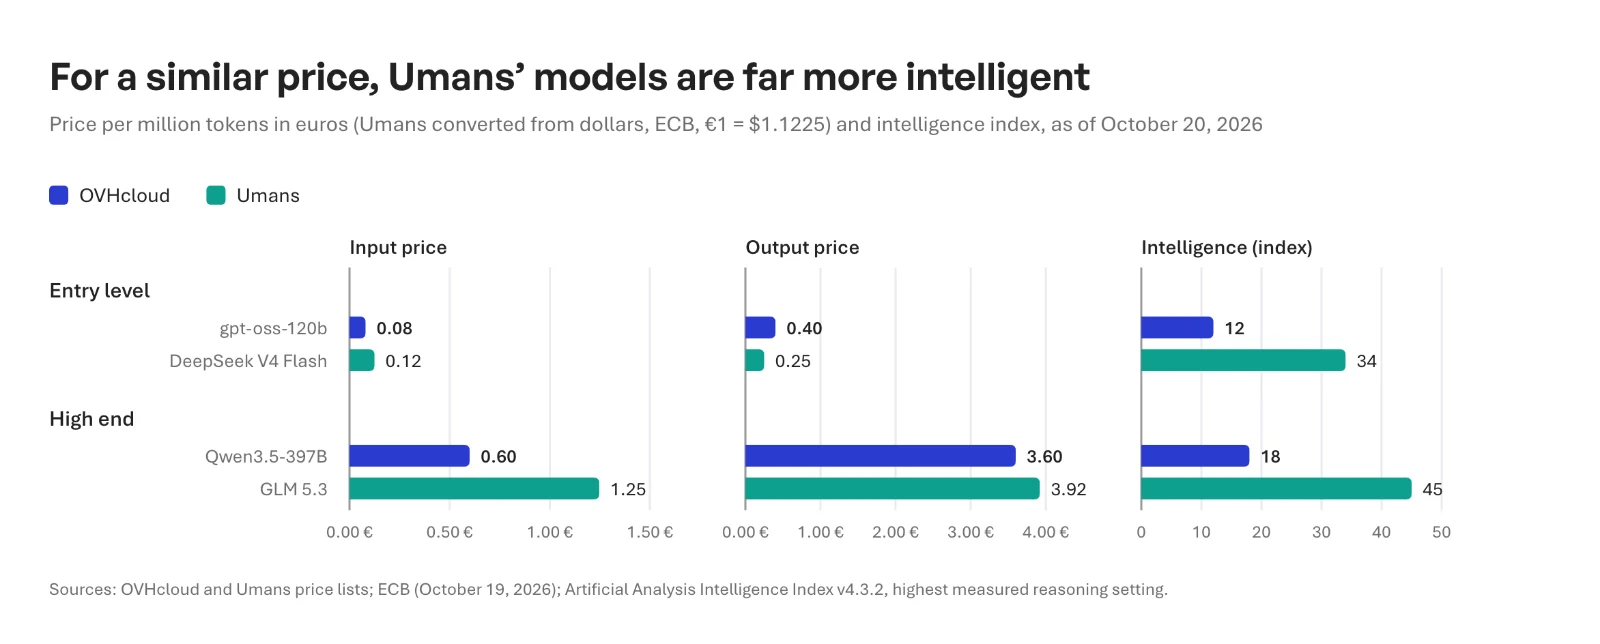 OVHcloud und Umans im Vergleich am 20. Oktober 2026, Preis pro Million Tokens in Euro und Intelligenzindex von Artificial Analysis. Einstiegsklasse: gpt-oss-120b bei OVHcloud, 0,08 € Input, 0,40 € Output, Index 12; DeepSeek V4 Flash bei Umans, 0,12 €, 0,25 €, Index 34. Oberklasse: Qwen3.5-397B bei OVHcloud, 0,60 €, 3,60 €, Index 18; GLM 5.3 bei Umans, 1,25 €, 3,92 €, Index 45. Preise von Umans aus US-Dollar umgerechnet zum EZB-Referenzkurs vom 19. Oktober 2026
Die Preise stammen aus den Preislisten von OVHcloud und Umans, umgerechnet aus US-Dollar zum EZB-Referenzkurs vom 19. Oktober 2026 (1 € = 1,1225 $). Für die Intelligenz gibt der Index von Artificial Analysis (Version 4.3.2) gpt-oss-120b 12 Punkte gegenüber 34 für DeepSeek V4 Flash, und Qwen3.5-397B 18 Punkte gegenüber 45 für GLM 5.3, jeweils in der höchsten Reasoning-Einstellung. Der Rest des Angebots:
| OVHcloud AI Endpoints | Umans | |
|---|---|---|
| Neueste Modelle | Qwen3.8-27B, Ende August 2026 aufgenommen | DeepSeek V4.1 Flash, GLM 5.3, Kimi K3 |
| Context Caching | nein | ja |
| Abgedeckte Anwendungsfälle | Text, Embeddings, Transkription, Vision, Bild | Code und Agenten |
| Inferenz in der EU | ja, in Gravelines | auf Anfrage |
In der Einstiegsklasse liegen die Preise beider Anbieter nah beieinander, aber die Modelle von Umans sind deutlich intelligenter: Ihr Score ist 2,5- bis fast 3-mal so hoch wie der der OVHcloud-Modelle. Umans hat einen deutlichen Vorsprung bei der Aktualität der Modelle, und sein Cache senkt die Rechnung eines Code-Agenten spürbar. Nach eigenen Messungen liefert Umans DeepSeek V4 Flash mit mehr als 360 Tokens pro Sekunde aus. Die beiden Angebote ergänzen sich: auf der einen Seite ein in Frankreich gehosteter Generalisten-Katalog, auf der anderen die besten offenen Code-Modelle direkt zum Release.
Bei den gefragtesten Modellen langsamer
Hugging Face leitet Anfragen an mehrere Inferenzanbieter weiter, darunter OVHcloud, und veröffentlicht deren Durchsatz. Am Morgen des 20. Oktober war OVHcloud bei gpt-oss-120b der langsamste von zehn gemessenen Anbietern: 35 Tokens pro Sekunde, gegenüber 161 bei Scaleway und 227 bei Baseten. Derselbe Rang bei Llama 3.3 70B, unter vier Anbietern. Umgekehrt war OVHcloud bei Qwen3.5-397B der schnellste, mit 105 Tokens pro Sekunde gegenüber 62 bei Scaleway. Diese Messungen sind eine Momentaufnahme, und Hugging Face dokumentiert seine Methode nicht.
OVHcloud verheimlicht das nicht. Einem Kunden, der im April 13 Tokens pro Sekunde gemessen hatte, antwortete das Unternehmen, der geteilte Dienst „can occasionally vary“, und riet ihm, sein eigenes Modell mit AI Deploy bereitzustellen. Im August schrieb ein technischer Verantwortlicher, er habe ein Deployment wegen dieser schwankenden Latenz ausgesetzt. Unsere eigenen Tests von AI Endpoints, die wir vor der von Octave Klaba eingeleiteten strategischen Wende durchgeführt haben, hatten uns enttäuscht. Vorerst gehört AI Endpoints daher nicht zu den Inferenzanbietern von Ask This Guy. Wir bleiben dran: Mit dem hauseigenen Modell und den neuen Angeboten testen wir erneut.
SambaNova: Das Versprechen schneller Endpoints ist noch nicht sichtbar
Hier sollte SambaNova ins Spiel kommen. Am 20. November 2025 hat OVHcloud diesen US-Hersteller von Inferenz-Chips ausgewählt, für „Echtzeit“-Endpoints mit garantierter Leistung, einer Verfügbarkeitszusage von 99,8 % und einem angekündigten Start in Frankreich „bis Ende des Jahres“. Die Chips von SambaNova, sogenannte RDUs, sind dafür gebaut, Modelle viel schneller auszuliefern als eine klassische GPU: Auf der eigenen Plattform liefert SambaNova gpt-oss-120b mit 708 Tokens pro Sekunde aus, laut Artificial Analysis.
SambaNova bezeichnet das Premium-Angebot von OVHcloud als „available now“. Bei OVHcloud dagegen haben wir am 20. Oktober weder eine Produktseite noch Preise noch ein Modell im Katalog gefunden. Die Seite des OVHcloud-Labors führt das schnelle Angebot weiterhin als „Coming soon“, mit einer monatlichen Mindestabnahme. Elf Monate nach der Ankündigung findet ein Kunde, der bei OVHcloud schnelle Tokens sucht, sie nicht in Selbstbedienung. Weder SambaNova noch AI Endpoints tauchen übrigens in der Pressemitteilung zu den Ergebnissen auf, die die KI-Strategie auf die Messe am 19. November verschiebt.
Warum trainiert OVHcloud ein eigenes LLM?
Die Angst, abgeschnitten zu werden
Octave Klabas Erklärung passt in einen Satz. Wenn OVHcloud sein Modell nicht selbst beherrscht, „kann uns eines Tages jemand sagen: ‚Sie sind mein Konkurrent, ich kappe Ihnen den Zugang zu meinem Modell.‘“ Er fügt hinzu: „Wir werden unsere Daten hergegeben haben, sie werden unser Geschäft machen, und uns bleibt nur das Nachsehen.“ Nichts hindert die großen Labore seiner Meinung nach daran, morgen ein CRM oder ein ERP als Konkurrenz zu SAP zu entwickeln.
Für ein französisches Unternehmen ist dieses Szenario alles andere als theoretisch, wir hatten es in „Was, wenn die USA Ihnen den digitalen Hahn zudrehen?“ beschrieben. Neu ist, dass ein Cloud-Anbieter es auf sich selbst anwendet. Octave Klaba betont, die Modelle seien „zuerst für uns, mit unseren Daten, nicht mit denen unserer Kunden“ gemacht, um produktiver zu werden, bevor sie gegebenenfalls Kunden angeboten werden.
Vom angekündigten Modell zu Olala mini
OVHcloud hat drei Bereiche gewählt, die das erste Modell „nicht genau“ alle abdecken wird: „offensive und defensive“ Cybersicherheit, Code sowie Agenten für Finanzen, Personalwesen, Recht und Logistik. Octave Klaba verspricht eine Architektur, die „ihrer Zeit weit voraus“ sei, ohne Größe oder Score zu nennen. Reuters präzisiert, es werde ein „Mixture-of-Experts“-Modell sein, das für jeden verarbeiteten Token nur einen Teil seiner Parameter aktiviert, die „Experten“.
Der Anspruch ist bescheidener geworden. Im Juni, auf der VivaTech, wollte Octave Klaba Spitzenmodelle von Grund auf trainieren, erwähnte ein erstes Pre-Training auf dem europäischen Supercomputer Jupiter und bezifferte die Kosten eines solchen Projekts auf 150 bis 200 Millionen Euro. Im Oktober betont er drei Branchen, die OVHcloud kennt, und eine Methode: „Es geht nicht darum, heute Milliarden auf den Tisch zu legen, sondern zu prüfen, ob wir in diesem Geschäft innovativ sein können […].“ Die Veröffentlichung als Open Source bleibt an eine Bedingung geknüpft: „Wenn es für uns funktioniert“.
Am 20. Oktober war der Zeitplan unklar: „Ende November“ in La Tribune, „Anfang 2027“ bei Reuters. Recht hatte La Tribune. Am 17. November 2026 hat OVH Olala mini 7A1B angekündigt, ein Mixture-of-Experts-Modell mit 7 Milliarden Parametern, davon eine Milliarde aktiv pro Token, veröffentlicht unter der Lizenz Apache 2.0. Es ist ein kleines Allzweckmodell, noch nicht die versprochenen spezialisierten Modelle: Diese sind auf eine Version 2.0 mit mehr als 100 Milliarden Parametern verschoben, ohne Datum. Was es taugt und was seine Zahlen verschweigen, beschreiben wir in unserem Artikel über Olala mini.
Der Fall Mistral
Octave Klaba nimmt kein Blatt vor den Mund. Auf eine Allianz mit Mistral angesprochen, antwortet er, „Mistral ähnelt in seinem Geschäft eher einem KI-Systemhaus, denn es macht vor allem Integration“, und stellt die Bewertung infrage: „Ist es dieses Geld wert? Ich weiß es nicht.“ BFM sieht darin einen Seitenhieb, der auch auf Mistrals Milliarden zielt. Die Formel trifft zu einem guten Teil zu. Mistral ist zuallererst ein Anbieter von KI-Dienstleistungen für Unternehmen: Das Unternehmen nennt mehr als 125 Unternehmenskunden, entsendet Forschende zu seinen Kunden, um maßgeschneiderte Modelle zu bauen, und der französische Staat kauft laut ActuIA eher Kompetenzen als Lizenzen bei ihm ein. Um diese Kunden zu bedienen, entwickelt Mistral eigene Technologien: Modelle, einen Inferenzdienst und mit Mistral Compute Rechenkapazität, die an andere Unternehmen vermietet wird. Bei diesem letzten Baustein, teilweise finanziert durch die Finanzierungsrunde über 3 Milliarden Euro im September 2026, kreuzen sich die Wege mit OVHcloud, was Octave Klabas Satz „Mistral hat sich zum Konkurrenten von OVHcloud erklärt“ erklärt. Die Infrastruktur von Mistral haben wir in unserem Artikel über CoreWeave beschrieben.
Welche Bausteine hat OVHcloud 2026 zugekauft?
Was es nicht selbst baut, kauft OVHcloud zu. Drei Übernahmen seit Januar:
- Seald, im Januar: Ende-zu-Ende-Verschlüsselung, mit einem von der ANSSI (der französischen Cybersicherheitsbehörde) zertifizierten Entwicklungskit;
- Dragon LLM, ehemals Lingua Custodia, im März: spezialisierte Modelle für regulierte Branchen und der Ausgangspunkt des KI-Labors von OVHcloud, das LLM trainieren und anpassen soll;
- Gladia, Ende Juli abgeschlossen: Transkription von Sprache in Text, in mehr als 100 Sprachen, bezahlt mit neuen Aktien.
Die Ergebnispräsentation ordnet jede Übernahme einer Schicht zu: Dragon LLM dem Training, Gladia den Tokens, Seald der Plattform, OVHai workspace den Anwendungsfällen. Für die weitere Finanzierung schließt Octave Klaba eine Kapitalerhöhung vorerst aus: „Ich will das Geld investieren, das wir verdienen.“
Wo liegen die Grenzen dieser Strategie?
Das Budget
OVHcloud hat 2026 einen freien Cashflow von 24,7 Millionen Euro erwirtschaftet. Mistral hat 3 Milliarden in einer einzigen Runde eingesammelt. Neil Shah, Analyst bei Counterpoint, erinnerte im Juni, zitiert von Le Monde Informatique, daran, dass ein Modell an Wert verliert, „wenn es nicht regelmäßig trainiert wird“. Ein LLM kostet jedes Jahr Geld, nicht nur einmal.
Die Präzedenzfälle
Der Gründer des deutschen Unternehmens Aleph Alpha fasste es 2024 zusammen, als er das Geschäftsmodell wechselte: „Just having an European LLM is not sufficient as a business model“. Umgekehrt nutzt Alibaba seine Qwen-Modelle, mehr als 3 Milliarden Mal heruntergeladen, um Kunden in seine Cloud zu holen. OVHcloud hat, was Aleph Alpha fehlte, nämlich 1,7 Millionen Kunden, aber noch nicht das Modell, das Lust darauf machen würde, sie zu bedienen.
Die Qualität offener Modelle
Octave Klaba meint, die Qualität der Tokens aus Open-Source-Modellen „entspricht nicht unbedingt unseren Anforderungen“. Dabei liegen die besten offenen Modelle laut Epoch AI im Schnitt nur noch vier Monate hinter den geschlossenen Modellen. Ein Teil des Qualitätsdefizits von AI Endpoints liegt am eigenen Katalog, dem aktuelle Modelle fehlen, die andere europäische Anbieter bereits ausliefern.
Die Hardware-Abhängigkeit
Die GPUs stammen von Nvidia, die Chips des schnellen Angebots von SambaNova, und ein erstes Pre-Training lief auf Jupiter, einem Supercomputer mit Nvidia-Chips. Vertrag und Daten bleiben unter französischem Recht, was für die rechtliche Souveränität zählt. Wie Sanchit Vir Gogia vom Analysehaus Greyhound, zitiert von Le Monde Informatique, es formuliert: Souveränität „wechselt nur die Hand“, die den Ausschalter kontrolliert.
Cybersicherheit, erste Stoßrichtung des Modells
Am Vortag der Ankündigung enthielten mehrere Versionen des offiziellen Kommandozeilen-Tools von OVHcloud Spyware, die ein Angreifer über das GitHub-Konto eines Mitwirkenden eingeschleust hatte. Über das künftige Modell sagt der Vorfall nichts. Er erinnert aber daran, dass sich die Sicherheit der Software-Lieferkette auch im eigenen Haus beweisen muss.
Was CIOs daraus mitnehmen können
- AI Endpoints mit der eigenen Last testen. Für Batch-Verarbeitung, Extraktion oder Klassifikation ist das Preis-Leistungs-Verhältnis bei gpt-oss sehr gut, und der Dienst ist souverän. Für einen Agenten oder einen interaktiven Assistenten messen Sie die Latenz zu Spitzenzeiten, bevor Sie sich festlegen.
- Keinen Anbieter wegen eines Modells wählen, das man nicht gemessen hat. Olala mini, das erste LLM von OVH, ist ohne Qualitätswert angekündigt: Man wird es an Fakten messen, sobald Gewichte und technischer Bericht am 19. November veröffentlicht sind, wie wir in unserem Artikel über Olala mini erklären.
- Den Austausch von Modellen einplanen. Bei allen Anbietern werden Modelle abgekündigt, sobald bessere kommen: drei Monate Vorlauf bei OVHcloud und Scaleway, zwei bis drei Wochen bei Together AI. Ein produktiver Einsatz muss seinen Nachfolger vorsehen und testen.
- Klabas Überlegung auf sich selbst anwenden. Ein Unternehmen, das seine Prozesse auf ein einziges Modell stützt, setzt sich einer Abschaltung aus, einer Preiserhöhung oder einem Anbieter, der zum Konkurrenten wird. Mit einem LLM-Gateway lässt sich der Anbieter wechseln, ohne Anwendungen umzuschreiben, und ein Open-Weight-Modell dient als Rückfallebene.
- Rechtliche Souveränität und technische Unabhängigkeit unterscheiden. OVHcloud löst die erste: französisches Recht, französisches Kapital, Daten in Frankreich. Die zweite, Chips und Modelle eingeschlossen, gibt es heute in Europa bei niemandem. Unser Vergleich der Möglichkeiten, ein Modell im Unternehmen zu betreiben, hilft beim richtigen Kompromiss.
Der Transparenz halber: Ask This Guy hostet seine Server bei OVHcloud in Gravelines, Umans ist einer unserer Partner, und wir nutzen mehrere europäische Inferenzanbieter, wie wir in unserem Überblick über französische KI-Anbieter erläutern.
Häufige Fragen zur KI-Strategie von OVHcloud
Was ist OVHcloud AI Endpoints?
AI Endpoints ist der Inferenzdienst von OVHcloud, gestartet im April 2025. Er bietet über eine OpenAI-kompatible API Zugang zu rund zwanzig Open-Weight-Modellen (gpt-oss, Llama, Qwen, Whisper), gehostet in Gravelines in Frankreich. Abgerechnet wird pro Million Tokens, und eine Batch-API kostet für nicht dringende Aufgaben nur die Hälfte.
Hat OVHcloud den Zeitplan für sein LLM eingehalten?
Beim Datum ja, beim Anspruch nein. Octave Klaba hatte La Tribune am 20. Oktober 2026 eine Veröffentlichung Ende November angekündigt; Reuters sprach von Anfang 2027. OVH hat Olala mini 7A1B am 17. November 2026 angekündigt, die Gewichte werden am 19. November auf Hugging Face erwartet. Es ist aber ein kleines Modell mit 7 Milliarden Parametern: Die spezialisierten und die großen Modelle sind auf eine Version 2.0 verschoben, ohne Datum.
Ist OVHcloud AI Endpoints souverän?
Ja, im rechtlichen Sinne. Der Dienst wird von der OVH SAS erbracht, einer französischen Gesellschaft, deren Kapital zu fast 80 % von der Familie Klaba kontrolliert wird, und seine Bedingungen nennen keinen dritten Unterauftragsverarbeiter für den Betrieb der Modelle. Der Katalog verortet sie in Frankreich; die Dokumentation sagt seit dem 10. November 2026 nur „Europa“, und der Standort ist vertraglich nicht garantiert. Es gibt keine US-Muttergesellschaft: Über diesen Weg ist der Dienst nicht dem CLOUD Act ausgesetzt. GPUs und Chips stammen dagegen von US-Herstellern, Nvidia und SambaNova.
Worum geht es bei der Partnerschaft zwischen OVHcloud und SambaNova?
Im November 2025 hat OVHcloud SambaNova, einen US-Hersteller von Inferenz-Chips, ausgewählt, um schnelle Endpoints mit garantierter Leistung anzubieten, mit 99,8 % Verfügbarkeit und einer Abnahmeverpflichtung. SambaNova bezeichnet das Angebot als verfügbar, OVHcloud hatte bis zum 20. Oktober 2026 aber weder eine Produktseite noch Preise veröffentlicht.
Was unterscheidet OVHcloud AI Endpoints von Umans?
Die beiden Angebote ergänzen sich. OVHcloud AI Endpoints liefert rund zwanzig Generalisten-Modelle (Text, Embeddings, Transkription, Vision) aus Gravelines aus, zu Preisen, die zu den niedrigsten in Europa gehören. Umans, ein 2025 gegründetes französisches Unternehmen, bietet sechs der neuesten Modelle für Code und Agenten (DeepSeek V4.1 Flash, GLM 5.3, Kimi K3), mit Context Caching und Inferenz in der Europäischen Union auf Anfrage. In der Einstiegsklasse liegen die Preise nah beieinander, aber die Modelle von Umans sind deutlich intelligenter: 34 gegenüber 12 Punkten im Index von Artificial Analysis für DeepSeek V4 Flash im Vergleich zu gpt-oss-120b.
Ist Mistral ein IT-Dienstleister?
Zum Teil. Am 20. Oktober 2026 meinte Octave Klaba, CEO von OVHcloud, Mistral „ähnelt in seinem Geschäft eher einem KI-Systemhaus, denn es macht vor allem Integration“. Mistral ist zuallererst ein Anbieter von KI-Dienstleistungen für Unternehmen: Das Unternehmen nennt mehr als 125 Unternehmenskunden und entsendet Forschende zu einigen von ihnen, um maßgeschneiderte Modelle zu bauen. Anders als ein klassischer IT-Dienstleister entwickelt es eigene Technologien, darunter Modelle, einen Inferenzdienst und mit Mistral Compute Rechenkapazität, die an andere Unternehmen vermietet wird.
Um bei KI erfolgreich zu sein, müsste OVHcloud fast nur aktuelle Modelle schnell ausliefern: Infrastruktur und Preise hat es bereits. Das erste LLM, Olala mini, wird mit seinen ersten Werten zeigen, ob das Unternehmen Forschung kann. Die Monate danach werden zeigen, ob es verkaufen kann, was es im November 2025 angekündigt hat.
Für ein Unternehmen ist Octave Klabas Lektion nützlicher als sein Modell: nie von einem einzigen Anbieter abhängen, wenn das eigene Geschäft an diesem Baustein hängt.