.webp)
RAG in der KI: ein LLM mit Unternehmensdokumenten verbinden
Was ist RAG in der KI? Retrieval Augmented Generation erklärt: Funktionsweise, Wahl des LLM, hybride Suche, Agentic RAG und Erfahrungen aus der Produktion.

Was ist RAG in der KI?
RAG in der KI (Retrieval Augmented Generation, auf Deutsch etwa „durch Abruf erweiterte Generierung“) ist ein Ansatz, der ein KI-Modell mit Ihren eigenen Quellen verbindet. Bei jeder Frage sucht das System die relevanten Passagen in Ihren Dokumenten, Datenbanken und Tools und übergibt sie dem Modell, das daraus eine belegte Antwort formuliert und seine Quellen nennt. Das Modell wird weder neu trainiert noch verändert: Geändert wird nur, was es liest, bevor es antwortet.
Das Problem: eine KI, die alles weiß, nur nicht über Sie
Sie nutzen eine KI für Endverbraucher (ChatGPT, Mistral Le Chat, Gemini usw.) und sind von ihren Fähigkeiten beeindruckt? Zu Recht.
Aber haben Sie schon einmal versucht, ihr Fragen zum letzten Finanzbericht Ihres Unternehmens oder zu einem internen Prozess zu stellen? Sobald die Quellen nicht öffentlich sind, ist sie machtlos.
 KI, die Fragen zu internen Unternehmensdokumenten nicht beantworten kann
KI-Systeme wie ChatGPT werden mit astronomischen Mengen öffentlicher Daten trainiert. Sie sind Experten für die Welt, aber nicht für Ihre Welt.
Damit eine KI intern wirklich nützlich ist, braucht sie Zugriff auf:
- Ihre internen Dokumente
- Ihre HR-Richtlinien
- Ihre Geschäftsprozesse
- Ihre Tools (CRM, ERP, Laufwerke)
- Ihre Datenbanken
Kurz: auf alles, was die DNA Ihres Unternehmens ausmacht.
Die Grenzen von „Copy-and-paste“
Dokumente von Hand in ChatGPT hochzuladen, kann wie eine schnelle, pragmatische Lösung wirken (wenn man die Vertraulichkeitsprobleme außer Acht lässt).
In der Praxis aber:
- kostet es viel Zeit
- weiß man nicht immer, welche Dateien wirklich relevant sind
- schickt man zu viele Dokumente oder zu große Dateien, was die KI weniger leistungsfähig macht
- vergisst man Dokumente oder lädt nicht die richtigen Versionen hoch
- fließen die Informationen aus einem CRM oder einem Laufwerk nicht ein
Ergebnis: Das interne Wissen ist nie vollständig und nie strukturiert. Das Problem ist alt, Wissensmanagement-Initiativen haben es nie wirklich gelöst, und warum, erklären wir in Wissensmanagement: warum Ihre Initiativen scheitern.
Das Kontextfenster: die Achillesferse unserer Lieblings-KIs
Die KI hat ein sehr leistungsfähiges Arbeitsgedächtnis, aber ein begrenztes. Das ist ihr Kontextfenster: Sie kann nur eine bestimmte Menge an Informationen auf einmal verarbeiten.
Konkrete Grenzen
Aktuelle Modelle bieten Kontextfenster von mehreren hunderttausend Token, manchmal mehr. In Seiten umgerechnet sind das je nach Modell einige hundert bis gut tausend Seiten.
Das klingt nach viel. Aber wenn Sie zehn Dokumente mit je 300 Seiten schicken, ist die Grenze bereits überschritten.
Vor allem ist die angegebene Größe keine Qualitätsgarantie. Je voller der Kontext, desto ungenauer wird das Modell: Es vergisst Passagen, verwechselt Quellen oder stützt sich auf den falschen Absatz. Man spricht manchmal von Kontextverwässerung. Deshalb ist es besser, vorab zu sortieren, was man schickt, damit nur die relevanten Informationen beim Modell ankommen.
Hier kommt RAG ins Spiel: die Lösung für eine „klug informierte“ KI
RAG (Retrieval Augmented Generation) ist ein Ansatz, bei dem:
- das Tool sich mit Ihren Quellen verbindet und die Dokumente für spätere Suchen vorverarbeitet
- es bei jeder Anfrage die relevanten Dokument-„Stücke“ sucht („Retrieval“)
- es der KI die Anfrage zusammen mit diesen relevanten Dokumenten schickt („Augmented“)
- die KI daraufhin eine präzise Antwort auf Basis dieser Elemente erzeugt („Generation“)
Als hätten Sie Ihrer KI einen extrem schnellen und extrem präzisen Bibliothekar zur Seite gestellt.
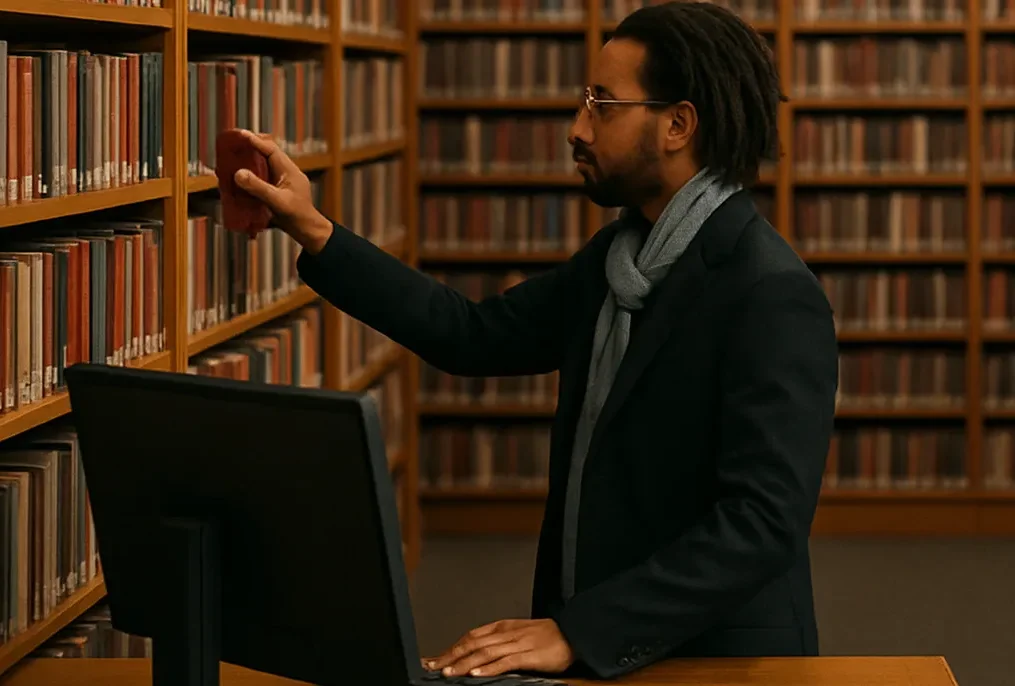 Ein schneller und präziser Bibliothekar
Wichtig: RAG verändert das Modell nicht. Das LLM bleibt dasselbe, geändert wird nur, was man ihm vor der Antwort zu lesen gibt. Dieser Unterschied ist für alles Weitere entscheidend.
RAG und LLM: wer macht was in der Kette?
Oft ist von RAG LLM die Rede, als handle es sich um eine einzige Technologie. Tatsächlich sind es zwei getrennte Bausteine, und wer weiß, welcher was tut, vermeidet die meisten Designfehler.
Das LLM (Large Language Model) ist der Generator. Es versteht die Frage, denkt über das nach, was man ihm liefert, und formuliert die Antwort. Es weiß nichts über Ihr Unternehmen und hat keinen Zugriff auf Ihre Systeme.
RAG ist die Schicht, die es umgibt. Sie bereitet Ihre Dokumente auf, findet im Moment der Frage die nützlichen Passagen und legt sie in den Kontext des LLM, bevor es aufgerufen wird.
In einer RAG-Kette läuft jeder Aufruf des LLM so ab:
| Schritt | Wer ihn ausführt | Was passiert |
|---|---|---|
| 1. Vorbereitung | RAG | Ihre Dokumente werden zerlegt, vektorisiert und indexiert, noch bevor eine Frage gestellt wird |
| 2. Suche | RAG | Die Frage wird in eine Suchanfrage übersetzt, die relevanten Passagen werden gefunden |
| 3. Zusammenstellung | RAG | Frage, Auszüge und Anweisungen werden zu einem einzigen Kontext zusammengefügt |
| 4. Generierung | LLM | Das Modell formuliert die Antwort auf Basis dieses Kontexts |
| 5. Zuordnung | RAG | Die passenden Quellen werden der Antwort beigefügt |
Daraus folgen drei praktische Konsequenzen.
Das LLM lernt nichts aus Ihren Dokumenten. Es liest sie bei jeder Anfrage und vergisst sie danach. Das ist eine gute Nachricht für die Vertraulichkeit, und es bedeutet, dass eine Aktualisierung Ihrer Quellen sofort greift, ohne neues Training.
Die Qualität eines RAG entscheidet sich vor allem außerhalb des LLM. Liefert Schritt 2 die falschen Passagen, kann kein Modell den Fehler ausbügeln: Es schreibt eine flüssige und falsche Antwort. In unseren Projekten kommt der Großteil der Relevanzgewinne aus Chunking, Suche und Filterung, nicht aus der Wahl des Modells.
Man kann das LLM wechseln, ohne das RAG neu zu bauen. Das ist der Vorteil einer Multi-Modell-Architektur: Dieselbe Dokumentenbasis kann von einem schnellen, günstigen Modell für einfache Fragen und von einem leistungsstärkeren Modell für komplexe Analysen bedient werden.
Welches LLM für ein RAG?
Die Frage kommt schnell, und die Antwort lautet nicht „das größte verfügbare Modell“. Fünf Kriterien zählen wirklich:
- Befolgen der Anweisungen. Ein gutes RAG-LLM hält sich an die gelieferten Auszüge und sagt, dass es etwas nicht weiß, wenn die Information fehlt. Ein brillantes, aber geschwätziges Modell, das Lücken mit seinem Allgemeinwissen füllt, ist eine schlechte Wahl.
- Fähigkeit zu zitieren. Jede Aussage dem Auszug zuzuordnen, aus dem sie stammt, beherrschen Modelle sehr unterschiedlich gut.
- Das Kontextfenster. Groß genug für rund zehn Auszüge und den Gesprächsverlauf, aber nicht übertrieben: Darüber hinaus sinkt die Präzision und die Kosten steigen.
- Kosten und Latenz. Ein interner Assistent, der hundertmal am Tag befragt wird, hat ein anderes wirtschaftliches Profil als eine monatliche Aktenanalyse.
- Sprache und Rechtsraum. Die Qualität in der jeweiligen Sprache variiert je nach Modell, und der Ort, an dem die Anfragen verarbeitet werden, ist ein eigenes Kriterium, sobald die Dokumente sensibel sind. Diese Abwägung beschreiben wir auf unserer Seite zu souveräner KI.
In der Praxis liefert ein diszipliniertes Mittelklasse-Modell bei einem Unternehmens-RAG bessere Ergebnisse als ein schlecht geführtes Spitzenmodell. Das LLM ist ein austauschbares Bauteil, Ihre Dokumentenkette nicht.
RAG, Fine-Tuning oder langer Kontext: was wählen?
Drei Ansätze machen eine KI für Ihr Geschäft relevanter. Sie erfüllen nicht denselben Zweck und werden oft zu Unrecht gegeneinander ausgespielt.
| Was es tut | Wann es die richtige Wahl ist | Wichtigste Grenze | |
|---|---|---|---|
| RAG | Holt die Information im Moment der Frage aus Ihren Quellen | Viel Wissen, das sich ändert und zitiert werden muss | Erfordert echte Ingenieursarbeit an den Daten |
| Fine-Tuning | Trainiert das Modell nach, um ihm einen Stil, ein Format, ein Vokabular beizubringen | Einen Ton, eine Nomenklatur, ein Ausgabeformat durchsetzen | Bringt kein verlässliches, überprüfbares Wissen und veraltet schnell |
| Langer Kontext | Schickt die Dokumente direkt mit der Frage | Kleiner, stabiler Bestand, gelegentliche Nutzung | Teuer, langsam, und die Präzision sinkt mit steigendem Volumen |
Die häufigste Verwechslung betrifft das Fine-Tuning. Viele Unternehmen glauben, ein auf ihren Dokumenten trainiertes Modell werde ihr Unternehmen „lernen“. In der Praxis lernt das Modell vor allem eine Art zu sprechen. Es wird Ihnen nicht sagen können, welche Vertragsversion heute gilt, und es wird keine Quelle nennen. Für Wissen ist RAG die Antwort.
Die drei lassen sich übrigens sehr gut kombinieren: ein solides RAG für das Wissen, ein komfortables Kontextfenster, um über das Gefundene nachzudenken, und gegebenenfalls Fine-Tuning für den Stil.
Ein Blick in den RAG-Motor: wie funktioniert das wirklich?
Mehr dazu in unserer Dokumentation zur Datenverarbeitung und zu RAG (auf Englisch).
Schritt 1: Intelligentes Zerlegen (Chunking)
Zunächst müssen Ihre Dokumente in verwertbaren Text umgewandelt werden:
- Extraktion der Absätze
- Übernahme des Texts aus Tabellen
- Interpretation von Schaubildern, Grafiken usw. (dieser Teil ist wichtig, denn sie enthalten oft nützliche, verwertbare Informationen)
Dann folgt das Chunking. Ein guter Chunk ist:
- kurz → damit er ins Kontextfenster passt
- kohärent → ein klarer Gedanke pro Block
- abgegrenzt → keine Vermischung von Konzepten
Sie geben der KI nicht das ganze Dokument. Sie geben ihr den Absatz, der die Frage genau beantwortet.
Schritt 2: Der Suchmechanismus (die Magie der Embeddings)
Um Texte zu vergleichen, verwandelt RAG:
- Ihre Frage
- Ihre Chunks
...in numerische Vektoren: Das sind die Embeddings. Zwei inhaltlich ähnliche Chunks → ihre Vektoren liegen nah beieinander.
Zwei unverzichtbare Sucharten
- Semantische Suche (nach Bedeutung)
Ideal für konzeptionelle Fragen: „Wie beantrage ich Urlaub?“
- Stichwortsuche (nach Genauigkeit)
Unverzichtbar für spezifische Begriffe ohne allgemeine Bedeutung:
- „Produktnummer XYZ-123“
- „Verfahren PNC-V4“
- „Jean-Pierre Dubreuil“
Denn eine KI kennt Jean-Pierre Dubreuil aus der Buchhaltung nicht...
Beide Mechanismen ergänzen sich. Ein rein „semantisches“ RAG (obwohl häufig) scheitert an solchen Suchen.
Das RAG-Schema Schritt für Schritt
Hier das vollständige RAG-Schema mit seinen zwei Phasen: auf der einen Seite die Vorbereitung der Quellen, auf der anderen die Verarbeitung jeder Frage. Die erste läuft nur erneut, wenn Dokumente hinzukommen oder aktualisiert werden; die zweite bei jeder Frage eines Nutzers.
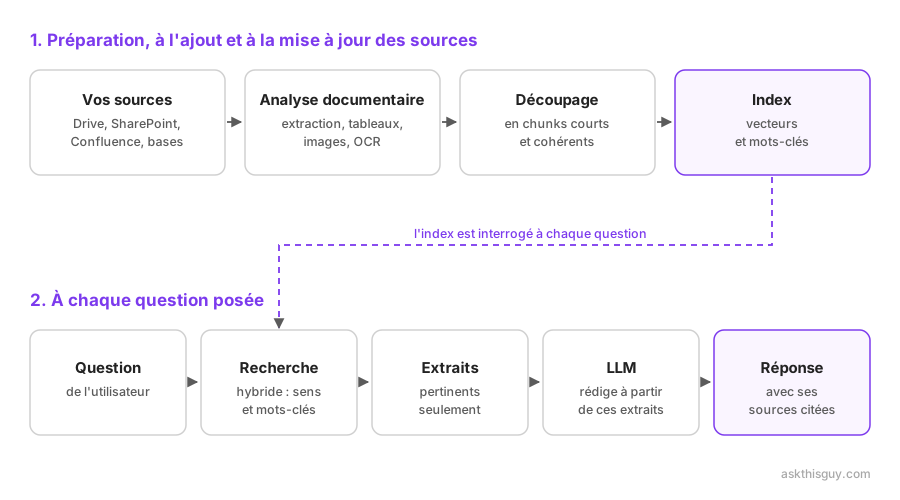 RAG-Schema in zwei Phasen: Vorbereitung der Quellen (Dokumentenanalyse, Chunking, Indexierung als Vektoren und Stichwörter), dann Verarbeitung einer Frage (hybride Suche, relevante Auszüge, Generierung durch das LLM, belegte Antwort)
Dieses Schema beschreibt RAG so, wie es gelehrt und in den meisten Demos umgesetzt wird: eine Frage, eine Suche, eine Antwort. Um das Prinzip zu verstehen, ist das ein guter Weg. So funktionieren ernsthafte Systeme heute aber nicht mehr.
Vom linearen RAG zum Agentic RAG
Das Schema oben beruht auf einer starken Annahme: Eine einzige Suche genügt für die Antwort. Im echten Unternehmensalltag stimmt das selten.
Nehmen Sie eine Frage, wie eine Führungskraft sie tatsächlich stellt: „Halten wir unsere Zusagen gegenüber Durand im Zeitraum ein?“
Nichts in diesem Satz sagt, wo gesucht werden soll. Weder welche Zusagen noch welcher Zeitraum noch in welchem System. Das muss das System selbst herausfinden. Es muss zuerst finden, was unsere Verpflichtungen gegenüber Durand festhält, einen Vertrag, einen Nachtrag, eine Service-Vereinbarung, und dort lesen, was zugesagt ist: eine Reaktionszeit, eine Zahl inkludierter Einsätze, eine Verfügbarkeitsquote. Erst beim Lesen dieser Dokumente erfährt es, dass der Verpflichtungszeitraum das Kalenderjahr ist. Dann kann es im Ticketsystem die Tickets des Jahres zu den richtigen Verträgen suchen und sie mit den gerade entdeckten Schwellenwerten vergleichen.
Zwei Quellen unterschiedlicher Art, und vor allem: Die zweite Anfrage lässt sich erst formulieren, wenn das Ergebnis der ersten gelesen ist.
Genau das leistet ein Agentic RAG (agentisches RAG). Statt einer einzigen Suche führt ein orchestrierender Agent eine Untersuchung:
- er analysiert die Frage und formuliert sie um, manchmal in mehrere Teilfragen
- er wählt die abzufragende(n) Quelle(n)
- er liest, was er erhält, und entscheidet, ob er genug weiß
- falls nicht, startet er mit dem gerade Gelernten eine gezieltere Suche
- er formuliert die Antwort erst, wenn alle Elemente beisammen sind, und nennt seine Quellen
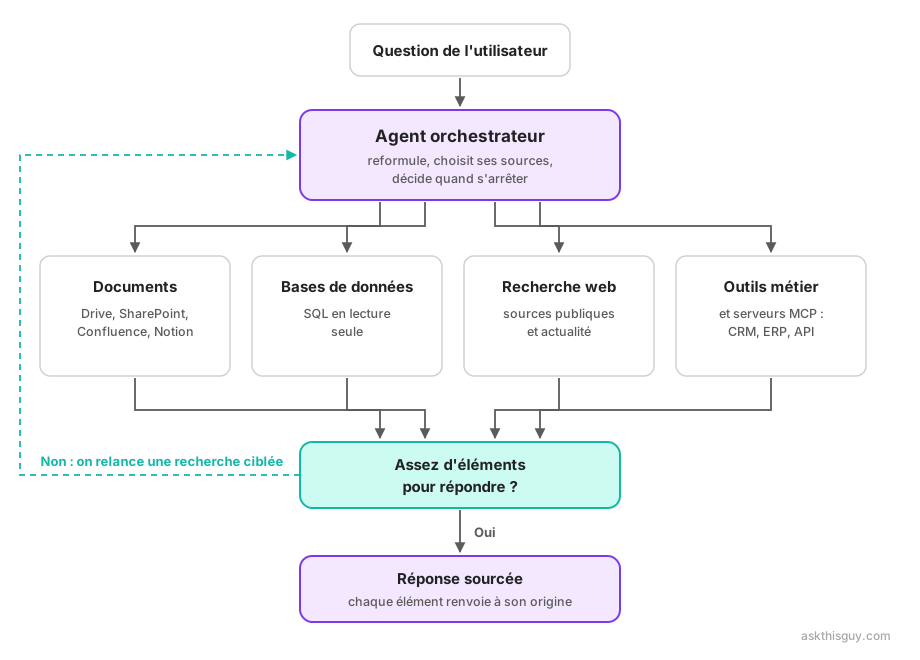 Schema eines Agentic RAG: Der orchestrierende Agent fragt Dokumente, Datenbanken, Web und Fachanwendungen ab, prüft, ob er genug Elemente hat, startet bei Bedarf eine gezielte Suche neu und liefert dann eine belegte Antwort
Der Unterschied zum vorigen Schema liegt in einem einzigen Pfeil: dem, der zum Agenten zurückführt. Er wiegt schwerer als die Wahl des Modells: Auf den Finanzberichten von FinanceBench hat Mistral gezeigt, dass bei gleichem Modell die Präzision von 26,7 % auf 86 % steigt, je nachdem, wie die Software die Suchen verkettet. Welche Folgen das für die Due Diligence hat, beschreiben wir gesondert.
Vier praktische Konsequenzen, die oft unterschätzt werden.
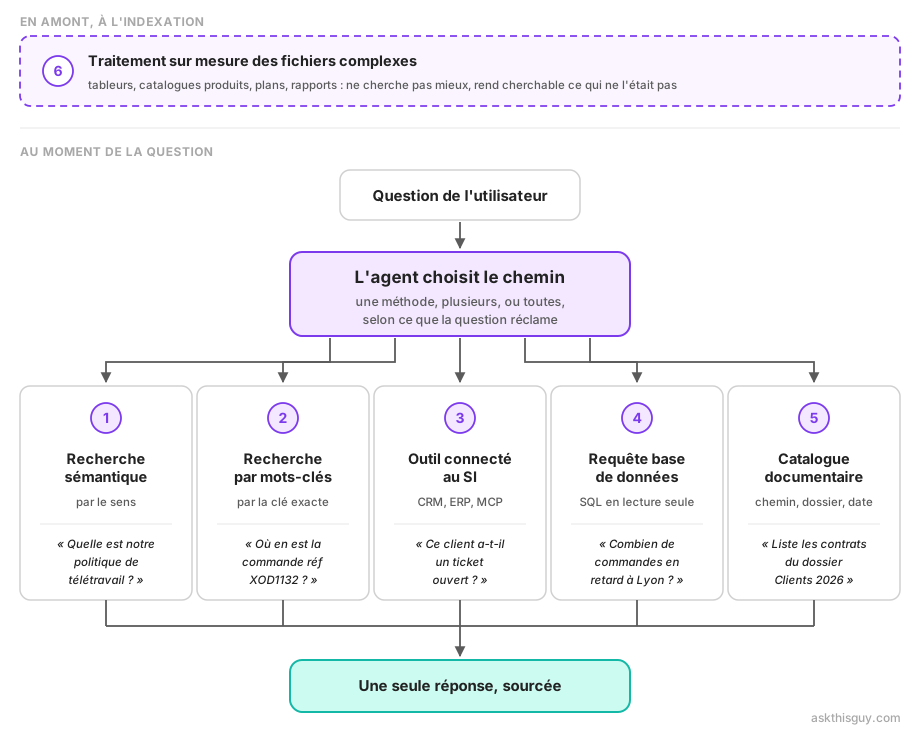
Wissen ist nicht mehr nur dokumentbasiert. Ein Agent kann im selben Gespräch Ihre Dokumente, eine SQL-Datenbank im Lesemodus, das Web und Ihre Fachanwendungen abfragen, die über MCP-Server oder maßgeschneiderte Tools angebunden sind. Der Nutzer stellt eine einzige Frage und muss nicht wissen, wo die Information liegt.
Hin und Her kostet Zeit und Token. Ein ermittelnder Agent verbraucht mehr als eine einzelne Suche. Die Zahl der Iterationen muss also begrenzt werden, der Agent muss wissen, wann er aufhört, und die Kosten müssen überwacht werden. Ein schlecht eingegrenztes agentisches System ist langsam und teuer.
Nachvollziehbarkeit wird unverzichtbar. Wenn eine Antwort aus vier Aufrufen an drei Quellen entsteht, muss der Nutzer prüfen können, woher jedes Element stammt. Ohne Quellenangaben ist ein Agentic RAG eine Blackbox, und niemand verlässt sich bei Entscheidungen auf eine Blackbox.
Das Volumen ist keine Obergrenze mehr. Ein lineares RAG durchsucht bei jeder Frage den gesamten Bestand, und seine Präzision sinkt jenseits einiger tausend Dokumente. Ein Agent grenzt zuerst den Umfang ein (Quelle, Ordner, Kunde, Datum) und sucht dann in dieser Teilmenge: So lassen sich mehr als 100.000 Dokumente bewältigen. Der Mechanismus wird in wie viele Dokumente kann ein RAG verarbeiten? erklärt.
KI und Dokumentenanalyse: was sich vor der Suche entscheidet
Viel ist von Modellen und Agenten die Rede. In echten Projekten liegt das, was ein RAG scheitern lässt, fast immer weiter vorne: in der Analyse der Dokumente.
Ihr Wissen besteht nicht aus sauberem Text. Es sind gescannte PDFs, Präsentationen, Excel-Tabellen, Pläne, Verträge mit Anhängen, eilig geschriebene Protokolle. Jedes Format bringt sein eigenes Problem mit.
- Gescannte PDFs brauchen Texterkennung (OCR). Eine mittelmäßige OCR erzeugt fehlerdurchsetzten Text, und ein unleserlicher Chunk wird nie gefunden.
- Tabellen verlieren ihre Struktur, wenn sie naiv in Text umgewandelt werden. Eine verrutschte Spalte, und die Zahl aus Quartal 2 landet bei Quartal 3.
- Schaubilder und Grafiken enthalten oft die dichteste Information eines Dokuments. Sie zu ignorieren heißt, die Hälfte des Werts einer Vertriebspräsentation wegzuwerfen.
- Lange, heterogene Dokumente (etwa ein 200-seitiges Qualitätshandbuch) müssen entlang ihrer logischen Struktur zerlegt werden, nicht alle 500 Zeichen.
- Mehrere Versionen werfen eine Frage auf, die nicht technisch ist: Welches Dokument ist maßgeblich? Ein RAG, das drei Versionen eines Verfahrens indexiert, antwortet manchmal mit der falschen.
Deshalb lässt sich KI-gestützte Dokumentenanalyse nicht auf „einen Ordner anschließen“ reduzieren. Jedes Unternehmen hat eigene Formate, Konventionen und Ausnahmen, und die Verarbeitung muss sich daran anpassen. Das ist die unsichtbarste Arbeit in einem RAG-Projekt und mit Abstand die entscheidendste.
Ein RAG-Beispiel von Anfang bis Ende
Nehmen wir noch einmal „Halten wir unsere Zusagen gegenüber Durand im Zeitraum ein?“, diesmal in einem agentischen System.
- Eingang. Die Frage nennt weder Dokument noch System noch Datum. Drei Unbekannte: Um welche Zusagen geht es, über welchen Zeitraum, und wo liegen die Fakten, mit denen man sie messen kann?
- Erste Suche. Hybride Suche in den Dokumenten. Die Stichwortsuche findet „Durand“, einen Eigennamen, den keine semantische Suche allein gezielt treffen würde; parallel liefert die semantische Suche Passagen zu Service-Levels und Einsatzzeiten. Der Agent erhält einen Rahmenvertrag, einen Nachtrag und eine Service-Vereinbarung.
- Lesen und entscheiden. Der Nachtrag ersetzt zwei Klauseln des Rahmenvertrags. Der Agent hält sich an die gültige Fassung und liest dort die bezifferten Zusagen: Reaktionszeit, Zahl inkludierter Einsätze und einen jährlichen Verpflichtungszeitraum. Er hat gerade gelernt, was er anfangs nicht wusste.
- Zweite Quelle, aus der ersten abgeleitet. Erst jetzt kann der Agent das Ticketsystem über das Tool für Datenbankabfragen befragen: die Tickets des Jahres zu genau diesen Verträgen, mit ihren tatsächlichen Reaktionszeiten.
- Vergleich. Der Agent stellt die erhaltenen Zahlen den gelesenen Schwellenwerten gegenüber und erkennt die Abweichungen.
- Generierung. Eine nach Zusagen gegliederte Antwort, mit dem Link zur jeweiligen Vertragsklausel und den Details der betroffenen Tickets.
Eine einzige Frage, zwei Quellen und eine Kette, in der Schritt 4 vor Schritt 3 nicht formulierbar war. Diese Mechanik sieht der Nutzer nicht, und genau sie macht den Unterschied zwischen einem Spielzeug und einem Arbeitswerkzeug.
RAG mit ChatGPT, Gemini, Claude oder Copilot: was sich ändert
Eine häufige Frage: „Wir haben schon ChatGPT Enterprise (oder Copilot, oder Gemini). Macht das nicht schon RAG?“
Teilweise ja. Diese Tools können Dateien lesen, die Sie ihnen geben, und manche verbinden sich mit einem Arbeitsbereich (Microsoft 365 bei Copilot, Google Workspace bei Gemini). Für einfache Suchen in einem Bereich, den der Anbieter bereits abdeckt, reicht das oft.
Die Grenzen zeigen sich schnell, sobald man diesen Bereich verlässt.
- Der Umfang ist der des Anbieters. Copilot ist hervorragend in SharePoint und Teams. Ihr fachliches DMS, Ihr selbst entwickeltes ERP oder Ihre PostgreSQL-Datenbank kennt es nicht.
- Sie haben die Verarbeitungskette nicht in der Hand. Chunking, Embedding-Modell und Suchstrategie wählt der Anbieter. Weichen Ihre Dokumente vom Standardfall ab, haben Sie keinen Hebel.
- Das Modell ist vorgegeben. Sie nutzen das des Anbieters, ohne wechseln zu können, wenn ein anderes für Ihren Use Case besser oder günstiger ist.
- Der Speicherort der Daten hängt vom Anbieter ab. Für viele europäische Organisationen ist das ein grundlegender Punkt.
Das eigentliche Kriterium ist also nicht „RAG oder kein RAG“, sondern: Wie weit können Sie die Kette an Ihre Daten anpassen, und behalten Sie die technischen Entscheidungen in der Hand? Diesen Punkt vertiefen wir in unserem Artikel über RAG-Fehler im Unternehmen nach dem POC.
RAG ist nicht gleich RAG: die Kunst, die richtige Lösung zu wählen
Der Markt ist voll von RAG-Lösungen, die sich „schnell integrieren“ lassen, aber... wie im berühmten Jäger-Sketch der französischen Komikertruppe Les Inconnus: Es gibt die guten und die schlechten.
Was den Unterschied macht:
- Qualität der Konvertierung → wer die Daten einer Grafik nicht extrahieren kann, verliert eine wichtige Information
- Qualität des Chunkings → zu große oder inkohärente Chunks = verwirrte KI
- Wahl der Embedding-Modelle → nicht alle glänzen in denselben Bereichen
- Hybride Suche → nur semantisch = Fehler bei Eigennamen
- Fähigkeit zur Untersuchung → eine Engine, die nur einen Durchgang beherrscht, scheitert an jeder etwas zusammengesetzten Frage
- Nachvollziehbarkeit → ohne überprüfbare Quellenangaben hören Nutzer beim ersten Zweifel auf, das Tool zu verwenden
Ein schlechtes RAG kann die KI vage und ungenau machen, unfähig, Informationen zu finden, die durchaus vorhanden sind.
Das ist keine Theorie. In dem Benchmark, den wir laufend von einem Server in Frankreich aus betreiben, lagen im Januar 2026 mehr als 95 % der Embedding-Aufrufe unter einer Sekunde, aber an manchen Tagen lief es völlig aus dem Ruder, bis hin zu einer live gescheiterten Kundendemo. Die Episode und unsere Lehren daraus beschreiben wir in unserer Embedding-Strategie. Bei der Textgenerierung zeigt unser Benchmark für Q1 2026 so deutliche Unterschiede in den Erfolgsquoten der Anbieter, dass ein Unternehmens-RAG nie auf einem einzigen Modell beruhen sollte: Das ist der zweite der 5 Fehler, die nach dem POC auftreten.
Ein weiterer zentraler Punkt ist die Integration ergänzender Tools. Wenn es Ihnen nur um die interne Suche geht, genügt ein RAG. In der Regel wollen Sie aber auch im Web suchen, Daten aus Datenbanken abfragen, Aktionen auslösen usw. Die Integration dieser Tools vervielfacht die Leistung Ihrer KI.
RAG ist Ingenieursarbeit
Es gibt klar Best Practices und „generische“ Entscheidungen, die recht gut funktionieren. Ein Patentrezept gibt es aber nicht.
Jedes Unternehmen hat spezifische Formate und Daten, die eine besondere Verarbeitung erfordern, um gute Ergebnisse zu erzielen.
Der Ansatz von Ask This Guy (ATG): das Beste aus RAG, ohne den Aufwand
Bei Ask This Guy haben wir tausende Stunden damit verbracht, RAG-Pipelines zu benchmarken, zu testen, zu zerlegen und zu verbessern. Unsere RAG-Lösung für Unternehmen macht diese Bausteine für Ihre Teams industrietauglich.
Wir bieten:
- Optimierte Konvertierung und optimiertes Chunking
Zahlreiche Konnektoren, Verarbeitung komplexer Dokumente, Tabellen, Folien, Bilder usw.
- Intelligente hybride Suche
Semantik + Stichwörter für maximale Präzision.
- Ein orchestrierender Agent statt einer einfachen Suche
Der Assistent entscheidet, welche Quellen er abfragt, startet neue Suchen, wenn ihm ein Element fehlt, und verknüpft Dokumente, Datenbanken und Fachanwendungen in einem einzigen Gespräch.
- Weitgehende Anpassung
Wir passen die Konvertierungen an Ihre Dokumente an und können spezifische Algorithmen entwickeln. Wir können ein Embedding-Modell einsetzen, das zu Ihrer Branche passt.
- Volle Flexibilität
Sie behalten die Hoheit über Ihre Daten. Und wenn Sie die Lösung eines Tages selbst betreiben möchten, erhalten Sie Ihre spezifischen Entwicklungen.
- Ein RAG für alle Ihre Anwendungen
Dieselbe Intelligenz lässt sich über mehrere Oberflächen ausspielen: Administrationskonsole, Chatbots auf Ihrer Website, in Ihr SaaS-Produkt integriertes Widget, API für Ihre internen Tools usw.
- Eine Software, die mehrere Tools kombiniert, nicht nur RAG
- Suche in Ihren Laufwerken
- Websuche
- Integration mit Ihren internen Tools
- fortgeschrittene Dokumentenverarbeitung
Das Ziel: eine KI, die Ihr Unternehmen so gut kennt wie ein erfahrener Mitarbeiter.
Häufige Fragen zu RAG
Was ist RAG in der KI?
RAG (Retrieval Augmented Generation) ist ein Ansatz, der ein KI-Modell mit Ihren eigenen Quellen verbindet. Bei jeder Frage sucht das System die relevanten Passagen in Ihren Dokumenten, Datenbanken oder Tools und übergibt sie dem Modell, das daraus eine belegte Antwort mit Quellenangaben formuliert.
Was ist der Unterschied zwischen einem LLM und RAG?
Ein LLM ist das Sprachmodell, das die Antwort formuliert. RAG ist das, was es umgibt: die Kette, die die richtige Information beschafft, bevor das Modell aufgerufen wird. RAG ersetzt das LLM nicht und verändert es nicht, es gibt ihm das Material für eine richtige Antwort.
Wie erweitert RAG ein LLM?
RAG erweitert nicht die Fähigkeiten des Modells, sondern das, was es vor Augen hat. Bei jeder Frage findet die Kette die relevanten Passagen in Ihren Quellen und fügt sie vor dem Aufruf in den Kontext des LLM ein. Das Modell formuliert seine Antwort dann auf Basis dieser Auszüge statt nur aus seinem Trainingsgedächtnis und kann angeben, woher jedes Element stammt.
Welches LLM für ein RAG?
Ein diszipliniertes Modell ist dem leistungsstärksten vorzuziehen: Es muss sich an die gelieferten Auszüge halten, zugeben, dass es etwas nicht weiß, wenn die Information fehlt, und seine Quellen nennen können. Weitere Kriterien sind das Kontextfenster, die Kosten pro Anfrage, die erwartete Latenz, die Qualität in der jeweiligen Sprache und der Rechtsraum, in dem die Anfragen verarbeitet werden. Ein gut geführtes Mittelklasse-Modell schlägt oft ein schlecht geführtes Spitzenmodell.
Muss man das LLM auf den eigenen Dokumenten neu trainieren?
Nein, in den allermeisten Fällen nicht. Ein LLM in einer RAG-Kette liest Ihre Dokumente bei jeder Anfrage, ohne sie sich zu merken. So greifen Aktualisierungen sofort, und Ihre Inhalte landen nicht in den Gewichten des Modells. Fine-Tuning bleibt nützlich, um einen Stil oder ein Ausgabeformat durchzusetzen, nicht um Wissen zu vermitteln.
Ersetzt RAG das Fine-Tuning?
Nein, beide decken unterschiedliche Bedürfnisse ab. Fine-Tuning wirkt auf Stil, Format und Vokabular. RAG liefert das Wissen, aktuell und überprüfbar. Um auf Basis von Unternehmensdokumenten zu antworten, braucht es RAG.
Wie lange dauert die Einführung eines RAG im Unternehmen?
Ein Prototyp steht in wenigen Tagen. Ein verlässliches System in Produktion braucht länger, weil der Großteil der Arbeit Ihre Dokumentformate, die Zugriffsrechte, die Bewertung der Antwortqualität und das Kostenmonitoring betrifft. Genau diese Lücke zwischen beidem lässt viele Projekte scheitern.
Kann man ein RAG in Europa oder on-premise betreiben?
Ja, und das ist in europäischen Organisationen ein häufiges Kriterium. Lokales Hosting und echte Souveränität sollte man allerdings nicht verwechseln: Diese Nuance erläutern wir in unserem Artikel über die Illusion des lokalen LLM.
Fazit: Mit RAG bekommen Ihre Unternehmensdaten eine Stimme
RAG ist nicht nur eine Technologie: Es ist eine Strategie der dokumentbasierten Intelligenz.
Es macht aus einer generischen KI einen echten internen Experten, der:
- Fragen präzise beantwortet
- komplexe Dokumente zusammenfasst
- Prozesse flüssiger macht
- Entscheidungen unterstützt
Die Messlatte liegt aber höher. Ein RAG, das sich mit einer einzigen Suche in einem PDF-Ordner begnügt, reicht nicht mehr. Den Unterschied machen heute die Fähigkeit, Ihre Dokumente richtig zu analysieren, über mehrere Quellen hinweg zu ermitteln und jede Antwort zu begründen.
Wenn Sie eine KI wollen, die Ihr Unternehmen wirklich versteht, liegt genau dort der Schlüssel. Und wir können Ihnen helfen, sie einzurichten.
Demo buchen, um es an Ihren eigenen Dokumenten zu besprechen.