Due Diligence mit Agentic RAG: das richtige Dokument finden
Auf FinanceBench steigt dasselbe Modell je nach Suchsoftware von 27 % auf 86 % richtige Antworten. In der Due Diligence zählt vor allem: das richtige Dokument.

Im August 2026 hat Mistral die Ergebnisse seiner agentischen Suche (Agentic Search, oft auch Agentic RAG genannt) auf FinanceBench veröffentlicht, einem Test mit 150 Analystenfragen zu 368 Berichten börsennotierter Unternehmen. Mit demselben Modell, GLM-5.2, steigt die Präzision von 26,7 % auf 86 %, je nachdem, wie die Software in den Berichten sucht. Das Modell ändert sich nicht, die Dokumente auch nicht: Es ändert sich nur die Art, die Information zu beschaffen.
Dieses Ergebnis bestätigt, was der Test schon 2023 zeigte: Ein Sprachmodell interpretiert einen Finanzbericht gut, wenn man ihm die richtige Seite vorlegt. Was die Präzision einbrechen lässt, ist die Notwendigkeit, diese Seite zu finden. Das Modell ist nicht mehr das Thema: Entscheidend ist die Software, die die Information sucht und den Agenten steuert.
Für ein Due-Diligence-Team ist die Konsequenz unmittelbar. Ein Datenraum besteht aus hunderten Dokumenten, die sich ähneln: drei Jahresabschlüsse, mehrere Versionen eines Vertrags, ein Abschlusspaket pro Tochtergesellschaft. Das Schwierigste ist nicht, die Dokumente zu interpretieren, sondern das richtige zu finden, und genau hier trennen sich die KI-Werkzeuge.
Ein Dokument interpretieren oder das richtige finden: zwei verschiedene Aufgaben
FinanceBench ist ein Fragenkatalog, den Patronus AI im November 2023 veröffentlicht hat, um zu messen, wie gut eine KI Analystenfragen anhand echter Berichte beantwortet: Jahresberichte (10-K), Quartalsberichte (10-Q), Ergebnismitteilungen. Jede Frage hat eine eindeutige, überprüfbare Antwort, einen Betrag, eine Kennzahl oder eine Erklärung aus dem Bericht.
Die Autoren haben GPT-4 Turbo die 150 öffentlichen Fragen in fünf Konfigurationen gestellt und dabei nur verändert, was das Modell erhält. Die Antworten wurden von Hand bewertet. Die Ergebnisse aus Tabelle 2 zeichnen eine Treppe:
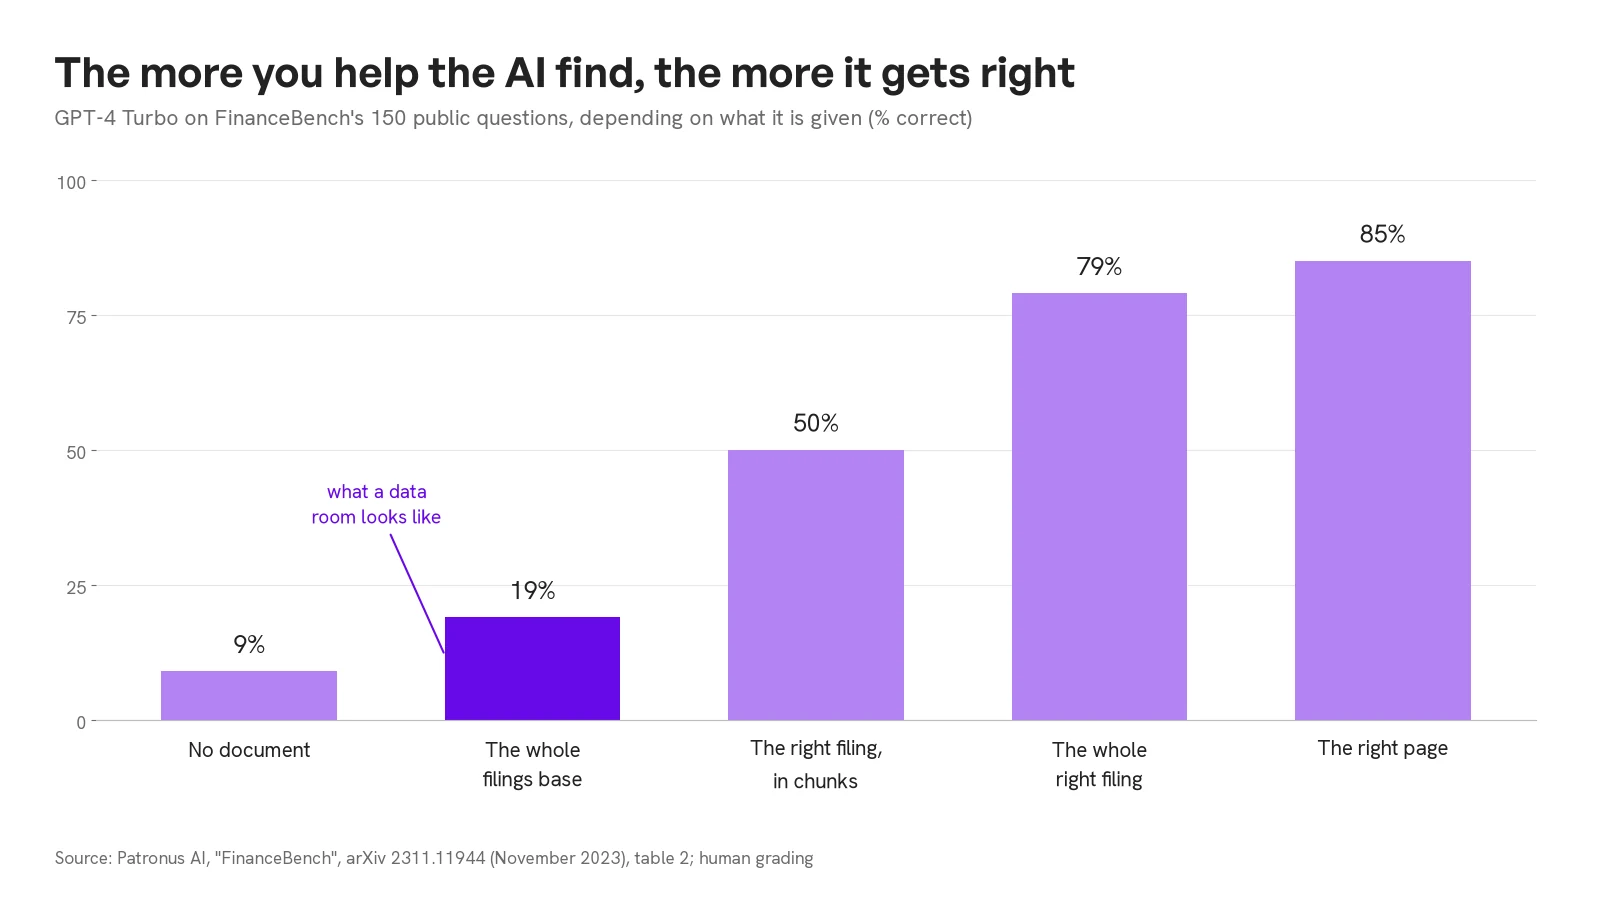 Balkendiagramm: GPT-4 Turbo beantwortet 9 % der Fragen ohne Dokument richtig, 19 %, wenn es in der gesamten Berichtsbasis sucht, 50 % mit dem richtigen Bericht in Auszügen, 79 % mit dem vollständigen richtigen Bericht, 85 % mit der richtigen Seite
Ohne jedes Dokument antwortet das Modell zu 9 % richtig. Mit der richtigen Seite steigt es auf 85 %. Dazwischen hängt alles vom Suchaufwand ab, den man ihm überlässt: 19 %, wenn es die Passage in einer gemeinsamen Basis aller Berichte finden muss, 50 %, wenn die Basis nur den richtigen Bericht enthält, 79 %, wenn der ganze Bericht in sein Kontextfenster passt. Von 19 % auf 85 %, ohne das Modell zu wechseln: Der Abstand kommt vollständig aus dem, was gefunden werden muss.
Die Zusammenfassung des Artikels sagt es unverblümt: GPT-4 Turbo mit einem Retrieval-System „incorrectly answered or refused to answer 81% of questions“. Der Anbieter Ragie fand ein Jahr später mit seiner eigenen Engine denselben Abstand: 27 % in der gemeinsamen Basis, 51 % in einer auf das richtige Dokument beschränkten Basis. Den Suchraum einzugrenzen, verdoppelt die Präzision.
Was ist Agentic RAG? Bei gleichem Modell verdreifacht die Software die Präzision
Die agentische Suche (Agentic Search oder Agentic RAG) bezeichnet eine Software, die sich nicht mit einer einzigen Suche begnügt: Sie verkettet Suchen, öffnet Dokumente, die relevant erscheinen, geht sie durch, prüft, was sie gefunden hat, und entscheidet, wann sie genug weiß, um zu antworten. Das Sprachmodell formuliert und denkt; die Software um es herum steuert die Untersuchung.
Der Beitrag von Mistral vom 20. August 2026 isoliert genau den Effekt dieser Software. Dieselben 150 Fragen, dieselben 368 Berichte, dasselbe Modell, drei Arten zu suchen: ein RAG „in einem Durchgang“, das „retrieves a fixed set of text chunks and asks a model to answer in a single pass“, eine Schleife verketteter Suchen und dieselbe Schleife mit Werkzeugen zur Navigation in den Dokumenten.
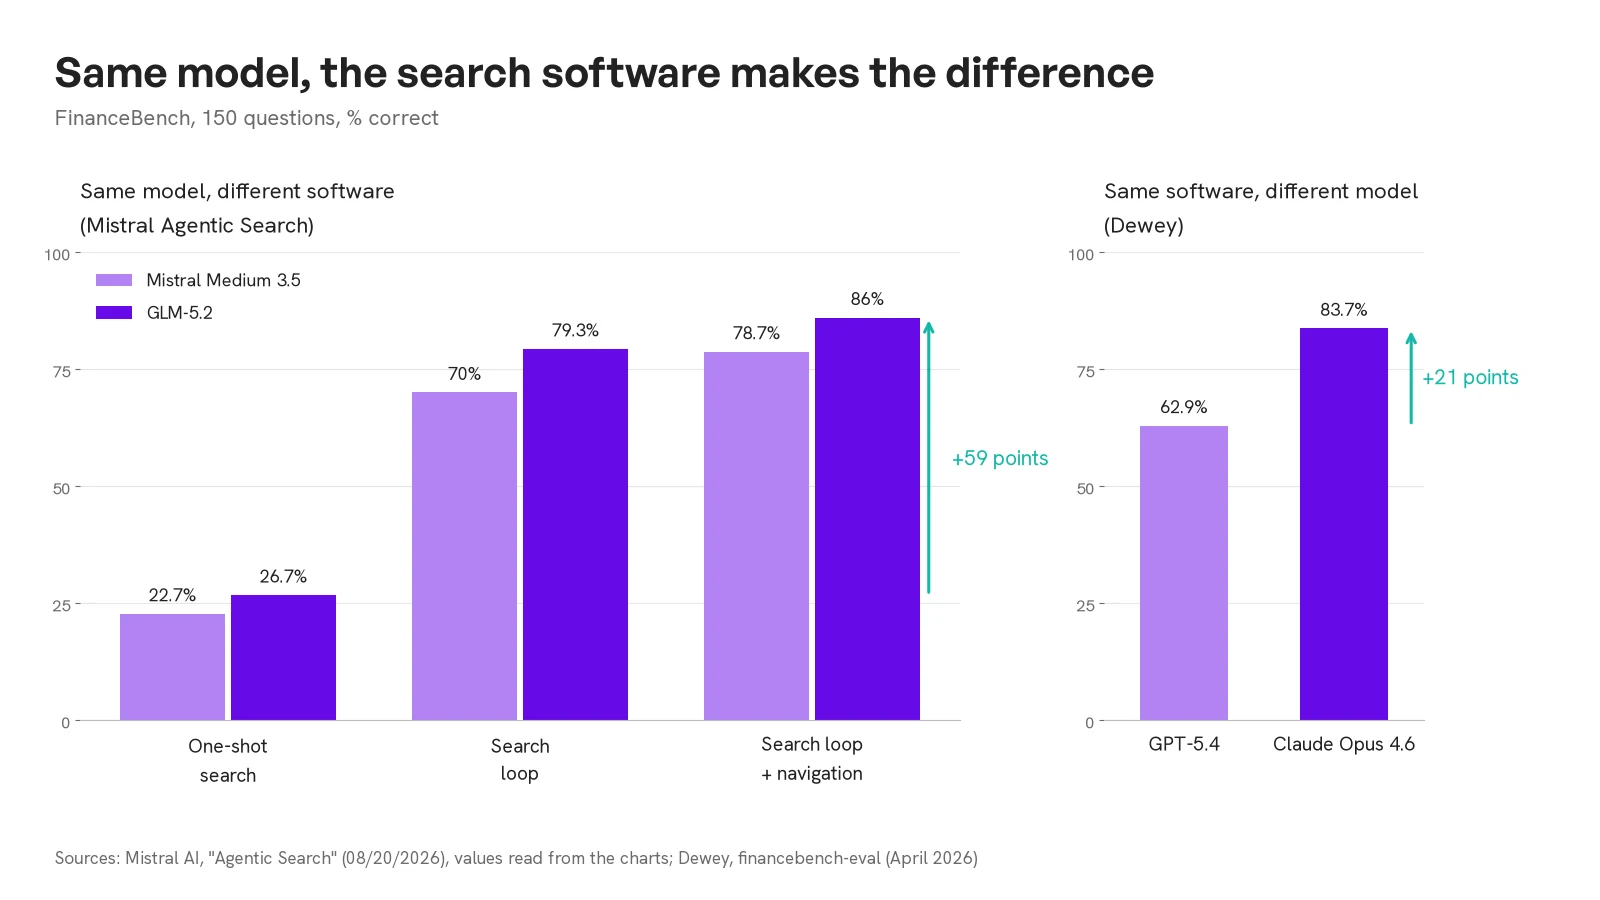 Zweiteiliges Diagramm. Links, gleiches Modell und andere Software: Mistral Medium 3.5 steigt von 22,7 % auf 70 %, dann 78,7 %, GLM-5.2 von 26,7 % auf 79,3 %, dann 86 %. Rechts, gleiche Software und anderes Modell bei Dewey: 62,9 % für GPT-5.4, 83,7 % für Claude Opus 4.6
Die Suchschleife bringt Mistral Medium 3.5 47,3 Punkte und GLM-5.2 52,6 Punkte; die Navigation fügt weitere 8,7 und 6,7 hinzu. Insgesamt verdreifacht dasselbe Modell seine Präzision, ohne dass seine Parameter angetastet werden. Mistral merkt außerdem an, dass die Navigation den Token-Verbrauch um ein Viertel bis ein Drittel senkt: Besser suchen kostet weniger als viel suchen.
Das Modell zählt noch. Dewey hat das umgekehrte Experiment gemacht: gleiche Ingestion, gleiche agentische Suchengine, nur das Modell wechselt. Claude Opus 4.6 erreicht 83,7 %, GPT-5.4 62,9 %, also 21 Punkte Abstand. Derselbe Beitrag zeigt aber, dass Opus pro Frage im Schnitt 21,2 Aufrufe des Suchwerkzeugs macht, GPT-5.4 dagegen 9,4: Ein Teil des Abstands liegt daran, wie jedes Modell die Software nutzt. Das Modell zählt; die Software zählt mehr, mit 56 bis 59 Punkten Abstand bei Mistral gegenüber 21 bei Dewey.
Unsere eigene Erfahrung zeigt in dieselbe Richtung. Auf FinanceBench ändert der Austausch von Qwen 3.8 27B, dem Modell, das die Antworten von ATG formuliert, gegen Gemini 3.8 Flash den Score nicht. Wir haben den Test außerdem mit demselben Modell bei zwei verschiedenen Hostern durchgeführt, einem globalen und einem europäischen: 138 und 139 richtige Antworten von 150. Nur die Antwortzeit ändert sich: im Schnitt 10,5 Sekunden auf der einen Seite, 30,9 auf der anderen.
Was diese Software tut: suchen, öffnen, auswählen, aufhören
Die Software, die die Suche steuert, trifft vier Entscheidungen, die das Modell allein nicht trifft. Sie grenzt den Umfang vor der Suche ein: das Unternehmen, das Geschäftsjahr, die Dokumentart. Das erlaubt es einem RAG, auch bei zehntausenden Dokumenten zu bestehen, wie wir in unserem Artikel darüber, wie viele Dokumente ein RAG verarbeiten kann, erklären. Sie verkettet Suchen, wenn die erste nicht reicht. Sie öffnet und durchsucht einen Bericht, wenn die Information in einer Tabelle steht, die Auszüge schlecht zerschneiden. Und schließlich hört sie auf: Sie entscheidet, dass sie genug Elemente hat oder dass sie nichts gefunden hat und das sagen muss.
Ein Beispiel aus unseren FinanceBench-Berichten zeigt diese Entscheidungen bei der Arbeit. Frage: „Was there any drop in Cash & Cash equivalents between FY 2023 and Q2 of FY2024?“, zu Best Buy. Die Antwort erfordert zwei Dokumente aus zwei verschiedenen Perioden, unter den Jahresberichten, Quartalsberichten und Mitteilungen desselben Händlers. ATG hat den Jahresbericht 2023 und die Mitteilung zum zweiten Quartal 2024 zitiert: 1.874 Millionen Dollar zum Ende des Geschäftsjahres 2023, 1.093 Millionen im zweiten Quartal des folgenden Geschäftsjahres, also ein Rückgang um 41,7 %. Die erwartete Antwort lautete „etwa 42 %“. ATG wies nebenbei darauf hin, dass das Geschäftsjahr von Best Buy Ende Januar endet, was alle Bezeichnungen um ein Jahr verschiebt. Eine Suche, 7,2 Sekunden.
Die Falle der ähnlichen Dokumente
Eine Basis von Finanzberichten ist aus einem einfachen Grund ein schwieriger Fall: Die Dokumente ähneln sich. Der Jahresbericht 2022 und der Jahresbericht 2023 desselben Unternehmens haben dieselbe Struktur, dieselben Überschriften, oft dieselben Sätze. Eine Suche nach semantischer Ähnlichkeit stellt sie auf eine Stufe. Filtert die Software nicht nach Geschäftsjahr, erhält das Modell die richtige Tabelle aus dem falschen Jahr und interpretiert sie tadellos.
FinanceBench liefert dafür einen Hinweis. Elf der ursprünglichen Fragen nennen weder Geschäftsjahr noch Unternehmen („this 10-K report“): Sie waren für ein einziges Dokument geschrieben, während die Basis mehrere pro Unternehmen enthält. So gestellt haben sie keine eindeutige Antwort. In unserem Protokoll haben wir ihnen einen festen Satz hinzugefügt, der Zeitraum oder Unternehmen präzisiert, ohne den Rest der Frage zu verändern.
Ein Due-Diligence-Datenraum treibt diese Falle weiter. Dort liegen drei Jahresabschlüsse, Abschlusspakete pro Tochtergesellschaft, mehrere Versionen desselben Vertrags, Excel-Tabellen, die die Zahlen aus den PDFs wiederholen. Eine richtige Antwort aus dem falschen Geschäftsjahr bleibt eine falsche Antwort, und das richtige Dokument auszuwählen, ist Aufgabe der Software, nicht des Modells. Die Wege, einer KI Zugang zu diesen Dokumenten zu geben (API, MCP, Export), behandelt unser Artikel über Datenräume und KI.
Was das für eine Due Diligence ändert
Jede Konfiguration von FinanceBench entspricht einer Situation in der Due Diligence.
| FinanceBench-Konfiguration | Situation in der Due Diligence | GPT-4 Turbo (2023) |
|---|---|---|
| kein Dokument | einen Assistenten für Endverbraucher fragen, was er über das Zielunternehmen weiß | 9 % |
| die gesamte Berichtsbasis | den ganzen Datenraum befragen | 19 % |
| der richtige Bericht, in Auszügen | den Jahresbericht in einen Assistenten hochladen | 50 % |
| die richtige Seite | eine Tabelle in den Assistenten kopieren | 85 % |
Die entscheidende Zeile ist die zweite. Sie ist die einzige, die der echten Arbeit ähnelt: hunderte Dokumente, eine Frage und niemand, der zeigt, wo die Antwort steht. Sie ist auch die Zeile, in der der Abstand zwischen Softwarelösungen am größten ist, und die, die eine Demo mit einer einzigen Datei nicht testet.
Wie man die Demo eines KI-Tools liest
Wenn eine Demo mit einem PDF läuft, das vor den Augen des Kunden hochgeladen wird, beweist sie, dass das Modell einen Bericht gut interpretiert. Über seine Fähigkeit, diesen Bericht unter fünfhundert anderen zu finden, sagt sie nichts, und genau das ist die Schwierigkeit eines Datenraums.
Drei Fragen trennen die Werkzeuge besser als der Name des Modells. Läuft die Demo mit einer vorab ausgewählten Datei oder mit der ganzen Basis? Was tut die Software um das Modell herum: eine einzige Suche oder eine Untersuchung, die Dokumente öffnet und nach Unternehmen und Geschäftsjahr filtert? Und wenn die Information nicht existiert, sagt das Tool es? Eine vierte Frage ergänzt sie: Veröffentlicht der Anbieter eine Präzisionsmessung auf einem öffentlichen Test, mit den Bedingungen? Ein Tool nach seinem Modell auszuwählen, heißt auf die falsche Variable zu schauen.
Für M&A-, Transaction-Services- und Fondsteams beschreiben wir unseren Ansatz für die Financial Due Diligence: Datenraum, Abschlüsse, Excel, mit einer Quellenangabe für jede Antwort.
Unsere Ergebnisse auf FinanceBench
Wir haben FinanceBench unter den Bedingungen der zweiten Tabellenzeile durchgeführt: 368 Berichte in einer standardmäßigen ATG-Wissensdatenbank, jede Frage einzeln gestellt, ohne Hinweis auf das richtige Dokument. ATG beantwortet 138 von 150 Fragen richtig (92 %), mit einer durchschnittlichen Antwortzeit von 10,5 Sekunden und im Schnitt 1,5 Aufrufen des Suchwerkzeugs pro Frage. Protokoll, jede Frage, jede Antwort und jedes Urteil sind auf unserer FinanceBench-Seite veröffentlicht. Die Bewertungsbedingungen unterscheiden sich von Quelle zu Quelle (menschliche Bewertung bei Patronus AI, automatischer Bewerter anderswo): Diese Zahlen ordnen die Ansätze ein, sie ergeben keine Rangliste.
Häufige Fragen zur agentischen Suche in der Due Diligence
Was ist agentische Suche (Agentic Search oder Agentic RAG)?
Agentische Suche bezeichnet eine Software, die die Informationssuche für ein Sprachmodell steuert. Statt eine einzige Suche zu starten und mit den erhaltenen Auszügen zu antworten, verkettet sie Suchen, filtert nach Unternehmen oder Zeitraum, öffnet und durchsucht die Dokumente, prüft, was sie gefunden hat, und entscheidet, wann sie aufhört. Auf FinanceBench bringt dieser Ansatz dasselbe Modell laut Mistral von 26,7 % auf 86 % richtige Antworten.
Zählt die Wahl des KI-Modells noch, um Finanzdokumente zu analysieren?
Ja, aber weniger als die Suchsoftware. Bei Dewey liegen mit derselben Software 21 Punkte zwischen Claude Opus 4.6 und GPT-5.4 auf FinanceBench. Bei Mistral bringt mit demselben Modell der Wechsel der Suchmethode 56 bis 59 Punkte. Für andere Aufgaben bleibt das Modell entscheidend, etwa um eine lange Analyse zu verfassen oder eine schlecht formulierte Frage zu verstehen.
Warum irrt sich eine KI in einem Datenraum häufiger als bei einem einzelnen PDF?
Weil sie zuerst das richtige Dokument finden muss. Auf FinanceBench beantwortet GPT-4 Turbo 50 bis 79 % der Fragen richtig, wenn man ihm den richtigen Bericht gibt, und 19 %, wenn es ihn in der gesamten Basis suchen muss. Ähnliche Dokumente (aufeinanderfolgende Geschäftsjahre, Versionen, Tochtergesellschaften) vergrößern den Abstand: Eine Suche nach semantischer Ähnlichkeit verwechselt sie leicht.
Wie bewertet man ein KI-Tool für die Due Diligence?
Der aussagekräftigste Test stellt echte Fragen zu einem vollständigen Dokumentenbestand, ohne dem Tool zu sagen, wo die Antwort steht, und enthält Fragen, deren Antwort nicht in den Dokumenten steht. Dann zählen die Richtigkeit der Antworten, die Quellenangabe, die Antwortzeit und die Fähigkeit des Tools zu sagen, dass es nichts gefunden hat. Ein Anbieter, der seine Ergebnisse auf einem öffentlichen Test wie FinanceBench veröffentlicht, ermöglicht den Vergleich schon vor dem Test.
Das Modell zu wechseln, ist eine Zeile in der Konfiguration. Die Software, die es steuert, entsteht langsamer: Filter, Navigation, Wahl des richtigen Geschäftsjahres, Verweigerung einer Antwort ohne Quelle. In der Due Diligence macht sie den Unterschied, und sehen kann man sie bei der Arbeit nur in einem echten Datenraum, nicht mit einem vorab ausgewählten PDF.