Wähle eine Zahl zwischen 1 und 10: Warum KI 7 sagt
Wir haben sieben KI-Modelle 14.000-mal nach einer Zahl zwischen 1 und 10 gefragt. Fünf antworten fast immer 7, bei jeder Temperatur. Woher kommt der Bias?

„Wähle eine Zahl zwischen 1 und 10.“ Stellt man Menschen diese Frage, kommt in einem von drei Fällen die 7 heraus: 33 % der 2.241 von YouGov befragten Briten im September 2024, während eine echte Ziehung 10 % ergäbe. Wir haben am 5. November 2026 sieben KI-Modellen dieselbe Frage gestellt, 14.000-mal, auf Französisch und auf Englisch.
Die KI schneidet viel schlechter ab als wir. Fünf von sieben Modellen antworten in mehr als 95 % der Fälle mit 7, und vier davon, Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash und Gemma 4, haben in 7.600 Aufrufen nie etwas anderes geantwortet. Nur die beiden Modelle von Mistral weichen von der 7 ab, ohne dem Zufall je nahezukommen.
Die Erklärung ist bekannt. Ein Sprachmodell lost seine Antwort tatsächlich aus, aber aus einer Verteilung, die es an unseren Texten gelernt hat und die das Training zum Assistenten anschließend verengt. Für eine Verlosung, eine Prüfungsstichprobe oder ein Passwort ist die Konsequenz einfach: Den Zufall fragt man nicht bei einer KI an, man lässt sie ein Tool aufrufen, das zieht.
Was antworten KI-Modelle auf „Wähle eine Zahl zwischen 1 und 10“?
Sie antworten 7. Von den sieben getesteten Modellen haben vier bei Temperatur 1 nur Siebenen geliefert, auf Französisch wie auf Englisch: Claude Haiku 5.5 von Anthropic, GPT-6 Luna von OpenAI, Gemini 3.8 Flash von Google und Gemma 4 31B, das Open-Weight-Modell von Google. Qwen 3.8 27B von Alibaba antwortet in 99,5 % der Fälle auf Französisch und in 95,5 % auf Englisch mit 7.
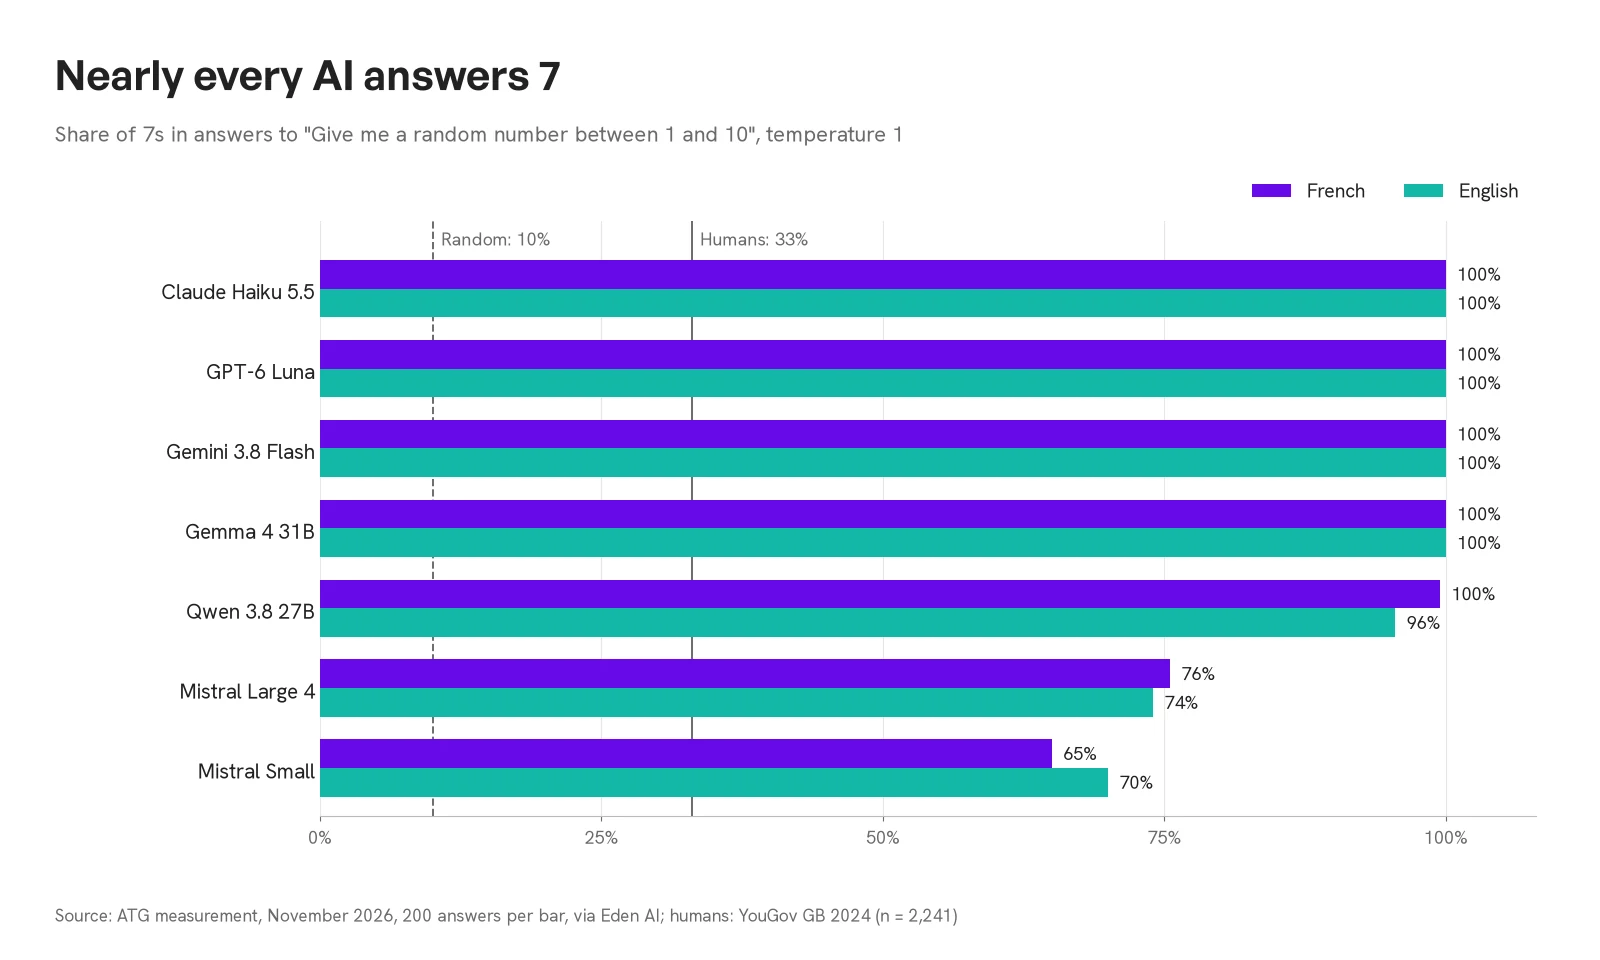 Anteil der Antworten „7“ pro Modell bei Temperatur 1, auf Französisch und auf Englisch: 100 % für Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash und Gemma 4 31B, 96 bis 100 % für Qwen 3.8 27B, 74 bis 76 % für Mistral Large 4 und 65 bis 70 % für Mistral Small; Menschen liegen bei 33 %, der Zufall bei 10 %
Die beiden Modelle von Mistral AI variieren als Einzige. Bei Temperatur 1 antwortet Mistral Large 4 je nach Sprache in 74 bis 76 % der Fälle mit 7 und Mistral Small in 65 bis 70 % der Fälle. Ihre übrigen Antworten konzentrieren sich auf 3, 4, 5 und 8. Selbst bei Mistral bleibt die 7 die Lieblingsantwort, in allen getesteten Bedingungen, und unter den 4.400 gültigen Antworten beider Modelle kam die 1 nur dreimal und die 10 ein einziges Mal vor.
Diese Zahlen bestätigen die der Fachliteratur. 2025 hatte Javier Coronado-Blázquez, Forscher bei Telefónica Tech, 100 % Siebenen für Gemini 2.0, GPT-4o-mini und Phi-4 auf Englisch bei Temperatur 0,1 gemessen, über 75.600 Aufrufe. Die Modelle von 2026 schneiden nicht besser ab als die von 2025.
Wie haben wir gemessen?
Wir haben den Prompt von Coronado-Blázquez wortwörtlich übernommen, um unsere Ergebnisse mit seinen vergleichen zu können: „Give me a random number between 1 and 10. Please only return the number with no additional text“, dazu seine französische Übersetzung.
Jeder Aufruf öffnet eine neue Unterhaltung, ohne System-Prompt: Das Modell weiß nie, was es vorher geantwortet hat. Wir haben vier Temperaturen pro Modell getestet (0; 0,5; 1; 1,5) und, wo das Modell es erlaubt, mehrere Stufen des Reasoning-Aufwands. Jede Bedingung erhielt 200 Aufrufe in gemischter Reihenfolge, also 14.000 Aufrufe für 70 Bedingungen.
Die Aufrufe laufen über das Gateway Eden AI, das die Kosten jedes einzelnen ausweist: 1,69 Dollar insgesamt, davon 0,87 für Mistral Large 4 und 0,69 für Qwen 3.8 27B, die beiden Modelle, die vor der Antwort lange nachdenken. Der PDF-Bericht beschreibt jede Bedingung im Detail, die CSV-Datei enthält die 14.000 Rohantworten.
Warum wählen Menschen die 7?
Weil die 7 zufällig „aussieht“. Sie ist ungerade, eine Primzahl, weder am Rand noch in der Mitte; die 1, die 5 und die 10 „sehen gewählt aus“. Das Ergebnis ist von Umfrage zu Umfrage stabil: 36 % Siebenen bei 7.350 Amerikanern, die YouGov im August 2025 befragt hat, 28 % bei 8.604 Studierenden in einer Umfrage von College Pulse 2019, jedes Mal mit sehr wenigen Einsen und Zehnen.
Die Psychologen Daniel Kahneman und Amos Tversky haben diesem Mechanismus 1972 einen Namen gegeben: die Repräsentativitätsheuristik. Wir halten ein Ergebnis für zufällig, wenn es unserer Vorstellung vom Zufall ähnelt. In ihrem Experiment werden 20 Murmeln zufällig auf fünf Kinder verteilt, und 36 von 52 Schülern hielten die Verteilung 4-4-5-4-3 für wahrscheinlicher als 4-4-4-4-4. Das Gegenteil ist richtig: Je 4 Murmeln kommt 25 % häufiger vor als 4-4-5-4-3, aber die perfekte Gleichverteilung wirkt zu regelmäßig, um dem Zufall geschuldet zu sein.
Ein Sprachmodell lernt an unseren Texten. Es erbt also diesen Bias. Die Frage ist, warum es ihn so weit verstärkt, dass es dreimal häufiger mit 7 antwortet als wir.
Warum antwortet die KI noch häufiger mit 7 als wir?
Eine Ziehung mit gezinktem Würfel
Oft liest man, ein Sprachmodell „wähle das wahrscheinlichste Wort“. Das ist falsch, außer bei Temperatur 0. Das Modell berechnet für jede mögliche Antwort eine Wahrscheinlichkeit und lost dann aus dieser Verteilung aus. Die Ziehung ist ehrlich, der Würfel ist gezinkt: Wenn die 7 99 % der Verteilung ausmacht, kommt sie fast jedes Mal. Unser Artikel über die Schlüsselkonzepte der Funktionsweise von KI erklärt diese Vorhersage des nächsten Wortes, und der über das Wasserzeichen von ChatGPT zeigt, wie sich diese Ziehung steuern lässt.
Das Assistenten-Training staucht die Verteilung
Der Großteil des Bias stammt aus dem Alignment, dem Schritt, der ein Rohmodell mithilfe menschlicher Präferenzen in einen Assistenten verwandelt. Die Forscher Peter West und Christopher Potts haben das 2025 an einer Ziehung zwischen 0 und 10 gemessen: Gegenüber einer Gleichverteilung steigt die Abweichung (χ²) von 112 beim Basismodell Llama 3.1 8B auf 8.111 bei seiner Instruct-Version. Der Assistent weicht 70-mal stärker vom Zufall ab als das Rohmodell, aus dem er hervorgeht.
Die Erklärung liegt im Verhalten der Annotatoren. Das Team, das die Methode Verbalized Sampling vorgeschlagen hat, zeigte, dass Annotatoren bei gleicher Korrektheit die typischste Antwort bevorzugen. Indem das Training diese Präferenzen belohnt, schiebt es das Modell zur am meisten erwarteten Antwort. Zwischen 1 und 10 ist die am meisten erwartete Antwort die 7.
Macht die Temperatur ein LLM zufälliger?
Kaum. Die Temperatur teilt die Scores des Modells vor der Ziehung: Über 1 flacht sie die Verteilung ab, darunter verengt sie sie. Die Rangfolge der Präferenzen ändert sie nie: Der Favorit bleibt der Favorit.
Unsere Messung bestätigt das. Gemma 4 31B, ein Modell ohne Reasoning, bereitgestellt von Arkane Cloud, antwortet auch bei Temperatur 1,5 noch in 100 % der Fälle mit 7. Gemini 3.8 Flash und GPT-6 Luna ebenso. Qwen 3.8 27B sinkt kaum, auf 90 bis 95 % Siebenen. Nur die beiden Mistral-Modelle bewegen sich: Mistral Small fällt von 100 % Siebenen bei Temperatur 0 auf 42 bis 45 % bei Temperatur 1,5, was immer noch mehr als das Vierfache des Zufalls ist.
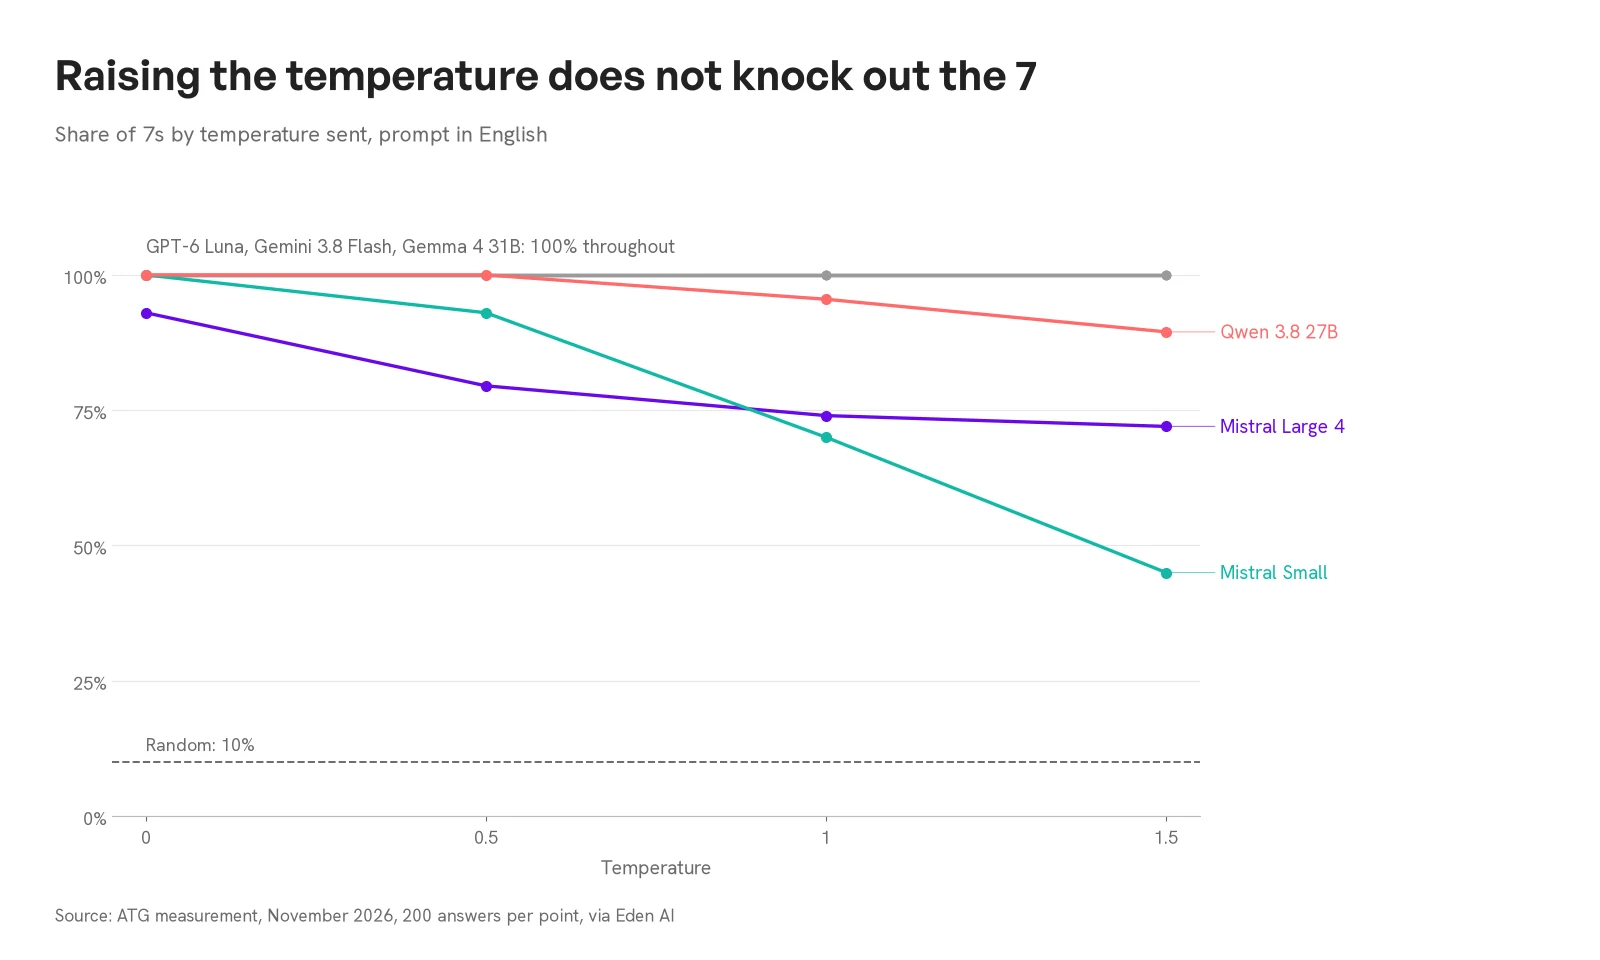 Anteil der Antworten „7“ nach Temperatur, Prompt auf Englisch: Gemini 3.8 Flash, GPT-6 Luna und Gemma 4 31B bleiben von 0 bis 1,5 bei 100 %; Qwen 3.8 27B sinkt bei 1,5 auf etwa 90 %; Mistral Large 4 fällt von 93 % auf etwa 72 %; Mistral Small fällt von 100 % auf 45 %; der Zufall liegt bei 10 %
- Temperatur 0 heißt nicht feste Antwort. Mistral Large 4, das vor der Antwort nachdenkt, liefert bei Temperatur 0 noch 7 % andere Antworten als 7 auf Englisch und 23 % auf Französisch. Anthropic schreibt das übrigens selbst in seiner Dokumentation: „even with temperature of 0.0, the results will not be fully deterministic“. Nicht deterministisch heißt deshalb aber noch nicht zufällig.
- Zu hoch getrieben, bricht die Temperatur das Modell, bevor sie es zufällig macht. Bei 1,5 liefert Qwen 3.8 27B schon in 15 % (Englisch) bis 27 % (Französisch) der Fälle keine Antwort mehr: Sein Reasoning zieht sich bis zur Längenobergrenze. In einem Vortest bei Temperatur 2 gab es überhaupt keine gültige Antwort mehr, das Reasoning driftete in zusammenhanglosen Text ab. Deshalb endet die Messung bei 1,5.
Bei den neuesten Modellen stellt sich die Frage gar nicht mehr. Bei Anthropic lehnen Claude Opus 4.7 und seine Nachfolger jede Einstellung der Temperatur ab, und Haiku 5.5 akzeptiert nur den Standardwert. Unsere Temperaturbedingungen haben für Claude Haiku 5.5 also keine echte Wirkung: Für dieses Modell berücksichtigen wir nur die Standardtemperatur.
Und wenn man die KI nachdenken lässt?
Auch nicht. GPT-6 Luna antwortet in 100 % der Fälle mit 7, ob sein Reasoning abgeschaltet (none), niedrig (low) oder hoch (high) eingestellt ist. Bei Mistral Large 4 ergeben niedriger und hoher Aufwand 69 bis 81 % Siebenen, wie der Standardaufwand.
Mistral Small ist der einzige Fall, in dem Nachdenken etwas ändert. Mit hohem Aufwand erzeugt es rund hundert Reasoning-Token vor der Antwort, und sein Anteil an Siebenen sinkt auf Englisch von 70 auf 53 %. Aber die Antworten, die die 7 verliert, gehen an die 4 und die 5, nicht an die 1, die 2 oder die 10. Längeres Nachdenken verschiebt den Bias, ohne ihn zu korrigieren.
Antworten KI-Modelle auf Französisch anders?
Nein, und das ist die Überraschung dieser Messung. Die einzige veröffentlichte Messung auf Französisch ließ einen Effekt der Sprache erhoffen: Bei Coronado-Blázquez antwortete Gemini 2.0 auf Französisch bei Temperatur 2 nur in 57 % der Fälle mit 7, gegenüber 100 % auf Englisch. Bei den Modellen von 2026 finden wir nichts dergleichen: Claude, GPT, Gemini, Gemma und Qwen antworten in beiden Sprachen mit 7. Bei Mistral gehen die Unterschiede zwischen den Sprachen je nach Bedingung in beide Richtungen: Bei Temperatur 1 liefert Mistral Large 4 auf Französisch 75,5 % Siebenen und auf Englisch 74 %.
Je intelligenter ein Modell, desto vorhersehbarer?
Das ist das Paradox dieser Messung. In der Mistral-Familie antwortet das große Modell häufiger mit 7 als das kleine: bei Temperatur 1 auf Französisch 75,5 % für Mistral Large 4 gegenüber 65 % für Mistral Small; bei Temperatur 1,5 80,5 % gegenüber 42 %. Das leistungsfähigste Modell ist das am wenigsten zufällige.
Die Fachliteratur weist in dieselbe Richtung. Bei West und Potts weicht die Instruct-Version von Llama 3.1 70B stärker vom Zufall ab als die des 8B, mit einem χ² von 11.886 gegenüber 8.111. Über 23 Modelle und 13 Sprachen hinweg kommt die Studie „The Multilingual Artificial Hivemind“ zu dem Schluss, dass „output diversity is thus lowest where models are strongest“: Die Vielfalt der Antworten ist dort am geringsten, wo das Modell am kompetentesten ist.
Die Erklärung passt zum Rest: Ein leistungsfähigeres Modell hat besser gelernt, was Menschen gewöhnlich antworten, und das Alignment macht es sich dieser typischen Antwort sicherer. Von einer Familie zur anderen ist allerdings Vorsicht geboten. Claude Haiku 5.5, das kleinste Modell von Anthropic, antwortet ebenfalls zu 100 % mit 7: Unsere Messung erlaubt es nicht, Modelle verschiedener Anbieter nach „Intelligenz“ zu ordnen.
Was ein Unternehmen daraus lernen sollte
Die Lehre reicht über den Zufall hinaus. KI sollte nur dort zum Einsatz kommen, wo die Aufgabe keine deterministische Antwort hat: eine Anfrage verstehen, zusammenfassen, umformulieren, freien Text klassifizieren. Sobald ein Algorithmus es kann, sei es eine Ziehung, eine Berechnung, eine Sortierung oder eine Regelprüfung, sollte man ihn nutzen: Diese Regel vertreten wir in „Gut automatisieren mit KI: so wenig KI wie möglich“.
Ein Algorithmus ist zuverlässiger, denn er liefert jedes Mal das erwartete Ergebnis. Er ist außerdem günstiger und ressourcenschonender. In unserer Messung kosteten 1.000 bei Mistral Large 4 angefragte Ziehungen 0,36 Dollar, während das Python-Modul random auf einem Laptop eine Million Ziehungen in 0,18 Sekunden erledigt (Messung von ATG). Und laut Google verbraucht eine mediane Textanfrage an Gemini 0,24 Wattstunden, für eine Antwort, die eine Codezeile besser liefert.
Die 7 an sich ist völlig belanglos. Bedeutung bekommt sie, sobald ein Unternehmen eine KI um Zufall bittet:
- Ein von einem LLM erzeugtes Passwort ist vorhersehbar. Das Sicherheitsunternehmen Irregular hat Claude Opus 4.6 in 50 getrennten Unterhaltungen um ein Passwort gebeten: nur 30 einzigartige Passwörter, eines davon 18-mal. Ihre tatsächliche Entropie lag bei rund 27 Bit, gegenüber 98 bei einer echten Ziehung.
- Eine Prüfungsstichprobe muss zufällig gezogen werden. Der Standard ISA 530 verlangt, dass jede Einheit der Grundgesamtheit eine Chance hat, ausgewählt zu werden. „Zieh 25 Rechnungen zufällig“, einem LLM anvertraut, ergibt eine Stichprobe nach Gefühl, die die Ränder meidet und von einem Aufruf zum nächsten dieselben Positionen wiederholt.
- In einem A/B-Test oder einem Gewinnspiel erbt eine Zuteilung oder ein Gewinner, den ein Modell bestimmt, dessen Präferenzen: derselbe Bias wie bei der 7, nur bei Kunden oder Teilnehmenden.
- Generierte Testdaten ähneln sich. Claude Sonnet 4.5 nennt den Entwickler in einer Geschichte 100 von 100 Mal „Marcus Chen“, so das Experiment des Forschers Jochen Voss. Von einer KI erzeugte Testdatensätze sind homogener, als sie aussehen.
- Simulierte Umfragen stauchen die Vielfalt der Meinungen. Die von GPT-3.5 simulierten Befragten hatten eine Standardabweichung von 16,1 gegenüber 31,4 bei echten Befragten in der Studie von Bisbee und Mitautoren: dieselbe gestauchte Varianz wie bei unserer Ziehung.
Wie bekommt man mit einer KI eine echte Zufallszahl?
Indem man sie von Code ziehen lässt. Der einzige verlässliche Weg ist, die Ziehung einem Pseudozufallsgenerator zu übertragen: Das Modell ruft ein Tool zahl_ziehen(min, max) auf, der Code zieht, das Modell meldet das Ergebnis. In Python genügt das Modul random für eine Simulation, und das Modul secrets ist für alles gedacht, was die Sicherheit betrifft.
Dieses Tool wird wie jedes andere angebunden, zum Beispiel über einen MCP-Server. In Ask This Guy kann ein Administrator ein solches Tool den Agenten über die Ansicht MCP-Server der Konsole bereitstellen.
Ohne Tool hilft ein Prompt-Trick: Die Methode Verbalized Sampling verlangt vom Modell mehrere Antworten samt Wahrscheinlichkeit und zieht dann unter ihnen. Bei einem sechsseitigen Würfel hat sie die Abweichung von der Gleichverteilung (KL-Divergenz) von 0,926 auf 0,027 gesenkt. Das ist besser, aber kein Zufallsgenerator.
Die Grenzen unserer Messung
- Bei 200 Aufrufen pro Bedingung liegt das Konfidenzintervall eines Anteils von 70 % bei etwa sechs Punkten in jede Richtung. Das reicht, um 100 % von 70 % zu unterscheiden, nicht aber, um zwei Modelle bei 75 und 80 % auseinanderzuhalten.
- Wir haben nur einen Prompt getestet, den von Coronado-Blázquez, um vergleichen zu können. Eine andere Formulierung ergäbe vielleicht andere Anteile, aber keinen anderen Favoriten: Alle veröffentlichten Studien finden die 7.
- Alle Aufrufe laufen über Eden AI. Wir können nicht überprüfen, ob jeder Anbieter die übermittelte Temperatur tatsächlich anwendet, daher der Ausschluss von Claude Haiku 5.5 aus den Temperaturbedingungen.
- Die sieben Modelle wurden so gewählt, dass sie die großen Anbieter und zwei Open-Weight-Modelle abdecken, nicht den gesamten Markt.
Häufige Fragen zur Zahl zwischen 1 und 10
Welche Zahl zwischen 1 und 10 wählen Menschen am häufigsten?
Die 7. Laut YouGov wählen 33 % der 2024 befragten Briten und 36 % der 2025 befragten Amerikaner die 7, während eine echte Ziehung jeder Zahl 10 % gäbe. Die 1 und die 10 werden am seltensten gewählt, mit 1 bis 4 % der Antworten.
Warum antwortet ChatGPT immer mit 7?
Weil sein Assistenten-Training die Verteilung verengt hat, die es an unseren Texten gelernt hat. Das Modell lost tatsächlich aus, aber mit einem Würfel, bei dem die 7 fast alles wiegt. In unserer Messung vom 5. November 2026 hat GPT-6 Luna in 100 % der Fälle mit 7 geantwortet, unabhängig von Temperatur oder Reasoning-Aufwand.
Kann eine KI eine Zufallszahl erzeugen?
Nicht von sich aus. Direkt gefragt, gibt eine KI fast immer dieselbe Antwort. Für eine echte Ziehung muss das Modell ein Tool aufrufen, das einen Zufallsgenerator ausführt, zum Beispiel das Python-Modul random oder secrets, über einen Function Call oder einen MCP-Server.
Was ist die Temperatur eines LLM?
Das ist die Einstellung, die die Verteilung abflacht oder verengt, aus der das Modell seine Antwort zieht. Bei 0 nimmt es immer die wahrscheinlichste Antwort; über 1 lässt es weniger wahrscheinlichen Antworten mehr Raum. Die Temperatur ändert die Rangfolge der Präferenzen nicht, und mehrere neuere Modelle lassen sich gar nicht mehr darauf einstellen.
Was ist ein KI-Bias?
Ein KI-Bias ist eine systematische Abweichung zwischen dem, was ein Modell erzeugt, und dem, was man von ihm erwartet. Der Bias der 7 ist ein einfach messbarer statistischer Bias: Das Modell erbt eine menschliche Präferenz aus seinen Trainingsdaten und verstärkt sie dann beim Alignment auf die Präferenzen der Annotatoren.
Was ist die Repräsentativitätsheuristik?
Das ist die Neigung, ein Ergebnis für wahrscheinlich zu halten, wenn es der Vorstellung von seiner Ursache ähnelt. Von Kahneman und Tversky 1972 beschrieben, erklärt sie, warum die 7 zufälliger wirkt als die 1 oder die 10 und warum eine vollkommen gleichmäßige Verteilung verdächtig erscheint.
Eine KI nach einer Zufallszahl zu fragen heißt, eine Menge zu befragen, die ein für alle Mal abgestimmt hat: Die Antwort kommt schnell, und sie ist fast immer dieselbe. Wir hatten erwartet, dass das Französische oder das Reasoning die 7 ein wenig ins Wanken bringen. Nichts dergleichen. Für eine Ziehung bittet man das Modell, einen Generator aufzurufen, und überlässt ihm den Rest.