Text-to-SQL: So entsteht ein zuverlässiger KI-Agent
Text-to-SQL in der Praxis: was wir beim Anbinden von KI-Agenten an Unternehmensdatenbanken gelernt haben. Fallstricke, Sicherheit, Make or Buy.

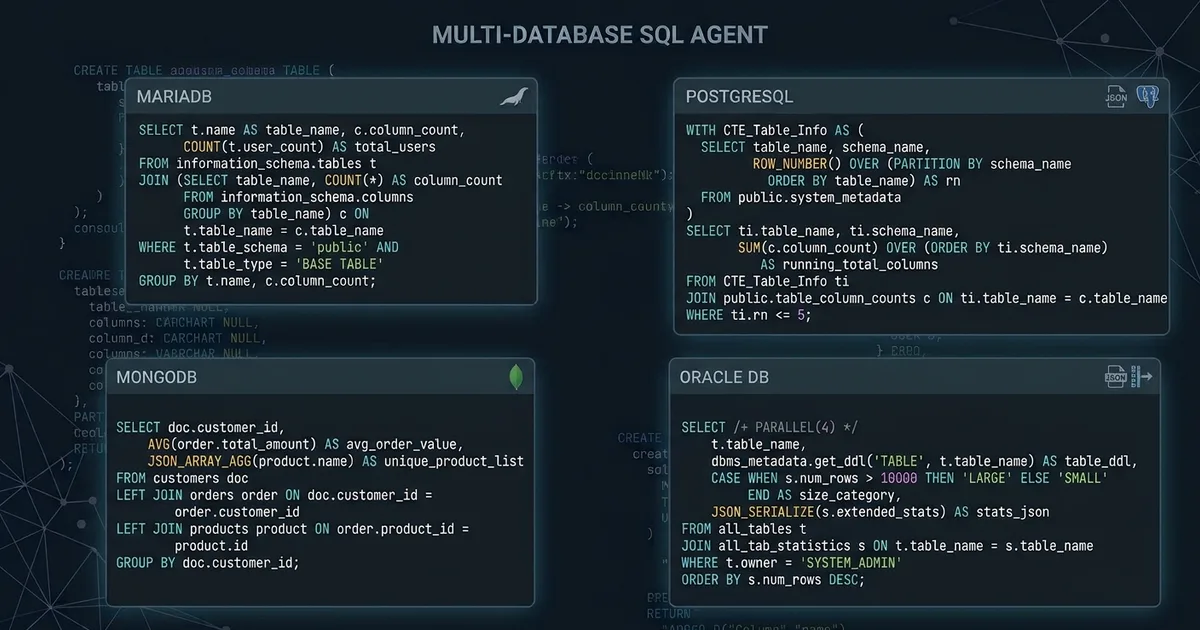
Einen KI-Agenten an eine Datenbank anzubinden, was man als Text-to-SQL bezeichnet, ermöglicht es ihm, weit mehr Fragen zu beantworten. Bei unseren Kunden ist das typische Beispiel ein Troubleshooting-Agent für ein komplexes Produkt. Reicht die technische Dokumentation nicht aus, sucht er in der Ticket-Datenbank nach einem Fall, der dem des Nutzers ähnelt, und hilft ihm, sein Problem zu lösen. Anschließend kann er die Aktualisierung der Dokumentation verfassen und einer Person zur Freigabe vorlegen.
Das Modell übersetzt die Frage in eine SQL-Abfrage, die Plattform führt sie aus, und das Modell liest das Ergebnis. Zwar lässt sich ein Agent, der eine Datenbank abfragen kann, schnell programmieren, doch gute Antworten in der Produktion, über eine große Zahl von Fragen hinweg, erfordern eine erhebliche Investition, wie bei einem RAG zwischen POC und Produktion.
Das haben wir gelernt, indem wir monatelang an dieser Art von Agent iteriert haben, mit Kunden, die jeweils ihre eigenen Use Cases, Schemata und Engines mitbrachten, insbesondere MariaDB und PostgreSQL, teils auf Datenbanken mit mehreren Hundert Tabellen. Bei einem von ihnen waren nach mehreren Iterationen etwa 84 % der Aufrufe unseres Datenbank-Tools erfolgreich. Seit dem Wechsel zu einem agentischen Ansatz, bei dem der Agent in mehreren Schritten arbeitet, sind mehr als 99 % der Abfragen auf Anhieb erfolgreich. Für eine IT-Abteilung ist das der Weg, den man vor einem Eigenentwicklungsprojekt beziffern muss: Monate an Iterationen, um von der Demo zu einem zuverlässigen Werkzeug zu kommen, und danach eine Wartung, die nie aufhört.
Hier in 40 Sekunden, was unser Agent tut. Danach gehen wir die Fallstricke einzeln durch und dann die Optionen zwischen Selbstbau und Kauf.
Zwei LLM, die sich verstehen müssen
In den meisten Architekturen arbeiten zwei Modelle zusammen:
- der Hauptagent unterhält sich mit dem Nutzer, entscheidet, wann die Datenbank abgefragt wird, und verfasst dann die Antwort;
- ein SQL-Generator, der wie ein Werkzeug aufgerufen wird, erhält eine Frage und die Struktur der Datenbank und schreibt die Abfrage; die Plattform führt sie aus und gibt das Ergebnis an den Hauptagenten zurück.
Die Aufteilung ist logisch: Der Hauptagent muss keine 600 Spalten kennen, um ein Gespräch zu führen, und der Generator kann ein schnelles, spezialisiertes Modell sein.
Aber jede Übergabe vom einen zum anderen erzeugt Reibung. Der Hauptagent formuliert die Frage des Nutzers um, bevor er sie weitergibt, und manchmal formuliert er sie schlecht um. Vor allem erfindet er mitunter plausible Spaltennamen („filtere auf vertragsart = 'Premium'“), die der Generator für korrekt hält, obwohl die Spalte vertragsstufe heißt und der Wert PREMIUM lautet.
Was die Hin-und-her-Runden kosten
Scheitert die Abfrage, geht der Fehler an den Hauptagenten zurück, der umformuliert und den Generator erneut aufruft, der neu schreibt, und die Datenbank führt erneut aus. Jede Runde fügt mehrere Sekunden Wartezeit hinzu und verbraucht Modellaufrufe.
Hilft die zurückgegebene Fehlermeldung nicht bei der Korrektur, läuft die Schleife ins Leere. Ein Beispiel aus einem Bug bei einem unserer Kunden: Eine einzige Frage zog rund zwanzig gescheiterte Aufrufe nach sich, weil wir dem Modell bei jedem Spaltenfehler die Spalten einer anderen Tabelle zurückschickten …
Das hat uns zum agentischen Ansatz gebracht. Statt jeden Versuch über den Hauptagenten laufen zu lassen, ermittelt ein Datenanalyst selbst, mit der realen Struktur der Datenbank vor Augen, und gibt die Kontrolle erst mit einem Ergebnis zurück. Bei dem oben genannten Kunden sind wir von fast drei Tool-Aufrufen pro Antwort auf gut einen gekommen.
Die Beschreibung der Datenbank pflegen
Um korrektes SQL zu schreiben, und zwar schnell, muss der Generator die Datenbank kennen: die Tabellen, die Spalten und vor allem, was sie bedeuten. In einer echten Datenbank heißt die Spalte für den Rechnungskunden cd_cli_2, der Status ist 1 oder 2, und der Umsatz „versteht sich ohne Gutschriften“.
Üblicherweise verfasst ein Administrator eine Beschreibung der Datenbank, die dem Generator bei jeder Frage mitgegeben wird. Das funktioniert, ist aber aufwendig zu schreiben, und nur zwei oder drei Personen im Unternehmen können das. Vor allem ist es schwer zu pflegen: Jedes hinzugefügte, umbenannte oder gelöschte Feld macht die Beschreibung falsch, ohne dass jemand gewarnt wird. Und bei einer großen Datenbank passt die vollständige Beschreibung nicht mehr in das, was man dem Modell bei jeder Frage schicken kann. Man muss auswählen, was man zeigt.
Ist die Beschreibung falsch oder unvollständig, irrt sich das Modell, ohne es zu wissen. Es schreibt eine gültige Abfrage auf der falschen Spalte, und die angezeigte Antwort ist falsch, bei einem Modell, das sich völlig sicher ist. Es kommt kein Fehler zurück, und niemand bemerkt etwas, bis ein Nutzer eine Zahl sieht, die nicht stimmen kann.
Die Lösung besteht darin, die Struktur regelmäßig direkt aus der Datenbank zu lesen: die tatsächliche Liste der Tabellen und Spalten und die Kommentare, die Ihre Teams dort manchmal schon hinterlegt haben. Dieses Datenwörterbuch aktualisiert sich, wenn sich die Datenbank ändert, und Menschen ergänzen nur, was fehlt.
Abfrageergebnisse, die nicht in die Antwort passen
Eine Abfrage, die 5.000 Zeilen zurückgibt, kann nicht unverändert an das Modell geschickt werden. Man muss das Ergebnis separat speichern, dem Modell nur eine Vorschau zeigen und es ihm ermöglichen, seitenweise darin zu blättern. Bei uns sieht das Modell höchstens 20 Zeilen des Ergebnisses und liest den Rest bei Bedarf.
Diese Aufteilung birgt ein sehr konkretes Risiko: Das Modell rechnet mit der Vorschau. Man zeigt ihm 20 Zeilen, es zählt, bildet einen Durchschnitt und verkündet selbstsicher eine falsche Zahl. Man muss ihm ausdrücklich verbieten, auf einer Stichprobe zu rechnen, und es für jede Aggregation an die Datenbank verweisen (COUNT, SUM, AVG über die ganze Tabelle).
Dann kommen die Erwartungen der Nutzer, die keine Rohtabelle im Chat wollen:
- ein lesbares Diagramm, erstellt aus dem richtigen Datensatz;
- ein vollständiger Excel-Export (bei uns bis zu 50.000 Zeilen), nicht nur die sichtbaren Zeilen;
- Nachfragen zum selben Ergebnis („und nur für Bayern?“), ohne die Datenbank unnötig erneut abzufragen.
Jede dieser Funktionen wirkt einfach. Zusammen ergeben sie ein kleines Produkt.
Sicherheit: ein Agent, der nur lesen darf
Das Risiko eines Agenten, der SQL schreibt, besteht darin, dass er Ihre Daten verändert: aus Versehen oder weil er manipuliert wird, mit einer Anweisung, die in die Frage eines Nutzers oder in einen Inhalt eingeschleust wurde, den er liest. Der Fall des MCP-Servers für Postgres zeigt, dass ein Schutz, der solide wirkt, nachgeben kann.
MCP ermöglicht es, eine Datenbank mit wenigen Konfigurationszeilen an Claude, ChatGPT oder Cursor anzubinden. Der Referenzserver für Postgres kapselte jede Abfrage in eine schreibgeschützte Transaktion. Datadog zeigte im August 2025, dass ein einfaches COMMIT;, gefolgt von einer weiteren Anweisung, genügte, um daraus auszubrechen und beliebige Befehle auszuführen. Der Server wurde als veraltet markiert und archiviert.
Die Lehre gilt für alle Projekte:
- Der Lesezugriff muss von einem Datenbankkonto ohne Schreibrechte kommen, nicht von einem darübergelegten Filter;
- jede Abfrage muss vor der Ausführung validiert werden: eine einzige Anweisung, kein Schreiben, keine Systemtabellen;
- das Modell darf diese Regeln nicht umgehen können, selbst wenn ein Nutzer es darum bittet.
Zugriffsrechte: Nicht jeder darf alles sehen
Ein weiteres Thema, das oft spät entdeckt wird: Ein Vertriebsmitarbeiter aus dem Süden soll den Umsatz des Nordens nicht sehen, und ein Techniker hat keine Gehälter zu lesen.
Mit einem MCP-Server oder einem selbst geschriebenen Skript verbindet sich der Agent mit einem einzigen Konto: Jeder Nutzer, der mit ihm spricht, sieht alles, was dieses Konto sieht. Eine Einschränkung pro Nutzer setzt voraus, die Identität der fragenden Person zu kennen, sie bis zur Abfrage durchzureichen und entsprechend zu filtern. Das ist machbar, aber es ist ein eigenständiger Architekturbaustein, der die Authentifizierung Ihrer Anwendung berührt.
Selbst bauen: was Ihre IT-Abteilung pflegen muss
Wer selbst bauen will, findet in Vanna eine der Referenz-Open-Source-Bibliotheken für Text-to-SQL. Version 2.0, unter MIT-Lizenz, wurde rund um einen Agenten neu geschrieben, mit Rechten pro Nutzer und Ausgaben als Tabellen und Diagramme.
Die Vorbereitung bleibt aber Ihre Sache: Damit die Bibliothek korrekt antwortet, muss man sie mit der Struktur der Datenbank, fachlicher Dokumentation und Beispielfragen samt der richtigen SQL-Abfrage „trainieren“. Man muss sie außerdem hosten, in die eigene Authentifizierung integrieren, mit den eigenen Dokumenten verbinden und bei jeder Änderung der Datenbank oder der Modelle pflegen. Das ist eine gute Ausgangsbasis, sofern man dauerhaft ein Team dafür hat.
Denn die initiale Entwicklung ist nur der Anfang. Sobald der Agent in Produktion ist, muss jemand in Ihren Teams dauerhaft:
- das Schema verfolgen: Jede hinzugefügte Tabelle oder umbenannte Spalte muss in die Beschreibung, sonst antwortet der Agent falsch;
- die Modelle verfolgen: Die Anbieter bringen alle paar Monate neue Versionen heraus und ziehen die alten zurück, und ein Modellwechsel kann verändern, wie der Agent sein SQL schreibt;
- die Fehler überwachen: gescheiterte Abfragen und beanstandete Antworten durchsehen, die Ursache verstehen, korrigieren;
- nach jeder Änderung einen Referenzsatz von Fragen erneut durchlaufen lassen, um zu prüfen, dass sich nichts verschlechtert hat;
- die Leitplanken aktuell halten: schreibgeschütztes Konto, Validierung der Abfragen, Rechte pro Nutzer.
Ein Beispiel: Mitte Oktober hat ein Anbieter über Nacht geändert, wie eines seiner Modelle ein vorgegebenes Antwortformat einhielt, und einer unserer Bausteine musste zu einem anderen Anbieter wechseln. Das ist unser Beruf, also kümmern wir uns darum. In einer IT-Abteilung werden Ihre Teams mehr Zeit mit der Wartung eines KI-Systems verbringen als mit Innovation in Ihrem Kerngeschäft, und diese Zeit taucht fast nie im Projektbudget auf.
Einsetzen ohne zu entwickeln: Ask This Guy
Wir haben gebaut, was wir selbst gern vorgefunden hätten: Es ist der Agent aus dem Video am Anfang des Artikels. Eine Datenbank wird ohne Entwicklung angebunden, in wenigen Minuten, und für jeden oben beschriebenen Fallstrick gibt es eine Antwort:
- Beim Verbinden liest der Agent die Tabellen, Views und Spalten und übernimmt die Kommentare, die bereits in der Datenbank stehen. Ihre Teams erläutern nur die unklaren Codes („
cd_cli_2ist der Rechnungskunde“), ohne Dokumentation zu schreiben, und das Datenwörterbuch folgt den Änderungen der Datenbank. - Im agentischen Modus ermittelt er in mehreren Schritten: Er klärt, was die Frage bedeutet, liest die relevanten Spalten, prüft die Werte und startet dann seine Abfragen, innerhalb fester Grenzen (45 Sekunden, höchstens sechs Abfragen). Jeder Schritt wird im Gespräch angezeigt.
- Er liest nur: schreibgeschütztes Konto, eine Anweisung pro Abfrage, Systemtabellen gesperrt.
- Seine Ergebnisse bleiben nutzbar: Datensätze, die im Gespräch erhalten bleiben, Diagramme, Excel-Export.
- Derselbe Agent sucht in Ihren Dokumenten (SharePoint, Notion, Websites) und fragt Ihre Datenbanken in derselben Antwort ab.
Die Wartung liegt bei uns: Modellpflege, Leitplanken, Produktentwicklung. Ihre Teams kümmern sich um die fachlichen Fragen.
Wenn Sie ein Projekt haben, bei dem ein Agent auf Ihre Daten zugreifen soll, vereinbaren Sie einen Termin: Mit wenigen Klicks konfigurieren wir den Agenten auf Ihren eigenen Daten, und Sie sehen sofort, ob das der richtige Ansatz ist. Den vollständigen Überblick bieten unsere Seite Talk to Data und der Artikel Ihre Datenbanken sind eine Goldmine.
Häufige Fragen zu Text-to-SQL
Was ist Text-to-SQL?
Text-to-SQL bedeutet, eine in natürlicher Sprache gestellte Frage mithilfe eines Sprachmodells (LLM) in eine SQL-Abfrage zu übersetzen. Die Abfrage wird auf der Datenbank ausgeführt, und das Ergebnis wird als Antwort umformuliert. Diese Technik ermöglicht es, „mit seinen Daten zu sprechen“, ohne SQL zu beherrschen.
Warum gibt ein Text-to-SQL-Agent falsche Antworten?
Meist, weil er die Datenbank nicht versteht: unklare Spaltennamen, Codes ohne Erklärung, eine unvollständige oder veraltete Beschreibung der Tabellen. Das Modell schreibt dann eine gültige Abfrage auf der falschen Spalte, und die Antwort ist falsch, ohne dass ein Fehler angezeigt wird. Eine Summe aus einer bloßen Vorschau des Ergebnisses zu berechnen, ist die andere häufige Ursache.
Reicht ein MCP-Server für Postgres für den Einsatz im Unternehmen?
Um die eigenen Daten zu erkunden, ja. Für Dutzende Mitarbeitende fehlt das Wesentliche: ein durch ein Konto ohne Schreibrechte garantierter Lesezugriff, Rechte pro Nutzer, das fachliche Verständnis der Datenbank, der Umgang mit großen Ergebnissen und die Verknüpfung mit Dokumenten.
Sollte man seinen Text-to-SQL-Agenten selbst bauen oder eine bestehende Lösung nutzen?
Selbst bauen ist sinnvoll, wenn Sie ein Team haben, das Engine, Datenbankbeschreibung, Leitplanken und Oberfläche dauerhaft pflegt. Es braucht Monate, um den Agenten zuverlässig zu machen, und danach eine laufende Wartung, die Entwickler bindet, statt sie am Kerngeschäft arbeiten zu lassen. Wenn Ihre Fragen mehrere Datenbanken und Ihre Dokumente verknüpfen oder Sie in wenigen Tagen ein Ergebnis wollen, erspart Ihnen eine bestehende Lösung, die Fallstricke der Produktion einzeln neu zu entdecken.
Wer das Projekt selbst angeht, sollte zwei Dinge vor dem ersten Prompt erledigen: ein schreibgeschütztes Datenbankkonto anlegen und die Spalten auflisten, die niemand im Team erklären kann. Das Konto schützt Sie, und die Länge der Liste zeigt Ihnen, wie viel Beschreibungsarbeit auf Sie wartet.