Servidor de IA local: ¿qué hardware necesita un LLM?
Servidor de IA local: puesto de trabajo, RTX PRO 6000 o H200. Lo que da cada nivel con Qwen 3.8 27B, velocidades medidas y precios de noviembre de 2026.

Un servidor de IA local es una máquina de la empresa que ejecuta un modelo de lenguaje (un LLM local) sin enviar los datos a una API externa. El modelo de referencia de este artículo, Qwen 3.8 27B, cabe en una tarjeta gráfica de 24 GB y genera en ella de 40 a 75 tokens por segundo para un usuario. En una GPU de servidor H100, con 50 peticiones simultáneas, cada usuario recibe 35 tokens por segundo con SGLang, y menos de uno con Ollama.
Dicho de otro modo, es el número de peticiones simultáneas lo que determina el hardware que hay que comprar, y por tanto el presupuesto, junto con la longitud de los documentos enviados. El mismo modelo funciona en una tarjeta de 2.333 € sin IVA y en una H200 NVL de 32.533 € sin IVA; solo la segunda da servicio a toda una empresa.
Hemos reunido las mediciones publicadas para tres niveles (un puesto de trabajo, un servidor con una tarjeta, una H100 o una H200), con precios tomados el 16 de noviembre de 2026 en tiendas francesas, y para dos usos que no esperan lo mismo de un LLM local: el desarrollo, donde la referencia es Claude Code, y el chatbot o el agente de negocio, donde la referencia es la velocidad de un asistente de chat. La cuestión de si conviene alojarlo uno mismo, con el coste completo y el umbral de rentabilidad frente a una API, se trata en nuestro artículo sobre los LLM on premise.
¿Por qué tomar Qwen 3.8 27B como referencia?
Porque es, que sepamos, el modelo abierto mejor valorado que cabe en una sola tarjeta. Qwen 3.8 27B es un modelo denso de 27.000 millones de parámetros, publicado por Alibaba con licencia Apache 2.0. En el índice de Artificial Analysis obtiene unas cinco veces la nota de gpt-oss-120b, un modelo cuatro veces más grande: nuestro artículo Qwen 4 27B vs Qwen 3.8 27B detalla su rendimiento y su arquitectura. En ATG, es el modelo que redacta las respuestas a los mensajes y el que se usa en nuestro benchmark FinanceBench.
¿Por qué un modelo denso y no un MoE, esos modelos «mixture of experts» que solo activan una parte de sus parámetros en cada token? El MoE va más rápido: en una misma tarjeta de consumo, un desarrollador midió 31 tokens por segundo para el denso Qwen 3.6 27B y 98 para el MoE Qwen 3.6 35B-A3B. Pero un MoE debe mantener todos sus expertos en memoria, puesto que cualquiera puede servir en el token siguiente: ese MoE ocupa 71,9 GB en BF16, frente a 55,6 del denso. Y el denso responde mejor, 77,2 frente a 73,4 en SWE-bench Verified según Qwen. En un servidor con una tarjeta, la memoria y la calidad cuentan más que la velocidad de un usuario solo: nuestra guía del mixture of experts detalla la diferencia.
Eso cambia el cálculo del hardware. En nuestro artículo sobre el on premise, un modelo de unos 100.000 millones de parámetros seguía siendo el mínimo en cuanto la tarea se complica, con dos GPU de servidor como consecuencia. Un modelo de 27.000 millones que lo supera devuelve la cuestión a una sola tarjeta. Sus pesos ocupan 55,6 GB en BF16 y 30,9 GB en FP8, y unos 17 GB en 4 bits (la versión Q4_K_S ocupa 16,68 GiB).
Qwen 4 27B, anunciado por Alibaba, no está publicado: a 16 de noviembre, la organización Qwen en Hugging Face no tiene ningún repositorio de Qwen 4. El hardware elegido para Qwen 3.8 27B probablemente lo ejecutará si conserva su tamaño, pero su memoria real sigue siendo desconocida: un margen no es un lujo.
Desarrollo o chatbot: ¿basta Qwen 3.8 27B?
Los dos usos no exigen la misma calidad. En el índice de Artificial Analysis, Qwen 3.8 27B obtiene 20 puntos, al nivel de Claude Haiku 5.5 con esfuerzo bajo (19), pero lejos de Claude Sonnet 5.5 (55), de Claude Opus 5.5 (59) y de Claude Fable 5.2 (65).
Para el desarrollo, Claude sigue siendo la referencia, y la diferencia es clara. En Terminal-Bench 2.1, una batería de tareas de programación en línea de comandos, Vals.ai mide un 87,6 % para Claude Opus 5.5, un 83,2 % para Claude Sonnet 5.5 y un 58,4 % para Qwen 3.8 27B, en las mismas condiciones. Qwen anuncia mejores resultados en sus propias pruebas: 61,7 en SWE-bench Pro, frente a 53,4 de Claude Opus 4.6, un modelo Claude de una generación anterior. Nosotros no sustituiríamos Claude Code por un Qwen local para poner a trabajar a un agente sobre una base de código grande; un puesto local sirve más bien para el código que no debe salir de la empresa y para las tareas sencillas.
Para un chatbot o un agente de negocio, Qwen 3.8 27B funciona muy bien, salvo en casos muy complejos. Es nuestra opinión de usuarios: en ATG redacta las respuestas a los mensajes, y nuestro benchmark FinanceBench alcanza un 92 % de respuestas correctas con él, sobre 150 preguntas de analistas planteadas a 368 informes financieros. Sustituirlo por Gemini 3.8 Flash, o darle más tiempo de reflexión, no cambia la puntuación de forma significativa, como explicamos en nuestro artículo sobre la auditoría de un RAG: la calidad viene ante todo de encontrar los pasajes adecuados. Los casos que justifican un modelo puntero son los razonamientos largos sobre varios documentos y los agentes que encadenan muchos pasos.
¿Qué determina el hardware de un LLM local?
La memoria necesaria cabe en una regla: los pesos del modelo, más la caché KV, la memoria de trabajo de cada conversación, que crece con la longitud del texto leído y con el número de usuarios. Nuestro artículo sobre los LLM on premise detalla este cálculo. Qwen 3.8 27B tiene la ventaja de una caché KV reducida: solo 16 de sus 64 capas la conservan, es decir, unos 2,1 GB para una conversación de 32.000 tokens.
Después, tres preguntas deciden el nivel:
- Cuántas peticiones llegan a la vez en las horas punta. Una petición simultánea no es un empleado: un usuario pasa la mayor parte de su tiempo leyendo o escribiendo, no esperando una respuesta.
- Qué longitud de texto lee el modelo en cada petición. Una pregunta de chat ocupa unos cientos de tokens; un RAG o un agente que lee contratos envía decenas de miles.
- Qué velocidad es aceptable para cada usuario. Como Qwen 3.8 27B razona antes de responder, produce mucho más texto que la media de los modelos comparables: en nuestra opinión, por debajo de 20 a 30 tokens por segundo, la espera se nota. Las referencias siguientes indican a qué están ya acostumbrados los usuarios.
¿Qué velocidad esperan los usuarios?
Dos referencias fijan las expectativas. Para un desarrollador acostumbrado a Claude Code, es la API de Anthropic, a la que llama Claude Code. Para un usuario de chat, es la velocidad de los asistentes de gran público, y ha cambiado de escala: Le Chat de Mistral responde a más de 1.100 tokens por segundo con Mistral Large 2 desde febrero de 2025, gracias a los chips de Cerebras, y OpenAI firmó en enero de 2026 por 750 megavatios de cálculo de Cerebras, con vistas a «faster responses, more natural interactions».
| Servicio | Modelo | Velocidad para un usuario | Naturaleza de la cifra |
|---|---|---|---|
| API de Anthropic (Claude Code) | Claude Opus 5.5 | 105 a 116 tokens/s | medición de Artificial Analysis |
| API de Anthropic | Claude Sonnet 5.5 | 126 a 152 tokens/s | medición de Artificial Analysis |
| API de Anthropic | Claude Haiku 5.5 | 209 a 257 tokens/s | medición de Artificial Analysis |
| API de Mistral | Mistral Large 4 | 81 a 88 tokens/s | medición de Artificial Analysis |
| API de Alibaba | Qwen 3.8 27B | unos 40 tokens/s | medición de Artificial Analysis |
| Groq | Qwen 3.8 27B | 450 tokens/s | anuncio de Groq |
| Cerebras | Qwen 3.8 27B | unos 1.850 tokens/s | anuncio de Cerebras |
| Puesto local (RTX 3090 a 5090) | Qwen 3.8 27B | 40 a 75 tokens/s | medición de Hardware Corner |
Mediciones de Artificial Analysis tomadas el 16 de noviembre de 2026 (media de cinco días), según el nivel de esfuerzo del modelo.
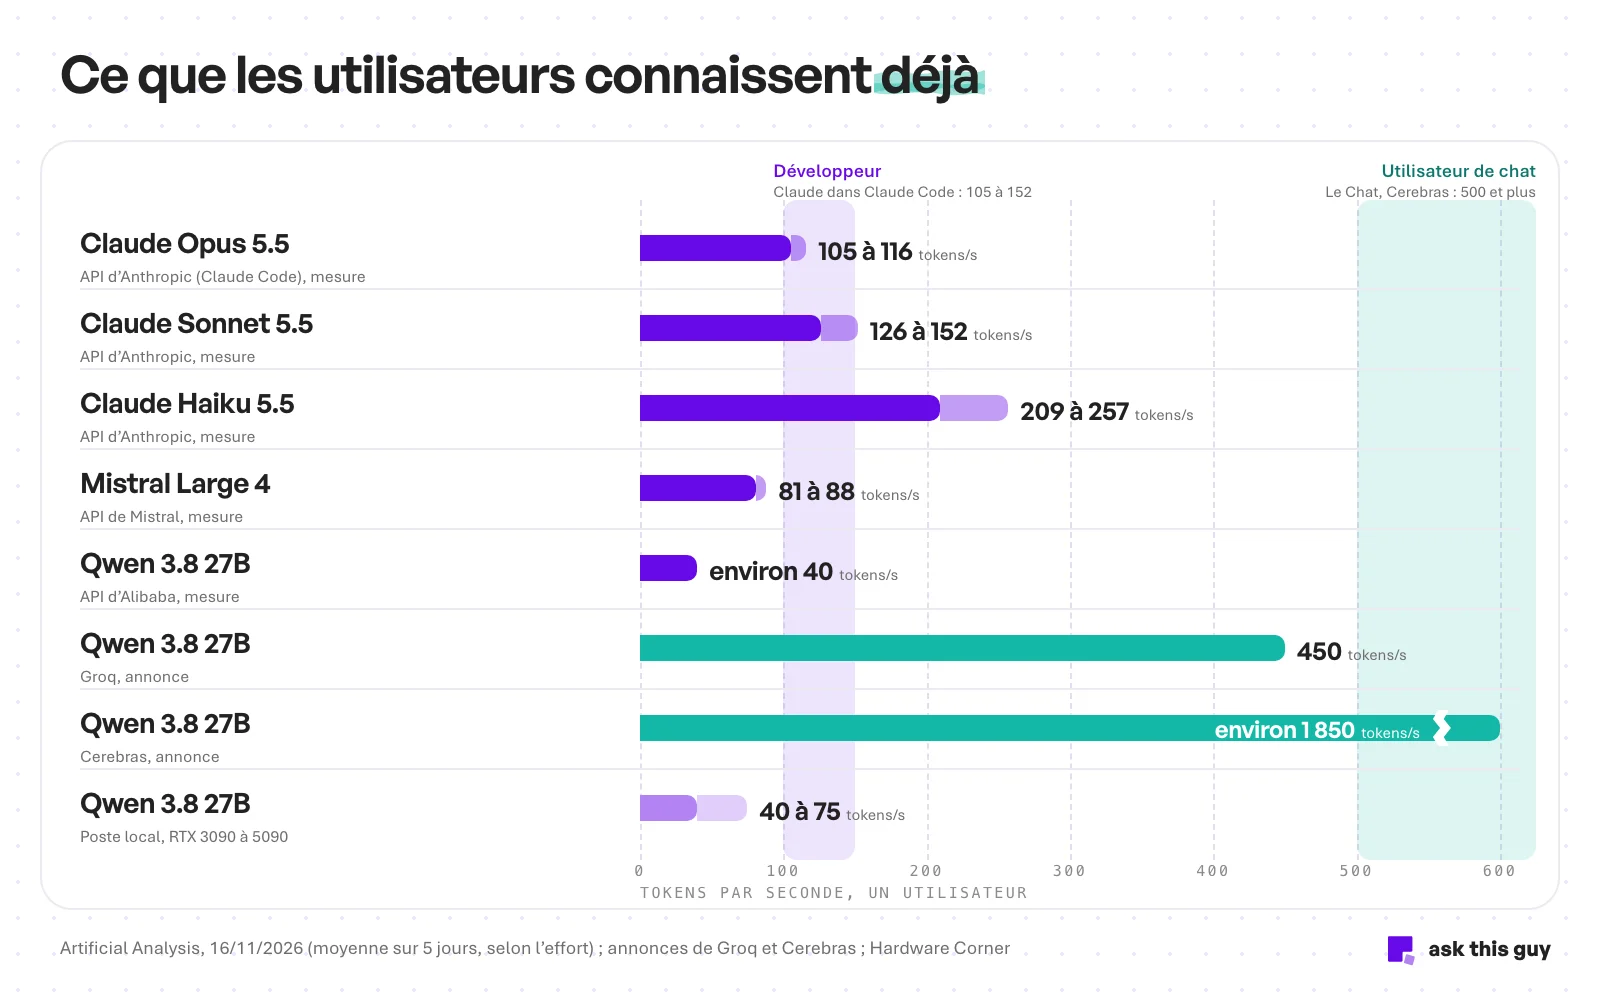 Gráfico: velocidad para un usuario, en tokens por segundo, de los servicios que los usuarios ya conocen. Claude Opus 5.5 en la API de Anthropic, que usa Claude Code: 105 a 116. Claude Sonnet 5.5: 126 a 152. Claude Haiku 5.5: 209 a 257. Mistral Large 4 en la API de Mistral: 81 a 88. Qwen 3.8 27B en la API de Alibaba: unos 40; en Groq: 450 (anuncio); en Cerebras: unos 1.850 (anuncio); en un puesto local: 40 a 75. Franjas de referencia: desarrollador 100 a 150, usuario de chat 500 o más
De ahí sacamos dos referencias: de 100 a 150 tokens por segundo para un desarrollador, 500 o más para un usuario de chat, el umbral que ya fijamos para los usos exigentes en nuestro artículo sobre los LLM on premise. Un puesto local va, por tanto, a la mitad de velocidad que Claude Opus 5.5, y entre veinticinco y cuarenta y cinco veces más despacio que el mismo modelo en Cerebras. Un servidor compartido con carga, a 32 a 42 tokens por segundo por usuario, da aproximadamente un tercio de lo que da Claude. El fast mode de Claude Code promete incluso hasta 2,5 veces más. Un desarrollador que pase de Claude Code a un servidor propio notará la diferencia; un usuario de chat acostumbrado a Le Chat la notará todavía más.
El rendimiento total de un servidor se reparte entre las peticiones: un servidor que produce 1.600 tokens por segundo para 50 peticiones da unos 32 tokens por segundo a cada una. Las cifras que siguen separan siempre ambas cosas.
Un puesto de trabajo para un usuario: ¿qué PC para la IA local?
Para un desarrollador, un piloto o un uso personal, basta una tarjeta gráfica de 24 o 32 GB. Hardware Corner midió Qwen 3.8 27B en 4 bits con llama.cpp, actualizado el 17 de agosto, con 4.000 tokens de contexto:
| Máquina | Memoria | Velocidad medida (un usuario) | Precio a 16/11/2026 (Francia) |
|---|---|---|---|
| RTX 5090 | 32 GB | 75 tokens/s | 7.750 € sin IVA la tarjeta, 10.833 € sin IVA la estación completa |
| RTX 4090 | 24 GB | 46 tokens/s | ya no se fabrica |
| RTX 3090 | 24 GB | 40 tokens/s | solo de segunda mano |
| Apple M5 Max | 128 GB | 31 tokens/s | 5.616 € sin IVA el Mac Studio de 128 GB |
| GB10 (base del DGX Spark) | 128 GB | 12 tokens/s | 6.548 € IVA incluido (ASUS Ascent GX10) |
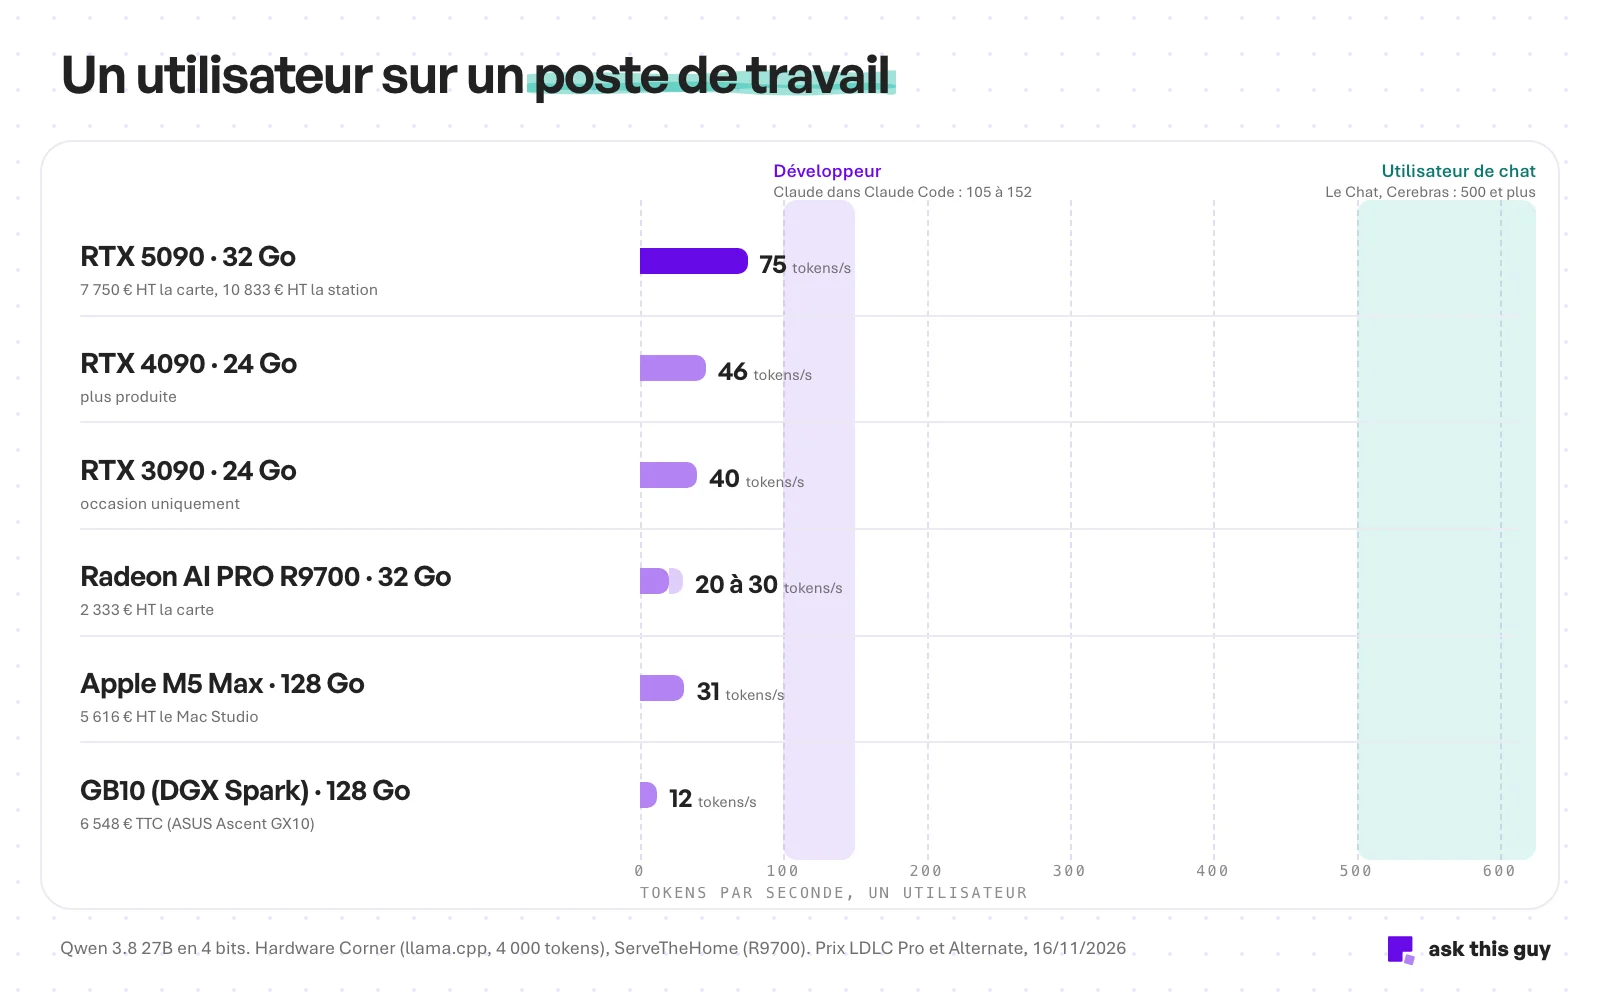 Gráfico: velocidad de Qwen 3.8 27B en 4 bits para un usuario en un puesto de trabajo, frente a las velocidades de referencia. RTX 5090 32 GB: 75 tokens por segundo (7.750 € sin IVA la tarjeta, 10.833 € sin IVA la estación). RTX 4090 24 GB: 46. RTX 3090 24 GB: 40. Radeon AI PRO R9700 32 GB: 20 a 30 (2.333 € sin IVA). Apple M5 Max 128 GB: 31 (5.616 € sin IVA el Mac Studio). GB10, la base del DGX Spark, 128 GB: 12 (6.548 € IVA incluido). Todas las barras quedan por debajo de la franja del desarrollador, 100 a 150 tokens por segundo, y lejos de la del usuario de chat, 500 o más
La tarjeta de AMD, la Radeon AI PRO R9700 de 32 GB, es la más barata del grupo, a 2.333 € sin IVA. ServeTheHome la midió entre 20 y 30 tokens por segundo para un usuario solo; AMD anuncia hasta 51,8 con la decodificación especulativa, una técnica que hace adivinar varios tokens de golpe y los verifica después.
Las máquinas con 128 GB de memoria unificada compran capacidad, no velocidad. El DGX Spark de NVIDIA, el Mac Studio o los mini PC Ryzen AI Max+ cargan sin problema un modelo de 27.000 millones de parámetros, pero su memoria es lenta para un modelo denso, que relee todos sus parámetros en cada token. En el DGX Spark, un desarrollador midió 11,2 tokens por segundo sin decodificación especulativa, de 19 a 28 con ella. Peor aún: leer un documento de 128.000 tokens exige en él 150 segundos antes de la primera palabra. Estas máquinas encajan mejor con los modelos MoE, que solo releen una parte de sus parámetros en cada token.
Los precios, por su parte, han seguido a la escasez de memoria. NVIDIA subió el DGX Spark de 3.999 a 4.699 dólares en febrero, alegando «worldwide constraints in memory supply», y luego a 6.950 dólares en octubre. En Francia, la RTX 5090 alcanzó 8.899,95 € el 3 de noviembre según el observatorio de precios de GinjFo, antes de bajar a 5.609,90 € el 14 de noviembre según Pro-gamer. En este nivel, un precio tomado un lunes no siempre se mantiene al lunes siguiente.
Los 4 bits casi no cuestan calidad. La versión INT4 publicada por Red Hat conserva entre el 98,5 y el 101 % de las puntuaciones del modelo original según las tareas (87,9 frente a 89,2 en GPQA Diamond). Quesma no midió ninguna pérdida notable en Q4_K_M, y solo una caída clara en 2 bits. Preferimos las versiones publicadas por Qwen, NVIDIA o Red Hat: algunas versiones de la comunidad han mostrado bucles de razonamiento.
Sin tarjeta gráfica, solo es viable un modelo pequeño, para tareas sencillas. OVH anuncia para Olala mini 7A1B, su primer LLM, presentado el 17 de noviembre de 2026, 50 tokens por segundo en un simple procesador: es una mezcla de expertos que solo pone a trabajar mil millones de sus 7.000 millones de parámetros en cada token. La cifra es declarativa, sin condiciones de prueba, y un modelo de este tamaño no juega en la categoría de Qwen 3.8 27B: apunta a la clasificación o la extracción, no a la redacción ni al código. Lo analizamos en nuestro artículo sobre Olala mini.
Un puesto no tiene ni redundancia ni control de acceso, y solo atiende bien a una persona a la vez: es una herramienta de piloto.
Ollama, vLLM o SGLang: ¿qué software de inferencia elegir?
El software que ejecuta el modelo, el motor de inferencia, merece tanta atención como la tarjeta: no todos son iguales, y la diferencia va de uno a cincuenta en la misma GPU. Ollama y LM Studio son herramientas de puesto: atienden muy bien a una persona. Para varios usuarios hace falta un motor de servidor, que agrupa las peticiones para procesarlas juntas. Phil Winder (Winder.AI) comparó cinco motores en una misma H100 alquilada, con Qwen 3.8 27B en 8 bits y peticiones de unos 900 tokens. Esta es la velocidad que recibe cada usuario, en tokens por segundo; entre paréntesis, el rendimiento total de la GPU, que dividimos por el número de peticiones:
| Motor | 1 petición | 10 simultáneas | 50 simultáneas | Espera mediana con 50 |
|---|---|---|---|---|
| SGLang 0.5.20 | 81 | 63 (627 en total) | 35 (1.725 en total) | 1,5 s |
| vLLM 0.30.0 | 76 | 59 (589) | 32 (1.610) | 2,1 s |
| llama.cpp | 56 | 14 (138) | 1,9 (97) | 8,2 s |
| Ollama 0.34.4 | 33 | 3,3 (33) | 0,7 (33) | 381 s |
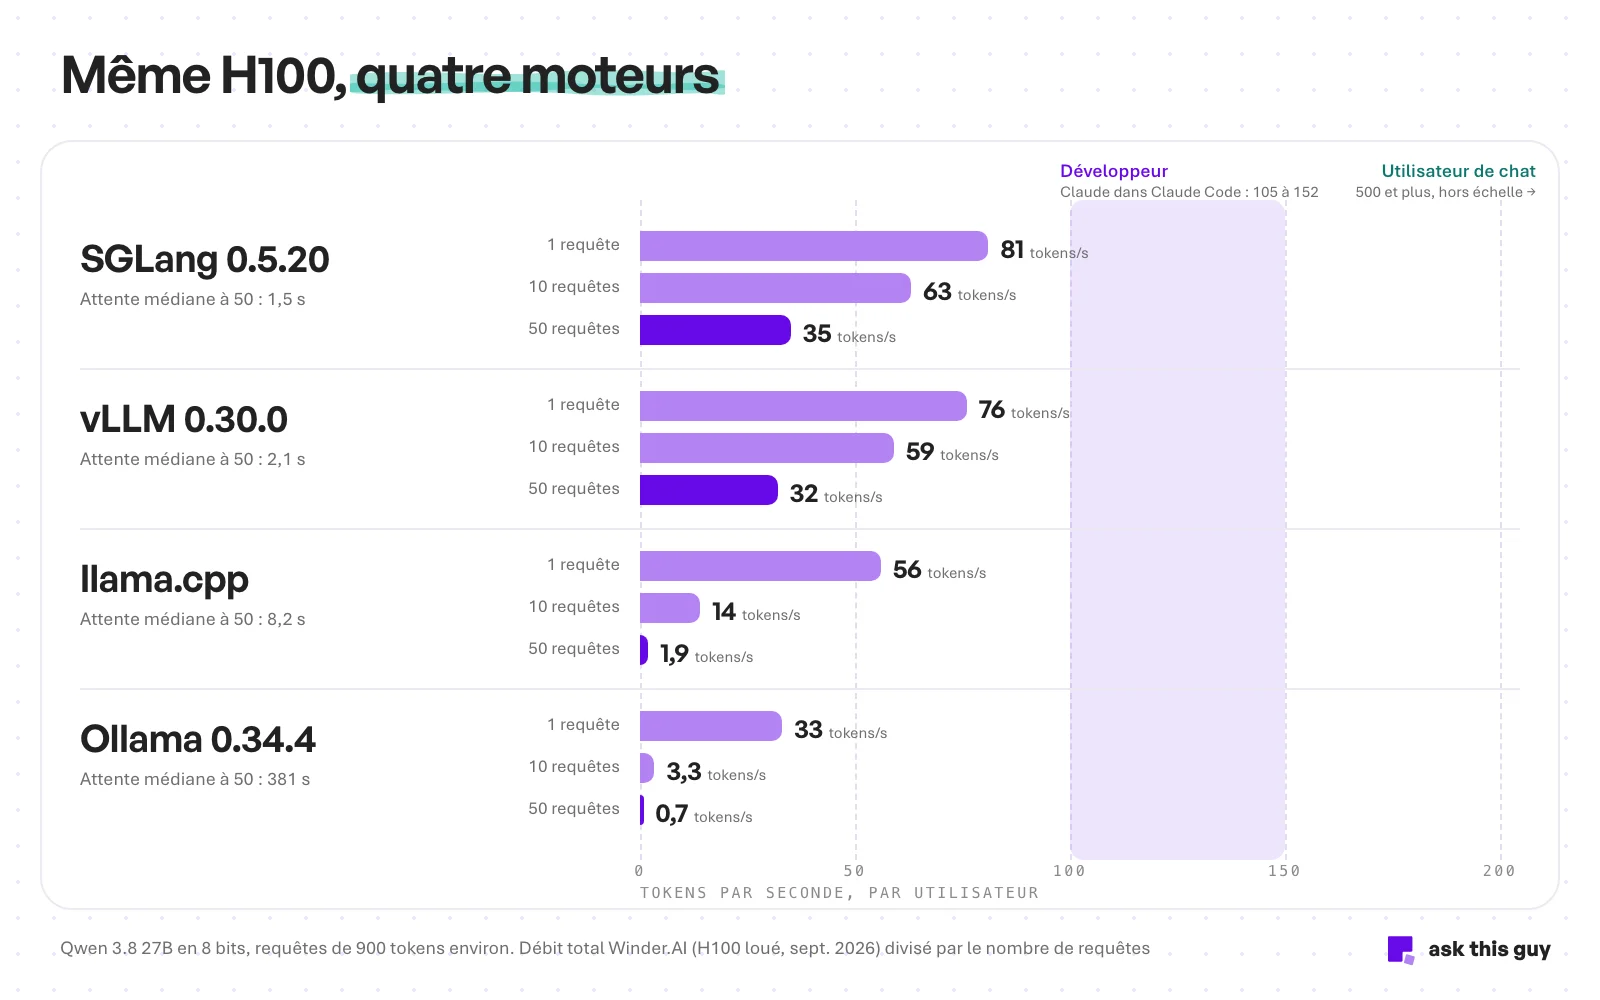 Gráfico: velocidad de Qwen 3.8 27B en 8 bits para cada usuario, en una misma H100, según el motor, con 1, 10 y 50 peticiones simultáneas. SGLang 0.5.20: 81, 63 y 35 tokens por segundo, espera mediana de 1,5 s con 50. vLLM 0.30.0: 76, 59 y 32, 2,1 s. llama.cpp: 56, 14 y 1,9, 8,2 s. Ollama 0.34.4: 33, 3,3 y 0,7, 381 s. Rendimiento total medido por Winder.AI en septiembre de 2026, dividido por el número de peticiones
«Ollama served 33», resume Winder.AI: en esta arquitectura, Ollama procesa las peticiones una a una. Visto desde cada usuario, con 50 peticiones simultáneas, SGLang da 35 tokens por segundo y Ollama 0,7: cincuenta veces menos, en la misma tarjeta. Un piloto en Ollama que funciona bien para una persona se ralentiza para todos en cuanto el equipo empieza a usarlo, sin que la tarjeta tenga la culpa. La configuración también cuenta: con sus parámetros por defecto, SGLang se limitaba a 20 peticiones a la vez, y la espera antes de la primera palabra subía a 10 segundos.
Un servidor de IA con una tarjeta para un equipo
El nivel siguiente es una tarjeta de servidor en una máquina alojada. La RTX PRO 6000 de NVIDIA, con 96 GB de memoria, mantiene en memoria el modelo y muchas conversaciones. Paralon Cloud la midió con vLLM en 4 bits, con respuestas de 256 tokens: 106 tokens por segundo para una petición, 636 en total para 8 peticiones simultáneas, 1.342 para 32. Es decir, por usuario, unos 80 tokens por segundo con 8 y 42 con 32 (cálculo nuestro).
Una tarjeta de este tipo atiende, por tanto, una treintena de peticiones simultáneas a la velocidad de la API del editor. Cuesta entre 16.142 y 16.600 € sin IVA en LDLC Pro según la versión, y más en otros sitios. Ningún integrador francés publica el precio de un servidor en rack con una tarjeta: el único servidor GPU del catálogo de LDLC Pro, con tres RTX PRO 6000, aparece a 89.562 € sin IVA. Una paradoja que señala Pause Hardware: Dell vende en Estados Unidos una estación completa con esta tarjeta por unos 12.600 euros, menos que la tarjeta sola al por menor en Europa.
La tarjeta de servidor más antigua, la L40S de 48 GB, se alquila a 1,40 € la hora en OVHcloud, pero no hemos encontrado ninguna medición publicada de Qwen 3.8 27B en este modelo.
H100 y H200: dar servicio a toda la empresa
Por encima de unas cuantas decenas de peticiones simultáneas, se pasa a las GPU de centro de datos. En una H100 de 80 GB, Winder.AI mide de 1.610 a 1.725 tokens por segundo con 50 peticiones simultáneas, es decir, unos 32 a 35 tokens por segundo por usuario, con 1,5 a 2,1 segundos de espera antes de la primera palabra. La H100 ya no se vende nueva, pero se alquila a 2,80 € la hora en OVHcloud, es decir, 1.940 € al mes en uso continuo.
Su sucesora, la H200 NVL de 141 GB, cuesta 32.533 € sin IVA en LDLC Pro. En 4 bits con vLLM, Paralon Cloud mide 3.342 tokens por segundo en total para 128 peticiones, unos 26 por usuario; con 64 peticiones, unos 48. La B200, más reciente, no lo hace mejor con este modelo en carga: según Paralon, queda entre un 12 y un 14 % por detrás de la H200 entre 32 y 128 peticiones.
La longitud de los documentos cuenta tanto como el número de usuarios. En una H200 con SGLang en FP8, unas mediciones publicadas en el repositorio del proyecto dan, para peticiones de 1.000 tokens, 98 tokens por segundo para un usuario solo, 83 con 16 usuarios y 50 con 64. Con 8.000 tokens de entrada, la velocidad cae a 29 tokens por segundo con 64 usuarios, y la espera antes de la primera palabra pasa de 2,6 a 19 segundos. Un asistente de chat y un RAG que lee contratos no necesitan el mismo servidor, aunque tengan el mismo número de usuarios.
¿Y para la velocidad de un chat?
Ninguna medición publicada de Qwen 3.8 27B en GPU alcanza los 500 tokens por segundo por usuario, ni siquiera para un usuario solo. La decodificación especulativa, que hace adivinar varios tokens de golpe y luego los verifica, acerca al objetivo: en una H200 con SGLang, lleva a un usuario solo de 98 a 196 tokens por segundo, y DataPacket anuncia hasta 360 tokens por segundo en una RTX PRO 6000 con el método DFlash2. Pero la ventaja se diluye con la carga: en la misma H200, solo quedan 66 tokens por segundo por usuario con 32 usuarios. Según los autores de HyperQwen, «speculation wins below ~8 concurrent users, plain batching above».
Un chat local rápido se paga, por tanto, en tarjetas: para acercarse a los 200 a 360 tokens por segundo, cada GPU solo atiende a unos pocos usuarios a la vez, y el presupuesto sigue al número de usuarios simultáneos más que al número de empleados. Por encima de eso hace falta hardware especializado: la velocidad de Le Chat de Mistral o de Cerebras viene de chips diseñados para la inferencia, accesibles por API, no de un servidor GPU clásico. Para un chatbot interno, consideramos que una respuesta que se muestra a 40 a 80 tokens por segundo sigue siendo cómoda: una respuesta de 300 palabras, unos 400 tokens, se escribe en cinco a diez segundos (cálculo nuestro).
Lo que una empresa puede sacar en claro
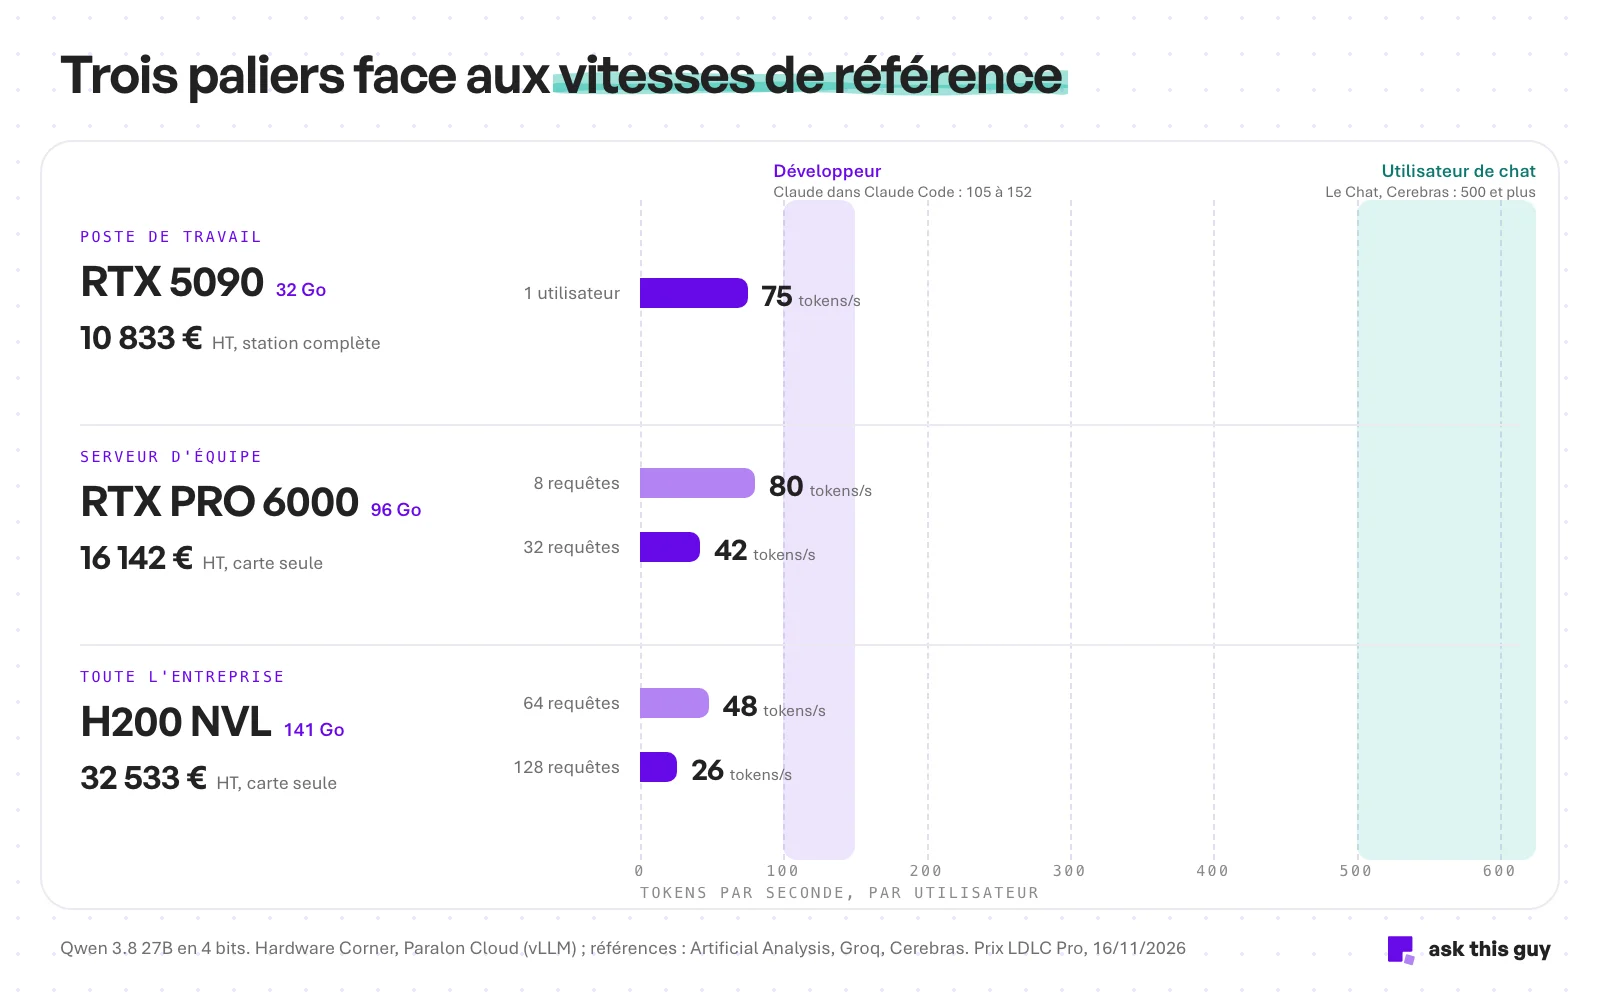 Gráfico: tres niveles de hardware para Qwen 3.8 27B en 4 bits frente a las velocidades de referencia. Puesto de trabajo RTX 5090 (10.833 € sin IVA la estación completa): 75 tokens por segundo para un usuario. Servidor de equipo RTX PRO 6000 de 96 GB (16.142 € sin IVA la tarjeta): 80 tokens por segundo por petición con 8 peticiones simultáneas, 42 con 32. H200 NVL de 141 GB (32.533 € sin IVA la tarjeta): 48 con 64 peticiones, 26 con 128. Todas las barras quedan por debajo de la franja del desarrollador, 100 a 150 tokens por segundo (Claude en Claude Code), y lejos de la del usuario de chat, 500 o más (Le Chat, Cerebras)
| Nivel | Hardware | Precio a 16/11/2026 (Francia) | Peticiones simultáneas medidas | Velocidad por usuario |
|---|---|---|---|---|
| Puesto de trabajo | RTX 5090, estación completa | 10.833 € sin IVA | 1 | 75 tokens/s |
| Puesto de trabajo | Radeon AI PRO R9700, tarjeta | 2.333 € sin IVA | 1 | 20 a 30 tokens/s |
| Servidor de equipo | RTX PRO 6000 96 GB, tarjeta | 16.142 a 16.600 € sin IVA | 8 / 32 | 80 / 42 tokens/s |
| Empresa | H100 80 GB, alquiler | 2,80 € la hora | 50 | 32 a 35 tokens/s |
| Empresa | H200 NVL 141 GB, tarjeta | 32.533 € sin IVA | 64 / 128 | 48 / 26 tokens/s |
Mediciones en 4 bits, salvo la H100 (8 bits); peticiones cortas; cálculos por usuario de ATG a partir de los rendimientos totales publicados.
Nuestra lectura de estas cifras: la carga se mide antes de comprar. El número de peticiones simultáneas y la longitud de los documentos se registran durante un piloto, y deciden el nivel mucho más que el nombre del modelo. Una H100 alquilada unos días en OVHcloud basta para reproducir esa carga con vLLM antes de pedir una tarjeta cuyo plazo de entrega supera a veces los quince días. Un piloto en Ollama, en cambio, muestra la calidad de las respuestas, pero nada del comportamiento en carga.
La tarjeta es solo una línea del presupuesto. Alojamiento, electricidad, mantenimiento y, sobre todo, personal pesan más: nuestro artículo sobre los LLM on premise cifra el coste completo y el umbral de rentabilidad frente a una API.
El mismo modelo existe también como API alojada en Francia: OVHcloud sirve Qwen 3.8 27B y Scaleway lo ofrece, lo que permite un piloto sin hardware. Nuestra página sobre la IA soberana describe lo que resuelve un alojamiento europeo, y lo que no resuelve.
Preguntas frecuentes
¿Qué PC hace falta para ejecutar una IA en local?
Para un modelo como Qwen 3.8 27B en 4 bits, una tarjeta gráfica de 24 o 32 GB basta para un usuario: Hardware Corner mide 40 tokens por segundo en una RTX 3090, 46 en una RTX 4090 y 75 en una RTX 5090. Las máquinas con 128 GB de memoria unificada, como el DGX Spark o el Mac Studio, cargan modelos más grandes, pero generan este modelo denso más despacio.
¿Puede Qwen 3.8 27B sustituir a Claude para programar?
No para código agéntico sobre una base de código grande. En Terminal-Bench 2.1, Vals.ai mide un 87,6 % para Claude Opus 5.5, un 83,2 % para Claude Sonnet 5.5 y un 58,4 % para Qwen 3.8 27B, y el índice de Artificial Analysis lo sitúa en 20 puntos frente a 59 de Opus 5.5. Un Qwen local sirve más bien para el código que no debe salir de la empresa y para las tareas sencillas. Para un chatbot o un agente de negocio, en cambio, suele bastar.
¿A cuántos usuarios puede dar servicio un servidor de IA local?
Depende de la GPU, del motor y de la longitud de los documentos. Con vLLM y Qwen 3.8 27B en 4 bits, una RTX PRO 6000 atiende 32 peticiones simultáneas a unos 42 tokens por segundo cada una, según Paralon Cloud; una H200 NVL atiende 128 a unos 26. El número de empleados atendidos es mayor, porque la mayoría lee o escribe mientras otros esperan una respuesta.
¿Un LLM local es tan rápido como Claude o Le Chat?
No, en general. En un puesto, Qwen 3.8 27B funciona a 40 a 75 tokens por segundo; Artificial Analysis mide Claude Opus 5.5 a unos 110 tokens por segundo en la API de Anthropic, y Cerebras anuncia unos 1.850 tokens por segundo para Qwen 3.8 27B. Cerebras también proporciona el cálculo de Le Chat de Mistral, que responde a más de 1.100 tokens por segundo, y OpenAI ha firmado con ella por 750 megavatios. Un servidor compartido con carga baja a 30 o 40 tokens por segundo por usuario.
¿Cuánto cuesta el hardware de un servidor de IA local?
A 16 de noviembre de 2026, en la tienda francesa LDLC Pro: 2.333 € sin IVA por una Radeon AI PRO R9700 de 32 GB, 10.833 € sin IVA por una estación completa con RTX 5090, de 16.142 a 16.600 € sin IVA por una RTX PRO 6000 de 96 GB y 32.533 € sin IVA por una H200 NVL, solo la tarjeta. Un servidor con tres RTX PRO 6000 aparece a 89.562 € sin IVA. El alquiler de una H100 cuesta 2,80 € la hora en OVHcloud.
¿Basta un DGX Spark para un LLM local?
Para probar modelos, sí; para servir Qwen 3.8 27B con rapidez, no. Sus 128 GB de memoria cargan modelos grandes, pero genera este modelo denso a 11 o 12 tokens por segundo sin decodificación especulativa, y tarda 150 segundos en leer un documento de 128.000 tokens. Su precio ha pasado de 3.999 a 6.950 dólares en un año.
¿Hay que cuantizar un LLM local en 4 bits?
Para Qwen 3.8 27B, la pérdida es pequeña: la versión INT4 de Red Hat conserva entre el 98,5 y el 101 % de las puntuaciones del modelo original, y Quesma no mide ninguna pérdida notable en Q4_K_M. La calidad cae claramente a partir de 2 bits. Las versiones publicadas por Qwen, NVIDIA o Red Hat son más seguras que algunas versiones de la comunidad, que han mostrado bucles de razonamiento.
¿Conviene esperar a Qwen 4 para comprar hardware?
Qwen 4 27B no está publicado a 16 de noviembre de 2026, y su memoria real es desconocida. El hardware dimensionado para Qwen 3.8 27B probablemente lo ejecutará si conserva su tamaño, pero el avance de la arquitectura de Qwen 4 añade grandes tablas de embeddings: mantener un margen de memoria es más prudente que esperar.
Antes de elegir una tarjeta, hay una pregunta que merece una semana de medición: cuántas peticiones llegan de verdad a la vez y qué longitud de texto envían. Es analizando los logs de un piloto como se obtiene una respuesta que puede ahorrar varias decenas de miles de euros.
Qwen 3.8 27B sin gestionar un servidor, con ATG
Con ATG, todo esto ya está resuelto. Elección de la tarjeta, del motor de inferencia y de la cuantización, medición de la carga, mantenimiento: nuestro RAG empresarial llega llave en mano, alojado en OVHcloud en Francia. El modelo que redacta en él las respuestas es precisamente Qwen 3.8 27B, y esas respuestas llegan rápido sin perder pertinencia, algo que una demostración muestra con tus propias preguntas.