Qwen 3.8 27B vs Qwen 4 27B: ¿qué cabe esperar?
Qwen4-Max salió el 16 de noviembre, sin pesos, y Qwen 4 27B se hace esperar. Lo que está confirmado y lo que vale Qwen 3.8 27B frente a Mistral.

El 16 de noviembre, Alibaba lanzó Qwen4-Max, el primer modelo de la generación Qwen 4, tras cinco días de vista previa por suscripción. Es un MoE de 2,4 billones de parámetros, accesible solo a través de la API de Alibaba: sus pesos no se han publicado. Artificial Analysis le da 43 puntos, nueve más que a su predecesor. En el mismo anuncio, Alibaba promete que saldrán «soon» modelos Qwen 4 más pequeños, con pesos abiertos, sin tamaño ni fecha. Qwen 4 27B, por su parte, sigue sin estar en Hugging Face a 16 de noviembre. El modelo que se puede descargar hoy se llama Qwen 3.8 27B, publicado el 14 de agosto con licencia Apache 2.0. Sus resultados son excepcionales para su tamaño, y por eso lo usamos mucho en Ask This Guy.
Para situarse: Qwen (por Tongyi Qianwen) es la familia de modelos de IA de Alibaba, el gigante chino del comercio electrónico (Taobao, Tmall, AliExpress), que es también el primer proveedor de cloud de gama alta de China. Lanzado en abril de 2023, Qwen publica desde agosto de 2023 la mayoría de sus modelos en open weights: cualquiera puede descargarlos y ejecutarlos en sus propias máquinas. La gama va de menos de 1.000 millones de parámetros a 2,4 billones. El «27B» de Qwen 3.8 27B significa 27.000 millones de parámetros, los ajustes internos cuyo número da una idea del tamaño de un modelo.
Qwen 3.8 27B es un modelo denso, mientras que casi todos los grandes modelos abiertos, incluidos los de Mistral, son ahora MoE. Cabe en una sola GPU. En la clasificación de Artificial Analysis del 14 de noviembre obtiene 20 puntos, unas cinco veces más que Gemma 4 31B o gpt-oss-120b, y cuatro veces más que Mistral Medium 3.5, un denso de 128.000 millones de parámetros.
¿Qué cabe esperar de Qwen 4 27B? Sobre su rendimiento no se ha publicado nada. Sobre su forma, el nombre da una pista: en Qwen, los nombres de los modelos MoE incluyen dos números, como «35B-A3B», y los de los densos uno solo. Un «Qwen4-27B» sería, por tanto, denso, si Alibaba mantiene su convención. Pero la vista previa de la arquitectura de Qwen 4, publicada en agosto, añade tablas de embeddings de 51.000 millones de parámetros que no figuran en su nombre, y Qwen4-Max tiene 328.000 millones más que sus 2,4 billones: la memoria real de un futuro «27B» podría superar lo que su nombre hace esperar. Esa vista previa también da la medida de la nueva arquitectura: Artificial Analysis le concede 29 puntos, más que Mistral Large 4, con 6.000 millones de parámetros activos por token. Otras dos señales invitan a la prudencia. Esa vista previa se publica con una licencia propia, no con Apache 2.0: con ese régimen, quien ofreciera Qwen 4 27B como servicio de inferencia tendría que obtener una licencia separada de Qwen, sea cual sea su facturación. Y la generación 3.7 nunca tuvo versión abierta: nada obliga a Alibaba a publicar un Qwen 4 27B descargable.
Qwen 4 y Qwen 4 27B: ¿qué está confirmado?
Qwen4-Max, un modelo cerrado, y la promesa de modelos pequeños abiertos. El nombre «Qwen4-27B» circula desde la conferencia Apsara de Alibaba, pero procede de diapositivas y de crónicas de la keynote, no del comunicado oficial, y el anuncio de Qwen4-Max tampoco lo menciona. El estado de la información a 16 de noviembre de 2026:
| Información | Estado |
|---|---|
| Qwen 4 está en entrenamiento | Confirmado por Alibaba el 22 de septiembre, con una hoja de ruta hacia Qwen 4.5 y Qwen 5 |
| Una gama Max, Plus, Flash y 27B | Nombres vistos en diapositivas, ausentes de los textos de Alibaba; solo ha salido Qwen4-Max |
| «Qwen4 next week» | Frase atribuida al CTO el 29 de octubre por un único asistente, no confirmada; la semana pasó sin lanzamiento |
| Teaser «The becoming begins» | Publicado el 6 de noviembre por la cuenta oficial de Qwen, sin nombre de modelo, ni fecha, ni tamaño |
| Vista previa de Qwen4-Max | Anunciada el 11 de noviembre por Qwen; abierta hasta el 25 de noviembre con la suscripción Token Plan de Alibaba Cloud |
| Lanzamiento de Qwen4-Max | El 16 de noviembre, por API y en las aplicaciones de Alibaba; MoE de 2,4 billones de parámetros, de los cuales 71.000 millones activos; pesos no publicados |
| Modelos Qwen 4 pequeños de pesos abiertos | Prometidos «soon» por Alibaba el 16 de noviembre, sin tamaño, ni fecha, ni licencia |
| Pesos en Hugging Face | Ningún repositorio Qwen 4 en la organización Qwen |
| Licencia, tamaño real, arquitectura de Qwen 4 27B | Desconocidos |
Qwen4-Max: lo que Alibaba publicó el 16 de noviembre
Qwen4-Max es un MoE de 2,4 billones de parámetros, de los cuales 71.000 millones activos por token, frente a 95.000 millones en Qwen 3.8 Max. Lee texto, imagen y vídeo, y su documentación anuncia un contexto de un millón de tokens, hasta 262.144 tokens de salida, razonamiento incluido, y tres niveles de esfuerzo de razonamiento: low, high por defecto, y xhigh. Cuesta 1,50 dólares por millón de tokens de entrada y 4,50 dólares de salida en Singapur, frente a 2 y 6 dólares en Qwen 3.8 Max, y algo menos en las demás regiones de Alibaba Cloud, entre ellas Fráncfort. No se puede ajustar ni desplegar por cuenta propia: solo existe en los servidores de Alibaba, a través de su API y en sus aplicaciones (QwenWork, QwenStudio, Qoder).
Alibaba destaca sobre todo la eficiencia. En Work360, un banco de pruebas propio de tareas profesionales, Qwen4-Max consume entre un 24 y un 35 % menos de tokens que su predecesor según el nivel de esfuerzo, y el coste medio de una tarea pasa de 4,43 a 1,67 dólares, es decir, un 62 % menos. La entrada de Qwen lo compara en dieciséis benchmarks con Qwen 3.8 Max, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra y Kimi K3.1: queda primero en cuatro, entre ellos DeepSWE para el código (75,7 frente a 74,2 para Opus 5.5), pero se queda muy por detrás en otros, como Terminal-Bench 4.0 (48,5 frente a 59,6 para Opus 5.5 y 67,2 para Kimi K3.1) o ProgramBench (31,5 frente a 65,0 para Opus 5.5). Una parte de estas puntuaciones procede de clasificaciones de terceros (Artificial Analysis, Arena, Vals), y el resto, de mediciones del propio editor.
Las mediciones independientes llegaron rápido. Artificial Analysis da a Qwen4-Max 43 puntos en su índice, frente a 34 para Qwen 3.8 Max, pero Kimi K3.1 Pro, el modelo de pesos abiertos de Moonshot, sigue por delante con 46. Qwen4-Max sigue siendo locuaz: 127 millones de tokens generados para pasar el índice, frente a 78,6 millones de mediana, tantos como Qwen 3.8 27B. En la clasificación de desarrollo web de Code Arena entra 6.º, con una nota todavía provisional, por detrás de los mejores modelos de Anthropic, Google y OpenAI.
La vista previa abierta el 11 de noviembre, por su parte, sigue accesible con la suscripción Token Plan hasta el 25 de noviembre, y después se retirará. Para quien quiere pesos, Qwen4-Max no cambia nada: es un modelo cerrado, como lo eran Qwen 3.7 Max y Plus. La generación anterior hacía esperar algo mejor: Qwen 3.8 2.4T-A95B, la versión abierta de Qwen 3.8 Max, salió el 12 de agosto, nueve días después del modelo de API. Esta vez, Alibaba solo promete pesos para los modelos pequeños.
Fecha de lanzamiento de Qwen 4 27B: lo que sugiere el precedente
Pronto, si se toma a Alibaba al pie de la letra. Su anuncio del 16 de noviembre dice que los modelos Qwen 4 «open-weight, smaller-scale» estarán «soon» a disposición de los desarrolladores, sin citar ningún tamaño. La entrada de Qwen precisa que estarán «built on the same lineage and trained with the same generation of techniques», es decir, con la misma arquitectura que Qwen4-Max. El precedente apunta en la misma dirección: Qwen 3.8 Max salió el 3 de agosto, y Qwen 3.8 27B llegó unos diez días después. En el código, un «qwen4-27b» apareció a finales de octubre en una modificación de kernels de cálculo para GPU de Intel, publicada en un repositorio de terceros, que enseguida suscitó una petición de soporte en llama.cpp, sin confirmar ninguna fecha. En Manifold, un mercado de predicción con moneda ficticia, los apostantes daban el 16 de noviembre un 78 % de probabilidades a que hubiera pesos de Qwen 4 en Hugging Face antes del 25 de noviembre, frente al 62 % dos días antes. Una apuesta no equivale a un anuncio.
Mientras tanto, Hugging Face ya cuenta con 51 repositorios llamados «Qwen4-27B», creados por una decena de cuentas de terceros desde el 9 de noviembre. Los que hemos abierto solo contienen un archivo de presentación, sin ningún peso: son nombres reservados de cara al lanzamiento. Alibaba publica sus modelos en la organización Qwen, y en ningún otro sitio.
Qwen 3.8 27B y la familia Qwen 27B: tres versiones en seis meses
Qwen 27B es el modelo de tamaño medio de la familia Qwen de Alibaba: un modelo de lenguaje denso de 27.000 millones de parámetros, multimodal (texto, imagen, vídeo), publicado en open weights con licencia Apache 2.0. Ha tenido tres versiones en 2026, todas construidas sobre la misma arquitectura:
| Versión | Publicación | Licencia | Descargas acumuladas en Hugging Face a 14/11 |
|---|---|---|---|
| Qwen 3.5 27B | febrero de 2026 | Apache 2.0 | 22,6 millones |
| Qwen 3.6 27B | 22 de abril de 2026 | Apache 2.0 | 31,2 millones |
| Qwen 3.8 27B | 14 de agosto de 2026 | Apache 2.0 | 22,5 millones, de ellas 7,0 millones en 30 días |
No hubo Qwen 3.7 27B. La generación 3.7, Qwen 3.7 Max en mayo y luego Qwen 3.7 Plus el 1 de junio, solo salió por API, sin pesos publicados: no existe ningún repositorio Qwen 3.7 en Hugging Face. Algunos sitios de seguimiento esperaban versiones abiertas de 27B y 35B, que nunca llegaron. El 27B abierto pasó directamente de la versión 3.6 a la 3.8. El anterior modelo denso de este tamaño en Qwen era Qwen 3 32B, publicado en abril de 2025, con una arquitectura clásica.
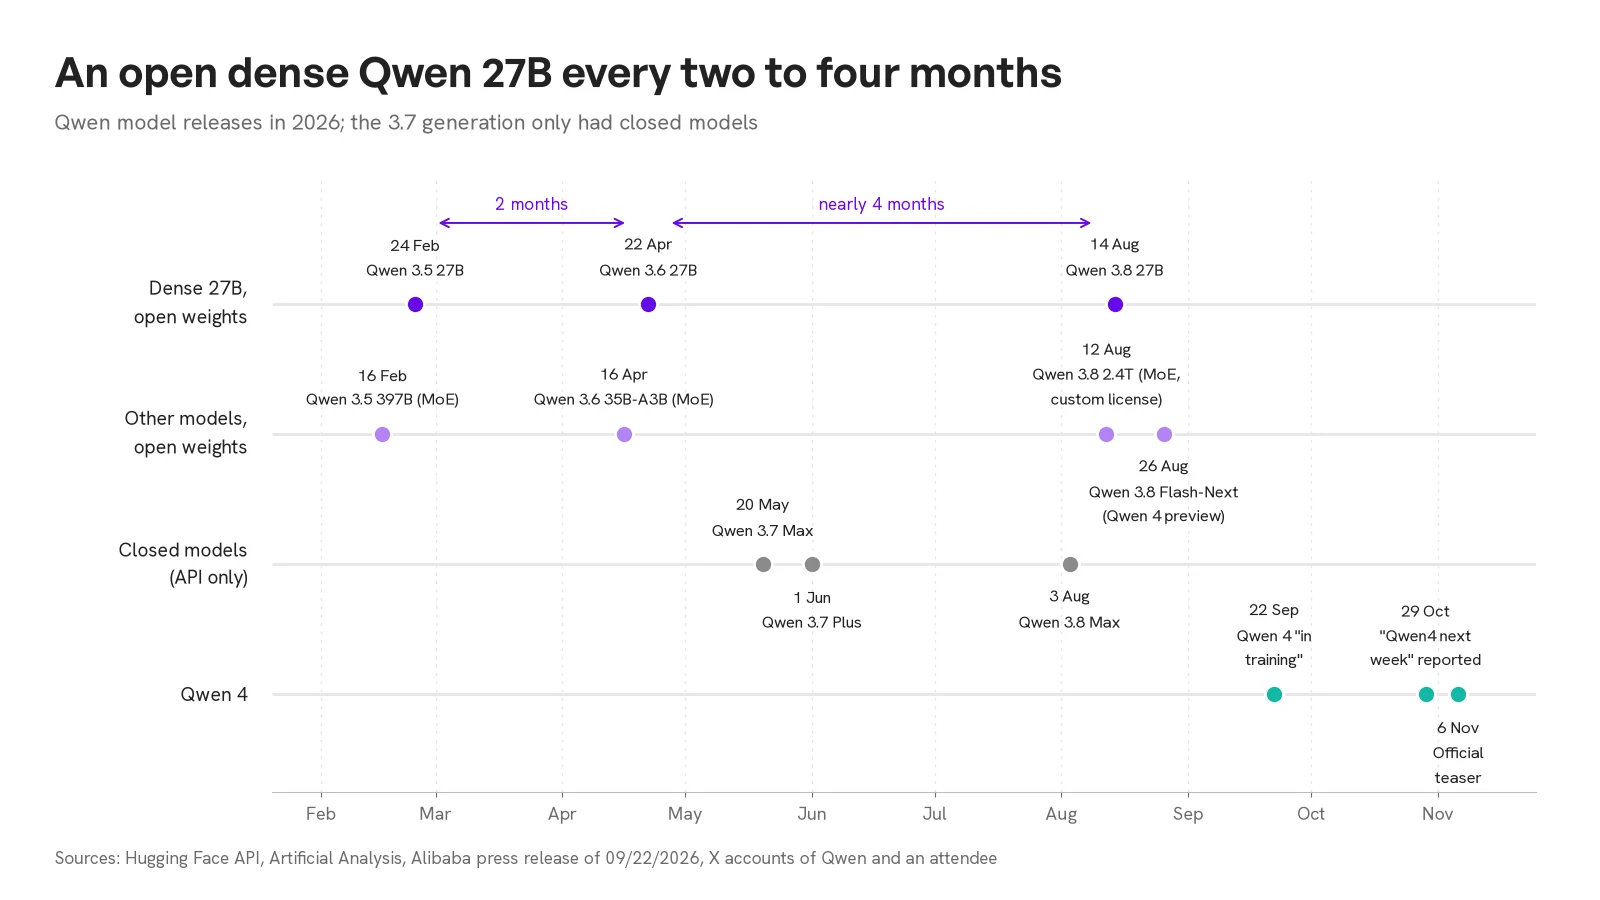 Cronología de los lanzamientos de Qwen en 2026, en cuatro líneas. 27B denso de pesos abiertos: Qwen 3.5 27B el 24 de febrero, Qwen 3.6 27B el 22 de abril (dos meses después), Qwen 3.8 27B el 14 de agosto (casi cuatro meses después). Otros modelos abiertos: Qwen 3.5 397B el 16 de febrero, Qwen 3.6 35B-A3B el 16 de abril, Qwen 3.8 2.4T con licencia propia el 12 de agosto, Qwen 3.8 Flash-Next, vista previa de Qwen 4, el 26 de agosto. Modelos cerrados: Qwen 3.7 Max el 20 de mayo, Qwen 3.7 Plus el 1 de junio, Qwen 3.8 Max el 3 de agosto, Qwen4-Max el 16 de noviembre tras una vista previa abierta el 11. Qwen 4: anunciado en entrenamiento el 22 de septiembre, «Qwen4 next week» atribuido el 29 de octubre, teaser oficial el 6 de noviembre
Fechas: Hugging Face, Artificial Analysis y Alibaba.
Desde Qwen 3.5, estos modelos son híbridos: de las 64 capas de la red, tres de cada cuatro usan una atención llamada lineal (Gated DeltaNet), que ahorra memoria, y una de cada cuatro una atención completa. La ficha de Qwen 3.8 27B anuncia un contexto de 262.144 tokens, ampliable a un millón, y un modo de razonamiento activado por defecto, que se puede desactivar, con tres niveles de esfuerzo: low, medium y xhigh. Qwen lo presenta como un «compact, deployment-friendly dense model», un modelo denso compacto y fácil de desplegar.
Lo que anuncia Qwen
De una versión a otra, Qwen no cambia la arquitectura sino el entrenamiento, y las mejoras anunciadas son importantes. Una selección de las puntuaciones publicadas por Qwen:
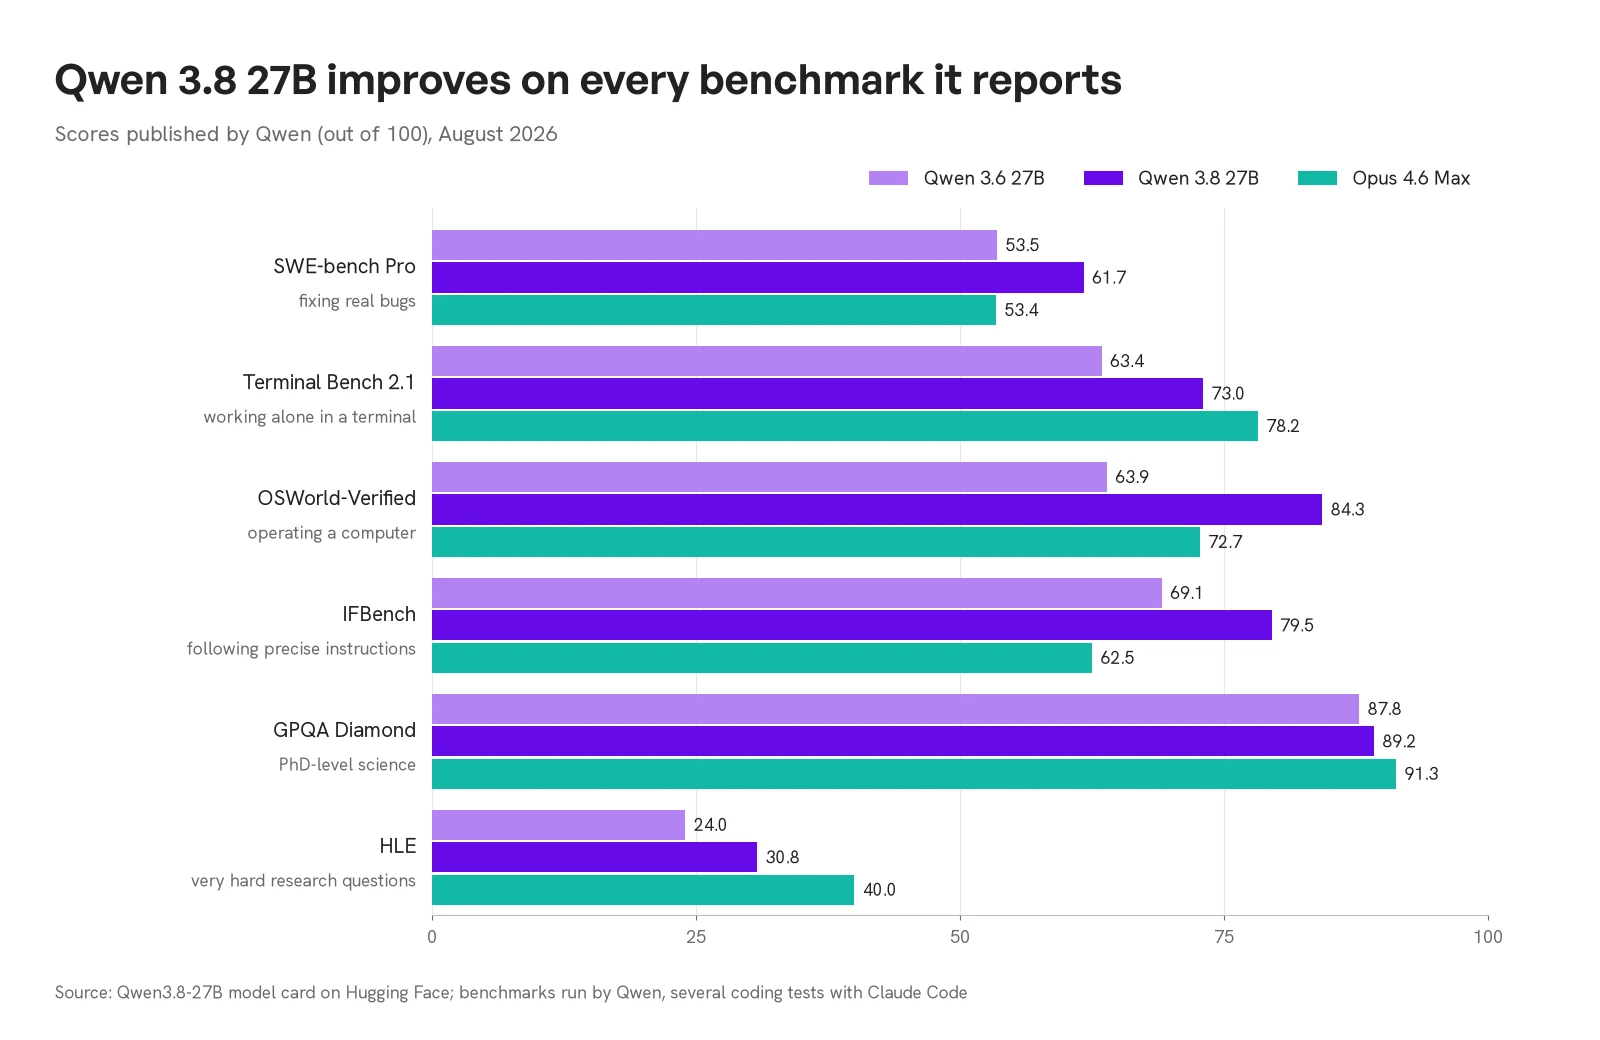 Gráfico de barras de las puntuaciones publicadas por Qwen, sobre 100, para Qwen 3.6 27B, Qwen 3.8 27B y Opus 4.6 Max: SWE-bench Pro 53,5, 61,7 y 53,4; Terminal Bench 2.1 63,4, 73,0 y 78,2; OSWorld-Verified 63,9, 84,3 y 72,7; IFBench 69,1, 79,5 y 62,5; GPQA Diamond 87,8, 89,2 y 91,3; HLE 24,0, 30,8 y 40,0
Son cifras del editor, medidas con sus propios ajustes, y varios benchmarks de código, entre ellos SWE-bench Pro, se pasaron con Claude Code como entorno. Los titulares del tipo «Qwen 3.8 27B bate a Opus» que circulan por YouTube exageran: lo supera en SWE-bench Pro en esta tabla, no en Terminal Bench ni en HLE.
La cifra más interesante está en la tabla anterior, la de Qwen 3.6 27B. Qwen compara ahí su modelo denso con su propio MoE de la generación previa, Qwen 3.5 397B, quince veces más pesado. En SWE-bench Verified, el denso obtiene 77,2 frente a 76,2; en Terminal-Bench 2.0, 59,3 frente a 52,5. En código agéntico, un 27B denso igualaba a un MoE de 397.000 millones de parámetros. El modelo grande mantiene la ventaja en conocimientos (MMLU-Pro, GPQA, HLE), lo cual es lógico: el conocimiento se almacena en los parámetros, y tiene quince veces más.
Lo que miden los demás
Artificial Analysis somete a cada modelo a la misma batería de pruebas. En la versión 4.3.2 de su índice, consultada el 21 de octubre, Qwen 3.8 27B obtenía 34 puntos, frente a 21 para Qwen 3.6 27B, 18 para Qwen 3.5 397B, 15 para Gemma 4 31B de Google y 12 para gpt-oss-120b de OpenAI. Desde entonces, el sitio ha pasado a una versión 5.0.1, con una escala más severa: Qwen 3.8 27B vale en ella 20 puntos, cuando la mediana de los modelos comparables está en 8. En la clasificación del 14 de noviembre, es unas cinco veces la nota de Gemma 4 31B o de gpt-oss-120b, con 4 puntos cada uno.
La misma página muestra el reverso. Para pasar el índice, Qwen 3.8 27B generó 128 millones de tokens, frente a 77,7 millones de mediana, y tardó 44,1 minutos por tarea frente a 14,9. El modelo razona largo y tendido antes de responder. A 42 tokens por segundo en Alibaba, eso se paga en tiempo de espera, y en euros cuando se factura por token generado.
Lo que vemos en ATG
En ATG, Qwen 3.8 27B es el modelo que redacta las respuestas a los mensajes de los usuarios. Es el que se usa, por ejemplo, en nuestro benchmark FinanceBench, donde nuestro agente de búsqueda responde correctamente al 92 % de las preguntas de analistas planteadas sobre 368 informes financieros. Al sustituirlo por Gemini 3.8 Flash, no vimos ninguna diferencia significativa de puntuación, como tampoco al aumentar su presupuesto de razonamiento. En un RAG, lo que determina el resultado es ante todo la búsqueda. Un modelo de 27.000 millones de parámetros bien equipado basta para leer documentos y sacar de ellos una respuesta con fuentes.
También hemos visto sus límites. Llevado a una temperatura de 1,5 (un ajuste que hace las respuestas más aleatorias), deja de dar una respuesta válida en el 15 a 27 % de los casos: su razonamiento se desboca y supera la longitud máxima. Con los ajustes recomendados por Qwen, no hemos observado este problema.
Qwen 27B frente a Mistral, la referencia europea
Para una empresa francesa, y para muchos compradores europeos, la referencia en open weights sigue siendo Mistral. La comparación es útil, siempre que se coloque cada modelo en su sitio, porque las dos gamas no cubren los mismos niveles.
| Modelo | Arquitectura | Parámetros (totales / activos) | Licencia | Índice Artificial Analysis v5.0.1 | Descargas acumuladas |
|---|---|---|---|---|---|
| Qwen 3.8 27B | denso híbrido | 27B | Apache 2.0 | 20 | 22,5 millones |
| Mistral Small 3.2 (junio de 2025) | denso | 24B | Apache 2.0 | no medido | 5,6 millones |
| Mistral Small 4 (marzo de 2026) | MoE | 119B / 6,5B | Apache 2.0 | 4 | 0,7 millones |
| Mistral Medium 3.5 (abril de 2026) | denso | 128B | MIT modificada, con techo de facturación | 5 | 1,1 millones |
| Mistral Large 3 (diciembre de 2025) | MoE | 675B / 41B | Apache 2.0 | no medido | 18.100 |
| Mistral Large 4 (octubre de 2026) | MoE | unos 1.000B / 49B | Mistral Ecosystem Open-Weight License | 26 | 14.100 |
| Qwen 3.8 Flash-Next (agosto de 2026, vista previa de Qwen 4) | MoE | 125B / 6B, más 51B de embeddings | Qwen Community License 1.0 | 29 | 6,1 millones |
| Qwen 3.8 2.4T-A95B (agosto de 2026) | MoE | 2.400B / 95B | Qwen3.8-Max License | sin nota (versión API, Qwen 3.8 Max: 34) | 123.200 |
Las descargas proceden de la API de Hugging Face a 14 de noviembre de 2026.
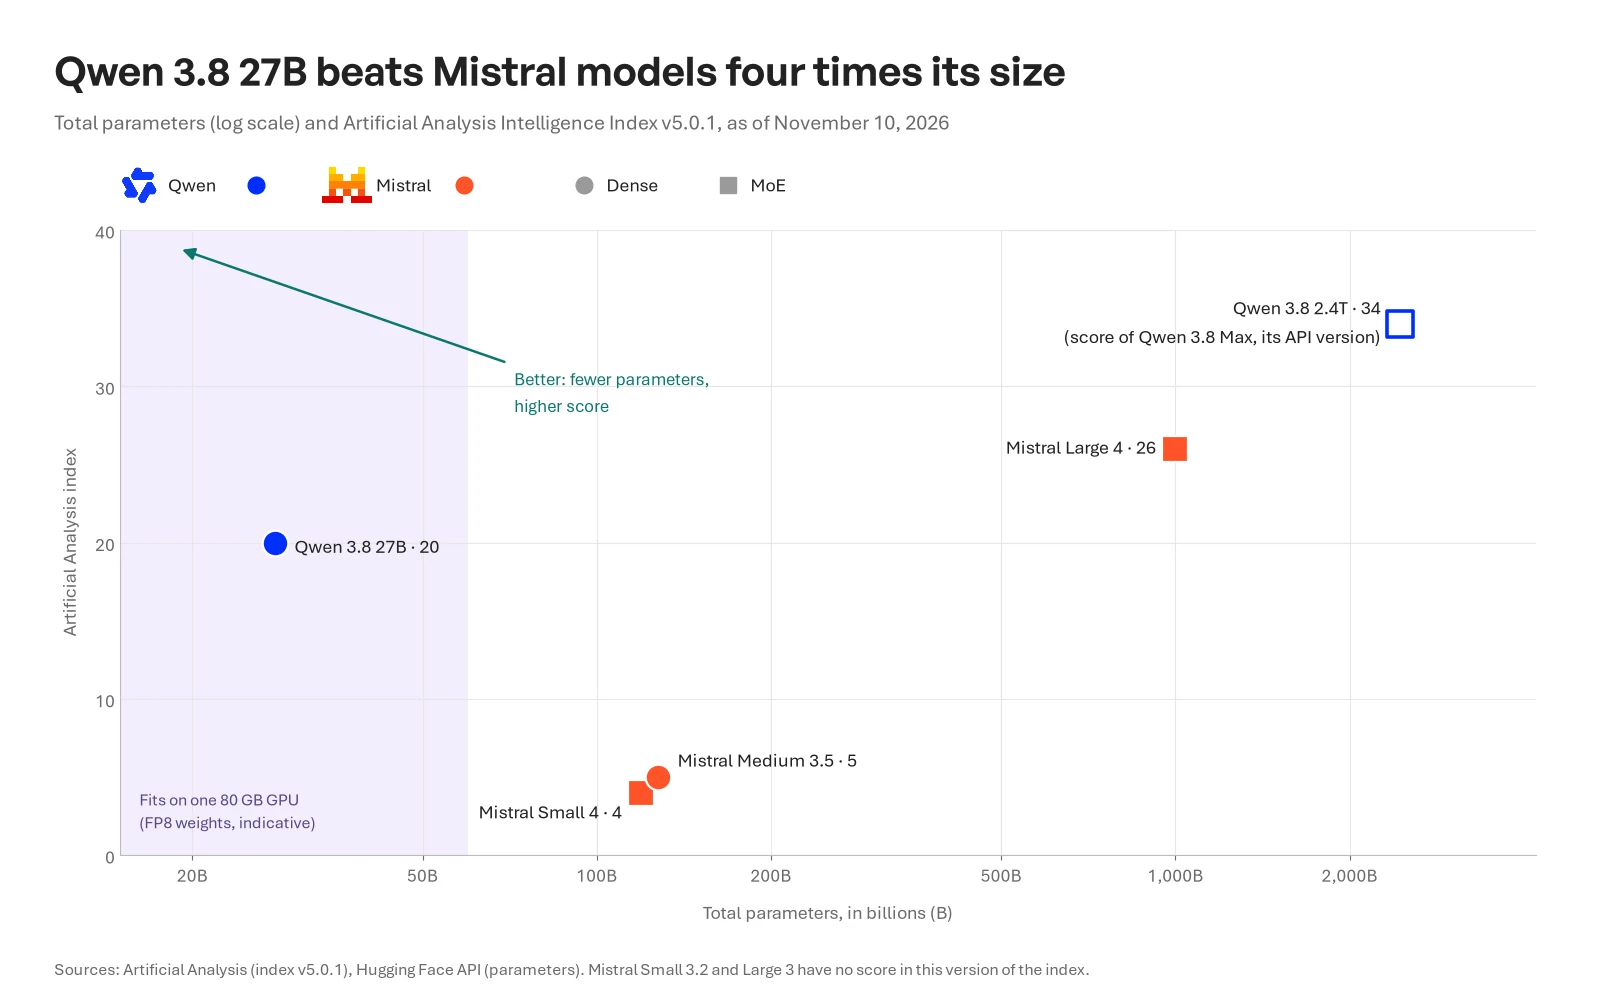 Nube de puntos, parámetros totales en escala logarítmica e índice de Artificial Analysis v5.0.1. Qwen 3.8 27B, denso, 27.000 millones de parámetros, nota 20, único modelo en la zona que cabe en una GPU de 80 GB. Mistral Small 4, MoE de 119.000 millones, nota 4. Mistral Medium 3.5, denso de 128.000 millones, nota 5. Qwen 3.8 Flash-Next, vista previa de la arquitectura de Qwen 4, MoE de 180.000 millones contando sus tablas de embeddings, nota 29. Mistral Large 4, MoE de alrededor de un billón, nota 26. Qwen 3.8 2.4T, MoE de 2,4 billones, situado en 34, la nota de su versión API Qwen 3.8 Max. Una flecha indica que lo mejor está arriba a la izquierda: menos parámetros, mejor nota
En el nivel de una sola GPU, Mistral no tiene una respuesta reciente. Sus últimos modelos generalistas de menos de 30.000 millones de parámetros, Ministral 3 y Devstral Small 2 para el código, son de finales de 2025. Mistral Small 3.2, el denso de 24.000 millones de parámetros descargado 5,6 millones de veces, es de junio de 2025. En 2026, Mistral ha publicado modelos grandes y modelos especializados (voz, series temporales, demostraciones matemáticas), pero ningún sucesor de Small 3.2. La línea Qwen 27B ha tenido tres versiones en ese mismo tiempo.
Mistral Medium 3.5 es el otro denso de la gama, pero pesa 128.000 millones de parámetros, y sus ejemplos de despliegue usan ocho GPU. Mistral anuncia 77,6 en SWE-bench Verified, al nivel de los 77,2 que anuncia Qwen para su 27B, con protocolos que no son necesariamente comparables. Sobre todo, su licencia excluye a las empresas cuya facturación mensual consolidada supere los 20 millones de dólares: por encima, hay que pedir a Mistral una licencia comercial, que concede «at its sole discretion», o recurrir a sus servicios alojados. Una gran empresa o un grupo no puede desplegar Medium 3.5 en sus propios servidores sin contrato.
Mistral Small 4, por su parte, es un MoE de 119.000 millones de parámetros, de los cuales 6.500 millones activos, con licencia Apache 2.0, y el ejemplo de despliegue que da Mistral usa dos GPU. Es rápido (137 tokens por segundo en Mistral según Artificial Analysis) y ahorrador: Mistral afirma en su ficha que los modelos Qwen necesitan entre 3,5 y 4 veces más texto de salida para obtener resultados comparables, lo que confirma la verbosidad de Qwen 3.8 27B medida más arriba. En el índice, se queda muy por detrás.
En la gama alta ocurre lo contrario. Mistral Large 4, lanzado a finales de octubre, obtiene 26 puntos en el índice de Artificial Analysis, por encima de los 20 de Qwen 3.8 27B, y Mistral lo presenta como el mejor modelo abierto occidental de ese índice. Pero tiene alrededor de un billón de parámetros, sus ejemplos de despliegue usan ocho GPU, y su licencia exige una licencia comercial separada a quien quiera ofrecerlo como servicio de inferencia: otro proyecto, con otro presupuesto.
Alibaba también tiene su equivalente, aún más grande: Qwen 3.8 2.4T-A95B, la versión de pesos abiertos de su modelo insignia, tiene 2,4 billones de parámetros, de los cuales 95.000 millones activos, y pesa 4,9 TB en Hugging Face. Artificial Analysis aún no le da nota, aunque cinco proveedores lo sirven, pero Qwen 3.8 Max, la versión comercial construida sobre él, obtiene 34 puntos, por encima de los 26 de Mistral Large 4. Su sucesor, Qwen4-Max, sube a 43 puntos, pero sin pesos publicados. Su licencia no es la Apache 2.0 del 27B: la «Qwen3.8-Max License» obliga a mostrar el nombre del modelo por encima de 100 millones de usuarios mensuales o de 20 millones de dólares de facturación mensual, y exige una licencia separada para ofrecerlo como servicio de inferencia o en un asistente de código o de ofimática por encima de 50 millones de dólares de facturación en doce meses. Tanto en Qwen como en Mistral, el modelo abierto muy grande viene con una licencia propia. Entre ambos, Qwen 3.8 Flash-Next, la vista previa de la arquitectura de Qwen 4, obtiene 29 puntos con 6.000 millones de parámetros activos, más que Mistral Large 4. Su Qwen Community License va más lejos que la de Qwen 3.8 Max: exige la licencia separada para cualquier servicio de inferencia o asistente de código y de ofimática, sin umbral de facturación; el uso interno sigue siendo libre. Más cerca de Mistral Large 3 por tamaño, Qwen 3.5 397B sigue en Apache 2.0, pero no tiene nota en la versión actual del índice.
Nuestra opinión: entre Qwen y Mistral, decidiríamos según el presupuesto de GPU y la licencia. Para un modelo que cabe en una tarjeta, Qwen 3.8 27B no tiene equivalente reciente en Mistral. Para la mejor calidad abierta, Mistral Large 4 y Qwen 3.8 2.4T exigen ambos un servidor de varias GPU y una licencia propia; Mistral tiene la ventaja de ser un editor europeo. La cuestión de la soberanía, en cambio, se resuelve en otro lugar, y volvemos a ella más abajo.
Denso o MoE: ¿por qué un 27B denso cuando todo el mundo pasa al MoE?
Un modelo denso hace trabajar todos sus parámetros para cada token que genera. Un MoE (mixture of experts, o mezcla de expertos) se divide en subredes, los expertos, y un enrutador solo activa algunos de ellos para cada token. Nuestra guía del mixture of experts explica la diferencia paso a paso. Su tamaño se indica con dos cifras: Qwen 3.6 35B-A3B tiene 35.000 millones de parámetros, de los cuales 3.000 millones activos en cada token.
El MoE se ha convertido en la norma de los grandes modelos abiertos. El modelo insignia de Alibaba, Qwen 3.8 Max, tiene 2,4 billones de parámetros, de los cuales 95.000 millones activos. Mistral Small 4 y Large 4, DeepSeek V4 y gpt-oss también son MoE. Los densos recientes se cuentan con los dedos: Qwen 27B, Gemma 4 31B de Google, Mistral Medium 3.5.
Un MoE tiene que guardarlo todo en memoria
Un MoE calcula poco, pero tiene que mantener cargados todos sus expertos, porque el enrutador puede llamar a cualquiera de ellos en el token siguiente. Como resume Hugging Face, «all parameters need to be loaded in RAM, so memory requirements are high»: todos los parámetros tienen que estar en memoria. Para el tamaño de los pesos publicados en BF16, el formato de referencia, la API de Hugging Face da:
| Modelo | Arquitectura | Pesos en BF16 |
|---|---|---|
| Qwen 3.8 27B | denso, 27B | 55,6 GB (30,9 GB en FP8) |
| Qwen 3.6 35B-A3B | MoE, 3B activos | 71,9 GB |
| Qwen 3.5 397B-A17B | MoE, 17B activos | 806,8 GB |
En FP8, Qwen 3.8 27B cabe en una GPU de 80 GB con espacio para las conversaciones. En 4 bits pesa unos 17 a 18 GB según Runpod, lo que le permite caber en una tarjeta de 24 GB como una RTX 4090. Con una calidad de código comparable, necesita quince veces menos memoria que el MoE de 397.000 millones de parámetros.
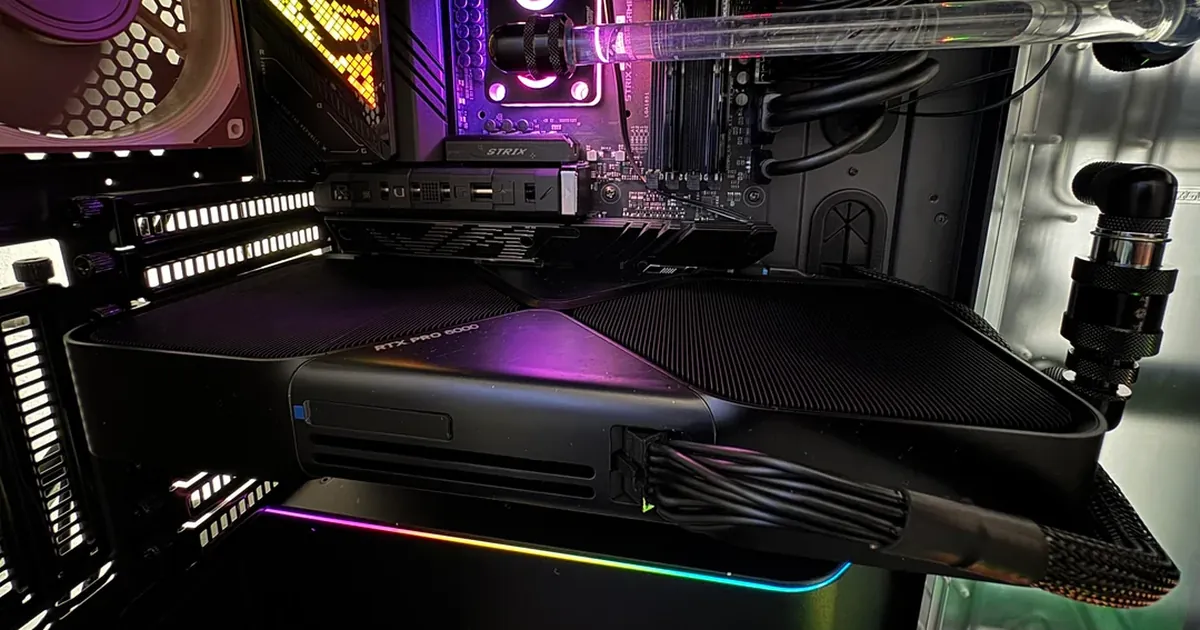
AMD lo midió desde el día de su lanzamiento en dos máquinas de escritorio: hasta 24,5 tokens por segundo en un mini PC equipado con un procesador Ryzen AI Max+ 395 y 128 GB de memoria, y hasta 51,8 en una sola tarjeta Radeon AI PRO R9700 de 32 GB, con llama.cpp y la decodificación especulativa activada. Son cifras preliminares, medidas por el fabricante para un solo usuario. El propio AMD lo recuerda: como modelo denso, Qwen 3.8 27B «places substantial demands on memory capacity and compute», y necesita unos 24 GB de memoria gráfica para funcionar con holgura. Un puesto de trabajo basta para un desarrollador o un piloto, no para dar servicio a toda una empresa. Para cada nivel (puesto de trabajo, servidor con una tarjeta, H100 o H200), nuestro artículo sobre el servidor de IA local da los rendimientos medidos y los precios consultados en noviembre de 2026. La imagen de cabecera de este artículo procede de esta entrada de AMD.
El MoE va más rápido, el denso responde mejor
La contrapartida es la velocidad. Para cada token, un MoE solo lee sus parámetros activos, mientras que un denso los lee todos. En una misma tarjeta gráfica de consumo, un desarrollador midió 31 tokens por segundo para Qwen 3.6 27B y 98 para Qwen 3.6 35B-A3B, con cuantizaciones algo distintas. En Alibaba, Artificial Analysis mide 59 tokens por segundo para el denso y 118 para el MoE.
El mismo desarrollador señala que el denso «scores higher on every coding benchmark». Las cifras de Qwen van en esa dirección: 77,2 en SWE-bench Verified para el 27B denso, 73,4 para el 35B-A3B. El MoE responde dos o tres veces más rápido, el denso responde mejor. Para un asistente de código que un desarrollador usa todo el día, la velocidad puede imponerse. Para un agente que encadena pasos sin que ningún humano espere, la exactitud cuenta más.
Una KV cache cuatro veces más pequeña
La KV cache es la memoria de trabajo de un modelo para cada conversación: guarda un rastro de cada token ya leído y crece con la longitud del contexto y el número de usuarios simultáneos. En un servidor compartido, a menudo es ella, más que los pesos, la que limita el número de usuarios.
La arquitectura híbrida de Qwen 27B reduce claramente esta partida: solo 16 de sus 64 capas mantienen una KV cache, y las 48 restantes se conforman con un pequeño estado de tamaño fijo. A partir de los archivos de configuración publicados de Qwen 3.8 27B y de Qwen 3 32B, nuestro cálculo da 64 KiB por token para Qwen 3.8 27B, frente a 256 KiB para Qwen 3 32B, un denso clásico de tamaño similar. Una conversación de 32.000 tokens, habitual en un RAG, ocupa 2,1 GB en lugar de 8,4 GB. Runpod llega a la misma conclusión: cada conversación cuesta «roughly a quarter» de lo que costaría en un 27B clásico.
En la práctica, en un solo H100 de 80 GB, con los pesos en FP8 y un margen de seguridad, nuestro cálculo da unas 18 conversaciones de 32.000 tokens en paralelo, y unas 35 con una KV cache en FP8. Para dimensionar un servidor más allá de este ejemplo, nuestro artículo sobre los LLM on premise detalla el método.
Más fácil de adaptar
Un denso también es más fácil de personalizar. Hugging Face señala que a los MoE les costó durante mucho tiempo generalizar tras un fine-tuning, con riesgo de sobreajuste. Un denso de 27.000 millones de parámetros se adapta con un adaptador LoRA en una sola tarjeta. A 14 de noviembre, Hugging Face recoge 896 versiones afinadas de Qwen 3.8 27B y más de 1.000 versiones cuantizadas, frente a 523 versiones afinadas del MoE Qwen 3.6 35B-A3B. Nous Research publicó el 6 de noviembre Arete-27B, un reentrenamiento de Qwen 3.8 27B.
Cuándo es preferible un MoE
El MoE sigue siendo la buena elección en tres casos: cuando prima la velocidad que percibe cada usuario, cuando la tarea requiere muchos conocimientos generales y cuando se busca la mejor calidad abierta, que hoy solo existe en MoE de varios cientos de miles de millones de parámetros. Un denso de 27.000 millones de parámetros también tiene sus límites: sabe menos cosas, y razona largo y tendido para compensar, lo que consume tokens.
¿Qué cabe esperar de Qwen 4 27B?
Un modelo más capaz, si uno se fía del ritmo de la línea, pero nadie conoce aún su forma. Primera señal, la generación 3.7: Alibaba demostró que podía lanzar una versión entera de Qwen sin modelo abierto. Con Qwen 4, se ha comprometido por escrito a publicar modelos pequeños de pesos abiertos, algo que no hizo con la 3.7. Segunda señal: Qwen 3.8 Flash-Next, publicado a finales de agosto y presentado por Qwen como un «experimental preview of the architecture that will underpin Qwen4», una vista previa de la arquitectura de Qwen 4. Es un MoE de 125.000 millones de parámetros, de los cuales 6.000 millones activos, a los que se suman 51.000 millones de parámetros de «n-gram embedding», tablas de correspondencia que no cuentan en el tamaño anunciado. En el índice de Artificial Analysis obtiene 29 puntos, frente a 20 para Qwen 3.8 27B. No tiene ni el tamaño ni la forma de un 27B denso, y nada permite deducir de ello la nota de un futuro Qwen 4 27B, pero la nueva arquitectura parte de muy arriba. Su licencia se llama «qwen-community-1.0»: no es la Apache 2.0 de la línea 27B, y exige una licencia separada para cualquier servicio de inferencia abierto a terceros.
Que la vista previa sea un MoE no dice casi nada del 27B: en Qwen, los grandes modelos son MoE desde Qwen 3, mientras que el 27B sigue siendo denso. El nombre cuenta más. El nombre de los MoE de Qwen incluye dos números («35B-A3B»: 35.000 millones de parámetros, de los cuales 3.000 millones activos), y el de los densos uno solo. Un modelo publicado con el nombre «Qwen4-27B» sería, por tanto, denso, si la convención se mantiene; ese nombre procede, no obstante, de diapositivas, no de un comunicado. La verdadera incógnita es la memoria. Qwen4-Max retoma la arquitectura de la vista previa: según la entrada de Qwen, alterna tres capas de atención lineal y una capa de atención dispersa, y tiene 328.000 millones de parámetros de embeddings n-gram además de sus 2,4 billones. Como Qwen anuncia modelos pequeños «built on the same lineage», el 27B también podría pesar más de lo que indica su nombre. Queda la licencia: Alibaba habla de pesos abiertos, sin decir cuáles, y sus dos últimos grandes modelos de lenguaje abiertos, Qwen 3.8 2.4T y Flash-Next, salieron con licencia propia. El día de su lanzamiento, hay cuatro puntos que comprobar antes de cambiar:
- La licencia: Apache 2.0 o licencia propia, con sus posibles restricciones de uso comercial.
- La arquitectura: denso o MoE, número de parámetros totales y activos.
- La memoria: tamaño de los pesos en FP8 y en 4 bits, y KV cache por token, que se puede calcular a partir del archivo de configuración.
- Las mediciones independientes: el índice de Artificial Analysis o las pruebas propias; los benchmarks del editor no bastan.
Actualizaremos este artículo cuando salga Qwen 4 27B, con la comparación en cifras.
¿Puede ser soberano un modelo chino?
Un modelo de pesos abiertos no «llama a casa» de su editor: una vez descargados los pesos, son archivos que se ejecutan en servidores que tú eliges. Alojado en Francia por un operador europeo, Qwen 3.8 27B no envía nada a Alibaba. OVHcloud lo sirve desde el 24 de agosto, en FP8, en un centro de datos francés, a 0,40 € por millón de tokens de entrada y 2,70 € de salida. Scaleway lo ofrece a 0,60 € y 3,30 € (tarifas consultadas el 21 de octubre).
La soberanía depende del proveedor de alojamiento y del operador del cálculo; la nacionalidad de los pesos no cambia nada. Qwen4-Max muestra el caso contrario: Alibaba lo ofrece en su región de Fráncfort, pero es Alibaba quien lo opera y, sin pesos publicados, ningún proveedor europeo puede servirlo. Un centro de datos en Alemania no cambia la nacionalidad del operador. Quedan dos cuestiones abiertas para los pesos abiertos, que se plantean también con los modelos estadounidenses: los sesgos heredados del entrenamiento, que hay que probar en los propios casos de uso, y la dependencia de un editor para las versiones siguientes, que la licencia aún desconocida de Qwen 4 ilustra bien. Ahí está el argumento propio de Mistral: un editor europeo, con el que se puede contratar bajo derecho europeo. Nuestra página sobre la IA soberana y nuestro artículo sobre las licencias open weights detallan estos criterios.
Lo que un departamento de sistemas puede sacar en claro
Si un modelo que cabe en una sola GPU basta para el caso de uso, partiríamos de Qwen 3.8 27B, a través de la API de OVHcloud o de Scaleway, o en una tarjeta propia. Esperar a Qwen 4 solo tiene sentido para un proyecto que no empiece antes de varias semanas. Qwen4-Max no cambia nada de este cálculo: solo existe en los servidores de Alibaba. Los modelos pequeños prometidos, en cambio, podrían cambiarlo, siempre que lleguen con una licencia compatible con el uso previsto.
El cambio de modelo se prepara desde el principio. OVHcloud y Scaleway exponen una API compatible con la de OpenAI: el nombre del modelo tiene su sitio en la configuración, donde se puede cambiar sin tocar el código. Con un conjunto de 100 a 300 preguntas reales y sus respuestas esperadas, como el que describe nuestra guía de auditoría RAG, un equipo mide Qwen 4 27B en media jornada el día de su lanzamiento, y cambia si la mejora es real.
Una pasarela LLM lleva esta lógica un paso más allá: una sola API y una sola clave delante de varios proveedores, con cambio a otro proveedor si el primero no responde. Es donde más sirve con un modelo abierto, que varios proveedores sirven a la vez. A 18 de noviembre, el endpoint europeo de Eden AI, pasarela francesa, ofrece Qwen 3.8 27B en seis proveedores, entre ellos OVHcloud y Scaleway. Elegir la pasarela importa tanto como elegir el modelo: es ella la que decide a qué proveedores van las peticiones, y por tanto dónde se tratan los datos, y con qué rapidez un modelo nuevo como Qwen 4 27B queda disponible. Comparamos las opciones, SaaS, código abierto o pasarela propia, en LLM gateway: ¿OpenRouter, LiteLLM o pasarela propia?
Conviene que el esfuerzo de razonamiento se ajuste a la tarea. Qwen 3.8 27B razona al nivel máximo por defecto; para clasificar un correo o extraer un campo, basta con el nivel low o con el razonamiento desactivado, y el modelo genera menos tokens. Para las tareas que un algoritmo sabe hacer (cálculo, ordenación, regla de negocio), no usaríamos IA en absoluto: es más fiable, más barato y más sobrio.
Preguntas frecuentes
¿Ha salido Qwen 4?
En parte. Qwen4-Max, el modelo insignia de la generación, salió el 16 de noviembre de 2026, tras una vista previa abierta el 11 de noviembre. Es accesible a través de la API de Alibaba Cloud y en las aplicaciones de Qwen. Ningún modelo Qwen 4 se puede descargar: ni Qwen4-Max ni Qwen 4 27B tienen pesos publicados en Hugging Face a 16 de noviembre.
¿Es Qwen4-Max open source?
No. Qwen4-Max es un modelo cerrado: sus pesos no se han publicado y solo se usa a través de la API de Alibaba Cloud o de sus aplicaciones. Alibaba anunció el 16 de noviembre que pronto saldrán modelos Qwen 4 más pequeños, de pesos abiertos, sin precisar su tamaño, su fecha ni su licencia.
¿Cuándo sale Qwen 4 27B?
No hay ninguna fecha oficial a 16 de noviembre de 2026. Alibaba promete modelos Qwen 4 pequeños de pesos abiertos «soon», sin mencionar un 27B. En el caso de Qwen 3.8, el modelo de 27.000 millones de parámetros llegó unos diez días después del modelo insignia. Los repositorios «Qwen4-27B» que ya hay en Hugging Face los publican terceros y no contienen ningún peso.
¿Cuáles son los benchmarks de Qwen4-Max?
Artificial Analysis le da 43 puntos en su índice, frente a 34 para Qwen 3.8 Max y 46 para Kimi K3.1 Pro. Code Arena lo sitúa 6.º en desarrollo web, con una nota provisional. Según Qwen, obtiene 75,7 en DeepSWE, por delante de Claude Opus 5.5, pero 48,5 en Terminal-Bench 4.0, por detrás de Opus 5.5 y Kimi K3.1, y reduce un 62 % el coste medio de una tarea en su banco de pruebas Work360.
¿Es Qwen 3.8 27B open source?
Qwen 3.8 27B es un modelo open weights: sus pesos se pueden descargar libremente con licencia Apache 2.0, que autoriza el uso comercial, la modificación y la redistribución. Sus datos y su código de entrenamiento no se publican, lo que lo distingue de un software open source en sentido estricto.
¿Qué GPU hace falta para ejecutar Qwen 3.8 27B?
En 4 bits, Qwen 3.8 27B pesa unos 17 a 18 GB según Runpod y cabe en una tarjeta de 24 GB como una RTX 4090, para un usuario. AMD anuncia hasta 51,8 tokens por segundo en una tarjeta Radeon AI PRO R9700 de 32 GB. En FP8, sus pesos ocupan 30,9 GB: un H100 de 80 GB atiende entonces unas 18 conversaciones de 32.000 tokens en paralelo. En BF16, hacen falta 55,6 GB solo para los pesos. Para dar servicio a todo un equipo, nuestro artículo sobre el hardware de un servidor de IA local compara tres niveles con sus precios.
Qwen 3.8 27B o Mistral: ¿cuál elegir?
Depende de la infraestructura. Para un modelo que cabe en una sola GPU, Qwen 3.8 27B no tiene equivalente reciente en Mistral, cuyo denso de 24.000 millones de parámetros, Mistral Small 3.2, es de junio de 2025. Para la mejor calidad abierta con un editor europeo, Mistral Large 4 supera a Qwen 3.8 27B en el índice de Artificial Analysis, pero se despliega en ocho GPU en los ejemplos de Mistral y exige una licencia comercial para revenderlo como servicio.
¿Por qué no hay Qwen 3.7 27B?
La generación Qwen 3.7 solo salió por API: Qwen 3.7 Max en mayo de 2026 y Qwen 3.7 Plus el 1 de junio de 2026, sin pesos publicados en Hugging Face. Las versiones abiertas de 27B y de 35B que esperaba la comunidad nunca llegaron. El modelo abierto de 27.000 millones de parámetros pasó de Qwen 3.6 27B, en abril, a Qwen 3.8 27B, en agosto.
¿Es Qwen 3.8 27B mejor que Qwen 3.6 27B?
Sí, tanto según Qwen como según Artificial Analysis. Con la misma arquitectura, Qwen 3.8 27B pasa de 53,5 a 61,7 en SWE-bench Pro y de 63,9 a 84,3 en OSWorld-Verified según el editor, y de 21 a 34 puntos en la versión 4.3.2 del índice de Artificial Analysis. También es más locuaz, y consume más tokens de razonamiento.
En febrero de 2026 hacía falta un MoE de 397.000 millones de parámetros para conseguir lo que un modelo de 27.000 millones hacía en abril en código. Si este ritmo se mantiene, el modelo que bastará para la mayoría de los usos empresariales cabrá pronto en la tarjeta gráfica de un puesto de trabajo. La ventaja será para los equipos capaces de cambiar de modelo en un día: cada nueva versión les beneficia sin obras, mientras los demás se quedan con la que tienen instalada.