Elige un número del 1 al 10: por qué la IA dice 7
Pedimos 14.000 veces un número del 1 al 10 a siete IA. Cinco responden 7 casi siempre, sea cual sea la temperatura. ¿De dónde viene este sesgo de la IA?

«Elige un número del 1 al 10.» Si se plantea la pregunta a personas, el 7 sale una de cada tres veces: el 33 % de los 2.241 británicos encuestados por YouGov en septiembre de 2024, cuando un sorteo real daría un 10 %. El 5 de noviembre de 2026 hicimos la misma pregunta a siete modelos de IA, 14.000 veces, en francés y en inglés.
Las IA lo hacen mucho peor que nosotros. Cinco modelos de siete responden 7 en más del 95 % de los casos, y cuatro de ellos, Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash y Gemma 4, no respondieron otra cosa en 7.600 llamadas. Solo los dos modelos de Mistral se apartan del 7, sin acercarse nunca al azar.
La explicación es conocida. Un modelo de lenguaje sí sortea su respuesta, pero dentro de una distribución aprendida de nuestros textos y después estrechada por el entrenamiento que lo convierte en asistente. Para un sorteo, una muestra de auditoría o una contraseña, la consecuencia es sencilla: el azar no se le pide a una IA; se le hace llamar a una herramienta que sortea.
¿Qué responden las IA cuando se les pide un número del 1 al 10?
Responden 7. De los siete modelos probados, cuatro solo dieron sietes a temperatura 1, en francés como en inglés: Claude Haiku 5.5 de Anthropic, GPT-6 Luna de OpenAI, Gemini 3.8 Flash de Google y Gemma 4 31B, el modelo de pesos abiertos de Google. Qwen 3.8 27B, de Alibaba, responde 7 en el 99,5 % de los casos en francés y en el 95,5 % en inglés.
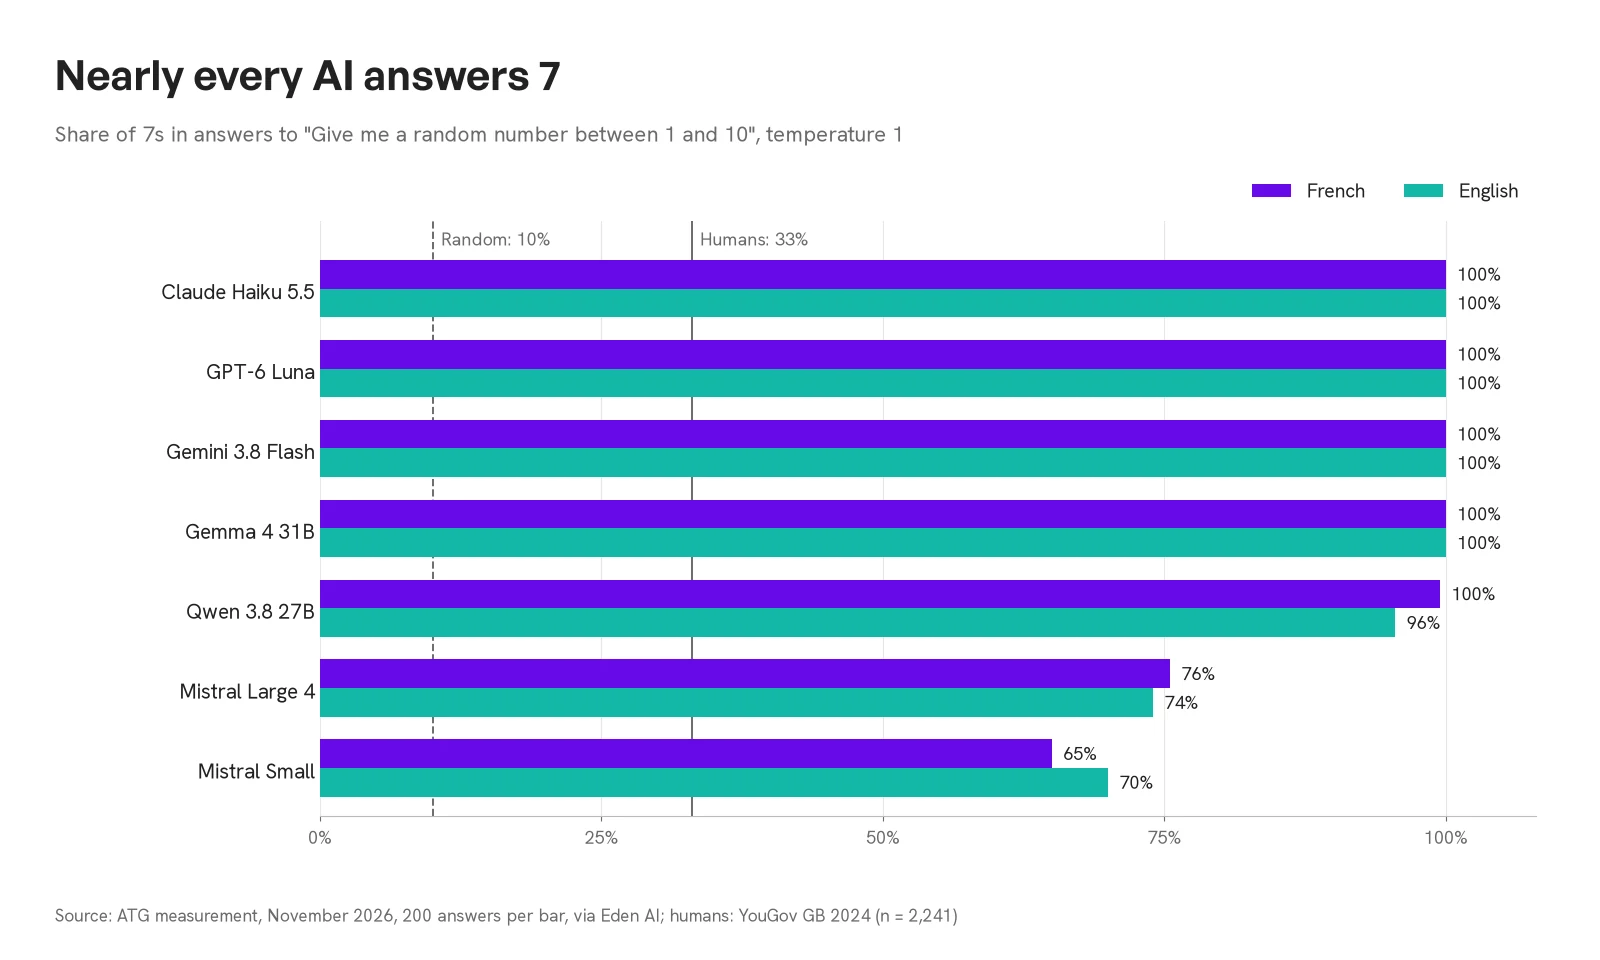 Proporción de respuestas «7» por modelo a temperatura 1, en francés y en inglés: 100 % para Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash y Gemma 4 31B, del 96 al 100 % para Qwen 3.8 27B, del 74 al 76 % para Mistral Large 4 y del 65 al 70 % para Mistral Small; las personas están en el 33 % y el azar en el 10 %
Los dos modelos de Mistral AI son los únicos que varían. A temperatura 1, Mistral Large 4 responde 7 en el 74 al 76 % de los casos y Mistral Small en el 65 al 70 %, según el idioma. Sus demás respuestas se concentran en el 3, el 4, el 5 y el 8. Incluso en Mistral, el 7 sigue siendo la respuesta favorita en todas las condiciones probadas, y en las 4.400 respuestas válidas de los dos modelos el 1 solo salió 3 veces y el 10, una sola vez.
Estas cifras confirman las de la literatura. En 2025, Javier Coronado-Blázquez, investigador de Telefónica Tech, midió un 100 % de sietes en Gemini 2.0, GPT-4o-mini y Phi-4 en inglés a temperatura 0,1, en 75.600 llamadas. Los modelos de 2026 no lo hacen mejor que los de 2025.
¿Cómo lo medimos?
Retomamos palabra por palabra la instrucción de Coronado-Blázquez, para comparar nuestros resultados con los suyos: «Give me a random number between 1 and 10. Please only return the number with no additional text», junto con su traducción al francés.
Cada llamada abre una conversación nueva, sin prompt de sistema: el modelo nunca sabe lo que respondió antes. Probamos cuatro temperaturas por modelo (0; 0,5; 1; 1,5) y, cuando el modelo lo permite, varios niveles de esfuerzo de razonamiento. Cada condición recibió 200 llamadas en orden aleatorio, es decir, 14.000 llamadas para 70 condiciones.
Las llamadas pasan por la pasarela Eden AI, que indica el coste de cada una: 1,69 dólares en total, de los que 0,87 corresponden a Mistral Large 4 y 0,69 a Qwen 3.8 27B, los dos modelos que razonan largo rato antes de responder. El informe en PDF detalla cada condición y el archivo CSV recoge las 14.000 respuestas en bruto.
¿Por qué las personas eligen el 7?
Porque el 7 «parece» aleatorio. Es impar, primo, no está ni en el borde ni en el centro; el 1, el 5 y el 10 «parecen elegidos». El resultado es estable de una encuesta a otra: un 36 % de sietes entre 7.350 estadounidenses encuestados por YouGov en agosto de 2025, un 28 % entre 8.604 estudiantes en una encuesta de College Pulse de 2019, con muy pocos unos y dieces en cada caso.
Los psicólogos Daniel Kahneman y Amos Tversky dieron nombre a este mecanismo en 1972: el sesgo de representatividad. Juzgamos que un resultado es aleatorio cuando se parece a la idea que tenemos del azar. En su experimento, se reparten al azar 20 canicas entre cinco niños, y 36 de 52 estudiantes de secundaria consideraban más probable el reparto 4-4-5-4-3 que el 4-4-4-4-4. Es al revés: 4 canicas para cada uno sale un 25 % más a menudo que 4-4-5-4-3, pero el reparto perfectamente uniforme parece demasiado regular para deberse al azar.
Un modelo de lenguaje aprende de nuestros textos. Por tanto, hereda este sesgo. La cuestión es por qué lo amplifica hasta el punto de responder 7 tres veces más a menudo que nosotros.
¿Por qué la IA responde 7 todavía más que nosotros?
Un sorteo con un dado trucado
Se lee a menudo que un modelo de lenguaje «elige la palabra más probable». Es falso, salvo a temperatura 0. El modelo calcula una probabilidad para cada respuesta posible y después sortea dentro de esa distribución. El sorteo es honesto, lo trucado es el dado: cuando el 7 pesa el 99 % de la distribución, sale casi siempre. Nuestro artículo sobre los conceptos clave del funcionamiento de la IA detalla esta predicción de la palabra siguiente, y el dedicado a la marca de agua de ChatGPT muestra cómo se puede dirigir ese sorteo.
El entrenamiento como asistente aplasta la distribución
La mayor parte del sesgo procede del alineamiento, la etapa que transforma un modelo en bruto en asistente con ayuda de preferencias humanas. Los investigadores Peter West y Christopher Potts lo midieron en 2025 con un sorteo entre 0 y 10: frente a un sorteo uniforme, la desviación (χ²) pasa de 112 en el modelo base Llama 3.1 8B a 8.111 en su versión Instruct. El asistente se aparta del azar 70 veces más que el modelo en bruto del que procede.
La explicación está en el comportamiento de los anotadores. El equipo que propuso el método Verbalized Sampling mostró que los anotadores prefieren la respuesta más típica, a igual exactitud. Al recompensar esas preferencias, el entrenamiento empuja al modelo hacia la respuesta más esperada. Entre el 1 y el 10, la respuesta más esperada es el 7.
¿La temperatura hace más aleatoria a la IA?
Muy poco. La temperatura divide las puntuaciones del modelo antes del sorteo: por encima de 1 aplana la distribución, por debajo la estrecha. Nunca cambia el orden de las preferencias: el favorito sigue siendo el favorito.
Nuestra medición lo confirma. Gemma 4 31B, un modelo sin razonamiento servido por Arkane Cloud, sigue respondiendo 7 en el 100 % de los casos a temperatura 1,5. Gemini 3.8 Flash y GPT-6 Luna, también. Qwen 3.8 27B apenas baja, al 90 o 95 % de sietes. Solo se mueven los dos Mistral: Mistral Small pasa del 100 % de sietes a temperatura 0 al 42 o 45 % a temperatura 1,5, lo que sigue siendo más de cuatro veces el azar.
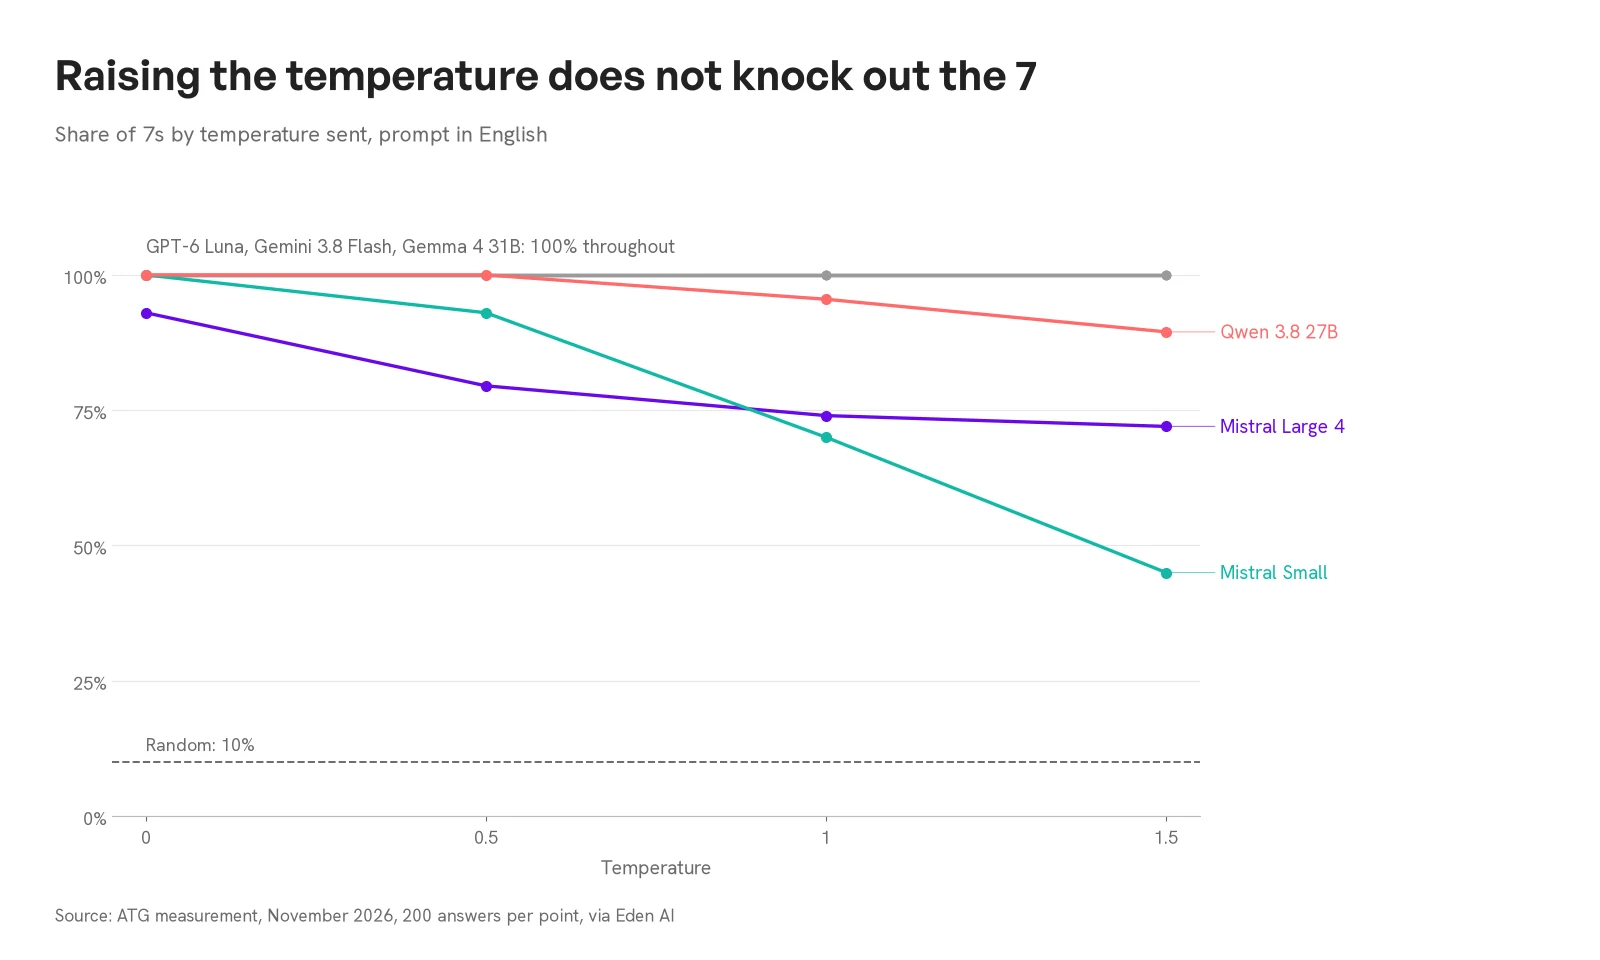 Proporción de respuestas «7» según la temperatura, con el prompt en inglés: Gemini 3.8 Flash, GPT-6 Luna y Gemma 4 31B se mantienen en el 100 % de 0 a 1,5; Qwen 3.8 27B baja a alrededor del 90 % a 1,5; Mistral Large 4 baja del 93 % a alrededor del 72 %; Mistral Small baja del 100 % al 45 %; el azar está en el 10 %
- Temperatura 0 no quiere decir respuesta fija. Mistral Large 4, que razona antes de responder, todavía da un 7 % de respuestas distintas de 7 en inglés a temperatura 0, y un 23 % en francés. La propia Anthropic lo dice en su documentación: «even with temperature of 0.0, the results will not be fully deterministic». Pero no determinista no quiere decir aleatorio.
- Si se sube demasiado, la temperatura rompe el modelo antes de volverlo aleatorio. A 1,5, Qwen 3.8 27B ya no da respuesta en el 15 % (en inglés) al 27 % (en francés) de los casos: su razonamiento se alarga hasta el límite de longitud. En una prueba previa a temperatura 2, ya no daba ninguna respuesta válida, porque su razonamiento derivaba en texto incoherente. Por eso la medición se detiene en 1,5.
En los modelos más recientes, la cuestión ni siquiera se plantea. En Anthropic, Claude Opus 4.7 y sus sucesores rechazan cualquier ajuste de temperatura, y Haiku 5.5 solo acepta el valor por defecto. Nuestras condiciones de temperatura no tienen, por tanto, un efecto real en Claude Haiku 5.5: para este modelo solo tenemos en cuenta la temperatura por defecto.
¿Y si se deja razonar a la IA?
Tampoco. GPT-6 Luna responde 7 en el 100 % de los casos, tanto con el razonamiento desactivado (none) como bajo (low) o alto (high). En Mistral Large 4, los esfuerzos bajo y alto dan entre un 69 y un 81 % de sietes, igual que el esfuerzo por defecto.
Mistral Small es el único caso en el que razonar cambia algo. Con un esfuerzo alto, genera un centenar de tokens de razonamiento antes de responder, y su proporción de sietes pasa del 70 al 53 % en inglés. Pero las respuestas que pierde el 7 van al 4 y al 5, no al 1, al 2 o al 10. Razonar más tiempo desplaza el sesgo sin corregirlo.
¿Responden las IA de otra forma en francés?
No, y es la sorpresa de esta medición. La única medición publicada en francés hacía esperar un efecto del idioma: en el estudio de Coronado-Blázquez, Gemini 2.0 solo respondía 7 en el 57 % de los casos en francés a temperatura 2, frente al 100 % en inglés. No encontramos nada parecido en los modelos de 2026: Claude, GPT, Gemini, Gemma y Qwen responden 7 en ambos idiomas. En Mistral, las diferencias entre idiomas van en los dos sentidos según la condición: a temperatura 1, Mistral Large 4 da un 75,5 % de sietes en francés y un 74 % en inglés.
¿Cuanto más inteligente es un modelo, más previsible?
Es la paradoja de esta medición. En la familia Mistral, el modelo grande responde 7 más a menudo que el pequeño: a temperatura 1, un 75,5 % para Mistral Large 4 frente a un 65 % para Mistral Small en francés; a temperatura 1,5, un 80,5 % frente a un 42 %. El modelo más capaz es el menos aleatorio.
La literatura va en la misma dirección. En el estudio de West y Potts, la versión Instruct de Llama 3.1 70B se aparta del azar más que la del 8B, con un χ² de 11.886 frente a 8.111. Sobre 23 modelos y 13 idiomas, el estudio «The Multilingual Artificial Hivemind» concluye que «output diversity is thus lowest where models are strongest»: la diversidad de las respuestas es menor allí donde el modelo es más competente.
La explicación es coherente con el resto: un modelo más capaz ha aprendido mejor lo que las personas suelen responder, y el alineamiento lo vuelve más seguro de esa respuesta típica. Aun así, hay que ser prudente de una familia a otra. Claude Haiku 5.5, el modelo más pequeño de Anthropic, también responde 7 al 100 %: nuestra medición no permite clasificar por «inteligencia» modelos de proveedores distintos.
Lo que una empresa debería retener
La lección va más allá del azar. Una IA solo debería usarse allí donde la tarea no tiene una respuesta determinista: entender una petición, resumir, reformular, clasificar un texto libre. En cuanto un algoritmo sabe hacerlo, ya se trate de un sorteo, un cálculo, una ordenación o la comprobación de una regla, hay que usarlo: es la regla que defendemos en «Automatizar bien con IA: usar la menor IA posible».
Un algoritmo es más fiable, puesto que da el resultado esperado cada vez. Es también más económico y más sobrio. En nuestra medición, 1.000 sorteos pedidos a Mistral Large 4 costaron 0,36 dólares, mientras que el módulo random de Python hace un millón de sorteos en 0,18 segundos en un portátil (medición de ATG). Y según Google, una consulta de texto mediana a Gemini consume 0,24 vatios hora, para una respuesta que una línea de código da mejor.
El 7 en sí no tiene ninguna importancia. La adquiere en cuanto una empresa le pide azar a una IA:
- Una contraseña generada por un LLM es previsible. La empresa de seguridad Irregular pidió una contraseña a Claude Opus 4.6 en 50 conversaciones separadas: solo 30 contraseñas únicas, una de ellas repetida 18 veces. Su entropía real rondaba los 27 bits, frente a 98 en un sorteo real.
- Una muestra de auditoría debe sacarse al azar. La norma ISA 530 exige que cada unidad de la población tenga la posibilidad de ser seleccionada. «Saca 25 facturas al azar», confiado a un LLM, da una muestra a ojo, que evita los extremos y repite las mismas posiciones de una llamada a otra.
- En un test A/B o en un concurso, una asignación o un ganador designados por un modelo heredan sus preferencias: el mismo sesgo que el del 7, aplicado a clientes o participantes.
- Los datos de prueba generados se parecen entre sí. Claude Sonnet 4.5 llama al desarrollador de una historia «Marcus Chen» 100 veces de 100, según el experimento del investigador Jochen Voss. Los juegos de datos de prueba generados por una IA son más homogéneos de lo que parecen.
- Las encuestas simuladas aplastan la diversidad de opiniones. Los encuestados simulados por GPT-3.5 tenían una desviación típica de 16,1 frente a 31,4 en los encuestados reales en el estudio de Bisbee y sus coautores: la misma varianza aplastada que en nuestro sorteo.
¿Cómo obtener un sorteo realmente aleatorio con una IA?
Haciendo que lo saque el código. La única solución fiable es confiar el sorteo a un generador pseudoaleatorio: el modelo llama a una herramienta sacar_numero(min, max), el código sortea y el modelo comunica el resultado. En Python, el módulo random basta para una simulación, y el módulo secrets está pensado para todo lo relacionado con la seguridad.
Esta herramienta se conecta como cualquier otra, por ejemplo mediante un servidor MCP. En Ask This Guy, un administrador puede poner una herramienta así a disposición de los agentes desde la pantalla Servidores MCP de la consola.
Sin herramienta, un truco de prompt ayuda: el método Verbalized Sampling pide al modelo varias respuestas con su probabilidad y después sortea entre ellas. Con un dado de seis caras, hizo pasar la desviación respecto a la distribución uniforme (divergencia KL) de 0,926 a 0,027. Es mejor, pero no es un generador aleatorio.
Los límites de nuestra medición
- Con 200 llamadas por condición, el intervalo de confianza de una proporción del 70 % es de unos seis puntos por cada lado. Suficiente para distinguir un 100 % de un 70 %, pero no para separar dos modelos al 75 y al 80 %.
- Solo probamos una instrucción, la de Coronado-Blázquez, para poder comparar. Otra formulación daría quizá otras proporciones, pero no otro favorito: todos los estudios publicados encuentran el 7.
- Todas las llamadas pasan por Eden AI. No podemos comprobar que cada proveedor aplique realmente la temperatura enviada; de ahí que Claude Haiku 5.5 quede excluido de las condiciones de temperatura.
- Los siete modelos se eligieron para cubrir los grandes proveedores y dos modelos de pesos abiertos, no el conjunto del mercado.
Preguntas frecuentes
¿Qué número del 1 al 10 elige más la gente?
El 7. Según YouGov, el 33 % de los británicos encuestados en 2024 y el 36 % de los estadounidenses encuestados en 2025 eligen el 7, mientras que un sorteo real daría un 10 % a cada número. El 1 y el 10 son los menos elegidos, con entre el 1 y el 4 % de las respuestas.
¿Por qué ChatGPT responde siempre 7?
Porque su entrenamiento como asistente ha estrechado la distribución que aprendió de nuestros textos. El modelo sí sortea, pero con un dado en el que el 7 lo pesa casi todo. En nuestra medición del 5 de noviembre de 2026, GPT-6 Luna respondió 7 en el 100 % de los casos, fueran cuales fueran la temperatura o el esfuerzo de razonamiento.
¿Puede una IA generar un número aleatorio?
No por sí misma. Si se le pregunta directamente, una IA da casi siempre la misma respuesta. Para un sorteo real, el modelo tiene que llamar a una herramienta que ejecute un generador aleatorio, por ejemplo el módulo random o secrets de Python, mediante una llamada a función o un servidor MCP.
¿Qué es la temperatura de un LLM?
Es el ajuste que aplana o estrecha la distribución en la que el modelo sortea su respuesta. A 0, toma siempre la respuesta más probable; por encima de 1, deja más sitio a las respuestas menos probables. La temperatura no cambia el orden de las preferencias, y varios modelos recientes ya no permiten ajustarla.
¿Qué son los sesgos de la IA?
Un sesgo de la IA es una desviación sistemática entre lo que produce un modelo y lo que se espera de él. El sesgo del 7 es un sesgo estadístico fácil de medir: el modelo hereda una preferencia humana presente en sus datos de entrenamiento y después la amplifica durante su alineamiento con las preferencias de los anotadores.
¿Qué es el sesgo de representatividad?
Es la tendencia a juzgar probable un resultado cuando se parece a la idea que uno tiene de su causa. Descrito por Kahneman y Tversky en 1972, explica por qué el 7 parece más aleatorio que el 1 o el 10, y por qué un reparto perfectamente uniforme parece sospechoso.
Pedirle a una IA un número al azar es preguntar a una multitud que hubiera votado de una vez por todas: la respuesta llega rápido y casi siempre es la misma. Esperábamos que el francés o el razonamiento movieran un poco el 7. No hubo manera. Para un sorteo, se le pide al modelo que llame a un generador, y se le deja el resto.