Cómo funciona la IA: 10 conceptos antes de firmar
¿Cómo funciona la IA? Red neuronal, token, entrenamiento, fine-tuning, alucinación, LLMOps: los conceptos que explican adónde va tu presupuesto de IA.

¿Cómo funciona la IA y qué implica para un proyecto de empresa? Este artículo está pensado para quienes se interesan por la IA, intuyen su potencial, pero no tienen ni el tiempo ni las ganas de convertirla en su oficio.
Lo más probable es que quieras delegar tus necesidades de IA en un equipo interno o en proveedores externos. Es legítimo. Pero no podrás ahorrarte el trabajo de cuestionarlos, y para eso hay que entender algunos conceptos clave y, sobre todo, lo que implican para un proyecto de empresa.
Aquí van, por tanto, diez nociones que conviene conocer. Sin matemáticas, sin más jerga de la estrictamente necesaria. Lo suficiente para entender de qué se habla y para gestionar la parte de negocio de un proyecto de IA.
El contenido de este artículo se publicó primero este verano en LinkedIn, un concepto al día.
Cómo funciona la IA: lo esencial
No hay nada mágico en todo esto. Pesos numéricos ajustados a base de ejemplos, texto troceado en fragmentos, herramientas conectadas alrededor, tus documentos colocados en el momento justo sobre la mesa del modelo y mucha ingeniería para que el conjunto se sostenga.
Lo que enseñan estos diez conceptos cabe en dos frases. Tu factura casi nunca depende del modelo que elijas, sino de cómo lo utilices. Y el POC, la demostración que te convenció, representa alrededor del 20 % del coste total del proyecto.
Nada de esto justifica prometer de más. Tampoco justifica esperar.
Parte 1: de qué está hecho un modelo
1. La red neuronal
Un software clásico es una serie de instrucciones escritas por una persona. «Si el cliente tiene más de tres pedidos, aplicar un 10 % de descuento». Una regla, aplicada al pie de la letra, con un resultado previsible. Para escribirla, eso sí, hay que poder formularla.
Intenta ahora escribir la regla que reconoce si una foto muestra un gato. No lo conseguirás. Un cerebro lo hace sin esfuerzo, así que los informáticos se inspiraron en él.
Una red neuronal es una entrada que atraviesa millones o miles de millones de pesos numéricos y sale convertida en un resultado. Esos pesos no se han programado: se han ajustado solos a partir de ejemplos. Si los abres, no verás ninguna lógica.
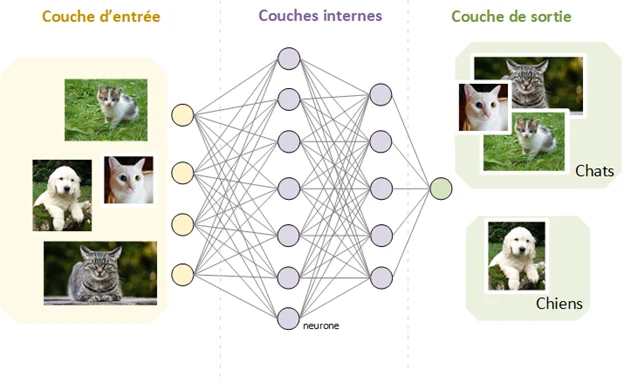 Esquema de una red neuronal: una capa de entrada recibe fotos de gatos y perros, las señales atraviesan varias capas internas de neuronas interconectadas y la capa de salida separa las imágenes en dos categorías, gatos y perros
Un gato en una foto, una frase que completar, un contrato que resumir: siempre el mismo principio. Pesos, no reglas.
La consecuencia es enorme, y te afecta directamente. Nadie, ni siquiera quienes construyeron el modelo, puede decirte con precisión por qué respondió esto y no aquello. No es un defecto de fabricación, es la naturaleza de la cosa. Con un gato, da igual. Con una denegación de crédito, un diagnóstico o un presupuesto, mucho menos. Por eso la manera de enmarcar la IA en la empresa no es un detalle de implementación.
2. Los parámetros
Esos pesos tienen otro nombre: los parámetros. Son los famosos «8B», «70B» o «405B» que aparecen junto a los nombres de los modelos.
Para dar una escala: reconocer un gato en una foto requiere unos 2,5 millones de parámetros. Comprender y escribir el lenguaje humano es otra historia, y los modelos más grandes superan hoy el billón (un millón de millones). A modo de comparación, el equivalente biológico del peso sería la sinapsis: una mosca tiene 50 millones, un ratón un billón y un ser humano 100 billones.
Lo que contienen esos pesos, nadie puede leerlo. Se pueden ver como dos cosas mezcladas: conocimiento y capacidad de razonamiento. La segunda cuenta más, y procede sobre todo de la forma en que se afina el modelo después de su aprendizaje inicial.
Por eso la carrera por el tamaño se ha calmado. En 2020, los 175.000 millones de parámetros de GPT-3 eran un récord. Hoy, un modelo de 8.000 millones lo supera en la mayoría de las tareas. Mejor entrenado, pero más pequeño.
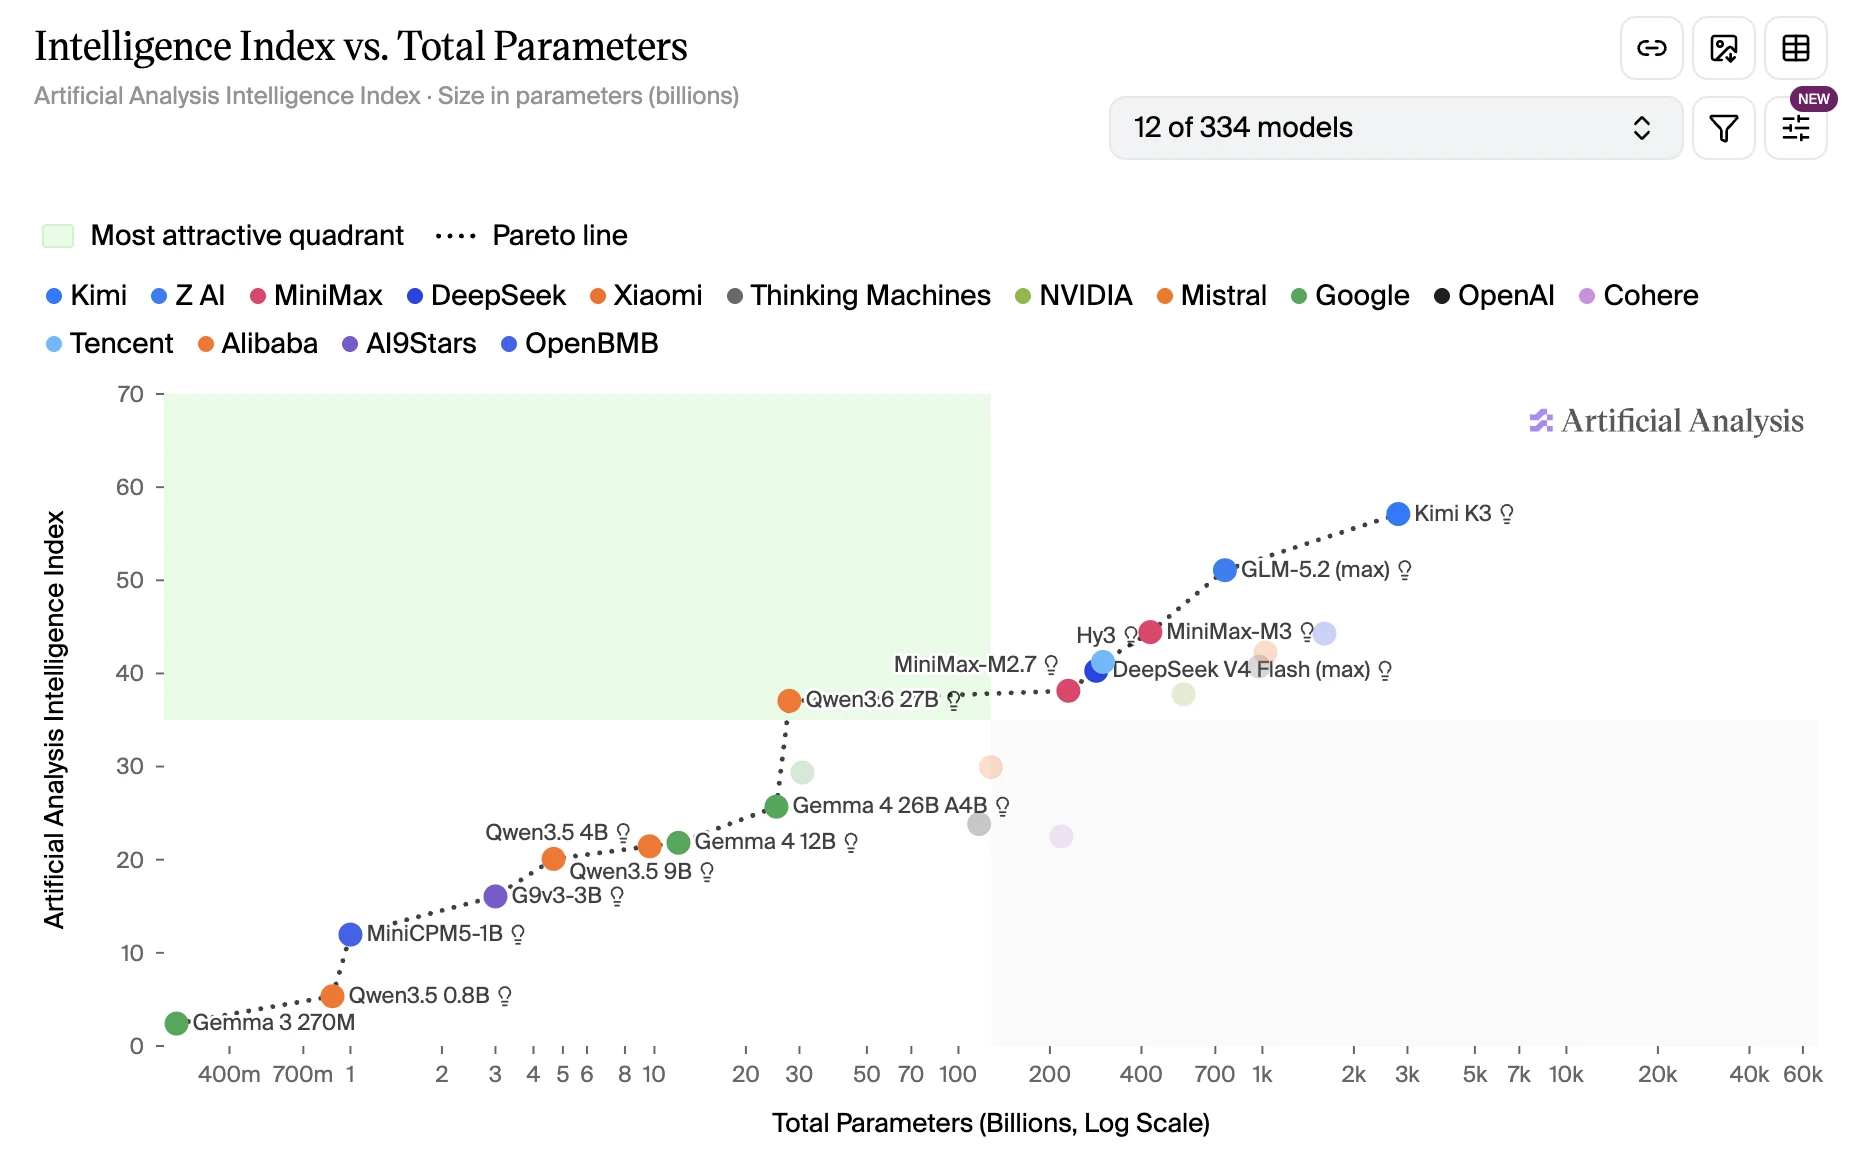 Nube de puntos que compara el nivel de los modelos abiertos con su número de parámetros, en escala logarítmica. La curva sube con fuerza hasta unos treinta mil millones de parámetros y luego se aplana: a partir de ahí, multiplicar el tamaño por cien solo aporta unos pocos puntos
Con un entrenamiento comparable, un modelo grande sigue siendo más capaz que uno pequeño. Pero fíjate en dónde se aplana la curva: pasadas unas decenas de miles de millones de parámetros, cada vez que se multiplica el tamaño por diez solo se ganan unos pocos puntos. El tamaño por sí solo ya no dice quién gana.
Por qué te afecta: más grande significa más caro, más lento y con más consumo de energía. Cuenta con 0,35 € por millón de tokens generados para un Mistral Small en Scaleway, frente a 50 $ para el modelo más caro de Anthropic. Más de cien veces de diferencia, cuando para resumir el acta de una reunión o detectar opiniones negativas el modelo pequeño hace el trabajo. Los más pequeños incluso funcionan en local, en un portátil o un móvil, sin que tus datos salgan del dispositivo.
3. El entrenamiento
Si nadie sabe qué contienen esos miles de millones de pesos, ¿cómo se han determinado? No se escribieron: se hicieron emerger mediante el entrenamiento.
Es una obra industrial que moviliza miles de millones de dólares en cálculo, energía y conocimiento experto. Se desarrolla en dos tiempos.
El preentrenamiento parte de parámetros aleatorios. Se le hace tragar al modelo un corpus enorme, todo Internet, los libros, y se le pide que prediga la palabra siguiente. «El médico examina al paciente con su…» da «estetoscopio». En cada predicción se mide el error y se corrigen los pesos. Miles de millones de veces. Poco a poco, el modelo construye representaciones internas de las estructuras del lenguaje.
El postentrenamiento afina después esa base: resultados verificables, imitación de un modelo más potente, arbitrajes humanos del tipo «¿prefiere la respuesta A o la respuesta B?». Al final se obtiene un modelo con pesos congelados.
Conviene retener esta palabra: congelados. Es la que desmonta la promesa comercial más extendida del mercado, la que se oye en casi todas las reuniones previas a un proyecto:
«Vamos a entrenar una IA con los datos de su empresa».
El modelo que utilizas no cambia cuando te sirves de él, y no aprende nada de tus documentos.
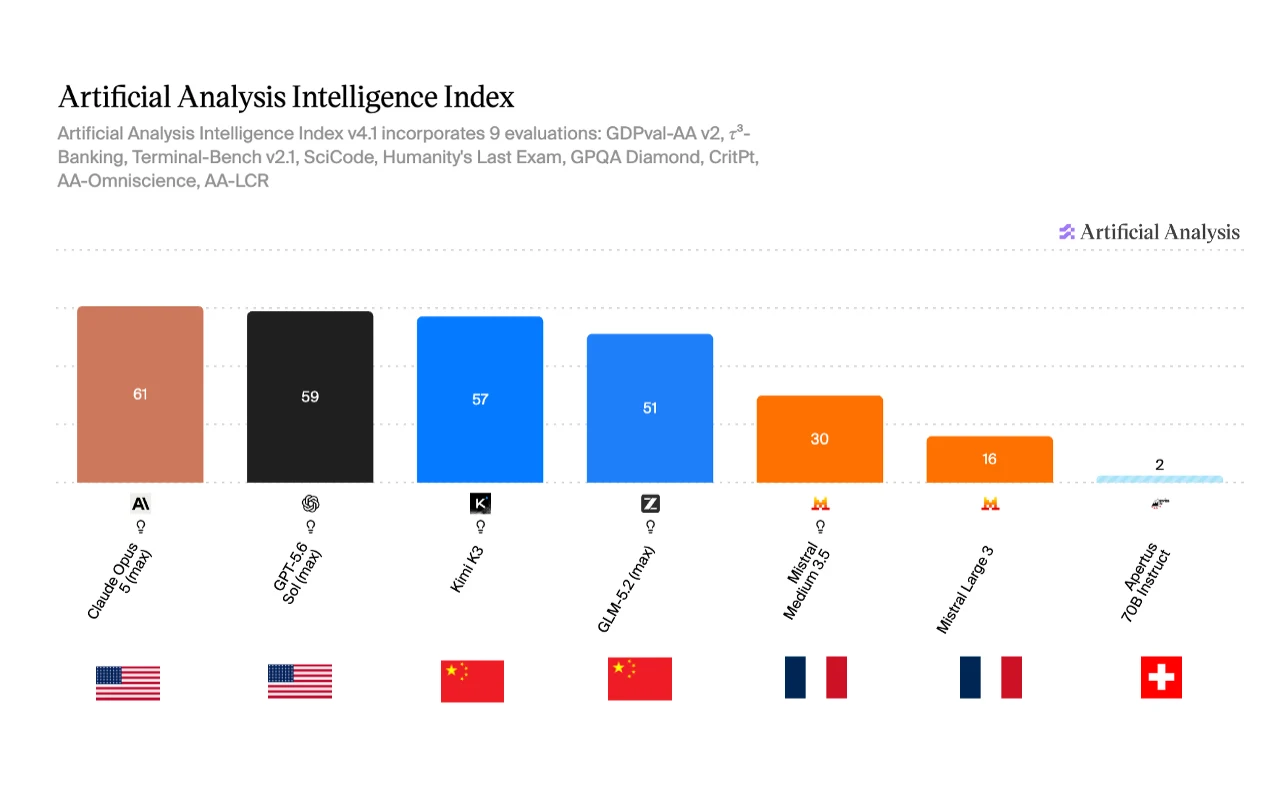 Clasificación de los modelos según un índice de nivel general, con la bandera del país de origen. Los dos primeros son estadounidenses, los dos siguientes chinos y muy próximos, los modelos franceses llegan claramente detrás y el modelo suizo cierra la lista
Dos países dominan hoy esta etapa, Estados Unidos y China, y Europa ha perdido esta batalla por ahora. Es menos grave de lo que parece: muchos modelos chinos y algunos estadounidenses son abiertos, es decir, se pueden descargar y ejecutar en tus propias instalaciones. Explicamos lo que «abierto» abarca realmente en nuestro artículo sobre open source y open weights. Puestos a elegir, perder la batalla de los modelos es menos grave que perder la de la inferencia, es decir, la del momento en que se utilizan.
Parte 2: lo que pagas de verdad
4. El token
Una red neuronal necesita entradas expresadas en un alfabeto cerrado, un número finito de valores que la máquina sabe manipular. Para que lea nuestro idioma, hay que trocear los textos. Pero ¿cómo?
¿Por caracteres? Es posible, pero una «c» aislada no significa nada y el modelo tardaría una eternidad en calcular el sentido de un párrafo. ¿Por palabras completas? Imposible: entre idiomas, conjugaciones, erratas, código y signos de puntuación, habría que almacenar decenas de millones de entradas.
El término medio que se encontró se llama token. Imagina una caja de Lego del idioma: en lugar de todas las palabras del mundo, un diccionario de 100.000 a 200.000 fragmentos. Una palabra muy común como el francés «bonjour» equivale a un solo token. Una palabra más larga se compone como un puzle: «développerait» (en francés, «desarrollaría») puede convertirse en [dé] + [velop] + [per] + [ait], donde el cuarto fragmento lleva por sí solo la información del condicional.
Este troceado es el trabajo del tokenizer, un traductor que convierte tu texto en una serie de códigos antes de enviarlo al modelo.
Por qué esta palabra aparece en todas tus facturas. Hay dos puntos que cuentan.
En primer lugar, la factura depende del idioma. Como los modelos se han entrenado mayoritariamente con textos en inglés, su diccionario favorece a ese idioma.
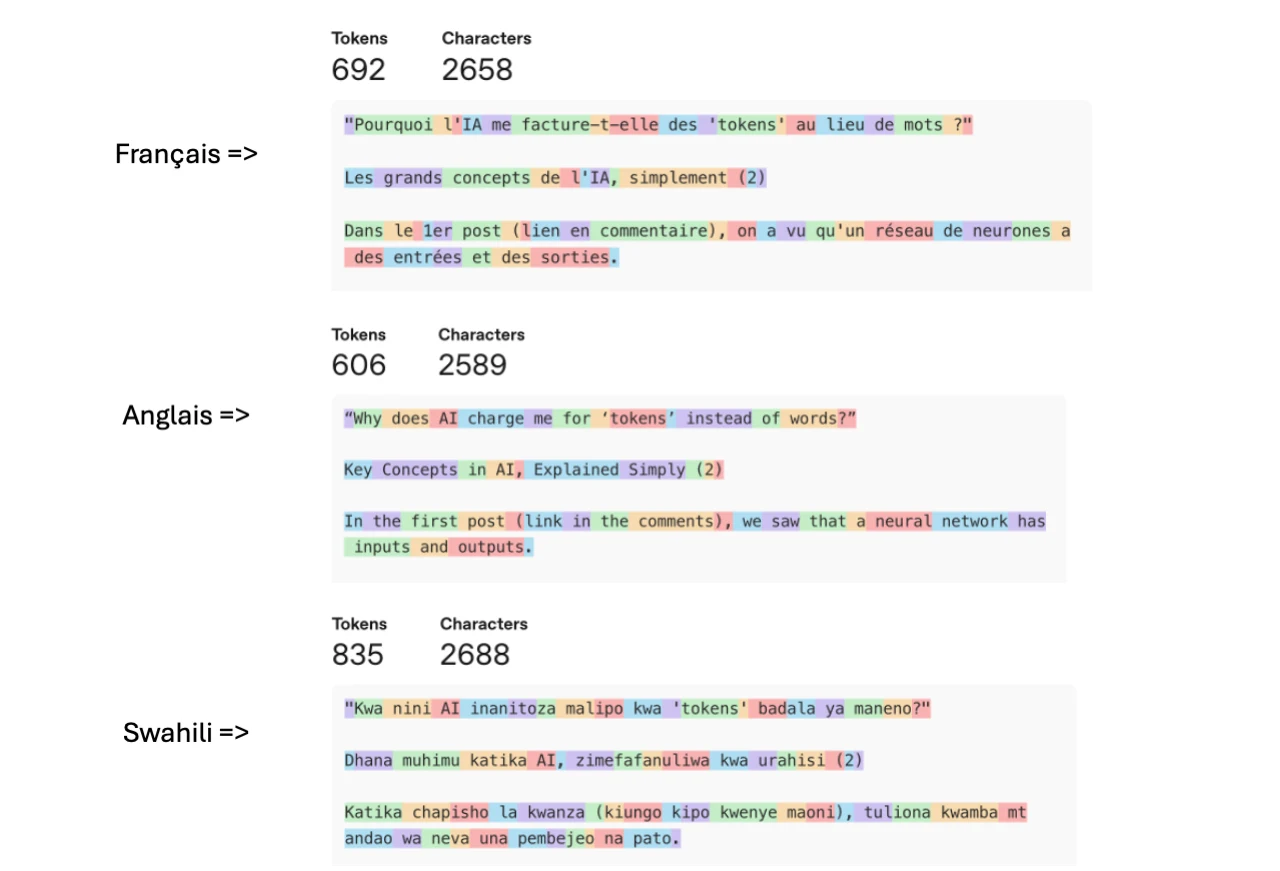 El mismo texto troceado en tokens en tres idiomas. En francés, 2.658 caracteres dan 692 tokens. En inglés, 2.589 caracteres solo dan 606. En suajili, 2.688 caracteres producen 835
El mismo texto, con una longitud en caracteres casi idéntica, cuesta un 14 % más en francés que en inglés, y cerca de un 40 % más en suajili. Se paga un impuesto sobre el idioma de trabajo, y no se negocia.
En segundo lugar, la entrada y la salida cuentan las dos. Pagas los tokens que envías, tu pregunta pero también las instrucciones, el historial y los documentos adjuntos, y los que genera el modelo. Un documento de diez páginas no es «un archivo», son unos 5.000 tokens de entrada que procesar, cada vez.
5. La inferencia
Entrenar un gran modelo le ha costado a alguien más de mil millones. Tú nunca pagarás ni un céntimo de eso. En cambio, pagarás cada respuesta.
Este cálculo bajo demanda se llama inferencia. A diferencia de un software clásico, que funciona con procesadores corrientes, la inferencia consume muchos recursos y exige chips especializados, las GPU. Es lo que permitió a Nvidia multiplicar su valor por diez en cinco años.
Cuanto más grande es el modelo, más pesada es la infraestructura. Un modelo muy pequeño cabe en un PC. Un modelo mediano requiere servidores de unas decenas de miles de euros, todavía asumibles internamente. Un modelo grande está fuera de alcance: hay que alquilar y, en la práctica, recurrir a un proveedor de inferencia que cobra por token.
Aquí es donde se concentran tus costes, y no donde crees. Elegir el modelo adecuado para cada tarea y no hacer calcular dos veces lo mismo. Estas dos decisiones pesan mucho más que el precio anunciado del millón de tokens.
Y aquí es también donde se juega la soberanía, porque aquel a quien envías tus datos los ve, y obedece a su gobierno. Ahora bien, en esta capa la diferencia no es solo política, es técnica.
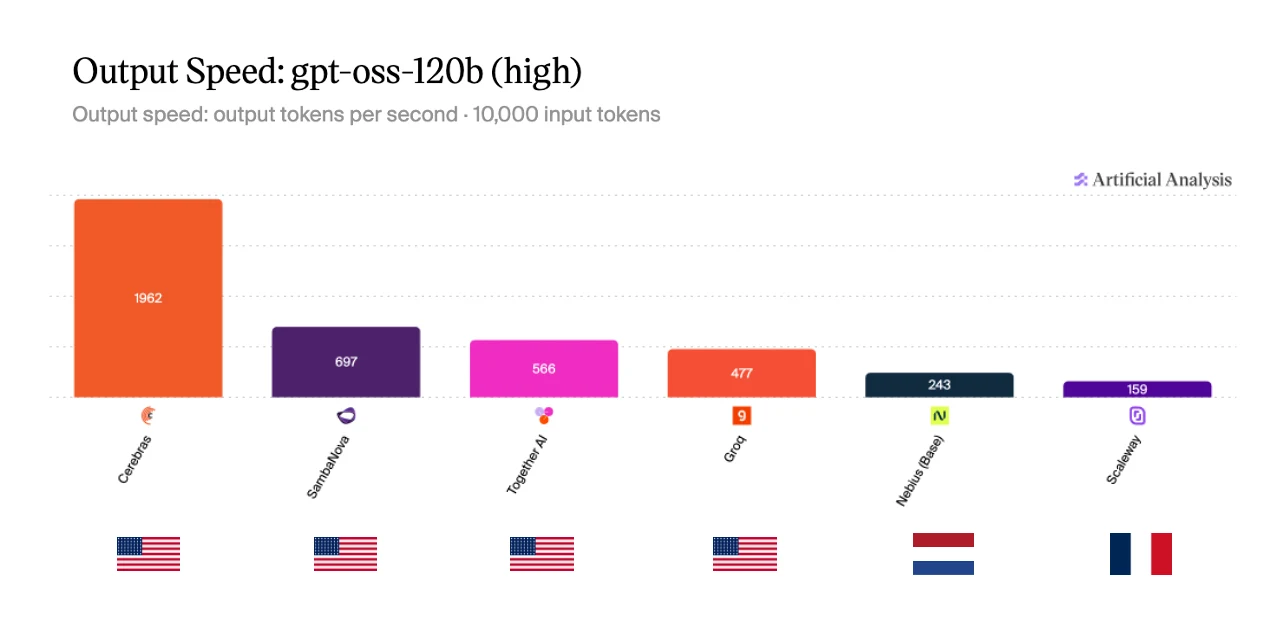 Velocidad de generación de un mismo modelo abierto según el proveedor que lo ejecuta, con la bandera del país. Los cuatro primeros son estadounidenses, y el más rápido supera los 1.900 tokens por segundo; los dos proveedores europeos cierran la lista, con 243 y 159 tokens por segundo
El modelo es el mismo en los seis casos. Solo cambia quién lo ejecuta, y la relación entre el proveedor estadounidense más rápido y el mejor europeo supera un factor de ocho. Es un dato que conviene conocer antes de prometer a los usuarios una IA soberana tan reactiva como la que usan en casa.
El tema merece algo más que un párrafo: hemos detallado las siete formas de ejecutar un modelo en la empresa y lo que cuestan realmente.
6. La ventana de contexto
La ventana de contexto es la memoria de trabajo del modelo: todo lo que puede leer de una sola vez, tus instrucciones, los documentos adjuntos, el historial de la conversación y tu pregunta. Se mide en tokens y oscila hoy entre 128.000 y 1.000.000.
Esta cifra, en fuerte aumento, ha dado lugar a un tipo de publicación que se ha vuelto habitual: «el RAG se acabó, ya se puede meter todo en la ventana de contexto».
Es falso, por tres razones.
- Cuanto más se llena la ventana, más se paga. Cada intercambio vuelve a leer todo lo anterior. Una sola petición puede costar varios euros.
- Cuanto más se llena, menos preciso es el modelo. Un dato perdido en mitad de 500 páginas se pasa por alto con mucha más frecuencia que al principio o al final del documento.
- Un millón de tokens no es gran cosa frente a los volúmenes documentales reales de una empresa.
Una ventana grande no es, por tanto, una invitación a volcarlo todo en ella. Precisamente para eso existe el RAG: más vale cinco buenos pasajes que dos mil páginas a granel.
Parte 3: lo que hace útil al modelo en tu empresa
7. Las herramientas
Un modelo está congelado y nunca ha visto ni uno solo de tus datos. Y sin embargo tu IA sabe comentar la actualidad de la mañana, responder sobre un contrato confidencial y analizar tu trimestre comercial. ¿Cómo?
Recuerda finales de 2022: el ChatGPT de los inicios era incapaz de darte el tiempo que hacía. En 2023 llega la búsqueda web, luego otras herramientas, y todo cambia.
En concreto, cuando se envía una petición a un modelo equipado con herramientas, este tiene dos opciones: responder directamente o activar una herramienta. La herramienta se ejecuta y le devuelve su resultado. El modelo lo lee y vuelve a elegir: responder o llamar a otras herramientas. Y así sucesivamente.
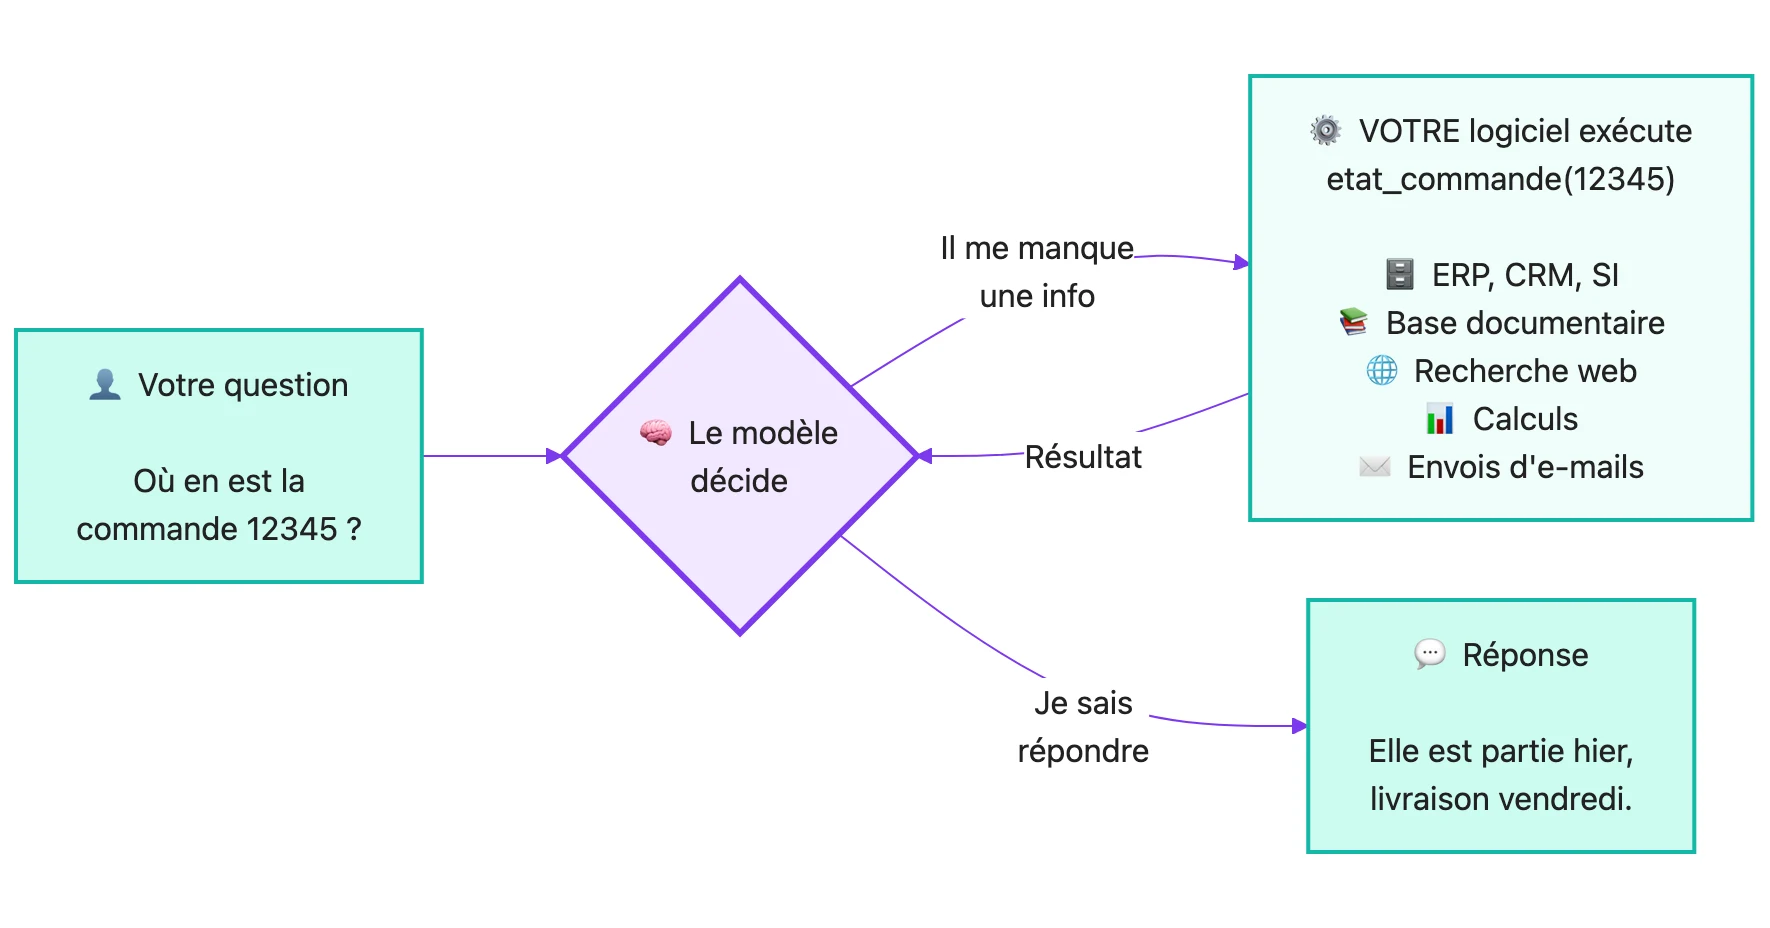 Esquema de una llamada a herramienta: la pregunta del usuario llega al modelo, que elige entre responder directamente o activar una herramienta ejecutada por el software de la empresa (ERP, CRM, base documental, búsqueda web, cálculos, envío de correos) antes de formular su respuesta
Los papeles están claros. El modelo decide, el software ejecuta. Esa ejecución pasa por software tradicional, lo que a veces se llama el arnés, y es ahí donde se gestionan los permisos de acceso, los registros y las validaciones.
La idea fuerte, la que cambia la forma de evaluar a un proveedor: se suman el software y la red neuronal. El modelo comprende, razona y orquesta. El software calcula, accede a los datos reales y actúa de forma fiable y trazable. En un proyecto de IA serio, el software cuenta hoy tanto como el modelo, y a menudo más.
Para estas herramientas conviven dos enfoques. Las herramientas propietarias, desarrolladas para un software concreto y que solo funcionan en él. Y las herramientas estándar, con MCP a la cabeza: se expone el sistema una vez y cualquier IA compatible se conecta a él.
La diferencia no es técnica, es contractual. Con los grandes editores, tus conectores y tus automatizaciones se quedan en casa del editor. El día que te vas, empiezas de cero.
8. El RAG
Un modelo no sabe nada de tus contratos, de tus procedimientos ni de tu historial de clientes. Hay que darle la información en el momento en que se hace la pregunta. Ese es el principio del RAG, por Retrieval-Augmented Generation.
En su forma clásica, cabe en cuatro pasos. Se seleccionan los documentos y se ponen en un formato utilizable. Se trocean en fragmentos, que se almacenan en una base adaptada a la búsqueda semántica, es decir, por proximidad de significado. Cuando un usuario hace una pregunta, el sistema encuentra los pasajes más útiles y los añade a la pregunta. El modelo responde a partir de esos elementos.
No se ha entrenado ni modificado nada del modelo. Tus documentos se consultan en el momento de la pregunta, nada más. Conviene retener esta frase: volverá a servir cuando lleguemos al fine-tuning.
Un ejemplo para captar el interés de la búsqueda semántica: si preguntas «¿cuántos días de teletrabajo?», una búsqueda por palabras clave puede pasar por alto un pasaje titulado «trabajo a distancia». La búsqueda por significado entiende que ambos hablan probablemente de lo mismo. Pero las palabras clave siguen siendo imprescindibles, porque una referencia de producto como XR-4471B tiene que encontrarse carácter a carácter. Ese es todo el objeto de la búsqueda híbrida.
La palabra RAG da la impresión de una receta sencilla. En producción se ha convertido en un sistema completo: conectores, preparación de documentos, permisos de acceso, elección del método de búsqueda, citas, evaluación, supervisión. Hemos escrito una guía completa del RAG en la empresa para quien quiera entrar en detalle.
9. La IA agéntica
Una IA que sabe llamar a una herramienta todavía no es un agente. La IA agéntica es el paso siguiente: cuando el modelo descompone un objetivo en varias etapas, las orquesta y se corrige para alcanzar su meta.
La diferencia se nota con el uso. Con una IA clásica, se pide «analiza este archivo y dame los tres productos menos rentables», la IA llama a la herramienta que lee el archivo y responde. Con una IA agéntica, se pide «prepara la revisión comercial de la semana», y la IA recupera las cifras del CRM, las compara con la semana anterior, detecta las desviaciones inusuales, busca las explicaciones en las actas, redacta una síntesis, pide una validación humana y la envía.
Un agente no es, por tanto, un nuevo tipo de modelo. Es un modelo situado en el centro de un sistema que le proporciona herramientas, una memoria de trabajo, reglas, permisos, a veces un presupuesto, y un objetivo. Detallamos los casos de uso, los costes y el retorno de la inversión de un agente de IA en la empresa en un artículo específico.
El límite que conviene conocer antes de firmar. Un modelo sigue siendo probabilístico, y por tanto menos fiable que un software sencillo. Tomemos un agente que encadena diez etapas, cada una de las cuales sale bien en el 95 % de los casos. La probabilidad de que las diez salgan bien es 0,95 elevado a 10, es decir, alrededor del 60 %.
El cálculo es deliberadamente simplista, pero la idea es esencial: cuantas más acciones se encadenan, más hay que verificar los resultados intermedios. Una buena automatización solo usa la IA donde es necesaria, un principio que desarrollamos en nuestro artículo sobre la automatización con IA mínima.
Y como es muy difícil distinguir desde fuera un buen agente de uno malo, si se externalizan estos desarrollos, lo sensato es pedir un precio cerrado y un compromiso de resultado.
Parte 4: las dos confusiones que salen caras
10. El fine-tuning
Ya hemos llegado. El fine-tuning consiste en tomar un modelo ya entrenado y retocar ligeramente sus pesos con unos miles de ejemplos propios. Es una pequeña continuación del entrenamiento, no un entrenamiento.
Y es el concepto más sobrevendido del mercado, el que algunos proveedores presentan prometiendo «entrenar una IA con los datos de su empresa».
Lo que hay que retener cabe en una frase.
El fine-tuning cambia el comportamiento, no los conocimientos.
¿Quieres que el modelo responda siempre en un formato preciso, adopte el tono de tu casa o maneje la jerga de tu sector? Fine-tuning. ¿Quieres mejorar su tasa de acierto en una tarea bien delimitada, una clasificación o la generación de código? Fine-tuning.
¿Quieres que conozca tus 40.000 documentos? RAG. No fine-tuning.
Un último punto que no hay que olvidar: el fine-tuning hay que rehacerlo cada vez que se cambia de modelo. Es decir, a menudo.
11. La alucinación
Una alucinación de la IA es una respuesta falsa producida con la seguridad de una respuesta verdadera. Una jurisprudencia que no existe, una cláusula inventada en un contrato, una cifra verosímil pero falsa.
El error habitual consiste en tratarla como un fallo que algún editor acabará corrigiendo. No lo es. Volvamos al concepto número 1: un modelo no aplica reglas, produce la continuación más probable a partir de pesos ajustados a base de ejemplos. Cuando no dispone de la información, nada en su funcionamiento lo lleva a decir «no lo sé» en lugar de producir algo verosímil. La alucinación es estructural, no accidental.
Lo cual quiere decir que no se elimina. Se reduce y se hace detectable, con medios que son todos decisiones de arquitectura, no ajustes del modelo: proporcionar los documentos adecuados en el momento justo en lugar de confiar en la memoria del modelo, exigir citas verificables en cada respuesta, hacer que un software determinista compruebe los resultados intermedios y medir de forma continua.
Cuando un editor te anuncia una IA «sin alucinaciones», te está vendiendo o un abuso del lenguaje, o un desconocimiento de su propio producto. La buena pregunta no es «¿alucina?», sino «¿cómo lo veo cuando ocurre?».
Lo que decide la supervivencia del proyecto: los LLMOps
El concepto menos vendedor de la lista, y con diferencia el más decisivo. Los LLMOps agrupan todo lo que hace falta alrededor del modelo para que un proyecto aguante en producción.
El software clásico se sabe hacer desde hace cuarenta años. Con un agente, ya nada funciona igual.
Las pruebas ya no son binarias. La misma pregunta dos veces, dos respuestas distintas. Y los usuarios no siguen diez recorridos marcados, formulan su petición como quieren. El «hago clic aquí y pasa esto» ya no basta: hace falta un conjunto de preguntas con las respuestas esperadas, validado por los expertos de negocio.
No comprarás la infraestructura. Una H100 alquilada de forma continua cuesta cerca de 2.000 € al mes por una sola tarjeta. Dependerás, por tanto, de proveedores externos.
Y esos proveedores se caen. Sus páginas de estado muestran entre un 99 y un 99,5 % de disponibilidad, es decir, hasta varios días de interrupción al año. O se paga muy caro un compromiso contractual, o se conectan varios y se cambia en cuanto uno falla. Esa es toda la cuestión de un SLA para un servicio de IA.
La factura se cuenta en tokens y se dispara rápido, con un agente que da quince vueltas releyendo todo su historial en cada una. Lo que conviene vigilar es el coste por petición útil, no el precio del millón de tokens.
Los modelos cambian todo el tiempo. El proveedor saca uno mejor, retira el anterior con unos meses de preaviso, y el prompt ajustado al milímetro ya no da el mismo resultado. Hay que poder probar, cambiar y volver atrás sin reescribir la aplicación.
El comportamiento se supervisa cada semana: registrar las preguntas, las herramientas llamadas, las fuentes utilizadas. Si no, cuando un usuario dice «me ha contado cualquier cosa», se debate sobre una percepción y no se mejora nada.
El POC sale bien casi siempre. Precisamente ese es el problema.
Preguntas frecuentes
¿Qué es un LLM?
Un LLM, por large language model o gran modelo de lenguaje, es una red neuronal entrenada para predecir la continuación de un texto. Está formado por miles de millones de pesos numéricos, llamados parámetros, que se han ajustado automáticamente con inmensos corpus de textos en lugar de ser programados por personas. Una vez terminado ese entrenamiento, los pesos quedan congelados: el modelo ya no cambia y no aprende nada de las preguntas que se le hacen. Eso es lo que lo distingue radicalmente de un software clásico, en el que cada regla se ha escrito de forma explícita y puede releerse.
¿Cómo funciona una IA generativa?
Una IA generativa produce texto prediciendo, fragmento a fragmento, la continuación más probable de lo anterior. Primero, tu pregunta se trocea en tokens, esos fragmentos de palabras que el modelo sabe manipular. Esos tokens atraviesan después los miles de millones de pesos de la red, que calculan el fragmento siguiente más verosímil, luego el siguiente, hasta el final de la respuesta. No se consulta ninguna base de conocimientos ni se aplica ninguna regla de negocio: solo un cálculo de probabilidad sobre pesos congelados. Por eso la misma pregunta puede dar dos respuestas distintas.
¿Puede una IA aprender a partir de los documentos de mi empresa?
No, al menos no en el sentido en que se suele entender. Los pesos de un modelo quedan congelados después de su entrenamiento y no se modifican cuando se utiliza. Para que una IA responda sobre tus documentos, no se modifica el modelo: se le proporcionan los extractos adecuados en el momento de la pregunta, una técnica llamada RAG. Los documentos se consultan bajo demanda y luego se olvidan. La fórmula «entrenar una IA con sus datos», habitual en las propuestas comerciales, describe mal lo que ocurre en realidad y merece aclararse antes de firmar.
¿Qué es un token en IA?
Un token es la unidad de texto que un modelo de IA manipula realmente: una palabra corta o un fragmento de una palabra más larga. Los modelos disponen de un diccionario de 100.000 a 200.000 fragmentos, y el texto se trocea según ese diccionario antes de procesarse. Es la unidad de facturación de casi todos los servicios de IA, y se cuenta por separado lo que se envía y lo que genera el modelo. Un texto en francés consume alrededor de un 14 % más de tokens que el mismo texto en inglés, porque los diccionarios se han construido mayoritariamente a partir del inglés.
¿Por qué la IA cuesta más en francés que en inglés?
Porque los diccionarios de tokens de los grandes modelos se construyeron mayoritariamente a partir de textos en inglés. Las palabras inglesas comunes ocupan en ellos un solo token, mientras que sus equivalentes franceses a menudo tienen que reconstruirse a partir de varios fragmentos. Con una longitud de texto comparable, el francés consume alrededor de un 14 % más de tokens que el inglés, y algunos idiomas poco representados superan el 40 %. Como la facturación se hace por token, esta diferencia se traslada directamente a la factura, sin que ninguna negociación comercial pueda eliminarla.
¿Qué significan 8B, 70B o 405B en el nombre de un modelo de IA?
Estas menciones indican el número de parámetros del modelo, expresado en miles de millones (billions en inglés): 8B significa ocho mil millones de pesos numéricos. Esta cifra da un orden de magnitud del tamaño del modelo y, por tanto, de su coste de ejecución, de su velocidad y de la potencia de hardware necesaria. No mide directamente la calidad: desde 2023, un modelo de 8.000 millones de parámetros bien entrenado supera a GPT-3 y sus 175.000 millones en la mayoría de las tareas. Por encima de unas decenas de miles de millones, cada vez que se multiplica el tamaño por diez solo se ganan unos pocos puntos de rendimiento.
¿Qué es la ventana de contexto de un modelo de IA?
La ventana de contexto es la cantidad de texto que un modelo puede leer de una sola vez: tus instrucciones, los documentos adjuntos, el historial de la conversación y tu pregunta. Se mide en tokens y va hoy de 128.000 a cerca de un millón según los modelos. Dos límites la hacen menos útil de lo que parece: cuanto más se llena, más caro resulta cada intercambio, puesto que todo el contenido se relee en cada turno, y más baja la precisión, ya que un dato perdido en mitad de cientos de páginas se ignora con frecuencia.
¿Qué diferencia hay entre el fine-tuning y el RAG?
El fine-tuning retoca los pesos del modelo con tus ejemplos y modifica su comportamiento: formato de respuesta, tono, jerga del sector, tasa de acierto en una tarea concreta. El RAG no toca el modelo: encuentra los pasajes útiles de tus documentos y se los proporciona en el momento de la pregunta. Para que una IA conozca tus documentos internos, se usa RAG. Para que responda siempre de una determinada manera, fine-tuning. La confusión entre ambos está en el origen de la promesa comercial «entrenar una IA con sus datos», que no describe correctamente ni lo uno ni lo otro.
¿Por qué alucina una IA?
Porque un modelo de lenguaje no consulta una base de hechos: produce la continuación más probable a partir de pesos ajustados estadísticamente con ejemplos. Cuando le falta la información, nada en su funcionamiento lo empuja a responder «no lo sé» en lugar de generar un contenido verosímil. La alucinación es, por tanto, estructural y no se suprime con un parche. Se reduce y se detecta: proporcionando los documentos adecuados en el momento de la pregunta, exigiendo citas verificables y haciendo que un software determinista controle los resultados intermedios.
¿Hay que elegir el modelo más potente para un proyecto de IA en la empresa?
No, y a menudo es un error caro. La diferencia de precio entre un modelo pequeño y uno muy grande supera el factor cien por millón de tokens generados, cuando muchas tareas de empresa, como resumir actas o clasificar mensajes, las resuelve correctamente un modelo pequeño. Desde 2023, el tamaño por sí solo ya no determina la calidad: un modelo de 8.000 millones de parámetros bien entrenado supera a GPT-3 y sus 175.000 millones en la mayoría de las tareas. La buena práctica consiste en asignar el modelo adecuado a cada tarea en lugar de elegir uno solo para todo.
¿Qué son los LLMOps?
Los LLMOps designan el conjunto de prácticas necesarias para mantener en producción un sistema basado en un modelo de lenguaje: crear un conjunto de preguntas con las respuestas esperadas para probar la calidad, registrar las preguntas formuladas, las herramientas llamadas y las fuentes utilizadas, controlar el coste por petición útil y poder cambiar de modelo o de proveedor sin reescribir la aplicación. Esta disciplina se diferencia del DevOps clásico porque un modelo no es determinista, porque los proveedores retiran sus modelos con regularidad y porque la calidad se degrada en silencio en lugar de provocar una avería visible.
¿Se puede garantizar que una IA no alucine nunca?
No. La alucinación se deriva del propio funcionamiento de los modelos de lenguaje, que producen una continuación probable en lugar de un hecho verificado, y ningún editor puede eliminarla por completo. Lo que se controla es su frecuencia y su detectabilidad: proporcionar los documentos pertinentes en el momento de la pregunta, exigir citas verificables en cada respuesta, hacer que un software determinista controle los resultados intermedios y medir la calidad de forma continua. Una promesa comercial de IA «sin alucinaciones» revela un desconocimiento del producto o un abuso del lenguaje.
¿Cuántas etapas puede encadenar un agente de IA de forma fiable?
El número de etapas está limitado por la composición de las tasas de acierto. Si cada etapa sale bien en el 95 % de los casos, diez etapas encadenadas solo salen bien juntas en alrededor del 60 % de los casos, puesto que 0,95 elevado a 10 da 0,60. Este cálculo simplifica, pero explica por qué los agentes fiables no son los que encadenan más acciones: son los que verifican sus resultados intermedios y solo emplean el modelo donde un software determinista no bastaría.
¿Cuánto cuesta un proyecto de IA una vez terminado el POC?
El POC representa en general alrededor del 20 % del coste total del proyecto a lo largo de su vida. El 80 % restante se reparte entre la inferencia facturada por token, el mantenimiento del sistema que rodea al modelo, los cambios de modelo impuestos por los proveedores, la evaluación continua de la calidad de las respuestas y la supervisión del comportamiento del agente. Un presupuesto que solo cubre la fase de demostración no es un presupuesto de proyecto, y esa es la principal causa de abandono de los proyectos internos de IA al cabo de dieciocho meses.
Conclusión
Diez conceptos y, en el fondo, una sola idea: no hay nada mágico en todo esto.
Pesos ajustados a base de ejemplos. Texto troceado en tokens. Herramientas conectadas alrededor. Tus documentos colocados en el momento justo sobre la mesa. Y mucho trabajo de ingeniería para que todo aguante en producción.
Lo que te dan estas nociones no es una competencia técnica. Es la capacidad de plantear las tres o cuatro preguntas que separan a un proveedor que sabe de uno que recita.
Si estás preparando un proyecto y quieres contrastar tu caso de uso con estas decisiones: reservar una demo.