Inferencia de IA: 7 formas de ejecutar modelos en la empresa
Inferencia de IA en la empresa: 7 enfoques comparados, de la compra de GPU al proveedor llave en mano. Costes reales, soberanía, latencia y criterios.

«Compramos GPU y lo alojamos todo nosotros». «No, conectamos una API y seguimos adelante».
Esta discusión es un gran clásico de las filosofías que chocan sobre la inferencia de IA en la empresa. Surge pronto en un proyecto de IA, por lo general en el momento de presupuestarlo. De un lado, quienes quieren la IA en casa: se compran las tarjetas, se instalan los modelos y nada sale de la empresa. Del otro, quienes quieren consumir un servicio: una clave de API o una suscripción, se paga por uso y no hay hardware que gestionar.
Los dos bandos tienen buenos argumentos. El problema es que debaten sobre dos opciones de siete.
Lo que se disputan tiene un nombre: la inferencia.
¿Qué es exactamente la inferencia en IA?
La inferencia es el momento en que un modelo de IA responde a una pregunta. No su aprendizaje, que ya tuvo lugar y que le costó millones a otro: simplemente el hecho de enviarle una petición y obtener un texto como respuesta.
La inferencia se repite todos los días. Es proporcional a tu uso, durante todo el tiempo que funcione tu servicio. Es ella la que determina la velocidad, la factura y el nivel de confidencialidad de tu proyecto.
Un token es una pequeña unidad de texto, una palabra o un trozo de palabra. Los proveedores facturan por millón de tokens, contando por separado la entrada y la salida.
Los tokens de entrada son todo lo que se envía al modelo: la pregunta del usuario, pero también las instrucciones, el historial de la conversación, los extractos de documentos y la descripción de las herramientas disponibles. Los tokens de salida son lo que el modelo genera como respuesta. A igual volumen, la salida suele costar de tres a cinco veces más, porque cada token producido exige un paso completo por el modelo, mientras que la entrada se procesa de una vez.
La proporción entre ambos depende mucho de tu caso de uso, y es la que da forma a tu factura. Un asistente generalista envía poco y recibe mucho: pregunta corta, respuesta desarrollada. Una IA agéntica hace lo contrario. En cada paso, el agente reenvía todo el contexto acumulado, los resultados de sus llamadas a herramientas y el historial de sus intentos, para producir a veces tres líneas de decisión. La entrada crece en cada vuelta del bucle. Por eso los proveedores ofrecen tarifas reducidas para la parte del contexto que se reutiliza de una llamada a otra.
Queda la velocidad, medida en tokens por segundo. Para un chat sencillo o un autocompletado, 100 tokens/s dan una respuesta que parece fluida. Para lo agéntico, donde el modelo encadena varias llamadas antes de mostrar nada, conviene apuntar más bien a 500 tokens/s. Detallamos estos umbrales en nuestro artículo sobre el LLM en local.
Si solo hay que quedarse con una idea
El mundo no es binario. Entre «comprarlo todo» y «consumirlo todo», el mercado ofrece un abanico de soluciones válidas, todas con buenas razones para existir, y la mayoría de las empresas que funcionan en producción combinan varias. La buena elección depende de tu contexto, no de una postura de principio.
Hay dos formas razonables de abordar el tema. La primera: no complicarse, contratar una solución con un proveedor y concentrar la vigilancia en un solo punto, su métrica de facturación. Una oferta facturada por mensaje, por usuario o con tarifa plana sigue siendo previsible. Una oferta facturada por token, mucho menos.
La segunda: dedicarle unos días, porque la diferencia de coste entre los siete enfoques se cuenta en órdenes de magnitud y no en porcentajes.
En ambos casos, lo que se busca evitar se llama bill shock, el susto de la factura, y ocurre con regularidad. En junio de 2025, Cursor pasa sus suscripciones individuales a una facturación por uso sin que sus usuarios entiendan que el «ilimitado» anunciado solo cubría un modelo; la empresa publicó sus disculpas el 4 de julio y reembolsó tres semanas de excesos. En el repositorio de Gemini CLI, desarrolladores convencidos de no superar un límite de 1.000 peticiones al día descubrieron facturas de 2.000, 6.400 y a veces 10.000 dólares: su clave de API facturaba por token, y los bucles de razonamiento del modelo consumían cientos de millones.
La misma raíz en los dos casos. El usuario razonaba en peticiones, el proveedor facturaba en tokens.
Cuatro cosas se juegan en la capa de inferencia
Tus usuarios comparan con ChatGPT
Llegan con una referencia en mente, y esa referencia se llama ChatGPT, Gemini o Mistral. Se han acostumbrado a un texto que aparece al instante. Si tu asistente interno tarda quince segundos en empezar a responder, nadie dirá que la infraestructura está infradimensionada. Se dirá que tu herramienta no funciona, y se volverá a la de antes.
Muchas soluciones B2B funcionan así hoy en día. El producto hace lo que promete, la demo sale bien y nadie lo abre una segunda vez.
Esta latencia se juega casi por completo en la capa de inferencia, y es con diferencia el primer motivo de abandono que observamos en los asistentes internos. Un proyecto técnicamente correcto puede morir perfectamente por quince segundos de más.
Nadie llega solo al 99,9 %
Los grandes proveedores de IA rondan el 99 a 99,5 % de disponibilidad, es decir, varios días de indisponibilidad acumulada al año. Tus usuarios, en cambio, están acostumbrados a los cuatro nueves en sus herramientas ofimáticas. La diferencia se nota.
Hemos publicado las cifras reales por proveedor en SLA de IA para empresas. El defecto de diseño más frecuente que encontramos no ha cambiado en dos años: un solo proveedor, ninguna alternativa de respaldo.
Envías tus documentos a alguien
Hacer inferencia es transmitir a un tercero la pregunta de tu usuario y los extractos de documentos que sirven para responderla. Contratos, notas internas, datos de clientes. Más vale saber a quién, bajo qué derecho, con qué política de retención y con qué compromiso de no entrenamiento.
Aquí no hay una respuesta buena universal, solo un cursor que situar. Hemos documentado el nuestro en la página IA soberana.
El modelo que encabeza la clasificación cuesta caro para nada
Casi nunca es el que se necesita. Para clasificar un ticket, extraer un campo o reformular una respuesta a partir de documentos proporcionados, un modelo más pequeño y más rápido hace el trabajo.
Sobre todo, la diferencia de precio no guarda ninguna relación con la diferencia de capacidad. Estas son cuatro ofertas del mercado, situadas según su coste medio por millón de tokens y su índice de inteligencia:
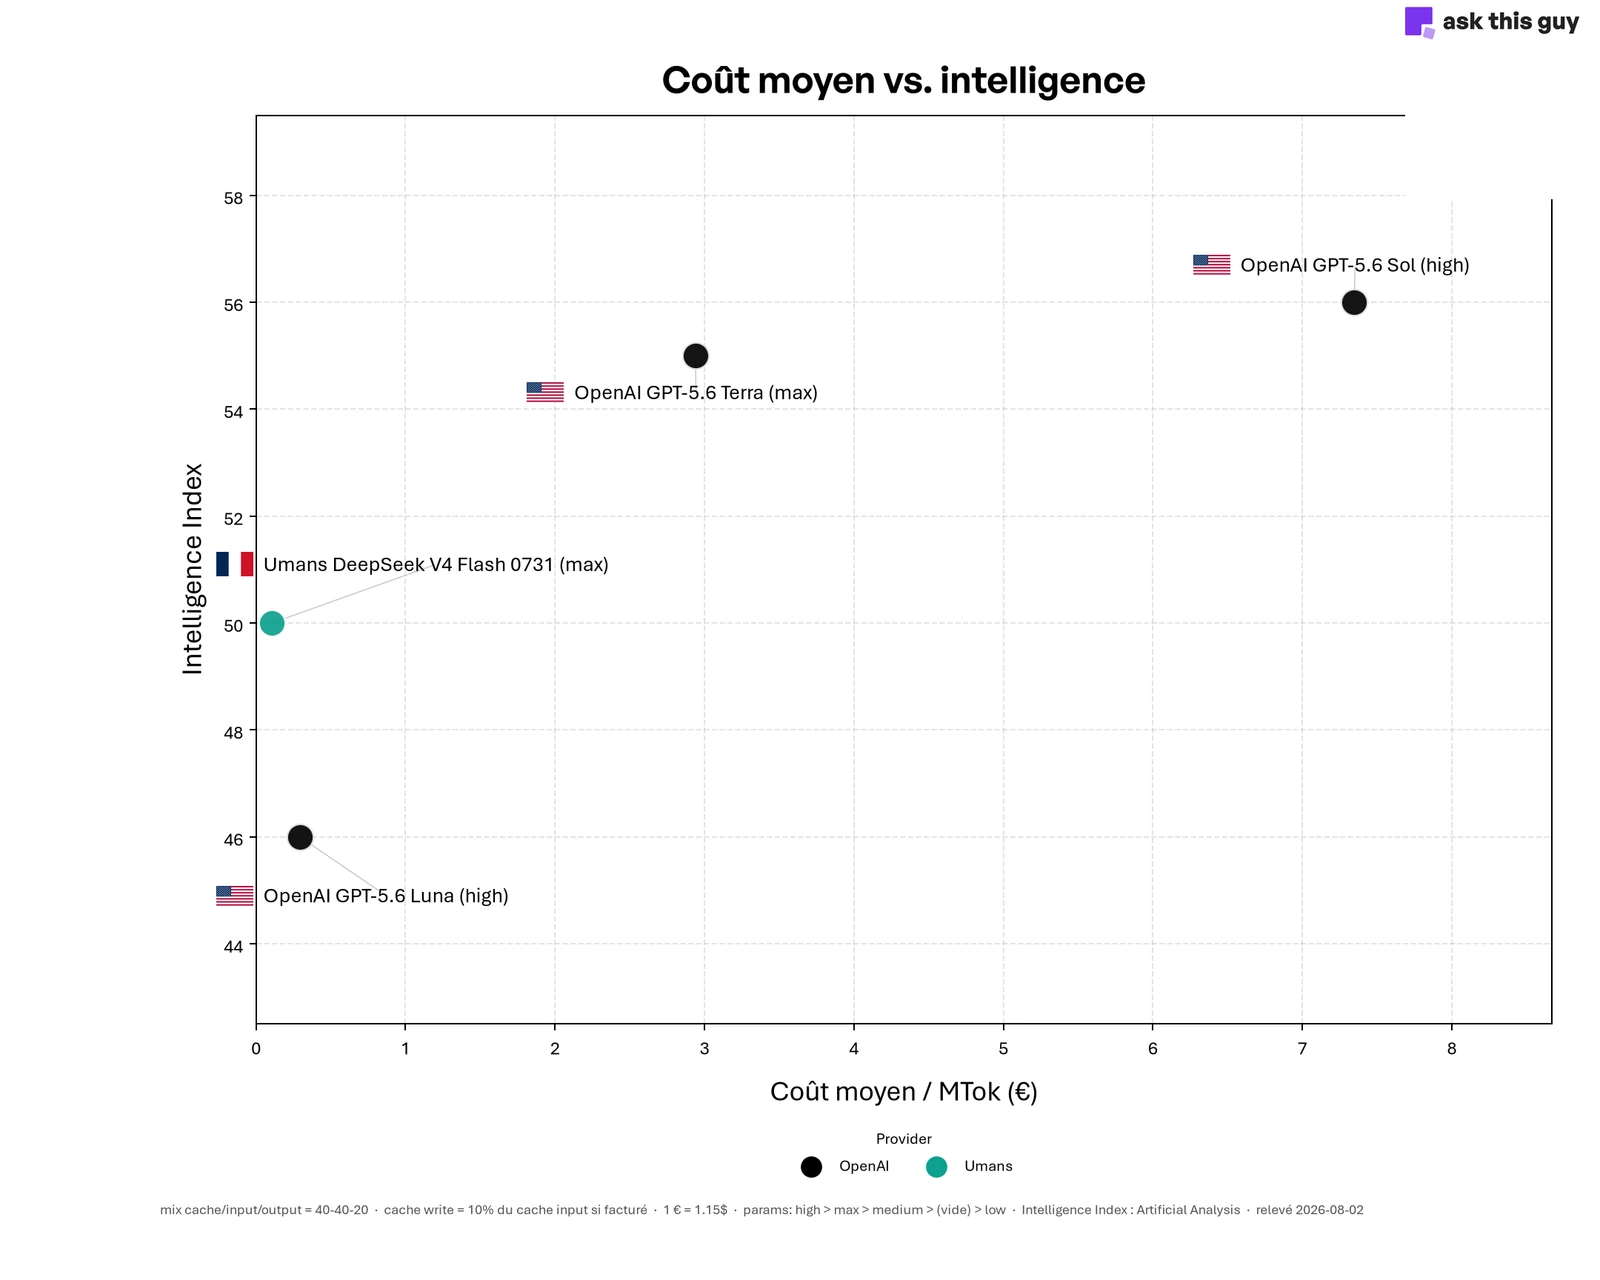 Nube de puntos que compara el coste por millón de tokens y el índice de inteligencia de cuatro ofertas. DeepSeek V4 Flash servido por la francesa Umans alcanza un índice de 50 por 0,11 € el MTok, mientras que GPT-5.6 Sol de OpenAI alcanza 56 por 7,35 €, y GPT-5.6 Luna 46 por 0,29 €.
GPT-5.6 Sol cuesta 7,35 € el MTok con un índice «de inteligencia» de 56. DeepSeek V4 Flash servido por Umans cuesta 0,11 € con un índice de 50. Seis puntos de diferencia, un factor 69 en la factura.
Después está GPT-5.6 Luna, en la parte baja de la nube: casi tres veces el precio de la oferta de Umans, con un índice cuatro puntos inferior. Pagar más ni siquiera garantiza obtener algo mejor. La clasificación dice lo que un modelo sabe hacer, nunca lo que va a costar.
Un último punto, y es el que más repetimos: un benchmark clasifica los modelos en tareas genéricas, nunca en la tuya. Un índice de inteligencia no dice nada de cómo se comporta un modelo con tu jerga profesional, tus documentos, tu idioma o el formato de salida que se espera. Merece la pena dedicar dos días a ejecutar tres o cuatro candidatos sobre una muestra representativa de tus casos reales y comparar lo que sale. Es la única clasificación que cuenta para ti, y altera con frecuencia el orden oficial.
Índice de inteligencia: Artificial Analysis, datos de agosto de 2026. Coste medio calculado con una mezcla de un 40 % de entrada en caché, un 40 % de entrada nueva y un 20 % de salida, a razón de 1 € = 1,15 $. Las menciones max y high designan el nivel de esfuerzo de razonamiento del modelo.
Los siete enfoques
1. Comprar tus GPU y explotarlas tú mismo
Compras las tarjetas, las instalas, despliegas los modelos y mantienes el conjunto. Control máximo: tus datos nunca salen, tú lo eliges todo y nadie cambia tus condiciones de un día para otro.
También CAPEX máximo. Para un modelo realmente rápido y capaz, hay que contar con seis cifras, más las competencias que habrá que contratar para operar la máquina. Tu infraestructura de IA se convierte en un proyecto en sí mismo, con su presupuesto y su equipo. Hemos hecho el cálculo detallado en RAG on premise: ¿qué se puede hacer con 60.000 €?.
Es una opción para las restricciones regulatorias absolutas, los volúmenes masivos y estables y las empresas que ya tienen un equipo de infraestructura. O para las que cuentan con revender su capacidad cuando está inactiva, algo sobre lo que volvemos en el enfoque 4.
2. Alquilar GPU dedicadas a un proveedor cloud
La misma arquitectura, el mismo trabajo de despliegue, pero el hardware ya no es tuyo. El CAPEX se convierte en OPEX previsible, electricidad y refrigeración incluidas, y las averías de hardware son cosa de tu proveedor.
Conviene desconfiar del precio por hora que se anuncia. Un servicio disponible de forma continua funciona 730 horas al mes, así que ese precio por hora es en realidad un alquiler mensual. Una H100 en Scaleway cuesta 2,73 € la hora, lo que suena muy bien en una reunión, y supone casi 2.000 € al mes, 24.000 € al año, por una sola tarjeta. En Verda, operador finlandés cuyos centros de datos están en Finlandia e Islandia, la H100 SXM5 cuesta 3,25 $ la hora, con un 8 % de descuento a un año y un 25 % a dos años.
El reflejo siguiente es comparar con la compra. Una H100 PCIe se negocia entre 25.000 y 33.000 $ en el mercado, una H100 SXM5 entre 35.000 y 40.000 $. Alquilar una tarjeta de forma continua cuesta, por tanto, su precio de compra en doce a diecisiete meses según el modelo y el proveedor. Y una tarjeta rara vez basta: un servidor con ocho H100, dimensionado para servir correctamente un modelo grande, ronda los 19.000 $ al mes, es decir, 228.000 $ al año, cuando la máquina equivalente se compra por más de 350.000 $. Dieciocho meses de retorno de la inversión.
Sobre el papel, es excelente. Salvo que la comparación enfrenta una tarjeta a un servicio. El precio de compra no incluye ni el centro de datos, ni la electricidad, ni la refrigeración, ni la red, ni los equipos que explotan el conjunto. Y el activo se deprecia rápido: una H100 de segunda mano se revende al 60 o 70 % del precio nuevo mientras llegan las B200 y B300 y tiran a la baja de los precios de alquiler. Se amortiza en tres años un hardware cuyo alquiler equivalente habrá bajado antes del final del periodo.
A esta escala, el alquiler no hace desaparecer las seis cifras del enfoque 1: las transforma en un alquiler anual.
3. Levantar las GPU solo cuando se necesitan
Se enciende la máquina, o más bien un contenedor en la mayoría de los casos, se hace el trabajo y se apaga. Algunos proveedores facturan por tramos de tiempo utilizado, diez minutos en Verda por ejemplo, lo que significa que un proceso terminado en 45 minutos cuesta 50. Muchos ofrecen también tarifas spot, sobre capacidad disponible, a mitad de precio.
Dos horas de procesamiento por noche suman unas sesenta horas al mes, es decir, unos 98 $ en spot, cuando la misma tarjeta mantenida de forma continua cuesta 2.370 $. Un factor veinticuatro. Es el mejor negocio del mercado para el procesamiento de fondo: reindexación documental, cálculo de embeddings, clasificación masiva, extracción sobre un fondo de PDF.
Para un servicio abierto durante el día, no sirve. Arrancar una máquina y cargar un modelo lleva minutos, y una instancia spot se te puede retirar a mitad de camino. Nadie espera cinco minutos a que su asistente se despierte.
4. Alquilar capacidad sobrante a quienes tienen de más
Quienes eligieron el enfoque 1 tienen GPU inactivas parte del tiempo. Se ha formado un mercado para revender esas horas valle, a menudo muy por debajo de los precios de los grandes proveedores, puesto que el hardware ya está amortizado de todos modos.
Esta categoría abarca dos realidades muy distintas. En un extremo, actores que han hecho de ello un servicio empresarial: capacidad reservada por contrato, compromiso de disponibilidad, operador identificado, hardware alojado en centros de datos conocidos. Se accede como a cualquier proveedor cloud, con una factura y un interlocutor, pero a una tarifa rebajada por el hecho de que las tarjetas ya existían.
En el otro extremo, el mercado entre particulares. Darkbloom, surgido de Eigen Labs, ejecuta inferencia en Mac con Apple Silicon inactivos, con un cifrado diseñado para que el propietario de la máquina no pueda leer lo que pasa por ella. El proyecto es todavía experimental y hoy no pondríamos en él un servicio crítico. La idea se sostiene: decenas de millones de Mac recientes duermen buena parte del día con mucha memoria disponible.
En ambos casos, lo que hay que mirar es quién opera la máquina, qué puede ver y qué compromiso de disponibilidad firma. Es lo que separa una buena oportunidad de una apuesta.
5. Recurrir a un proveedor de inferencia
Ya no hay ninguna máquina que gestionar. Se llama a una API, se paga por token y otro mantiene GPU en caliente de forma permanente.
Conviven dos familias. Los especialistas puros de la inferencia sirven modelos open weights y compiten en velocidad y precio: Cerebras, Groq, DeepInfra, Nebius. Los actores de gran público, OpenAI, Anthropic, Google, Mistral, sirven sus propios modelos.
El matiz se ve en la factura. Con una calidad comparable en muchas tareas, los primeros son sensiblemente más baratos, porque los segundos también cobran su notoriedad y la exclusividad de sus modelos. Como un mismo modelo abierto funciona en una decena de proveedores, se puede cambiar de opinión sin tocar los prompts.
Lo recomendable es elegir un actor que publique un verdadero compromiso de servicio, no solo una página de estado. Y prever una alternativa de respaldo desde el primer día.
6. Poner una pasarela delante de varios proveedores
Se conectan varios detrás de una capa única, que mide su estado, arbitra según la velocidad y el precio y conmuta automáticamente cuando uno falla. Es lo que se llama una pasarela multiproveedor, o AI gateway.
Ningún proveedor alcanza solo el 99,9 %. Encadenados detrás de una pasarela que prueba y conmuta, se consigue. Las cifras de disponibilidad están en SLA de IA para empresas, y la comparación de las pasarelas del mercado, de OpenRouter a LiteLLM, en LLM gateway: ¿OpenRouter, LiteLLM o pasarela propia?
7. Dejar que tu plataforma se encargue
Se compra un producto de IA empresarial y la inferencia pasa a ser problema de otro. Ninguna GPU que explotar, ninguna pasarela que construir, y la vigilancia de los modelos deja de ser asunto tuyo.
A cambio, heredas las decisiones de tu proveedor de IA. De ahí la pregunta que conviene hacerle antes de firmar: ¿es capaz de describir su cadena de inferencia? Qué proveedores, en qué jurisdicción, con qué alternativa de respaldo, bajo qué compromiso de no entrenamiento. Quien se mantiene impreciso en esta parte te pide confianza en el eslabón más sensible.
Los siete enfoques de inferencia de IA comparados
Lectura: el verde es favorable, el rojo desfavorable. El signo ± marca un criterio que depende del proveedor elegido.
| # | Enfoque | Modelo de coste | Ligereza de explotación | Fiabilidad | Soberanía | Puesta en marcha | Cuándo es la buena elección |
|---|---|---|---|---|---|---|---|
| 1 | Comprar las GPU | CAPEX elevado | −−− | ++ | +++ | Meses | Restricción regulatoria absoluta, volumen masivo |
| 2 | Alquilar GPU dedicadas | OPEX elevado, previsible | −− | ++ | ++ | Días | Volumen estable, exigencia de ubicación |
| 3 | GPU bajo demanda | OPEX por uso | − | −− | ++ | Horas | Procesamiento de fondo, batch, picos puntuales |
| 4 | Capacidad sobrante | OPEX muy bajo | − | − | ± | Horas | Presupuesto ajustado, operador verificado |
| 5 | Proveedor de inferencia | Por token | ++ | − | ± | Minutos | La mayoría de los proyectos |
| 6 | Pasarela multiproveedor | Por token, más la capa | ++ | +++ | ± | Días | En cuanto se espera un verdadero nivel de servicio |
| 7 | Plataforma llave en mano | Suscripción | +++ | +++ | ± | Minutos | Se compra un resultado de negocio |
En la práctica, una empresa suele combinar varias soluciones
Un solo enfoque puede bastar perfectamente, y suele ser así cuando el perímetro está claro y los usos son homogéneos. Pero en cuanto los casos de uso se diversifican, las empresas acaban a menudo con dos o tres regímenes distintos. En un caso como en el otro, el punto de partida es la restricción más dura, y el resto se organiza a su alrededor.
Una restricción regulatoria casi nunca afecta a todo el perímetro. El caso de uso realmente sensible se puede aislar en una infraestructura dedicada y dejar el resto en infraestructura compartida. A menudo es este reparto el que desbloquea un presupuesto, porque limita la exigencia fuerte a la parte del proyecto a la que realmente afecta.
Cuando es la latencia la que manda, solo manda en lo interactivo. Una empresa a la que acompañamos ejecuta su reindexación documental nocturna en GPU bajo demanda, por unas decenas de euros al mes, y sirve su asistente durante el día a través de un proveedor de inferencia rápido. Dos regímenes de coste, un solo proyecto.
Y si es el presupuesto, lo sensato es empezar por el enfoque 5 o el 7, sin dudarlo. Seis meses de uso real dirán si la internalización tiene el más mínimo sentido. Casi siempre es más cara de lo previsto, y nadie se da cuenta antes de tener las cifras delante.
Para fijar los órdenes de magnitud, esta es la misma H100 vista desde tres ángulos:
| Acceso a una H100 | Coste | Base de cálculo |
|---|---|---|
| Compra | ~30.000 $, es decir, ~26.000 €, solo la tarjeta | Precio de mercado PCIe y SXM5 |
| Alquiler dedicado, 24/7 | ~2.000 € al mes | Scaleway, 2,73 €/h × 730 h |
| Bajo demanda, 2 h por noche | ~98 $ al mes | Verda spot, 1,63 $/h × 60 h |
El hardware es idéntico en los tres casos; solo cambia el régimen de uso.
¿Cuánto tiempo hay que alquilar antes de haber gastado el precio de la tarjeta? De forma continua, a 2.000 € al mes, hacen falta trece meses para alcanzar los 26.000 € de la compra. En el régimen bajo demanda, a 85 € al mes, hacen falta más de veinticinco años.
Ahí es donde se juega la decisión, y en ningún otro sitio. La compra solo resulta interesante si se sabe que la máquina funcionará realmente de forma continua, durante varios años, con volúmenes que ya se han medido.
En Ask This Guy
Hoy, nuestros clientes están en el caso 7. No operan ninguna GPU, no construyen ninguna pasarela y la inferencia no figura en su presupuesto.
Esto solo funciona porque nosotros mismos combinamos los enfoques 2, 3 y 5. Montamos nuestras propias infraestructuras GPU en Verda, en Finlandia e Islandia, donde desplegamos y operamos algunos modelos, y en paralelo consumimos proveedores de inferencia seleccionados detrás de nuestra pasarela de proveedores de IA. Después eres tú quien sitúa el cursor, política solo UE o mundo entero, modificable en cualquier momento desde la consola. Todo es público en nuestro enfoque de la IA soberana.
Si escribimos este artículo, es porque los arbitrajes que aquí se describen los hemos pagado.
Bring Your Own AI: conectar tu propia inferencia
El caso 7 no debería ser un callejón sin salida. Si ya tienes GPU, un contrato con un proveedor de inferencia o tu propia pasarela, debes poder conectarlos en lugar de desecharlos.
Es lo que permite nuestro modo Bring Your Own AI: conectar tus propios modelos, tus proveedores o tus puntos de inferencia a la plataforma. Está disponible hoy bajo petición, y pronto se ofrecerá de serie.
En la práctica, los otros seis enfoques siguen abiertos. Unas GPU compradas el año pasado se pueden conectar. Una tarifa negociada con un proveedor de inferencia se conserva. Y si prefieres empezar llave en mano para internalizar dentro de dieciocho meses, una vez conocidos de verdad tus volúmenes, no tendrás que cambiar de herramienta por el camino.
Preguntas frecuentes
¿Qué es la inferencia en IA?
La inferencia es la fase en la que un modelo de inteligencia artificial ya entrenado procesa una petición y produce una respuesta. Se opone al entrenamiento, que es la fase de aprendizaje del modelo. Para una empresa, el entrenamiento es un coste poco frecuente y a menudo inexistente, mientras que la inferencia es un coste recurrente proporcional al uso real del servicio.
¿Cuánto cuesta la inferencia de un LLM en la empresa?
El coste de la inferencia de un LLM depende por completo del enfoque elegido. En alquiler de GPU dedicada, una H100 mantenida de forma continua sale por unos 2.000 a 2.400 € al mes, es decir, casi 24.000 € al año por una sola tarjeta, y un servidor de ocho tarjetas supera los 200.000 € al año. A través de un proveedor de inferencia que factura por token, un asistente interno para unos cientos de usuarios cuesta casi siempre unos cientos de euros al mes. La diferencia entre ambos modelos justifica medir los volúmenes reales antes de internalizar.
¿Hay que comprar GPU para usar la IA en la empresa?
En la gran mayoría de los casos, no. La compra de GPU se justifica cuando una restricción regulatoria prohíbe cualquier salida de los datos, cuando el volumen es masivo y estable y cuando ya existe un equipo de infraestructura para explotar el hardware. Fuera de esas condiciones, el alquiler o el recurso a un proveedor de inferencia cuesta menos y se pone en marcha en minutos en lugar de meses.
¿Qué es una infraestructura de IA?
Una infraestructura de IA reúne todo lo que permite ejecutar modelos de inteligencia artificial: las GPU, los servidores que las alojan, la red, el almacenamiento y la capa de software que sirve los modelos. En la empresa, la cuestión no es solo qué componentes elegir, sino quién los explota: tú, un proveedor cloud, un proveedor de inferencia o el editor de tu plataforma.
¿Qué diferencia hay entre un proveedor de inferencia y una API gateway?
Un proveedor de inferencia ejecuta él mismo los modelos en sus propias GPU y te factura los tokens consumidos. Una API gateway, o pasarela multiproveedor, no ejecuta ningún modelo: se sitúa delante de varios proveedores, mide su disponibilidad y su velocidad y conmuta automáticamente de uno a otro. Por lo general se usan las dos juntas, y la pasarela sirve para obtener un nivel de servicio que ningún proveedor alcanza solo.
Conclusión
Tu proyecto de IA te obligará a resolver la cuestión de la inferencia, probablemente desde el momento de presupuestarlo. Puedes construir tu propia infraestructura de IA, delegarlo todo o montar algo intermedio.
Los proyectos que se mantienen en producción no son los que eligieron el bando correcto. Son los que sabían que había siete.
Si estás preparando un proyecto de IA y quieres contrastar tu caso de uso con estos arbitrajes: reservar una demo.