SLA de IA en la empresa: un solo proveedor de IA no basta
Por qué un solo proveedor no basta para un SLA de IA en la empresa: compromisos comparados, LLM gateway multiproveedor y fallback para RAG y asistentes de IA.

En la página de estado de Anthropic, lo más habitual es encontrar una disponibilidad de entre el 99 y el 99,5 %. «Two nines». Para un SLA de IA en la empresa, es poco.
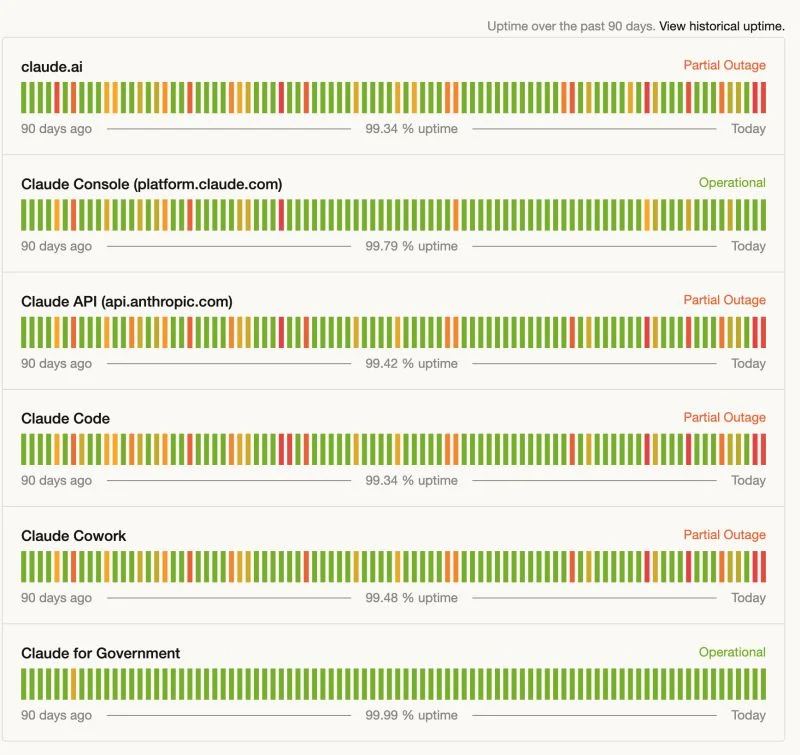
Hemos pasado de una época en la que se aspiraba a los four nines (99,99 %) a otra en la que un 99,3 % de uptime ya no escandaliza (o no lo suficiente). Los «vibe coders» que usan Claude se conforman, pero ¿basta para tu empresa? Probablemente no...
¿Es Anthropic un caso aislado? No. Mantener un nivel de servicio alto en inferencia a gran escala es difícil para todos.
Si solo hay que quedarse con una idea
Conectar la producción (RAG, asistente interno, agentes) a un único proveedor de IA, ya sea Claude, ChatGPT, Gemini o Mistral, supone aceptar varios días de indisponibilidad acumulada al año. Para un servicio de negocio que importa, ese riesgo se trata como cualquier otra dependencia de infraestructura.
Qué significan los nines
Órdenes de magnitud de la indisponibilidad en un año, sumando todas las causas:
| Nines | Uptime | Indisponibilidad aproximada |
|---|---|---|
| Two nines | 99 % | ~3,6 días |
| Three nines | 99,9 % | ~8,8 horas |
| Four nines | 99,99 % | ~52 minutos |
¿Puede tu proyecto de IA asumir varios días de parada al año?
Tus usuarios, en cambio, están acostumbrados a los «four nines» en sus herramientas de todos los días. Esta es la disponibilidad real de Microsoft 365:
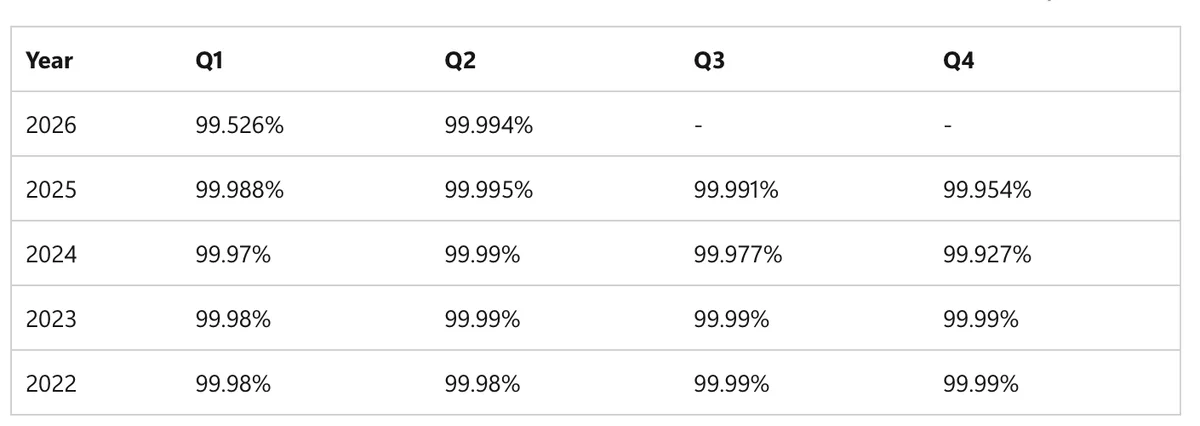 Disponibilidad mundial de Microsoft 365 por trimestre, en torno al 99,9 % o más (fuente: Microsoft Learn)
¿Y en los competidores de Anthropic?
OpenAI y Mistral también publican su disponibilidad. Las cifras no son directamente comparables: cada página cubre componentes y periodos distintos. A 31 de julio de 2026, Mistral mostraba un 99,4 % en los tres últimos meses.
Una página de estado no es un SLA con compensación económica. Aun así, algunas ofertas concretas publican un compromiso, como Gemini Online Inference con un 99,5 % u OpenAI Scale Tier con un 99,9 %, como opción de pago.
Los hiperescaladores pueden ofrecer compromisos más altos en algunos servicios gestionados de inferencia, por ejemplo un 99,9 % en Azure AI. El compromiso se aplica al endpoint. La latencia, la calidad de las respuestas y el resto de tu cadena RAG quedan fuera.
Estamos lejos de las garantías habituales de los SaaS de productividad, donde los tres «nines» son un estándar sin coste adicional.
Los open weights hacen posible el fallback
Un mismo modelo abierto se ejecuta en una decena de proveedores de inferencia. Es una de las siete formas de servir inferencia en la empresa que comparamos en nuestra guía sobre la inferencia de IA. Si uno cae, se pasa a otro sin cambiar de modelo y, por tanto, sin retocar los prompts.
De ahí la pasarela multiproveedor, o LLM gateway: una capa capaz de llamar a varios modelos en varios proveedores y de elegir entre ellos según quién responde, a qué velocidad y a qué precio.
Ninguno de estos proveedores alcanza el 99,9 % por sí solo. Encadenados detrás de una pasarela que comprueba su estado y conmuta en cuanto uno falla, se consigue. Esto es lo que medimos en producción en Ask This Guy en los últimos 30 días:
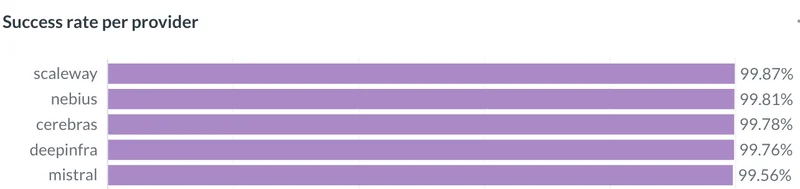 Tasa de éxito por proveedor de inferencia: Scaleway 99,87 %, Nebius 99,81 %, Cerebras 99,78 %, DeepInfra 99,76 %, Mistral 99,56 %
Esta pasarela se puede contratar como SaaS (OpenRouter, Eden AI), alojar en código abierto (LiteLLM), desarrollar internamente o recibir integrada en una plataforma, que es nuestro caso en Ask This Guy. Comparamos estas opciones, su coste y lo que hacen con tus datos en LLM gateway: ¿OpenRouter, LiteLLM o pasarela propia?
Un SLA de RAG en la empresa no se limita, por cierto, al uptime del LLM. La ingesta de las fuentes, la búsqueda y las llamadas a herramientas pueden fallar sin que el modelo se inmute. Sobre las trampas que aparecen después del POC, véase RAG en la empresa: 5 errores en producción.
Preguntas frecuentes
¿Qué es un SLA de IA en la empresa?
Un SLA de IA en la empresa fija el nivel de disponibilidad esperado de un servicio de IA, su perímetro de medición, sus exclusiones y los créditos que se deben si no se cumple el compromiso. Una página de estado sirve para observar las incidencias, no compromete a nadie.
¿Qué SLA para un RAG en la empresa?
Un SLA de RAG en la empresa debe cubrir algo más que la API del modelo: la ingesta de las fuentes, la búsqueda, la pasarela y la latencia de extremo a extremo. El 99,9 % es la referencia habitual, pero la cifra no significa nada mientras el perímetro y el método de medición no estén escritos negro sobre blanco.
SLA de un asistente de IA: ¿cómo mejorar la disponibilidad?
Lo primero es eliminar el punto único de fallo: una pasarela multiproveedor, varios modelos, comprobaciones de estado y un fallback automático. Después conviene añadir una monitorización de errores y de latencia, y un modo degradado para los momentos en que ya nada genera.
En Ask This Guy
Nuestra pasarela de proveedores de IA selecciona de forma continua los modelos que responden, y rápido. Objetivo para los clientes: un nivel de servicio superior al 99,9 % en el perímetro definido, sin depender de un único modelo puntero. Política UE o mundo entero, según tu exigencia de soberanía.
No hay milagro: una arquitectura que parte de la base de que los LLM en la nube se caen. Es la base de nuestra solución RAG para empresas, y la misma pasarela alimenta un asistente de soporte de producto cuando los usuarios son tus clientes.
Si estás industrializando un RAG o un asistente interno y quieres ver esta pasarela en condiciones reales: Reservar una demo.