LLM gateway: ¿OpenRouter, LiteLLM o pasarela propia?
LLM gateway o AI gateway: qué hace una pasarela de IA como OpenRouter o LiteLLM, cuánto cuesta y por dónde pasan tus datos. Con nuestras mediciones.

En junio, en LinkedIn, nos preocupaban las empresas que habían construido sus agentes en torno a un único proveedor. En dos meses, el modelo premium de Anthropic había pasado de 5/25 $ a 10/50 $ por millón de tokens, justo después de un cambio de tokenizer que ya hacía consumir entre un 30 y un 45 % más de tokens para la misma petición, según las mediciones de OpenRouter. Una factura multiplicada por 2,6 a 2,9, sin tocar una sola línea de código.
Su modelo hacía muy bien el trabajo. El error estaba en otra parte: la aplicación llamaba a una única API, escrita a fuego en el código. Cuando el proveedor se cae, sube sus precios o retira un modelo, solo queda aguantar.
La capa que evita llegar a eso se llama LLM gateway, o pasarela de IA. El mercado las ofrece de todas las formas, desde OpenRouter, el servicio más conocido, hasta LiteLLM, la referencia open source. Lo habitual es compararlas por el tamaño del catálogo y por el precio. En la empresa, nosotros empezamos por otra pregunta: ¿por dónde pasan tus datos?
¿Qué es un LLM gateway, o AI gateway?
Un LLM gateway es una capa de software situada entre tus aplicaciones y los proveedores de modelos de IA. Expone una sola API, envía cada petición al modelo y al proveedor más adecuados, y cambia automáticamente a otro cuando el primero falla.
No ejecuta ningún modelo. Es lo que lo distingue de un proveedor de inferencia, que ejecuta los modelos en sus propias GPU. Detallamos esta diferencia en nuestra guía sobre la inferencia de IA.
Varios nombres designan lo mismo: AI gateway, LLM gateway, pasarela multiproveedor. El término LLM router designa a veces una pieza más estrecha, que elige el modelo según la dificultad de la pregunta sin gestionar ni la conmutación ni las claves.
Lo que hace de verdad una pasarela
Conmuta cuando un proveedor se cae
Ningún proveedor de inferencia alcanza por sí solo el 99,9 % de disponibilidad. Esto es lo que medimos en producción con cinco de ellos, durante treinta días de julio de 2026:
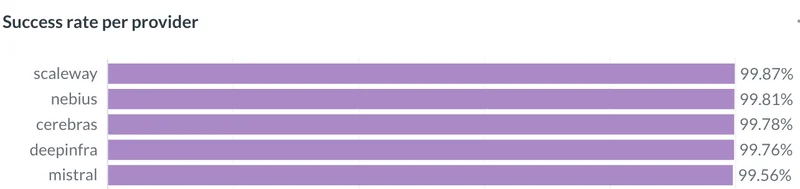 Tasa de éxito por proveedor de inferencia: Scaleway 99,87 %, Nebius 99,81 %, Cerebras 99,78 %, DeepInfra 99,76 %, Mistral 99,56 %
Uno por uno, ninguno llega a los tres nueves. Encadenados detrás de una pasarela que comprueba su estado y conmuta en cuanto uno falla, se consigue. El razonamiento completo, con los compromisos contractuales de los grandes proveedores, está en nuestro artículo sobre el SLA de IA en la empresa.
La conmutación supone que el mismo modelo funciona en varios proveedores, o que se acepta un modelo de reserva. Es una de las ventajas concretas de los modelos open weights: se cambia de proveedor sin tocar los prompts.
Arbitra entre precio, velocidad y país
Es la función menos conocida, y la que más rinde. Un mismo modelo no tiene ni el mismo precio, ni la misma velocidad, ni la misma nacionalidad según quién lo sirva. Nuestras mediciones:
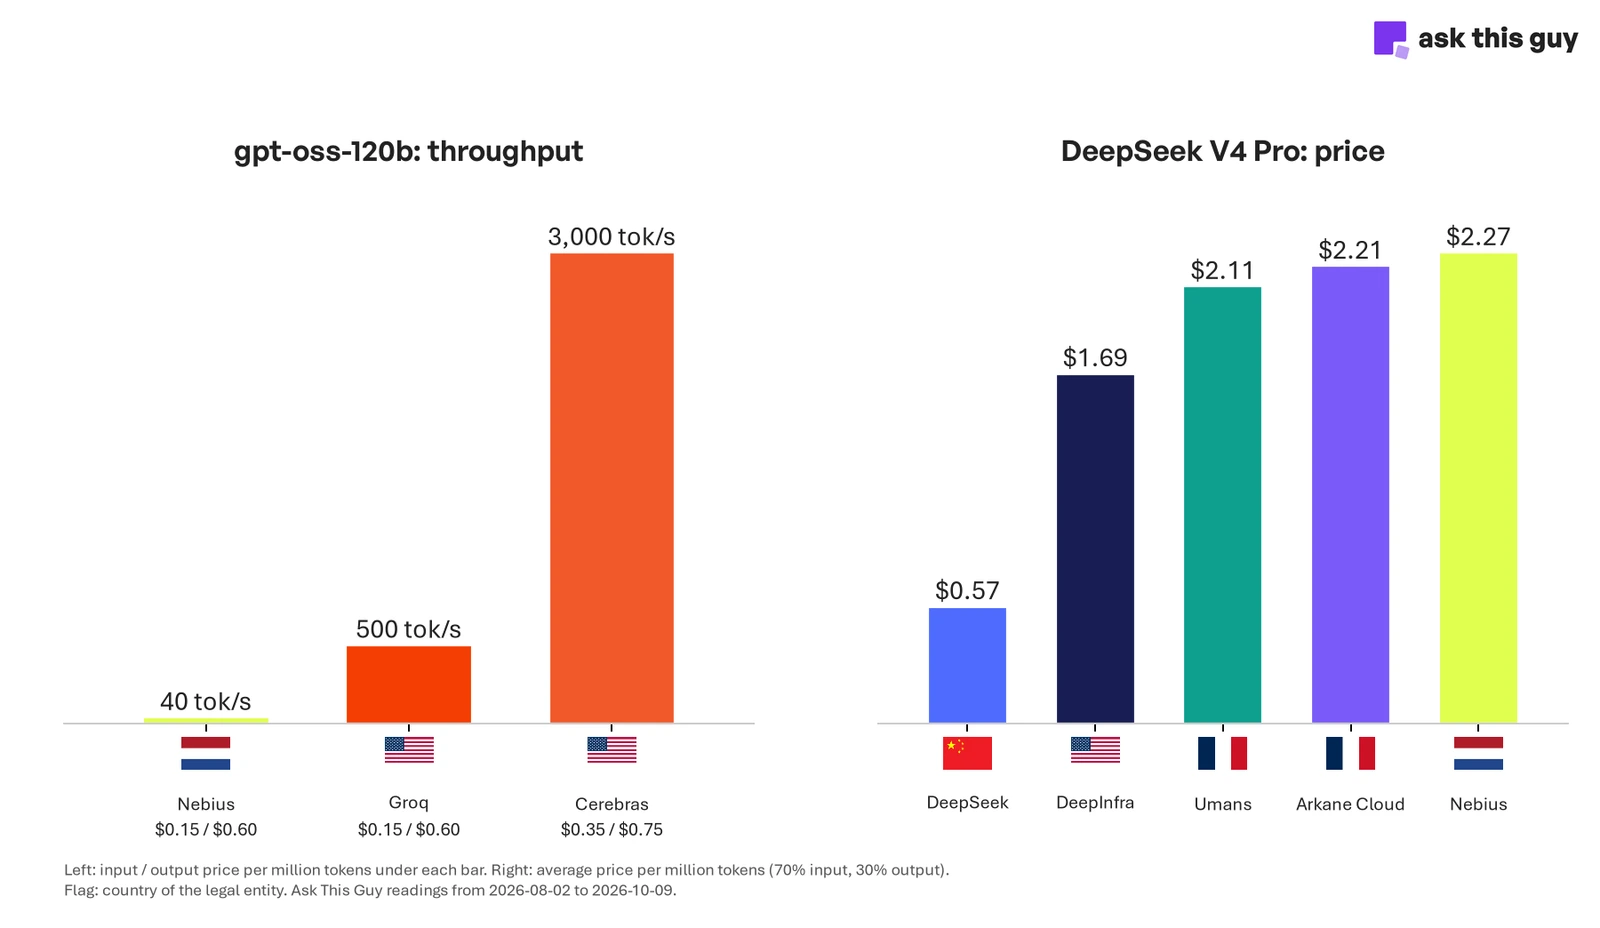 Dos gráficos de barras. A la izquierda, el modelo gpt-oss-120b: Nebius lo sirve a 40 tokens por segundo y Groq a 500, ambos a 0,15 $ de entrada y 0,60 $ de salida por millón de tokens, Cerebras a 3.000 tokens por segundo por 0,35 y 0,75 $. A la derecha, el modelo DeepSeek V4 Pro cuesta 0,57 $ por millón de tokens en DeepSeek (China), 1,69 $ en DeepInfra (Estados Unidos), 2,11 $ en Umans y 2,21 $ en Arkane Cloud (Francia), 2,27 $ en Nebius (Países Bajos).
A la izquierda, gpt-oss-120b. Nebius y Groq lo cobran al mismo precio, 0,15 $ de entrada y 0,60 $ de salida por millón de tokens. El primero lo sirve a 40 tokens por segundo, el segundo a 500. Cerebras sube a 3.000 tokens por segundo por una tarifa apenas más alta. Un factor 75 en la velocidad, a un precio casi idéntico.
A la derecha, DeepSeek V4 Pro. Servido por DeepSeek, sale a 0,57 $ el millón de tokens. En Nebius, a 2,27 $. El mismo modelo, cuatro veces más caro. Pero el más barato es una empresa china, y los tres más caros son europeos. El precio más bajo no siempre es el que se tiene derecho a pagar.
Un último matiz, invisible en el gráfico: la bandera indica el país de la entidad, no el del centro de datos. Nebius, sociedad neerlandesa, sirve gpt-oss-120b desde Finlandia, pero DeepSeek V4 Pro desde el Reino Unido.
Una pasarela que lee estas tres variables elige, petición a petición, la combinación que respeta tu restricción al mejor coste.
Centraliza las claves y las cuentas
La aplicación solo conoce una API, en general compatible con la de OpenAI. Las claves de los proveedores se guardan en un mismo sitio. Cambiar de modelo se convierte en una línea de configuración y no en una obra, y es lo que hace posibles arbitrajes como el de nuestro artículo sobre el OCR, en el que un modelo open weight dividió la factura por 10.
La contrapartida es inmediata: la pasarela tiene todas tus claves. Volvemos sobre ello más abajo, con LiteLLM.
Mide el consumo
Coste por equipo, por aplicación o por usuario, cuotas, registros de llamadas. Suele ser la función que convence a la dirección financiera, mucho antes que la disponibilidad.
Las cinco familias de pasarelas
Lectura: el verde es favorable, el rojo desfavorable. El signo ± marca un criterio que depende del editor o de tu configuración.
| Familia | Ejemplos | Por dónde pasan tus datos | Ligereza de explotación | Soberanía | Coste |
|---|---|---|---|---|---|
| SaaS | OpenRouter, Eden AI, Requesty | Por el editor de la pasarela, y después por el proveedor | ++ | ± | Comisión sobre los créditos o suscripción |
| Open source para alojar | LiteLLM, Portkey Gateway | Por tu infraestructura, y después por el proveedor | − | +++ | Servidores y tiempo del equipo |
| Pieza de infraestructura | Cloudflare AI Gateway, Kong AI Gateway | Por el operador de red, y después por el proveedor | + | ± | Según la oferta |
| Propia | Tu propio código | Por tu infraestructura, y después por el proveedor | −−− | +++ | Tiempo del equipo, sobre todo en la medición |
| Integrada en una plataforma | Ask This Guy, por ejemplo | Por el editor de la plataforma, y después por el proveedor | +++ | ± | Incluido en la suscripción |
La columna de soberanía solo se lee junto con la anterior. Una pasarela alojada en tu infraestructura en Europa puede perfectamente enviar tus peticiones a Estados Unidos si nadie la ha configurado para impedirlo.
OpenRouter: qué es y qué conviene comprobar en la empresa
OpenRouter es una pasarela SaaS estadounidense: una API única, compatible con la de OpenAI, que da acceso a varios cientos de modelos servidos por decenas de proveedores. Se compran créditos, se llama a un modelo, OpenRouter elige el proveedor y conmuta en caso de fallo. Según Dealroom, la empresa levantó 113 millones de dólares en mayo de 2026, en una ronda liderada por CapitalG, el fondo de crecimiento de Alphabet.
Para un desarrollador que quiere probar diez modelos en una tarde, es imbatible. Para una empresa, hay cuatro puntos que merece la pena comprobar antes de hacer pasar datos por ella.
Primero, el modelo económico. OpenRouter repercute el precio de los proveedores sin margen y cobra sobre la compra de créditos: un 5,5 % de comisión, con un mínimo de 0,80 $. Si se aportan las propias claves de los proveedores, los primeros 25.000 dólares de consumo mensual no pagan comisión, y después OpenRouter cobra un 5 %.
En cuanto a los datos, OpenRouter no almacena por defecto ni los prompts ni las respuestas. Dos opciones cambian esto, si se activan: el registro de tus intercambios, y la autorización a OpenRouter para usarlos, a cambio de un descuento del 1 %. Lo que importa ocurre después, en cada proveedor llamado, que aplica su propia política.
El control del enrutamiento es el verdadero punto fuerte de OpenRouter, siempre que se configure. El parámetro data_collection: "deny" excluye a los proveedores que recogen datos, zdr: true limita el enrutamiento a los proveedores sin conservación de datos, y las listas only e ignore fijan quién tiene derecho a responder. La documentación sobre la selección de proveedores advierte ella misma de que cada restricción reduce las posibilidades de reserva.
Por último, la jurisdicción. OpenRouter ofrece un enrutamiento limitado a Europa, a través de eu.openrouter.ai, reservado a sus planes Business y Enterprise. Los tratamientos se quedan entonces en la Unión Europea. La entidad, en cambio, es estadounidense, y por tanto está sujeta a la CLOUD Act como cualquier proveedor estadounidense, dondequiera que funcionen sus servidores. Explicamos por qué importa este punto en ¿Y si Estados Unidos te cerrara el grifo digital?
Una palabra sobre los modelos gratuitos, que atraen a muchos curiosos. Están limitados a 50 peticiones al día, o 1.000 tras comprar 10 $ de créditos. Perfectos para probar, inutilizables en producción.
¿Qué alternativa a OpenRouter existe en Europa?
En el lado SaaS, Eden AI, editor francés, ofrece un endpoint europeo que solo enruta hacia proveedores y modelos validados para un tratamiento en Europa, y afirma no conservar ni los prompts, ni los archivos, ni las respuestas. Como en OpenRouter, la garantía se refiere a un par de modelo y proveedor: conviene comprobarla para cada uno de los que se activen.
La otra opción es alojar uno mismo una pasarela open source en un centro de datos europeo. La más usada se llama LiteLLM.
LLM gateway open source: LiteLLM, para alojar uno mismo
LiteLLM es la referencia open source del sector: una biblioteca Python y un servidor proxy que exponen una API compatible con OpenAI delante de más de un centenar de proveedores. Se aloja donde se quiera, también en Europa, y tus peticiones no pasan por ningún tercero antes del proveedor final. Existen otras pasarelas open source, como Portkey Gateway o Envoy AI Gateway; las observaciones que siguen también valen para ellas.
Lo que la herramienta no hace por ti es explotarla. Hay que actualizarla, hacerla a su vez altamente disponible (si no, se convierte en el punto único de fallo que debía eliminar) y, sobre todo, medir. Saber qué proveedor responde rápido ahora exige sondas, umbrales e historial. Es la parte que más subestimamos al construir nuestra propia pasarela.
También está la seguridad. El 24 de marzo de 2026, dos versiones trampa de LiteLLM, la 1.82.7 y la 1.82.8, se publicaron en PyPI. Contenían un ladrón de credenciales que se llevaba las variables de entorno, las claves SSH, las credenciales cloud y las contraseñas de bases de datos. Estuvieron en línea unos cuarenta minutos. La imagen Docker oficial del proxy, que fija sus dependencias, no se vio afectada, y una versión limpia salió en la misma semana. Las búsquedas de LiteLLM se multiplicaron por más de tres en Francia ese mes.
La lección va más allá de LiteLLM. Una pasarela tiene, por construcción, las claves de todos tus proveedores: es el objetivo más rentable de tu infraestructura de IA. Si se aloja uno mismo, conviene fijar las versiones, aislarla y tratarla como una caja fuerte, no como una utilidad.
Fijar no significa esperar: en abril de 2026, una vulnerabilidad crítica de LiteLLM se atacó 36 horas después de que su aviso de seguridad se registrara en las bases de vulnerabilidades. Lo prudente es pasar rápido a la versión corregida, tras comprobar que viene de la fuente oficial. Explicamos por qué este plazo se cuenta ahora en horas en nuestro artículo sobre Claude Mythos y la ventana de corrección.
LiteLLM vs. OpenRouter: la comparativa
Las dos herramientas responden a la misma necesidad, una API única delante de varios proveedores, pero OpenRouter es un servicio que se alquila, LiteLLM un software que se explota uno mismo.
| OpenRouter | LiteLLM | |
|---|---|---|
| Naturaleza | Servicio SaaS | Software open source |
| Alojamiento | Servidores de OpenRouter; enrutamiento limitado a la UE en los planes Business y Enterprise | Donde se quiera, también en un centro de datos europeo |
| Entidad jurídica | Sociedad estadounidense, sujeta a la CLOUD Act | Ninguna entre tú y el proveedor final |
| Coste | 5,5 % sobre la compra de créditos (mínimo 0,80 $); 5 % por encima de 25.000 $ al mes con tus propias claves | Gratuito, pero el alojamiento y la explotación corren de tu cuenta |
| Datos | Sin almacenamiento de prompts por defecto; enrutamiento restringible a proveedores sin conservación | No pasan por ningún tercero antes del proveedor final |
| Explotación | Nada que gestionar | Actualizaciones, alta disponibilidad, medición del rendimiento, seguridad |
| Para quién | Prototipado, pruebas de modelos | Equipos con infraestructura propia y una restricción de soberanía |
Las cifras y condiciones de esta tabla se detallan, con sus fuentes, en las dos secciones anteriores. El riesgo propio de cada opción también es distinto: con OpenRouter es jurídico; con LiteLLM es operativo, como mostró la publicación de versiones trampa en marzo de 2026.
La pasarela también es una herramienta de soberanía
La pasarela se presenta como una herramienta de fiabilidad. También es el único lugar de tu arquitectura en el que una regla de soberanía se aplica a todas las peticiones a la vez.
«Ningún dato sale hacia un proveedor no europeo». Sin pasarela, esta regla depende de la disciplina de cada desarrollador que escribe una llamada a la API. Con una pasarela, es una línea de configuración, y la conmutación automática ya no puede enviarte, una noche de avería, a un proveedor que no has validado.
Tres condiciones para que la regla se sostenga:
- La propia pasarela debe ser europea. Si no, todas tus peticiones pasan por una entidad sujeta a la CLOUD Act antes de llegar a Mistral o a Scaleway.
- El filtro debe aplicarse al país de la entidad y al del centro de datos. El caso de Nebius, más arriba, lo muestra: una empresa europea puede servir un modelo desde fuera de la Unión.
- Hacen falta suficientes proveedores europeos para conmutar. Cada proveedor retirado de la lista es una ruta de reserva menos: es el precio de la soberanía, y más vale medirlo antes de la primera avería.
Los criterios que aplicamos a cualquier actor de la IA se detallan en nuestra página sobre la IA soberana.
¿Hace falta una pasarela?
Todavía no si estás en fase de POC, con un modelo, un uso y ningún compromiso de disponibilidad. Aun así, es buena idea escribir las llamadas detrás de una pequeña capa de abstracción: el día en que haga falta una pasarela, se conectará sin reescribir la aplicación.
Sí, en cuanto una aplicación pasa a producción con usuarios que dependen de ella, en cuanto varios equipos consumen modelos, o en cuanto una restricción de soberanía debe aplicarse a todas las llamadas.
Y no te corresponde construirla si compras una plataforma de IA que ya la integra. Basta con pedir al editor que la describa: qué proveedores, en qué países, con qué reglas de conmutación y qué compromiso de no entrenar con tus datos.
| Tu situación | Lo que recomendamos |
|---|---|
| Prototipos, ningún dato sensible | OpenRouter, por la amplitud del catálogo |
| Producción, restricción europea, sin equipo de infraestructura | Pasarela SaaS europea o plataforma integrada |
| Producción, equipo de infraestructura, restricción fuerte | LiteLLM o Portkey Gateway, alojado en Europa y blindado |
| Compras un resultado de negocio, no una pieza técnica | Plataforma que integra su pasarela |
En Ask This Guy
La pasarela está integrada en la plataforma: nuestros clientes no tienen nada que construir ni que explotar. Selecciona de forma continua los modelos que responden, y rápido, con un objetivo de servicio superior al 99,9 % en el perímetro definido.
La regla de soberanía es un ajuste de la organización. Solo UE: Mistral, Scaleway, Nebius, Black Forest Labs, más nuestras propias GPU en Verda, en Finlandia y en Islandia. Todo el mundo: los mismos, más proveedores no europeos seleccionados. El ajuste se cambia en cualquier momento desde la consola, y el detalle es público en nuestra página de gestión de los proveedores de IA.
Los costes de los modelos están incluidos en la suscripción. Las diferencias de precio y de velocidad descritas más arriba son problema nuestro, no tuyo.
Y si ya tienes tu propia pasarela o un contrato con un proveedor, nuestro modo Bring Your Own AI permite conectarlos a la plataforma. Está disponible bajo petición.
Preguntas frecuentes
LLM gateway o AI gateway: ¿qué diferencia hay?
Los dos términos designan la misma capa: un punto de entrada único delante de varios proveedores de modelos, con conmutación automática. AI gateway es algo más amplio, porque algunos productos cubren también los modelos de imagen, de audio o de embeddings. LLM gateway pone el acento en los modelos de lenguaje, que representan la mayor parte del tráfico en la empresa.
¿Qué diferencia hay entre un LLM gateway y un API gateway clásico?
Un API gateway clásico enruta, autentica y limita las llamadas hacia tus propios servicios. Un LLM gateway hace el mismo trabajo delante de proveedores de modelos de IA, y añade lo que este oficio exige: contar los tokens, comparar el precio y la velocidad de varios proveedores para un mismo modelo, y conmutar a otro proveedor o a otro modelo cuando uno falla. Varios API gateways del mercado, como Kong, ofrecen ya un módulo dedicado a la IA.
¿Qué es OpenRouter?
OpenRouter es una pasarela de IA ofrecida en SaaS por una empresa estadounidense. Da acceso a varios cientos de modelos, de OpenAI, de Anthropic, de Google, de Mistral u open weights, a través de una sola API compatible con la de OpenAI. Elige el proveedor que sirve cada petición, conmuta en caso de fallo y cobra una comisión del 5,5 % sobre la compra de créditos.
¿OpenRouter cumple el RGPD?
OpenRouter no almacena los prompts por defecto, permite limitar el enrutamiento a los proveedores sin conservación de datos y ofrece un tratamiento en Europa en sus planes Business y Enterprise. La empresa sigue siendo estadounidense, y por tanto está sujeta a la CLOUD Act. El cumplimiento depende sobre todo de tu configuración y de los proveedores finales llamados: se comprueba caso por caso con tu delegado de protección de datos.
LiteLLM u OpenRouter: ¿cuál elegir?
OpenRouter es un servicio llave en mano: nada que alojar, pero tus peticiones pasan por una empresa estadounidense que cobra un 5,5 % sobre los créditos. LiteLLM es un software open source que se aloja uno mismo: eliges por dónde pasan tus datos, pero tienes que explotarlo, protegerlo y actualizarlo. El primero conviene al prototipado, el segundo a los equipos con infraestructura propia y una restricción de soberanía.
¿Una pasarela añade latencia?
Un poco, pero rara vez de forma perceptible. El rodeo por una pasarela cuesta unas decenas de milisegundos como mucho, cuando la generación de una respuesta se cuenta en segundos. Una pasarela que elige el proveedor más rápido hace ganar mucho más tiempo del que cuesta: en gpt-oss-120b, la diferencia entre proveedores va de 40 a 3.000 tokens por segundo.
¿Se pueden usar los modelos gratuitos de OpenRouter en la empresa?
Para probar, sí. Para producción, no: están limitados a 50 peticiones al día, o 1.000 tras comprar 10 $ de créditos, sin compromiso de servicio. Y un modelo que solo sirven proveedores que conservan los datos solo es accesible si se han autorizado esos proveedores en los ajustes: conviene revisarlos antes de enviar nada.
Conclusión
Una aplicación conectada a un solo proveedor sufre sus averías, sus subidas de precio y su jurisdicción. Una pasarela te devuelve estas tres decisiones, siempre que se sepa dónde funciona y quién la controla.
Para ver una pasarela aplicar una política europea en condiciones reales: reservar una demo.