Mistral OCR: dividir la factura por 10 con open weight
Mistral OCR cuesta 4 $ por cada 1.000 páginas. Un OCR open weight en una GPU europea baja a 0,15 $ y sigue siendo soberano. Benchmark, umbral y trampas.

En marzo de 2025, Mistral OCR costaba 1 $ por cada 1.000 páginas. En diciembre, 2 $. Desde junio de 2026, 4 $. El precio se ha multiplicado por cuatro en quince meses.
Tomemos una empresa que quiere que su base documental se pueda consultar con una IA: 10.000 documentos de 100 páginas de media, es decir, un millón de páginas. Con la tarifa actual, solo el OCR cuesta 4.000 $, antes de haber hecho la primera pregunta.
Hemos pasado la misma carga por PaddleOCR-VL, un modelo open weight, desplegado en una GPU alquilada en Europa. A precio de catálogo, con la GPU ocupada de forma continua: 151 $. Veintiséis veces menos.
Y sin ceder nada en soberanía: las máquinas pertenecen a un operador finlandés, y ninguna página sale hacia el editor del modelo.
Una GPU nunca está ocupada al 100 %, de ahí el diez de nuestro título en lugar de veintiséis.
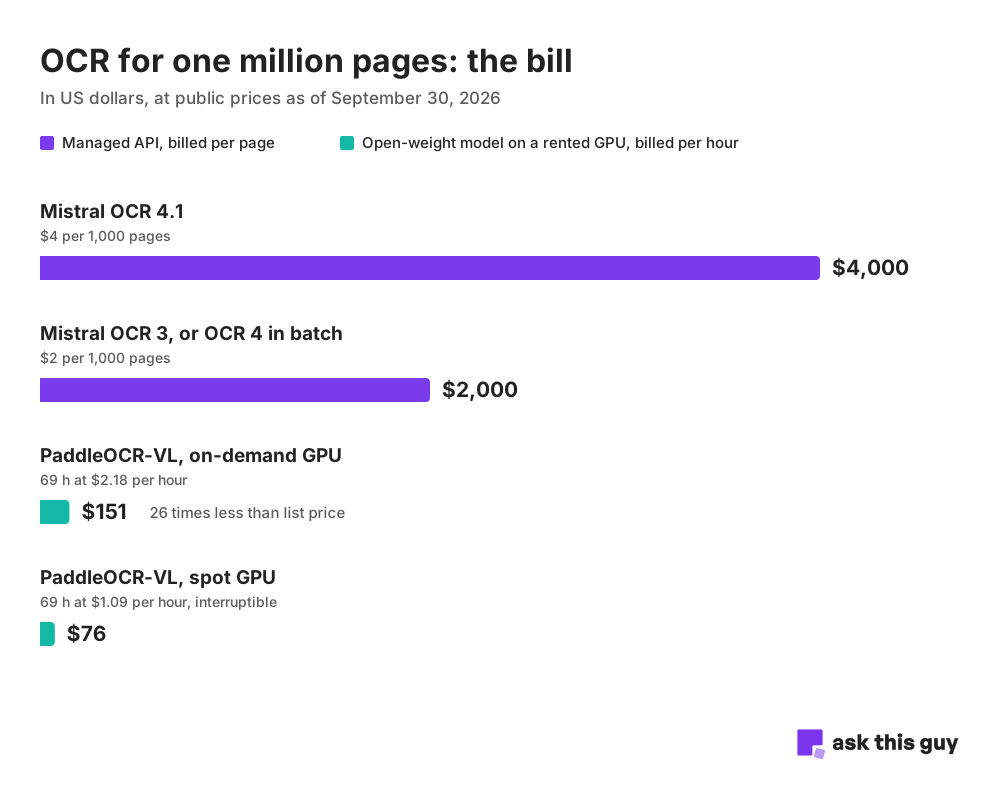 Diagrama de barras que compara el coste del OCR de un millón de páginas: 4.000 $ con Mistral OCR 4.1, 2.000 $ con Mistral OCR 3 u OCR 4 por lotes, 151 $ con PaddleOCR-VL en una GPU RTX PRO 6000 bajo demanda en Verda, 76 $ en la misma GPU con tarifa spot
Hipótesis: GPU RTX PRO 6000 en Verda, ocupada al 100 %, a 4 páginas por segundo (nuestra medición sobre 173 páginas, una máquina).
Por qué un parser de PDF no basta
Un PDF es un formato de impresión. Describe dónde colocar cada carácter en la página. El archivo no sabe qué es un título o una tabla: solo contiene glifos y coordenadas.
Un parser de PDF (PyMuPDF, pdfplumber, pypdf) lee esa capa de texto y la devuelve. Es instantáneo y gratuito. Cuando la capa existe, es incluso exacto carácter a carácter. El problema viene de todo lo que no contiene.
El documento no tiene capa de texto. Un contrato firmado y luego escaneado, un fax, una foto de un albarán: el PDF solo contiene una imagen. El parser devuelve una página vacía.
El texto está en las imágenes. En nuestro conjunto de prueba, una presentación de 25 diapositivas contiene 148 imágenes para 470 palabras de texto extraíble. En una guía técnica de 34 páginas llena de capturas de pantalla, Mistral OCR encontró 546 palabras que no existen en ninguna parte de la capa de texto.
Las tablas no existen. En un PDF, una tabla es una serie de líneas y números colocados en unas coordenadas. El parser devuelve los números seguidos, sin las columnas. Una cifra separada del encabezado de su columna no sirve de nada: el modelo de lenguaje que la recibe tendrá que adivinar a qué corresponde.
El orden de lectura y el ruido. Dos columnas, un recuadro, una nota a pie de página: el parser sigue el orden del archivo, que no es necesariamente el de lectura. Además, conserva todo lo que se repite. En un pliego de condiciones de 28 páginas de nuestro conjunto de prueba, 669 palabras no eran más que líneas de encabezado y de pie de página repetidas de una página a otra.
En un RAG, todo esto se paga más adelante en la cadena. Cuando un asistente responde fuera de lugar, la causa suele ser un documento mal leído a la entrada. Es uno de los errores que aparecen después del POC.
Lo que hace un OCR con IA
El OCR clásico, el de Tesseract, reconoce caracteres línea a línea. Lee un escaneo limpio y ahí se queda: sin estructura, con las tablas desordenadas.
La generación actual trabaja en dos tiempos. Un primer modelo divide la página en bloques (título, párrafo, tabla, figura, encabezado) y los pone en orden de lectura. Un segundo, un modelo de visión y lenguaje, transcribe cada bloque. El resultado es un archivo Markdown con sus títulos, sus tablas y sus imágenes, directamente utilizable por un LLM. Es lo que se busca al escribir «pdf to markdown».
Se accede de dos maneras. La primera es una API gestionada, de la que Mistral OCR es el ejemplo más conocido en Francia: se envía un PDF, se recibe el Markdown y se paga por página.
La segunda es un modelo open weight que se aloja uno mismo. PaddleOCR-VL, publicado por Baidu con licencia Apache 2.0, tiene menos de mil millones de parámetros y cabe en una sola GPU. En ese caso, se alquila la máquina y se paga por hora.
El modelo viene de China. Eso no resta nada a la soberanía del montaje, y volvemos sobre ello después de las cifras.
Lo que cuesta Mistral OCR
| Versión | Salida | Precio por 1.000 páginas |
|---|---|---|
| Mistral OCR | Marzo de 2025 | 1 $ |
| Mistral OCR 3 | Diciembre de 2025 | 2 $ |
| Mistral OCR 4, luego 4.1 | Junio y julio de 2026 | 4 $ (2 $ con procesamiento por lotes) |
Fuentes: anuncio de marzo de 2025, ficha del modelo OCR 4.1 y Silicon.fr (en francés) para el historial.
Seamos justos: cada versión hace más que la anterior. OCR 4 lee 170 idiomas, devuelve la posición de cada párrafo y se atreve con el manuscrito. Pero si tus documentos son informes mecanografiados en español, pagas esos avances sin sacarles partido. OCR 3 sigue disponible a 2 $, y nada indica durante cuánto tiempo.
Nuestro millón de páginas cuesta, por tanto, 4.000 $ a precio de catálogo, y 2.000 $ si se acepta el procesamiento por lotes o el modelo anterior.
Y ese importe solo corresponde a la primera factura. Llegan documentos nuevos, se actualizan otros antiguos. Sobre todo, cada vez que se mejora la cadena de ingesta (un modelo nuevo, un ajuste distinto en las tablas), hay que volver a pasar todo el fondo. A 4.000 $ la pasada, se duda antes de probar una mejora. A 150 $, se prueba.
PaddleOCR-VL en una GPU alquilada: el mismo millón de páginas
Nuestro despliegue funciona en Verda, un operador finlandés cuyos centros de datos están en Finlandia e Islandia. La máquina: una GPU RTX PRO 6000, alquilada a 2,18 $ la hora bajo demanda, o 1,09 $ con tarifa spot (capacidad disponible, que se puede interrumpir en cualquier momento).
El 30 de septiembre de 2026 medimos su rendimiento con 9 PDF reales que sumaban 173 páginas. Una sola máquina llega como máximo a unas 4 páginas por segundo, es decir, 14.400 páginas por hora.
Un millón de páginas a 14.400 páginas por hora son 69 horas de GPU. A 2,18 $ la hora, 151 $.
| Coste por 1.000 páginas | Un millón de páginas | |
|---|---|---|
| Mistral OCR 4.1 | 4 $ | 4.000 $ |
| Mistral OCR 3, u OCR 4 por lotes | 2 $ | 2.000 $ |
| PaddleOCR-VL, GPU bajo demanda | 0,15 $ | 151 $ |
| PaddleOCR-VL, GPU spot | 0,08 $ | 76 $ |
Por qué decimos diez, y no veintiséis
Esos 0,15 $ suponen una GPU que trabaja cada segundo facturado. Pero una GPU alquilada se paga por hora, tanto si convierte páginas como si espera.
Todo depende, por tanto, de su tasa de ocupación:
| Páginas procesadas por hora facturada | Ocupación de la GPU | Resultado frente a Mistral OCR 4.1 |
|---|---|---|
| 545 | 4 % | Mismo coste |
| 1.090 | 8 % | La mitad de caro (el precio de Mistral OCR 3) |
| 5.450 | 38 % | 10 veces más barato |
| 14.400 | 100 % | 26 veces más barato |
Un fondo documental por procesar es el caso ideal: se llena la cola, la máquina se satura y se apaga al final. Un goteo de tres documentos por hora es el peor: la GPU espera, y se paga la espera.
Una GPU encendida todo el tiempo no tiene ningún sentido
El error más fácil de cometer: alquilar una máquina, dejarla encendida y descubrir la factura a final de mes. Una GPU a 2,18 $ la hora que funciona día y noche cuesta 1.591 $ al mes, convierta un millón de páginas o ninguna. Por ese precio, Mistral OCR 4.1 procesa cerca de 400.000 páginas. Por debajo de ese volumen mensual, la máquina encendida de forma continua sale más cara que la API.
Tomemos 100.000 páginas al mes:
| Montaje | Coste mensual |
|---|---|
| Mistral OCR 4.1 | 400 $ |
| GPU alquilada, encendida todo el tiempo | 1.591 $ |
| GPU alquilada, encendida 7 horas y luego en pausa | 15 $, más los minutos de arranque |
Hace falta, por tanto, un sistema que arranque el contenedor cuando llegan documentos y lo ponga en pausa en cuanto la cola está vacía. Sin él, el open weight cuesta más que lo que sustituye.
Verda lo permite. Sus Serverless Containers bajan a cero máquinas cuando no hay nada que hacer y mantienen las peticiones en cola mientras arranca una máquina. Solo se facturan los minutos en que ha funcionado, arranque y parada incluidos.
Quedan dos ajustes a cargo del usuario. Primero, el umbral de arranque: despertar una GPU para tres documentos cuesta más que enviarlos a una API. En nuestro caso, la máquina arranca a partir de 50 documentos recibidos en un cuarto de hora y se pone en pausa tras diez minutos sin actividad. Después, qué hacer con los documentos que llegan durante el arranque, que lleva unos minutos. En nuestro caso, se envían al motor de respaldo sin esperar.
Más barato, e igual de soberano
Pasar de la API de un editor francés a un modelo publicado por Baidu no resta nada a la soberanía del montaje. Una IA soberana se juzga en tres capas: el derecho aplicable al proveedor, la infraestructura que trata los datos y los modelos que los leen.
El proveedor. Verda es una sociedad finlandesa, sujeta al derecho europeo, igual que Mistral es una sociedad francesa.
La infraestructura. Sus centros de datos están en Finlandia e Islandia, en un perímetro europeo cubierto por el RGPD. Es allí donde se convierten los documentos.
El modelo. PaddleOCR-VL se publica con licencia Apache 2.0: descargamos sus pesos una vez, y se ejecuta en nuestro propio contenedor. Ninguna página llega a su editor. El recorrido de los datos depende del lugar donde funciona el modelo y de quién opera la máquina. El país donde se entrenó no cambia nada.
En un punto, el open weight es incluso mejor que una API, francesa o no: nadie puede cambiar su precio. Unos pesos con licencia Apache 2.0 no duplican su tarifa en diciembre, y nadie los retira del catálogo. Ser soberano también es no depender de la tabla de precios de otro.
Mantenemos Mistral OCR en nuestra cadena, como respaldo. Es una decisión de coste y de riesgo, no de bandera.
Más allá de la tarifa por hora
La diferencia de precio es real. Tiene sus contrapartidas.
Mistral es más rápido
Con un solo documento, Mistral OCR 4.1 procesa una página en 0,20 segundos, frente a 0,43 a 0,56 de nuestro despliegue. La diferencia aumenta con carga: con ocho documentos enviados a la vez, Mistral alcanza de 18 a 20 páginas por segundo, mientras que nuestra máquina se queda en torno a 4. Y en una máquina saturada, un documento de una página que tarda 2 segundos solo espera más de 20 detrás de los grandes.
Ese techo es el de una sola máquina. Si el rendimiento es una prioridad, basta con alquilar varias: cada máquina añade sus 4 páginas por segundo, y el coste por página no se mueve mientras estén ocupadas. Nuestro millón de páginas requiere 69 horas en una GPU, es decir, casi tres días. Con cuatro GPU, se hace en 17 horas, por los mismos 151 $.
Varias máquinas no acortan la conversión de un documento suelto. Para un usuario que deposita un PDF en una conversación y espera su respuesta, la API sigue siendo más rápida.
Spot o API, hacen falta respaldos
Con tarifa spot, comprobamos con regularidad que nos retiran la máquina a mitad de trabajo. Muy poco por la noche, en cambio, y es de noche cuando se ejecuta la mayor parte de nuestros procesos.
La API no es más segura. En dos meses de producción, el 4,8 % de nuestras llamadas a Mistral OCR fallaron con un error 404: 402 llamadas de 8.320, casi una de cada veinte.
En todos los casos, hacen falta respaldos. Desaparezca una GPU o devuelva una API un error, la ingesta no debe detenerse: el documento se reenvía a otro motor, sin intervención. Ningún eslabón aguanta solo, y eso vale para el OCR como para el resto de la cadena de IA.
La calidad: equivalente en la revisión
Revisamos a ojo las salidas de los dos motores. PaddleOCR-VL y Mistral OCR dan resultados muy parecidos. Ambos lo hacen mejor que lo que observamos con LightOnOCR y con Docling.
Una medición automática completa esta revisión. Contamos, para cada motor, la proporción de palabras de la capa de texto de los PDF que recupera: 93,6 % para PaddleOCR-VL, 97,7 % para Mistral OCR 3 y 98,3 % para Mistral OCR 4.1. La mayor parte de esta diferencia es deliberada, ya que nuestra configuración elimina los encabezados, los pies de página y las notas a pie de página.
Quedan dos diferencias reales. Mistral transcribe el texto de las capturas de pantalla, mientras que PaddleOCR-VL las deja casi siempre como imágenes. Y PaddleOCR-VL escribe sus tablas en HTML, con entidades en lugar de apóstrofos, lo que exige una limpieza.
La medición automática se basa en 9 documentos, ninguno de ellos escaneado. Antes de decidir, lo sensato es probar los dos motores con cincuenta documentos propios.
Hay que explotarlo
Una imagen de contenedor de más de 15 GB, unos cinco minutos de arranque en frío, una facturación por tramos de diez minutos, el controlador que arranca y pone en pausa la máquina, un respaldo cuando no responde. Nada de esto es difícil por separado. El conjunto representa unas semanas de trabajo de ingeniería y, después, una supervisión continuada.
Cuándo cambiar y cuándo quedarse con la API
| Tu situación | La buena elección | Por qué |
|---|---|---|
| Poco volumen, sobre la marcha (unos miles de páginas al mes) | La API | Lo que está en juego se cuenta en decenas de dólares, una GPU no compensa el esfuerzo |
| Gran fondo documental o reprocesos regulares (cientos de miles de páginas) | El open weight en GPU alquilada | La GPU funciona a pleno rendimiento: de 10 a 26 veces más barato |
| Un usuario espera la respuesta delante de la pantalla | La API | Un documento suelto pasa más rápido, sin arranque que esperar |
| Se exige el control completo de la cadena | El open weight en GPU alquilada | El modelo se ejecuta en tu infraestructura, y nadie puede cambiar su precio |
| Volumen e interactividad | Los dos, en cadena | La GPU procesa el volumen, la API toma el relevo cuando está apagada o no disponible |
El último caso es el más frecuente. También es el único que exige construir algo.
En Ask This Guy, este trabajo ya está hecho
Nuestra cadena de ingesta encadena tres motores. PaddleOCR-VL en nuestras GPU de Verda pasa primero. Si no responde, el documento se envía a Mistral OCR, sin esperar a que arranque una máquina. Docling sirve de último recurso. Un controlador enciende la GPU cuando el volumen lo justifica y la pone en pausa tras diez minutos de inactividad.
El primer eslabón funciona en nuestras GPU en Finlandia e Islandia, y el respaldo lo asegura un editor francés. Hemos bajado el coste sin tocar el nivel de soberanía, que detallamos en nuestro enfoque de la IA soberana (en inglés).
Nuestros clientes no ven nada de esto. Depositan sus documentos o conectan sus fuentes, y luego los consultan en su asistente documental. Describimos las otras formas de ejecutar modelos, desde la GPU comprada hasta la plataforma llave en mano, en nuestra guía de la inferencia de IA en la empresa.
Preguntas frecuentes
¿Cuánto cuesta Mistral OCR?
A 30 de septiembre de 2026, Mistral OCR 4.1 cuesta 4 $ por cada 1.000 páginas y 2 $ con procesamiento por lotes. El modelo anterior, Mistral OCR 3, sigue disponible a 2 $ por cada 1.000 páginas. En el lanzamiento de marzo de 2025, la tarifa era de 1 $ por cada 1.000 páginas. Para un millón de páginas, hay que contar, por tanto, de 2.000 a 4.000 $ por pasada.
¿Qué diferencia hay entre un parser de PDF y un OCR?
Un parser de PDF lee el texto ya guardado en el archivo: es instantáneo y gratuito, pero no ve ni los documentos escaneados ni el texto contenido en las imágenes, y no reconstruye las tablas. Un OCR analiza la imagen de la página. Los OCR basados en IA reconocen además la estructura del documento (títulos, tablas, orden de lectura) y producen un texto estructurado, en general en Markdown.
¿Existe una alternativa open source a Mistral OCR?
Sí, varias. PaddleOCR-VL, publicado por Baidu con licencia Apache 2.0, es el que hemos elegido: un modelo de menos de mil millones de parámetros que cabe en una sola GPU. LightOnOCR, Docling, MinerU y DeepSeek-OCR son otras opciones. Todos exigen alquilar o poseer una GPU y explotar el despliegue por cuenta propia.
¿Es soberano un OCR open weight publicado por un editor chino?
Sí, si se ejecuta en una infraestructura que se controla. Un modelo open weight como PaddleOCR-VL, publicado por Baidu con licencia Apache 2.0, se descarga una vez y luego funciona en un contenedor propio: ningún documento se transmite a su editor. La soberanía depende entonces del operador de la máquina y de su ubicación. Desplegado en un operador sujeto al derecho europeo, en centros de datos situados en Europa, un OCR así es tan soberano como la API de un editor francés.
¿A partir de qué volumen sale rentable un OCR autoalojado?
En una GPU alquilada a 2,18 $ la hora, el OCR autoalojado cuesta menos que Mistral OCR 4.1 desde 545 páginas procesadas por hora facturada, y menos que Mistral OCR 3 desde 1.090 páginas. Para dividir la factura por diez, hacen falta unas 5.450 páginas por hora, es decir, una GPU ocupada al 38 %. Este cálculo supone que la máquina se pone en pausa en cuanto no tiene nada que procesar: encendida todo el tiempo, cuesta 1.591 $ al mes y solo sale rentable por encima de 400.000 páginas mensuales.
¿Es PaddleOCR-VL tan preciso como Mistral OCR?
En la revisión humana, los resultados de PaddleOCR-VL y de Mistral OCR son muy parecidos y mejores que los que observamos con LightOnOCR y Docling. En una medición automática sobre 173 páginas, PaddleOCR-VL recupera el 93,6 % de las palabras de la capa de texto de los PDF, frente al 97,7 % de Mistral OCR 3 y el 98,3 % de Mistral OCR 4.1. La mayor parte de esta diferencia procede de los encabezados, los pies de página y las notas a pie de página, que nuestra configuración elimina a propósito.
Conclusión
El OCR parece una línea de coste sin historia. Basta un millón de páginas y una tarifa que se duplica dos veces para que la tenga.
Un modelo open weight en una GPU alquilada en Europa reduce esa línea de 4.000 $ a unos pocos cientos, sin ceder nada en soberanía ni en calidad. Con una condición: que la máquina solo funcione cuando tiene trabajo.
Si tienes un fondo documental que quieres poder consultar y prefieres no construir todo esto por tu cuenta: reservar una demo.
Mediciones del 30 de septiembre de 2026: 9 PDF, 173 páginas, una máquina por despliegue, una o dos pasadas por motor. Precios públicos de Mistral y de Verda consultados el mismo día.