.webp)
RAG en IA: qué es y cómo conectar un LLM a tus documentos
¿Qué es el RAG en IA? Retrieval Augmented Generation explicado: funcionamiento, elección del LLM, búsqueda híbrida, RAG agéntico y experiencia en producción.

¿Qué es el RAG en IA?
El RAG en IA (Retrieval Augmented Generation, o generación aumentada por recuperación) es un enfoque que conecta un modelo de IA con tus propias fuentes. Ante cada pregunta, el sistema busca los pasajes pertinentes en tus documentos, tus bases de datos y tus herramientas, y después se los pasa al modelo, que redacta una respuesta basada en esos elementos y cita sus fuentes. El modelo no se vuelve a entrenar ni se modifica: lo que cambia es lo que lee antes de responder.
El problema: una IA que lo sabe todo… menos lo tuyo
¿Usas una IA de uso general (ChatGPT, Mistral Le Chat, Gemini, etc.) y te asombran sus capacidades? Hay motivos.
Pero ¿has probado a preguntarle por el último informe financiero de tu empresa o por un procedimiento interno? En cuanto las fuentes no son públicas, no puede hacer nada.
 IA incapaz de responder a preguntas sobre documentos internos de la empresa
Las IA como ChatGPT se entrenan con cantidades astronómicas de datos públicos. Son expertas en el mundo, pero no en tu mundo.
Para que una IA sea realmente útil internamente, necesita acceder a:
- tus documentos internos
- tus políticas de recursos humanos
- tus procesos de negocio
- tus herramientas (CRM, ERP, unidades compartidas)
- tus bases de datos
En resumen: todo lo que forma el ADN de tu empresa.
Los límites del «copiar y pegar»
Añadir documentos a mano en ChatGPT puede parecer una solución rápida y pragmática (dejando de lado los problemas de confidencialidad).
Pero en la práctica:
- lleva mucho tiempo
- no siempre se sabe qué archivos son realmente pertinentes
- se envían demasiados documentos o archivos demasiado grandes, lo que hace que la IA sea menos eficaz
- se olvidan documentos o no se suben las versiones correctas
- no integra la información de un CRM o de una unidad compartida
Resultado: el conocimiento interno nunca está completo ni estructurado. Es un problema antiguo, que las iniciativas de gestión del conocimiento nunca han resuelto del todo, y explicamos por qué en Gestión del conocimiento: por qué fracasan sus iniciativas.
La ventana de contexto: el talón de Aquiles de nuestras IA favoritas
La IA tiene una memoria de trabajo muy eficaz... pero limitada. Es su ventana de contexto: solo puede procesar una cierta cantidad de información a la vez.
Límites concretos
Los modelos recientes ofrecen ventanas de contexto de varios cientos de miles de tokens, a veces más. Traducido a páginas, hablamos de unos pocos cientos a algo más de mil páginas según el modelo.
Parece mucho. Pero si envías diez documentos de 300 páginas, ya has superado el límite.
Sobre todo, el tamaño anunciado no es una garantía de calidad. Cuanto más cargado está el contexto, más precisión pierde el modelo: olvida pasajes, confunde fuentes o se apoya en el párrafo equivocado. Es lo que a veces se llama dilución del contexto. Por eso es mejor seleccionar de antemano lo que se envía, para que solo la información pertinente llegue al modelo.
Aquí entra el RAG: la solución para una IA «bien informada»
El RAG (Retrieval Augmented Generation) es un enfoque en el que:
- La herramienta se conecta a tus fuentes y preprocesa los documentos para las futuras búsquedas
- Para cada consulta, busca los «fragmentos» de documentos pertinentes («Retrieval»)
- Envía a la IA la consulta enriquecida con esos documentos pertinentes («Augmented»)
- La IA genera después una respuesta precisa basada en esos elementos («Generation»)
Es como si añadieras a tu IA un bibliotecario ultrarrápido y ultrapreciso.
 Un bibliotecario rápido y preciso
Conviene tener en cuenta que el RAG no modifica el modelo. El LLM sigue siendo el mismo: lo que cambia es lo que se le da a leer antes de que responda. Es una diferencia esencial para lo que sigue.
RAG y LLM: ¿quién hace qué en la cadena?
Se habla a menudo de RAG LLM como si se tratara de una sola tecnología. En realidad son dos piezas distintas, y saber cuál hace qué evita la mayoría de los errores de diseño.
El LLM (Large Language Model, modelo de lenguaje) es el generador. Entiende la pregunta, razona sobre lo que se le proporciona y redacta la respuesta. No sabe nada de tu empresa y no tiene ningún acceso a tus sistemas.
El RAG es la capa que lo rodea. Prepara tus documentos, encuentra los pasajes útiles en el momento de la pregunta y los coloca en el contexto del LLM antes de llamarlo.
En una cadena RAG, cada llamada al LLM se desarrolla así:
| Etapa | Quién la realiza | Qué ocurre |
|---|---|---|
| 1. Preparación | El RAG | Tus documentos se dividen, se vectorizan y se indexan, antes de cualquier pregunta |
| 2. Búsqueda | El RAG | La pregunta se transforma en consulta y se encuentran los pasajes pertinentes |
| 3. Ensamblaje | El RAG | Pregunta, extractos e instrucciones se reúnen en un contexto único |
| 4. Generación | El LLM | El modelo redacta la respuesta a partir de ese contexto |
| 5. Atribución | El RAG | Las fuentes correspondientes se vinculan a la respuesta |
De ello se derivan tres consecuencias prácticas.
El LLM no aprende nada de tus documentos. Los lee en cada consulta y después los olvida. Es una buena noticia para la confidencialidad, y significa que una actualización de tus fuentes se tiene en cuenta inmediatamente, sin volver a entrenar nada.
La calidad de un RAG se juega sobre todo fuera del LLM. Si la etapa 2 recupera los pasajes equivocados, ningún modelo corregirá el error: redactará una respuesta fluida y falsa. En nuestros proyectos, la mayor parte de las mejoras de pertinencia procede de la división en fragmentos, la búsqueda y el filtrado, no de la elección del modelo.
Se puede cambiar de LLM sin rehacer el RAG. Es la ventaja de una arquitectura multimodelo: la misma base documental puede atenderla un modelo rápido y económico para las preguntas sencillas y un modelo más potente para los análisis complejos.
¿Qué LLM elegir para un RAG?
La pregunta llega pronto, y la respuesta no es «el modelo más grande disponible». Cinco criterios cuentan de verdad:
- El respeto de las instrucciones. Un buen LLM para RAG se ciñe a los extractos proporcionados y dice que no lo sabe cuando la información no está. Un modelo brillante pero hablador, que rellena los huecos con sus conocimientos generales, es una mala elección.
- La capacidad de citar. Vincular cada afirmación al extracto del que procede es una competencia desigual de un modelo a otro.
- La ventana de contexto. Suficiente para acoger una decena de extractos y el historial de la conversación, sin excesos: más allá, la precisión se degrada y el coste se dispara.
- El coste y la latencia. Un asistente interno consultado cien veces al día no tiene el mismo perfil económico que un análisis mensual de expedientes.
- El idioma y la jurisdicción. La calidad en cada idioma varía según el modelo, y el lugar donde se procesan las consultas es un criterio en sí mismo en cuanto los documentos son sensibles. Detallamos este equilibrio en nuestra página sobre la IA soberana.
En la práctica, un modelo de gama media disciplinado da mejores resultados en un RAG de empresa que un modelo de gama alta mal encuadrado. El LLM es un componente sustituible; tu cadena documental, no.
RAG, fine-tuning o contexto largo: ¿qué elegir?
Tres enfoques permiten que una IA sea más pertinente en tu negocio. No responden a la misma necesidad, y a menudo se oponen sin razón.
| Qué hace | Cuándo es la opción correcta | Límite principal | |
|---|---|---|---|
| RAG | Busca la información en tus fuentes en el momento de la pregunta | Conocimientos numerosos, que cambian y que deben citarse | Exige un verdadero trabajo de ingeniería sobre los datos |
| Fine-tuning | Reentrena el modelo para darle un estilo, un formato, un vocabulario | Hacer que adopte un tono, una nomenclatura, un formato de salida | No aporta conocimiento fiable y verificable, y envejece rápido |
| Contexto largo | Envía los documentos directamente en la pregunta | Corpus pequeño y estable, uso puntual | Caro, lento, y la precisión se degrada cuando aumenta el volumen |
La confusión más frecuente tiene que ver con el fine-tuning. Muchas empresas piensan que entrenar un modelo con sus documentos le hará «aprender» su empresa. En la práctica, el modelo aprende sobre todo una manera de hablar. No sabrá decirte qué versión del contrato está vigente hoy, y no citará ninguna fuente. Para el conocimiento, la respuesta es el RAG.
Los tres se combinan, además, muy bien: un RAG sólido para el conocimiento, una ventana de contexto holgada para razonar sobre lo recuperado y, eventualmente, fine-tuning para el estilo.
Dentro del motor del RAG: ¿cómo funciona de verdad?
Para profundizar, puede consultarse nuestra documentación sobre el tratamiento de los datos y el RAG (en inglés).
Etapa 1: La división inteligente (chunking)
Ante todo, tus documentos deben convertirse en texto aprovechable:
- extracción de los párrafos
- recuperación del texto de las tablas
- interpretación de esquemas, gráficos, etc. (esta parte es importante, porque a menudo contienen información útil y aprovechable)
Después llega la división en chunks. Un buen chunk debe ser:
- corto → para caber en la ventana de contexto
- coherente → una idea clara por bloque
- aislado → sin mezcla de conceptos
No se le da a la IA todo un documento. Se le da el párrafo que responde exactamente a la pregunta.
Etapa 2: El mecanismo de búsqueda (la magia de los embeddings)
Para comparar los textos, el RAG transforma:
- tu pregunta
- tus chunks
...en vectores numéricos: son los embeddings. Dos chunks cercanos en sentido → sus vectores están cerca.
Dos tipos de búsqueda imprescindibles
- Búsqueda semántica (por el sentido)
Ideal para las preguntas conceptuales: «¿Cómo se piden unas vacaciones?»
- Búsqueda por palabras clave (por la precisión)
Esencial para los términos específicos sin significado universal:
- «Referencia de producto XYZ-123»
- «Procedimiento PNC-V4»
- «Jean-Pierre Dubreuil»
Porque una IA no conoce a Jean-Pierre Dubreuil, del departamento de contabilidad...
Los dos mecanismos son complementarios. Un RAG solo «semántico» (aunque es frecuente) fallará en este tipo de búsquedas.
El esquema de un RAG, paso a paso
Este es el esquema RAG completo, con sus dos fases: la preparación de las fuentes por un lado y el tratamiento de cada pregunta por el otro. La primera solo se repite cuando se añaden o actualizan documentos; la segunda se repite cada vez que un usuario hace una pregunta.
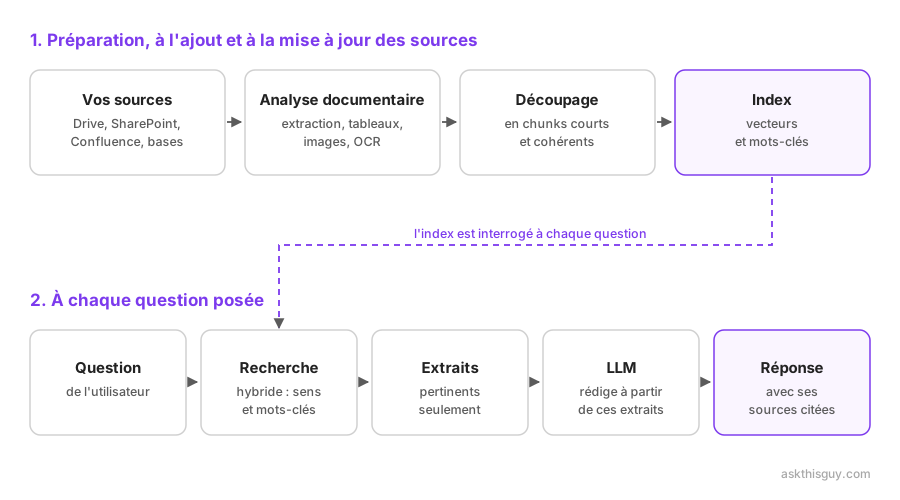 Esquema RAG en dos fases: preparación de las fuentes (análisis documental, división en chunks, indexación en vectores y palabras clave) y después tratamiento de una pregunta (búsqueda híbrida, extractos pertinentes, generación por el LLM, respuesta con fuentes)
Este esquema describe el RAG tal como se enseña y tal como se implementa en la mayoría de las demostraciones: una pregunta, una búsqueda, una respuesta. Es una buena manera de entender el principio. Ya no es la manera en que funcionan los sistemas serios.
Del RAG lineal al RAG agéntico
El esquema anterior parte de un supuesto fuerte: una sola búsqueda basta para responder. En la vida real de las empresas, rara vez es así.
Tomemos una pregunta tal como la plantea de verdad un directivo: «¿Estamos cumpliendo nuestros compromisos con Durand en el periodo?»
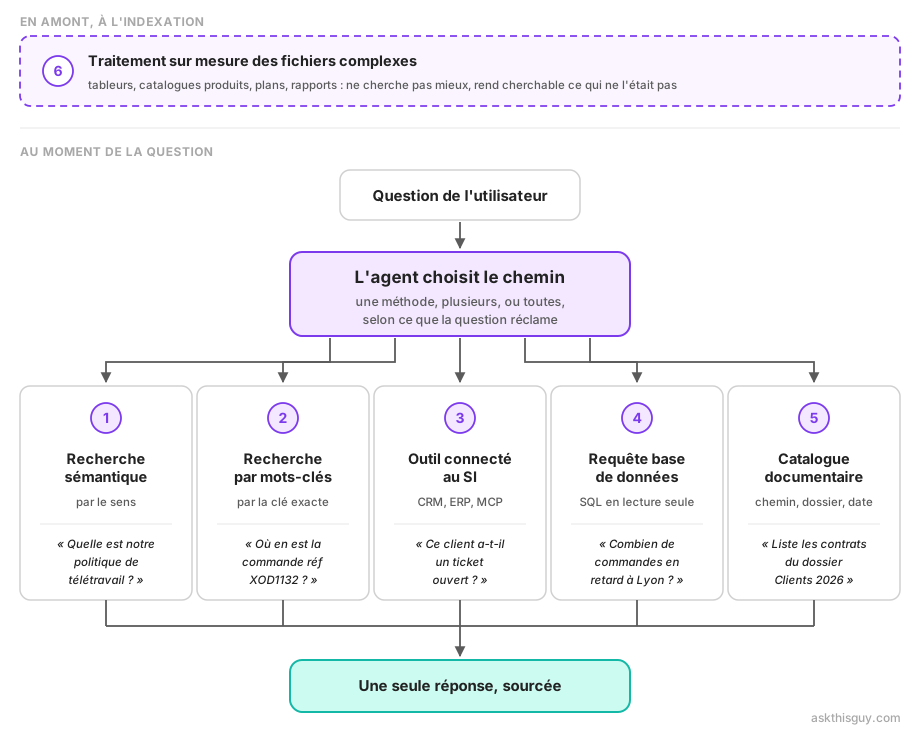
Nada en esta frase dice dónde buscar. Ni qué compromisos, ni qué periodo, ni en qué sistema. Es el sistema el que tiene que descubrirlo. Primero debe encontrar lo que materializa nuestras obligaciones con Durand, un contrato, una adenda, un acuerdo de servicio, y después leer en ellos lo comprometido: un plazo de respuesta, un número de intervenciones incluidas, una tasa de disponibilidad. Solo al leer esos documentos se entera de que el periodo de compromiso es el año natural. Entonces puede buscar en la herramienta de tickets los tickets del año vinculados a los contratos correctos y compararlos con los umbrales que acaba de descubrir.
Dos fuentes de naturaleza distinta y, sobre todo: la segunda consulta no puede formularse antes de leer el resultado de la primera.
Es exactamente lo que hace un RAG agéntico (agentic RAG). En lugar de ejecutar una búsqueda única, un agente orquestador lleva a cabo una investigación:
- analiza la pregunta y la reformula, a veces en varias subpreguntas
- elige la fuente o las fuentes que va a consultar
- lee lo que obtiene y decide si sabe lo suficiente
- si no es así, lanza una búsqueda mejor orientada, con lo que acaba de aprender
- solo redacta la respuesta cuando ha reunido los elementos, citando sus fuentes
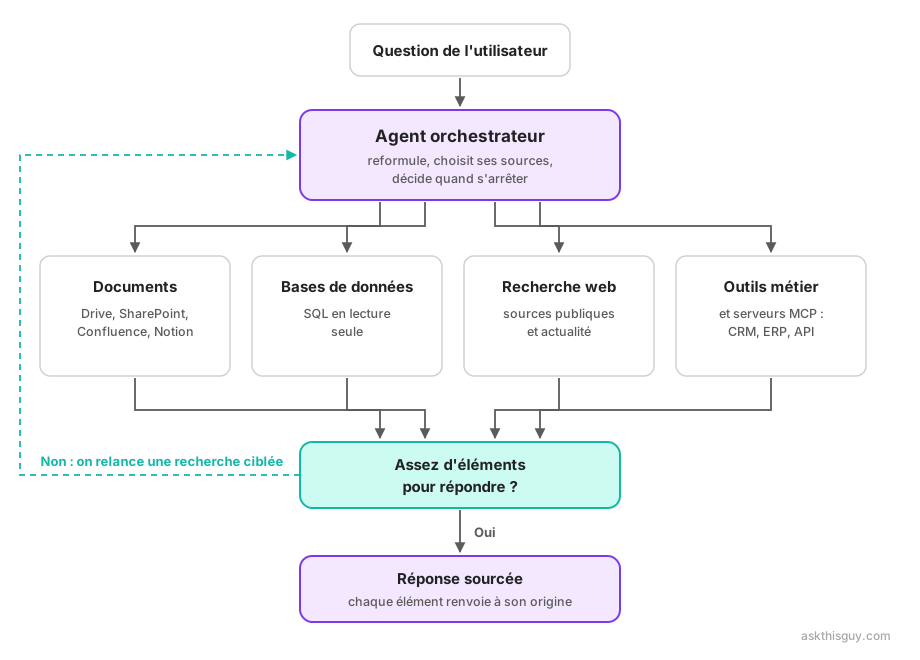 Esquema de un RAG agéntico: el agente orquestador consulta documentos, bases de datos, la web y herramientas de negocio, evalúa si tiene suficientes elementos, lanza una búsqueda dirigida si es necesario y después produce una respuesta con fuentes
La diferencia con el esquema anterior se reduce a una sola flecha: la que vuelve hacia el agente. Pesa más que la elección del modelo: con los informes financieros de FinanceBench, Mistral demostró que, con el mismo modelo, la precisión pasa del 26,7 % al 86 % según la forma en que el software encadena las búsquedas. Sacamos las consecuencias para la due diligence en otro artículo.
Cuatro consecuencias prácticas, a menudo subestimadas.
El conocimiento ya no es solo documental. Un agente puede consultar en la misma conversación tus documentos, una base SQL en modo de solo lectura, la web y tus herramientas de negocio expuestas mediante servidores MCP o herramientas a medida. El usuario hace una sola pregunta y no tiene por qué saber dónde vive la información.
Las idas y vueltas cuestan tiempo y tokens. Un agente que investiga consume más que una búsqueda única. Hay que limitar el número de iteraciones, saber cuándo parar y vigilar los costes. Un sistema agéntico mal encuadrado es un sistema lento y caro.
La trazabilidad se vuelve imprescindible. Cuando una respuesta resulta de cuatro llamadas a tres fuentes, el usuario tiene que poder comprobar de dónde viene cada elemento. Sin citas, un RAG agéntico es una caja negra, y nadie confía en una caja negra para decidir.
El volumen deja de ser un techo. Un RAG lineal busca en todo el corpus en cada pregunta, y su precisión baja más allá de unos pocos miles de documentos. Un agente empieza por reducir el perímetro (fuente, carpeta, cliente, fecha) y después busca en ese subconjunto: es lo que permite superar los 100.000 documentos. El mecanismo se detalla en ¿cuántos documentos puede tratar un RAG?
IA y análisis de documentos: lo que se juega antes de la búsqueda
Se habla mucho de los modelos y de los agentes. En los proyectos reales, lo que hace fracasar un RAG casi siempre está antes: en el análisis de los documentos.
Tus conocimientos no son texto limpio. Son PDF escaneados, presentaciones, hojas de Excel, planos, contratos con anexos, actas redactadas deprisa. Cada formato plantea su problema.
- Los PDF escaneados exigen un reconocimiento de caracteres (OCR). Un OCR mediocre produce un texto plagado de errores, y un chunk ilegible nunca se encontrará.
- Las tablas pierden su estructura cuando se convierten a texto de forma ingenua. Basta una columna mal alineada para que la cifra del segundo trimestre acabe atribuida al tercero.
- Los esquemas y gráficos contienen a menudo la información más densa de un documento. Ignorarlos equivale a tirar la mitad del valor de una presentación comercial.
- Los documentos largos y heterogéneos (un manual de calidad de 200 páginas, por ejemplo) deben dividirse respetando su estructura lógica, no cada 500 caracteres.
- Las versiones múltiples plantean una cuestión que no es técnica: ¿qué documento es el que vale? Un RAG que indexa tres versiones de un procedimiento responderá a veces con la equivocada.
Por eso el análisis documental con IA no se reduce a «conectar una carpeta». Cada empresa tiene formatos, convenciones y excepciones propios, y el tratamiento debe adaptarse a ellos. Es el trabajo menos visible de un proyecto RAG y, con diferencia, el más determinante.
Un ejemplo de RAG de principio a fin
Volvamos a «¿Estamos cumpliendo nuestros compromisos con Durand en el periodo?», en un sistema agéntico.
- Recepción. La pregunta no designa ni documento, ni sistema, ni fechas. Tres incógnitas: de qué compromisos se habla, en qué periodo y dónde están los hechos que permiten medirlos.
- Primera búsqueda. Búsqueda híbrida en los documentos. La búsqueda por palabras clave encuentra «Durand», un nombre propio al que ninguna búsqueda semántica sabría apuntar sola; en paralelo, la búsqueda semántica recupera los pasajes que hablan de niveles de servicio y plazos de intervención. El agente obtiene un contrato marco, una adenda y un acuerdo de servicio.
- Lectura y decisión. La adenda sustituye dos cláusulas del contrato marco. El agente se queda con la versión vigente y lee en ella los compromisos cuantificados: plazo de respuesta, número de intervenciones incluidas y un periodo de compromiso anual. Acaba de aprender lo que no sabía al principio.
- Segunda fuente, formulada a partir de la primera. Solo ahora puede el agente consultar la herramienta de tickets mediante la herramienta de consulta a la base de datos: los tickets del año vinculados a esos contratos concretos, con sus plazos de respuesta reales.
- Comparación. El agente contrasta las cifras obtenidas con los umbrales que ha leído y detecta las desviaciones.
- Generación. Respuesta estructurada compromiso por compromiso, con el enlace a la cláusula contractual correspondiente y el detalle de los tickets afectados.
Una sola pregunta, dos fuentes y una cadena en la que la etapa 4 era imposible de escribir antes de la etapa 3. Es este mecanismo el que el usuario no ve, y es el que marca la diferencia entre un juguete y una herramienta de trabajo.
RAG con ChatGPT, Gemini, Claude o Copilot: lo que cambia
Pregunta frecuente: «Ya tenemos ChatGPT Enterprise (o Copilot, o Gemini). ¿No hace eso ya RAG?»
En parte, sí. Estas herramientas saben leer los archivos que se les dan, y algunas se conectan a un espacio de trabajo (Microsoft 365 en el caso de Copilot, Google Workspace en el de Gemini). Para una búsqueda sencilla dentro de un perímetro que ya cubre el proveedor, suele bastar.
Los límites aparecen enseguida en cuanto se sale de ese perímetro.
- El perímetro es el del proveedor. Copilot es excelente en SharePoint y Teams. No conoce tu gestor documental de negocio, tu ERP propio ni tu base PostgreSQL.
- No controlas la cadena de tratamiento. La división en fragmentos, el modelo de embeddings y la estrategia de búsqueda son decisiones del proveedor. Si tus documentos se salen del caso estándar, no tienes margen de maniobra.
- El modelo viene impuesto. Se usa el del proveedor, sin posibilidad de cambiarlo si otro es mejor o más barato para tu caso de uso.
- La ubicación de los datos depende del proveedor. Es un punto estructural para muchas organizaciones europeas.
El verdadero criterio no es, por tanto, «RAG o no RAG», sino: ¿hasta dónde puedes adaptar la cadena a tus datos, y conservas el control de las decisiones técnicas? Desarrollamos este punto en nuestro artículo sobre los errores de RAG en la empresa después del POC.
No todos los RAG son iguales: el arte de elegir bien la solución
El mercado está lleno de RAG «rápidos de integrar», pero... como en el famoso sketch de los cazadores del grupo cómico francés Les Inconnus: están los buenos y los malos.
Lo que marca la diferencia:
- Calidad de la conversión → no saber extraer los datos de un gráfico = perder una información importante
- Calidad de la división → chunks demasiado grandes o incoherentes = IA confundida
- Elección de los modelos de embeddings → no todos destacan en los mismos ámbitos
- Búsqueda híbrida → solo semántica = errores con los nombres propios
- Capacidad de investigación → un motor que solo sabe hacer una pasada fallará en cualquier pregunta mínimamente compuesta
- Trazabilidad → sin citas verificables, los usuarios dejan de usar la herramienta a la primera duda
Un mal RAG puede volver a la IA vaga, aproximada, incapaz de encontrar información que sin embargo está ahí.
No es teórico. En el benchmark que operamos de forma continua desde un servidor situado en Francia, más del 95 % de las llamadas de embeddings tardaban menos de un segundo en enero de 2026, pero algunos días se salían por completo de lo normal, hasta el punto de hacer fracasar una demo con un cliente en directo. Contamos el episodio y lo que aprendimos de él en nuestra estrategia de embeddings. En la generación de texto, nuestro benchmark del primer trimestre de 2026 muestra diferencias de tasa de éxito entre proveedores tan marcadas que un RAG de empresa nunca debería depender de un solo modelo: es el segundo de los 5 errores que aparecen después del POC.
Otro punto capital es la integración de herramientas complementarias. Si tu necesidad se limita a la búsqueda interna, basta con un RAG. Pero, por lo general, también querrás buscar en la web, consultar datos en bases de datos, lanzar acciones, etc. La integración de estas herramientas multiplica la potencia de tu IA.
El RAG es ingeniería
Existen claramente buenas prácticas y opciones «genéricas» que funcionan bastante bien. Pero no hay receta mágica.
Cada empresa tiene formatos y datos específicos que requieren tratamientos particulares para obtener buenos resultados.
El enfoque de Ask This Guy (ATG): lo mejor del RAG, sin complicaciones
En Ask This Guy hemos pasado miles de horas haciendo benchmarks, probando, rompiendo y mejorando pipelines RAG. Nuestra solución RAG para empresas industrializa estas piezas para tus equipos.
Ofrecemos:
- Conversión y división optimizadas
Numerosos conectores, gestión de documentos complejos, tablas, diapositivas, imágenes, etc.
- Búsqueda híbrida inteligente
Semántica + palabras clave para una precisión máxima.
- Un agente orquestador, no una simple búsqueda
El asistente decide qué fuentes consultar, vuelve a buscar cuando le falta un elemento y cruza documentos, bases de datos y herramientas de negocio en una misma conversación.
- Personalización a fondo
Adaptamos las conversiones a tus documentos y podemos desarrollar algoritmos específicos. Podemos usar un modelo de embeddings adaptado a tu actividad.
- Flexibilidad total
Conservas el control de tus datos. Y si algún día deseas internalizar la solución, recuperas tus desarrollos específicos.
- Un solo RAG para todos tus usos
La misma inteligencia puede desplegarse en varias interfaces: consola de administración, chatbots en tu web, widget integrado en su producto SaaS, API para tus herramientas internas, etc.
- Un software que combina varias herramientas, no solo el RAG
- búsqueda en tus unidades compartidas
- búsqueda web
- integración con tus herramientas internas
- tratamiento documental avanzado
El objetivo: una IA que conozca tu empresa tan bien como un empleado experimentado.
Preguntas frecuentes
¿Qué es el RAG en IA?
El RAG (Retrieval Augmented Generation) es un enfoque que conecta un modelo de IA con tus propias fuentes. Ante cada pregunta, el sistema busca los pasajes pertinentes en tus documentos, tus bases de datos o tus herramientas, y después se los pasa al modelo, que redacta una respuesta basada en esos elementos, con sus fuentes.
¿Qué diferencia hay entre un LLM y un RAG?
Un LLM es el modelo de lenguaje que redacta la respuesta. El RAG es lo que lo rodea: la cadena que busca la información correcta antes de recurrir a él. El RAG no sustituye al LLM ni lo modifica: le da lo necesario para responder bien.
¿Cómo amplía el RAG a un LLM?
El RAG no amplía las capacidades del modelo, amplía lo que tiene delante. Ante cada pregunta, la cadena encuentra los pasajes pertinentes en tus fuentes y los inserta en el contexto del LLM antes de la llamada. El modelo redacta entonces su respuesta a partir de esos extractos y no solo de su memoria de entrenamiento, y puede indicar de dónde procede cada elemento.
¿Qué LLM elegir para un RAG?
Conviene un modelo disciplinado antes que el más potente: debe ceñirse a los extractos proporcionados, reconocer que no lo sabe cuando la información no está y saber citar sus fuentes. Los demás criterios son la ventana de contexto, el coste por consulta, la latencia esperada, la calidad en el idioma de trabajo y la jurisdicción en la que se procesan las consultas. Un modelo de gama media bien encuadrado suele superar a un modelo de gama alta mal encuadrado.
¿Hay que reentrenar el LLM con los propios documentos?
No, en la gran mayoría de los casos. Un LLM utilizado en una cadena RAG lee tus documentos en cada consulta sin memorizarlos, lo que hace que las actualizaciones sean inmediatas y evita que tus contenidos queden expuestos en los pesos del modelo. El fine-tuning sigue siendo útil para imponer un estilo o un formato de salida, no para transmitir conocimiento.
¿Sustituye el RAG al fine-tuning?
No, los dos responden a necesidades distintas. El fine-tuning actúa sobre el estilo, el formato y el vocabulario. El RAG aporta el conocimiento, actualizado y verificable. Para responder a partir de documentos de empresa, lo que hace falta es el RAG.
¿Cuánto tiempo lleva implantar un RAG en la empresa?
Un prototipo se monta en unos días. Un sistema fiable en producción exige más, porque la mayor parte del trabajo tiene que ver con tus formatos documentales, los permisos de acceso, la evaluación de la calidad de las respuestas y el seguimiento de los costes. Es precisamente la distancia entre ambos lo que hace fracasar muchos proyectos.
¿Se puede alojar un RAG en Europa u on-premise?
Sí, y es un criterio frecuente en las organizaciones europeas. Ahora bien, no hay que confundir alojamiento local y soberanía real: detallamos este matiz en nuestro artículo sobre la ilusión del LLM local.
Conclusión: dar voz a los datos de tu empresa con el RAG
El RAG no es solo una tecnología: es una estrategia de inteligencia documental.
Transforma una IA genérica en un verdadero experto interno, capaz de:
- responder con precisión a las preguntas
- sintetizar documentos complejos
- agilizar los procesos
- ayudar a la toma de decisiones
Pero el listón ha subido. Un RAG que se limita a una búsqueda única en una carpeta de PDF ya no basta. Lo que marca la diferencia hoy es la capacidad de analizar correctamente tus documentos, de investigar en varias fuentes y de justificar cada respuesta.
Si buscas una IA que entienda de verdad tu empresa, es ahí donde hay que mirar. Y podemos ayudarte a ponerla en marcha.
Reservar una demo para hablarlo sobre tus propios documentos.