Hybrid search: las 6 formas de encontrar información
Hybrid search explicada: búsqueda semántica, palabras clave, herramientas de negocio, consulta a base de datos, catálogo y tratamiento a medida para un agente.

Para entender por qué hace falta la hybrid search, o búsqueda híbrida, basta con un martes por la mañana cualquiera en una empresa de 300 personas. Seis empleados buscan una información. Ninguno busca lo mismo, y ninguna de sus preguntas se resuelve con el mismo mecanismo.
- «¿Se puede teletrabajar tres días por semana?»
- «¿Cómo va el pedido de JP Dupont, referencia XOD1132?»
- «¿Tiene este cliente una incidencia de soporte abierta ahora mismo?»
- «¿Cuántos pedidos van con retraso en el centro de Lyon?»
- «¿Cuántos contratos hay en la carpeta Clientes 2026, y cuáles?»
- «¿Qué opciones incluye la gama Horizon?»
Estas seis preguntas parecen similares. Técnicamente, no tienen casi nada en común: entender un sentido, encontrar una cadena exacta, llamar a un sistema externo, calcular un resultado, leer una estructura de carpetas. La sexta, como veremos, ni siquiera se juega en el momento de la pregunta.
Y aún son fáciles, porque cada una se resuelve por una sola vía. Un directivo, en cambio, hace preguntas que combinan varias, en un orden que no se conoce de antemano.
De ahí la búsqueda híbrida. Un asistente que solo domina una de estas vías responderá solo a una fracción de las preguntas de tus equipos. Veamos las seis y, después, qué ocurre cuando hay que encadenarlas.
1. La información está enterrada en un documento: la búsqueda semántica
«¿Se puede teletrabajar tres días por semana?»
La respuesta existe. Está en la página 34 de un convenio de empresa de 60 páginas, en un párrafo que no contiene ni la palabra «tres» ni la palabra «teletrabajo», sino la fórmula «modalidades de trabajo a distancia, con un límite del 60 % del tiempo mensual».
Ninguna búsqueda por palabra exacta encontrará ese pasaje. La búsqueda semántica sí lo encuentra, porque compara sentidos y no palabras: los documentos se dividen en fragmentos que se convierten en vectores, y la pregunta pasa por la misma conversión. Es el principio de la búsqueda densa descrita por Karpukhin et al. en 2020, que entonces superaba a un BM25 bien ajustado en varios conjuntos de preguntas y respuestas. Dos formulaciones que quieren decir lo mismo quedan cerca en ese espacio.
Es la pieza fundacional del RAG: el artículo de Lewis et al. que introdujo el RAG ya se apoyaba en un índice vectorial. Es también la que todo el mundo conecta primero. Con razón, es espectacular. El problema empieza cuando uno se queda ahí.
2. La información cabe en un nombre o una referencia: la búsqueda por palabras clave
«¿Cómo va el pedido de JP Dupont, referencia XOD1132?»
XOD1132 es una clave, no un concepto. Lo mismo ocurre con JP Dupont, Proyecto Atlas o PRD-19-B. Estas cadenas no tienen vecindad semántica: un modelo de embeddings no sabe que XOD1132 está más cerca de XOD1133 que de la política de vacaciones, y no tiene ningún motivo para saberlo.
En este tipo de consulta, la búsqueda vectorial sola devuelve ruido verosímil. Anthropic llega a la misma conclusión: un modelo de embeddings puede pasar por alto la coincidencia exacta de un código como «TS-999». Hace falta una búsqueda léxica, como el BM25 formalizado por Robertson y Zaragoza, que encuentra la cadena exacta allí donde aparece.
Y tus equipos usan ese vocabulario todo el día. Una empresa habla mucho más en referencias de clientes, códigos de proyecto y siglas internas que en conceptos. Por eso incluimos el «todo vectorial» entre los errores que alcanzan a un RAG después del POC: la demo funciona, la producción se rompe.
La búsqueda semántica encuentra lo que querías decir. La búsqueda por palabras clave encuentra lo que escribiste. Hacen falta las dos.
Queda fusionar dos listas de resultados cuyas puntuaciones no son comparables: ese es el papel de la fusión RRF y del reranking. La fusión RRF, propuesta por Cormack, Clarke y Büttcher en 2009, ordena cada documento según su posición en cada lista y no según su puntuación.
3. La información no está en ningún documento: la herramienta conectada a los sistemas de información
«¿Tiene este cliente una incidencia de soporte abierta ahora mismo?»
Aquí no sirven ni el sentido ni las palabras clave: la información no existe en ningún documento. Vive en la herramienta de tickets, en el CRM, en el ERP. Y como cambia en cuestión de horas, indexarla sería de todos modos una mala idea.
Hay que llamar al sistema que tiene el dato, en el momento de la pregunta. Mediante un servidor MCP cuando el fabricante lo ofrece, o mediante una herramienta a medida cuando hay que conectarse a una API interna. El protocolo MCP, publicado por Anthropic en noviembre de 2024, ha abaratado mucho esta conexión con respecto a hace dos años.
4. La información aún no existe, se calcula: la consulta a la base de datos
«¿Cuántos pedidos van con retraso en el centro de Lyon, y qué clientes están afectados?»
Esta respuesta no está escrita en ninguna parte. Se calcula cruzando líneas de pedido, fechas comprometidas y un código de centro.
Es el papel de una herramienta de consulta a la base de datos: el asistente traduce la pregunta a una consulta SQL, la ejecuta en modo de solo lectura sobre un perímetro autorizado y devuelve el resultado. Tus datos más fiables y más recientes suelen estar ahí, en bases estructuradas que nadie consulta porque hay que abrir un ticket al equipo de datos. Desarrollamos este punto en Tus bases de datos son una mina de oro.
5. La pregunta trata de los propios documentos: el catálogo documental
«¿Cuántos contratos hay en la carpeta Clientes 2026, y cuáles?»
Pregunta trampa para un RAG clásico. Una búsqueda semántica devolverá diez pasajes que hablan de contratos, sin saber contarlos ni garantizar que lo ha visto todo. Ante una pregunta de inventario, un sistema que responde «una quincena, más o menos» es peor que uno que no responde.
La pregunta trata de la propia base documental: su estructura de carpetas, sus rutas, sus fuentes, sus fechas. Hace falta una herramienta que consulte el catálogo de forma determinista, y no el texto.
Es lo que hace nuestra consulta del catálogo documental. Responde a los «cuántos», a los «enumera las subcarpetas de», a los «qué documentos vienen de este SharePoint», y sirve también para localizar un archivo concreto antes de leer su contenido.
6. La información está ahí, pero es ilegible: el tratamiento a medida
«¿Qué opciones incluye la gama Horizon?»
La respuesta está en un archivo que ya has indexado. Está en una hoja de cálculo de 40 columnas, donde cada fila es una referencia y cada columna una opción, con cruces, celdas combinadas y tres filas de encabezado. O en un plano de implantación, o en un catálogo de productos exportado de un ERP.
Ninguno de los cinco métodos anteriores salvará este archivo. Dividida en fragmentos de texto como un documento corriente, una hoja de cálculo produce chunks del tipo Horizon ; X ; ; X ; 2 ; ; sí. Sintácticamente es texto; semánticamente, ruido. Puede que el pasaje se encuentre, pero no querrá decir nada, ni para el modelo ni para el usuario que lea la cita.
Esta sexta vía es de otra naturaleza: hace buscable lo que no lo era. Interviene en la indexación, no en el momento de la pregunta.
En concreto, nuestro tratamiento a medida asocia un criterio de activación (un tipo de archivo, un patrón en el nombre, una estructura reconocible) y unas reglas de extracción escritas para ese formato preciso: qué significa cada columna, qué filas son totales, qué unidad se aplica. El archivo entra como hoja de cálculo y sale como conocimiento aprovechable, con sus citas.
No aplicamos a propósito ningún tratamiento genérico a todos los Excel. Una hoja de cálculo sin su contexto de negocio sigue siendo un dato en bruto: la columna «Importe» puede estar en euros o en dólares, el «Estado» puede ser el del pedido o el del proyecto. Un análisis automático produce ruido con apariencia de respuesta, y es el peor resultado posible.
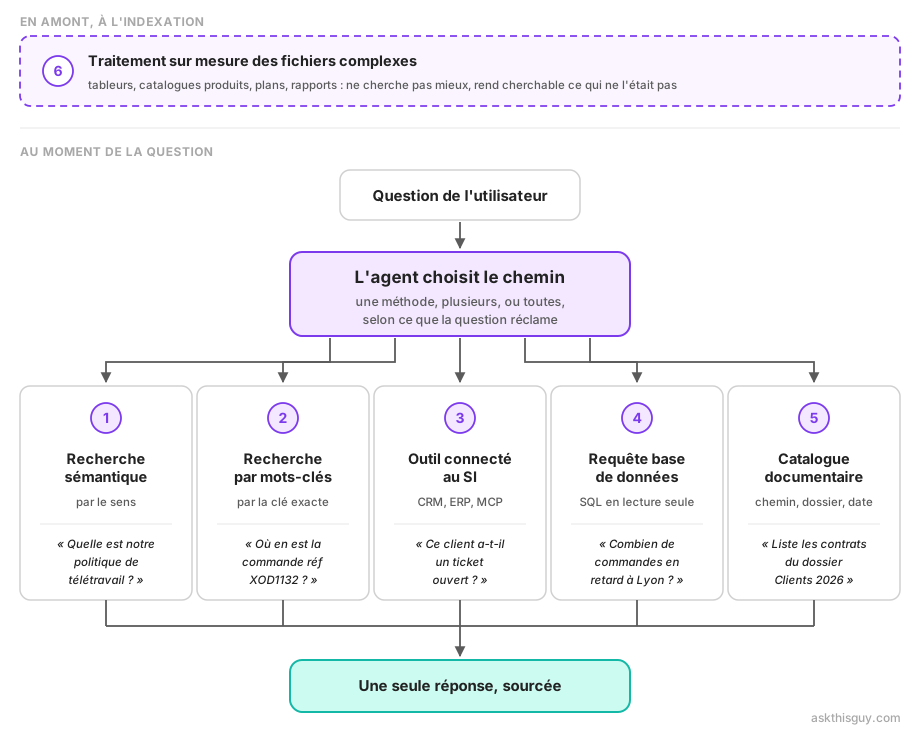
Esquema de las seis vías complementarias para encontrar una información: antes, en la indexación, el tratamiento a medida de los archivos complejos; después, en el momento de la pregunta, la búsqueda semántica, la búsqueda por palabras clave, la herramienta conectada al sistema de información, la consulta a la base de datos y la consulta del catálogo documental, movilizadas por un mismo agente para producir una respuesta única y con fuentes
Cuando una sola pregunta exige varias vías
Nuestros seis ejemplos tienen un defecto: son demasiado limpios. Cada uno señala su vía casi por sí solo.
Un director de operaciones, en cambio, pregunta más bien esto:
«¿Estamos cumpliendo nuestros compromisos con Durand este año?»
Nada en esta frase dice dónde buscar, ni a qué compromisos se refiere, ni en qué periodo. Ninguna de las seis vías basta, y no se puede decidir de antemano en qué orden recorrerlas.
El asistente tiene que encontrar primero lo que materializa el compromiso: un contrato, una adenda, un acuerdo de servicio. Vía 1, más la 5 si hay que localizar el archivo correcto en la carpeta correcta. Allí lee los umbrales: plazo de respuesta, número de intervenciones incluidas, tasa de disponibilidad. Y de paso se entera de que el periodo corresponde al año natural, no a doce meses móviles.
Solo entonces sabe qué preguntar a la herramienta de tickets. Se activa la vía 3, con un filtro que acaba de descubrir en el contrato. Si los volúmenes están en una base de datos y no en la herramienta de tickets, será la vía 4. Después compara y responde.
La segunda consulta no podía formularse antes de leer el resultado de la primera. Un agente lleva a cabo una investigación allí donde un simple conmutador se limita a dirigir: evalúa lo que obtiene y decide si sabe lo suficiente para responder o si tiene que volver a buscar. El principio se detalla en nuestro artículo sobre el RAG agéntico.
Dos consecuencias que, por lo general, se descubren demasiado tarde. La primera: hay que saber parar. Una investigación consume tiempo y tokens, y sin límites en el número de idas y vueltas el sistema se vuelve lento y caro, y por tanto inutilizable aunque sus respuestas sean buenas. La segunda: hay que dejar rastro. Cuando una respuesta resulta de cuatro llamadas a tres fuentes, el usuario tiene que poder comprobar de dónde viene cada elemento. Sin citas, nadie confía, y una respuesta de la que uno no se fía no sirve para nada.
Lo que probablemente tienes hoy
La prueba es sencilla: plantear las seis preguntas del principio al asistente que ya utilizas.
Con Copilot, las preguntas 1, 2 y 5 quedan bien cubiertas mientras la información esté en Microsoft 365: la licencia de Microsoft 365 Copilot basa sus respuestas en Microsoft Graph (correos, archivos, reuniones). Más allá, hay que configurar conectores de Copilot, indexados o consultados en directo, fuente por fuente. Sin ellos, todo se detiene en la frontera de tus sistemas de negocio y de tus bases de datos: las preguntas 3 y 4 se quedan sin respuesta o reciben una aproximación. Y tus archivos de negocio atípicos se tratan como archivos corrientes.
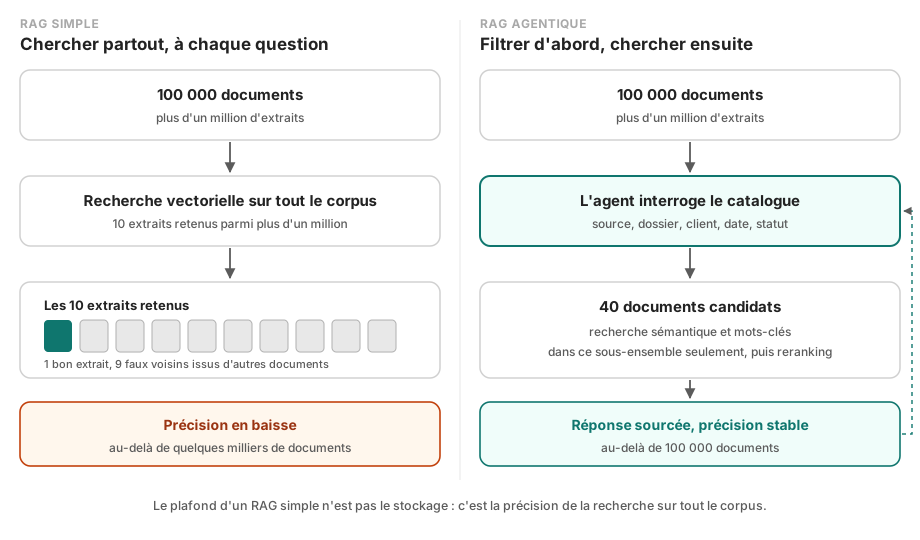
Con un RAG desarrollado internamente, tienes casi con toda seguridad la 1, a veces la 2. Es el camino natural: lo vectorial es lo que se conecta primero y lo que da una buena demo. Las demás vías exigen integraciones, permisos de acceso y operación, es decir, trabajo después del POC. Es también lo que le hace tocar techo en unos pocos miles de documentos.
Con un buscador empresarial clásico, tienes la 2 y la 5, con filtros. Es rápido y sólido, pero hay que saber qué escribir. Nadie encuentra la política de teletrabajo buscando «teletrabajo» si el documento dice «trabajo a distancia».
Ninguna de estas herramientas es mala, queremos dejarlo claro. Cubren una parte de la necesidad, y lo hacen correctamente. El problema es que tus equipos descubren la otra parte chocando con ella, pregunta tras pregunta, y que enseguida dejan de preguntar.
El enfoque de Ask This Guy
Abordamos el problema por el otro extremo. En lugar de optimizar un método de búsqueda, conectamos cinco, más un sexto que prepara el terreno, y pusimos un agente por encima.
Es él quien decide. Reformula la pregunta, elige la vía o las vías que va a seguir, lee lo que obtiene y juzga si sabe lo suficiente. Si no, vuelve a lanzar la búsqueda, mejor orientada, con lo que acaba de aprender. En el caso Durand de más arriba, encadena documentos y después tickets sin que nadie le haya dicho en qué orden. Y si el contrato vive en una hoja de seguimiento interna, es el tratamiento a medida, configurado una sola vez, lo que le ha permitido leerlo correctamente.
La documentación detalla el mecanismo. Cada elemento de la respuesta remite a su fuente, sea cual sea la vía que lo encontró.
Para el usuario, no hay nada de esto que saber. Hace su pregunta con sus propias palabras. Es lo mínimo: pedir a un comercial que elija entre «búsqueda semántica» y «consulta SQL» antes de escribir su frase sería trasladarle un problema de ingeniería.
Preguntas frecuentes
¿Qué es la hybrid search?
La hybrid search, o búsqueda híbrida, consiste en combinar varios métodos de búsqueda complementarios en lugar de uno solo. En sentido estricto, asocia la búsqueda semántica (por el sentido, mediante embeddings) y la búsqueda por palabras clave (por coincidencia exacta). En sentido amplio, integra también la llamada a herramientas de negocio, la consulta a la base de datos y la consulta del catálogo documental, para cubrir las preguntas cuya respuesta no está en ningún documento. A ello se suma una vía previa: el tratamiento a medida de los archivos complejos, que hace aprovechables hojas de cálculo o catálogos que una división clásica convertiría en ruido.
¿Qué diferencia hay entre la búsqueda semántica y la búsqueda por palabras clave?
La búsqueda semántica compara el sentido: encuentra «modalidades de trabajo a distancia» a partir de la pregunta «¿se puede teletrabajar?». La búsqueda por palabras clave compara cadenas de caracteres: encuentra la referencia exacta XOD1132 o el nombre JP Dupont, que la búsqueda semántica pasa por alto porque esas cadenas no tienen un sentido propio. Las dos son necesarias, porque una empresa maneja tantos conceptos como referencias internas.
¿Por qué no basta la búsqueda vectorial sola?
Porque una parte importante de las preguntas en la empresa trata de identificadores sin valor semántico (referencias de producto, códigos de proyecto, nombres de clientes), de datos vivos almacenados en los sistemas de información, de cifras que hay que calcular en una base de datos o de la estructura misma de la base documental. También falla con los archivos cuya estructura lleva el sentido, como las hojas de cálculo, que una división en texto reduce a series de celdas. Ninguno de estos casos lo resuelve bien la proximidad vectorial, que sin embargo sigue siendo el único mecanismo de muchos proyectos RAG.
¿Cómo sabe un asistente qué método de búsqueda usar?
Decide el agente, a partir de la formulación de la pregunta y de la descripción de las herramientas de que dispone. Una pregunta conceptual activa una búsqueda semántica, una referencia explícita activa una búsqueda por palabras clave, una petición de recuento activa una consulta del catálogo. En las preguntas complejas encadena varias y se sirve del resultado de la primera para formular la siguiente, hasta considerar que sabe lo suficiente para responder.
¿Por qué un RAG clásico aprovecha mal un archivo Excel?
Porque en una hoja de cálculo el sentido lo lleva la estructura tanto como el texto. Una celda no quiere decir nada sin el encabezado de su columna, su unidad y su fila de referencia. Una división en fragmentos de texto, que funciona bien con un contrato o un procedimiento, produce aquí series de valores sin contexto. Hace falta un tratamiento adaptado al formato, que reconstruya lo que significa cada columna antes de la indexación.
Conclusión
Todo el mundo sabe responder a la pregunta fácil, aquella cuya respuesta cabe en un párrafo bien escrito de un documento bien archivado. Un asistente se juzga por las otras cinco: aquellas en las que la información está en otra parte, todavía no existe en forma de texto o duerme en un archivo que nadie se ha molestado en hacer legible.
Si quieres ver qué dan tus propias preguntas, las que tus equipos hacen de verdad, puedes reservar una demo: partiremos de tus fuentes reales. El detalle del enfoque está en la página RAG para empresas llave en mano, y la consulta de tus bases de datos, en Talk to Data.