Agentic RAG: ¿cuántos documentos puede tratar un RAG?
Un RAG casero se queda en unos pocos miles de documentos por agente, menos si se parecen. Un agentic RAG que filtra antes de buscar trata más de 100.000.

¿Cuántos documentos puede tratar un RAG? Todo depende de su arquitectura. Un RAG simple, el que se monta internamente con una base vectorial y una búsqueda sobre todo el corpus, sigue siendo fiable hasta unos cientos, como mucho unos pocos miles de documentos por agente. Más allá, el almacenamiento aguanta: lo que se desploma es la precisión de la búsqueda. Y el umbral baja todavía más cuando los documentos se parecen: unos cientos de contratos redactados con la misma plantilla para clientes distintos bastan para desorientar a un RAG simple. Un agentic RAG (o RAG agéntico), que filtra el corpus antes de lanzar la búsqueda vectorial, absorbe más de 100.000 documentos. En varios de nuestros clientes, los agentes de ATG trabajan en producción sobre más de 100.000 documentos, es decir, más de un millón de páginas.
Las dos cifras circulan y las dos son ciertas. Describen dos sistemas distintos.
¿De dónde viene la cifra de «unos cientos de documentos»?
Tiene dos orígenes, y ninguno dice gran cosa de la tecnología RAG en sí.
El primero son los límites de las herramientas de consumo. Cuando se busca «cuántos documentos se le pueden dar a una IA», aparecen los límites que anuncian los productos que todo el mundo conoce. En octubre de 2026, NotebookLM acepta 50 fuentes por cuaderno en la versión gratuita y unos cientos en las ofertas de pago. Los proyectos de ChatGPT y los GPT personalizados aceptan unas decenas de ficheros según la suscripción. Son decisiones de producto, calibradas para una persona que trabaja en un expediente.
El segundo son las experiencias con RAG caseros. El tutorial clásico (trocear los documentos, calcular embeddings, buscar los diez fragmentos más cercanos, dárselos al modelo) da una demo impresionante con cincuenta documentos. Después, los equipos añaden ficheros y la calidad baja sin que nada se rompa. De ahí un consenso empírico: «a partir de unos pocos miles de documentos, ya no funciona muy bien».
Ese consenso es correcto, para esa arquitectura.
Por qué un RAG simple pierde precisión cuando el corpus crece
Un RAG simple funciona así: la pregunta se transforma en un vector, el sistema busca en todo el corpus los fragmentos cuyo vector está más cerca, se queda con un número fijo (a menudo entre 5 y 20) y el modelo responde solo a partir de esos fragmentos.
Con 50 documentos, la operación es trivial. Con un millón de páginas, el mismo mecanismo tiene que elegir diez fragmentos entre más de un millón. Cada documento añadido aporta su lote de pasajes que hablan más o menos del tema de la pregunta sin responderla, y acaban ocupando los diez puestos.
Las versiones antiguas agravan las cosas. Cuanto más grande es la base, más borradores y copias contiene. El procedimiento de 2022 y el de 2026 se parecen mucho, y el sistema no tiene ninguna razón para preferir el correcto.
Los nombres propios, también. Un nombre de cliente, una referencia de producto o un código de proyecto son a menudo la única palabra que cuenta en una pregunta, y es la que peor representa un embedding: son claves, sin sentido general. Lo hemos detallado en nuestro artículo sobre la búsqueda híbrida.
El resultado es engañoso: el asistente sigue respondiendo con aplomo y citando fuentes. Solo que cada vez con menos frecuencia la correcta.
Documentos que se parecen: el peor caso para un RAG simple
En nuestra opinión, es el punto peor entendido del tema. Se habla de volumen y se olvida el parecido. Sin embargo, dos corpus del mismo tamaño pueden comportarse de forma opuesta.
Tomemos 5.000 documentos heterogéneos: reglamento interno, fichas de producto, procedimientos de calidad, notas jurídicas. Una pregunta sobre las vacaciones cae de forma natural en los documentos de RR. HH., porque su sentido se distingue de todo lo demás. El RAG simple sale bastante bien parado.
Tomemos ahora 500 contratos de clientes redactados con la misma plantilla. Un comercial pregunta: «¿Cuál es el preaviso de rescisión en el contrato García?». Los 500 contratos tienen todos una cláusula de rescisión, casi palabra por palabra. Para la búsqueda vectorial, son 500 pasajes equivalentes. Lo que los distingue cabe en una palabra, García, y es precisamente la que peor capta. Los diez fragmentos seleccionados vendrán de diez clientes tomados al azar, y el reranking no cambiará nada: reordena los fragmentos que se le dan, y el correcto probablemente no está entre ellos.
Cuanto más se parecen los documentos, peor funciona un RAG simple, y antes. El techo de «unos pocos miles» baja entonces a unos cientos.
Este caso no tiene nada de marginal. Contratos, informes de auditoría, expedientes de due diligence, informes de visita, respuestas a licitaciones: es el día a día de las consultoras, las firmas de auditoría y los despachos de abogados, de los equipos de M&A, las aseguradoras y las oficinas técnicas. Estos oficios producen el mismo tipo de entregable para decenas o cientos de clientes, y son esos documentos los que más valor tienen para ellos. Una data room de due diligence es el caso de manual: tres ejercicios contables, varias versiones de un contrato, un paquete de cuentas por filial, y es la búsqueda del documento correcto, más que el modelo, lo que determina la precisión de una IA.
La solución consiste en tratar el nombre del cliente como un filtro, aplicado antes de cualquier búsqueda por sentido, y no como una palabra diluida en un vector. Es el principio del agentic RAG.
Lo que dice la investigación sobre el paso a escala
Un estudio publicado en julio de 2026, BM25 Wins at Scale, midió varias arquitecturas RAG sobre un corpus ampliado progresivamente, en un factor de 450, con las mismas preguntas de principio a fin. Nos interesan dos resultados.
La búsqueda vectorial sola sigue siendo rápida, pero pierde exactitud frente a la búsqueda por palabras clave cuando el corpus crece. Aparecen los pasajes «más o menos sobre el tema» descritos más arriba.
Un agente que explora los ficheros sin índice, como alguien que abriera las carpetas una por una, es excelente con un corpus pequeño y se hunde a gran escala: consume 39 veces más tokens y acaba casi 20 puntos por detrás. Los autores concluyen que el razonamiento agéntico da lo mejor de sí después de una primera búsqueda ordenada por relevancia.
Hacen falta, por tanto, las dos cosas: índices que encuentran rápido y un agente que razona sobre lo que encuentran.
El agentic RAG: filtrar antes de buscar
Un documentalista al que se le pregunta por el preaviso del contrato García no relee los 500 contratos. Va a la carpeta Clientes, abre la subcarpeta García, coge la última versión del contrato y busca la cláusula.
Un agentic RAG hace lo mismo. Antes de cualquier búsqueda vectorial, el agente reduce el perímetro.
- Entiende a qué se refiere la pregunta: un documento concreto (el contrato), un cliente (García), una noción (el preaviso de rescisión).
- Consulta el catálogo documental. Fuentes, carpetas, rutas, fechas, estados: el catálogo responde de forma determinista, sin aproximación semántica. El perímetro pasa de 100.000 documentos a un puñado.
- Busca solo en ese subconjunto, combinando búsqueda semántica y búsqueda por palabras clave, y después ordena los fragmentos mediante reranking. Las otras 499 cláusulas de rescisión ya ni siquiera son candidatas.
- Verifica. Si los fragmentos no bastan, lee el documento entero o vuelve a buscar con lo que acaba de aprender.
La búsqueda vectorial ya no elige diez fragmentos entre un millón, sino entre unos cientos, donde es muy fiable. El tamaño total del corpus deja de ser el factor limitante, ya que la búsqueda fina nunca se hace sobre todo el corpus.
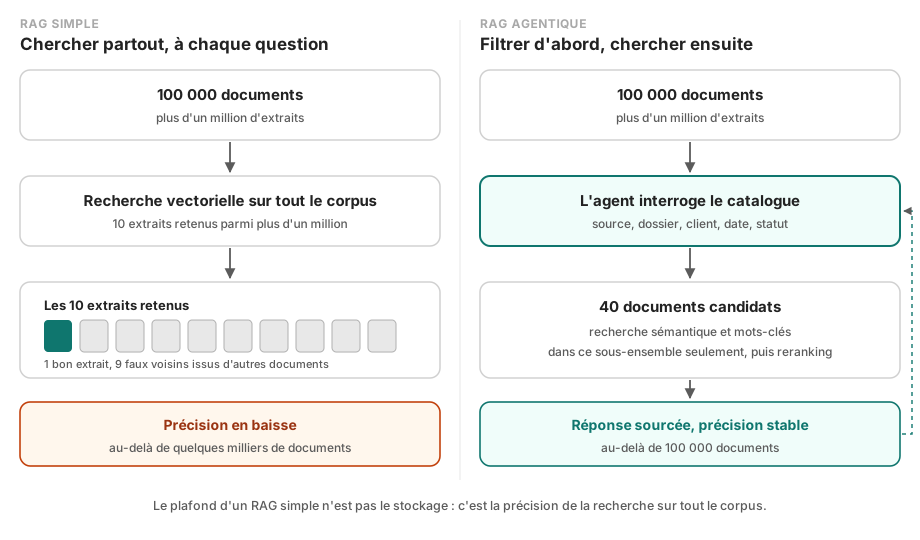
Esquema que compara dos arquitecturas RAG sobre 100.000 documentos. A la izquierda, el RAG simple lanza una búsqueda vectorial sobre todo el corpus y se queda con diez fragmentos, muchos de ellos falsos vecinos procedentes de otros documentos. A la derecha, el agentic RAG consulta primero el catálogo documental para reducir el perímetro a una cuarentena de documentos, después lanza una búsqueda híbrida con reranking en ese subconjunto y produce una respuesta con fuentes.
RAG simple o agentic RAG: la comparación
| RAG simple | Agentic RAG con filtrado | |
|---|---|---|
| Volumen fiable por agente | De unos cientos a unos pocos miles de documentos | Más de 100.000 documentos, más de un millón de páginas |
| Perímetro de la búsqueda | Todo el corpus, en cada pregunta | Subconjunto elegido por el agente |
| Documentos de la misma tipología para clientes distintos | El peor caso: falla ya con unos cientos | El cliente se convierte en un filtro, aplicado antes de la búsqueda |
| Nombres propios y referencias | Mal encontrados | Encontrados por palabras clave y por el catálogo |
| Preguntas de inventario («¿cuántos contratos…?») | Respuesta aproximada o errónea | Respuesta exacta, desde el catálogo |
| Versiones en competencia | Mezcladas | Arbitradas por fecha, estado o carpeta |
| Tiempo de respuesta | Unos segundos | Unos segundos más, según las idas y vueltas |
El agentic RAG tiene un coste. Cada etapa consume tokens y tiempo, y un agente sin salvaguardas puede dar vueltas en círculo. Hay que limitar el número de idas y vueltas y trazar cada fuente; de lo contrario, el sistema se vuelve lento y sus respuestas, imposibles de verificar.
Repartir en varios agentes: una falsa solución
Cuando un RAG simple se satura, el reflejo es crear un agente por departamento, después por tema, e incluso por cliente, para mantener cada corpus por debajo de la barrera de unos pocos miles de documentos. De ahí viene la idea de un límite «por agente».
Funciona, pero la carga pasa al usuario: es él quien tiene que saber a qué agente preguntar. La pregunta «¿estamos cumpliendo nuestros compromisos con García?» toca a la vez los contratos, el soporte y la facturación, y tres agentes compartimentados no pueden responderla. En cuanto a un agente por cliente, con 300 clientes se vuelve rápidamente inmanejable.
Hay buenas razones para separar agentes, y tienen que ver con los derechos de acceso: un agente de RR. HH. no tiene por qué leer los contratos de clientes. En ATG, ese perímetro se regula con las categorías de conocimiento (en inglés) asignadas a cada agente.
Lo que hace falta para gestionar 100.000 documentos en producción
La arquitectura agéntica elimina el techo de precisión. A esta escala aparecen otros temas, y es mejor conocerlos de antemano.
La ingesta se convierte en un proyecto industrial. Un millón de páginas son PDF escaneados, hojas de cálculo, presentaciones y una factura de OCR que dista de ser anecdótica. Hemos cifrado la diferencia entre una API y un modelo open weight sobre un millón de páginas en nuestra comparativa de Mistral OCR y PaddleOCR: de 4.000 $ a menos de 200 $.
El filtrado vale lo que valen los metadatos. El agente se apoya en lo que sabe el catálogo: fuente, carpeta, fecha, autor, estado. Una estructura de carpetas de SharePoint coherente le es mucho más útil que una carpeta «Varios» con 40.000 ficheros.
La sincronización debe ser incremental. No se reindexa un millón de páginas cada noche, solo los documentos modificados.
La calidad se mide con preguntas reales. Un RAG de 100.000 documentos no se valida con diez preguntas en un comité. Hacen falta cientos de preguntas representativas, incluidas preguntas trampa: un documento concreto entre miles de documentos similares, una referencia interna, una pregunta de inventario.
Cómo probar la capacidad de volumen de una solución RAG antes de comprarla
Un proveedor que anuncia «ilimitado» no dice nada. Bastan cuatro pruebas para desempatar entre soluciones, y se las pasaríamos a cualquiera, nosotros incluidos.
- Pedir el volumen en producción, no en demo: cuántos documentos y páginas en un cliente real, y repartidos en cuántos agentes.
- Buscar una aguja entre documentos gemelos. Elegir un documento perdido entre cientos de documentos de la misma tipología (el contrato de un cliente entre todos los contratos, un informe de auditoría entre todos los informes) y hacer una pregunta cuya respuesta solo está en ese documento. Es la prueba más discriminante.
- Hacer una pregunta con un nombre propio o una referencia interna, que la búsqueda semántica sola encuentra mal.
- Hacer una pregunta de inventario, del tipo «¿cuántos contratos se firmaron en 2025?». Una respuesta aproximada delata una búsqueda sin catálogo.
El enfoque de Ask This Guy
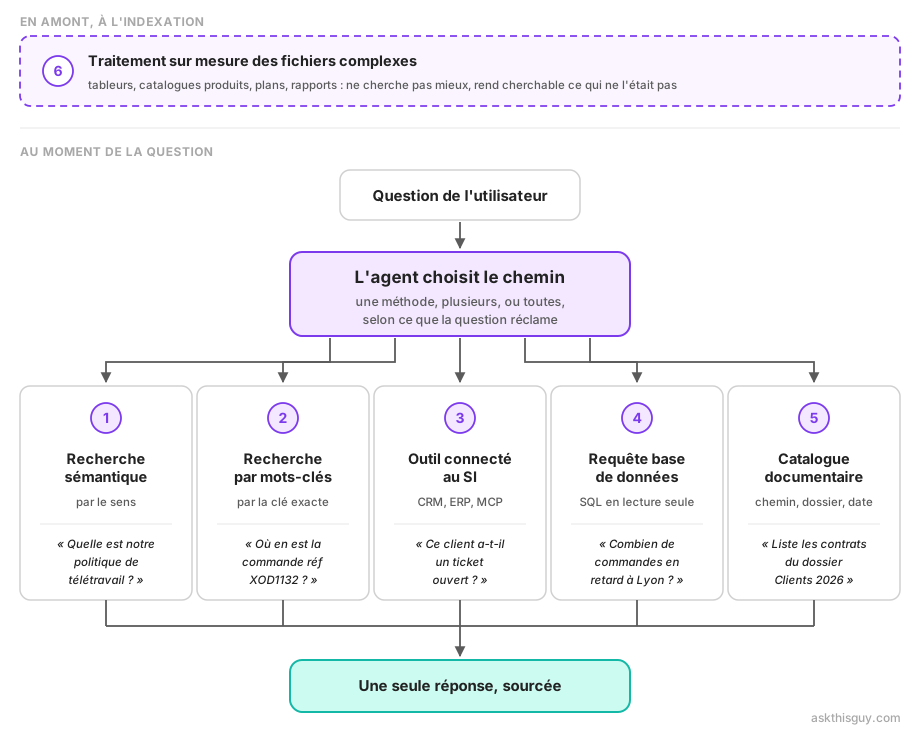
En Ask This Guy, el agente dirige la búsqueda. Dispone de varias herramientas complementarias: el catálogo documental (en inglés) para situar y contar los documentos, la búsqueda de documentos pertinentes para identificar un fichero, la búsqueda híbrida (semántica y por palabras clave) para encontrar el pasaje, el reranking para quedarse con los mejores fragmentos y la lectura completa cuando un fragmento no basta.
Así, nuestros clientes conectan más de 100.000 documentos, es decir, más de un millón de páginas, a un mismo agente, sin trocear su base para quedarse por debajo de un umbral. Las respuestas citan sus fuentes, sea cual sea el tamaño del corpus.
Si tu proyecto choca con el volumen, nuestro RAG empresarial llave en mano está pensado para ello, y reservar una demo permite probarlo con tus propios documentos.
Preguntas frecuentes
¿Cuántos documentos puede tratar un RAG?
Depende de su arquitectura. Un RAG simple, que lanza una búsqueda vectorial sobre todo el corpus en cada pregunta, sigue siendo fiable hasta unos cientos o unos pocos miles de documentos por agente, y menos aún cuando los documentos se parecen. Un agentic RAG, que filtra el corpus antes de buscar, trata más de 100.000 documentos, es decir, más de un millón de páginas: es el volumen que gestionan agentes de Ask This Guy en producción. El límite viene de la precisión de la búsqueda; el almacenamiento, en cambio, acompaña sin dificultad.
¿Por qué un RAG pierde precisión cuando aumenta el número de documentos?
Porque un RAG simple elige un número fijo de fragmentos, a menudo diez, entre todo el corpus. Cuanto más crece el corpus, más pasajes contiene que se acercan al sentido de la pregunta sin ser la respuesta correcta: cláusulas similares de contratos distintos, versiones antiguas, copias. Los nombres propios y las referencias internas, mal representados por los embeddings, agravan el problema. La respuesta correcta acaba por no figurar entre los fragmentos seleccionados.
¿Por qué un RAG funciona mal con documentos similares?
Porque la búsqueda vectorial compara el sentido de los pasajes, y los documentos de una misma tipología (contratos con la misma plantilla, informes de auditoría, expedientes de clientes) tienen casi todos el mismo sentido. Lo que los distingue, un nombre de cliente, una fecha, un importe, es justo lo que peor capta un embedding. Un RAG simple devuelve entonces pasajes de otros clientes. La solución consiste en filtrar primero por cliente, carpeta o fuente, y después buscar solo en ese subconjunto.
¿Qué es el filtrado previo a la búsqueda vectorial en un RAG?
Es la etapa en la que el agente reduce el perímetro antes de buscar por sentido. Consulta el catálogo documental (fuente, carpeta, fecha, estado, nombre del cliente o del proyecto) para aislar los pocos documentos afectados, y después lanza la búsqueda semántica y por palabras clave solo en ese subconjunto. El agente decide ese filtro a partir de la pregunta, sin que el usuario tenga que indicarlo.
¿Puede un RAG tratar un millón de páginas?
Sí, siempre que no busque en el millón de páginas en cada pregunta. Un agentic RAG filtra primero el corpus y después busca en un subconjunto reducido, lo que mantiene la búsqueda precisa sea cual sea el tamaño total. Un millón de páginas plantea sobre todo cuestiones de ingesta: coste del OCR, sincronización incremental de los documentos modificados, calidad de los metadatos.
¿Hay que crear varios agentes para repartir un gran número de documentos?
No por razones de volumen, si la arquitectura filtra antes de buscar. Repartir los documentos entre varios agentes obliga al usuario a saber a cuál preguntar, e impide responder a las preguntas que cruzan varios ámbitos. El criterio correcto para separar agentes es el de los derechos de acceso: un agente de RR. HH. no tiene por qué leer los contratos de clientes.
Conclusión
«Unos cientos, como mucho unos pocos miles de documentos»: la respuesta que se encuentra en internet es correcta para un RAG simple, y explica por qué tantos proyectos internos se estancan después del POC. Describe una arquitectura concreta, la que busca en todas partes en cada pregunta.
El número de documentos, por cierto, solo es la mitad del problema. A igual volumen, unos documentos que se parecen hacen fracasar un RAG simple mucho antes.
Un agente que sabe primero dónde buscar, antes de buscar qué, hace desaparecer el techo, incluso con cientos de documentos gemelos. Se pasa entonces de unos pocos miles de documentos a más de 100.000, y la empresa puede por fin conectar toda su base documental en lugar de una muestra cuidadosamente elegida.