Agentic search en due diligence: encontrar el documento correcto
En FinanceBench, un mismo modelo pasa del 27 % al 86 % de aciertos según el software que busca. En due diligence, el reto es encontrar el documento correcto.

En agosto de 2026, Mistral publicó los resultados de su búsqueda agéntica (agentic search, también llamada agentic RAG) en FinanceBench, una prueba de 150 preguntas de analista financiero formuladas sobre 368 informes de empresas cotizadas. Con el mismo modelo, GLM-5.2, la precisión pasa del 26,7 % al 86 % según la forma en que el software busca en los informes. El modelo no cambia, los documentos tampoco: solo cambia la manera de ir a buscar la información.
Este resultado confirma lo que la prueba ya mostraba en 2023: un modelo de lenguaje interpreta bien un informe financiero cuando se le pone delante la página correcta. Lo que hunde la precisión es tener que encontrar esa página. El modelo ya no es la cuestión: lo es el software que va a buscar la información y pilota el agente.
Para un equipo de due diligence, la consecuencia es directa. Una data room son cientos de documentos que se parecen: tres ejercicios de cuentas, varias versiones de un contrato, un paquete de cierre por filial. Lo más difícil no es interpretar los documentos, sino encontrar el correcto, y es en este punto donde las herramientas de IA se diferencian.
Interpretar un documento o encontrar el correcto: dos tareas distintas
FinanceBench es un conjunto de preguntas publicado por Patronus AI en noviembre de 2023 para medir la capacidad de una IA de responder a preguntas de analista a partir de informes reales: informes anuales (10-K), trimestrales (10-Q), comunicados de resultados. Cada pregunta tiene una respuesta única y verificable: un importe, un ratio o una explicación sacada del informe.
Los autores plantearon las 150 preguntas públicas a GPT-4 Turbo en cinco configuraciones, cambiando solo lo que se le da al modelo. Las respuestas se calificaron a mano. Los resultados de la tabla 2 dibujan una escalera:
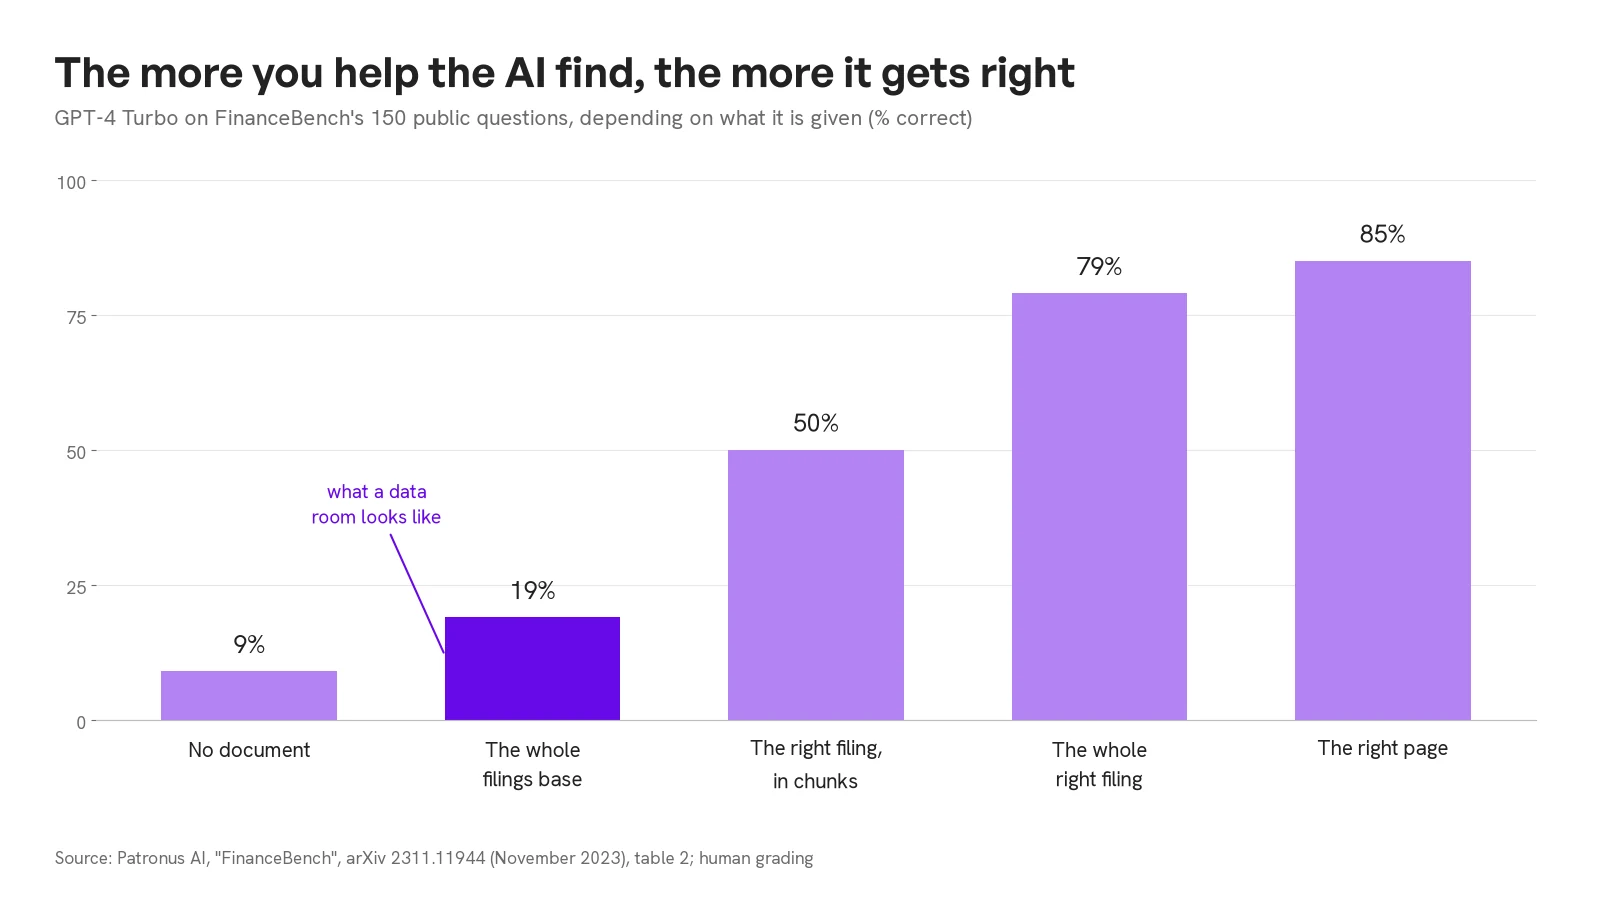 Gráfico de barras: GPT-4 Turbo acierta el 9 % de las preguntas sin documento, el 19 % cuando busca en toda la base de informes, el 50 % con el informe correcto en extractos, el 79 % con el informe correcto completo y el 85 % con la página correcta
Sin ningún documento, el modelo acierta el 9 %. Con la página correcta, sube al 85 %. Entre ambos extremos, todo depende del esfuerzo de búsqueda que se le deja: el 19 % cuando tiene que encontrar el pasaje en una base común a todos los informes, el 50 % cuando la base solo contiene el informe correcto, el 79 % cuando el informe entero cabe en su ventana de contexto. Del 19 % al 85 %, sin cambiar de modelo: la diferencia procede por completo de lo que hay que encontrar.
El resumen del artículo lo dice sin rodeos: GPT-4 Turbo asociado a un sistema de búsqueda «incorrectly answered or refused to answer 81% of questions». El proveedor Ragie encontró la misma diferencia un año después con su propio motor: 27 % en la base común, 51 % en una base limitada al documento correcto. Reducir el perímetro de búsqueda duplica la precisión.
¿Qué es el agentic search? Con el mismo modelo, el software triplica la precisión
La búsqueda agéntica (agentic search, o agentic RAG) designa un software que no se conforma con una única búsqueda: encadena búsquedas, abre los documentos que parecen pertinentes, los recorre, comprueba lo que ha encontrado y decide cuándo sabe lo suficiente para responder. El modelo de lenguaje redacta y razona; el software que lo rodea dirige la investigación.
La entrada de Mistral publicada el 20 de agosto de 2026 aísla precisamente el efecto de este software. Las mismas 150 preguntas, los mismos 368 informes, el mismo modelo, tres formas de buscar: un RAG «de una pasada», que «retrieves a fixed set of text chunks and asks a model to answer in a single pass», un bucle de búsquedas encadenadas y, por último, el mismo bucle con herramientas de navegación por los documentos.
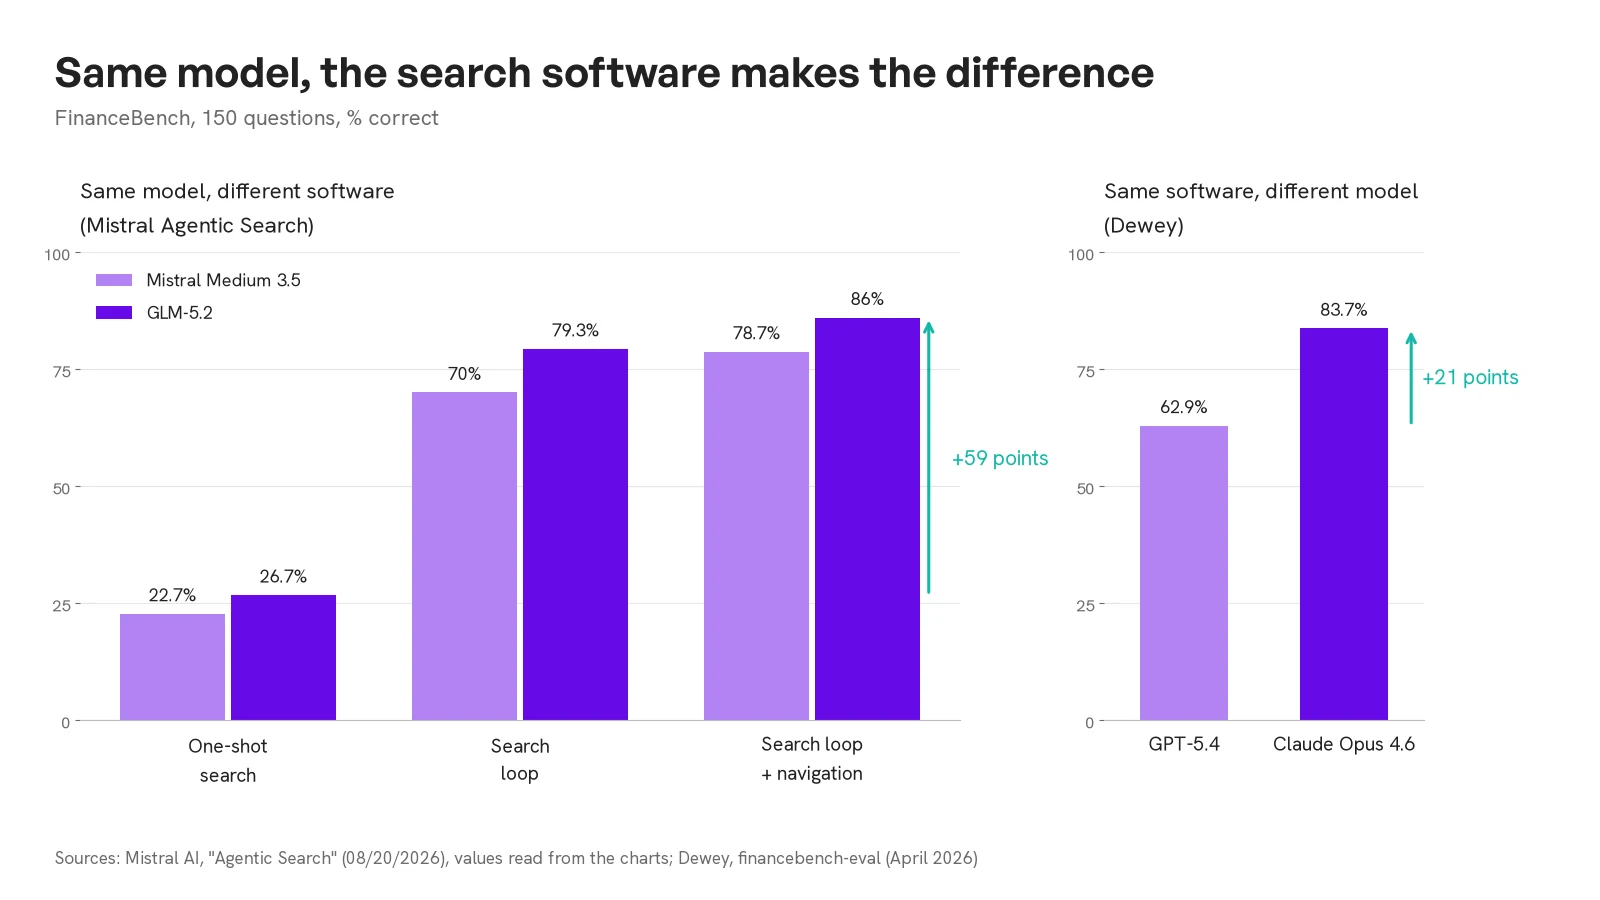 Gráfico en dos partes. A la izquierda, mismo modelo y software distinto: Mistral Medium 3.5 pasa del 22,7 % al 70 % y después al 78,7 %, GLM-5.2 del 26,7 % al 79,3 % y después al 86 %. A la derecha, mismo software y modelo distinto en Dewey: 62,9 % para GPT-5.4, 83,7 % para Claude Opus 4.6
El bucle de búsqueda hace ganar 47,3 puntos a Mistral Medium 3.5 y 52,6 puntos a GLM-5.2; la navegación añade otros 8,7 y 6,7. En total, el mismo modelo triplica su precisión sin que se toquen sus parámetros. Mistral señala también que la navegación reduce el consumo de tokens entre una cuarta parte y un tercio: buscar mejor cuesta menos que buscar mucho.
El modelo sigue contando. Dewey hizo el experimento contrario: misma ingesta, mismo motor de búsqueda agéntica, solo cambia el modelo. Claude Opus 4.6 alcanza el 83,7 %, GPT-5.4 el 62,9 %, es decir, 21 puntos de diferencia. Pero la misma entrada muestra que Opus hace de media 21,2 llamadas a la herramienta de búsqueda por pregunta, frente a 9,4 de GPT-5.4: parte de la diferencia se debe a la forma en que cada modelo usa el software. El modelo cuenta; el software cuenta más, con 56 a 59 puntos de diferencia en Mistral frente a 21 en Dewey.
Nuestra propia experiencia va en la misma dirección. En FinanceBench, sustituir Qwen 3.8 27B, el modelo que redacta las respuestas de ATG, por Gemini 3.8 Flash no cambia la puntuación. También pasamos la prueba con el mismo modelo en dos proveedores de alojamiento distintos, uno mundial y otro europeo: 138 y 139 respuestas correctas de 150. Solo cambia el tiempo de respuesta: 10,5 segundos de media en un caso, 30,9 en el otro.
Lo que hace este software: buscar, abrir, elegir, parar
El software que pilota la búsqueda toma cuatro decisiones que el modelo solo no toma. Reduce el perímetro antes de buscar: la empresa, el ejercicio, el tipo de documento. Es lo que permite a un RAG aguantar con decenas de miles de documentos, como explicamos en nuestro artículo sobre el número de documentos que puede tratar un RAG. Encadena búsquedas cuando la primera no basta. Abre y recorre un informe cuando la información está en una tabla que los extractos cortan mal. Por último, se detiene: decide que tiene suficientes elementos, o que no ha encontrado nada y debe decirlo.
Un ejemplo sacado de nuestros informes de FinanceBench muestra estas decisiones en acción. Pregunta: «Was there any drop in Cash & Cash equivalents between FY 2023 and Q2 of FY2024?», sobre Best Buy. La respuesta exige dos documentos de dos periodos distintos, entre los informes anuales, trimestrales y comunicados del mismo distribuidor. ATG citó el informe anual de 2023 y el comunicado del segundo trimestre de 2024: 1.874 millones de dólares al cierre del ejercicio 2023, 1.093 millones en el segundo trimestre del ejercicio siguiente, es decir, una bajada del 41,7 %. La respuesta esperada era «alrededor del 42 %». De paso, ATG precisó que el ejercicio de Best Buy termina a finales de enero, lo que desplaza un año todas las denominaciones. Una búsqueda, 7,2 segundos.
La trampa de los documentos parecidos
Una base de informes financieros es un caso difícil por una razón sencilla: los documentos se parecen. El informe anual de 2022 y el de 2023 de una misma empresa tienen la misma estructura, los mismos títulos y, a menudo, las mismas frases. Una búsqueda por similitud de sentido los pone al mismo nivel. Si el software no filtra por ejercicio, el modelo recibe la tabla correcta del año equivocado, y la interpreta a la perfección.
FinanceBench da una pista de ello. Once de las preguntas originales no nombran ni el ejercicio ni la empresa («this 10-K report»): se escribieron para un solo documento, mientras que la base contiene varios por empresa. Formuladas tal cual, no tienen una respuesta única. En nuestro protocolo, les añadimos una frase fija que precisa el periodo o la empresa, sin tocar el resto de la pregunta.
Una data room de due diligence lleva esta trampa más lejos. En ella hay tres ejercicios de cuentas, paquetes de cierre por filial, varias versiones de un mismo contrato y hojas de Excel que repiten las cifras de los PDF. Una respuesta correcta sacada del ejercicio equivocado sigue siendo una respuesta incorrecta, y elegir el documento correcto le corresponde al software, no al modelo. Las vías para dar a una IA acceso a estos documentos (API, MCP, exportación) son el tema de nuestro artículo sobre las data rooms y la IA.
Lo que esto cambia para una due diligence
Cada configuración de FinanceBench corresponde a una situación de due diligence.
| Configuración de FinanceBench | Situación en due diligence | GPT-4 Turbo (2023) |
|---|---|---|
| ningún documento | preguntar a un asistente de uso general qué sabe de la empresa objetivo | 9 % |
| toda la base de informes | consultar toda la data room | 19 % |
| el informe correcto, en extractos | subir el informe anual a un asistente | 50 % |
| la página correcta | copiar y pegar una tabla en el asistente | 85 % |
La fila que importa es la segunda. Es la única que se parece al trabajo real: cientos de documentos, una pregunta y nadie que indique dónde está la respuesta. Es también aquella en la que la diferencia entre programas es mayor, y la que una demostración con un solo archivo no pone a prueba.
Cómo leer la demostración de una herramienta de IA
Cuando una demostración se hace con un PDF subido delante del cliente, demuestra que el modelo interpreta bien un informe. No dice nada de su capacidad para encontrar ese informe entre otros quinientos, que es la dificultad de una data room.
Tres preguntas diferencian las herramientas mejor que el nombre del modelo. ¿La demostración se hace con un archivo elegido de antemano o con toda la base? ¿Qué hace el software alrededor del modelo: una sola búsqueda, o una investigación que abre los documentos y filtra por empresa y por ejercicio? Y cuando la información no existe, ¿lo dice la herramienta? Una cuarta pregunta las completa: ¿publica el proveedor una medida de precisión en una prueba pública, con sus condiciones? Elegir una herramienta por su modelo es mirar la variable equivocada.
Para los equipos de M&A, transaction services y fondos, describimos nuestro enfoque de la due diligence financiera: data room, cuentas, Excel, con una cita para cada respuesta.
Nuestros resultados en FinanceBench
Pasamos FinanceBench en las condiciones de la segunda fila de la tabla: 368 informes en una base de conocimiento de ATG estándar, cada pregunta planteada por separado, sin indicar el documento correcto. ATG acierta 138 preguntas de 150 (92 %) con un tiempo de respuesta medio de 10,5 segundos y, de media, 1,5 llamadas a la herramienta de búsqueda por pregunta. El protocolo, cada pregunta, cada respuesta y cada veredicto están publicados en nuestra página de FinanceBench. Las condiciones de calificación varían de una fuente a otra (calificación humana en Patronus AI, juez automático en otros casos): estas cifras sitúan los enfoques, no establecen una clasificación.
Preguntas frecuentes
¿Qué es la búsqueda agéntica (agentic search o agentic RAG)?
La búsqueda agéntica designa un software que dirige la búsqueda de información para un modelo de lenguaje. En lugar de lanzar una sola búsqueda y responder con los extractos obtenidos, encadena búsquedas, filtra por empresa o por periodo, abre y recorre los documentos, comprueba lo que ha encontrado y decide cuándo parar. En FinanceBench, este enfoque hace pasar a un mismo modelo del 26,7 % al 86 % de respuestas correctas, según Mistral.
¿Sigue importando la elección del modelo de IA para analizar documentos financieros?
Sí, pero menos que el software de búsqueda. En Dewey, con el mismo software, Claude Opus 4.6 y GPT-5.4 están separados por 21 puntos en FinanceBench. En Mistral, con el mismo modelo, el cambio de método de búsqueda hace ganar entre 56 y 59 puntos. El modelo sigue siendo decisivo para otras tareas, como redactar un análisis largo o entender una pregunta mal formulada.
¿Por qué se equivoca más una IA con una data room que con un solo PDF?
Porque primero tiene que encontrar el documento correcto. En FinanceBench, GPT-4 Turbo acierta entre el 50 y el 79 % de las preguntas cuando se le da el informe correcto, y el 19 % cuando tiene que buscarlo en toda la base. Los documentos parecidos (ejercicios sucesivos, versiones, filiales) agravan la diferencia: una búsqueda por similitud de sentido los confunde con facilidad.
¿Cómo evaluar una herramienta de IA para la due diligence?
La prueba más reveladora plantea preguntas reales sobre un conjunto de documentos completo, sin indicar a la herramienta dónde está la respuesta, e incluye preguntas cuya respuesta no está en los documentos. Se observa entonces la exactitud de las respuestas, la cita de la fuente, el tiempo de respuesta y la capacidad de la herramienta para decir que no ha encontrado nada. Un proveedor que publica sus resultados en una prueba pública como FinanceBench permite comparar incluso antes del ensayo.
Cambiar de modelo cabe en una línea de configuración. El software que lo pilota se construye más despacio: filtros, navegación, elección del ejercicio correcto, negativa a responder sin fuente. En due diligence, es él quien marca la diferencia, y es en una data room real, no en un PDF elegido de antemano, donde se le ve trabajar.