OVHcloud AI Endpoints y LLM: qué vale la estrategia de Klaba
OVHcloud anuncia su propio LLM y apunta a toda la cadena de la IA. Lo que ya ofrecen AI Endpoints y las GPU, lo pendiente y lo que un CIO puede sacar en claro.

El 20 de octubre de 2026, día de sus resultados anuales, Octave Klaba anunció en La Tribune que OVHcloud está terminando el entrenamiento de su primer LLM: «Pensamos publicarlo en código abierto a finales de noviembre». Ese mismo día, Reuters le atribuye que el primer modelo saldrá «in early 2027». Salió el 17 de noviembre con el nombre de Olala mini 7A1B, un modelo pequeño de 7.000 millones de parámetros que analizamos en un artículo específico. El modelo no es más que una pieza: en IA, OVH quiere controlar toda la cadena, del procesador gráfico hasta el uso.
Buena parte de esa cadena ya existe. OVHcloud alquila GPU, orquesta el entrenamiento y vende tokens, es decir, el acceso a modelos de IA facturado según el volumen de texto procesado, con su servicio OVHcloud AI Endpoints. En gpt-oss-120b es más barato que Scaleway e IONOS. Pero tarda en ofrecer los modelos abiertos más recientes y se queda atrás en velocidad.
El argumento central de Octave Klaba, el miedo a depender de un proveedor de modelos, concierne a todas las empresas.
¿Qué quiere hacer OVHcloud en IA?
La estrategia de IA de OVHcloud consiste en vender la IA de principio a fin desde sus propios centros de datos, sin depender de un intermediario. Octave Klaba, de nuevo al frente de la empresa desde el 20 de octubre de 2025, la describe en La Tribune en cinco capas:
- las GPU, instaladas en sus centros de datos;
- su orquestación, para el entrenamiento y la inferencia;
- los «tokens as a service», con «la cuestión de su precio y su calidad»;
- las herramientas para alojar aplicaciones desarrolladas con IA;
- los usos, con OVHai workspace, un paquete de correo, almacenamiento y videoconferencia dirigido por la IA.
La baza de partida es física. OVHcloud dispone de 250 MW de capacidad eléctrica conectada, de los que 140 MW están en explotación, en edificios de su propiedad, y fabrica sus servidores en sus propias fábricas. En su carta a los accionistas del 20 de octubre, Octave Klaba va más lejos: «por primera vez, algunos de nuestros nuevos productos ya no estarán destinados a humanos, sino a agentes de IA».
Los resultados del día le dan la razón. La facturación del ejercicio 2026, cerrado el 31 de agosto, alcanza 1.145,1 millones de euros, un 7,2 % más en términos orgánicos, y la nube pública, donde está la oferta de IA, crece un 18,9 %. El flujo de caja libre es positivo por primera vez desde la salida a Bolsa. La acción subió casi un 10 % por la mañana.
¿Qué existe ya en OVHcloud?
Las GPU y la orquestación
OVHcloud alquila GPU de Nvidia por horas: una H100 cuesta 2,80 € por hora, sin impuestos, y una instancia de ocho H200 cuesta 42 € por hora. Sus servicios AI Training, AI Notebooks y AI Deploy sirven para entrenar un modelo o desplegarlo en esas GPU, con facturación por minuto. Dos reservas: las instancias de ocho H200 están disponibles únicamente en París (AI Training, AI Notebooks y AI Deploy las ofrecen en bloques de cuatro en Gravelines), y la generación Blackwell de Nvidia todavía no está en el catálogo. En junio, OVHcloud indicaba en su hoja de ruta pública que sus H200 estaban «fully allocated due to high demand».
Los tokens: AI Endpoints
AI Endpoints es la oferta de inferencia de OVHcloud: una API, compatible con la de OpenAI, que da acceso a modelos de pesos abiertos alojados en Gravelines, en el norte de Francia. El servicio se lanzó en abril de 2025. Es la capa en la que OVHcloud se compara directamente con Scaleway, IONOS y las API de los grandes laboratorios. Volvemos sobre ella en detalle más abajo.
Los usos: OVHai workspace
OVHai workspace se presentó en vista previa en VivaTech el 17 de junio de 2026: correo, almacenamiento, videoconferencia y búsqueda confiada a agentes, con cifrado de extremo a extremo opcional. Se anunciaba una beta para la feria de noviembre de OVHcloud. La empresa dice que lo usa primero internamente para ganar productividad.
OVHcloud AI Endpoints: ¿qué valen hoy los tokens de OVHcloud?
Más barato que Scaleway e IONOS en varios modelos
En los modelos que también ofrecen sus competidores europeos, OVHcloud muestra precios bajos, a menudo los más bajos. Precios consultados el 20 de octubre de 2026 en las tarifas de OVHcloud, Scaleway e IONOS:
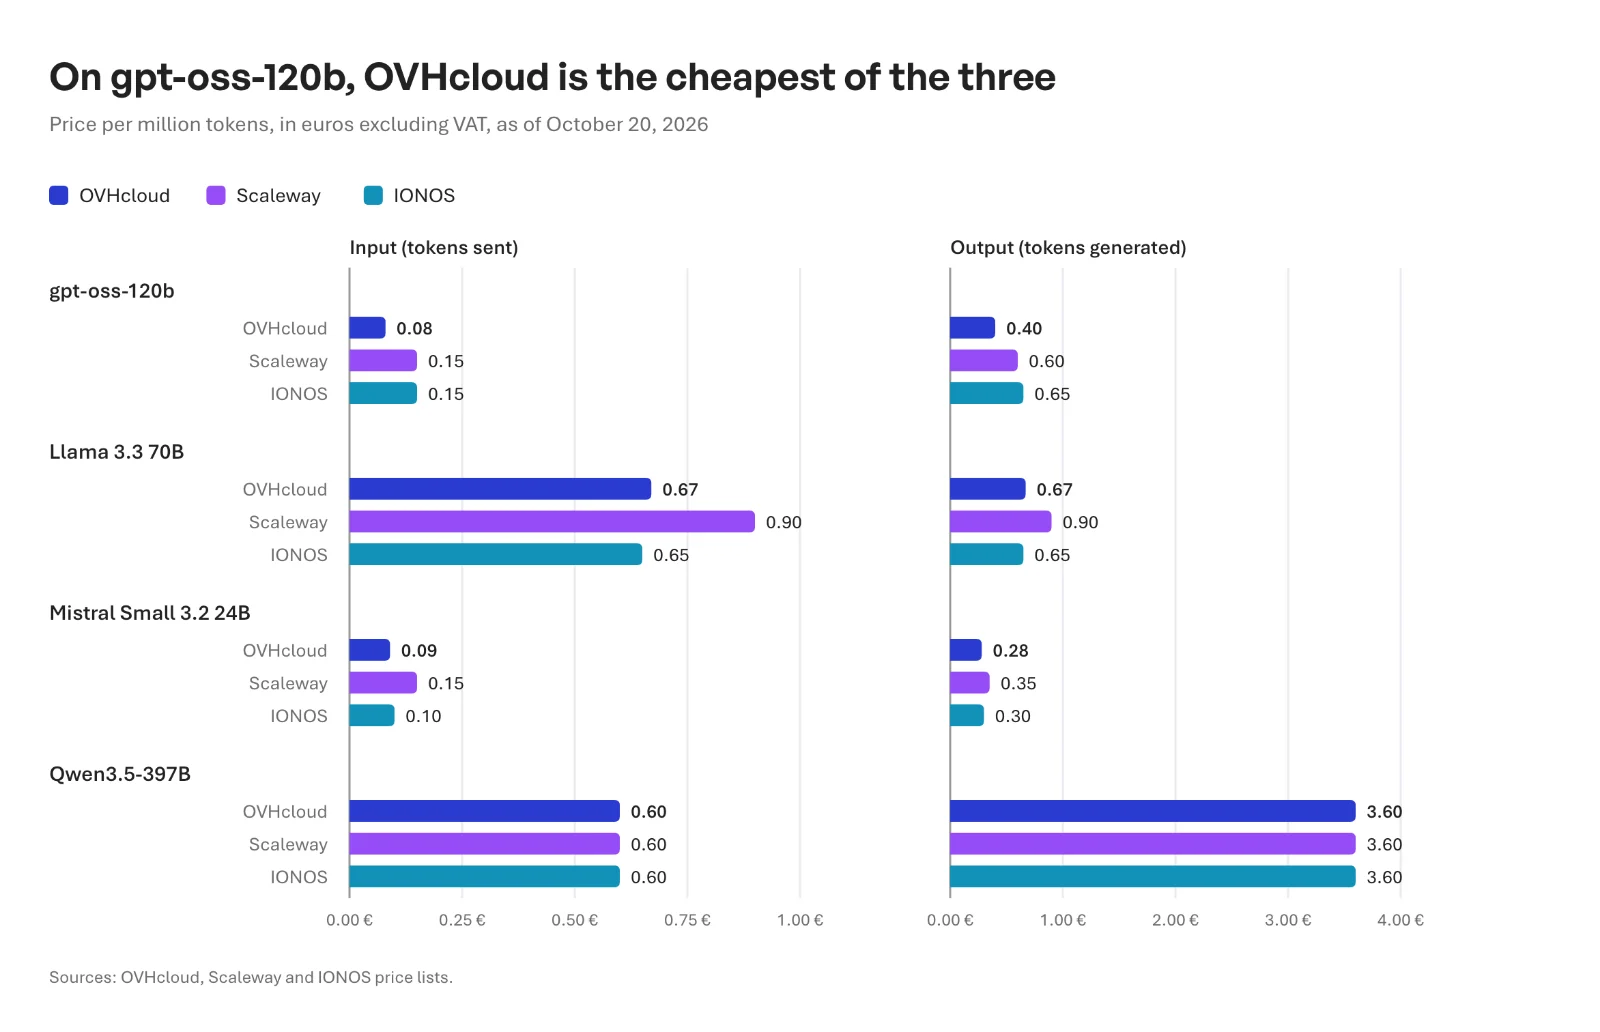 Precio por millón de tokens en euros sin impuestos a 20 de octubre de 2026, primero de entrada y después de salida. gpt-oss-120b: OVHcloud 0,08 y 0,40, Scaleway 0,15 y 0,60, IONOS 0,15 y 0,65. Llama 3.3 70B: OVHcloud 0,67 y 0,67, Scaleway 0,90 y 0,90, IONOS 0,65 y 0,65. Mistral Small 3.2 24B: OVHcloud 0,09 y 0,28, Scaleway 0,15 y 0,35, IONOS 0,10 y 0,30. Qwen3.5-397B: 0,60 y 3,60 en los tres
Una API de procesamiento por lotes, en beta desde junio, divide además la factura por dos para los procesos que pueden esperar un día o más. En cuanto a soberanía, AI Endpoints cumple los cuatro criterios que aplicamos a un proveedor: sociedad de derecho francés, operador del servicio, capital controlado en casi un 80 % por la familia Klaba y alojamiento en Francia. Nuestra página sobre la IA soberana detalla esta tabla de criterios.
Un catálogo reducido, como en los demás proveedores
El catálogo de AI Endpoints muestra 20 modelos, de los que ocho son LLM: gpt-oss de OpenAI, Llama de Meta y varios Qwen de Alibaba. En el lanzamiento de 2025, OVHcloud anunciaba más de 40. Los dos últimos Mistral, Mistral Small 3.2 y Mistral Nemo, tenían anunciada su retirada para el 4 de noviembre de 2026. Solo se ha ido Mistral Nemo: a 17 de noviembre, la API de AI Endpoints sigue sirviendo Mistral Small 3.2.
Esta reducción sigue la tendencia de todo el mercado de la inferencia. La mayoría de los modelos servidos son generalistas: un cliente sustituye un Qwen por un DeepSeek sin reescribir su aplicación. Los proveedores conservan, por tanto, los que ofrecen más inteligencia para su tamaño y retiran enseguida los demás. Scaleway lo escribe en su política: un modelo queda obsoleto «when a newer, more efficient version is available». La estadounidense Groq retiró Llama 3.3 70B de sus ofertas gratuita y para desarrolladores el 16 de agosto de 2026, y recomendó gpt-oss-120b o Qwen3.6-27B, un modelo 2,6 veces más pequeño. Together AI retiró decenas de modelos de su oferta compartida en 2026. Menos modelos, mejor servidos: es la lógica del oficio.
Lo que cuenta entonces es lo actualizados que están esos pocos modelos. OVHcloud añadió Qwen3.8-27B a finales de agosto, pero todavía no los últimos DeepSeek, GLM o Kimi: en su hoja de ruta pública, DeepSeek 3.2 y Kimi K2.5 se cerraron como «not planned» en agosto, y GLM-5.3 o DeepSeek-V4-Flash siguen siendo simples peticiones de usuarios. AI Endpoints tampoco ofrece caché de contexto, una función que reduce mucho el coste de los agentes que releen sin cesar los mismos documentos: la petición está abierta desde septiembre.
Umans: los modelos más recientes desde su lanzamiento
Umans, empresa francesa creada en 2025, lleva esta lógica hasta el final: seis modelos, todos pensados para el código y los agentes y, según la propia empresa, los mejores modelos abiertos de código servidos desde su lanzamiento.
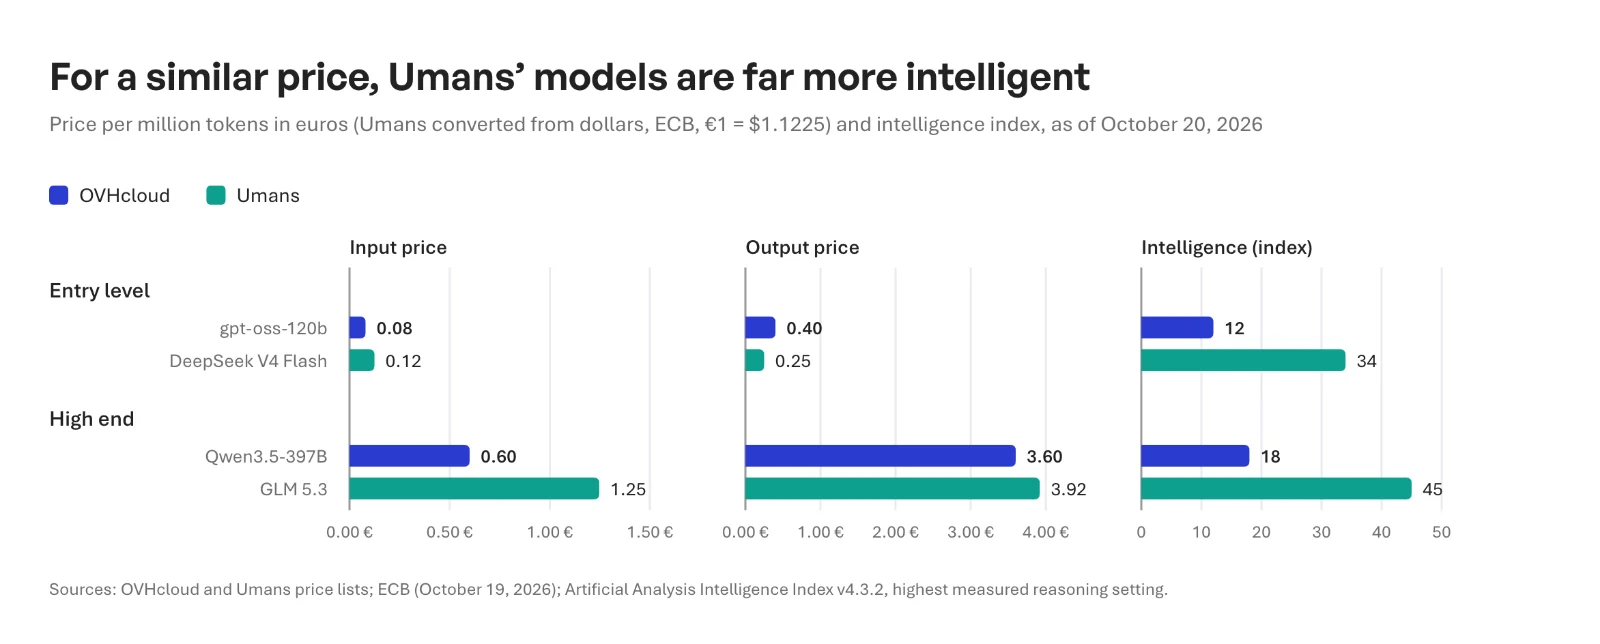 OVHcloud frente a Umans a 20 de octubre de 2026, precio por millón de tokens en euros e índice de inteligencia de Artificial Analysis. Gama de entrada: gpt-oss-120b en OVHcloud, 0,08 € de entrada, 0,40 € de salida, índice 12; DeepSeek V4 Flash en Umans, 0,12 €, 0,25 €, índice 34. Gama alta: Qwen3.5-397B en OVHcloud, 0,60 €, 3,60 €, índice 18; GLM 5.3 en Umans, 1,25 €, 3,92 €, índice 45. Precios de Umans convertidos desde el dólar al tipo de referencia del BCE del 19 de octubre de 2026
Los precios proceden de las tarifas de OVHcloud y de Umans, convertidos desde el dólar al tipo de referencia del BCE del 19 de octubre de 2026 (1 € = 1,1225 $). En cuanto a inteligencia, el índice de Artificial Analysis (versión 4.3.2) da 12 a gpt-oss-120b frente a 34 a DeepSeek V4 Flash, y 18 a Qwen3.5-397B frente a 45 a GLM 5.3, en su ajuste de razonamiento más alto. El resto de la oferta:
| OVHcloud AI Endpoints | Umans | |
|---|---|---|
| Modelos más recientes | Qwen3.8-27B, añadido a finales de agosto de 2026 | DeepSeek V4.1 Flash, GLM 5.3, Kimi K3 |
| Caché de contexto | no | sí |
| Usos cubiertos | texto, embeddings, transcripción, visión, imagen | código y agentes |
| Inferencia en la UE | sí, en Gravelines | bajo petición |
En la gama de entrada, los precios de los dos proveedores son parecidos, pero los modelos de Umans son mucho más inteligentes: su puntuación es de 2,5 a casi 3 veces la de los modelos de OVHcloud. Umans tiene una ventaja significativa en la actualidad de los modelos, y su caché reduce claramente la factura de un agente de código. Según sus propias mediciones, sirve DeepSeek V4 Flash a más de 360 tokens por segundo. Las dos ofertas se complementan: un catálogo generalista alojado en Francia por un lado, los mejores modelos abiertos de código desde su lanzamiento por el otro.
Una velocidad rezagada en los modelos más demandados
Hugging Face enruta peticiones hacia varios proveedores de inferencia, entre ellos OVHcloud, y publica su caudal. La mañana del 20 de octubre, en gpt-oss-120b, OVHcloud era el más lento de los diez proveedores medidos: 35 tokens por segundo, frente a 161 en Scaleway y 227 en Baseten. El mismo puesto en Llama 3.3 70B, entre cuatro proveedores. En cambio, era el más rápido en Qwen3.5-397B, con 105 tokens por segundo frente a 62 en Scaleway. Estas mediciones son una instantánea, y Hugging Face no documenta su método.
OVHcloud no lo oculta. A un cliente que medía 13 tokens por segundo en abril, la empresa le respondió que el servicio, compartido, «can occasionally vary», y le aconsejó desplegar su propio modelo con AI Deploy. En agosto, un responsable técnico escribía que había suspendido un despliegue por esa latencia irregular. Nuestras propias pruebas de AI Endpoints, realizadas antes del giro estratégico impulsado por Octave Klaba, nos habían decepcionado. Por ahora, AI Endpoints no forma parte de los proveedores de inferencia de Ask This Guy. Seguiremos de cerca: repetiremos la prueba con el modelo propio y las nuevas ofertas.
SambaNova: la promesa de endpoints rápidos, todavía invisible
Ahí es donde debía intervenir SambaNova. El 20 de noviembre de 2025, OVHcloud eligió a este fabricante estadounidense de chips de inferencia para unos endpoints «en tiempo real» con rendimiento garantizado, un compromiso de disponibilidad del 99,8 % y una puesta en servicio anunciada en Francia «antes de que acabe el año». Los chips de SambaNova, llamados RDU, están diseñados para servir modelos mucho más rápido que una GPU clásica: en su propia plataforma, SambaNova sirve gpt-oss-120b a 708 tokens por segundo, según Artificial Analysis.
SambaNova presenta la oferta Premium de OVHcloud como «available now». En OVHcloud, en cambio, el 20 de octubre no encontramos ni página de producto, ni precios, ni modelo en el catálogo. La página de su laboratorio sigue mostrando la oferta rápida como «Coming soon», con un compromiso mensual mínimo. Once meses después del anuncio, el cliente que busca tokens rápidos en OVHcloud no los encuentra en autoservicio. Por cierto, ni SambaNova ni AI Endpoints aparecen en el comunicado de resultados, que remite la estrategia de IA a la feria del 19 de noviembre.
¿Por qué entrena OVHcloud su propio LLM?
El miedo a un corte de acceso
La explicación de Octave Klaba cabe en una frase. Si OVHcloud no controla su modelo, «alguien podrá decirnos un día: "Usted es mi competidor, le corto el acceso a mi modelo."» Y añade: «Habremos entregado nuestros datos, harán nuestro trabajo y solo nos quedarán los ojos para llorar.» Según él, nada impide a los grandes laboratorios crear mañana un CRM o un ERP que compita con SAP.
Este escenario no tiene nada de teórico para una empresa francesa; lo describimos en «¿Y si Estados Unidos te cerrara el grifo digital?». Lo nuevo es que un proveedor de nube se lo aplique a sí mismo. Octave Klaba precisa que los modelos se hacen «primero para nosotros, con nuestros datos, no con los de nuestros clientes», para ganar productividad, antes de ofrecerlos eventualmente a los clientes.
Del modelo anunciado a Olala mini
OVHcloud ha elegido tres ámbitos, que el primer modelo «no cubrirá exactamente» todos: la ciberseguridad «ofensiva y defensiva», el código y agentes para finanzas, recursos humanos, jurídico y logística. Octave Klaba promete una arquitectura «muy adelantada a su tiempo», sin dar tamaño ni puntuación. Reuters precisa que se tratará de un modelo «mixture-of-experts», que solo activa una parte de sus parámetros, los «expertos», para cada token procesado.
La ambición se ha reducido. En junio, en VivaTech, Octave Klaba quería entrenar desde cero modelos punteros, mencionaba un primer preentrenamiento realizado en el superordenador europeo Jupiter y estimaba el coste de un proyecto así entre 150 y 200 millones de euros. En octubre, insiste en tres oficios que OVHcloud conoce y en un método: «La idea no es poner hoy miles de millones sobre la mesa, sino comprobar si podemos innovar en este oficio […].» La publicación en código abierto sigue siendo condicional: «Si funciona para nosotros».
El 20 de octubre, el calendario era impreciso: «finales de noviembre» en La Tribune, «principios de 2027» en Reuters. Quien tenía razón era La Tribune. El 17 de noviembre de 2026, OVH anunció Olala mini 7A1B, una mezcla de expertos de 7.000 millones de parámetros, de los que mil millones están activos para cada token, publicada con licencia Apache 2.0. Es un modelo generalista pequeño, todavía no los modelos especializados prometidos: estos quedan para una versión 2.0 de más de 100.000 millones de parámetros, sin fecha. Detallamos lo que vale, y lo que sus cifras no dicen, en nuestro artículo sobre Olala mini.
El caso de Mistral
Octave Klaba no se muerde la lengua. Preguntado por una alianza con Mistral, responde que «Mistral se parece más, en su negocio, a una consultora tecnológica de IA, porque hace sobre todo integración», y se pregunta por su valoración: «¿Vale ese dinero? No lo sé.» BFM ve en ello una pulla que apunta también a los miles de millones de Mistral. La fórmula es acertada en buena parte. Mistral es ante todo un proveedor de servicios de IA para empresas: reivindica más de 125 empresas clientes, envía investigadores destacados a sus clientes para construir modelos a medida y, según ActuIA, el Estado francés le compra más competencias que licencias. Para atender a esos clientes, desarrolla sus propias tecnologías: modelos, un servicio de inferencia y, con Mistral Compute, capacidad de cálculo alquilada a otras empresas. Es en esta última pieza, financiada en parte por su ronda de 3.000 millones de euros en septiembre de 2026, donde se cruza con OVHcloud, lo que explica el «Mistral se ha declarado competidor de OVHcloud» de Octave Klaba. Detallamos la infraestructura de Mistral en nuestro artículo sobre CoreWeave.
¿Qué piezas ha comprado OVHcloud en 2026?
Lo que no construye, OVHcloud lo compra. Tres adquisiciones desde enero:
- Seald, en enero: cifrado de extremo a extremo, con un kit de desarrollo certificado por la ANSSI (la agencia francesa de ciberseguridad);
- Dragon LLM, antes Lingua Custodia, en marzo: modelos especializados para los sectores regulados, y el punto de partida del laboratorio de IA de OVHcloud, encargado de entrenar y adaptar LLM;
- Gladia, cerrada a finales de julio: la transcripción de voz a texto, en más de 100 idiomas, pagada con acciones nuevas.
La presentación de resultados asocia cada compra a una capa: Dragon LLM al entrenamiento, Gladia a los tokens, Seald a la plataforma, OVHai workspace a los usos. Para financiar lo que viene, Octave Klaba descarta, por ahora, cualquier ampliación de capital: «Quiero invertir el dinero que ganamos.»
¿Cuáles son los límites de esta estrategia?
El presupuesto
OVHcloud generó 24,7 millones de euros de flujo de caja libre en 2026. Mistral levantó 3.000 millones en una sola operación. Citado por Le Monde Informatique, Neil Shah, analista de Counterpoint, recordaba en junio que un modelo se deprecia «si no se entrena de forma regular». Un LLM se paga todos los años, no una sola vez.
Los precedentes
El fundador de la alemana Aleph Alpha lo resumía en 2024, al cambiar de modelo de negocio: «Just having an European LLM is not sufficient as a business model». En el extremo opuesto, Alibaba se sirve de sus modelos Qwen, descargados más de 3.000 millones de veces, para atraer clientes a su nube. OVHcloud tiene lo que le faltaba a Aleph Alpha, 1,7 millones de clientes, pero todavía no el modelo que daría ganas de atenderlos.
La calidad de los modelos abiertos
Octave Klaba considera que la calidad de los tokens procedentes de modelos de código abierto «no responde necesariamente a nuestras necesidades». Sin embargo, los mejores modelos abiertos ya solo van cuatro meses por detrás de media de los modelos cerrados, según Epoch AI. Parte del déficit de calidad de AI Endpoints se debe a su propio catálogo, privado de modelos recientes que otros proveedores europeos ya sirven.
La dependencia del hardware
Las GPU son de Nvidia, los chips de la oferta rápida, de SambaNova, y un primer preentrenamiento se hizo en Jupiter, un superordenador equipado con chips de Nvidia. El contrato y los datos siguen bajo derecho francés, lo que cuenta para la soberanía jurídica. Como dice Sanchit Vir Gogia, de la consultora Greyhound, citado por Le Monde Informatique, la soberanía «simplemente cambia la mano» que controla el botón de apagado.
La ciberseguridad, primer eje del modelo
La víspera del anuncio, varias versiones de la herramienta de línea de comandos oficial de OVHcloud contenían un programa espía, introducido por un pirata a través de la cuenta de GitHub de un colaborador. El incidente no dice nada del futuro modelo. Recuerda que la seguridad de la cadena de software también se demuestra en casa.
Lo que un CIO puede sacar en claro
- Probar AI Endpoints con la carga propia. Para procesamiento por lotes, extracción o clasificación, la relación calidad-precio en gpt-oss es muy buena y el servicio es soberano. Para un agente o un asistente interactivo, conviene medir la latencia en horas punta antes de comprometerse.
- No elegir un proveedor por un modelo que no se ha medido. Olala mini, el primer LLM de OVH, se ha anunciado sin puntuación de calidad: habrá que juzgarlo con pruebas, una vez publicados sus pesos y su informe técnico el 19 de noviembre, como explicamos en nuestro artículo sobre Olala mini.
- Prever la sustitución de los modelos. En todos los proveedores, los modelos se retiran a medida que llegan otros mejores: tres meses de preaviso en OVHcloud y Scaleway, dos o tres semanas en Together AI. Un uso en producción debe prever su sustituto y probarlo.
- Aplicarse el razonamiento de Klaba. Una empresa que construye sus procesos sobre un solo modelo se expone a un corte, a una subida de precios o a un proveedor convertido en competidor. Una pasarela LLM permite cambiar de proveedor sin reescribir las aplicaciones, y un modelo de pesos abiertos sirve de solución de respaldo.
- Distinguir soberanía jurídica e independencia técnica. OVHcloud resuelve la primera: derecho francés, capital francés, datos en Francia. La segunda, incluidos chips y modelos, hoy no existe en nadie en Europa. Nuestra comparativa de las formas de ejecutar un modelo en la empresa ayuda a elegir el compromiso adecuado.
Por transparencia: Ask This Guy aloja sus servidores en OVHcloud, en Gravelines, Umans es uno de nuestros socios y utilizamos varios proveedores de inferencia europeos, como explicamos en nuestro panorama de las IA francesas.
Preguntas frecuentes
¿Qué es OVHcloud AI Endpoints?
AI Endpoints es el servicio de inferencia de OVHcloud, lanzado en abril de 2025. Da acceso, mediante una API compatible con la de OpenAI, a una veintena de modelos de pesos abiertos (gpt-oss, Llama, Qwen, Whisper) alojados en Gravelines, en Francia. La facturación se hace por millón de tokens, y una API de procesamiento por lotes cuesta la mitad para las tareas no urgentes.
¿Ha cumplido OVHcloud su calendario para el LLM?
En la fecha, sí; en la ambición, no. Octave Klaba había anunciado a La Tribune, el 20 de octubre de 2026, una publicación a finales de noviembre; Reuters hablaba de principios de 2027. OVH anunció Olala mini 7A1B el 17 de noviembre de 2026, con los pesos previstos en Hugging Face el 19 de noviembre. Pero es un modelo pequeño de 7.000 millones de parámetros: los modelos especializados y los grandes modelos quedan para una versión 2.0, sin fecha.
¿Es soberano OVHcloud AI Endpoints?
Sí, en sentido jurídico. El servicio lo presta OVH SAS, sociedad francesa cuyo capital controla en casi un 80 % la familia Klaba, y sus condiciones no nombran a ningún subencargado externo para ejecutar los modelos. El catálogo los sitúa en Francia; la documentación solo dice «Europa» desde el 10 de noviembre de 2026, y el lugar no está garantizado por contrato. No hay ninguna matriz estadounidense: por esa vía, el servicio no está expuesto a la CLOUD Act. Las GPU y los chips proceden, en cambio, de proveedores estadounidenses, Nvidia y SambaNova.
¿En qué consiste la asociación entre OVHcloud y SambaNova?
En noviembre de 2025, OVHcloud eligió a SambaNova, fabricante estadounidense de chips dedicados a la inferencia, para ofrecer endpoints rápidos con rendimiento garantizado, un 99,8 % de disponibilidad y un compromiso de consumo. SambaNova presenta la oferta como disponible, pero OVHcloud no había publicado ni página de producto ni precios a 20 de octubre de 2026.
¿Qué diferencia hay entre OVHcloud AI Endpoints y Umans?
Las dos ofertas son complementarias. OVHcloud AI Endpoints sirve una veintena de modelos generalistas (texto, embeddings, transcripción, visión) desde Gravelines, a precios entre los más bajos de Europa. Umans, empresa francesa creada en 2025, sirve seis de los modelos más recientes de código y agentes (DeepSeek V4.1 Flash, GLM 5.3, Kimi K3), con caché de contexto e inferencia en la Unión Europea bajo petición. En la gama de entrada, sus precios son parecidos, pero los modelos de Umans son mucho más inteligentes: 34 frente a 12 en el índice de Artificial Analysis para DeepSeek V4 Flash frente a gpt-oss-120b.
¿Es Mistral una consultora tecnológica?
En parte. El 20 de octubre de 2026, Octave Klaba, consejero delegado de OVHcloud, consideró que Mistral «se parece más, en su negocio, a una consultora tecnológica de IA, porque hace sobre todo integración». Mistral es ante todo un proveedor de servicios de IA para empresas: reivindica más de 125 empresas clientes y destaca investigadores en algunas de ellas para construir modelos a medida. A diferencia de una consultora tecnológica clásica, desarrolla sus propias tecnologías, entre ellas modelos, un servicio de inferencia y, con Mistral Compute, capacidad de cálculo alquilada a otras empresas.
Para triunfar en IA, a OVHcloud casi le bastaría con servir rápido modelos actualizados: la infraestructura y los precios ya los tiene. El primer LLM, Olala mini, dirá con sus primeras puntuaciones si la empresa sabe investigar. Los meses siguientes dirán si sabe vender lo que anunció en noviembre de 2025.
Para una empresa, la lección de Octave Klaba es más útil que su modelo: no depender nunca de un solo proveedor para una pieza de la que depende su negocio.