EuroHPC und AI Factories: Das öffentliche Geld hinter Olala
Olala, das LLM von OVH, wurde auf öffentlichen Supercomputern trainiert. EuroHPC, AI Factories, GENCI: Wer zahlte, wie viel, und wie KMU Zugang erhalten.

Am 19. November 2026 hat OVH die Gewichte von Olala mini veröffentlicht, seinem ersten LLM, zusammen mit einem technischen Bericht, dessen Danksagungen verraten, wer die Rechenzeit bezahlt hat. Das Pre-Training lief auf JUPITER, dem europäischen Supercomputer von EuroHPC, im Rahmen eines von der Europäischen Union finanzierten Wettbewerbs; das Fine-Tuning auf Jean Zay, dem öffentlichen französischen Supercomputer; ein Teil der Arbeiten an Agenten auf MeluXina in Luxemburg, mit Guthaben der „AI Factories“ (KI-Fabriken) von EuroHPC. OVH beziffert diese Unterstützung auf den Gegenwert von 7 Mio. € an Rechenstunden.
Anders gesagt: Die Rechenleistung für Olala ist fast vollständig öffentlich finanziert. Die Gesamtkosten des Modells sind dagegen nicht veröffentlicht: Welchen Anteil das öffentliche Geld daran trug, lässt sich nicht sagen, nur dass er erheblich ist.
Daran ist nichts Ungewöhnliches: Diese Programme wurden geschaffen, damit europäische Akteure Modelle trainieren. Die meisten stehen auch europäischen KMU und Start-ups offen, oft kostenlos und unter Bedingungen, und Olala zeigt sehr konkret, wie sie funktionieren.
Wie hat öffentliches Geld Olala finanziert?
Olala wurde in drei Schritten trainiert, jeder auf einer anderen öffentlichen Maschine und über ein anderes Programm. Der technische Bericht beschreibt sie im Einzelnen:
| Schritt | Öffentliche Maschine | Programm | Land |
|---|---|---|---|
| Pre-Training (12.800 Milliarden Tokens) | JUPITER, 1.024 GH200-GPUs | Large AI Grand Challenge, Zugang vergeben von EuroHPC | Deutschland |
| Überwachtes Fine-Tuning, Reinforcement Learning | Jean Zay, H100-GPUs | Zuteilung von GENCI | Frankreich |
| Ein Teil der Agentenforschung | MeluXina | Guthaben der KI-Fabriken von EuroHPC | Luxemburg |
Das Pre-Training: JUPITER und die Large AI Grand Challenge
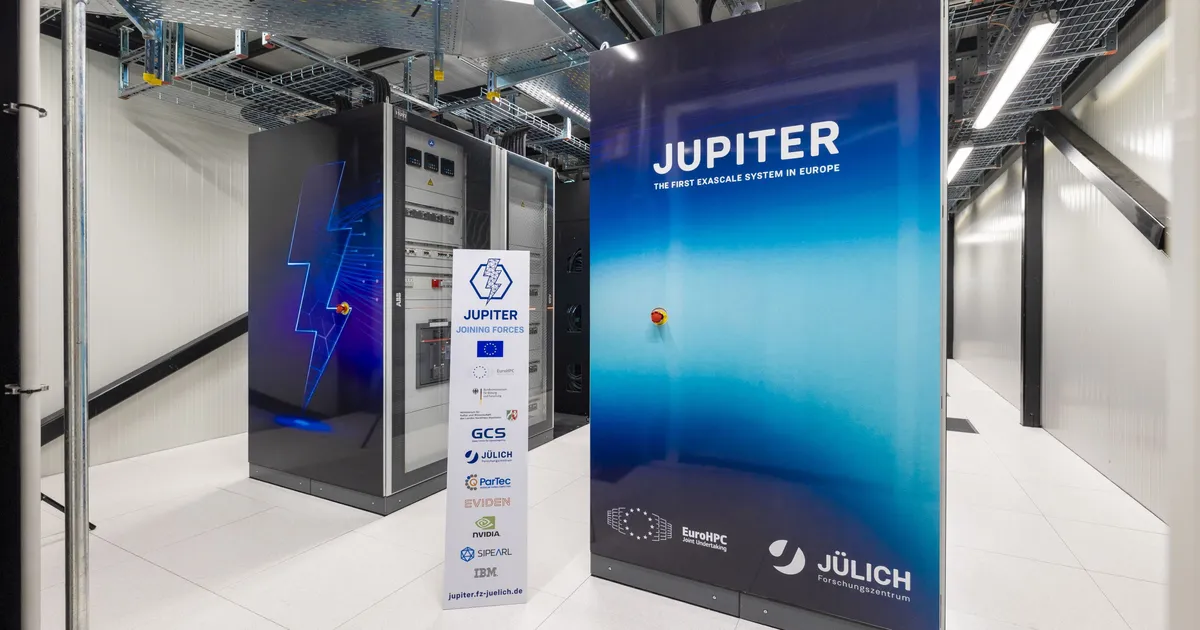
Das Pre-Training ist der aufwendigste Schritt: Das Modell liest 12.800 Milliarden Tokens, um die Sprache zu lernen. Es lief auf 1.024 GH200-GPUs von JUPITER, dem Exascale-Supercomputer, der im September 2025 in Jülich eingeweiht wurde. JUPITER zählt rund 24.000 GH200-Chips von Nvidia; er gehört EuroHPC, das ihn zur Hälfte bezahlt hat, die andere Hälfte kam zu gleichen Teilen vom Bundesforschungsministerium und vom Land Nordrhein-Westfalen. The Register beziffert seine Kosten auf 500 Mio. €, einschließlich sechs Jahren Betrieb.
Den Zugang brachte ein Wettbewerb. Laut dem Bericht wurde „a major part of this work“, ein großer Teil der Arbeit, im Rahmen der Large AI Grand Challenge geleistet, organisiert vom Projekt AI-BOOST mit EuroHPC und finanziert von der Europäischen Union. AI-BOOST ist ein Projekt aus Horizon Europe mit fast 4 Mio. € an EU-Mitteln. Der im November 2023 gestartete Wettbewerb kürte im Juni 2024 vier Gewinner, die sich 1 Mio. € Preisgeld und 8 Millionen Rechenstunden teilten und zwölf Monate Zeit hatten, ihr Modell zu entwickeln. Darunter war Lingua Custodia, ein auf Finanzen spezialisiertes Pariser Start-up, heute Dragon LLM. Das französische Fachportal ActuIA schreibt ihm 3,2 Millionen Stunden auf Leonardo und Jupiter zu.
OVH hat Dragon LLM dann im März 2026 übernommen, um sein KI-Labor zu gründen. Das Eintrittsticket für JUPITER hat also ein Start-up gewonnen, und es kam mit ihm zu OVH.
Das Fine-Tuning: Jean Zay und GENCI
Nach dem Pre-Training lernt das Modell, Anweisungen zu befolgen (überwachtes Fine-Tuning), und dann, besser zu schlussfolgern (Reinforcement Learning). Laut dem Bericht fand der Großteil des Fine-Tunings auf Jean Zay statt, dem Supercomputer, den GENCI am IDRIS bereitstellt. GENCI ist die französische Gesellschaft, die die nationalen Supercomputer finanziert; das IDRIS, das Rechenzentrum des CNRS, der staatlichen französischen Forschungsorganisation, betreibt Jean Zay. Ein Fine-Tuning-Lauf dauerte rund 25 Stunden auf 128 H100-GPUs, und das Reinforcement Learning nutzte bis zu 64 Knoten mit je vier GPUs. Der Bericht nennt ergänzend „a smaller DGX cluster“, einen kleineren DGX-Cluster: die einzige nicht öffentliche Rechenleistung, die er erwähnt.
GENCI öffnet seine Maschinen für Unternehmen, vom Start-up bis zum Großkonzern, kostenlos für offene Forschungsprojekte, unter der Bedingung, dass die Ergebnisse veröffentlicht werden. Anträge laufen über zwei Ausschreibungen pro Jahr.
Die Agenten: MeluXina und die KI-Fabriken
Das letzte Programm ist bescheidener: GPU-Guthaben auf MeluXina, dem luxemburgischen Supercomputer, dienten einem Teil der Agentenforschung. Der Projektcode beginnt mit EHPC-AIF, was aller Wahrscheinlichkeit nach auf die Ausschreibungen der KI-Fabriken von EuroHPC verweist. MeluXina trägt die KI-Fabrik Luxemburgs, seit April 2025 in Betrieb und auf Start-ups und KMU ausgerichtet.
Welchen Anteil der Kosten von Olala hat das öffentliche Geld getragen?
Mangels Daten lässt er sich nicht berechnen. Die von OVH genannten 7 Mio. € sind ein Wert an Rechenzeit, keine ausgezahlte Summe, und die Gesamtkosten von Olala sind nicht veröffentlicht. Die Gehälter, der andere große Posten, trägt OVH selbst. Der Konzern beschäftigt etwas weniger als hundert Personen für KI, über alle Projekte hinweg, und sammelt für diese Strategie kein Kapital ein.
Die Größenordnungen passen dagegen zusammen. Zum Listenpreis einer H100-GPU bei OVHcloud, 2,80 € netto pro Stunde, entsprechen 7 Mio. € rund 2,5 Millionen GPU-Stunden, in derselben Größenordnung wie die 3,2 Millionen Stunden, die Dragon LLM laut ActuIA erhielt.
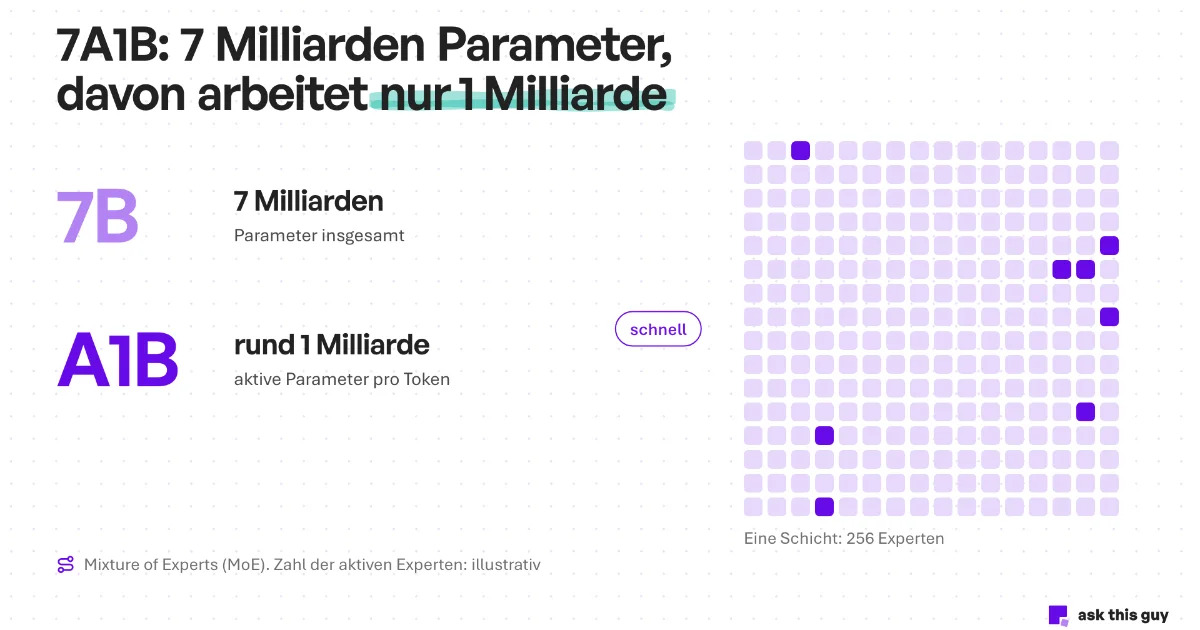
Überraschend ist der kleine Anteil des finalen Laufs. Unsere Schätzung: Ein Modell mit einer Milliarde aktiver Parameter, das 12.800 Milliarden Tokens liest, braucht rund 7,7 × 10²² Rechenoperationen, also 70.000 bis 140.000 GPU-Stunden bei der Effizienz, die der Bericht auf seinen GPUs misst. Das entspricht einigen hunderttausend Euro zu Marktpreisen. Der Großteil der öffentlichen Stunden diente also der Forschung, nicht dem Training des finalen Modells: den zahlreichen vorbereitenden Experimenten, die der Bericht beschreibt, dem Fine-Tuning und dem Reinforcement Learning. So entsteht ein Modell, und aus unserer Sicht ist das der Teil, den ein Start-up am schwersten finanzieren kann.
Bei diesem ersten Modell wiegt der öffentliche Anteil nach unserer Einschätzung so viel wie der private, wenn nicht mehr. Beweisen lässt sich das nicht, solange OVH seine Kosten nicht veröffentlicht.
Was ist EuroHPC?
EuroHPC ist das europäische gemeinsame Unternehmen, das die großen Supercomputer der Union kauft und mitfinanziert, zusammen mit den Staaten, die sie beherbergen. JUPITER ist ein Beispiel dafür: Eigentum von EuroHPC, zur Hälfte vom gemeinsamen Unternehmen bezahlt und zur Hälfte von Deutschland. Diese Maschinen mietet man nicht wie eine Cloud: Ihre Rechenzeit wird vor allem auf Antrag vergeben, über Ausschreibungen, die „open to all users“ sind, also Forschenden wie Unternehmen offenstehen. Für die Forschung und für innovative KMU ist sie kostenlos, andere Unternehmen zahlen nach Nutzung.
Das Budget zieht nach. Im Februar 2025 startete die Kommission InvestAI, das für KI 200 Milliarden Euro mobilisieren soll, darunter einen Fonds von 20 Milliarden für KI-„Gigafactories“. Dieser Betrag mischt öffentliches und privates Geld: Er ist ein Mobilisierungsziel, kein öffentlicher Haushaltsposten.
Was sind die AI Factories von EuroHPC?
Eine KI-Fabrik ist ein Zentrum, das einen öffentlichen Supercomputer für Unternehmen und Forschende öffnet, die KI entwickeln, mit Rechenleistung, Begleitung und Schulung. Die Union zählt 19 davon, ergänzt durch 13 Außenstellen, die KMU und Start-ups kostenlos begleiten. In Frankreich wird AI Factory France von GENCI getragen, zusammen mit CEA, CNRS, Inria, French Tech oder Station F, und bietet einen einzigen Zugangspunkt zu Jean Zay, Adastra, Joliot-Curie und später Alice Recoque.
EuroHPC bietet vier Zugangswege, am 20. November 2026 alle geöffnet:
| Zugangsweg | Für wen | Umfang | Frist |
|---|---|---|---|
| Playground | KMU, Start-ups, Einsteiger | begrenzte Ressourcen zum Testen | Zugang innerhalb von zwei Werktagen |
| Fast Lane | KI-KMU und KI-Start-ups mit Erfahrung im Hochleistungsrechnen | bis zu 50.000 GPU-Stunden, höchstens drei Monate | Antwort innerhalb von vier Werktagen |
| Large Scale | Modelle mit Bedarf von mehr als 50.000 GPU-Stunden | höchstens ein Jahr | mehrere Stichtage pro Jahr |
| AI for Science | Forschende, öffentlicher Sektor, europäische Projekte | je nach Ausschreibung | je nach Ausschreibung |
Die Zugänge für „industrielle Innovation“ sind für KI-KMU und KI-Start-ups kostenlos, für Innovationsprojekte; andere Unternehmen können nach Nutzung bezahlen. Für ein KMU sind 50.000 kostenlose GPU-Stunden mehr als das Fünfzehnfache des Fine-Tuning-Laufs von Olala auf Jean Zay (25 Stunden auf 128 GPUs, rund 3.200 GPU-Stunden).
Wurde das öffentliche Geld gut eingesetzt?
Aus unserer Sicht ja, und es geht um mehr als Olala. Europa braucht gute eigene Modelle und mehr noch eine europäische Inferenz: Modelle, die bei europäischen Betreibern unter europäischem Recht laufen, ohne Abhängigkeit von einem US-Anbieter, der seine Preise ändern oder den Zugang sperren kann. Beides nährt sich gegenseitig. Wer eigene Modelle trainiert, lernt sie zu betreiben, seine Kunden und ihre Daten bleiben in Europa, und seine Einnahmen finanzieren die nächste Generation. Öffentliche Rechenzeit setzt diesen positiven Kreislauf in Gang, in einer Phase, in der weder ein Start-up noch ein Hoster allein vorankäme.
Olala zeigt, dass der Kreislauf schon läuft. Das Modell steht unter der Apache-2.0-Lizenz, kommerzielle Nutzung eingeschlossen, während die Large AI Grand Challenge nur eine Veröffentlichung unter Open-Source-Lizenz, zumindest für die nicht kommerzielle Nutzung verlangte; der technische Bericht und Datensätze sind öffentlich, und jeder kann es herunterladen und nutzen. Es läuft zudem in Frankreich auf AI Endpoints, dem Inferenzdienst von OVH: auf öffentlichen europäischen Rechnern trainiert, bei einem europäischen Betreiber betrieben.
Geld ist dabei nicht der einzige Gewinn. Der Zugang zu GPUs ist eine eigene Herausforderung, und hier hat die öffentliche Rechenzeit OVH wohl am meisten geholfen. Im Juni 2026 meldete das Unternehmen auf seiner öffentlichen Roadmap, seine H200 seien „fully allocated due to high demand“, und die Blackwell-Generation kam erst im November in sein Angebot. Das Pre-Training von Olala konnte auf einen Schlag 1.024 GH200 von JUPITER nutzen, ohne Kunden Kapazität wegzunehmen oder auf eigene Lieferungen zu warten. Die öffentliche Rechenzeit hat OVH Zeit gespart, nicht nur Geld.
Zwei Punkte bleiben zu beobachten, ohne diese Bilanz zu ändern. Die Stunden gewann ein Start-up, heute nutzt sie OVH, nach einer gewöhnlichen Übernahme. Und die Regeln des Wettbewerbs sahen ein Modell mit mindestens 30 Milliarden Parametern vor, von Grund auf trainiert: Olala mini hat 7, doch die angekündigte Version 2.0 mit 100 bis 300 Milliarden Parametern laut Octave Klaba ginge weit darüber hinaus.
Diese Version 2.0 wird die Kosten auf eine andere Stufe heben, wie wir in unserem Artikel über die KI-Strategie von OVH erläutern. Braucht sie erneut öffentliche Rechenzeit, sähen wir darin kein Scheitern. Angesichts dessen, was souveräne KI für die kommenden Jahre bedeutet, ist das aus unserer Sicht gut eingesetztes Geld.
Was ein Unternehmen daraus mitnehmen kann
- Öffentliche Supercomputer sind nicht der Forschung vorbehalten. Ein KMU oder ein KI-Start-up kann im Playground oder in der Fast Lane Stunden beantragen, kostenlos für ein Innovationsprojekt, mit einer Antwort innerhalb weniger Tage.
- Den passenden Zugangsweg wählen. Die KI-Fabriken eignen sich für Experimente und das Fine-Tuning eines Modells; GENCI in Frankreich für ein Forschungsprojekt, dessen Ergebnisse man zu veröffentlichen bereit ist; Large Scale für das Training eines Modells.
- Die Gegenleistung abwägen. Die kostenlose Rechenzeit hat Bedingungen: Innovation, Veröffentlichung, begrenzte Dauer. Ein Dienst in Produktion, mit Kunden und Verfügbarkeitszusage, gehört zu einem Cloud- oder Inferenzanbieter, wie wir in unserem Vergleich der Wege, ein Modell im Unternehmen zu betreiben, erklären.
- Nutzen, was öffentliches Geld bereits hervorgebracht hat. Olala steht unter Apache 2.0: ein europäisches Modell, auf öffentlicher Rechenleistung trainiert, das ein Unternehmen auf eigenen Servern betreiben kann, ohne von einem US-Anbieter abzuhängen, eines der Kriterien souveräner KI.
Häufige Fragen zu KI-Fabriken, EuroHPC und Olala
Was sind die KI-Fabriken von EuroHPC?
Die KI-Fabriken (AI Factories) von EuroHPC sind europäische Zentren, die einen öffentlichen Supercomputer für Unternehmen und Forschende öffnen, die KI entwickeln, mit Rechenleistung, Begleitung und Schulung. Die Union zählt 19 davon, ergänzt durch 13 Außenstellen. In Frankreich wird AI Factory France von GENCI getragen und gibt Zugang zu Jean Zay, Adastra, Joliot-Curie und später Alice Recoque.
Was ist EuroHPC?
EuroHPC ist das europäische gemeinsame Unternehmen, das die großen Supercomputer der Union kauft und mitfinanziert, zusammen mit den Staaten, die sie beherbergen, etwa JUPITER in Deutschland, zur Hälfte von EuroHPC bezahlt. Seine Rechenzeit wird kostenlos auf Antrag vergeben, über Ausschreibungen, die Forschenden und Unternehmen offenstehen.
Wurde Olala mit öffentlichem Geld finanziert?
Die Rechenleistung fast vollständig. Das Pre-Training lief auf JUPITER im Rahmen der Large AI Grand Challenge, das Fine-Tuning auf Jean Zay dank GENCI, ein Teil der Agentenforschung auf MeluXina. OVH bewertet diese Unterstützung mit 7 Mio. € an Rechenstunden. Die Gehälter und alles Übrige trägt OVH, ohne veröffentlichten Betrag. Über das Geld hinaus gaben diese Rechner OVH sofort Zugang zu GPUs, während die eigenen ausgelastet waren: ein Gewinn an Zeit ebenso wie an Budget.
Kann ein KMU einen europäischen Supercomputer kostenlos nutzen?
Ja, unter Bedingungen. Die Zugänge Playground und Fast Lane der KI-Fabriken sind für KI-KMU und KI-Start-ups mit einem Innovationsprojekt kostenlos; die Fast Lane umfasst bis zu 50.000 GPU-Stunden über drei Monate, mit einer Antwort innerhalb von vier Werktagen. In Frankreich öffnet GENCI außerdem Jean Zay kostenlos für Unternehmen, bei offenen Forschungsprojekten, deren Ergebnisse veröffentlicht werden.
Was ist die Large AI Grand Challenge?
Ein Wettbewerb, den das europäische Projekt AI-BOOST im November 2023 mit EuroHPC und der Kommission gestartet hat. Im Juni 2024 teilten sich vier Start-ups, Lingua Custodia, Unbabel, Tilde und Textgain, 1 Mio. € Preisgeld und 8 Millionen Rechenstunden, um in zwölf Monaten ein großes Sprachmodell zu entwickeln, mit einer Pflicht zur Veröffentlichung.
Was ist Dragon LLM?
Dragon LLM ist die frühere Lingua Custodia, ein Pariser Start-up für KI-Modelle, die auf Finanzen spezialisiert sind, und Gewinner der Large AI Grand Challenge 2024. OVH hat es im März 2026 übernommen, um sein KI-Labor OVHai LLM zu gründen, das Olala mini trainiert hat.
Der Fall Olala zeigt eine europäische Kette, die funktioniert: Ein Wettbewerb entdeckt ein Start-up, öffentliche Supercomputer liefern ihm die Rechenleistung, ein französischer Anbieter übernimmt es und veröffentlicht ein freies Modell. Für ein europäisches Unternehmen ist die Frage einfacher: Welches Projekt würde es morgen mit 50.000 GPU-Stunden angehen, wenn es sie beantragte?