Comment construire un agent text-to-SQL fiable
Notre retour d'expérience sur le développement d'agents qui interrogent vos bases de données : les pièges à éviter en production et le make or buy.

Brancher un agent IA sur une base de données, ce qu'on appelle le text-to-SQL, lui permet de répondre à bien plus de questions. Chez nos clients, l'exemple type est un agent de troubleshooting sur un produit complexe. Quand la documentation technique ne suffit pas, il cherche dans la base des tickets un cas proche de celui de l'utilisateur et l'aide à résoudre son problème. Il peut ensuite rédiger la mise à jour de la documentation et la soumettre à une personne qui la valide.
Le modèle traduit la question en requête SQL, la plateforme l'exécute, et le modèle lit le résultat. S'il est possible de rapidement coder un agent capable d'interroger une base, en réalité obtenir de bonnes réponses en production, sur un grand nombre de questions, nécessite un investissement important, comme pour un RAG entre le POC et la production.
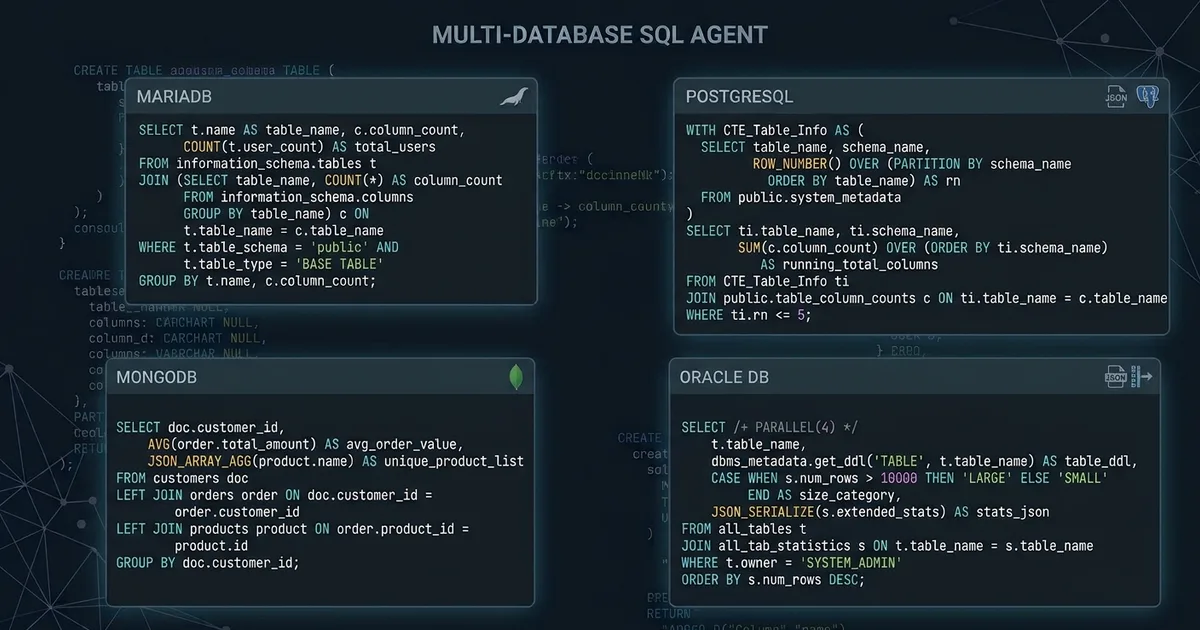
On l'a appris en itérant pendant des mois sur ce type d'agent, avec des clients qui apportaient chacun leurs cas d'usage, leurs schémas et leurs moteurs, notamment MariaDB et PostgreSQL, parfois sur des bases de plusieurs centaines de tables. Chez l'un d'eux, après plusieurs itérations, environ 84 % des appels à notre outil base de données aboutissaient. Depuis le passage à une approche agentique, où l'agent travaille en plusieurs étapes, plus de 99 % des requêtes aboutissent du premier coup. Si vous êtes à la DSI, c'est ce chemin qu'il faut chiffrer avant de lancer un projet maison : des mois d'itérations pour passer de la démo à un outil fiable, puis une maintenance qui ne s'arrête pas.
Voici en 40 secondes ce que fait notre agent. On reprend ensuite les pièges un par un, puis les options pour construire ou acheter.
Deux LLM qui doivent se comprendre
Dans la plupart des architectures, deux modèles travaillent ensemble :
- l'agent principal converse avec l'utilisateur, décide quand interroger la base, puis rédige la réponse ;
- un générateur SQL, appelé comme un outil, reçoit une question et la structure de la base, et écrit la requête ; la plateforme l'exécute et renvoie le résultat à l'agent principal.
Le découpage est logique : l'agent principal n'a pas besoin de connaître 600 colonnes pour discuter, et le générateur peut être un modèle rapide, spécialisé.
Mais chaque passage de l'un à l'autre ajoute de la friction. L'agent principal reformule la question de l'utilisateur avant de la transmettre, et il la reformule parfois mal. Surtout, il lui arrive d'inventer des noms de colonnes plausibles (« filtre sur type_contrat = 'Premium' ») que le générateur prend pour exacts, alors que la colonne s'appelle niveau_contrat et la valeur PREMIUM.
Le coût des allers-retours
Quand la requête échoue, l'erreur remonte à l'agent principal, qui reformule et rappelle le générateur, qui réécrit, et la base exécute de nouveau. Chaque tour ajoute plusieurs secondes d'attente et consomme des appels de modèle.
Si l'erreur renvoyée n'aide pas à se corriger, la boucle tourne à vide. Par exemple un bug qu'on a eu chez un de nos clients, une seule question a enchaîné une vingtaine d'appels en échec : à chaque erreur de colonne, on renvoyait au modèle les colonnes d'une autre table...
C'est ce qui nous a poussés vers l'approche agentique. Au lieu de faire transiter chaque essai par l'agent principal, un analyste de données mène lui-même l'enquête, avec la structure réelle de la base sous les yeux, et ne rend la main qu'avec un résultat. Chez le client cité plus haut, on est passé de près de trois appels à l'outil par réponse à un peu plus d'un.
Maintenir la description de la base
Pour écrire du SQL juste, et vite, le générateur doit connaître la base : les tables, les colonnes, et surtout ce qu'elles veulent dire. Dans une vraie base, la colonne du client facturé s'appelle cd_cli_2, le statut vaut 1 ou 2, et le chiffre d'affaires « s'entend hors avoirs ».
D'habitude, un administrateur rédige une description de la base, que l'on passe au générateur à chaque question. Ça marche, mais c'est long à écrire, et seules deux ou trois personnes dans l'entreprise savent le faire. C'est surtout difficile à maintenir : chaque champ ajouté, renommé ou supprimé rend la description fausse, sans que personne ne soit prévenu. Et sur une grande base, la description complète ne tient plus dans ce qu'on peut envoyer au modèle à chaque question. Il faut choisir quoi montrer.
Quand la description est fausse ou incomplète, le modèle se trompe sans le savoir. Il écrit une requête valide, sur la mauvaise colonne, et la réponse affichée est fausse, avec un modèle parfaitement sûr de lui. Aucune erreur ne remonte, et personne ne s'en aperçoit avant qu'un utilisateur reconnaisse un chiffre qui cloche.
La parade consiste à lire régulièrement la structure dans la base elle-même : la liste réelle des tables et des colonnes, et les commentaires que vos équipes y ont parfois déjà écrits. Ce dictionnaire se met à jour quand la base change, et les humains ne complètent que ce qui manque.
Des résultats de requêtes qui ne tiennent pas dans la réponse
Une requête qui renvoie 5 000 lignes ne peut pas être envoyée telle quelle au modèle. Il faut stocker le résultat à part, ne lui en montrer qu'un aperçu, et lui permettre de le parcourir page par page. Chez nous, le modèle voit au plus 20 lignes du résultat, et lit le reste à la demande.
Ce découpage crée un risque très concret : le modèle calcule sur l'aperçu. On lui montre 20 lignes, il compte, fait une moyenne, et annonce un chiffre faux avec assurance. Il faut lui interdire explicitement de calculer sur un échantillon, et le renvoyer vers la base pour tout agrégat (COUNT, SUM, AVG sur la table entière).
Puis viennent les attentes des utilisateurs, qui ne veulent pas d'un tableau brut dans le chat :
- un graphique lisible, construit à partir du bon jeu de données ;
- un export Excel complet (chez nous, jusqu'à 50 000 lignes), pas seulement les lignes visibles ;
- des relances sur le même résultat (« et uniquement pour l'Île-de-France ? ») sans réinterroger la base pour rien.
Chacune de ces fonctions paraît simple. Ensemble, elles forment un petit produit.
La sécurité : un agent qui ne doit que lire
Le risque d'un agent qui écrit du SQL, c'est qu'il modifie vos données : par erreur, ou parce qu'on le manipule, avec une instruction glissée dans la question d'un utilisateur ou dans un contenu qu'il lit. Le cas du serveur MCP Postgres montre qu'une protection qui semble solide peut céder.
Le MCP permet de brancher une base sur Claude, ChatGPT ou Cursor en quelques lignes de configuration. Le serveur Postgres de référence enveloppait chaque requête dans une transaction en lecture seule. Datadog a montré en août 2025 qu'un simple COMMIT; suivi d'une autre instruction suffisait à en sortir et à exécuter n'importe quelle commande. Le serveur a été déprécié et archivé.
La leçon vaut pour tous les projets :
- la lecture seule doit venir d'un compte de base de données sans droits d'écriture, pas d'un filtre posé par-dessus ;
- chaque requête doit être validée avant exécution : une seule instruction, pas d'écriture, pas de tables système ;
- le modèle ne doit pas pouvoir contourner ces règles, même si un utilisateur le lui demande.
Les droits d'accès : tout le monde ne doit pas tout voir
Autre sujet souvent découvert tard : un commercial du Sud ne doit pas voir le chiffre d'affaires du Nord, et un technicien n'a pas à lire les salaires.
Avec un serveur MCP ou un script maison, l'agent se connecte avec un seul compte : tout utilisateur qui lui parle voit tout ce que ce compte voit. Restreindre par utilisateur suppose de connaître l'identité de la personne qui pose la question, de la faire suivre jusqu'à la requête, et de filtrer en conséquence. C'est faisable, mais c'est une brique d'architecture à part entière, qui touche à l'authentification de votre application.
Construire soi-même : ce que votre DSI devra maintenir
Si vous voulez construire vous-même, Vanna est l'une des bibliothèques open source de référence en text-to-SQL. La version 2.0, sous licence MIT, a été réécrite autour d'un agent, avec des droits par utilisateur et des sorties en tableaux et en graphiques.
Mais la préparation reste à votre charge : pour qu'elle réponde juste, il faut l'« entraîner » avec la structure de la base, de la documentation métier et des exemples de questions accompagnés de la bonne requête SQL. Il faut aussi l'héberger, l'intégrer à votre authentification, la relier à vos documents, et la maintenir à chaque évolution de la base ou des modèles. C'est une bonne base de départ, à condition d'avoir une équipe pour ça dans la durée.
Car le développement initial n'est que le début. Une fois l'agent en production, quelqu'un dans vos équipes devra en permanence :
- suivre le schéma : chaque table ajoutée ou colonne renommée doit se retrouver dans la description, sinon l'agent répond faux ;
- suivre les modèles : les fournisseurs sortent de nouvelles versions tous les quelques mois et retirent les anciennes, et changer de modèle peut changer la façon dont l'agent écrit son SQL ;
- surveiller les erreurs : relire les requêtes en échec et les réponses contestées, comprendre pourquoi, corriger ;
- rejouer un jeu de questions de référence après chaque modification, pour vérifier que rien n'a régressé ;
- tenir les garde-fous à jour : compte en lecture seule, validation des requêtes, droits par utilisateur.
Un exemple : mi-octobre, un fournisseur a changé du jour au lendemain la façon dont l'un de ses modèles respectait un format de réponse imposé, et une de nos briques a dû passer chez un autre fournisseur. C'est notre métier, alors on s'en occupe. Dans une DSI, vos équipes passeront plus de temps à maintenir un système d'IA qu'à innover sur votre cœur de métier, et ce temps-là ne figure presque jamais dans le budget du projet.
Déployer sans développer : Ask This Guy
On a construit ce qu'on aurait voulu trouver : c'est l'agent de la vidéo en tête d'article. Une base se branche sans développement, en quelques minutes, et chaque piège décrit plus haut a sa réponse :
- À la connexion, l'agent lit les tables, les vues et les colonnes, et reprend les commentaires déjà présents dans la base. Vos équipes ne précisent que les codes obscurs («
cd_cli_2, c'est le client facturé »), sans écrire de documentation, et le dictionnaire suit les évolutions de la base. - En mode agentique, il enquête en plusieurs étapes : il cherche ce que veut dire la question, lit les colonnes utiles, vérifie les valeurs, puis lance ses requêtes, dans des limites fixes (45 secondes, six requêtes au plus). Chaque étape s'affiche dans la conversation.
- Il ne fait que lire : compte en lecture seule, une instruction par requête, tables système refusées.
- Ses résultats restent utilisables : jeux de données conservés dans la conversation, graphiques, export Excel.
- Le même agent cherche dans vos documents (SharePoint, Notion, sites web) et interroge vos bases dans la même réponse.
La maintenance est de notre côté : suivi des modèles, garde-fous, évolutions du produit. Vos équipes, elles, s'occupent des questions métier.
Si vous avez un projet où un agent doit accéder à vos données, prenez rendez-vous : en quelques clics, on configure l'agent sur vos propres données, et vous voyez tout de suite si c'est la bonne approche. Pour le panorama complet, voir notre page Talk to Data et l'article Vos bases de données sont une mine d'or.
Questions fréquentes sur le text-to-SQL
Qu'est-ce que le text-to-SQL ?
Le text-to-SQL consiste à traduire une question posée en langage naturel en requête SQL, grâce à un modèle de langage (LLM). La requête est exécutée sur la base de données et le résultat est reformulé en réponse. C'est la technique qui permet de « parler à ses données » sans connaître le SQL.
Pourquoi un agent text-to-SQL donne-t-il de mauvaises réponses ?
Le plus souvent parce qu'il ne comprend pas la base : noms de colonnes obscurs, codes sans explication, description des tables incomplète ou périmée. Le modèle écrit alors une requête valide sur la mauvaise colonne, et la réponse est fausse sans qu'aucune erreur ne s'affiche. Calculer un total à partir d'un simple aperçu du résultat est l'autre cause fréquente.
Un serveur MCP Postgres suffit-il pour un usage en entreprise ?
Pour explorer ses propres données, oui. Pour des dizaines de collaborateurs, il manque l'essentiel : une lecture seule garantie par un compte sans droits d'écriture, des droits par utilisateur, la compréhension métier de la base, la gestion des gros résultats et le croisement avec les documents.
Faut-il construire son agent text-to-SQL ou utiliser une solution existante ?
Construire a du sens si vous avez une équipe pour maintenir dans la durée le moteur, la description de la base, les garde-fous et l'interface. Il faut compter des mois pour fiabiliser l'agent, puis une maintenance continue qui mobilise des développeurs au lieu de les laisser travailler sur le cœur de métier. Si vos questions croisent plusieurs bases et vos documents, ou si vous voulez un résultat en quelques jours, une solution existante vous évite de redécouvrir un à un les pièges de la production.
Si vous lancez le chantier vous-même, deux choses passent avant le premier prompt : créer un compte de base de données en lecture seule, et lister les colonnes que personne dans l'équipe ne sait expliquer. Le compte vous protège, et la longueur de la liste vous dira combien de travail de description vous attend.