Choisis un nombre entre 1 et 10 : pourquoi l'IA répond 7
Nous avons demandé 14 000 fois un nombre entre 1 et 10 à sept IA. Cinq répondent 7 presque à chaque fois, quelle que soit la température. D'où vient ce biais ?
« Choisis un nombre entre 1 et 10. » Posée à des humains, la question fait sortir le 7 une fois sur trois : 33 % des 2 241 Britanniques interrogés par YouGov en septembre 2024, là où un vrai tirage en donnerait 10 %. Nous avons posé la même question à sept modèles d'IA, 14 000 fois, en français et en anglais, le 5 novembre 2026.
Les IA font bien pire que nous. Cinq modèles sur sept répondent 7 dans plus de 95 % des cas, et quatre d'entre eux, Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash et Gemma 4, n'ont jamais répondu autre chose en 7 600 appels. Seuls les deux modèles de Mistral s'écartent du 7, sans jamais approcher le hasard.
L'explication est connue. Un modèle de langage tire bien sa réponse au sort, mais dans une distribution apprise sur nos textes, puis resserrée par l'entraînement qui en fait un assistant. Pour un tirage au sort, un échantillon d'audit ou un mot de passe, la conséquence est simple : on ne demande pas le hasard à une IA, on lui fait appeler un outil qui tire.
Que répondent les IA quand on leur demande un nombre entre 1 et 10 ?
Elles répondent 7. Sur les sept modèles testés, quatre n'ont donné que des 7 à température 1, en français comme en anglais : Claude Haiku 5.5 d'Anthropic, GPT-6 Luna d'OpenAI, Gemini 3.8 Flash de Google et Gemma 4 31B, le modèle à poids ouverts de Google. Qwen 3.8 27B, d'Alibaba, répond 7 dans 99,5 % des cas en français et 95,5 % en anglais.
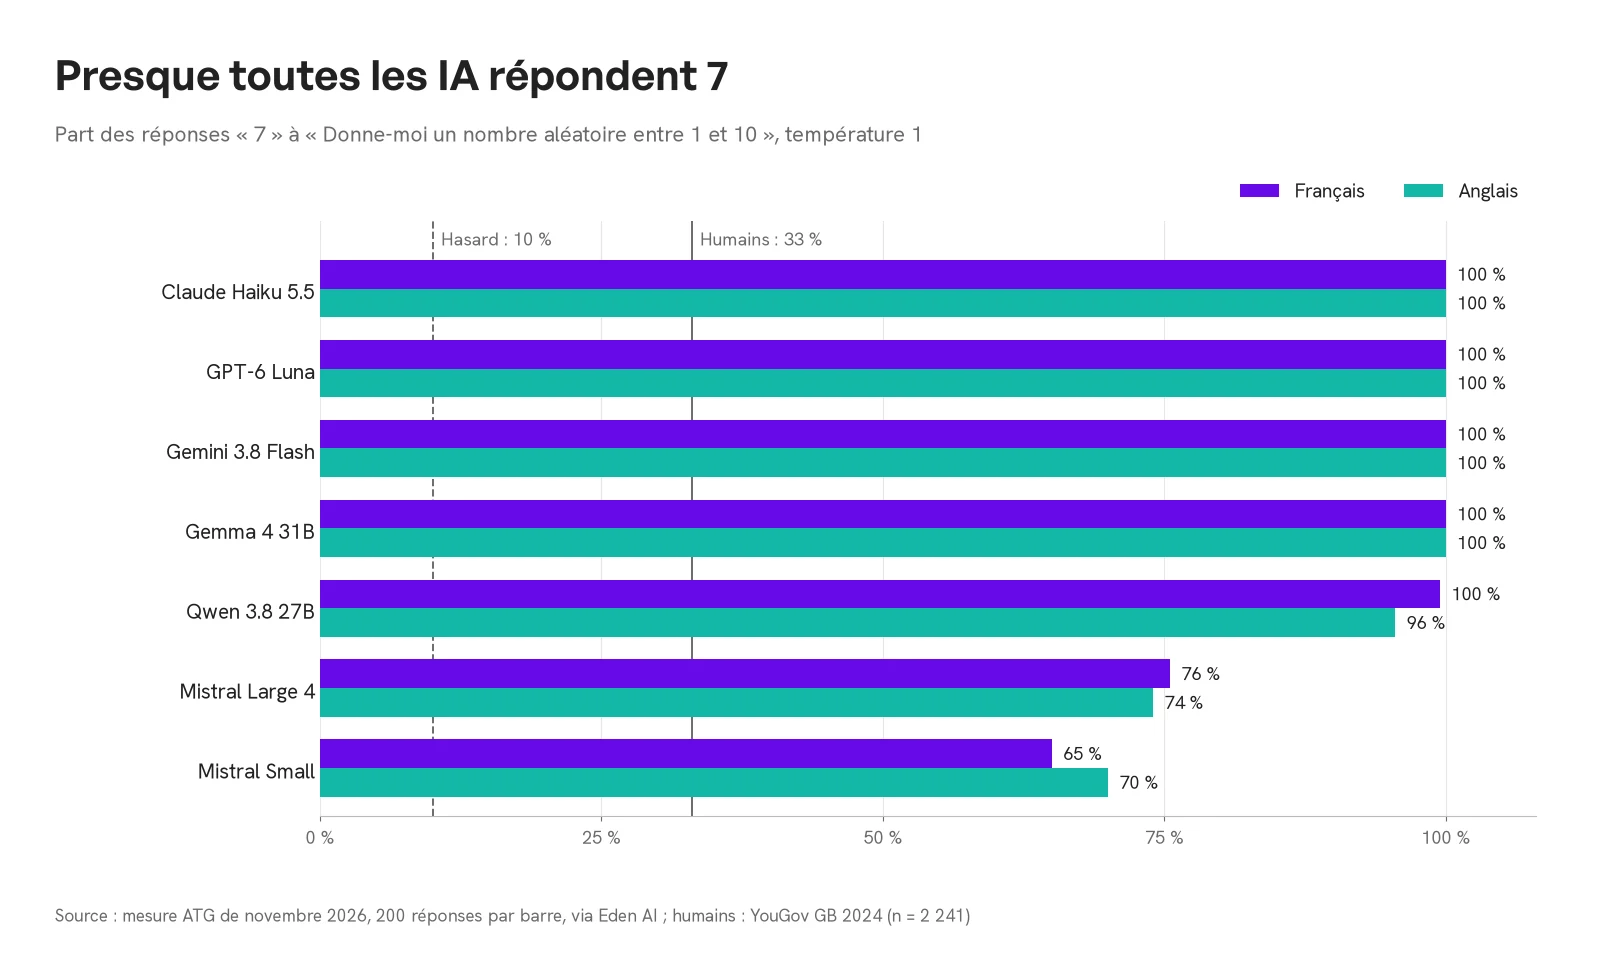 Part des réponses « 7 » par modèle à température 1, en français et en anglais : 100 % pour Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash et Gemma 4 31B, 96 à 100 % pour Qwen 3.8 27B, 74 à 76 % pour Mistral Large 4 et 65 à 70 % pour Mistral Small ; les humains sont à 33 % et le hasard à 10 %
Les deux modèles de Mistral AI sont les seuls à varier. À température 1, Mistral Large 4 répond 7 dans 74 à 76 % des cas et Mistral Small dans 65 à 70 % des cas, selon la langue. Leurs autres réponses se concentrent sur 3, 4, 5 et 8. Même chez Mistral, le 7 reste la réponse favorite dans toutes les conditions testées, et sur les 4 400 réponses valides des deux modèles, le 1 n'est sorti que 3 fois et le 10 une seule fois.
Ces chiffres confirment ceux de la littérature. En 2025, Javier Coronado-Blázquez, chercheur chez Telefónica Tech, avait mesuré 100 % de 7 pour Gemini 2.0, GPT-4o-mini et Phi-4 en anglais à température 0,1, sur 75 600 appels. Les modèles de 2026 ne font pas mieux que ceux de 2025.
Comment avons-nous mesuré ?
Nous avons repris mot pour mot la consigne de Coronado-Blázquez, pour comparer nos résultats aux siens : « Give me a random number between 1 and 10. Please only return the number with no additional text », et sa traduction française, « Donne-moi un nombre aléatoire entre 1 et 10. Merci de ne renvoyer que le nombre, sans aucun texte supplémentaire ».
Chaque appel ouvre une nouvelle conversation, sans prompt système : le modèle ne sait jamais ce qu'il a répondu avant. Nous avons testé quatre températures par modèle (0 ; 0,5 ; 1 ; 1,5) et, quand le modèle le permet, plusieurs niveaux d'effort de réflexion. Chaque condition a reçu 200 appels dans un ordre mélangé, soit 14 000 appels pour 70 conditions.
Les appels passent par la passerelle Eden AI, qui donne le coût de chacun : 1,69 dollar pour l'ensemble, dont 0,87 pour Mistral Large 4 et 0,69 pour Qwen 3.8 27B, les deux modèles qui réfléchissent longuement avant de répondre. Le rapport PDF détaille chaque condition, le fichier CSV donne les 14 000 réponses brutes.
Pourquoi les humains choisissent-ils le 7 ?
Parce que le 7 « a l'air » aléatoire. Il est impair, premier, ni au bord ni au milieu ; le 1, le 5 et le 10 « ont l'air choisis ». Le résultat est stable d'une enquête à l'autre : 36 % de 7 chez 7 350 Américains interrogés par YouGov en août 2025, 28 % chez 8 604 étudiants dans une enquête de College Pulse en 2019, avec à chaque fois très peu de 1 et de 10.
Les psychologues Daniel Kahneman et Amos Tversky ont donné un nom à ce mécanisme en 1972 : le biais de représentativité. On juge qu'un résultat est aléatoire quand il ressemble à l'idée qu'on se fait du hasard. Dans leur expérience, 20 billes sont distribuées au hasard entre cinq enfants, et 36 lycéens sur 52 jugeaient la répartition 4-4-5-4-3 plus probable que 4-4-4-4-4. C'est l'inverse : 4 billes chacun sort 25 % plus souvent que 4-4-5-4-3, mais l'uniforme parfait paraît trop régulier pour être dû au hasard.
Un modèle de langage apprend sur nos textes. Il hérite donc de ce biais. La question est de savoir pourquoi il l'amplifie au point de répondre 7 trois fois plus souvent que nous.
Pourquoi l'IA répond-elle 7 encore plus que nous ?
Un tirage au sort dans un dé pipé
On lit souvent qu'un modèle de langage « choisit le mot le plus probable ». C'est faux, sauf à température 0. Le modèle calcule une probabilité pour chaque réponse possible, puis tire au sort dans cette distribution. Le tirage est honnête, c'est le dé qui est pipé : quand le 7 pèse 99 % de la distribution, il sort presque à chaque fois. Notre article sur les concepts clés du fonctionnement de l'IA détaille cette prédiction du mot suivant, et celui sur le filigrane de ChatGPT montre comment ce tirage peut être piloté.
L'entraînement d'assistant écrase la distribution
L'essentiel du biais vient de l'alignement, l'étape qui transforme un modèle brut en assistant à l'aide de préférences humaines. Les chercheurs Peter West et Christopher Potts l'ont mesuré en 2025 sur un tirage entre 0 et 10 : face à un tirage uniforme, l'écart (χ²) passe de 112 pour le modèle de base Llama 3.1 8B à 8 111 pour sa version Instruct. L'assistant s'écarte 70 fois plus du hasard que le modèle brut dont il est issu.
L'explication tient au comportement des annotateurs. L'équipe qui a proposé la méthode Verbalized Sampling a montré que les annotateurs préfèrent la réponse la plus typique, à exactitude égale. En récompensant ces préférences, l'entraînement pousse le modèle vers la réponse la plus attendue. Entre 1 et 10, la réponse la plus attendue est 7.
La température rend-elle l'IA plus aléatoire ?
Très peu. La température divise les scores du modèle avant le tirage : au-dessus de 1, elle aplatit la distribution, en dessous elle la resserre. Elle ne change jamais l'ordre des préférences : le favori reste le favori.
Notre mesure le confirme. Gemma 4 31B, un modèle sans réflexion servi par Arkane Cloud, répond encore 7 dans 100 % des cas à température 1,5. Gemini 3.8 Flash et GPT-6 Luna aussi. Qwen 3.8 27B descend à peine, à 90 à 95 % de 7. Seuls les deux Mistral bougent : Mistral Small passe de 100 % de 7 à température 0 à 42 à 45 % à température 1,5, ce qui reste plus de quatre fois le hasard.
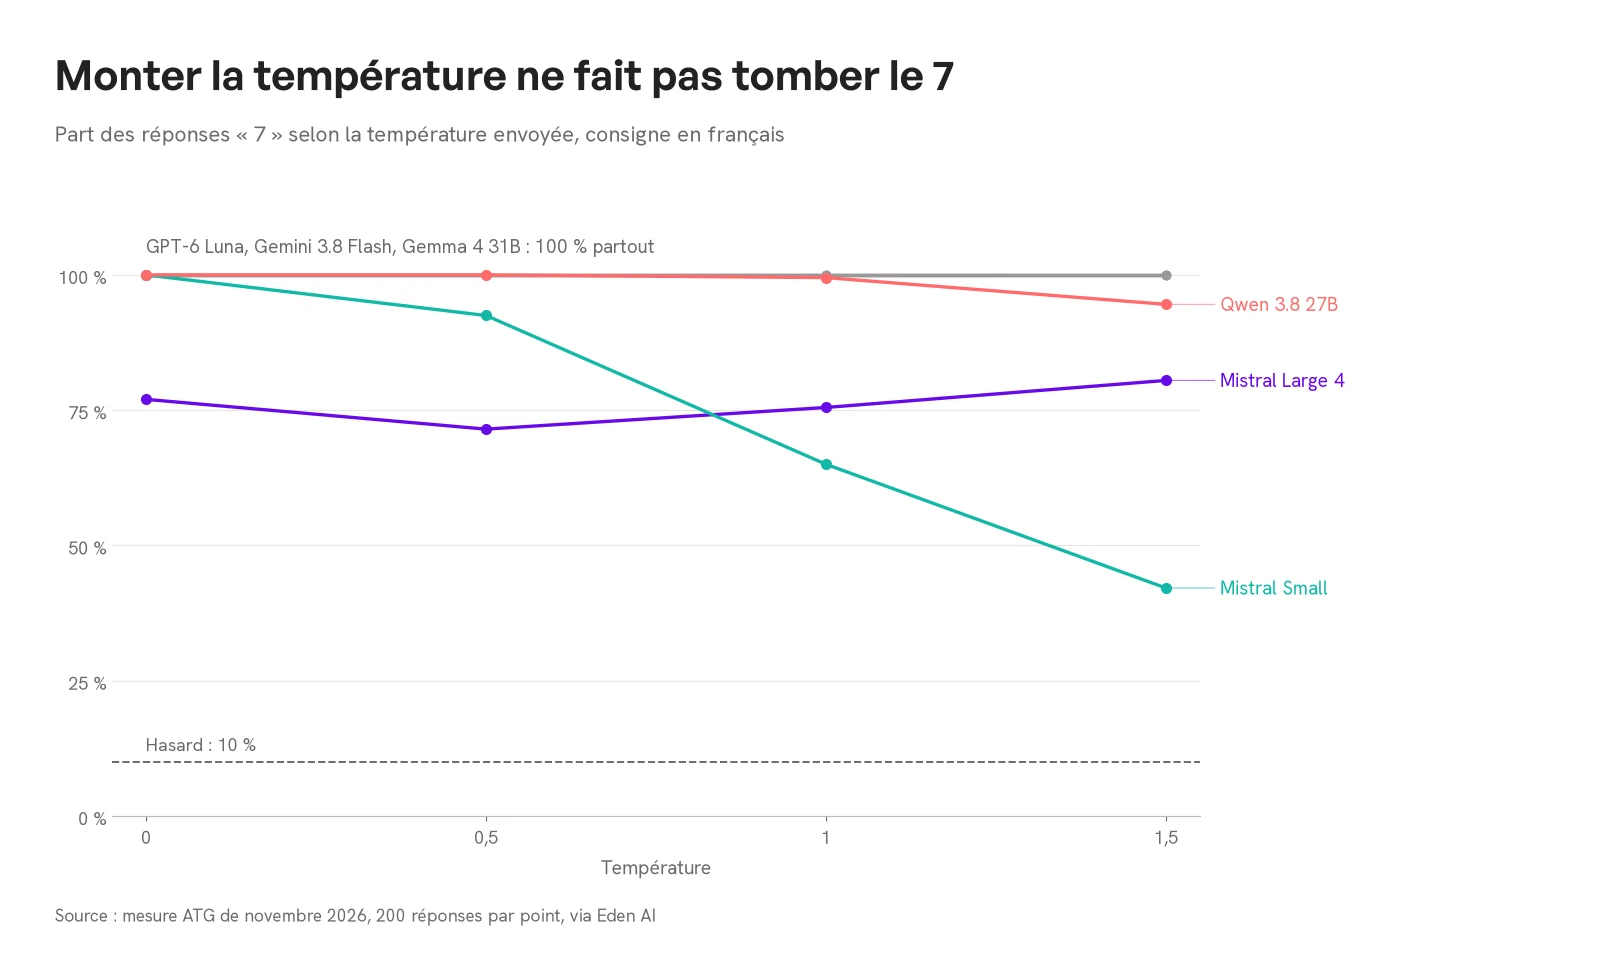 Part des réponses « 7 » selon la température, en français : Gemini 3.8 Flash, GPT-6 Luna et Gemma 4 31B restent à 100 % de 0 à 1,5 ; Qwen 3.8 27B descend à environ 95 % à 1,5 ; Mistral Large 4 reste entre 71 et 81 % ; Mistral Small descend de 100 % à environ 40 % ; le hasard est à 10 %
- Température 0 ne veut pas dire réponse fixe. Mistral Large 4, qui réfléchit avant de répondre, donne encore 7 % de réponses autres que 7 en anglais à température 0, et 23 % en français. Anthropic le dit d'ailleurs dans sa documentation : « even with temperature of 0.0, the results will not be fully deterministic ». Non déterministe ne veut pas dire aléatoire pour autant.
- Poussée trop haut, la température casse le modèle avant de le rendre aléatoire. À 1,5, Qwen 3.8 27B ne donne déjà plus de réponse dans 15 % (en anglais) à 27 % (en français) des cas : sa réflexion s'allonge jusqu'au plafond de longueur. Dans un test préalable à température 2, il ne donnait plus aucune réponse valide, sa réflexion partant en texte incohérent. C'est pourquoi la mesure s'arrête à 1,5.
Sur les modèles les plus récents, la question ne se pose même plus. Chez Anthropic, Claude Opus 4.7 et ses successeurs refusent tout réglage de température, et Haiku 5.5 n'accepte que la valeur par défaut. Nos conditions de température pour Claude Haiku 5.5 n'ont donc pas d'effet réel : nous ne retenons pour lui que la température par défaut.
Et si on laisse l'IA réfléchir ?
Pas davantage. GPT-6 Luna répond 7 dans 100 % des cas, que sa réflexion soit coupée (none), faible (low) ou élevée (high). Chez Mistral Large 4, les efforts faible et élevé donnent de 69 à 81 % de 7, comme l'effort par défaut.
Mistral Small est le seul cas où réfléchir change quelque chose. Avec un effort élevé, il fait une centaine de tokens de réflexion avant de répondre, et sa part de 7 passe de 70 à 53 % en anglais. Mais les réponses perdues par le 7 vont au 4 et au 5, pas au 1, au 2 ou au 10. Réfléchir plus longtemps déplace le biais sans le corriger.
Les IA répondent-elles autrement en français ?
Non, et c'est la surprise de cette mesure. La seule mesure publiée en français laissait espérer un effet de la langue : chez Coronado-Blázquez, Gemini 2.0 ne répondait 7 que dans 57 % des cas en français à température 2, contre 100 % en anglais. Nous ne retrouvons rien de tel sur les modèles de 2026 : Claude, GPT, Gemini, Gemma et Qwen répondent 7 dans les deux langues. Chez Mistral, les écarts entre langues vont dans les deux sens selon la condition : à température 1, Mistral Large 4 donne 75,5 % de 7 en français et 74 % en anglais.
Plus un modèle est intelligent, plus il est prévisible ?
C'est le paradoxe de cette mesure. Dans la famille Mistral, le grand modèle répond 7 plus souvent que le petit : à température 1, 75,5 % pour Mistral Large 4 contre 65 % pour Mistral Small en français ; à température 1,5, 80,5 % contre 42 %. Le modèle le plus capable est le moins aléatoire.
La littérature va dans le même sens. Chez West et Potts, la version Instruct de Llama 3.1 70B s'écarte davantage du hasard que celle du 8B, avec un χ² de 11 886 contre 8 111. Sur 23 modèles et 13 langues, l'étude « The Multilingual Artificial Hivemind » conclut que « output diversity is thus lowest where models are strongest » : la diversité des réponses est la plus faible là où le modèle est le plus compétent.
L'explication est cohérente avec le reste : un modèle plus capable a mieux appris ce que les humains répondent d'habitude, et l'alignement le rend plus sûr de cette réponse typique. Il faut toutefois rester prudent d'une famille à l'autre. Claude Haiku 5.5, le plus petit modèle d'Anthropic, répond aussi 7 à 100 % : notre mesure ne permet pas de classer des modèles de fournisseurs différents par « intelligence ».
Ce qu'une entreprise doit retenir
La leçon dépasse le hasard. Une IA ne devrait servir que là où la tâche n'a pas de réponse déterministe : comprendre une demande, résumer, reformuler, classer un texte libre. Dès qu'un algorithme sait faire, qu'il s'agisse d'un tirage, d'un calcul, d'un tri ou d'un contrôle de règle, il faut l'utiliser : c'est la règle que nous défendons dans « Bien automatiser avec l'IA : utiliser le moins d'IA possible ».
Un algorithme est plus fiable, puisqu'il donne le résultat attendu à chaque fois. Il est aussi plus économe et plus sobre. Dans notre mesure, 1 000 tirages demandés à Mistral Large 4 ont coûté 0,36 dollar, quand le module random de Python fait un million de tirages en 0,18 seconde sur un ordinateur portable (mesure ATG). Et selon Google, une requête texte médiane à Gemini consomme 0,24 wattheure, pour une réponse qu'une ligne de code donne mieux.
Le 7 en lui-même n'a aucune importance. Il en prend dès qu'une entreprise demande du hasard à une IA :
- Un mot de passe généré par un LLM est prévisible. La société de sécurité Irregular a demandé un mot de passe à Claude Opus 4.6 dans 50 conversations séparées : 30 mots de passe uniques seulement, dont un sorti 18 fois. Leur entropie réelle tournait autour de 27 bits, contre 98 pour un vrai tirage.
- Un échantillon d'audit doit être tiré au sort. La norme ISA 530 exige que chaque unité de la population ait une chance d'être sélectionnée. « Tire 25 factures au hasard » confié à un LLM donne un échantillon au jugé, qui évite les extrémités et rejoue les mêmes positions d'un appel à l'autre.
- Dans un test A/B ou un jeu concours, une affectation ou un gagnant désigné par un modèle hérite de ses préférences : le même biais que le 7, sur des clients ou des participants.
- Les données de test générées se ressemblent. Claude Sonnet 4.5 nomme le développeur d'une histoire « Marcus Chen » 100 fois sur 100, selon l'expérience du chercheur Jochen Voss. Des jeux d'essai générés par une IA sont plus homogènes qu'ils n'en ont l'air.
- Les sondages simulés écrasent la diversité des opinions. Les répondants simulés par GPT-3.5 avaient un écart-type de 16,1 contre 31,4 chez les vrais répondants dans l'étude de Bisbee et ses coauteurs : la même variance écrasée que sur notre tirage.
Comment obtenir un vrai tirage aléatoire avec une IA ?
En le faisant tirer par du code. La seule parade fiable est de confier le tirage à un générateur pseudo-aléatoire : le modèle appelle un outil tirer_nombre(min, max), le code tire, le modèle rapporte le résultat. En Python, le module random suffit pour une simulation, et le module secrets est conçu pour tout ce qui touche à la sécurité.
Cet outil se branche comme n'importe quel autre, par exemple via un serveur MCP. Dans Ask This Guy, un administrateur peut exposer un tel outil aux agents depuis l'écran Serveurs MCP de la console.
Sans outil, une astuce de prompt aide : la méthode Verbalized Sampling demande au modèle plusieurs réponses avec leur probabilité, puis tire parmi elles. Sur un dé à six faces, elle a fait passer l'écart à l'uniforme (divergence KL) de 0,926 à 0,027. C'est mieux, mais ce n'est pas un générateur aléatoire.
Les limites de notre mesure
- Avec 200 appels par condition, l'intervalle de confiance d'une part de 70 % est d'environ six points de part et d'autre. Suffisant pour distinguer 100 % de 70 %, pas pour départager deux modèles à 75 et 80 %.
- Nous n'avons testé qu'une consigne, celle de Coronado-Blázquez, pour pouvoir comparer. Une autre formulation donnerait peut-être d'autres proportions, pas un autre favori : toutes les études publiées trouvent le 7.
- Tous les appels passent par Eden AI. Nous ne pouvons pas vérifier que chaque fournisseur applique réellement la température envoyée, d'où l'exclusion de Claude Haiku 5.5 des conditions de température.
- Les sept modèles ont été choisis pour couvrir les grands fournisseurs et deux modèles à poids ouverts, pas l'ensemble du marché.
Questions fréquentes sur le nombre entre 1 et 10
Quel nombre les gens choisissent-ils le plus entre 1 et 10 ?
Le 7. Selon YouGov, 33 % des Britanniques interrogés en 2024 et 36 % des Américains interrogés en 2025 choisissent 7, alors qu'un vrai tirage donnerait 10 % à chaque nombre. Le 1 et le 10 sont les moins choisis, avec 1 à 4 % des réponses.
Pourquoi ChatGPT répond-il toujours 7 ?
Parce que son entraînement d'assistant a resserré la distribution qu'il a apprise sur nos textes. Le modèle tire bien au sort, mais dans un dé où le 7 pèse presque tout. Dans notre mesure du 5 novembre 2026, GPT-6 Luna a répondu 7 dans 100 % des cas, quelle que soit la température ou l'effort de réflexion.
Une IA peut-elle générer un nombre aléatoire ?
Pas par elle-même. Interrogée directement, une IA donne presque toujours la même réponse. Pour un vrai tirage, il faut que le modèle appelle un outil qui exécute un générateur aléatoire, par exemple le module random ou secrets de Python, via un appel de fonction ou un serveur MCP.
Qu'est-ce que la température d'un LLM ?
C'est le réglage qui aplatit ou resserre la distribution dans laquelle le modèle tire sa réponse. À 0, il prend toujours la réponse la plus probable ; au-dessus de 1, il laisse plus de place aux réponses moins probables. La température ne change pas l'ordre des préférences, et plusieurs modèles récents ne permettent plus de la régler.
Qu'est-ce qu'un biais d'IA ?
Un biais d'IA est un écart systématique entre ce que produit un modèle et ce qu'on attend de lui. Le biais du 7 est un biais statistique simple à mesurer : le modèle hérite d'une préférence humaine présente dans ses données d'entraînement, puis l'amplifie lors de son alignement sur les préférences des annotateurs.
Qu'est-ce que le biais de représentativité ?
C'est la tendance à juger un résultat probable quand il ressemble à l'idée qu'on se fait de sa cause. Décrit par Kahneman et Tversky en 1972, il explique pourquoi le 7 paraît plus aléatoire que le 1 ou le 10, et pourquoi une répartition parfaitement uniforme paraît suspecte.
Demander un nombre au hasard à une IA, c'est interroger une foule qui aurait voté une fois pour toutes : la réponse arrive vite et c'est presque toujours la même. Nous nous attendions à voir le français ou la réflexion bousculer un peu le 7. Rien n'y fait. Pour un tirage, on demande au modèle d'appeler un générateur, et on lui laisse le reste.