
 IA
LLM de traduction : Olala d'OVHcloud testé face à DeepL
LLM de traduction : nous avons testé Olala Translate d'OVHcloud face à DeepL et gpt-oss-120b sur 100 extraits de documents. Fidélité, style, coût, vitesse.
11 min
IALLM de traduction : nous avons testé Olala Translate d'OVHcloud face à DeepL et gpt-oss-120b sur 100 extraits de documents. Fidélité, style, coût, vitesse.
 IA
Qwen4-Max est sorti le 16 novembre, sans poids. Qwen 4 27B se fait attendre. Ce qui est confirmé, et ce que vaut Qwen 3.8 27B face à Mistral.
 IA
Olala mini 7A1B, le premier LLM d'OVH, est sur Hugging Face. Ses scores face à Qwen et Ministral, comment le lancer en local, à quoi il sert en entreprise.
 IA
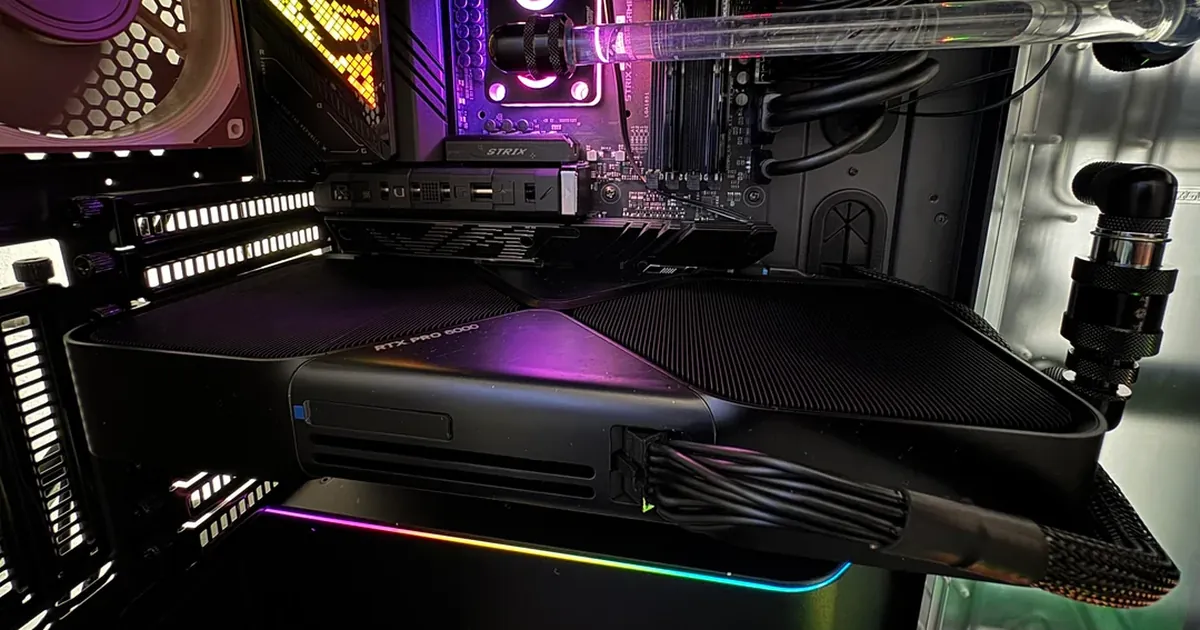
Serveur IA local : poste de travail, carte RTX PRO 6000 ou H200, ce que chaque palier sert avec Qwen 3.8 27B, débits mesurés et prix relevés en novembre 2026.
 Concepts
IA open source en entreprise : ce que chaque licence de modèle ouvert autorise, combien elle fait économiser face aux API, et pourquoi ses règles se durciront.
 IA
DeepSeek V4.1 Pro n'est pas sorti au 16 novembre. Ce qui est confirmé, ce que valent les rumeurs, et DeepSeek V4 Pro aujourd'hui : prix, licence, souveraineté.
 Guide
LLM gateway ou AI gateway : ce que fait une passerelle IA, OpenRouter ou LiteLLM, ce qu'elle coûte et par où passent vos données. Nos relevés de prix inclus.
 Concepts
Modèle open weight ou open source : définition, différences, licences et usages en entreprise. Pourquoi un LLM n'est presque jamais open source comme Linux.
 Concepts
Nous avons demandé 14 000 fois un nombre entre 1 et 10 à sept IA. Cinq répondent 7 presque à chaque fois, quelle que soit la température. D'où vient ce biais ?
 Concepts
Mixture of experts (MoE) ou modèle dense : comment fonctionne chaque architecture, ce qu'elle change pour vos GPU, la vitesse et le prix, et laquelle choisir.
 Concepts
Une IA peut-elle se répliquer seule ? Ce qu'Anthropic a testé sur des objets connectés, ver IA ou virus IA, les limites de l'étude et que faire en entreprise.
 Concepts
OpenAI et Anthropic accusent les labos chinois de distiller leurs modèles. Mais Meta, Google, Mistral et même xAI distillent aussi. Ce que l'on sait vraiment.
 Guide
Inférence IA en entreprise : 7 approches comparées, de l'achat de GPU au fournisseur clé en main. Coûts réels, souveraineté, latence et critères de choix.
 Guide
Pourquoi un seul fournisseur ne suffit pas pour un SLA IA entreprise. Comparatif des engagements, gateway multi-provider et fallback pour RAG et assistants IA.
 Guide
Mistral OCR coûte 4 $ les 1 000 pages. Un OCR open weight sur GPU européen descend à 0,15 $ en restant souverain. Benchmark, seuil de rentabilité et pièges.
 Concepts
API d'embeddings lentes, dépendance à un fournisseur : notre retour d'expérience en production, et pourquoi ATG appelle Qwen 3 Embedding 8B en parallèle.