
 IA
Qwen 4 27B vs Qwen 3.8 27B : que faut-il en attendre ?
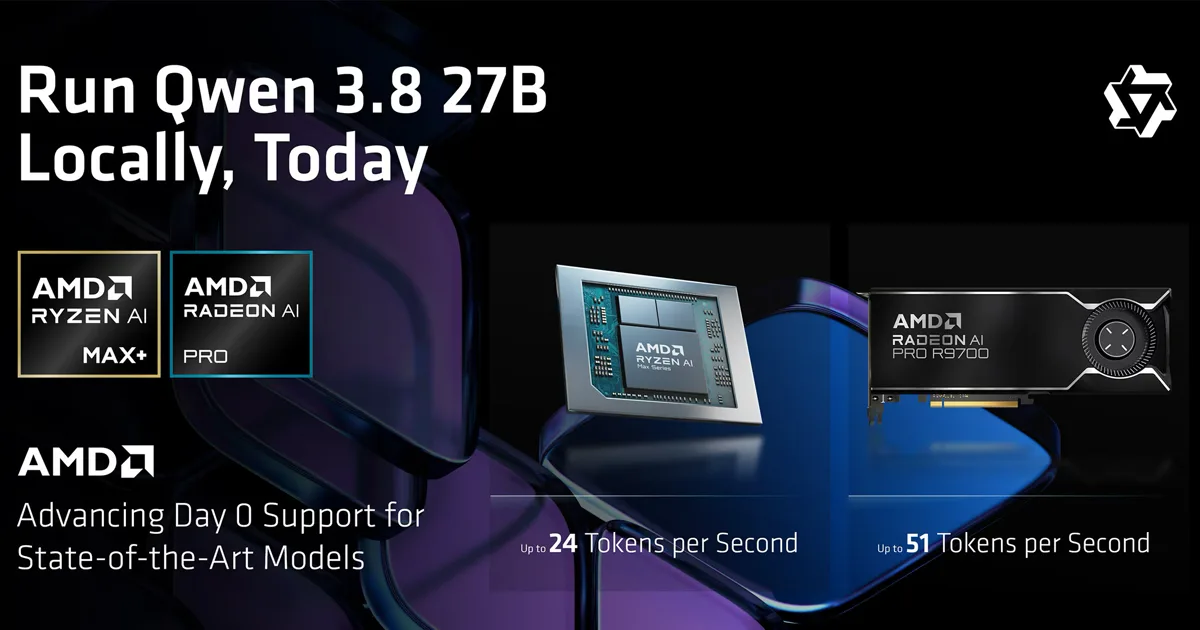
Cet article fait le point sur ce qui est confirmé sur Qwen 4 27B, le futur modèle de Qwen, et sur ce que vaut Qwen 3.8 27B, un dense sur un GPU, face à Mistral.
IACet article fait le point sur ce qui est confirmé sur Qwen 4 27B, le futur modèle de Qwen, et sur ce que vaut Qwen 3.8 27B, un dense sur un GPU, face à Mistral.
 Concepts
Mixture of experts (MoE) ou modèle dense : comment fonctionne chaque architecture, ce qu'elle change pour vos GPU, la vitesse et le prix, et laquelle choisir.
 Souveraineté Numérique
OVHcloud annonce son propre LLM et vise toute la chaîne de l'IA. Ce qui existe déjà (GPU, AI Endpoints), ce qui reste à prouver, ce qu'une DSI peut en retenir.
 Souveraineté Numérique
Pour tous ses produits, Mistral AI ne déclare que deux opérateurs de calcul : ses serveurs et CoreWeave, dont la dette inquiète. Ce qu'un défaut changerait.
 Guide
LLM gateway ou AI gateway : ce que fait une passerelle IA, OpenRouter ou LiteLLM, ce qu'elle coûte et par où passent vos données. Nos relevés de prix inclus.
 Guide
Inférence IA en entreprise : 7 approches comparées, de l'achat de GPU au fournisseur clé en main. Coûts réels, souveraineté, latence et critères de choix.
 Guide
Pourquoi un seul fournisseur ne suffit pas pour un SLA IA entreprise. Comparatif des engagements, gateway multi-provider et fallback pour RAG et assistants IA.
 IA
LLM on premise en 2026 : prix des GPU, mémoire par modèle, coût complet et seuil de rentabilité face au même modèle en API. Les chiffres pour trancher.