OVH et l'IA : ce que vaut la stratégie d'Octave Klaba
OVHcloud annonce son propre LLM et vise toute la chaîne de l'IA. Ce qui existe déjà (GPU, AI Endpoints), ce qui reste à prouver, ce qu'une DSI peut en retenir.
Le 20 octobre 2026, jour de ses résultats annuels, Octave Klaba a annoncé dans La Tribune qu'OVHcloud termine l'entraînement de son premier LLM : « Nous pensons le publier en open source fin novembre ». Le même jour, Reuters lui fait dire que le premier modèle sortira « in early 2027 ». Le modèle n'est qu'une pièce : dans l'IA, OVH veut tenir toute la chaîne, du processeur graphique jusqu'à l'usage.
Une bonne partie de cette chaîne existe déjà. OVHcloud loue des GPU, orchestre l'entraînement et vend des tokens, c'est-à-dire l'accès à des modèles d'IA facturé au volume de texte traité, avec son service AI Endpoints. Sur gpt-oss-120b, il est moins cher que Scaleway et IONOS. Mais il tarde à servir les modèles ouverts les plus récents, et reste en retrait sur la vitesse.
L'argument central d'Octave Klaba, la peur de dépendre d'un fournisseur de modèle, concerne toutes les entreprises.
Que veut faire OVHcloud dans l'IA ?
La stratégie IA d'OVHcloud consiste à vendre l'IA de bout en bout depuis ses propres data centers, sans dépendre d'un intermédiaire. Octave Klaba, revenu à la tête de l'entreprise le 20 octobre 2025, la décrit dans La Tribune en cinq couches :
- les GPU, installés dans ses data centers ;
- leur orchestration, pour l'entraînement et l'inférence ;
- les « tokens as a service », avec « la question de leur prix et de leur qualité » ;
- les outils pour héberger des applications développées avec l'IA ;
- les usages, avec OVHai workspace, une suite de messagerie, de stockage et de visioconférence pilotée par l'IA.
L'atout de départ est physique. OVHcloud dispose de 250 MW de capacité électrique raccordée, dont 140 MW en exploitation, dans des bâtiments qui lui appartiennent, et fabrique ses serveurs dans ses usines. Dans sa lettre aux actionnaires du 20 octobre, Octave Klaba pousse la vision plus loin : « pour la première fois, certains de nos nouveaux produits ne seront plus destinés à des humains, mais aux agents d'IA ».
Les résultats du jour vont dans son sens. Le chiffre d'affaires de l'exercice 2026, clos le 31 août, atteint 1 145,1 millions d'euros, en hausse de 7,2 % à périmètre constant, et le cloud public, où se trouve l'offre IA, progresse de 18,9 %. Le flux de trésorerie disponible est positif pour la première fois depuis l'introduction en Bourse. L'action a pris près de 10 % dans la matinée.
Qu'est-ce qui existe déjà chez OVHcloud ?
Les GPU et l'orchestration
OVHcloud loue des GPU Nvidia à l'heure : un H100 coûte 2,80 € HT de l'heure, une instance de huit H200 coûte 42 € de l'heure. Ses services AI Training, AI Notebooks et AI Deploy servent à entraîner un modèle ou à le déployer sur ces GPU, avec une facturation à la minute. Deux réserves : les instances de huit H200 sont disponibles uniquement à Paris (AI Training, AI Notebooks et AI Deploy en proposent par blocs de quatre à Gravelines), et la génération Blackwell de Nvidia n'est pas encore au catalogue. En juin, OVHcloud indiquait sur sa feuille de route publique que ses H200 étaient « fully allocated due to high demand ».
Les tokens : AI Endpoints
AI Endpoints est l'offre d'inférence d'OVHcloud : une API, compatible avec celle d'OpenAI, qui donne accès à des modèles à poids ouverts hébergés à Gravelines, dans le Nord. Le service a été lancé en avril 2025. C'est la couche sur laquelle OVHcloud se compare directement à Scaleway, à IONOS et aux API des grands laboratoires. Nous y revenons en détail plus bas.
Les usages : OVHai workspace
OVHai workspace a été présenté en aperçu à VivaTech le 17 juin 2026 : messagerie, stockage, visioconférence et recherche confiée à des agents, avec un chiffrement de bout en bout facultatif. Une bêta était annoncée pour le salon de novembre d'OVHcloud. L'entreprise dit d'abord l'utiliser en interne pour gagner en productivité.
AI Endpoints : que valent les tokens d'OVHcloud aujourd'hui ?
Moins cher que Scaleway et IONOS sur plusieurs modèles
Sur les modèles que servent aussi ses concurrents européens, OVHcloud affiche des prix bas, souvent les plus bas. Prix relevés le 20 octobre 2026 sur les grilles d'OVHcloud, de Scaleway et d'IONOS :
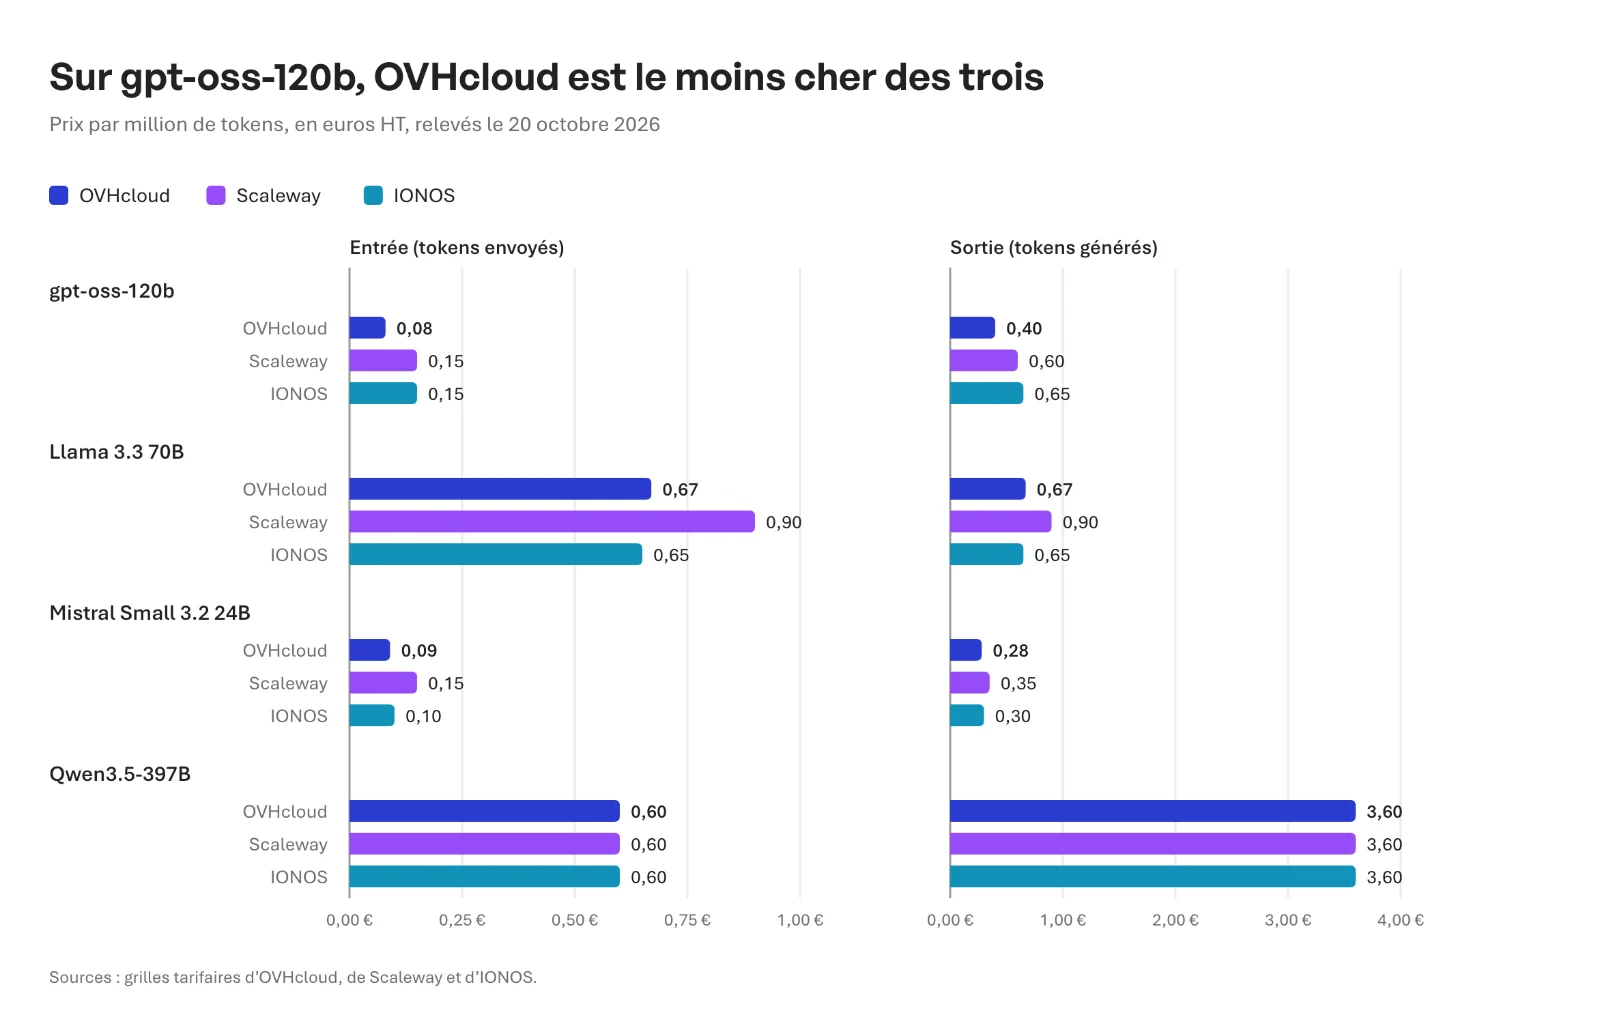 Prix par million de tokens en euros HT au 20 octobre 2026, en entrée puis en sortie. gpt-oss-120b : OVHcloud 0,08 et 0,40, Scaleway 0,15 et 0,60, IONOS 0,15 et 0,65. Llama 3.3 70B : OVHcloud 0,67 et 0,67, Scaleway 0,90 et 0,90, IONOS 0,65 et 0,65. Mistral Small 3.2 24B : OVHcloud 0,09 et 0,28, Scaleway 0,15 et 0,35, IONOS 0,10 et 0,30. Qwen3.5-397B : 0,60 et 3,60 chez les trois
Une API de traitement par lots, en bêta depuis juin, divise encore la facture par deux pour les traitements qui peuvent attendre un jour ou plus. Côté souveraineté, AI Endpoints coche les quatre critères que nous appliquons à un fournisseur : société de droit français, opérateur du service, capital contrôlé à près de 80 % par la famille Klaba, hébergement en France. Notre page sur l'IA souveraine détaille cette grille.
Un catalogue resserré, comme chez les autres fournisseurs
Le catalogue d'AI Endpoints affiche 20 modèles, dont huit LLM : gpt-oss d'OpenAI, Llama de Meta et plusieurs Qwen d'Alibaba. Au lancement de 2025, OVHcloud en annonçait plus de 40. Les deux derniers Mistral, Mistral Small 3.2 et Mistral Nemo, ont déjà quitté le catalogue : ils restent accessibles par l'API jusqu'à leur retrait, le 4 novembre 2026.
Ce resserrement suit la tendance de tout le marché de l'inférence. La plupart des modèles servis sont généralistes : un client remplace un Qwen par un DeepSeek sans réécrire son application. Les fournisseurs gardent donc ceux qui offrent le plus d'intelligence pour leur taille, et retirent vite les autres. Scaleway l'écrit dans sa politique : un modèle est déprécié « when a newer, more efficient version is available ». L'américain Groq a retiré Llama 3.3 70B de ses offres gratuite et développeur le 16 août 2026, en recommandant gpt-oss-120b ou Qwen3.6-27B, un modèle 2,6 fois plus petit. Together AI a retiré des dizaines de modèles de son offre mutualisée en 2026. Moins de modèles, mieux servis : c'est la logique du métier.
Ce qui compte alors, c'est la fraîcheur de ces quelques modèles. OVHcloud a ajouté Qwen3.8-27B fin août, mais pas encore les derniers DeepSeek, GLM ou Kimi : sur sa feuille de route publique, DeepSeek 3.2 et Kimi K2.5 ont été fermés comme « not planned » en août, et GLM-5.3 ou DeepSeek-V4-Flash restent de simples demandes d'utilisateurs. AI Endpoints ne propose pas non plus de cache de contexte, une fonction qui réduit fortement le coût des agents qui relisent sans cesse les mêmes documents : la demande est ouverte depuis septembre.
Umans : les modèles les plus récents dès leur sortie
Umans, société française créée en 2025, pousse cette logique jusqu'au bout : six modèles, tous taillés pour le code et les agents, et, selon elle, les meilleurs modèles ouverts de code servis dès leur sortie.
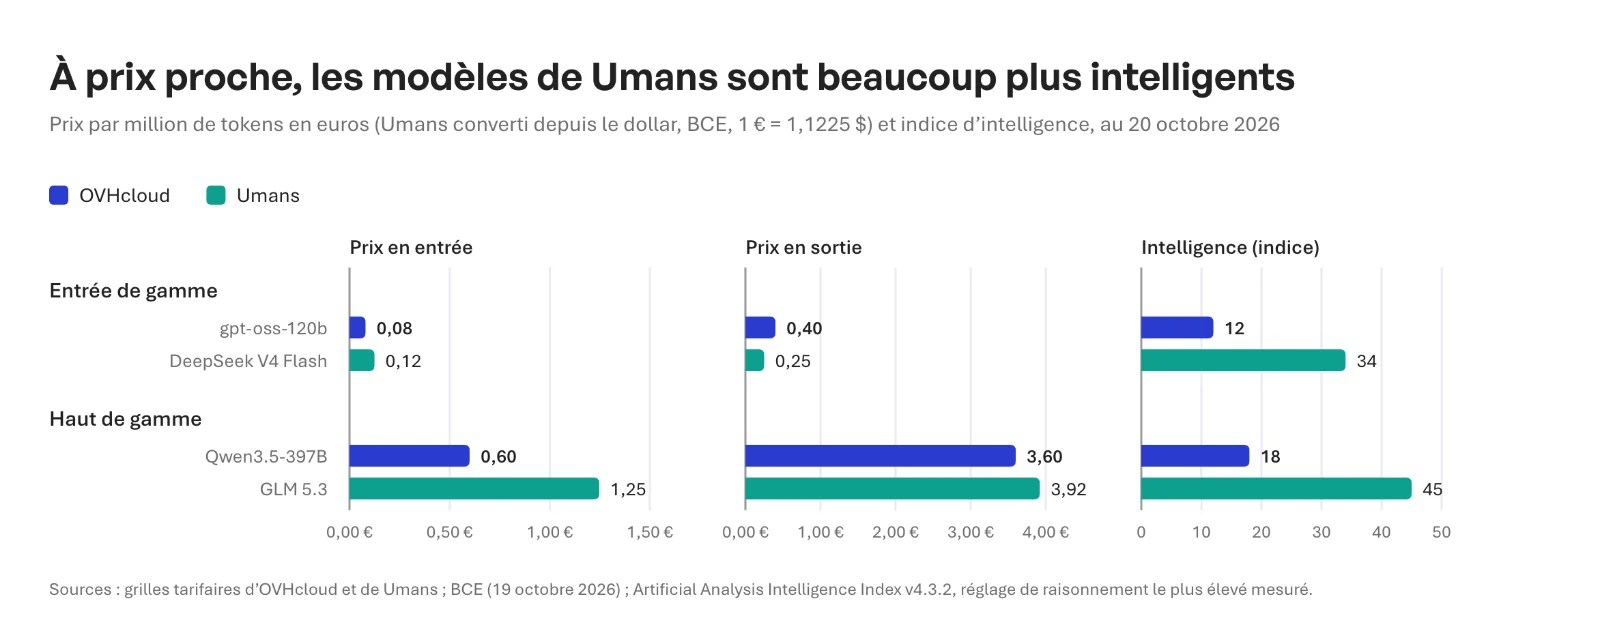 OVHcloud face à Umans au 20 octobre 2026, prix par million de tokens en euros et indice d'intelligence d'Artificial Analysis. Entrée de gamme : gpt-oss-120b chez OVHcloud, 0,08 € en entrée, 0,40 € en sortie, indice 12 ; DeepSeek V4 Flash chez Umans, 0,12 €, 0,25 €, indice 34. Haut de gamme : Qwen3.5-397B chez OVHcloud, 0,60 €, 3,60 €, indice 18 ; GLM 5.3 chez Umans, 1,25 €, 3,92 €, indice 45. Prix de Umans convertis depuis le dollar au cours de la BCE du 19 octobre 2026
Les prix viennent des grilles d'OVHcloud et d'Umans, convertis depuis le dollar au cours de la BCE du 19 octobre 2026 (1 € = 1,1225 $). Pour l'intelligence, l'indice d'Artificial Analysis (version 4.3.2) donne 12 à gpt-oss-120b contre 34 à DeepSeek V4 Flash, et 18 à Qwen3.5-397B contre 45 à GLM 5.3, dans leur réglage de raisonnement le plus élevé. Le reste de l'offre :
| OVHcloud AI Endpoints | Umans | |
|---|---|---|
| Modèles les plus récents | Qwen3.8-27B, ajouté fin août 2026 | DeepSeek V4.1 Flash, GLM 5.3, Kimi K3 |
| Cache de contexte | non | oui |
| Usages couverts | texte, embeddings, transcription, vision, image | code et agents |
| Inférence dans l'UE | oui, à Gravelines | sur demande |
En entrée de gamme, les prix des deux fournisseurs sont proches, mais les modèles de Umans sont beaucoup plus intelligents : leur score est 2,5 à près de 3 fois celui des modèles d'OVHcloud. Umans a un avantage significatif sur la fraîcheur des modèles, et son cache réduit nettement la facture d'un agent de code. Selon ses propres mesures, il sert DeepSeek V4 Flash à plus de 360 tokens par seconde. Les deux offres se complètent : un catalogue généraliste hébergé en France d'un côté, les meilleurs modèles ouverts de code dès leur sortie de l'autre.
Une vitesse en retrait sur les modèles les plus demandés
Hugging Face route des requêtes vers plusieurs fournisseurs d'inférence, dont OVHcloud, et publie leur débit. Le 20 octobre au matin, sur gpt-oss-120b, OVHcloud était le plus lent des dix fournisseurs mesurés : 35 tokens par seconde, contre 161 chez Scaleway et 227 chez Baseten. Même rang sur Llama 3.3 70B, parmi quatre fournisseurs. À l'inverse, il était le plus rapide sur Qwen3.5-397B, avec 105 tokens par seconde contre 62 chez Scaleway. Ces mesures sont un instantané, et Hugging Face ne documente pas sa méthode.
OVHcloud ne le cache pas. À un client qui mesurait 13 tokens par seconde en avril, l'entreprise a répondu que le service, mutualisé, « can occasionally vary », et lui a conseillé de déployer son propre modèle avec AI Deploy. En août, un responsable technique écrivait avoir suspendu un déploiement à cause de cette latence irrégulière. Nos propres essais d'AI Endpoints, menés avant le virage stratégique engagé par Octave Klaba, nous avaient déçus. Pour l'instant, AI Endpoints ne fait donc pas partie des fournisseurs d'inférence d'Ask This Guy. À suivre : nous referons l'essai avec le modèle maison et les nouvelles offres.
SambaNova : la promesse d'endpoints rapides, pas encore visible
C'est là que devait intervenir SambaNova. Le 20 novembre 2025, OVHcloud a choisi ce fabricant américain de puces d'inférence pour des endpoints « temps réel » à performance garantie, avec un engagement de disponibilité de 99,8 % et une mise en service annoncée en France « d'ici la fin de l'année ». Les puces de SambaNova, des RDU, sont conçues pour servir des modèles bien plus vite qu'un GPU classique : sur sa propre plateforme, SambaNova sert gpt-oss-120b à 708 tokens par seconde, selon Artificial Analysis.
SambaNova présente l'offre Premium d'OVHcloud comme « available now ». Côté OVHcloud, en revanche, nous n'avons trouvé le 20 octobre ni page produit, ni prix, ni modèle au catalogue. La page de son laboratoire indique toujours l'offre rapide comme « Coming soon », avec un engagement mensuel minimum. Onze mois après l'annonce, le client qui cherche des tokens rapides chez OVHcloud ne les trouve pas en libre-service. Ni SambaNova ni AI Endpoints ne figurent d'ailleurs dans le communiqué de résultats, qui renvoie la stratégie IA au salon du 19 novembre.
Pourquoi OVHcloud entraîne-t-il son propre LLM ?
La peur d'une coupure d'accès
L'explication d'Octave Klaba tient en une phrase. Si OVHcloud ne maîtrise pas son modèle, « quelqu'un pourra un jour nous dire : "Vous êtes mon concurrent, je vous coupe l'accès à mon modèle." » Il ajoute : « Nous aurons donné nos données, ils feront notre métier, et nous n'aurons plus que nos yeux pour pleurer. » Selon lui, rien n'empêche les grands laboratoires de créer demain un CRM ou un ERP concurrent de SAP.
Ce scénario n'a rien de théorique pour une entreprise française, nous l'avions décrit dans « Et si les États-Unis vous fermaient le robinet numérique ? ». Ce qui est nouveau, c'est qu'un fournisseur de cloud l'applique à lui-même. Octave Klaba précise que les modèles sont faits « d'abord pour nous, avec nos données, pas celles de nos clients », pour gagner en productivité, avant d'être éventuellement proposés aux clients.
Un premier modèle spécialisé, un calendrier flou
OVHcloud a choisi trois domaines, que le premier modèle « ne couvrira pas exactement » tous : la cybersécurité « offensive et défensive », le code, et des agents pour la finance, les ressources humaines, le juridique et la logistique. Octave Klaba promet une architecture « très en avance sur son temps », sans donner de taille ni de score. Reuters précise qu'il s'agira d'un modèle « mixture-of-experts », qui n'active qu'une partie de ses paramètres, des « experts », pour chaque token traité.
L'ambition s'est resserrée. En juin, à VivaTech, Octave Klaba voulait entraîner de zéro des modèles de pointe, citait un premier pré-entraînement mené sur le supercalculateur européen Jupiter, et estimait le coût d'un tel projet entre 150 et 200 millions d'euros. En octobre, il insiste sur trois métiers qu'OVHcloud connaît, et sur une méthode : « L'idée n'est pas de mettre aujourd'hui des milliards sur la table, mais de vérifier si nous pouvons innover dans ce métier […]. » La publication en open source reste conditionnelle : « Si cela fonctionne pour nous ».
Le calendrier, lui, est flou. « Fin novembre » dans La Tribune, « début 2027 » chez Reuters : les deux peuvent se concilier, une publication des poids puis un lancement commercial, mais OVHcloud ne l'a pas précisé.
Le cas de Mistral
Octave Klaba ne mâche pas ses mots. Interrogé sur une alliance avec Mistral, il répond que « Mistral se rapproche davantage, dans son business, d'une ESN de l'IA, car il fait avant tout de l'intégration », et s'interroge sur sa valorisation : « Est-ce que cela vaut cet argent-là ? Je n'en sais rien. » BFM y voit une pique qui vise aussi les milliards de Mistral. La formule tient en bonne partie. Mistral est d'abord un fournisseur de services d'IA aux entreprises : elle revendique plus de 125 entreprises clientes, envoie des chercheurs détachés chez ses clients pour construire des modèles sur mesure, et l'État lui achète, selon ActuIA, des compétences plus que des licences. Pour servir ces clients, elle développe ses propres technologies : des modèles, un service d'inférence et, avec Mistral Compute, de la capacité de calcul louée à d'autres entreprises. C'est sur cette dernière brique, financée en partie par sa levée de 3 milliards d'euros en septembre 2026, qu'elle croise OVHcloud, ce qui éclaire le « Mistral s'est déclaré concurrent d'OVHcloud » d'Octave Klaba. Nous avions détaillé l'infrastructure de Mistral dans notre article sur CoreWeave.
Quelles briques OVHcloud a-t-il achetées en 2026 ?
Faute de tout construire, OVHcloud achète. Trois rachats depuis janvier :
- Seald, en janvier : chiffrement de bout en bout, avec un kit de développement certifié par l'ANSSI ;
- Dragon LLM, ex-Lingua Custodia, en mars : des modèles spécialisés pour les secteurs régulés, et le point de départ du laboratoire d'IA d'OVHcloud, chargé d'entraîner et d'adapter des LLM ;
- Gladia, finalisé fin juillet : la transcription de la voix en texte, dans plus de 100 langues, payée en actions nouvelles.
La présentation des résultats associe chaque rachat à une couche : Dragon LLM à l'entraînement, Gladia aux tokens, Seald à la plateforme, OVHai workspace aux usages. Pour financer la suite, Octave Klaba écarte, pour l'instant, toute augmentation de capital : « Je veux investir l'argent que nous gagnons. »
Quelles sont les limites de cette stratégie ?
Le budget
OVHcloud a dégagé 24,7 millions d'euros de flux de trésorerie disponible en 2026. Mistral a levé 3 milliards en une seule opération. Cité par Le Monde Informatique, Neil Shah, analyste chez Counterpoint, rappelait en juin qu'un modèle se déprécie « s'il n'est pas entraîné de manière régulière ». Un LLM se paie tous les ans, pas une fois.
Les précédents
Le fondateur de l'allemand Aleph Alpha le résumait en 2024, au moment de changer de modèle économique : « Just having an European LLM is not sufficient as a business model ». À l'inverse, Alibaba se sert de ses modèles Qwen, téléchargés plus de 3 milliards de fois, pour attirer des clients vers son cloud. OVHcloud a ce qui manquait à Aleph Alpha, 1,7 million de clients, mais pas encore le modèle qui donnerait envie de les servir.
La qualité des modèles ouverts
Octave Klaba juge que la qualité des tokens issus de modèles open source « ne répond pas forcément à nos besoins ». Or les meilleurs modèles ouverts n'ont plus que quatre mois de retard en moyenne sur les modèles fermés, selon Epoch AI. Une partie du déficit de qualité d'AI Endpoints tient à son propre catalogue, privé de modèles récents que d'autres fournisseurs européens servent déjà.
La dépendance matérielle
Les GPU sont de Nvidia, les puces de l'offre rapide de SambaNova, et un premier pré-entraînement s'est fait sur Jupiter, un supercalculateur équipé de puces Nvidia. Le contrat et les données restent sous droit français, ce qui compte pour la souveraineté juridique. Comme le dit Sanchit Vir Gogia, du cabinet Greyhound, cité par Le Monde Informatique, la souveraineté « change simplement la main » qui contrôle le bouton d'arrêt.
La cybersécurité, premier axe du modèle
La veille de l'annonce, plusieurs versions de l'outil en ligne de commande officiel d'OVHcloud contenaient un logiciel espion, glissé par un pirate via le compte GitHub d'un contributeur. L'incident ne dit rien du futur modèle. Il rappelle que la sécurité de la chaîne logicielle se prouve aussi chez soi.
Ce qu'une DSI peut en retenir
- Tester AI Endpoints sur sa propre charge. Pour du traitement par lots, de l'extraction ou de la classification, le rapport qualité-prix sur gpt-oss est très bon et le service est souverain. Pour un agent ou un assistant interactif, mesurez la latence aux heures de pointe avant de vous engager.
- Ne pas choisir un fournisseur pour un modèle qui n'existe pas encore. Le LLM d'OVHcloud se jugera sur pièces, quand ses poids et ses scores seront publiés. Rendez-vous au 19 novembre, puis à la sortie.
- Prévoir le remplacement des modèles. Chez tous les fournisseurs, les modèles sont retirés à mesure que de meilleurs arrivent : trois mois de préavis chez OVHcloud et Scaleway, deux à trois semaines chez Together AI. Un usage en production doit prévoir son remplaçant et le tester.
- Appliquer à soi-même le raisonnement de Klaba. Une entreprise qui bâtit ses processus sur un seul modèle s'expose à une coupure, à une hausse de prix ou à un fournisseur devenu concurrent. Une passerelle LLM permet de changer de fournisseur sans réécrire ses applications, et un modèle à poids ouverts sert de solution de secours.
- Distinguer souveraineté juridique et indépendance technique. OVHcloud règle la première : droit français, capital français, données en France. La seconde, puces et modèles compris, n'existe aujourd'hui chez personne en Europe. Notre comparatif des façons de faire tourner un modèle en entreprise aide à choisir le bon compromis.
Par transparence : Ask This Guy héberge ses serveurs chez OVHcloud, à Gravelines, Umans est l'un de nos partenaires, et nous utilisons plusieurs fournisseurs d'inférence européens, comme nous l'expliquons dans notre panorama des IA françaises.
Questions fréquentes sur la stratégie IA d'OVHcloud
Qu'est-ce qu'OVHcloud AI Endpoints ?
AI Endpoints est le service d'inférence d'OVHcloud, lancé en avril 2025. Il donne accès, par une API compatible avec celle d'OpenAI, à une vingtaine de modèles à poids ouverts (gpt-oss, Llama, Qwen, Whisper) hébergés à Gravelines, en France. La facturation se fait au million de tokens, et une API de traitement par lots coûte deux fois moins cher pour les tâches non urgentes.
Quand sortira le LLM d'OVHcloud ?
Octave Klaba a déclaré à La Tribune, le 20 octobre 2026, que l'entraînement de la première version se terminait et qu'il pensait la publier en open source fin novembre. Le même jour, Reuters a rapporté un lancement début 2027. OVHcloud doit détailler sa stratégie IA lors de son AI Summit du 19 novembre 2026 à Paris.
OVHcloud AI Endpoints est-il souverain ?
Oui, au sens juridique. Le service est fourni par OVH SAS, société française dont la famille Klaba contrôle près de 80 % du capital, et les modèles tournent dans le data center de Gravelines. Aucune maison-mère américaine n'est concernée : le service n'est pas exposé au CLOUD Act par ce biais. Les GPU et les puces viennent en revanche de fournisseurs américains, Nvidia et SambaNova.
Quel est le partenariat entre OVHcloud et SambaNova ?
En novembre 2025, OVHcloud a choisi SambaNova, fabricant américain de puces dédiées à l'inférence, pour proposer des endpoints rapides à performance garantie, avec 99,8 % de disponibilité et un engagement de consommation. SambaNova présente l'offre comme disponible, mais OVHcloud n'avait publié ni page produit ni prix au 20 octobre 2026.
Quelle différence entre OVHcloud AI Endpoints et Umans ?
Les deux offres sont complémentaires. OVHcloud AI Endpoints sert une vingtaine de modèles généralistes (texte, embeddings, transcription, vision) depuis Gravelines, à des prix parmi les plus bas d'Europe. Umans, société française créée en 2025, sert six modèles de code et d'agents parmi les plus récents (DeepSeek V4.1 Flash, GLM 5.3, Kimi K3), avec un cache de contexte et une inférence dans l'Union européenne sur demande. En entrée de gamme, leurs prix sont proches, mais les modèles de Umans sont beaucoup plus intelligents : 34 contre 12 à l'indice d'Artificial Analysis pour DeepSeek V4 Flash face à gpt-oss-120b.
Mistral est-elle une ESN ?
En partie. Le 20 octobre 2026, Octave Klaba, PDG d'OVHcloud, a estimé que Mistral « se rapproche davantage, dans son business, d'une ESN de l'IA, car il fait avant tout de l'intégration ». Mistral est d'abord un fournisseur de services d'IA aux entreprises : elle revendique plus de 125 entreprises clientes et détache des chercheurs chez certains d'entre eux pour construire des modèles sur mesure. À la différence d'une ESN classique, elle développe ses propres technologies, dont des modèles, un service d'inférence et, avec Mistral Compute, de la capacité de calcul louée à d'autres entreprises.
Pour réussir dans l'IA, il suffirait presque à OVHcloud de servir vite des modèles à jour : l'infrastructure et les prix, il les a déjà. Le premier LLM, attendu fin 2026 ou début 2027, dira si l'entreprise sait faire de la recherche. Les mois suivants diront si elle sait vendre ce qu'elle a annoncé en novembre 2025.
Pour une entreprise française, la leçon d'Octave Klaba est plus utile que son modèle : ne jamais dépendre d'un seul fournisseur pour une brique dont dépend son métier.