LLM gateway : OpenRouter, LiteLLM ou passerelle maison ?
LLM gateway ou AI gateway : ce que fait une passerelle IA, OpenRouter ou LiteLLM, ce qu'elle coûte et par où passent vos données. Nos relevés de prix inclus.
En juin, nous nous inquiétions sur LinkedIn pour les entreprises qui avaient construit leurs agents autour d'un seul fournisseur. En deux mois, le modèle premium d'Anthropic était passé de 5/25 $ à 10/50 $ par million de tokens, juste après un changement de tokenizer qui faisait déjà consommer 30 à 45 % de tokens en plus pour la même requête, d'après les mesures d'OpenRouter. Une facture multipliée par 2,6 à 2,9, sans une ligne de code modifiée.
Leur modèle faisait très bien le travail. Leur erreur était ailleurs : l'application appelait une seule API, codée en dur. Quand le fournisseur tombe, augmente ses prix ou retire un modèle, il ne reste plus qu'à subir.
La couche qui évite d'en arriver là s'appelle une LLM gateway, ou passerelle IA. Le marché en propose de toutes les formes, d'OpenRouter, le service le plus connu, à LiteLLM, la référence open source. On les compare d'habitude sur la taille du catalogue et sur le prix. En entreprise, nous commençons par une autre question : par où passent vos données ?
Qu'est-ce qu'une LLM gateway, ou AI gateway ?
Une LLM gateway est une couche logicielle placée entre vos applications et les fournisseurs de modèles d'IA. Elle expose une seule API, envoie chaque requête au modèle et au fournisseur les plus adaptés, et bascule automatiquement vers un autre quand le premier échoue.
Elle n'exécute aucun modèle elle-même. C'est ce qui la distingue d'un fournisseur d'inférence, qui fait tourner les modèles sur ses propres GPU. Nous détaillons cette différence dans notre guide de l'inférence IA.
Plusieurs noms désignent la même chose : AI gateway, LLM gateway, passerelle multi-fournisseurs. Le terme LLM router désigne parfois une brique plus étroite, qui choisit le modèle selon la difficulté de la question sans gérer ni la bascule ni les clés.
Ce que fait vraiment une passerelle
Elle bascule quand un fournisseur tombe
Aucun fournisseur d'inférence ne tient seul 99,9 % de disponibilité. Voici ce que nous avons mesuré en production sur cinq d'entre eux, sur trente jours en juillet 2026 :
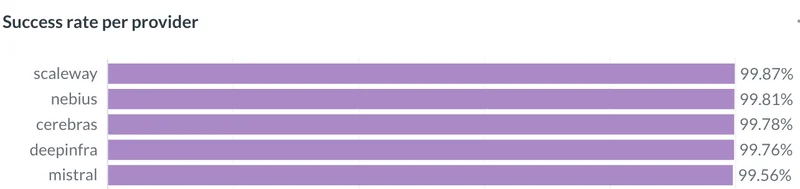 Taux de succès par fournisseur d'inférence : Scaleway 99,87 %, Nebius 99,81 %, Cerebras 99,78 %, DeepInfra 99,76 %, Mistral 99,56 %
Pris un par un, aucun n'atteint les trois neuf. Mis bout à bout derrière une passerelle qui teste leur santé et bascule dès que l'un décroche, on y arrive. Le raisonnement complet, avec les engagements contractuels des grands fournisseurs, est dans notre article SLA IA entreprise.
La bascule suppose que le même modèle tourne chez plusieurs fournisseurs, ou que vous acceptiez un modèle de repli. C'est l'un des avantages concrets des modèles open weights : on change de fournisseur sans toucher aux prompts.
Elle arbitre entre prix, vitesse et pays
C'est la fonction la moins connue, et celle qui rapporte le plus. Un même modèle n'a ni le même prix, ni la même vitesse, ni la même nationalité selon qui le sert. Nos relevés :
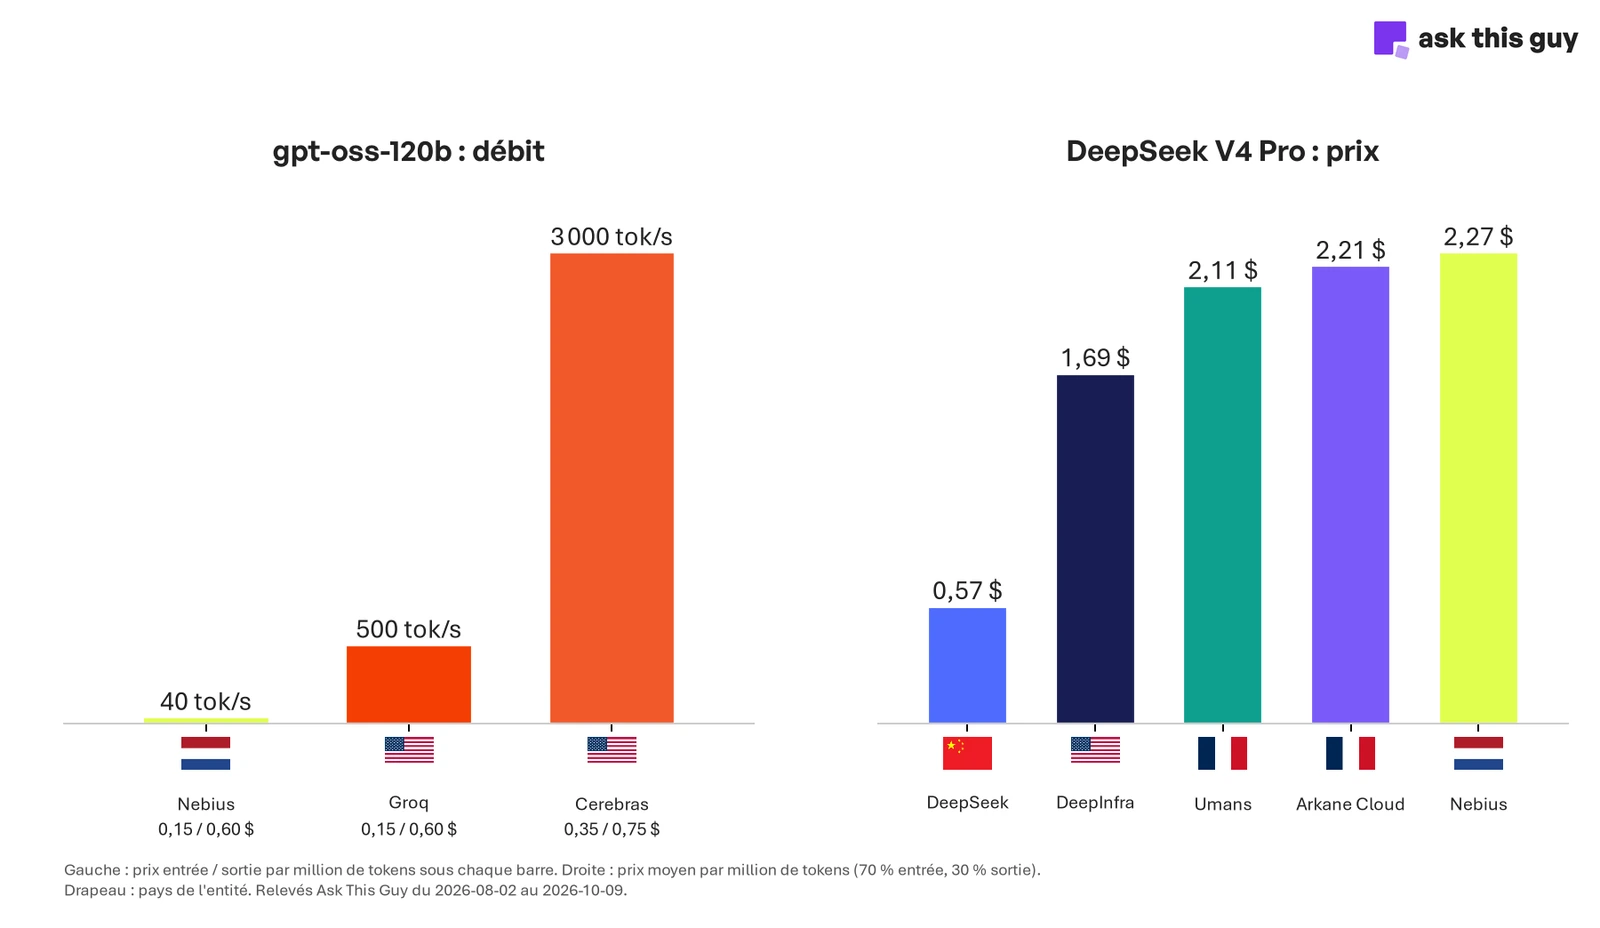 Deux graphiques en barres. À gauche, le modèle gpt-oss-120b : Nebius le sert à 40 tokens par seconde et Groq à 500, tous deux à 0,15 $ en entrée et 0,60 $ en sortie par million de tokens, Cerebras à 3 000 tokens par seconde pour 0,35 et 0,75 $. À droite, le modèle DeepSeek V4 Pro coûte 0,57 $ par million de tokens chez DeepSeek (Chine), 1,69 $ chez DeepInfra (États-Unis), 2,11 $ chez Umans et 2,21 $ chez Arkane Cloud (France), 2,27 $ chez Nebius (Pays-Bas).
À gauche, gpt-oss-120b. Nebius et Groq le facturent au même prix, 0,15 $ en entrée et 0,60 $ en sortie par million de tokens. Le premier le sert à 40 tokens par seconde, le second à 500. Cerebras monte à 3 000 tokens par seconde pour un tarif à peine plus élevé. Un facteur 75 sur la vitesse, à prix presque identique.
À droite, DeepSeek V4 Pro. Servi par DeepSeek, il revient à 0,57 $ le million de tokens. Chez Nebius, 2,27 $. Le même modèle, quatre fois plus cher. Mais le moins cher est une entreprise chinoise, et les trois plus chers sont européens. Le prix le plus bas n'est pas toujours celui que vous avez le droit de payer.
Dernière subtilité, invisible sur le graphique : le drapeau indique le pays de l'entité, pas celui du data center. Nebius, société néerlandaise, sert gpt-oss-120b depuis la Finlande, mais DeepSeek V4 Pro depuis le Royaume-Uni.
Une passerelle qui lit ces trois variables choisit, requête par requête, la combinaison qui respecte votre contrainte au meilleur coût.
Elle centralise les clés et les comptes
L'application ne connaît qu'une API, en général compatible avec celle d'OpenAI. Les clés des fournisseurs sont rangées au même endroit. Changer de modèle devient une ligne de configuration plutôt qu'un chantier, et c'est ce qui rend possibles des arbitrages comme celui de notre article sur l'OCR, où un modèle open weight a divisé la facture par 10.
Le revers est immédiat : la passerelle détient toutes vos clés. Nous y revenons plus bas, avec LiteLLM.
Elle mesure la consommation
Coût par équipe, par application ou par utilisateur, quotas, journaux d'appels. C'est souvent la fonction qui convainc la direction financière, bien avant la disponibilité.
Les cinq familles de passerelles
Lecture : le vert est favorable, le rouge défavorable. Le signe ± marque un critère qui dépend de l'éditeur ou de votre configuration.
| Famille | Exemples | Où transitent vos données | Légèreté d'exploitation | Souveraineté | Coût |
|---|---|---|---|---|---|
| SaaS | OpenRouter, Eden AI, Requesty | Chez l'éditeur, puis chez le fournisseur | ++ | ± | Frais sur les crédits ou abonnement |
| Open source à héberger | LiteLLM, Portkey Gateway | Chez vous, puis chez le fournisseur | − | +++ | Serveurs et temps d'équipe |
| Brique d'infrastructure | Cloudflare AI Gateway, Kong AI Gateway | Chez l'opérateur réseau, puis chez le fournisseur | + | ± | Selon l'offre |
| Maison | Votre propre code | Chez vous, puis chez le fournisseur | −−− | +++ | Temps d'équipe, surtout sur la mesure |
| Intégrée à une plateforme | Ask This Guy, par exemple | Chez l'éditeur, puis chez le fournisseur | +++ | ± | Inclus dans l'abonnement |
La colonne souveraineté ne se lit qu'avec la précédente. Une passerelle hébergée chez vous en Europe peut très bien envoyer vos requêtes aux États-Unis si personne ne l'a configurée pour l'en empêcher.
OpenRouter : ce que c'est, et ce qu'il faut vérifier en entreprise
OpenRouter est une passerelle SaaS américaine : une API unique, compatible avec celle d'OpenAI, qui donne accès à plusieurs centaines de modèles servis par des dizaines de fournisseurs. Vous achetez des crédits, vous appelez un modèle, OpenRouter choisit le fournisseur et bascule en cas d'échec. La société a levé 113 millions de dollars en mai 2026, dans un tour mené par CapitalG, le fonds de croissance d'Alphabet (Dealroom).
Pour un développeur qui veut tester dix modèles dans l'après-midi, c'est imbattable. Pour une entreprise, quatre points méritent d'être vérifiés avant d'y faire passer des données.
Le modèle économique d'abord. OpenRouter répercute le prix des fournisseurs sans marge et se rémunère sur l'achat de crédits : 5,5 % de frais, avec un minimum de 0,80 $ (FAQ OpenRouter). Si vous apportez vos propres clés fournisseurs, les 25 000 premiers dollars de consommation mensuelle sont sans frais, puis OpenRouter prélève 5 %.
Sur les données, OpenRouter ne stocke par défaut ni les prompts ni les réponses. Deux options changent cela, si vous les activez : la journalisation de vos échanges, et l'autorisation donnée à OpenRouter de s'en servir, contre une remise de 1 % (politique de collecte). Ce qui compte se passe ensuite, chez chaque fournisseur appelé, qui applique sa propre politique.
Le contrôle du routage est le vrai point fort d'OpenRouter, à condition de le configurer. Le paramètre data_collection: "deny" exclut les fournisseurs qui collectent des données, zdr: true limite le routage aux fournisseurs sans conservation de données, et les listes only et ignore fixent qui a le droit de répondre (sélection des fournisseurs). La documentation prévient elle-même que chaque restriction réduit les possibilités de repli.
Enfin, la juridiction. OpenRouter propose un routage limité à l'Europe, via eu.openrouter.ai, réservé à ses offres Business et Enterprise. Les traitements restent alors dans l'Union européenne. L'entité, elle, est américaine, donc soumise au CLOUD Act comme tout prestataire américain, où que tournent ses serveurs. Nous expliquons pourquoi ce point compte dans Et si les États-Unis vous fermaient le robinet numérique ?
Un mot sur les modèles gratuits, qui attirent beaucoup de curieux. Ils sont limités à 50 requêtes par jour, ou 1 000 après l'achat de 10 $ de crédits. Parfait pour tester, inutilisable en production.
Quelle alternative à OpenRouter en Europe ?
Côté SaaS, Eden AI, éditeur français, propose un endpoint européen qui ne route que vers des fournisseurs et des modèles validés pour un traitement en Europe, et annonce ne conserver ni les prompts, ni les fichiers, ni les réponses (documentation Eden AI). Comme chez OpenRouter, la garantie porte sur un couple modèle et fournisseur : vérifiez-la pour chacun de ceux que vous activez.
L'autre option est d'héberger soi-même une passerelle open source dans un data center européen. La plus utilisée s'appelle LiteLLM.
LiteLLM : la passerelle open source à héberger soi-même
LiteLLM est la référence open source du secteur : une bibliothèque Python et un serveur proxy qui exposent une API compatible OpenAI devant plus d'une centaine de fournisseurs. Vous l'hébergez où vous voulez, y compris en Europe, et vos requêtes ne transitent par aucun tiers avant le fournisseur final.
Ce que l'outil ne fait pas pour vous, c'est l'exploiter. Il faut le mettre à jour, le rendre lui-même hautement disponible (sinon il devient le point de défaillance unique qu'il devait supprimer), et surtout mesurer. Savoir quel fournisseur répond vite maintenant demande des sondes, des seuils et de l'historique. C'est la partie que nous avons le plus sous-estimée en construisant notre propre passerelle.
Il y a aussi la sécurité. Le 24 mars 2026, deux versions piégées de LiteLLM, la 1.82.7 et la 1.82.8, ont été publiées sur PyPI. Elles contenaient un voleur d'identifiants qui aspirait les variables d'environnement, les clés SSH, les identifiants cloud et les mots de passe de bases de données (avis de sécurité LiteLLM). Elles sont restées en ligne une quarantaine de minutes. L'image Docker officielle du proxy, qui fige ses dépendances, n'a pas été touchée, et une version saine est sortie dans la semaine. Les recherches sur LiteLLM ont plus que triplé en France ce mois-là.
La leçon dépasse LiteLLM. Une passerelle détient par construction les clés de tous vos fournisseurs : c'est la cible la plus rentable de votre infrastructure IA. Si vous l'hébergez, figez les versions, isolez-la et traitez-la comme un coffre-fort plutôt que comme un utilitaire.
La passerelle est aussi un outil de souveraineté
On présente la passerelle comme un outil de fiabilité. C'est aussi le seul endroit de votre architecture où une règle de souveraineté s'applique à toutes les requêtes à la fois.
« Aucune donnée ne part chez un fournisseur non européen. » Sans passerelle, cette règle dépend de la discipline de chaque développeur qui écrit un appel d'API. Avec une passerelle, c'est une ligne de configuration, et la bascule automatique ne peut plus vous envoyer, un soir de panne, chez un fournisseur que vous n'avez pas validé.
Trois conditions pour que la règle tienne :
- La passerelle elle-même doit être européenne. Sinon, toutes vos requêtes passent par une entité soumise au CLOUD Act avant d'arriver chez Mistral ou Scaleway.
- Le filtre doit porter sur le pays de l'entité et sur celui du data center. Le cas Nebius plus haut le montre : une société européenne peut servir un modèle depuis l'extérieur de l'Union.
- Il faut assez de fournisseurs européens pour basculer. Chaque fournisseur retiré de la liste est une route de secours en moins : c'est le prix de la souveraineté, et mieux vaut le mesurer avant la première panne.
Les critères que nous appliquons à n'importe quel acteur de l'IA sont détaillés sur notre page IA souveraine.
Faut-il une passerelle ?
Pas encore si vous êtes en POC, avec un modèle, un usage et aucun engagement de disponibilité. Écrivez quand même vos appels derrière une petite couche d'abstraction : le jour où il faudra une passerelle, vous la brancherez sans réécrire l'application.
Oui dès qu'une application passe en production avec des utilisateurs qui en dépendent, dès que plusieurs équipes consomment des modèles, ou dès qu'une contrainte de souveraineté doit s'appliquer à tous les appels.
Et ce n'est pas à vous de la construire si vous achetez une plateforme d'IA qui en intègre une. Demandez simplement à l'éditeur de la décrire : quels fournisseurs, dans quels pays, avec quelles règles de bascule et quel engagement de non-entraînement.
| Votre situation | Ce que nous recommandons |
|---|---|
| Prototypes, aucune donnée sensible | OpenRouter, pour la largeur du catalogue |
| Production, contrainte européenne, pas d'équipe infrastructure | Passerelle SaaS européenne ou plateforme intégrée |
| Production, équipe infrastructure, contrainte forte | LiteLLM ou Portkey Gateway, hébergé en Europe et verrouillé |
| Vous achetez un résultat métier, pas une brique technique | Plateforme qui intègre sa passerelle |
Chez Ask This Guy
La passerelle est intégrée à la plateforme : nos clients n'ont rien à construire ni à exploiter. Elle sélectionne en continu les modèles qui répondent, et vite, avec un objectif de service supérieur à 99,9 % sur le périmètre défini.
La règle de souveraineté est un réglage d'organisation. UE uniquement : Mistral, Scaleway, Nebius, Black Forest Labs, plus nos propres GPU chez Verda, en Finlande et en Islande. Monde entier : les mêmes, plus des fournisseurs non européens sélectionnés. Le réglage se change à tout moment depuis la console, et le détail est public dans notre page de gestion des fournisseurs IA.
Les coûts des modèles sont inclus dans l'abonnement. Les écarts de prix et de vitesse décrits plus haut sont notre problème, pas le vôtre.
Et si vous avez déjà votre propre passerelle ou un contrat chez un fournisseur, notre mode Bring Your Own AI permet de les brancher sur la plateforme. Il est disponible sur demande.
Questions fréquentes sur les LLM gateways
LLM gateway ou AI gateway : quelle différence ?
Les deux termes désignent la même couche : un point d'entrée unique devant plusieurs fournisseurs de modèles, avec bascule automatique. AI gateway est un peu plus large, car certains produits couvrent aussi les modèles d'image, d'audio ou d'embeddings. LLM gateway insiste sur les modèles de langage, qui représentent l'essentiel du trafic en entreprise.
Quelle différence entre une LLM gateway et une API gateway classique ?
Une API gateway classique route, authentifie et limite les appels vers vos propres services. Une LLM gateway fait le même travail devant des fournisseurs de modèles d'IA, et y ajoute ce que ce métier impose : compter les tokens, comparer le prix et la vitesse de plusieurs fournisseurs pour un même modèle, et basculer vers un autre fournisseur ou un autre modèle quand l'un échoue. Plusieurs API gateways du marché, comme Kong, proposent désormais un module dédié à l'IA.
OpenRouter, c'est quoi ?
OpenRouter est une passerelle IA proposée en SaaS par une société américaine. Elle donne accès à plusieurs centaines de modèles, d'OpenAI, d'Anthropic, de Google, de Mistral ou open weights, via une seule API compatible avec celle d'OpenAI. Elle choisit le fournisseur qui sert chaque requête, bascule en cas d'échec, et se rémunère par des frais de 5,5 % sur l'achat de crédits.
OpenRouter est-il conforme au RGPD ?
OpenRouter ne stocke pas les prompts par défaut, permet de limiter le routage aux fournisseurs sans conservation de données et propose un traitement en Europe sur ses offres Business et Enterprise. La société reste américaine, donc soumise au CLOUD Act. La conformité dépend surtout de votre configuration et des fournisseurs finaux appelés : elle se vérifie au cas par cas avec votre DPO.
LiteLLM ou OpenRouter : lequel choisir ?
OpenRouter est un service clé en main : rien à héberger, mais vos requêtes passent par une société américaine qui prélève 5,5 % sur les crédits. LiteLLM est un logiciel open source à héberger vous-même : vous choisissez où transitent vos données, mais vous l'exploitez, le sécurisez et le mettez à jour. Le premier convient au prototypage, le second aux équipes qui ont une infrastructure et une contrainte de souveraineté.
Une passerelle ajoute-t-elle de la latence ?
Un peu, mais rarement de façon perceptible. Le détour par une passerelle coûte quelques dizaines de millisecondes au plus, quand la génération d'une réponse se compte en secondes. Une passerelle qui choisit le fournisseur le plus rapide fait gagner bien plus de temps qu'elle n'en coûte : sur gpt-oss-120b, l'écart entre fournisseurs va de 40 à 3 000 tokens par seconde.
Peut-on utiliser les modèles gratuits d'OpenRouter en entreprise ?
Pour tester, oui. Pour la production, non : ils sont limités à 50 requêtes par jour, ou 1 000 après l'achat de 10 $ de crédits, sans engagement de service. Et un modèle qui n'est servi que par des fournisseurs qui conservent les données ne vous est accessible que si vous avez autorisé ces fournisseurs dans vos réglages : vérifiez-les avant d'y envoyer quoi que ce soit.
Conclusion
Une application branchée sur un seul fournisseur subit ses pannes, ses hausses de prix et sa juridiction. Une passerelle vous rend ces trois décisions, à condition de savoir où elle tourne et qui la contrôle.
Si vous voulez voir une passerelle appliquer une politique européenne en conditions réelles : réservez une démo.