SLA IA entreprise : un seul fournisseur d'IA pour vos agents ne peut pas suffire
Pourquoi un seul fournisseur ne suffit pas pour un SLA IA entreprise. Comparatif des engagements, gateway multi-provider et fallback pour RAG et assistants IA.
Ouvrez la page de statut d'Anthropic. Vous y trouverez le plus souvent un taux de disponibilité entre 99 et 99,5 %. « Two » nines.
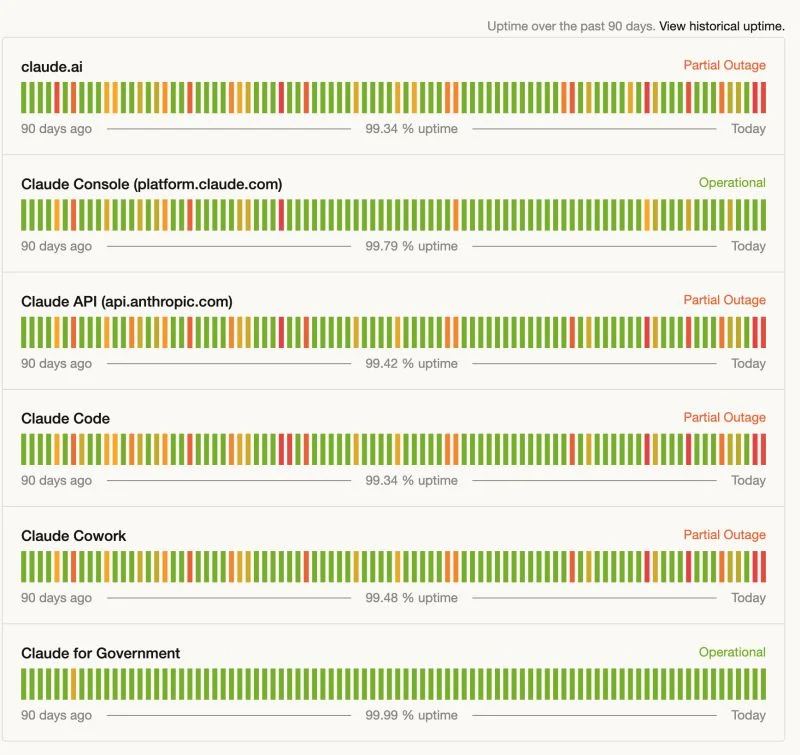
On est passé d'une époque où l'on visait les four nines (99,99 %) à une époque où 99,3 % d'uptime ne choque plus (plus assez). Les « vibe codeurs » utilisant Claude s'en contentent, mais est-ce assez pour votre entreprise ? Probablement pas...
Anthropic est-il un cas isolé ? Non. Tenir un haut niveau de service sur de l'inférence à grande échelle est difficile pour tout le monde.
Si vous ne devez retenir qu'une chose
Brancher votre production (RAG, assistant interne, agents) sur un seul fournisseur d'IA, que ce soit Claude, ChatGPT, Gemini ou Mistral, c'est accepter plusieurs jours d'indisponibilité cumulée par an. Pour un service métier qui compte, ce risque se traite comme n'importe quelle dépendance d'infrastructure.
Rappel de l'impact des nines
Ordres de grandeur d'indisponibilité, toutes causes confondues, sur un an :
| Nines | Uptime | Indispo approximative |
|---|---|---|
| Two nines | 99 % | ~3,6 jours |
| Three nines | 99,9 % | ~8,8 heures |
| Four nines | 99,99 % | ~52 minutes |
Votre projet d'IA peut-il encaisser plusieurs jours d'arrêt par an ?
Vos utilisateurs, eux, sont habitués aux « four nines » sur leurs outils du quotidien. Voici la disponibilité réelle de Microsoft 365 :
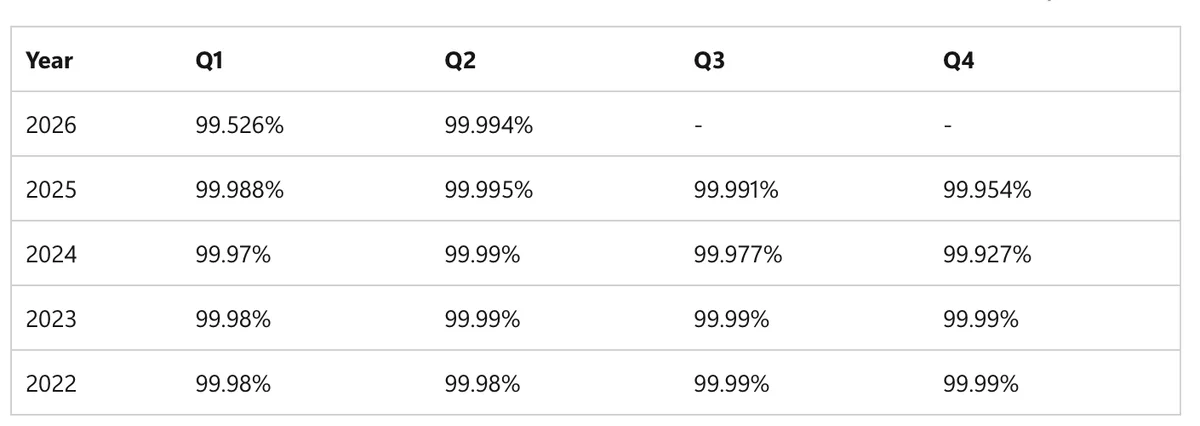 Disponibilité mondiale Microsoft 365 par trimestre, autour de 99,9 % et plus (source Microsoft Learn)
Chez les concurrents d'Anthropic ?
OpenAI et Mistral publient aussi leur disponibilité. Les chiffres ne sont pas directement comparables : chaque page couvre des composants et des périodes différentes. Au 31 juillet 2026, Mistral affichait 99,4 % sur les trois derniers mois.
Une page de statut n'est pas un SLA financier. Certaines offres spécifiques publient toutefois un engagement, comme Gemini Online Inference à 99,5 % ou OpenAI Scale Tier à 99,9 %, en option payante.
Les hyperscalers peuvent proposer des engagements plus élevés sur certains services managés d'inférence, par exemple 99,9 % sur Azure AI. L'engagement porte sur l'endpoint. La latence, la qualité des réponses et le reste de votre chaîne RAG n'entrent pas dedans.
On reste loin des garanties habituelles des SaaS de productivité, où les trois « nines » sont un standard sans surcoût.
Les open weights rendent la bascule possible
Un même modèle ouvert tourne chez une dizaine de fournisseurs d'inférence. C'est l'une des sept façons de servir de l'inférence en entreprise, que nous comparons dans notre guide sur l'inférence IA. Si l'un tombe, vous basculez sur un autre sans changer de modèle, donc sans retoucher vos prompts.
D'où la passerelle multi-fournisseurs, ou LLM gateway : une couche qui sait appeler plusieurs modèles chez plusieurs fournisseurs, et arbitrer entre eux selon qui répond, à quelle vitesse et à quel prix.
Aucun de ces fournisseurs n'atteint 99,9 % tout seul. Mis bout à bout derrière une passerelle qui teste leur santé et bascule dès que l'un décroche, on y arrive. Voici ce que nous mesurons en production chez Ask This Guy sur les 30 derniers jours :
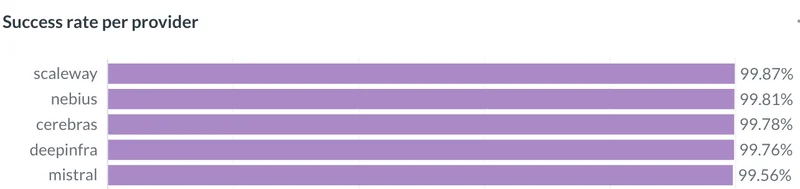 Taux de succès par provider d'inférence : Scaleway 99,87 %, Nebius 99,81 %, Cerebras 99,78 %, DeepInfra 99,76 %, Mistral 99,56 %
Des produits font ça, OpenRouter par exemple : un point d'accès unique vers plusieurs fournisseurs, et des règles de bascule à configurer. Côté européen, Eden AI, éditeur français, expose plus de 500 modèles derrière une seule API, avec bascule intégrée, endpoint européen et zéro rétention des données. De quoi mutualiser la disponibilité sans sortir votre contexte du périmètre RGPD.
Vous pouvez aussi la développer vous-même : brancher les fournisseurs un par un, mesurer ce qu'ils rendent vraiment, coder vos règles de priorité et de bascule. Comptez plus de temps que prévu sur la partie mesure.
Certaines plateformes l'intègrent nativement, c'est notre cas chez Ask This Guy.
Un SLA RAG entreprise ne s'arrête d'ailleurs pas à l'uptime du LLM. L'ingestion des sources, la recherche et les appels d'outils peuvent tomber sans que le modèle bouge d'un pouce. Pour les pièges après le POC, voir RAG entreprise : 5 erreurs en production.
Questions fréquentes sur le SLA IA entreprise
Qu'est-ce qu'un SLA IA entreprise ?
Un SLA IA entreprise fixe le niveau de disponibilité attendu pour un service d'IA, son périmètre de mesure, ses exclusions et les crédits dus si l'engagement n'est pas tenu. Une page de statut sert à observer les incidents, elle n'engage personne.
Quel SLA pour un RAG entreprise ?
Un SLA RAG entreprise doit couvrir plus que l'API du modèle : l'ingestion des sources, la recherche, la passerelle et la latence de bout en bout. 99,9 % sert de référence courante, mais le chiffre ne veut rien dire tant que le périmètre et la méthode de mesure ne sont pas écrits noir sur blanc.
SLA assistant IA : comment améliorer la disponibilité ?
Supprimez d'abord le point de défaillance unique : une passerelle multi-provider, plusieurs modèles, des contrôles de santé et une bascule automatique. Ajoutez un monitoring des erreurs et de la latence, et un mode dégradé pour les moments où plus rien ne génère.
Chez Ask This Guy
Notre passerelle de fournisseurs IA sélectionne en continu les modèles qui répondent, et vite. Objectif côté clients : un niveau de service supérieur à 99,9 % sur le périmètre défini, sans dépendre d'un seul modèle de pointe. Politique UE ou monde entier, selon votre contrainte de souveraineté.
Pas de miracle : une architecture qui part du principe que les LLM cloud tombent. C'est le socle de notre solution RAG entreprise, et la même passerelle alimente un assistant support produit quand les utilisateurs sont vos clients.
Si vous industrialisez un RAG ou un assistant interne et que vous voulez voir cette passerelle en conditions réelles : réservez une démo.