Mistral OCR : diviser sa facture par 10 grâce à l'open weight
Mistral OCR coûte 4 $ les 1 000 pages. Un OCR open weight sur GPU européen descend à 0,15 $ en restant souverain. Benchmark, seuil de rentabilité et pièges.
En mars 2025, Mistral OCR coûtait 1 $ les 1 000 pages. En décembre, 2 $. Depuis juin 2026, 4 $. Le prix a été multiplié par quatre en quinze mois.
Prenez une entreprise qui veut rendre sa base documentaire interrogeable par une IA : 10 000 documents de 100 pages en moyenne, soit un million de pages. Au tarif actuel, l'OCR seul coûte 4 000 $, avant d'avoir posé la première question.
Nous avons fait passer la même charge sur PaddleOCR-VL, un modèle open weight, déployé sur un GPU loué en Europe. Au prix catalogue, GPU occupé en continu : 151 $. Vingt-six fois moins.
Et sans rien céder sur la souveraineté : les machines appartiennent à un opérateur finlandais, et aucune page ne part chez l'éditeur du modèle.
Un GPU n'est jamais occupé à 100 %, d'où le dix de notre titre plutôt que vingt-six.
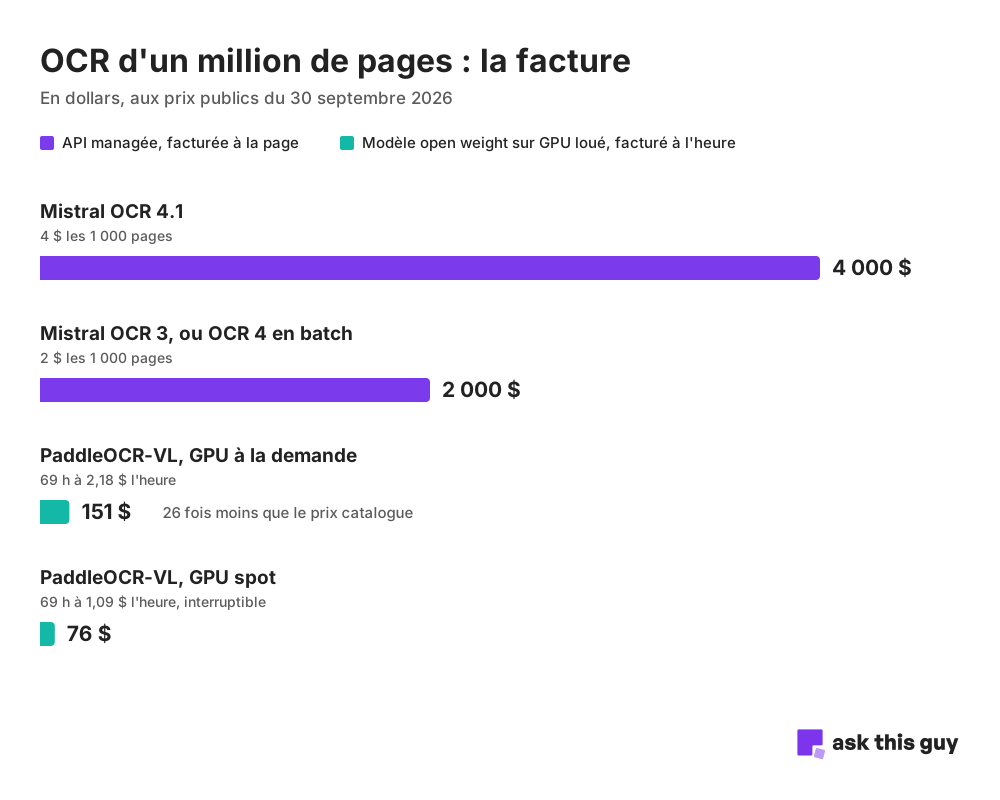 Diagramme en barres comparant le coût de l'OCR d'un million de pages : 4 000 $ avec Mistral OCR 4.1, 2 000 $ avec Mistral OCR 3 ou OCR 4 en batch, 151 $ avec PaddleOCR-VL sur un GPU RTX PRO 6000 à la demande chez Verda, 76 $ sur le même GPU en tarif spot
Hypothèses : GPU RTX PRO 6000 chez Verda, occupé à 100 %, à 4 pages par seconde (notre mesure sur 173 pages, une machine).
Pourquoi un parser PDF ne suffit pas
Un PDF est un format d'impression. Il décrit où poser chaque caractère sur la page. Le fichier ne sait pas ce qu'est un titre ou un tableau : il ne contient que des glyphes et des coordonnées.
Un parser PDF (PyMuPDF, pdfplumber, pypdf) lit cette couche de texte et vous la rend. C'est instantané et gratuit. Quand la couche existe, c'est même exact au caractère près. Le problème vient de tout ce qu'elle ne contient pas.
Le document n'a pas de couche texte. Un contrat signé puis scanné, une télécopie, une photo de bon de livraison : le PDF ne contient qu'une image. Le parser renvoie une page vide.
Le texte est dans les images. Dans notre jeu de test, une présentation de 25 diapositives contient 148 images pour 470 mots de texte extractible. Sur un guide technique de 34 pages rempli de captures d'écran, Mistral OCR a trouvé 546 mots qui n'existent nulle part dans la couche texte.
Les tableaux n'existent pas. Dans un PDF, un tableau est une série de traits et de nombres posés à des coordonnées. Le parser vous rend les nombres à la suite, sans les colonnes. Un chiffre séparé de son en-tête de colonne ne sert à rien : le modèle de langage qui le reçoit devra deviner à quoi il correspond.
L'ordre de lecture et le bruit. Deux colonnes, un encadré, une note de bas de page : le parser suit l'ordre du fichier, qui n'est pas forcément celui de la lecture. Il garde aussi tout ce qui se répète. Sur un cahier des charges de 28 pages de notre jeu de test, 669 mots n'étaient que des lignes d'en-tête et de pied de page répétées de page en page.
Pour un RAG, tout cela se paie plus loin dans la chaîne. Quand un assistant répond à côté, la cause est souvent un document mal lu à l'entrée. C'est l'une des erreurs qui apparaissent après le POC.
Ce que fait un OCR IA
L'OCR classique, celui de Tesseract, reconnaît des caractères ligne par ligne. Il lit un scan propre et s'arrête là : pas de structure, des tableaux en vrac.
La génération actuelle travaille en deux temps. Un premier modèle découpe la page en blocs (titre, paragraphe, tableau, figure, en-tête) et les remet dans l'ordre de lecture. Un second, un modèle de vision et de langage, transcrit chaque bloc. Le résultat est un fichier Markdown avec ses titres, ses tableaux et ses images, directement exploitable par un LLM. C'est ce que l'on cherche quand on tape « pdf to markdown ».
On y accède de deux façons. La première est une API managée, dont Mistral OCR est l'exemple le plus connu en France : vous envoyez un PDF, vous recevez le Markdown, vous payez à la page.
La seconde est un modèle open weight que vous hébergez. PaddleOCR-VL, publié par Baidu sous licence Apache 2.0, pèse moins d'un milliard de paramètres et tient sur un seul GPU. Là, vous louez la machine et vous payez à l'heure.
Le modèle vient de Chine. Cela ne retire rien à la souveraineté du montage, et nous y revenons après les chiffres.
Ce que coûte Mistral OCR
| Version | Sortie | Prix pour 1 000 pages |
|---|---|---|
| Mistral OCR | Mars 2025 | 1 $ |
| Mistral OCR 3 | Décembre 2025 | 2 $ |
| Mistral OCR 4, puis 4.1 | Juin et juillet 2026 | 4 $ (2 $ en traitement par lots) |
Sources : annonce de mars 2025, fiche du modèle OCR 4.1 et Silicon.fr pour l'historique.
Soyons justes : chaque version fait plus que la précédente. OCR 4 lit 170 langues, renvoie la position de chaque paragraphe et s'attaque au manuscrit. Mais si vos documents sont des rapports dactylographiés en français, vous payez ces progrès sans en avoir l'usage. OCR 3 reste disponible à 2 $, et rien ne dit pour combien de temps.
Notre million de pages coûte donc 4 000 $ au prix catalogue, 2 000 $ si vous acceptez le traitement par lots ou l'ancien modèle.
Et ce montant ne correspond qu'à la première facture. De nouveaux documents arrivent, d'anciens sont mis à jour. Surtout, chaque fois que vous améliorez votre chaîne d'ingestion (un nouveau modèle, un réglage différent sur les tableaux), vous repassez tout le stock. À 4 000 $ le passage, on hésite à tester une amélioration. À 150 $, on la teste.
PaddleOCR-VL sur un GPU loué : le même million de pages
Notre déploiement tourne chez Verda, opérateur finlandais dont les centres de données sont en Finlande et en Islande. La machine : un GPU RTX PRO 6000, loué 2,18 $ l'heure à la demande, 1,09 $ en tarif spot (capacité disponible, interruptible à tout moment).
Le 30 septembre 2026, nous avons mesuré son débit sur 9 PDF réels totalisant 173 pages. Une seule machine plafonne autour de 4 pages par seconde, soit 14 400 pages par heure.
Un million de pages à 14 400 pages par heure, c'est 69 heures de GPU. À 2,18 $ l'heure, 151 $.
| Coût pour 1 000 pages | Un million de pages | |
|---|---|---|
| Mistral OCR 4.1 | 4 $ | 4 000 $ |
| Mistral OCR 3, ou OCR 4 par lots | 2 $ | 2 000 $ |
| PaddleOCR-VL, GPU à la demande | 0,15 $ | 151 $ |
| PaddleOCR-VL, GPU spot | 0,08 $ | 76 $ |
Pourquoi nous disons dix, et pas vingt-six
Ces 0,15 $ supposent un GPU qui travaille à chaque seconde facturée. Or un GPU loué se paie à l'heure, qu'il convertisse des pages ou qu'il attende.
Tout dépend donc de son taux d'occupation :
| Pages traitées par heure facturée | Occupation du GPU | Résultat face à Mistral OCR 4.1 |
|---|---|---|
| 545 | 4 % | Même coût |
| 1 090 | 8 % | 2 fois moins cher (le prix de Mistral OCR 3) |
| 5 450 | 38 % | 10 fois moins cher |
| 14 400 | 100 % | 26 fois moins cher |
Un stock à traiter est le cas idéal : vous remplissez la file d'attente, la machine sature, vous l'éteignez à la fin. Un filet de trois documents par heure est le pire : le GPU attend, et vous payez l'attente.
Un GPU allumé en permanence n'a aucun sens
L'erreur la plus facile à faire : louer une machine, la laisser allumée et découvrir la facture à la fin du mois. Un GPU à 2,18 $ l'heure qui tourne jour et nuit coûte 1 591 $ par mois, qu'il convertisse un million de pages ou aucune. À ce prix, Mistral OCR 4.1 vous traite près de 400 000 pages. En dessous de ce volume mensuel, la machine allumée en continu revient plus cher que l'API.
Prenez 100 000 pages par mois :
| Montage | Coût mensuel |
|---|---|
| Mistral OCR 4.1 | 400 $ |
| GPU loué, allumé en permanence | 1 591 $ |
| GPU loué, allumé 7 heures puis mis en pause | 15 $, plus les minutes de démarrage |
Il faut donc un système qui démarre le conteneur quand des documents arrivent et le met en pause dès que la file est vide. Sans lui, l'open weight coûte plus cher que ce qu'il remplace.
Verda le permet. Ses Serverless Containers descendent à zéro machine quand il n'y a rien à faire et gardent les requêtes en file d'attente pendant qu'une machine démarre. Seules les minutes où elle a tourné sont facturées, démarrage et arrêt compris.
Deux réglages restent à votre charge. D'abord le seuil de démarrage : réveiller un GPU pour trois documents coûte plus cher que de les envoyer à une API. Chez nous, la machine démarre à partir de 50 documents reçus en un quart d'heure et se met en pause après dix minutes sans activité. Ensuite le sort des documents qui arrivent pendant le démarrage, qui prend quelques minutes. Chez nous, ils partent vers le moteur de repli sans attendre.
Moins cher, et tout aussi souverain
Passer de l'API d'un éditeur français à un modèle publié par Baidu ne retire rien à la souveraineté du montage. Une IA souveraine se juge sur trois couches : le droit applicable au fournisseur, l'infrastructure qui traite vos données et les modèles qui les lisent.
Le fournisseur. Verda est une société finlandaise, de droit européen, comme Mistral est une société française.
L'infrastructure. Ses centres de données sont en Finlande et en Islande, dans un périmètre européen couvert par le RGPD. C'est là que vos documents sont convertis.
Le modèle. PaddleOCR-VL est publié sous licence Apache 2.0 : nous avons téléchargé ses poids une fois, et il s'exécute dans notre propre conteneur. Aucune page ne remonte vers son éditeur. Le trajet de vos données dépend de l'endroit où le modèle tourne et de celui qui opère la machine. Le pays où il a été entraîné n'y change rien.
Sur un point, l'open weight fait même mieux qu'une API, française ou non : personne ne peut en changer le prix. Des poids sous licence Apache 2.0 ne doublent pas de tarif en décembre, et personne ne les retire du catalogue. Être souverain, c'est aussi ne pas dépendre de la grille tarifaire d'un autre.
Nous gardons Mistral OCR dans notre chaîne, en repli. Ce choix est affaire de coût et de risque, pas de drapeau.
Au-delà du tarif horaire
L'écart de prix est réel. Il a des contreparties.
Mistral est plus rapide
Sur un document seul, Mistral OCR 4.1 traite une page en 0,20 seconde, contre 0,43 à 0,56 pour notre déploiement. L'écart se creuse en charge : avec huit documents envoyés en même temps, Mistral atteint 18 à 20 pages par seconde quand notre machine reste autour de 4. Et sur une machine saturée, un document d'une page qui prend 2 secondes seul en attend plus de 20 derrière les gros.
Ce plafond est celui d'une seule machine. Si le débit est un enjeu, louez-en plusieurs : chaque machine ajoute ses 4 pages par seconde, et le coût à la page ne bouge pas tant qu'elles sont occupées. Notre million de pages demande 69 heures sur un GPU, soit près de trois jours. Sur quatre GPU, il passe en 17 heures, pour les mêmes 151 $.
Plusieurs machines ne raccourcissent pas la conversion d'un document pris seul. Pour un utilisateur qui dépose un PDF dans une conversation et attend sa réponse, l'API reste plus rapide.
Spot ou API, il faut des replis
En tarif spot, nous constatons régulièrement que la machine nous est reprise en cours de route. Très peu la nuit, en revanche, et c'est la nuit que passe l'essentiel de nos traitements.
L'API n'est pas plus sûre. Sur deux mois de production, 4,8 % de nos appels à Mistral OCR ont échoué sur une erreur 404 : 402 appels sur 8 320, soit près d'un sur vingt.
Dans tous les cas, il faut des replis. Qu'un GPU disparaisse ou qu'une API renvoie une erreur, l'ingestion ne doit pas s'arrêter : le document repart vers un autre moteur, sans intervention. Aucun maillon ne tient seul, ce qui vaut pour l'OCR comme pour le reste de la chaîne IA.
La qualité : équivalente à la relecture
Nous avons relu les sorties des deux moteurs à l'œil. PaddleOCR-VL et Mistral OCR donnent des résultats très proches. Tous deux font mieux que ce que nous avons constaté avec LightOnOCR et avec Docling.
Une mesure automatique complète cette relecture. Nous avons compté, pour chaque moteur, la part des mots de la couche texte des PDF qu'il retrouve : 93,6 % pour PaddleOCR-VL, 97,7 % pour Mistral OCR 3, 98,3 % pour Mistral OCR 4.1. L'essentiel de cet écart est voulu, puisque notre configuration retire les en-têtes, les pieds de page et les notes de bas de page.
Il reste deux différences réelles. Mistral transcrit le texte des captures d'écran, PaddleOCR-VL les laisse pour l'essentiel sous forme d'images. Et PaddleOCR-VL écrit ses tableaux en HTML, avec des entités à la place des apostrophes, ce qui demande un nettoyage.
La mesure automatique porte sur 9 documents, dont aucun n'est un scan. Avant de décider, faites tourner les deux moteurs sur cinquante de vos propres documents.
Il faut l'exploiter
Une image de conteneur de plus de 15 Go, environ cinq minutes de démarrage à froid, une facturation par tranches de dix minutes, le contrôleur qui démarre et met en pause la machine, un repli quand elle ne répond pas. Rien de tout cela n'est difficile pris séparément. L'ensemble représente quelques semaines de travail d'ingénierie, puis une surveillance dans la durée.
Quand basculer, quand rester sur l'API
| Votre situation | Le bon choix | Pourquoi |
|---|---|---|
| Petit volume, au fil de l'eau (quelques milliers de pages par mois) | L'API | L'enjeu se compte en dizaines de dollars, un GPU n'en vaut pas l'effort |
| Gros stock ou reprises régulières (centaines de milliers de pages) | L'open weight sur GPU loué | Le GPU tourne plein : 10 à 26 fois moins cher |
| Un utilisateur attend la réponse devant son écran | L'API | Un document seul y passe plus vite, sans démarrage à attendre |
| Maîtrise complète de la chaîne exigée | L'open weight sur GPU loué | Le modèle s'exécute chez vous, et personne ne peut en changer le prix |
| Du volume et de l'interactif | Les deux, en chaîne | Le GPU traite le volume, l'API prend le relais quand il est arrêté ou indisponible |
Le dernier cas est le plus fréquent. C'est aussi le seul qui demande de construire quelque chose.
Chez Ask This Guy, ce travail est déjà fait
Notre chaîne d'ingestion enchaîne trois moteurs. PaddleOCR-VL sur nos GPU chez Verda passe en premier. S'il ne répond pas, le document part chez Mistral OCR, sans attendre qu'une machine démarre. Docling sert de dernier recours. Un contrôleur allume le GPU quand le volume le justifie et le met en pause après dix minutes d'inactivité.
Le premier maillon tourne sur nos GPU en Finlande et en Islande, le repli est assuré par un éditeur français. Nous avons baissé le coût sans toucher au niveau de souveraineté, que nous détaillons dans notre approche de l'IA souveraine.
Nos clients ne voient rien de tout cela. Ils déposent leurs documents ou branchent leurs sources, puis les interrogent dans leur assistant documentaire. Nous décrivons les autres façons de faire tourner des modèles, du GPU acheté à la plateforme clé en main, dans notre guide de l'inférence IA en entreprise.
Questions fréquentes sur Mistral OCR et les OCR open source
Combien coûte Mistral OCR ?
Au 30 septembre 2026, Mistral OCR 4.1 coûte 4 $ pour 1 000 pages et 2 $ en traitement par lots. L'ancien modèle, Mistral OCR 3, reste disponible à 2 $ pour 1 000 pages. Au lancement de mars 2025, le tarif était de 1 $ pour 1 000 pages. Pour un million de pages, comptez donc 2 000 à 4 000 $ par passage.
Quelle différence entre un parser PDF et un OCR ?
Un parser PDF lit le texte déjà enregistré dans le fichier : il est instantané et gratuit, mais il ne voit ni les documents scannés, ni le texte contenu dans les images, et il ne reconstitue pas les tableaux. Un OCR analyse l'image de la page. Les OCR à base d'IA reconnaissent en plus la structure du document (titres, tableaux, ordre de lecture) et produisent un texte structuré, en général du Markdown.
Existe-t-il une alternative open source à Mistral OCR ?
Oui, plusieurs. PaddleOCR-VL, publié par Baidu sous licence Apache 2.0, est celui que nous avons retenu : un modèle de moins d'un milliard de paramètres qui tient sur un seul GPU. LightOnOCR, Docling, MinerU et DeepSeek-OCR sont d'autres options. Tous demandent de louer ou de posséder un GPU et d'exploiter le déploiement soi-même.
Un OCR open weight publié par un éditeur chinois est-il souverain ?
Oui, s'il est exécuté sur une infrastructure que vous maîtrisez. Un modèle open weight comme PaddleOCR-VL, publié par Baidu sous licence Apache 2.0, se télécharge une fois puis tourne dans votre propre conteneur : aucun document n'est transmis à son éditeur. La souveraineté dépend alors de l'opérateur de la machine et de sa localisation. Déployé chez un opérateur de droit européen, dans des centres de données situés en Europe, un tel OCR est aussi souverain que l'API d'un éditeur français.
À partir de quel volume un OCR auto-hébergé devient-il rentable ?
Sur un GPU loué 2,18 $ l'heure, l'OCR auto-hébergé coûte moins cher que Mistral OCR 4.1 dès 545 pages traitées par heure facturée et moins cher que Mistral OCR 3 dès 1 090 pages. Pour diviser la facture par dix, il faut environ 5 450 pages par heure, soit un GPU occupé à 38 %. Ce calcul suppose que la machine est mise en pause dès qu'elle n'a plus rien à traiter : allumée en permanence, elle coûte 1 591 $ par mois et ne devient rentable qu'au-delà de 400 000 pages mensuelles.
PaddleOCR-VL est-il aussi précis que Mistral OCR ?
À la relecture humaine, les résultats de PaddleOCR-VL et de Mistral OCR sont très proches et meilleurs que ceux que nous avons constatés avec LightOnOCR et Docling. En mesure automatique sur 173 pages, PaddleOCR-VL retrouve 93,6 % des mots de la couche texte des PDF, contre 97,7 % pour Mistral OCR 3 et 98,3 % pour Mistral OCR 4.1. La plus grande part de cet écart vient des en-têtes, pieds de page et notes de bas de page, que notre configuration retire volontairement.
Conclusion
L'OCR ressemble à une ligne de coût sans histoire. Il suffit d'un million de pages et d'un tarif qui double deux fois pour qu'elle en ait une.
Un modèle open weight sur un GPU loué en Europe ramène cette ligne de 4 000 $ à quelques centaines, sans rien céder sur la souveraineté ni sur la qualité. À une condition : que la machine ne tourne que lorsqu'elle a du travail.
Si vous avez un stock documentaire à rendre interrogeable et que vous préférez ne pas construire tout cela vous-même : réservez une démo.
Mesures du 30 septembre 2026 : 9 PDF, 173 pages, une machine par déploiement, une à deux passes par moteur. Prix publics de Mistral et de Verda relevés le même jour.