.webp)
RAG en IA : connecter un LLM à vos documents d'entreprise
Qu'est-ce que le RAG en IA ? Définition, fonctionnement, choix du LLM, recherche hybride, RAG agentique et retours de production en entreprise.
Qu'est-ce que le RAG en IA ?
Le RAG (Retrieval Augmented Generation, ou génération augmentée par récupération) est une approche qui connecte un modèle d'IA à vos propres sources. À chaque question, le système recherche les passages pertinents dans vos documents, vos bases et vos outils, puis les transmet au modèle, qui rédige une réponse appuyée sur ces éléments et cite ses sources. Le modèle n'est ni réentraîné ni modifié : on change ce qu'il lit avant qu'il réponde.
Le problème : une IA qui connaît tout… sauf vous
Vous utilisez une IA grand public (ChatGPT, Mistral Le Chat, Gemini, etc.) et vous êtes bluffé par ses capacités ? Il y a de quoi.
Mais avez-vous essayé de lui poser des questions sur le dernier rapport financier de votre entreprise ou sur une procédure interne ? Dès que les sources ne sont pas publiques, elle est impuissante.
 IA incapable de répondre à des questions sur des documents internes d'entreprise
Les IA comme ChatGPT sont entraînées sur des quantités astronomiques de données publiques. Elles sont expertes du monde, mais pas de votre monde.
Pour qu'une IA soit vraiment utile en interne, elle doit accéder à :
- vos documents internes
- vos politiques RH
- vos processus métiers
- vos outils (CRM, ERP, drive)
- vos bases de données
Bref : tout ce qui fait l'ADN de votre entreprise.
Les limites de l’approche “copier-coller”
Ajouter manuellement des documents dans ChatGPT peut sembler une solution rapide et pragmatique (si l'on met de côté les problèmes de confidentialité).
Mais dans la pratique :
- c'est chronophage
- on ne sait pas toujours quels fichiers sont réellement pertinents
- on envoie trop de documents ou des fichiers trop gros, rendant l’IA moins efficace
- on oublie des documents ou on ne met pas les bonnes versions
- cela n'intègre pas les informations d'un CRM ou d'un drive
Résultat : la connaissance interne n'est jamais complète ni structurée. C'est un problème ancien, que les démarches de gestion des connaissances n'ont jamais vraiment résolu, et nous expliquons pourquoi dans Knowledge management : pourquoi vos démarches échouent.
La fenêtre de contexte : le talon d'Achille de nos IA préférées
L'IA a une mémoire de travail très performante... mais limitée. C'est sa fenêtre de contexte : elle ne peut traiter qu'une certaine quantité d'informations à la fois.
Des limites concrètes
Les modèles récents affichent des fenêtres de contexte de plusieurs centaines de milliers de tokens, parfois davantage. Traduit en pages, on parle de quelques centaines à un peu plus d'un millier de pages selon les modèles.
Ça paraît beaucoup. Mais si vous envoyez dix documents de 300 pages, vous avez déjà dépassé la limite.
Surtout, la taille annoncée n'est pas une garantie de qualité. Plus le contexte est chargé, plus le modèle perd en précision : il oublie des passages, confond des sources, ou s'appuie sur le mauvais paragraphe. C'est ce qu'on appelle parfois la dilution du contexte. Il vaut donc mieux pré-trier ce que l'on envoie, pour que seules les informations pertinentes parviennent au modèle.
C’est là qu’intervient le RAG : la solution pour une IA "intelligemment informée"
Le RAG (Retrieval Augmented Generation) est une approche où :
- L'outil se connecte à vos sources et pré-traite les documents pour les futures recherches
- Pour chaque requête, il recherche les "morceaux" de documents pertinents ("Retrieval")
- Il envoie à l'IA la requête enrichie de ces documents pertinents ("Augmented")
- L'IA génère ensuite une réponse précise basée sur ces éléments ("Generation")
C'est comme si vous ajoutiez à votre IA un assistant bibliothécaire ultra-rapide et ultra-précis.
 Un bibliothécaire rapide et précis
Notez que le RAG ne modifie pas le modèle. Le LLM reste le même : on change ce qu'on lui donne à lire avant qu'il réponde. C'est une différence essentielle pour la suite.
RAG et LLM : qui fait quoi dans la chaîne ?
On parle souvent de RAG LLM comme s'il s'agissait d'une seule technologie. Ce sont en réalité deux briques distinctes, et savoir laquelle fait quoi évite la plupart des erreurs de conception.
Le LLM (Large Language Model) est le générateur. Il comprend la question, raisonne sur ce qu'on lui fournit, et rédige la réponse. Il ne sait rien de votre entreprise et n'a aucun accès à vos systèmes.
Le RAG est la couche qui l'entoure. Elle prépare vos documents, retrouve les passages utiles au moment de la question, et les place dans le contexte du LLM avant de l'appeler.
Dans une chaîne RAG, chaque appel au LLM se déroule ainsi :
| Étape | Qui la réalise | Ce qui se passe |
|---|---|---|
| 1. Préparation | Le RAG | Vos documents sont découpés, vectorisés et indexés, en amont de toute question |
| 2. Recherche | Le RAG | La question est transformée en requête, les passages pertinents sont retrouvés |
| 3. Assemblage | Le RAG | Question, extraits et consignes sont assemblés en un contexte unique |
| 4. Génération | Le LLM | Le modèle rédige la réponse à partir de ce contexte |
| 5. Attribution | Le RAG | Les sources correspondantes sont rattachées à la réponse |
Trois conséquences pratiques en découlent.
Le LLM n'apprend rien de vos documents. Il les lit à chaque requête, puis les oublie. C'est une bonne nouvelle pour la confidentialité, et cela signifie qu'une mise à jour de vos sources est immédiatement prise en compte, sans réentraînement.
La qualité d'un RAG se joue surtout hors du LLM. Si l'étape 2 remonte les mauvais passages, aucun modèle ne rattrapera l'erreur : il rédigera une réponse fluide et fausse. Dans nos projets, l'essentiel des gains de pertinence vient du découpage, de la recherche et du filtrage, pas du choix du modèle.
On peut changer de LLM sans refaire le RAG. C'est l'intérêt d'une architecture multi-modèle : le même socle documentaire peut être servi par un modèle rapide et économique pour les questions simples, et par un modèle plus puissant pour les analyses complexes.
Quel LLM choisir pour un RAG ?
La question arrive vite, et la réponse n'est pas « le plus gros modèle disponible ». Cinq critères comptent réellement :
- Le respect des consignes. Un bon LLM de RAG s'en tient aux extraits fournis et dit qu'il ne sait pas quand l'information est absente. Un modèle brillant mais bavard, qui complète les trous avec ses connaissances générales, est un mauvais choix.
- La capacité à citer. Rattacher chaque affirmation à l'extrait dont elle provient est une compétence inégale d'un modèle à l'autre.
- La fenêtre de contexte. Suffisante pour accueillir une dizaine d'extraits et l'historique de conversation, sans excès : au-delà, la précision se dégrade et le coût grimpe.
- Le coût et la latence. Un assistant interne interrogé cent fois par jour n'a pas le même profil économique qu'une analyse mensuelle de dossiers.
- La langue et la juridiction. La qualité en français varie selon les modèles, et le lieu de traitement des requêtes est un critère à part entière dès que les documents sont sensibles. Nous détaillons cet arbitrage sur notre page IA souveraine.
En pratique, un modèle de milieu de gamme discipliné donne de meilleurs résultats sur un RAG d'entreprise qu'un modèle haut de gamme mal cadré. Le LLM est un composant remplaçable ; votre chaîne documentaire, non.
RAG, fine-tuning ou contexte long : que choisir ?
Trois approches permettent de rendre une IA plus pertinente sur votre métier. Elles ne répondent pas au même besoin, et on les oppose souvent à tort.
| Ce que ça fait | Quand c'est le bon choix | Limite principale | |
|---|---|---|---|
| RAG | Va chercher l'information dans vos sources au moment de la question | Connaissances nombreuses, qui changent, et qui doivent être citées | Demande un vrai travail d'ingénierie sur les données |
| Fine-tuning | Réentraîne le modèle pour lui donner un style, un format, un vocabulaire | Faire adopter un ton, une nomenclature, un format de sortie | N'apporte pas de connaissance fiable et vérifiable, et vieillit vite |
| Contexte long | Envoie les documents directement dans la question | Corpus petit et stable, usage ponctuel | Coûteux, lent, et la précision se dégrade quand le volume monte |
La confusion la plus fréquente porte sur le fine-tuning. Beaucoup d'entreprises pensent qu'entraîner un modèle sur leurs documents va lui faire « apprendre » leur entreprise. En pratique, le modèle apprend surtout une manière de parler. Il ne saura pas vous dire quelle version du contrat est en vigueur aujourd'hui, et il ne citera aucune source. Pour la connaissance, c'est le RAG qui répond.
Les trois se combinent d'ailleurs très bien : un RAG solide pour la connaissance, une fenêtre de contexte confortable pour raisonner sur ce qui a été récupéré, et éventuellement du fine-tuning pour le style.
Plongée dans le moteur du RAG : comment ça marche vraiment ?
Pour aller plus loin, consultez notre documentation sur le traitement des données et le RAG.
Étape 1 : Le découpage intelligent (chunking)
Avant tout, vos documents doivent être convertis en texte exploitable :
- extraction des paragraphes
- récupération du texte des tableaux
- interprétation de schémas, graphiques, etc. (cette partie-là est importante, car ils contiennent souvent des informations utiles et exploitables)
Puis vient le découpage en chunks. Un bon chunk doit être :
- court → pour tenir dans la fenêtre de contexte
- cohérent → une idée claire par bloc
- isolé → pas de mélange de concepts
Vous ne donnez pas tout un document à l'IA. Vous lui donnez le paragraphe qui répond exactement à la question.
Étape 2 : Le mécanisme de recherche (la magie des embeddings)
Pour comparer les textes, le RAG transforme :
- votre question
- vos chunks
...en vecteurs numériques : ce sont les embeddings. Deux chunks proches en sens → leurs vecteurs sont proches.
Deux types de recherche indispensables
- Recherche sémantique (par le sens)
Idéale pour les questions conceptuelles : « Comment demander un congé ? »
- Recherche par mots-clés (par la précision)
Essentielle pour les termes spécifiques sans signification universelle :
- « Référence produit XYZ-123 »
- « Procédure PNC-V4 »
- « Jean-Pierre Dubreuil »
Car une IA ne connaît pas Jean-Pierre Dubreuil du service compta...
Les deux mécanismes sont complémentaires. Un RAG uniquement "sémantique" (pourtant fréquent) échouera sur ce type de recherches.
Le schéma d’un RAG, étape par étape
Voici le schéma RAG complet, avec ses deux phases : la préparation des sources d'un côté, le traitement de chaque question de l'autre. La première ne se rejoue qu'à l'ajout ou à la mise à jour de documents ; la seconde se rejoue à chaque fois qu'un utilisateur pose une question.
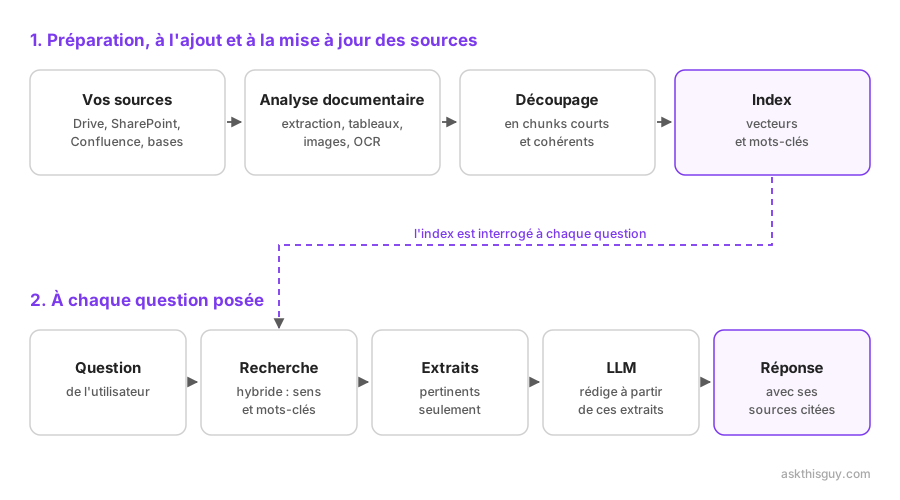 Schéma RAG en deux phases : préparation des sources (analyse documentaire, découpage en chunks, indexation en vecteurs et mots-clés) puis traitement d'une question (recherche hybride, extraits pertinents, génération par le LLM, réponse sourcée)
Ce schéma décrit le RAG tel qu'il est enseigné et tel qu'il est implémenté dans la majorité des démonstrations : une question, une recherche, une réponse. C'est une bonne façon de comprendre le principe. Ce n'est plus la façon dont les systèmes sérieux fonctionnent aujourd'hui.
Du RAG linéaire au RAG agentique
Le schéma ci-dessus a un présupposé fort : une seule recherche suffit pour répondre. Dans la vraie vie des entreprises, c'est rarement vrai.
Prenez une question comme un manager la pose vraiment : « Tient-on nos engagements avec Durand sur la période ? »
Rien dans cette phrase ne dit où chercher. Ni quels engagements, ni quelle période, ni dans quel système. C'est au système de le découvrir. Il doit d'abord trouver ce qui matérialise nos obligations envers Durand, un contrat, un avenant, une convention de service, puis y lire ce qui est engagé : un délai de prise en charge, un nombre d'interventions incluses, un taux de disponibilité. C'est seulement en lisant ces documents qu'il apprend que la période d'engagement est l'année civile. Il peut alors aller chercher, dans l'outil de ticketing, les tickets de l'année rattachés aux bons contrats, et les comparer aux seuils qu'il vient de découvrir.
Deux sources de nature différente, et surtout : la seconde requête ne peut pas être formulée avant d'avoir lu le résultat de la première.
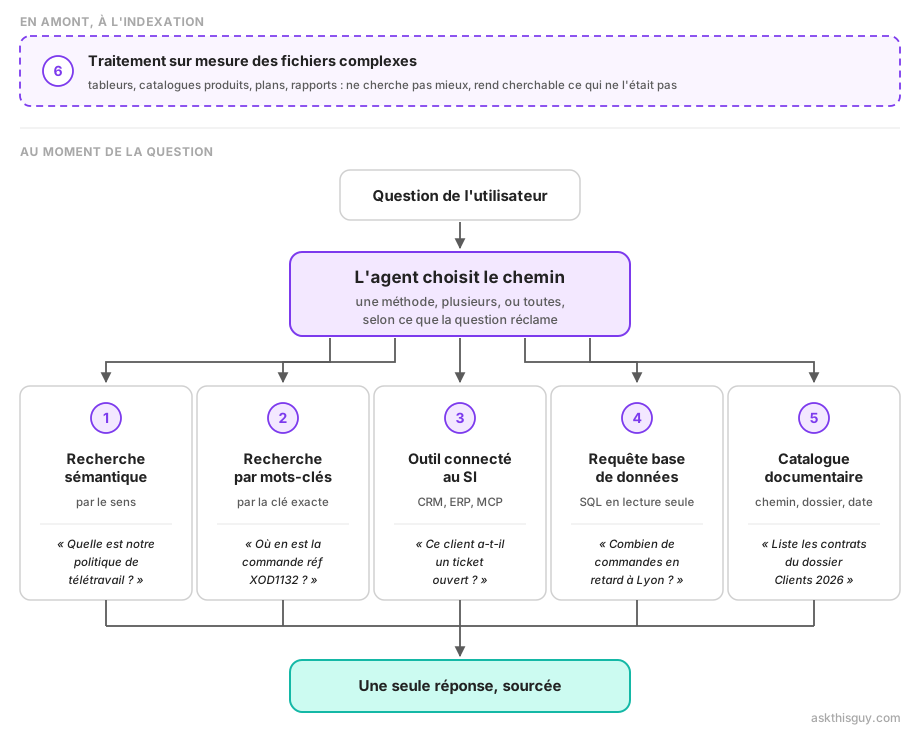
C'est exactement ce que fait un RAG agentique. Au lieu d'exécuter une recherche unique, un agent orchestrateur mène une enquête :
- il analyse la question et la reformule, parfois en plusieurs sous-questions
- il choisit la ou les sources à interroger
- il lit ce qu'il obtient, et décide s'il en sait assez
- si ce n'est pas le cas, il relance une recherche mieux ciblée, avec ce qu'il vient d'apprendre
- il ne rédige la réponse qu'une fois les éléments réunis, en citant ses sources
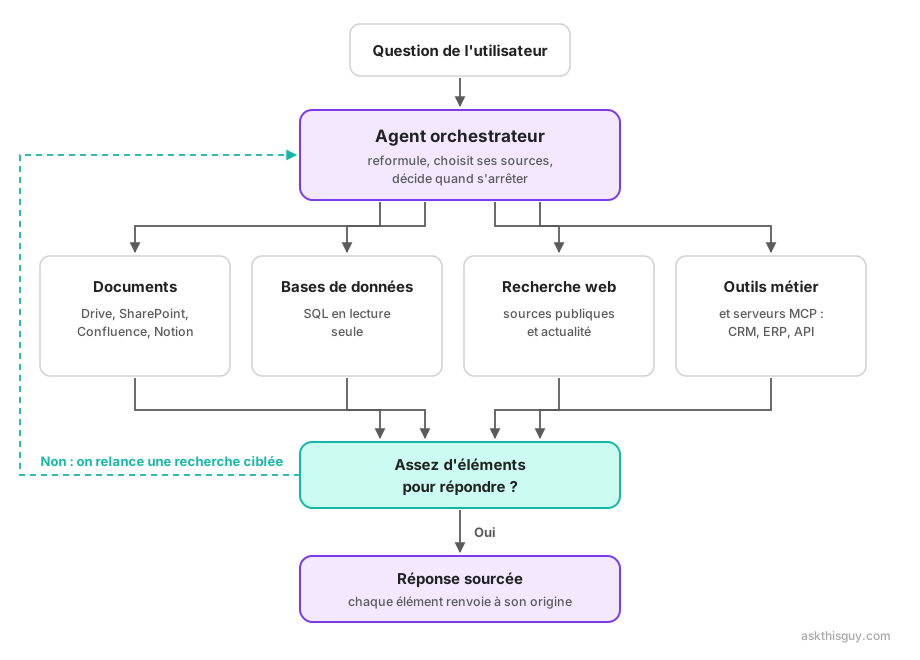 Schéma d'un RAG agentique : l'agent orchestrateur interroge documents, bases de données, web et outils métier, évalue s'il a assez d'éléments, relance une recherche ciblée si besoin, puis produit une réponse sourcée
La différence avec le schéma précédent tient dans une seule flèche : celle qui revient vers l'agent.
Trois conséquences pratiques, souvent sous-estimées.
La connaissance n'est plus seulement documentaire. Un agent peut interroger dans la même conversation vos documents, une base SQL en lecture seule, le web, et vos outils métier exposés via des serveurs MCP ou des outils sur mesure. L'utilisateur, lui, pose une seule question et n'a pas à savoir où vit l'information.
Les allers-retours coûtent du temps et des tokens. Un agent qui enquête consomme plus qu'une recherche unique. Il faut donc borner le nombre d'itérations, savoir quand s'arrêter, et surveiller les coûts. Un système agentique mal cadré est un système lent et cher.
La traçabilité devient indispensable. Quand une réponse résulte de quatre appels à trois sources, l'utilisateur doit pouvoir vérifier d'où vient chaque élément. Sans citations, un RAG agentique est une boîte noire, et personne ne fait confiance à une boîte noire pour décider.
IA et analyse de documents : ce qui se joue avant la recherche
On parle beaucoup des modèles et des agents. Dans les projets réels, ce qui fait échouer un RAG se situe presque toujours en amont : dans l'analyse des documents.
Vos connaissances ne sont pas du texte propre. Ce sont des PDF scannés, des présentations, des tableaux Excel, des plans, des contrats avec des annexes, des comptes rendus rédigés à la va-vite. Chaque format pose son problème.
- Les PDF scannés demandent une reconnaissance de caractères (OCR). Une OCR médiocre produit du texte truffé d'erreurs, et un chunk illisible ne sera jamais retrouvé.
- Les tableaux perdent leur structure quand ils sont convertis naïvement en texte. Une colonne mal alignée, et le chiffre du trimestre 2 se retrouve attribué au trimestre 3.
- Les schémas et graphiques contiennent souvent l'information la plus dense d'un document. Les ignorer revient à jeter la moitié de la valeur d'une présentation commerciale.
- Les documents longs et hétérogènes (un manuel qualité de 200 pages, par exemple) doivent être découpés en respectant leur structure logique, pas tous les 500 caractères.
- Les versions multiples posent une question qui n'est pas technique : quel document fait foi ? Un RAG qui indexe trois versions d'une procédure répondra parfois avec la mauvaise.
C'est pour cette raison que l'analyse documentaire par IA ne se réduit pas à « brancher un dossier ». Chaque entreprise a des formats, des conventions et des exceptions qui lui sont propres, et le traitement doit s'y adapter. C'est le travail le moins visible d'un projet RAG, et de loin le plus déterminant.
Un exemple de RAG de bout en bout
Reprenons « Tient-on nos engagements avec Durand sur la période ? », dans un système agentique.
- Réception. La question ne désigne ni document, ni système, ni dates. Trois inconnues : de quels engagements parle-t-on, sur quelle période, et où sont les faits qui permettent de les mesurer.
- Première recherche. Recherche hybride sur les documents. La recherche par mots-clés retrouve « Durand », un nom propre qu'aucune recherche sémantique ne saurait cibler seule ; la recherche sémantique remonte en parallèle les passages parlant de niveaux de service et de délais d'intervention. L'agent obtient un contrat-cadre, un avenant et une convention de service.
- Lecture et décision. L'avenant remplace deux clauses du contrat-cadre. L'agent retient la version en vigueur et y lit les engagements chiffrés : délai de prise en charge, nombre d'interventions incluses, et une période d'engagement annuelle. Il vient d'apprendre ce qu'il ne savait pas au départ.
- Deuxième source, formulée à partir de la première. Maintenant seulement, l'agent peut interroger le ticketing via l'outil de requête en base de données : les tickets de l'année, rattachés à ces contrats précis, avec leurs délais de prise en charge réels.
- Comparaison. L'agent confronte les chiffres obtenus aux seuils qu'il a lus, et repère les écarts.
- Génération. Réponse structurée engagement par engagement, avec le lien vers l'article contractuel correspondant et le détail des tickets concernés.
Une seule question posée, deux sources, et une chaîne où l'étape 4 était impossible à écrire avant l'étape 3. C'est cette mécanique que l'utilisateur ne voit pas, et c'est elle qui fait la différence entre un gadget et un outil de travail.
RAG avec ChatGPT, Gemini, Claude ou Copilot : ce que ça change
Question fréquente : « Nous avons déjà ChatGPT Entreprise (ou Copilot, ou Gemini). Est-ce que ça ne fait pas déjà du RAG ? »
En partie, oui. Ces outils savent lire des fichiers que vous leur donnez, et certains se connectent à un espace de travail (Microsoft 365 pour Copilot, Google Workspace pour Gemini). Pour de la recherche simple dans un périmètre déjà couvert par l'éditeur, c'est souvent suffisant.
Les limites apparaissent vite dès qu'on sort de ce périmètre.
- Le périmètre est celui de l'éditeur. Copilot est excellent sur SharePoint et Teams. Il ne connaît pas votre GED métier, votre ERP maison ni votre base PostgreSQL.
- Vous ne maîtrisez pas la chaîne de traitement. Le découpage, le modèle d'embeddings et la stratégie de recherche sont des choix de l'éditeur. Si vos documents sortent du cas standard, vous n'avez pas de levier.
- Le modèle est imposé. Vous utilisez celui du fournisseur, sans possibilité d'en changer si un autre est meilleur ou moins cher sur votre cas d'usage.
- La localisation des données dépend du fournisseur. C'est un point structurant pour beaucoup d'organisations européennes.
Le vrai critère n'est donc pas « RAG ou pas RAG », mais : jusqu'où pouvez-vous adapter la chaîne à vos données, et gardez-vous la main sur les choix techniques ? Nous avons développé ce point dans notre article sur les erreurs de RAG en entreprise après le POC.
Tous les RAG ne se valent pas : l'art de bien choisir sa solution
Le marché est rempli de RAG "rapides à intégrer", mais... comme les chasseurs des Inconnus : il y a les bons et les mauvais.
Ce qui fait la différence :
- Qualité de la conversion → ne pas savoir extraire les données d'un graphique = perdre une info importante
- Qualité du découpage → chunks trop gros ou incohérents = IA confuse
- Choix des modèles d'embeddings → ils n'excellent pas tous dans les mêmes domaines
- Recherche hybride → sémantique seule = erreurs sur les noms propres
- Capacité d'enquête → un moteur qui ne sait faire qu'une passe échouera sur toute question un peu composée
- Traçabilité → sans citations vérifiables, les utilisateurs cessent d'utiliser l'outil au premier doute
Un mauvais RAG peut rendre l'IA floue, approximative, incapable de retrouver des informations pourtant bien présentes.
Ce n'est pas théorique. Sur le benchmark que nous opérons en continu depuis un serveur situé en France, plus de 95 % des appels d'embeddings passaient sous la seconde en janvier 2026, mais certaines journées sortaient complètement des clous, au point de faire échouer une démo client en direct. Nous racontons l'épisode et ce que nous en avons tiré dans notre stratégie d'embeddings. Sur la génération de texte, notre benchmark Q1 2026 montre des écarts de taux de succès entre fournisseurs assez marqués pour qu'un RAG d'entreprise ne repose jamais sur un seul modèle : c'est la deuxième des 5 erreurs qui arrivent après le POC.
Un autre point capital est l'intégration d'outils complémentaires. Si votre besoin concerne uniquement la recherche interne, un RAG suffit. Mais généralement, vous voudrez également rechercher sur le Web, interroger des données en base de données, déclencher des actions, etc. L'intégration de ces outils décuple la puissance de votre IA.
Le RAG, c’est de l’ingénierie
Il y a clairement des best practices et des choix "génériques" qui marchent plutôt bien. Mais il n'y a pas de recette magique.
Chaque entreprise a des formats et des données spécifiques qui nécessitent des traitements particuliers pour obtenir de bonnes performances.
L'approche Ask This Guy (ATG) : le meilleur du RAG, sans les tracas
Chez Ask This Guy, nous avons passé des milliers d'heures à benchmarker, tester, casser puis améliorer des pipelines RAG. Notre solution RAG entreprise industrialise ces briques pour vos équipes.
Nous offrons :
- Conversion et découpage optimisés
Nombreux connecteurs, gestion des documents complexes, tableaux, slides, images, etc.
- Recherche hybride intelligente
Sémantique + mots-clés pour une précision maximale.
- Un agent orchestrateur, pas une simple recherche
L'assistant décide quelles sources interroger, relance ses recherches quand il lui manque un élément, et croise documents, bases de données et outils métier dans une même conversation.
- Personnalisation poussée
Nous adaptons les conversions à vos documents et pouvons développer des algorithmes spécifiques. Nous pouvons utiliser un modèle d'embeddings adapté à votre activité.
- Flexibilité totale
Vous gardez la main sur vos données. Et si vous souhaitez un jour internaliser la solution, vous récupérez vos développements spécifiques.
- Un seul RAG pour tous vos usages
Déployez la même intelligence sur plusieurs interfaces : console d'administration, chatbots sur votre site web, widget intégré dans votre produit SaaS, API pour vos outils internes, etc.
- Un logiciel qui combine plusieurs outils, pas seulement le RAG
- recherche dans vos drives
- recherche web
- intégration avec vos outils internes
- traitement documentaire avancé
L'objectif : une IA qui connaît votre entreprise aussi bien qu'un collaborateur expérimenté.
Questions fréquentes sur le RAG
Qu'est-ce que le RAG en IA ?
Le RAG (Retrieval Augmented Generation) est une approche qui connecte un modèle d'IA à vos propres sources. À chaque question, le système recherche les passages pertinents dans vos documents, vos bases ou vos outils, puis les transmet au modèle qui rédige une réponse appuyée sur ces éléments, avec ses sources.
Quelle différence entre un LLM et un RAG ?
Un LLM est le modèle de langage qui rédige la réponse. Le RAG est ce qui l'entoure : la chaîne qui va chercher la bonne information avant de le solliciter. Le RAG ne remplace pas le LLM et ne le modifie pas, il lui donne de quoi répondre juste.
Comment le RAG augmente-t-il un LLM ?
Le RAG n'augmente pas les capacités du modèle, il augmente ce qu'il a sous les yeux. À chaque question, la chaîne retrouve les passages pertinents dans vos sources et les insère dans le contexte du LLM avant l'appel. Le modèle rédige alors sa réponse à partir de ces extraits plutôt que de sa seule mémoire d'entraînement, et peut indiquer d'où vient chaque élément.
Quel LLM choisir pour un RAG ?
Privilégiez un modèle discipliné plutôt que le plus puissant : il doit s'en tenir aux extraits fournis, reconnaître qu'il ne sait pas quand l'information est absente, et savoir citer ses sources. Les autres critères sont la fenêtre de contexte, le coût par requête, la latence attendue, la qualité en français et la juridiction dans laquelle les requêtes sont traitées. Un modèle de milieu de gamme bien cadré bat souvent un modèle haut de gamme mal cadré.
Faut-il réentraîner le LLM sur ses documents ?
Non, dans la très grande majorité des cas. Un LLM utilisé dans une chaîne RAG lit vos documents à chaque requête sans les mémoriser, ce qui rend les mises à jour immédiates et évite d'exposer vos contenus dans les poids du modèle. Le fine-tuning reste utile pour imposer un style ou un format de sortie, pas pour transmettre de la connaissance.
Le RAG remplace-t-il le fine-tuning ?
Non, les deux répondent à des besoins différents. Le fine-tuning agit sur le style, le format et le vocabulaire. Le RAG apporte la connaissance, à jour et vérifiable. Pour répondre à partir de documents d'entreprise, c'est le RAG qu'il faut.
Combien de temps pour mettre en place un RAG en entreprise ?
Un prototype se monte en quelques jours. Un système fiable en production demande davantage, parce que l'essentiel du travail porte sur vos formats documentaires, les droits d'accès, l'évaluation de la qualité des réponses et le suivi des coûts. C'est précisément l'écart entre les deux qui fait échouer beaucoup de projets.
Peut-on héberger un RAG en Europe ou on-premise ?
Oui, et c'est un critère fréquent dans les organisations européennes. Attention toutefois à ne pas confondre hébergement local et souveraineté réelle : nous détaillons cette nuance dans notre article sur l'illusion du LLM local.
Conclusion : donnez une voix à vos données d'entreprise avec le RAG
Le RAG n'est pas qu’une technologie : c’est une stratégie d’intelligence documentaire.
Il transforme une IA générique en véritable expert interne, capable de :
- répondre précisément aux questions
- synthétiser des documents complexes
- fluidifier les processus
- aider à la prise de décision
Mais la barre a monté. Un RAG qui se contente d'une recherche unique dans un dossier de PDF ne suffit plus. Ce qui fait la différence aujourd'hui, c'est la capacité à analyser correctement vos documents, à enquêter sur plusieurs sources, et à justifier chaque réponse.
Si vous voulez une IA qui comprend vraiment votre entreprise, c'est de ce côté-là qu'il faut regarder. Et nous pouvons vous aider à le mettre en place.
Réservez une démo pour en discuter sur vos propres documents.