Qwen 4 27B vs Qwen 3.8 27B : que faut-il en attendre ?
Cet article fait le point sur ce qui est confirmé sur Qwen 4 27B, le futur modèle de Qwen, et sur ce que vaut Qwen 3.8 27B, un dense sur un GPU, face à Mistral.

« Qwen4 next week » : Qwen 4 sortirait la semaine suivante. C'est la phrase que la CTO d'Alibaba Cloud, Feifei Li, aurait prononcée le 29 octobre à Amsterdam, selon un participant. Douze jours plus tard, aucun modèle Qwen 4 n'est publié sur Hugging Face, et la seule déclaration écrite d'Alibaba reste son communiqué du 22 septembre : Qwen 4 est « en cours d'entraînement ». Tout indique pourtant une sortie imminente : le compte officiel de Qwen a publié un teaser le 6 novembre. Le modèle que l'on peut télécharger aujourd'hui s'appelle Qwen 3.8 27B, publié le 14 août sous licence Apache 2.0. Ses résultats sont exceptionnels pour sa taille : nous l'utilisons donc beaucoup chez Ask This Guy.
Pour situer, Qwen (pour Tongyi Qianwen) est la famille de modèles d'IA d'Alibaba, le géant chinois du commerce en ligne (Taobao, Tmall, AliExpress), qui est aussi le premier fournisseur de cloud haut de gamme en Chine. Lancé en avril 2023, Qwen publie depuis août 2023 l'essentiel de ses modèles en open weights : chacun peut les télécharger et les faire tourner sur ses propres machines. La gamme va de moins d'un milliard de paramètres à 2 400 milliards. Le « 27B » de Qwen 3.8 27B signifie 27 milliards de paramètres, les réglages internes dont le nombre donne une idée de la taille d'un modèle.
Qwen 3.8 27B est un modèle dense, alors que presque tous les grands modèles ouverts, ceux de Mistral compris, sont désormais des MoE. Il tient sur un seul GPU. Dans le classement d'Artificial Analysis du 10 novembre, il obtient 20 points, cinq fois plus que Gemma 4 31B ou gpt-oss-120b, et quatre fois plus que Mistral Medium 3.5, un dense de 128 milliards de paramètres.
Que faut-il attendre de Qwen 4 27B ? Sur ses performances, rien n'est publié. Sur sa forme, le nom donne un indice : chez Qwen, les noms des modèles MoE incluent deux nombres (« 35B-A3B »), les denses un seul. Un « Qwen4-27B » serait donc dense, si Alibaba garde sa convention. Mais l'aperçu de l'architecture de Qwen 4, publié en août, ajoute des tables d'embeddings de 51 milliards de paramètres qui ne figurent pas dans son nom : la mémoire réelle d'un futur « 27B » pourrait dépasser ce que son nom laisse attendre. Deux autres signaux invitent à la prudence. Cet aperçu est publié sous une licence maison, pas sous Apache 2.0 : sous ce régime, Qwen 4 27B pourrait exiger un contrat pour certains usages commerciaux, comme le revendre en service. Et la génération 3.7 n'a jamais eu de version ouverte : rien n'oblige Alibaba à publier un Qwen 4 27B téléchargeable.
Qwen 4 27B : qu'est-ce qui est confirmé ?
Peu de chose. Le nom « Qwen4-27B » circule depuis la conférence Apsara d'Alibaba, mais il vient de diapositives et de comptes rendus de keynote, pas du communiqué officiel, qui ne cite aucun modèle de 27 milliards de paramètres. L'état des informations au 10 novembre 2026 :
| Information | Statut |
|---|---|
| Qwen 4 est en cours d'entraînement | Confirmé par Alibaba le 22 septembre, avec une feuille de route vers Qwen 4.5 et Qwen 5 |
| Une gamme Max, Plus, Flash et 27B | Noms vus en keynote, absents du communiqué |
| « Qwen4 next week » | Phrase attribuée à la CTO le 29 octobre par un seul participant, non confirmée ; la semaine est passée sans sortie |
| Teaser « The becoming begins » | Publié le 6 novembre par le compte officiel de Qwen, sans nom de modèle, ni date, ni taille |
| Poids sur Hugging Face | Aucun dépôt Qwen 4 dans l'organisation Qwen |
| Licence, taille réelle, architecture | Inconnues |
Le précédent donne une idée du calendrier. Qwen 3.8 Max est sorti le 3 août, et Qwen 3.8 27B a suivi une dizaine de jours plus tard. Si Alibaba répète ce schéma, le 27B arrivera après le modèle phare de Qwen 4, qui n'est pas encore là. Sur Manifold, un marché de prédiction en monnaie fictive, les parieurs donnaient 61 % de chances à des poids Qwen 4 sur Hugging Face d'ici le 25 novembre, le 10 novembre. Un pari ne vaut pas une annonce.
La famille Qwen 27B : trois versions en six mois
Qwen 27B est le modèle de taille moyenne de la famille Qwen d'Alibaba : un modèle de langage dense de 27 milliards de paramètres, multimodal (texte, image, vidéo), publié en open weights sous licence Apache 2.0. Il a connu trois versions en 2026, toutes construites sur la même architecture :
| Version | Publication | Licence | Téléchargements cumulés sur Hugging Face au 10/11 |
|---|---|---|---|
| Qwen 3.5 27B | février 2026 | Apache 2.0 | 22,4 millions |
| Qwen 3.6 27B | 22 avril 2026 | Apache 2.0 | 30,9 millions |
| Qwen 3.8 27B | 14 août 2026 | Apache 2.0 | 22,0 millions, dont 7,5 millions sur 30 jours |
Il n'y a pas eu de Qwen 3.7 27B. La génération 3.7, Qwen 3.7 Max en mai puis Qwen 3.7 Plus le 1er juin, n'est sortie qu'en API, sans poids publiés : aucun dépôt Qwen 3.7 n'existe sur Hugging Face. Des sites de suivi attendaient des versions ouvertes de 27B et 35B, qui ne sont jamais venues. Le 27B ouvert est passé directement de la version 3.6 à la 3.8. Le précédent modèle dense de cette taille chez Qwen était Qwen 3 32B, sorti en avril 2025, avec une architecture classique.
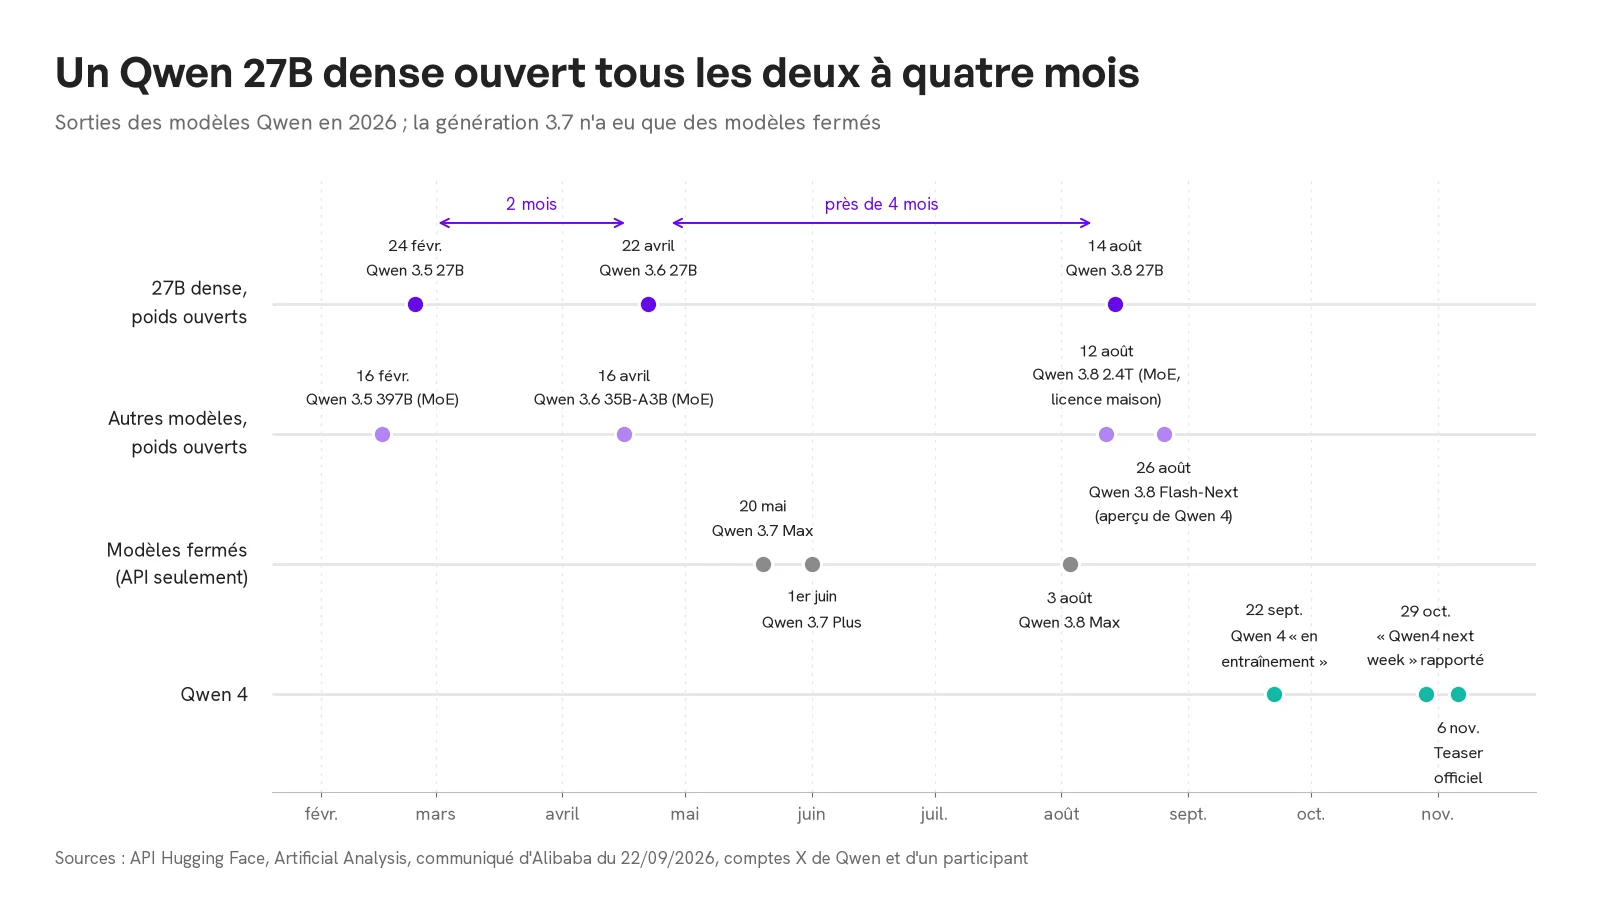 Frise des sorties Qwen en 2026, sur quatre lignes. 27B dense à poids ouverts : Qwen 3.5 27B le 24 février, Qwen 3.6 27B le 22 avril (deux mois plus tard), Qwen 3.8 27B le 14 août (près de quatre mois plus tard). Autres modèles ouverts : Qwen 3.5 397B le 16 février, Qwen 3.6 35B-A3B le 16 avril, Qwen 3.8 2.4T sous licence maison le 12 août, Qwen 3.8 Flash-Next, aperçu de Qwen 4, le 26 août. Modèles fermés : Qwen 3.7 Max le 20 mai, Qwen 3.7 Plus le 1er juin, Qwen 3.8 Max le 3 août. Qwen 4 : annoncé en entraînement le 22 septembre, « Qwen4 next week » rapporté le 29 octobre, teaser officiel le 6 novembre
Dates : Hugging Face, Artificial Analysis et Alibaba.
Depuis Qwen 3.5, ces modèles sont hybrides : sur les 64 couches du réseau, trois sur quatre utilisent une attention dite linéaire (Gated DeltaNet), plus économe en mémoire, et une sur quatre une attention complète. La carte de Qwen 3.8 27B annonce un contexte de 262 144 tokens, extensible à un million, et un mode de réflexion réglable en quatre niveaux, de désactivé à xhigh. Qwen le présente comme un « compact, deployment-friendly dense model », un modèle dense compact et facile à déployer.
Ce que Qwen annonce
D'une version à l'autre, Qwen ne change pas l'architecture mais l'entraînement, et les gains annoncés sont importants. Une sélection des scores publiés par Qwen :
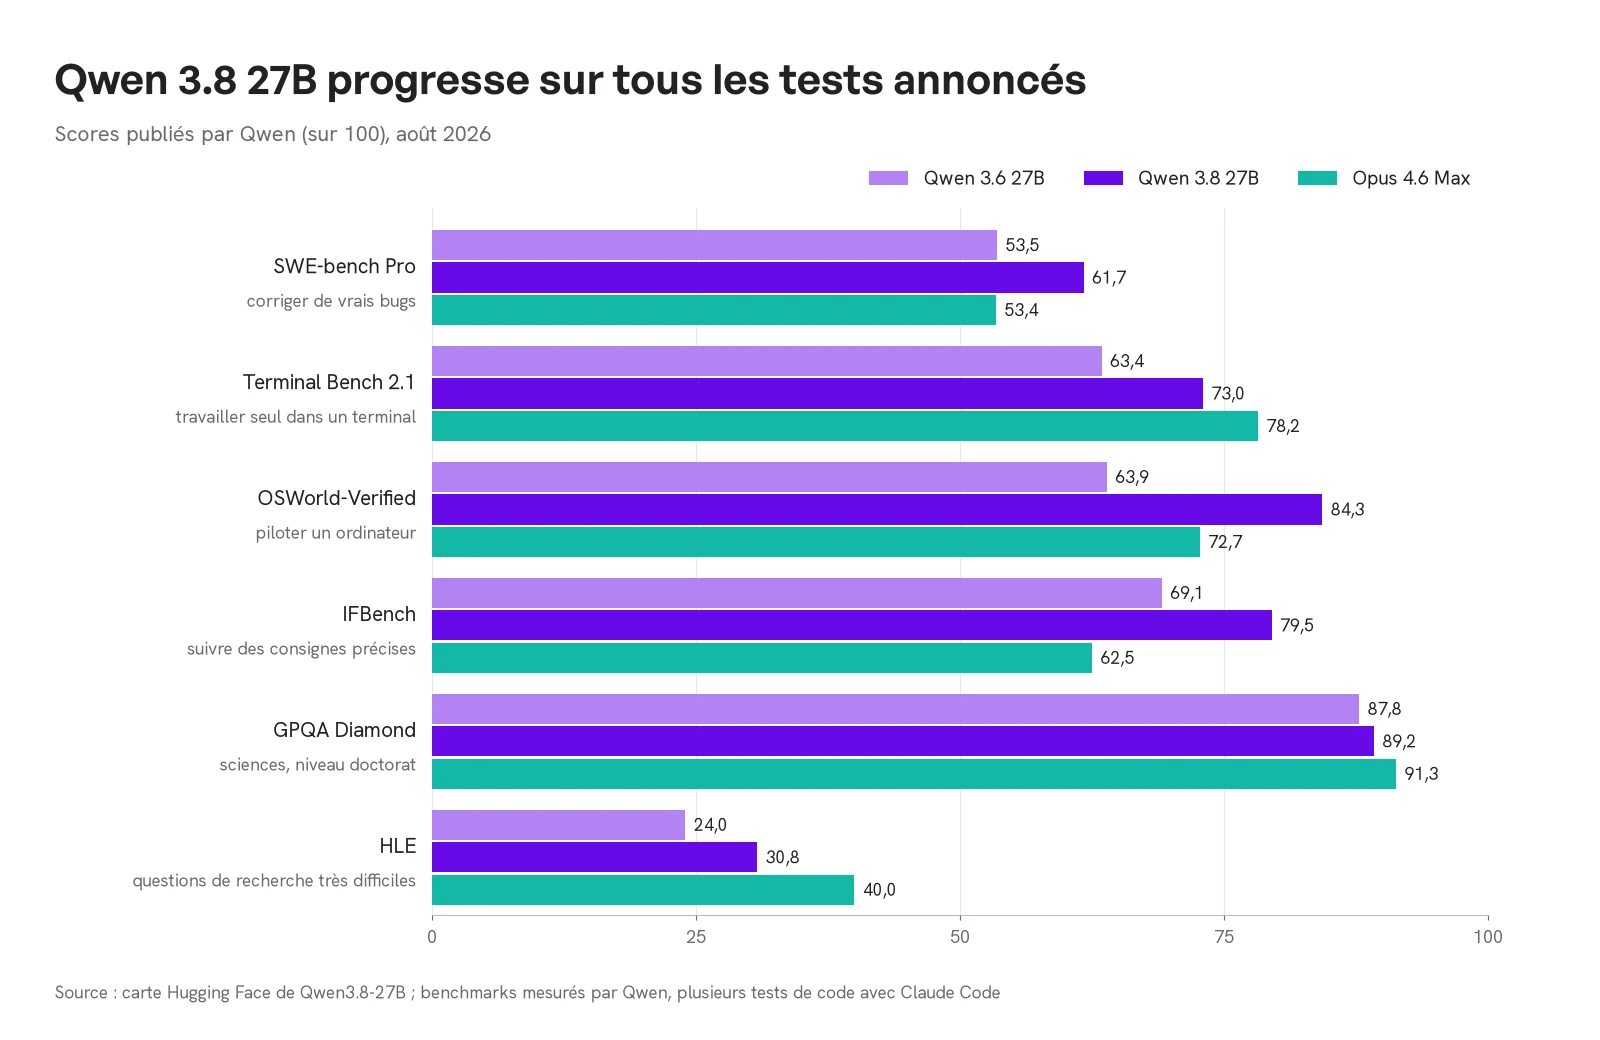 Graphique en barres des scores publiés par Qwen, sur 100, pour Qwen 3.6 27B, Qwen 3.8 27B et Opus 4.6 Max : SWE-bench Pro 53,5, 61,7 et 53,4 ; Terminal Bench 2.1 63,4, 73,0 et 78,2 ; OSWorld-Verified 63,9, 84,3 et 72,7 ; IFBench 69,1, 79,5 et 62,5 ; GPQA Diamond 87,8, 89,2 et 91,3 ; HLE 24,0, 30,8 et 40,0
Ce sont des chiffres de l'éditeur, mesurés avec ses propres réglages, et plusieurs benchmarks de code ont été passés avec Claude Code comme environnement. Les titres « Qwen 3.8 27B bat Opus » qui circulent sur YouTube exagèrent : il le dépasse sur SWE-bench Pro dans ce tableau, pas sur Terminal Bench ni sur HLE.
Le chiffre le plus intéressant se trouve dans le tableau précédent, celui de Qwen 3.6 27B. Qwen y compare son modèle dense à son propre MoE de la génération d'avant, Qwen 3.5 397B, quinze fois plus lourd. Sur SWE-bench Verified, le dense obtient 77,2 contre 76,2 ; sur Terminal-Bench 2.0, 59,3 contre 52,5. Sur le code agentique, un 27B dense égalait un MoE de 397 milliards de paramètres. Le gros modèle garde l'avantage sur les connaissances (MMLU-Pro, GPQA, HLE), ce qui est logique : la connaissance se stocke dans les paramètres, et il en a quinze fois plus.
Ce que mesurent les autres
Artificial Analysis fait passer à chaque modèle la même batterie de tests. Dans la version 4.3.2 de son indice, relevée le 21 octobre, Qwen 3.8 27B obtenait 34 points, contre 21 pour Qwen 3.6 27B, 18 pour Qwen 3.5 397B, 15 pour Gemma 4 31B de Google et 12 pour gpt-oss-120b d'OpenAI. Le site est depuis passé à une version 5.0.1, notée sur une échelle plus sévère : Qwen 3.8 27B y vaut 20 points, quand la médiane des modèles comparables est à 8. Dans le classement du 10 novembre, c'est cinq fois la note de Gemma 4 31B ou de gpt-oss-120b, à environ 4 points chacun.
La même page montre le revers. Pour passer l'indice, Qwen 3.8 27B a produit 128 millions de tokens, contre 77,7 millions en médiane, et a mis 39,9 minutes par tâche contre 13,9. Le modèle réfléchit longuement avant de répondre. À 46 tokens par seconde chez Alibaba, cela se paie en temps d'attente, et en euros quand on est facturé au token produit.
Ce que nous en voyons chez ATG
Chez ATG, Qwen 3.8 27B est le modèle qui rédige les réponses aux messages des utilisateurs. C'est celui qui est utilisé, par exemple, pour notre benchmark FinanceBench, où notre agent de recherche répond juste à 92 % des questions d'analystes posées sur 368 rapports financiers. En le remplaçant par Gemini 3.8 Flash, nous n'avons vu aucune différence significative de score, pas plus qu'en augmentant son budget de réflexion. Dans un RAG, c'est d'abord la recherche qui fait le résultat. Un modèle de 27 milliards de paramètres bien outillé suffit pour lire des documents et en tirer une réponse sourcée.
Nous avons aussi vu ses limites. Poussé à une température de 1,5 (un réglage qui rend les réponses plus aléatoires), il ne donne plus de réponse valide dans 15 à 27 % des cas : sa réflexion s'emballe et dépasse la longueur maximale. Aux réglages recommandés par Qwen, nous n'avons pas observé ce problème.
Qwen 27B face à Mistral : la référence française
Pour une entreprise française, la référence open weights reste Mistral. La comparaison est utile, à condition de mettre les modèles à la bonne place, car les deux gammes ne couvrent pas les mêmes étages.
| Modèle | Architecture | Paramètres (total / actifs) | Licence | Indice Artificial Analysis v5.0.1 | Téléchargements cumulés |
|---|---|---|---|---|---|
| Qwen 3.8 27B | dense hybride | 27B | Apache 2.0 | 20 | 22,0 millions |
| Mistral Small 3.2 (juin 2025) | dense | 24B | Apache 2.0 | non mesuré | 5,6 millions |
| Mistral Small 4 (mars 2026) | MoE | 119B / 6,5B | Apache 2.0 | 4 | 0,7 million |
| Mistral Medium 3.5 (avril 2026) | dense | 128B | MIT modifiée, avec plafond de chiffre d'affaires | 5 | 1,1 million |
| Mistral Large 3 (décembre 2025) | MoE | 675B / 41B | Apache 2.0 | non mesuré | 17 500 |
| Mistral Large 4 (octobre 2026) | MoE | environ 1 000B / 52B | Mistral Ecosystem Open-Weight License | 26 | 12 000 |
| Qwen 3.8 2.4T-A95B (août 2026) | MoE | 2 400B / 95B | Qwen3.8-Max License | non noté (version API, Qwen 3.8 Max : 34) | 117 500 |
Les téléchargements viennent de l'API de Hugging Face au 10 novembre 2026.
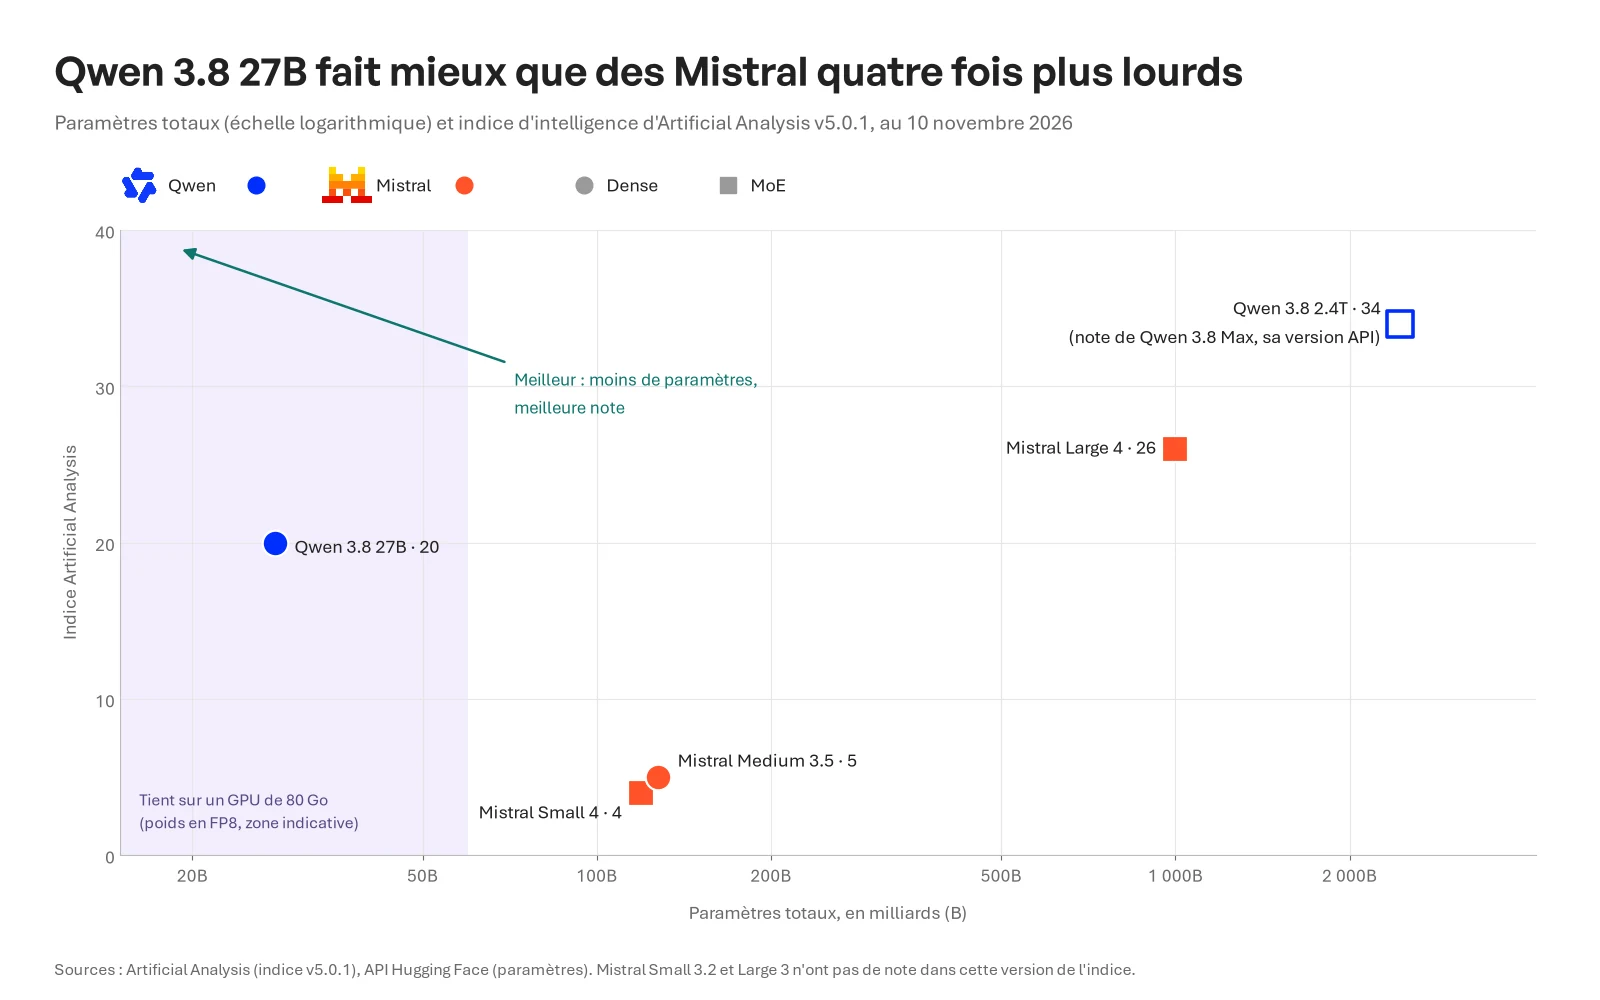 Nuage de points, paramètres totaux en échelle logarithmique et indice d'Artificial Analysis v5.0.1. Qwen 3.8 27B, dense, 27 milliards de paramètres, note 20, seul modèle dans la zone qui tient sur un GPU de 80 Go. Mistral Small 4, MoE de 119 milliards, note 4. Mistral Medium 3.5, dense de 128 milliards, note 5. Mistral Large 4, MoE d'environ 1 000 milliards, note 26. Qwen 3.8 2.4T, MoE de 2 400 milliards, placé à 34, la note de sa version API Qwen 3.8 Max. Une flèche indique que le meilleur est en haut à gauche : moins de paramètres, meilleure note
Au palier d'un seul GPU, Mistral n'a pas de réponse récente. Ses derniers modèles généralistes de moins de 30 milliards de paramètres, Ministral 3 et Devstral Small 2 pour le code, datent de fin 2025. Mistral Small 3.2, le dense de 24 milliards de paramètres téléchargé 5,6 millions de fois, date de juin 2025. En 2026, Mistral a publié de gros modèles et des modèles spécialisés (voix, séries temporelles, preuves mathématiques), pas de successeur à Small 3.2. La lignée Qwen 27B a eu trois versions dans le même temps.
Mistral Medium 3.5 est l'autre dense de la gamme, mais il pèse 128 milliards de paramètres, et ses exemples de déploiement utilisent huit GPU. Mistral annonce 77,6 sur SWE-bench Verified, au niveau des 77,2 annoncés par Qwen pour son 27B, avec des protocoles qui ne sont pas forcément comparables. Surtout, sa licence exclut les entreprises dont le chiffre d'affaires mensuel consolidé dépasse 20 millions de dollars : au-delà, il faut demander une licence commerciale à Mistral, qui l'accorde « at its sole discretion », ou passer par ses services hébergés. Une grande ETI ou un groupe français ne peut pas déployer Medium 3.5 chez lui sans contrat.
Mistral Small 4, lui, est un MoE de 119 milliards de paramètres, dont 6,5 actifs, sous licence Apache 2.0, et l'exemple de déploiement donné par Mistral utilise deux GPU. Il est rapide (145 tokens par seconde chez Mistral selon Artificial Analysis) et économe : Mistral affirme sur sa carte que les modèles Qwen ont besoin de trois à quatre fois plus de texte en sortie pour des résultats comparables, ce que confirme la verbosité de Qwen 3.8 27B mesurée plus haut. Sur l'indice, il reste loin derrière.
En haut de gamme, c'est l'inverse. Mistral Large 4, sorti fin octobre, obtient 26 points sur l'indice d'Artificial Analysis, au-dessus des 20 de Qwen 3.8 27B, et Mistral le présente comme le meilleur modèle ouvert occidental de cet indice. Mais il compte environ mille milliards de paramètres, ses exemples de déploiement utilisent huit GPU, et sa licence impose un contrat à qui veut le revendre comme service d'inférence : un autre projet, avec un autre budget.
Alibaba a aussi son équivalent, plus gros encore : Qwen 3.8 2.4T-A95B, la version à poids ouverts de son modèle phare, compte 2 400 milliards de paramètres, dont 95 milliards actifs, et pèse 4,9 To sur Hugging Face. Artificial Analysis ne le note pas, faute d'API publique pour cette version, mais Qwen 3.8 Max, la version commerciale construite dessus, obtient 34 points, au-dessus des 26 de Mistral Large 4. Sa licence n'est pas l'Apache 2.0 du 27B : la « Qwen3.8-Max License » impose d'afficher le nom du modèle au-delà de 100 millions d'utilisateurs mensuels ou de 20 millions de dollars de chiffre d'affaires mensuel, et un contrat pour le revendre en service au-delà de 50 millions de dollars de chiffre d'affaires. Chez Qwen comme chez Mistral, le très grand modèle ouvert vient avec une licence maison. Plus proche de Mistral Large 3 par la taille, Qwen 3.5 397B reste en Apache 2.0, mais n'a pas de note dans la version actuelle de l'indice.
Notre avis : entre Qwen et Mistral, nous trancherions d'après le budget GPU et la licence. Pour un modèle qui tient sur une carte, Qwen 3.8 27B n'a pas d'équivalent récent chez Mistral. Pour la meilleure qualité ouverte, Mistral Large 4 et Qwen 3.8 2.4T demandent tous deux un serveur de plusieurs GPU et une licence maison ; Mistral a l'avantage d'être un éditeur européen. La question de la souveraineté, elle, se règle ailleurs, nous y revenons plus bas.
Dense ou MoE : pourquoi un 27B dense alors que tout le monde passe au MoE ?
Un modèle dense fait travailler tous ses paramètres pour chaque token qu'il produit. Un MoE (mixture of experts, ou mélange d'experts) est découpé en sous-réseaux, les experts, et un routeur n'en active que quelques-uns pour chaque token. Notre guide du mixture of experts explique la différence pas à pas. On note leur taille en deux chiffres : Qwen 3.6 35B-A3B compte 35 milliards de paramètres, dont 3 milliards actifs à chaque token.
Le MoE est devenu la norme des grands modèles ouverts. Le modèle phare d'Alibaba, Qwen 3.8 Max, compte 2 400 milliards de paramètres dont 95 milliards actifs. Mistral Small 4 et Large 4, DeepSeek V4 et gpt-oss sont aussi des MoE. Les denses récents se comptent : Qwen 27B, Gemma 4 31B de Google, Mistral Medium 3.5.
Un MoE doit tout garder en mémoire
Un MoE calcule peu, mais il doit garder tous ses experts chargés, car le routeur peut en appeler n'importe lequel au token suivant. Comme le résume Hugging Face, « all parameters need to be loaded in RAM, so memory requirements are high » : tous les paramètres doivent être en mémoire. Pour la taille des poids publiés en BF16, le format de référence, l'API de Hugging Face donne :
| Modèle | Architecture | Poids en BF16 |
|---|---|---|
| Qwen 3.8 27B | dense, 27B | 55,6 Go (30,9 Go en FP8) |
| Qwen 3.6 35B-A3B | MoE, 3B actifs | 71,9 Go |
| Qwen 3.5 397B-A17B | MoE, 17B actifs | 806,8 Go |
En FP8, Qwen 3.8 27B tient dans un GPU de 80 Go avec de la place pour les conversations. En 4 bits, il pèse environ 17 à 18 Go selon Runpod, ce qui le fait entrer dans une carte de 24 Go comme une RTX 4090. À qualité de code comparable, il demande quinze fois moins de mémoire que le MoE de 397 milliards de paramètres.
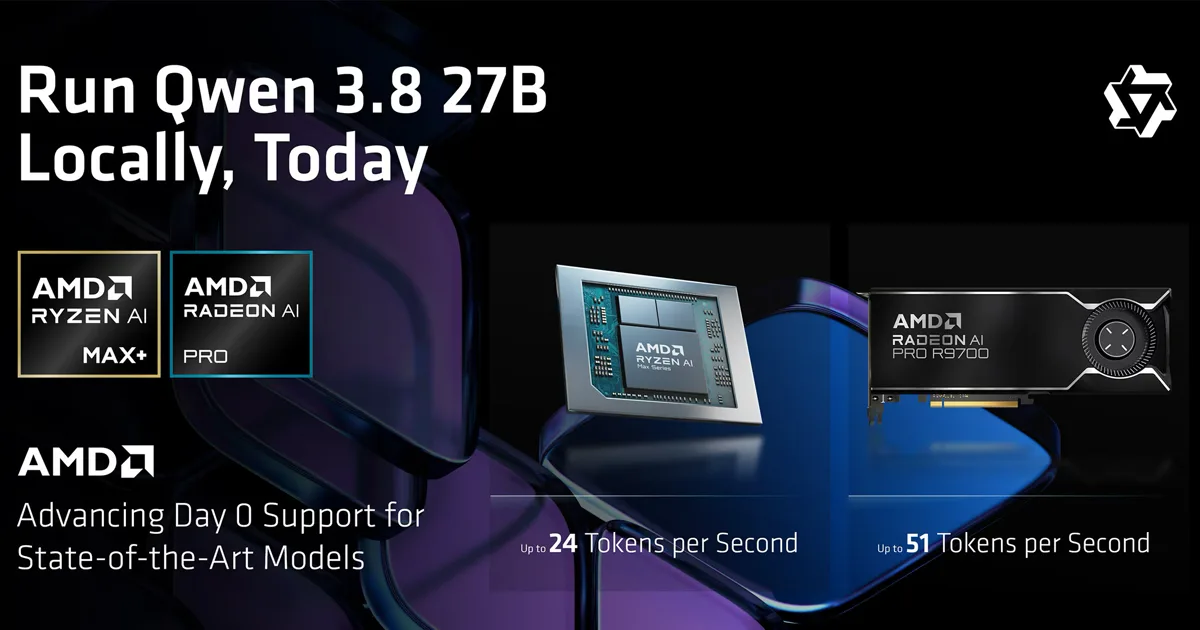
AMD l'a mesuré dès le jour de sa sortie sur deux machines de bureau : jusqu'à 24,5 tokens par seconde sur un mini-PC équipé d'un processeur Ryzen AI Max+ 395 et de 128 Go de mémoire, et jusqu'à 51,8 sur une seule carte Radeon AI PRO R9700 de 32 Go, avec llama.cpp et le décodage spéculatif activé. Ce sont des chiffres préliminaires, mesurés par le constructeur pour un seul utilisateur. AMD le rappelle lui-même : modèle dense, Qwen 3.8 27B « places substantial demands on memory capacity and compute », et il lui faut environ 24 Go de mémoire graphique pour tourner confortablement. Un poste de travail suffit pour un développeur ou un pilote, pas pour servir toute une entreprise. Le visuel en tête de cet article vient de ce billet d'AMD.
Le MoE va plus vite, le dense répond mieux
La contrepartie est la vitesse. Pour chaque token, un MoE ne lit que ses paramètres actifs, alors qu'un dense les lit tous. Sur une même carte graphique grand public, un développeur a mesuré 31 tokens par seconde pour Qwen 3.6 27B et 98 pour Qwen 3.6 35B-A3B, avec des quantifications un peu différentes. Chez Alibaba, Artificial Analysis mesure 55 tokens par seconde pour le dense et 107 pour le MoE.
Le même développeur note que le dense « scores higher on every coding benchmark ». Les chiffres de Qwen vont dans ce sens : 77,2 sur SWE-bench Verified pour le 27B dense, 73,4 pour le 35B-A3B. Le MoE répond deux à trois fois plus vite, le dense répond mieux. Pour un assistant de code qu'un développeur utilise toute la journée, la vitesse peut l'emporter. Pour un agent qui enchaîne des étapes sans humain qui attend, la justesse compte davantage.
Un KV cache quatre fois plus petit
Le KV cache est la mémoire de travail d'un modèle pour chaque conversation : il garde une trace de chaque token déjà lu, et grossit avec la longueur du contexte et le nombre d'utilisateurs simultanés. Sur un serveur partagé, c'est souvent lui, plus que les poids, qui limite le nombre d'utilisateurs.
L'architecture hybride de Qwen 27B réduit nettement ce poste : seules 16 de ses 64 couches gardent un KV cache, les 48 autres se contentent d'un petit état de taille fixe. D'après les fichiers de configuration publiés de Qwen 3.8 27B et de Qwen 3 32B, notre calcul donne 64 Kio par token pour Qwen 3.8 27B, contre 256 Kio pour Qwen 3 32B, un dense classique de taille voisine. Une conversation de 32 000 tokens, courante dans un RAG, occupe 2,1 Go au lieu de 8,4 Go. Runpod arrive à la même conclusion : chaque conversation coûte « roughly a quarter » de ce qu'elle coûterait sur un 27B classique.
En pratique, sur un seul H100 de 80 Go, avec les poids en FP8 et une marge de sécurité, notre calcul donne environ 18 conversations de 32 000 tokens en parallèle, et environ 35 avec un KV cache en FP8. Pour dimensionner un serveur au-delà de cet exemple, notre article sur les LLM on premise détaille la méthode.
Plus simple à adapter
Un dense est aussi plus simple à personnaliser. Hugging Face note que les MoE ont longtemps eu du mal à se généraliser après un fine-tuning, avec un risque de surapprentissage. Un dense de 27 milliards de paramètres s'adapte avec un adaptateur LoRA sur une seule carte. Au 10 novembre, Hugging Face recense 862 versions affinées de Qwen 3.8 27B et plus de 1 000 versions quantifiées, contre 442 versions affinées pour le MoE Qwen 3.6 35B-A3B. Nous Research a publié le 7 novembre Arete-27B, un réentraînement de Qwen 3.8 27B.
Quand préférer un MoE
Le MoE reste le bon choix dans trois cas : quand la vitesse ressentie par chaque utilisateur prime, quand la tâche demande beaucoup de connaissances générales, et quand on vise la meilleure qualité ouverte, qui n'existe aujourd'hui qu'en MoE de plusieurs centaines de milliards de paramètres. Un dense de 27 milliards de paramètres a aussi ses limites : il sait moins de choses, et il raisonne longuement pour compenser, ce qui consomme des tokens.
Que faut-il attendre de Qwen 4 27B ?
Un modèle plus capable, si l'on se fie au rythme de la lignée, mais personne ne connaît encore sa forme. Premier signal, la génération 3.7 : Alibaba a montré qu'il pouvait sortir une version entière de Qwen sans modèle ouvert. Second signal : Qwen 3.8 Flash-Next, publié fin août et présenté par Qwen comme un « experimental preview of the architecture that will underpin Qwen4 », un aperçu de l'architecture de Qwen 4. C'est un MoE de 125 milliards de paramètres, dont 6 milliards actifs, auxquels s'ajoutent 51 milliards de paramètres d'« n-gram embedding », des tables de correspondance qui ne comptent pas dans la taille annoncée. Sa licence s'appelle « qwen-community-1.0 » : ce n'est pas l'Apache 2.0 de la lignée 27B.
Que l'aperçu soit un MoE ne dit presque rien du 27B : chez Qwen, les grands modèles sont des MoE depuis Qwen 3, pendant que le 27B reste dense. Le nom compte davantage. Le nom des MoE de Qwen inclut deux nombres (« 35B-A3B » : 35 milliards de paramètres, dont 3 milliards actifs), celui des denses un seul. Un modèle publié sous le nom « Qwen4-27B » serait donc dense, si la convention tient ; ce nom vient toutefois de diapositives, pas d'un communiqué. Le vrai inconnu est la mémoire : si Qwen 4 reprend ces tables d'embeddings, un « 27B » pourrait peser plus lourd que son nom ne l'indique. Reste la licence, qui pourrait être plus restrictive que l'Apache 2.0. Le jour de sa sortie, quatre points à vérifier avant de basculer :
- La licence : Apache 2.0 ou licence maison, avec ses éventuelles restrictions d'usage commercial.
- L'architecture : dense ou MoE, nombre de paramètres totaux et actifs.
- La mémoire : taille des poids en FP8 et en 4 bits, et KV cache par token, calculable depuis le fichier de configuration.
- Les mesures indépendantes : l'indice d'Artificial Analysis ou vos propres tests ; les benchmarks de l'éditeur ne suffisent pas.
Nous mettrons cet article à jour à la sortie de Qwen 4 27B, avec la comparaison chiffrée.
Un modèle chinois peut-il être souverain ?
Un modèle à poids ouverts ne « téléphone » pas à son éditeur : une fois les poids téléchargés, ce sont des fichiers qui tournent sur des serveurs que vous choisissez. Hébergé en France par un opérateur européen, Qwen 3.8 27B n'envoie rien à Alibaba. OVHcloud le sert depuis le 24 août, en FP8, dans un datacenter français, à 0,40 € par million de tokens en entrée et 2,70 € en sortie. Scaleway le propose à 0,60 € et 3,30 € (tarifs relevés le 21 octobre).
La souveraineté dépend de l'hébergeur et de l'opérateur du calcul ; la nationalité des poids n'y change rien. Deux questions restent ouvertes, et elles se posent aussi pour les modèles américains : les biais hérités de l'entraînement, à tester sur vos propres cas d'usage, et la dépendance à un éditeur pour les versions suivantes, que la licence encore inconnue de Qwen 4 illustre bien. L'argument propre à Mistral est là : un éditeur européen, avec qui l'on peut contracter en droit européen. Notre page sur l'IA souveraine et notre article sur les licences open weights détaillent ces critères.
Ce qu'une DSI peut en retenir
Si un modèle qui tient sur un seul GPU suffit à votre cas d'usage, commencez avec Qwen 3.8 27B, soit par l'API d'OVHcloud ou de Scaleway, soit sur votre propre carte. Attendre Qwen 4 n'a de sens que pour un projet qui ne démarre pas avant plusieurs semaines.
Préparez le changement de modèle dès le départ. OVHcloud et Scaleway exposent une API compatible avec celle d'OpenAI : le nom du modèle doit se trouver dans la configuration, où l'on peut le changer sans toucher au code. Constituez un jeu de 100 à 300 questions réelles avec leurs réponses attendues, comme nous le décrivons dans notre grille d'audit RAG. Le jour où Qwen 4 27B sort, vous le mesurez sur vos questions en une demi-journée, et vous basculez si le gain est réel.
Réglez l'effort de réflexion selon la tâche. Qwen 3.8 27B réfléchit au niveau maximal par défaut ; pour classer un courriel ou extraire un champ, le niveau low ou la réflexion désactivée suffisent, et le modèle produit moins de tokens. Et pour les tâches qu'un algorithme sait faire (calcul, tri, règle métier), n'utilisez pas d'IA du tout : c'est plus fiable, moins cher et plus sobre.
Questions fréquentes sur Qwen 4 et Qwen 3.8 27B
Quand sort Qwen 4 27B ?
Aucune date n'est officielle au 10 novembre 2026. Alibaba a seulement écrit, le 22 septembre, que Qwen 4 était en cours d'entraînement. Une phrase attribuée à sa CTO annonçait une sortie début novembre, sans suite. Pour Qwen 3.8, le modèle de 27 milliards de paramètres était arrivé une dizaine de jours après le modèle phare.
Qwen 3.8 27B est-il open source ?
Qwen 3.8 27B est un modèle open weights : ses poids sont téléchargeables librement sous licence Apache 2.0, qui autorise l'usage commercial, la modification et la redistribution. Ses données et son code d'entraînement ne sont pas publiés, ce qui le distingue d'un logiciel open source au sens strict.
Quel GPU faut-il pour faire tourner Qwen 3.8 27B ?
En 4 bits, Qwen 3.8 27B pèse environ 17 à 18 Go selon Runpod et tient sur une carte de 24 Go comme une RTX 4090, pour un utilisateur. AMD annonce jusqu'à 51,8 tokens par seconde sur une carte Radeon AI PRO R9700 de 32 Go. En FP8, ses poids pèsent 30,9 Go : un H100 de 80 Go sert alors environ 18 conversations de 32 000 tokens en parallèle. En BF16, il faut 55,6 Go pour les seuls poids.
Qwen 3.8 27B ou Mistral : lequel choisir ?
Cela dépend de l'infrastructure. Pour un modèle qui tient sur un seul GPU, Qwen 3.8 27B n'a pas d'équivalent récent chez Mistral, dont le dense de 24 milliards de paramètres, Mistral Small 3.2, date de juin 2025. Pour la meilleure qualité ouverte avec un éditeur européen, Mistral Large 4 dépasse Qwen 3.8 27B sur l'indice d'Artificial Analysis, mais se déploie sur huit GPU dans les exemples de Mistral et exige une licence commerciale pour être revendu comme service.
Pourquoi n'y a-t-il pas de Qwen 3.7 27B ?
La génération Qwen 3.7 n'est sortie qu'en API : Qwen 3.7 Max en mai 2026 et Qwen 3.7 Plus le 1er juin 2026, sans poids publiés sur Hugging Face. Les versions ouvertes de 27B et de 35B attendues par la communauté ne sont jamais arrivées. Le modèle ouvert de 27 milliards de paramètres est passé de Qwen 3.6 27B, en avril, à Qwen 3.8 27B, en août.
Qwen 3.8 27B est-il meilleur que Qwen 3.6 27B ?
Oui, selon Qwen comme selon Artificial Analysis. Avec la même architecture, Qwen 3.8 27B passe de 53,5 à 61,7 sur SWE-bench Pro et de 63,9 à 84,3 sur OSWorld-Verified d'après l'éditeur, et de 21 à 34 points sur la version 4.3.2 de l'indice d'Artificial Analysis. Il est aussi plus bavard : prévoir davantage de tokens de réflexion.
En février 2026, il fallait un MoE de 397 milliards de paramètres pour obtenir ce qu'un modèle de 27 milliards faisait en avril sur le code. Si ce rythme tient, le modèle qui suffira à la plupart des usages d'entreprise tiendra bientôt sur une carte graphique de poste de travail. L'avantage ira aux équipes capables de changer de modèle en une journée : chaque nouvelle version leur profite sans chantier, pendant que les autres restent sur celle qu'elles ont installée.