Serveur IA local : quel matériel pour un LLM en entreprise ?
Serveur IA local : poste de travail, carte RTX PRO 6000 ou H200, ce que chaque palier sert avec Qwen 3.8 27B, débits mesurés et prix relevés en novembre 2026.

Un serveur IA local est une machine de l'entreprise qui fait tourner un modèle de langage (un LLM local) sans envoyer les données à une API extérieure. Le modèle de référence de cet article, Qwen 3.8 27B, tient sur une carte graphique de 24 Go et y génère 40 à 75 tokens par seconde pour un utilisateur. Sur un GPU de serveur H100, avec 50 requêtes simultanées, chaque utilisateur reçoit 35 tokens par seconde avec SGLang, et moins d'un avec Ollama.
Autrement dit, c'est le nombre de requêtes simultanées qui détermine le matériel à acheter, et donc le budget, avec la longueur des documents envoyés. Le même modèle tourne sur une carte à 2 333 € HT et sur un H200 NVL à 32 533 € HT ; seul le second sert une entreprise entière.
Nous avons rassemblé les mesures publiées pour trois paliers (un poste de travail, un serveur à une carte, un H100 ou un H200), avec les prix relevés le 16 novembre 2026, et pour deux usages qui n'attendent pas la même chose d'un LLM local : le développement, où la référence est Claude Code, et le chatbot ou l'agent métier, où la référence est la vitesse d'un assistant de chat. La question de savoir s'il faut héberger soi-même, avec le coût complet et le seuil de rentabilité face à une API, est traitée dans notre article sur les LLM on premise.
Pourquoi prendre Qwen 3.8 27B comme référence ?
Parce que c'est, à notre connaissance, le modèle ouvert le mieux noté qui tienne sur une seule carte. Qwen 3.8 27B est un modèle dense de 27 milliards de paramètres, publié par Alibaba sous licence Apache 2.0. Sur l'indice d'Artificial Analysis, il obtient environ cinq fois la note de gpt-oss-120b, un modèle quatre fois plus gros : notre article Qwen 4 27B vs Qwen 3.8 27B détaille ses performances et son architecture. Chez ATG, c'est le modèle qui rédige les réponses aux messages et qui sert à notre benchmark FinanceBench.
Pourquoi un modèle dense plutôt qu'un MoE, ces modèles « mixture of experts » qui n'activent qu'une partie de leurs paramètres à chaque token ? Le MoE va plus vite : sur une même carte grand public, un développeur a mesuré 31 tokens par seconde pour le dense Qwen 3.6 27B et 98 pour le MoE Qwen 3.6 35B-A3B. Mais un MoE doit garder tous ses experts en mémoire, puisque n'importe lequel peut servir au token suivant : ce MoE pèse 71,9 Go en BF16, contre 55,6 pour le dense. Et le dense répond mieux, 77,2 contre 73,4 sur SWE-bench Verified selon Qwen. Sur un serveur à une carte, la mémoire et la qualité comptent plus que la vitesse d'un utilisateur seul : notre guide du mixture of experts détaille la différence.
Cela change le calcul du matériel. Dans notre article sur l'on premise, un modèle d'environ 100 milliards de paramètres restait le minimum dès que la tâche se complique, avec deux GPU de serveur à la clé. Un modèle de 27 milliards qui le dépasse ramène la question à une seule carte. Ses poids pèsent 55,6 Go en BF16 et 30,9 Go en FP8, et environ 17 Go en 4 bits (la version Q4_K_S pèse 16,68 Gio).
Qwen 4 27B, annoncé par Alibaba, n'est pas publié : au 16 novembre, l'organisation Qwen sur Hugging Face ne compte aucun dépôt Qwen 4. Le matériel choisi pour Qwen 3.8 27B le fera probablement tourner s'il garde sa taille, mais sa mémoire réelle reste inconnue : une marge n'est pas du luxe.
Développement ou chatbot : Qwen 3.8 27B suffit-il ?
Les deux usages ne demandent pas la même qualité. Sur l'indice d'Artificial Analysis, Qwen 3.8 27B obtient 20 points, au niveau de Claude Haiku 5.5 en effort faible (19), mais loin de Claude Sonnet 5.5 (55), de Claude Opus 5.5 (59) et de Claude Fable 5.2 (65).
Pour le développement, Claude reste la référence, et l'écart est net. Sur Terminal-Bench 2.1, un banc de tâches de programmation en ligne de commande, Vals.ai mesure 87,6 % pour Claude Opus 5.5, 83,2 % pour Claude Sonnet 5.5 et 58,4 % pour Qwen 3.8 27B, dans les mêmes conditions. Qwen annonce mieux sur ses propres tests : 61,7 sur SWE-bench Pro, contre 53,4 pour Claude Opus 4.6, un modèle Claude d'une génération antérieure. Nous ne remplacerions pas Claude Code par un Qwen local pour faire travailler un agent sur une grosse base de code ; un poste local sert plutôt au code qui ne doit pas sortir de l'entreprise et aux tâches simples.
Pour un chatbot ou un agent métier, Qwen 3.8 27B est très bien, sauf cas très complexes. C'est notre avis d'utilisateur : chez ATG, il rédige les réponses aux messages, et notre benchmark FinanceBench atteint 92 % de bonnes réponses avec lui, sur 150 questions d'analystes posées à 368 rapports financiers. Le remplacer par Gemini 3.8 Flash, ou lui laisser plus de temps de réflexion, ne change pas le score de façon significative, comme nous l'expliquons dans notre article sur l'audit d'un RAG : la qualité vient d'abord de la recherche des bons passages. Les cas qui justifient un modèle de pointe sont les raisonnements longs sur plusieurs documents et les agents qui enchaînent beaucoup d'étapes.
Qu'est-ce qui fixe le matériel d'un LLM local ?
La mémoire nécessaire tient en une règle : les poids du modèle, plus le KV cache, la mémoire de travail de chaque conversation, qui grossit avec la longueur du texte lu et le nombre d'utilisateurs. Notre article sur les LLM on premise détaille ce calcul. Qwen 3.8 27B a l'avantage d'un KV cache réduit : seules 16 de ses 64 couches en gardent un, soit environ 2,1 Go pour une conversation de 32 000 tokens.
Trois questions décident ensuite du palier :
- Combien de requêtes arrivent en même temps aux heures de pointe. Une requête simultanée n'est pas un salarié : un utilisateur passe l'essentiel de son temps à lire ou à écrire, pas à attendre une réponse.
- Quelle longueur de texte le modèle lit à chaque requête. Une question de chat fait quelques centaines de tokens ; un RAG ou un agent qui lit des contrats en envoie des dizaines de milliers.
- Quelle vitesse est acceptable pour chaque utilisateur. Comme Qwen 3.8 27B réfléchit avant de répondre, il produit beaucoup plus de texte que la moyenne des modèles comparables : à notre avis, en dessous de 20 à 30 tokens par seconde, l'attente se sent. Les repères ci-dessous disent à quoi les utilisateurs sont déjà habitués.
Quelle vitesse attendent les utilisateurs ?
Deux références fixent les attentes. Pour un développeur habitué à Claude Code, c'est l'API d'Anthropic, que Claude Code appelle. Pour un utilisateur de chat, c'est la vitesse des assistants grand public, et elle a changé d'échelle : Le Chat de Mistral répond à plus de 1 100 tokens par seconde avec Mistral Large 2 depuis février 2025, sur les puces de Cerebras, et OpenAI a signé en janvier 2026 pour 750 mégawatts de calcul Cerebras, en vue de « faster responses, more natural interactions ».
| Service | Modèle | Vitesse pour un utilisateur | Nature du chiffre |
|---|---|---|---|
| API d'Anthropic (Claude Code) | Claude Opus 5.5 | 105 à 116 tokens/s | mesure Artificial Analysis |
| API d'Anthropic | Claude Sonnet 5.5 | 126 à 152 tokens/s | mesure Artificial Analysis |
| API d'Anthropic | Claude Haiku 5.5 | 209 à 257 tokens/s | mesure Artificial Analysis |
| API de Mistral | Mistral Large 4 | 81 à 88 tokens/s | mesure Artificial Analysis |
| API d'Alibaba | Qwen 3.8 27B | environ 40 tokens/s | mesure Artificial Analysis |
| Groq | Qwen 3.8 27B | 450 tokens/s | annonce de Groq |
| Cerebras | Qwen 3.8 27B | environ 1 850 tokens/s | annonce de Cerebras |
| Poste local (RTX 3090 à 5090) | Qwen 3.8 27B | 40 à 75 tokens/s | mesure Hardware Corner |
Mesures d'Artificial Analysis relevées le 16 novembre 2026 (moyenne sur cinq jours), selon le niveau d'effort du modèle.
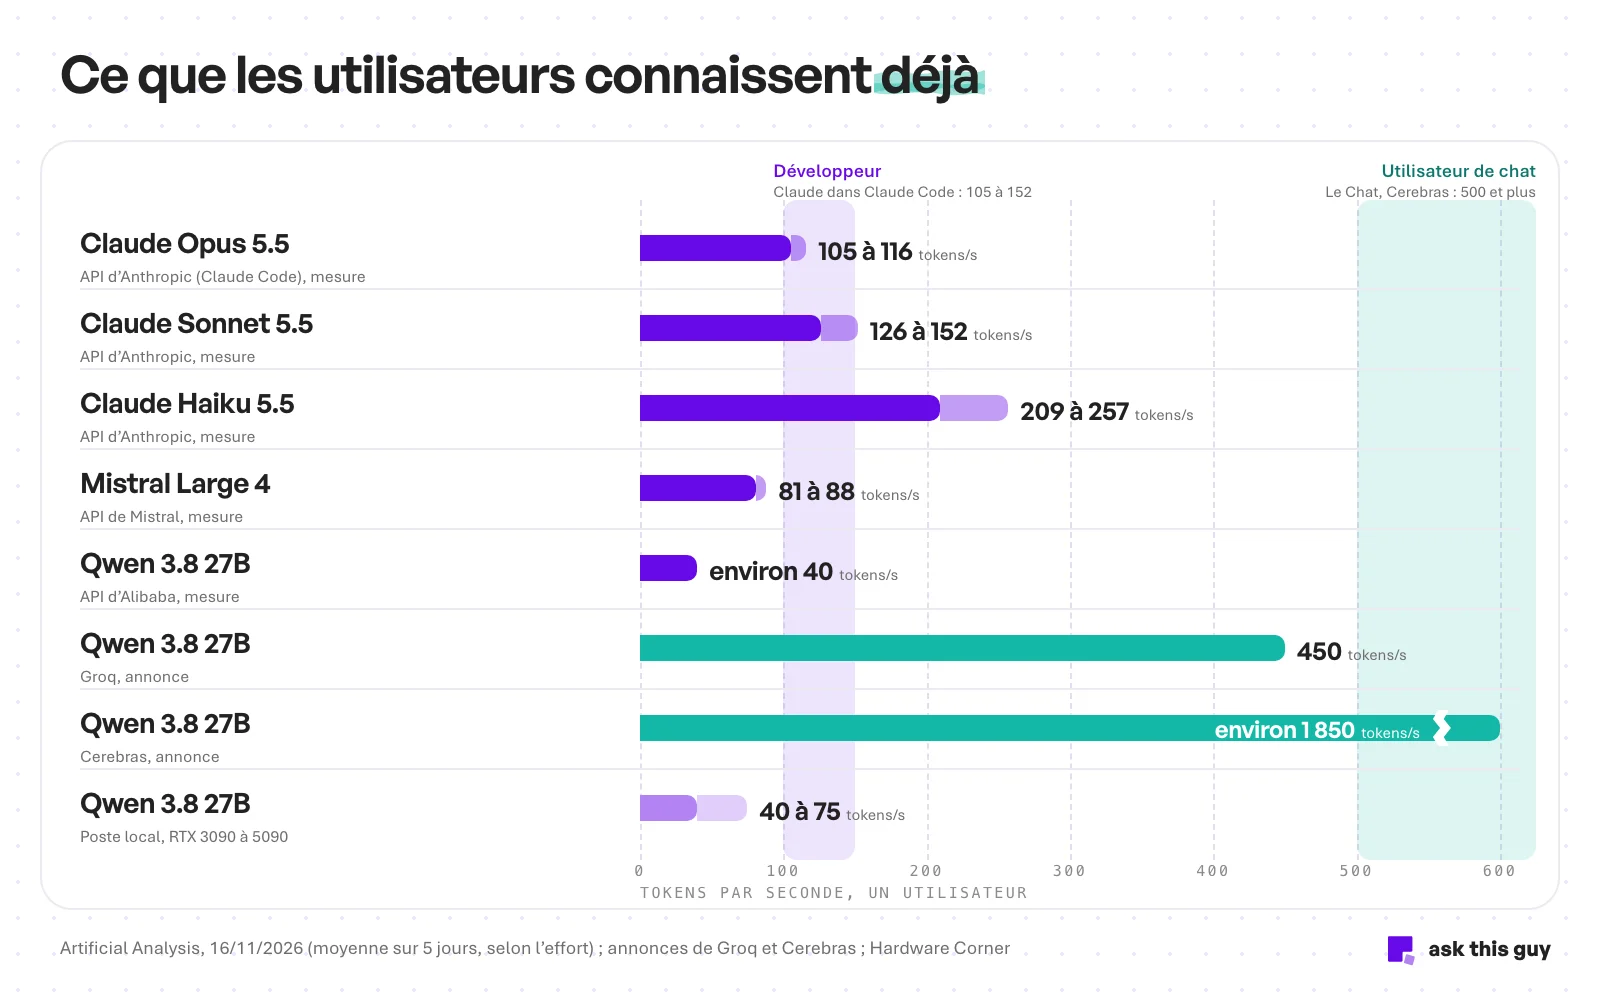 Graphique : vitesse pour un utilisateur, en tokens par seconde, des services que les utilisateurs connaissent déjà. Claude Opus 5.5 sur l'API d'Anthropic, utilisée par Claude Code : 105 à 116. Claude Sonnet 5.5 : 126 à 152. Claude Haiku 5.5 : 209 à 257. Mistral Large 4 sur l'API de Mistral : 81 à 88. Qwen 3.8 27B sur l'API d'Alibaba : environ 40, chez Groq : 450 (annonce), chez Cerebras : environ 1 850 (annonce), sur un poste local : 40 à 75. Bandes de référence : développeur 100 à 150, utilisateur de chat 500 et plus
Nous en tirons deux repères : 100 à 150 tokens par seconde pour un développeur, 500 et plus pour un utilisateur de chat, le seuil que nous retenons déjà pour les usages exigeants dans notre article sur les LLM on premise. Un poste local va donc deux fois moins vite que Claude Opus 5.5, et vingt-cinq à quarante-cinq fois moins vite que le même modèle chez Cerebras. Un serveur partagé en charge, à 32 à 42 tokens par seconde par utilisateur, en donne environ le tiers de Claude. Le fast mode de Claude Code promet même jusqu'à 2,5 fois plus. Un développeur passé de Claude Code à un serveur maison verra la différence ; un utilisateur de chat habitué à Le Chat la verra encore plus.
Le débit total d'un serveur se partage entre les requêtes : un serveur qui produit 1 600 tokens par seconde pour 50 requêtes donne environ 32 tokens par seconde à chacune. Les chiffres qui suivent séparent toujours les deux.
Un poste de travail pour un utilisateur : quel PC pour l'IA locale ?
Pour un développeur, un pilote ou un usage personnel, une carte graphique de 24 ou 32 Go suffit. Hardware Corner a mesuré Qwen 3.8 27B en 4 bits avec llama.cpp, mis à jour le 17 août, à 4 000 tokens de contexte :
| Machine | Mémoire | Vitesse mesurée (un utilisateur) | Prix relevé le 16/11/2026 |
|---|---|---|---|
| RTX 5090 | 32 Go | 75 tokens/s | 7 750 € HT la carte, 10 833 € HT en station complète |
| RTX 4090 | 24 Go | 46 tokens/s | plus produite |
| RTX 3090 | 24 Go | 40 tokens/s | occasion uniquement |
| Apple M5 Max | 128 Go | 31 tokens/s | 5 616 € HT le Mac Studio 128 Go |
| GB10 (base du DGX Spark) | 128 Go | 12 tokens/s | 6 548 € TTC (ASUS Ascent GX10) |
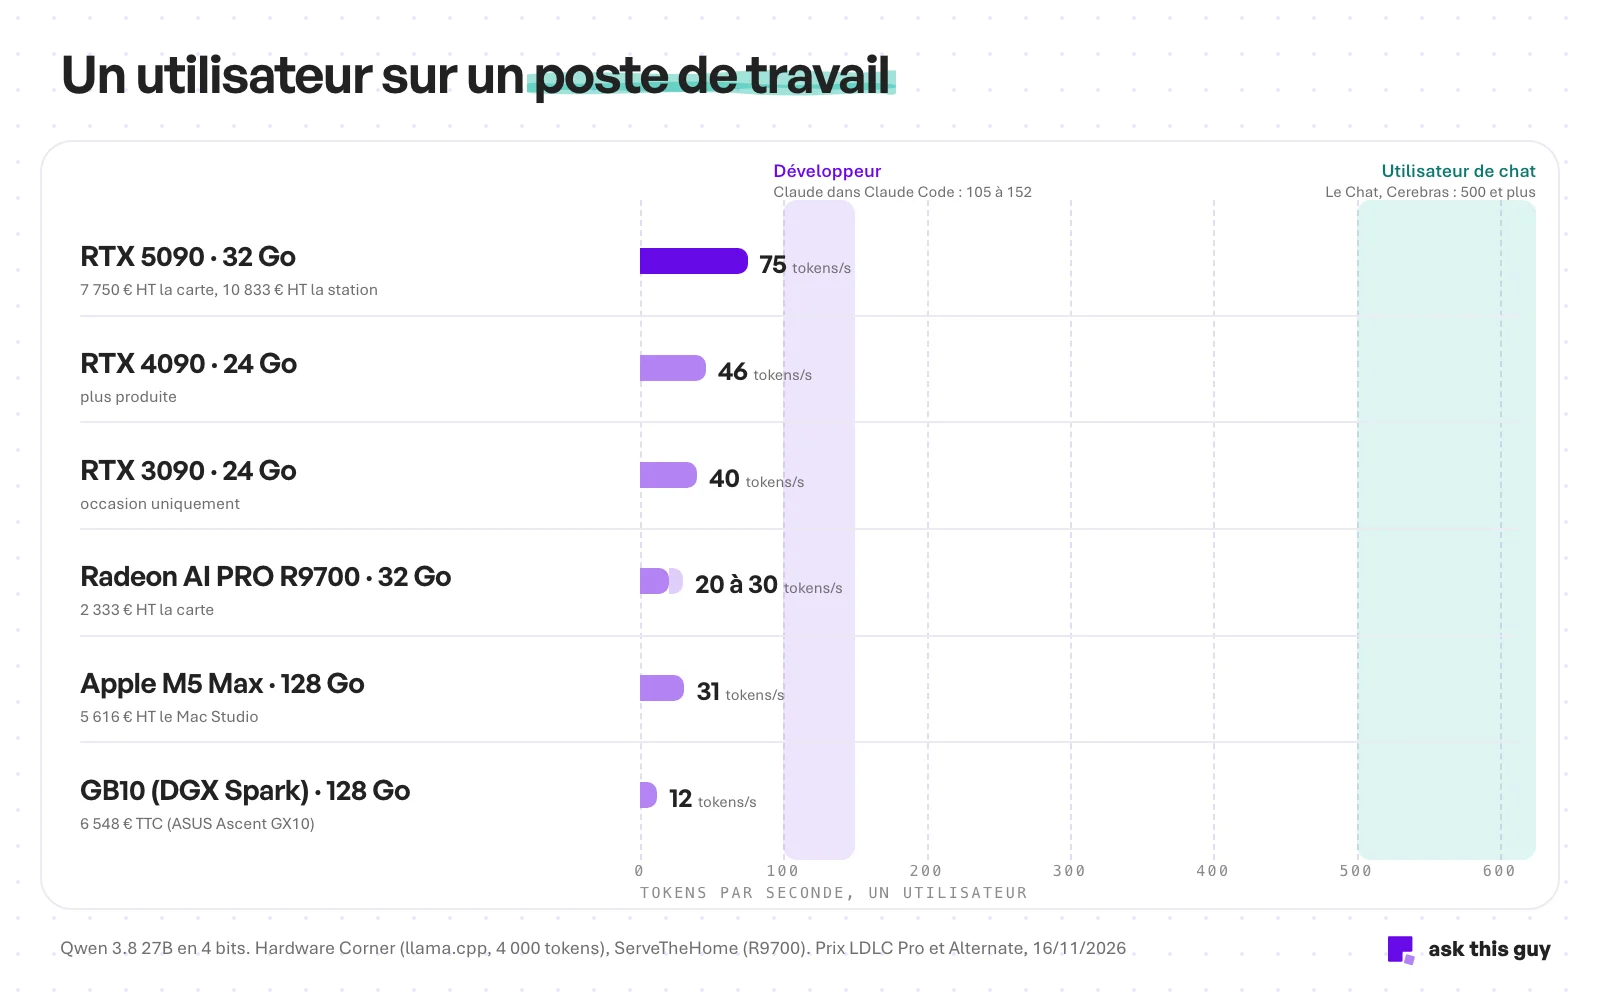 Graphique : vitesse de Qwen 3.8 27B en 4 bits pour un utilisateur sur un poste de travail, face aux vitesses de référence. RTX 5090 32 Go : 75 tokens par seconde (7 750 € HT la carte, 10 833 € HT la station). RTX 4090 24 Go : 46. RTX 3090 24 Go : 40. Radeon AI PRO R9700 32 Go : 20 à 30 (2 333 € HT). Apple M5 Max 128 Go : 31 (5 616 € HT le Mac Studio). GB10, la base du DGX Spark, 128 Go : 12 (6 548 € TTC). Toutes les barres restent sous la bande du développeur, 100 à 150 tokens par seconde, et loin de celle de l'utilisateur de chat, 500 et plus
La carte d'AMD, la Radeon AI PRO R9700 de 32 Go, est la moins chère du lot à 2 333 € HT. ServeTheHome l'a mesurée entre 20 et 30 tokens par seconde pour un utilisateur seul ; AMD annonce jusqu'à 51,8 avec le décodage spéculatif, une technique qui fait deviner plusieurs tokens d'un coup et les vérifie ensuite.
Les machines à 128 Go de mémoire unifiée achètent de la capacité, pas de la vitesse. Le DGX Spark de NVIDIA, le Mac Studio ou les mini-PC Ryzen AI Max+ chargent sans peine un modèle de 27 milliards de paramètres, mais leur mémoire est lente pour un modèle dense, qui relit tous ses paramètres à chaque token. Sur DGX Spark, un développeur a mesuré 11,2 tokens par seconde sans décodage spéculatif, 19 à 28 avec. Pire, lire un document de 128 000 tokens y demande 150 secondes avant le premier mot. Ces machines conviennent mieux aux modèles MoE, qui ne relisent qu'une partie de leurs paramètres à chaque token.
Les prix, eux, ont suivi la pénurie de mémoire. NVIDIA a relevé le DGX Spark de 3 999 à 4 699 dollars en février, en invoquant « worldwide constraints in memory supply », puis à 6 950 dollars en octobre. La RTX 5090 a atteint 8 899,95 € le 3 novembre selon l'observatoire de GinjFo, avant de redescendre à 5 609,90 € le 14 novembre selon Pro-gamer. Sur ce palier, un prix relevé un lundi ne tient pas toujours le lundi suivant.
Le 4 bits ne coûte presque rien en qualité. La version INT4 publiée par Red Hat conserve 98,5 à 101 % des scores du modèle d'origine selon les tâches (87,9 contre 89,2 sur GPQA Diamond). Quesma n'a mesuré aucune perte notable en Q4_K_M, et une chute nette seulement en 2 bits. Nous préférons les versions publiées par Qwen, NVIDIA ou Red Hat : des versions communautaires ont montré des boucles de raisonnement.
Sans carte graphique, seul un petit modèle reste envisageable, pour des tâches simples. OVH annonce pour Olala mini 7A1B, son premier LLM dévoilé le 17 novembre 2026, 50 tokens par seconde sur un simple processeur : c'est un mélange d'experts qui ne fait travailler qu'un milliard de ses 7 milliards de paramètres pour chaque token. Le chiffre est déclaratif, sans conditions de test, et un modèle de cette taille ne joue pas dans la catégorie de Qwen 3.8 27B : il vise le classement ou l'extraction, pas la rédaction ni le code. Nous l'analysons dans notre article sur Olala mini.
Un poste n'a ni redondance ni contrôle d'accès, et ne sert bien qu'une personne à la fois : c'est un outil de pilote.
Ollama, vLLM ou SGLang : quel logiciel d'inférence choisir ?
Le logiciel qui fait tourner le modèle, le moteur d'inférence, mérite autant d'attention que la carte : tous ne se valent pas, et l'écart va de un à cinquante sur le même GPU. Ollama et LM Studio sont des outils de poste : ils servent très bien une personne. Pour plusieurs utilisateurs, il faut un moteur de serveur, qui regroupe les requêtes pour les traiter ensemble. Phil Winder (Winder.AI) a comparé cinq moteurs sur un même H100 loué, avec Qwen 3.8 27B en 8 bits et des requêtes d'environ 900 tokens. Voici la vitesse que reçoit chaque utilisateur, en tokens par seconde ; entre parenthèses, le débit total du GPU, que nous divisons par le nombre de requêtes :
| Moteur | 1 requête | 10 simultanées | 50 simultanées | Attente médiane à 50 |
|---|---|---|---|---|
| SGLang 0.5.20 | 81 | 63 (627 au total) | 35 (1 725 au total) | 1,5 s |
| vLLM 0.30.0 | 76 | 59 (589) | 32 (1 610) | 2,1 s |
| llama.cpp | 56 | 14 (138) | 1,9 (97) | 8,2 s |
| Ollama 0.34.4 | 33 | 3,3 (33) | 0,7 (33) | 381 s |
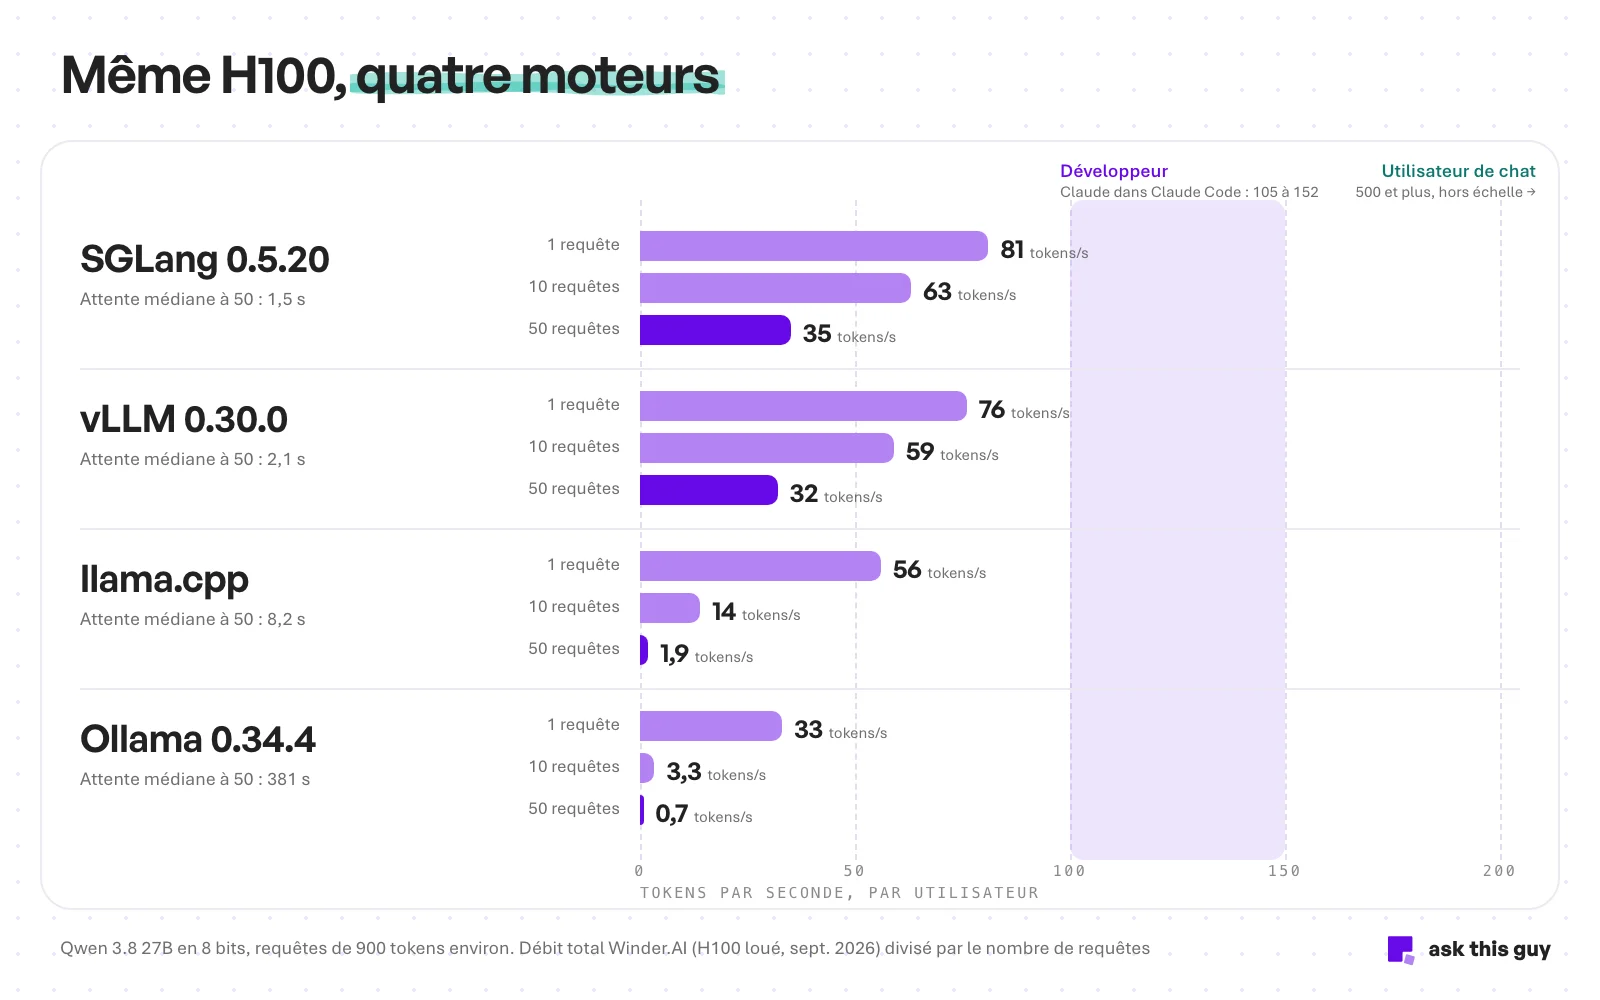 Graphique : vitesse de Qwen 3.8 27B en 8 bits pour chaque utilisateur, sur un même H100, selon le moteur, à 1, 10 et 50 requêtes simultanées. SGLang 0.5.20 : 81, 63 et 35 tokens par seconde, attente médiane de 1,5 s à 50. vLLM 0.30.0 : 76, 59 et 32, 2,1 s. llama.cpp : 56, 14 et 1,9, 8,2 s. Ollama 0.34.4 : 33, 3,3 et 0,7, 381 s. Débit total mesuré par Winder.AI en septembre 2026, divisé par le nombre de requêtes
« Ollama served 33 », résume Winder.AI : sur cette architecture, Ollama traite les requêtes une par une. Vu de chaque utilisateur, à 50 requêtes simultanées, SGLang donne 35 tokens par seconde et Ollama 0,7 : cinquante fois moins, sur la même carte. Un pilote sur Ollama qui convient à une personne ralentit pour tout le monde dès que l'équipe s'y met, sans que la carte soit en cause. Le réglage compte aussi : avec ses paramètres par défaut, SGLang se limitait à 20 requêtes à la fois, et l'attente avant le premier mot montait à 10 secondes.
Un serveur à une carte pour une équipe
Le palier suivant est une carte de serveur dans une machine hébergée. La RTX PRO 6000 de NVIDIA, avec 96 Go de mémoire, garde le modèle et beaucoup de conversations en mémoire. Paralon Cloud l'a mesurée avec vLLM en 4 bits, avec des réponses de 256 tokens : 106 tokens par seconde pour une requête, 636 au total pour 8 requêtes simultanées, 1 342 pour 32. Soit, par utilisateur, environ 80 tokens par seconde à 8 et 42 à 32 (notre calcul).
Une carte de ce type sert donc une trentaine de requêtes simultanées à la vitesse de l'API de l'éditeur. Elle coûte entre 16 142 et 16 600 € HT chez LDLC Pro selon la version, et davantage ailleurs. Aucun intégrateur français ne publie le prix d'un serveur rack à une carte : le seul serveur GPU au catalogue de LDLC Pro, avec trois RTX PRO 6000, s'affiche à 89 562 € HT. Paradoxe relevé par Pause Hardware : Dell vend aux États-Unis une station complète avec cette carte pour environ 12 600 euros, moins que la carte seule au détail en Europe.
La carte de serveur plus ancienne, la L40S de 48 Go, se loue 1,40 € de l'heure chez OVHcloud, mais nous n'avons trouvé aucune mesure publiée de Qwen 3.8 27B sur ce modèle.
H100 et H200 : servir toute l'entreprise
Au-delà de quelques dizaines de requêtes simultanées, on passe aux GPU de centre de données. Sur un H100 de 80 Go, Winder.AI mesure 1 610 à 1 725 tokens par seconde à 50 requêtes simultanées, soit environ 32 à 35 tokens par seconde par utilisateur, avec 1,5 à 2,1 secondes d'attente avant le premier mot. Le H100 n'est plus vendu neuf, mais il se loue 2,80 € de l'heure chez OVHcloud, soit 1 940 € par mois en continu.
Son successeur, le H200 NVL de 141 Go, coûte 32 533 € HT chez LDLC Pro. En 4 bits avec vLLM, Paralon Cloud mesure 3 342 tokens par seconde au total pour 128 requêtes, environ 26 par utilisateur ; à 64 requêtes, environ 48. Le B200, plus récent, ne fait pas mieux sur ce modèle en charge : selon Paralon, il passe 12 à 14 % derrière le H200 entre 32 et 128 requêtes.
La longueur des documents compte autant que le nombre d'utilisateurs. Sur un H200 avec SGLang en FP8, des mesures publiées sur le dépôt du projet donnent, pour des requêtes de 1 000 tokens, 98 tokens par seconde pour un utilisateur seul, 83 à 16 utilisateurs et 50 à 64. Avec 8 000 tokens en entrée, la vitesse tombe à 29 tokens par seconde à 64 utilisateurs, et l'attente avant le premier mot passe de 2,6 à 19 secondes. Un assistant de chat et un RAG qui lit des contrats n'ont pas besoin du même serveur, même avec le même nombre d'utilisateurs.
Et pour la vitesse d'un chat ?
Aucune mesure publiée de Qwen 3.8 27B sur GPU n'atteint 500 tokens par seconde par utilisateur, même pour un utilisateur seul. Le décodage spéculatif, qui fait deviner plusieurs tokens d'un coup puis les vérifie, rapproche du but : sur H200 avec SGLang, il fait passer un utilisateur seul de 98 à 196 tokens par seconde, et DataPacket annonce jusqu'à 360 tokens par seconde sur une RTX PRO 6000 avec la méthode DFlash2. Mais l'avantage fond en charge : sur le même H200, il ne reste que 66 tokens par seconde par utilisateur à 32 utilisateurs. Selon les auteurs de HyperQwen, « speculation wins below ~8 concurrent users, plain batching above ».
Un chat local rapide se paie donc en cartes : pour s'approcher des 200 à 360 tokens par seconde, chaque GPU ne sert que quelques utilisateurs à la fois, et le budget suit le nombre d'utilisateurs simultanés plutôt que le nombre de salariés. Au-delà, il faut du matériel spécialisé : la vitesse du Chat de Mistral ou de Cerebras vient de puces conçues pour l'inférence, accessibles en API, pas d'un serveur GPU classique. Pour un chatbot interne, nous jugeons qu'une réponse qui s'affiche à 40 à 80 tokens par seconde reste confortable : une réponse de 300 mots, environ 400 tokens, s'écrit en cinq à dix secondes (notre calcul).
Ce qu'une entreprise peut retenir
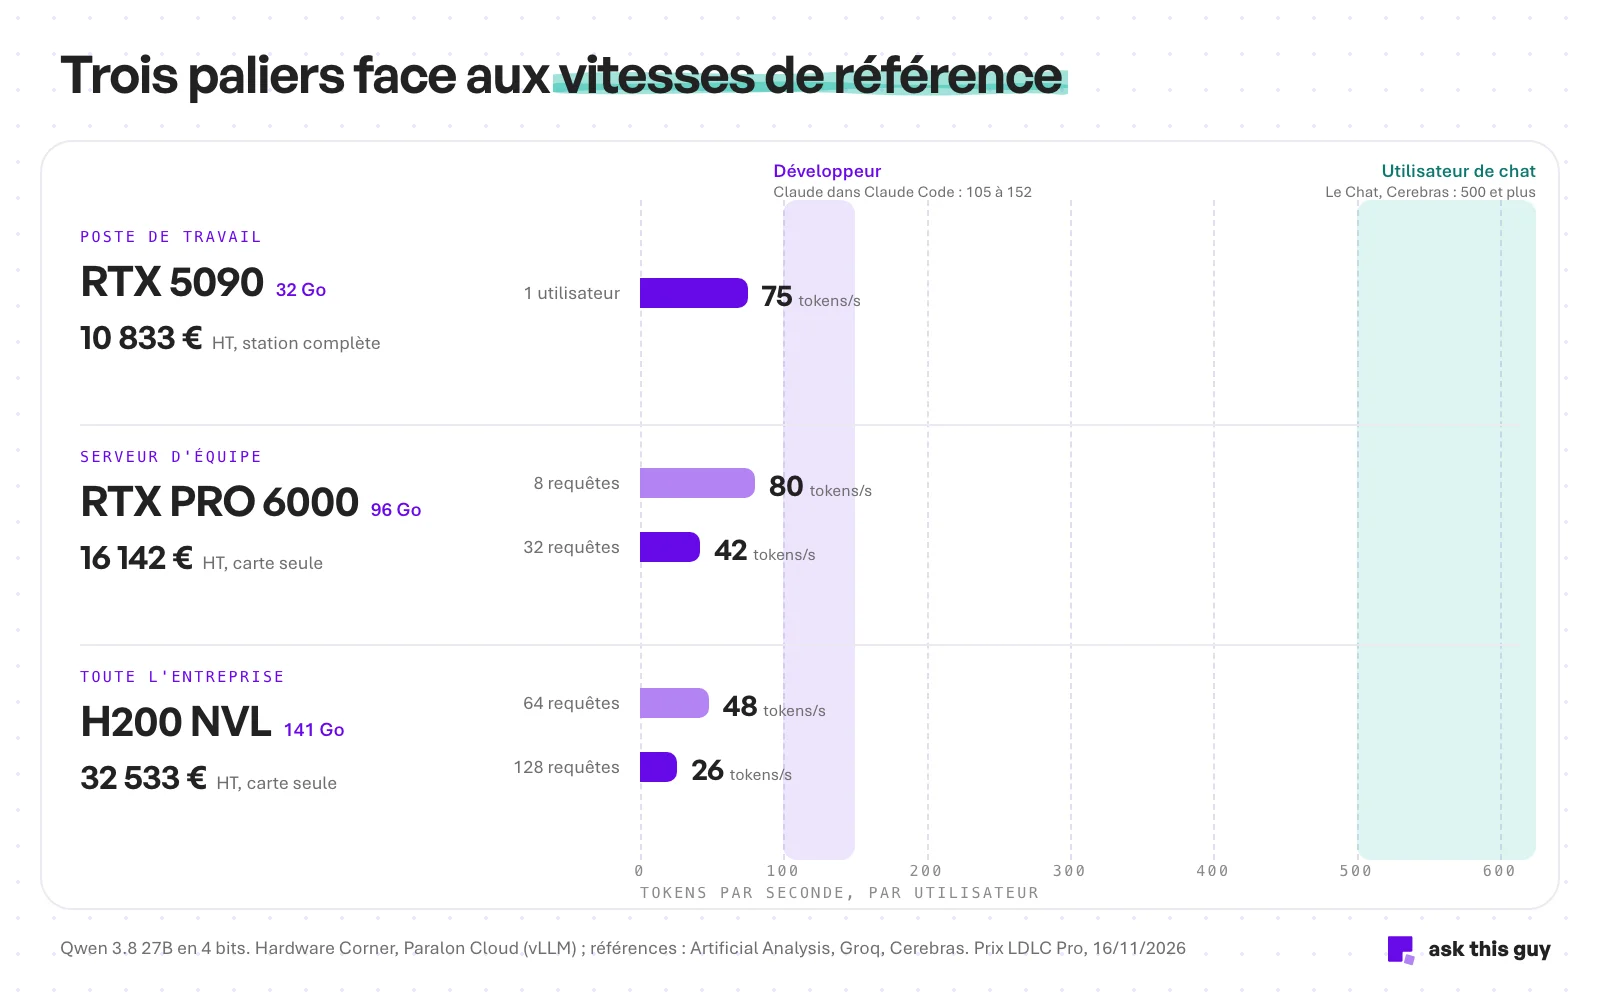 Graphique : trois paliers de matériel pour Qwen 3.8 27B en 4 bits face aux vitesses de référence. Poste de travail RTX 5090 (10 833 € HT la station complète) : 75 tokens par seconde pour un utilisateur. Serveur d'équipe RTX PRO 6000 de 96 Go (16 142 € HT la carte) : 80 tokens par seconde par requête à 8 requêtes simultanées, 42 à 32. H200 NVL de 141 Go (32 533 € HT la carte) : 48 à 64 requêtes, 26 à 128. Toutes les barres restent sous la bande du développeur, 100 à 150 tokens par seconde (Claude dans Claude Code), et loin de celle de l'utilisateur de chat, 500 et plus (Le Chat, Cerebras)
| Palier | Matériel | Prix relevé le 16/11/2026 | Requêtes simultanées mesurées | Vitesse par utilisateur |
|---|---|---|---|---|
| Poste de travail | RTX 5090, station complète | 10 833 € HT | 1 | 75 tokens/s |
| Poste de travail | Radeon AI PRO R9700, carte | 2 333 € HT | 1 | 20 à 30 tokens/s |
| Serveur d'équipe | RTX PRO 6000 96 Go, carte | 16 142 à 16 600 € HT | 8 / 32 | 80 / 42 tokens/s |
| Entreprise | H100 80 Go, location | 2,80 € de l'heure | 50 | 32 à 35 tokens/s |
| Entreprise | H200 NVL 141 Go, carte | 32 533 € HT | 64 / 128 | 48 / 26 tokens/s |
Mesures en 4 bits, sauf le H100 (8 bits) ; requêtes courtes ; calculs par utilisateur d'ATG à partir des débits totaux publiés.
Notre lecture de ces chiffres : la charge se mesure avant l'achat. Le nombre de requêtes simultanées et la longueur des documents se relèvent pendant un pilote, et ils décident du palier bien plus que le nom du modèle. Un H100 loué quelques jours chez OVHcloud suffit pour rejouer cette charge avec vLLM avant de commander une carte dont le délai dépasse parfois quinze jours. Un pilote sur Ollama, lui, montre la qualité des réponses, mais rien de la tenue en charge.
La carte n'est qu'une ligne du budget. Hébergement, électricité, maintenance et surtout personnel pèsent davantage : notre article sur les LLM on premise chiffre le coût complet et le seuil de rentabilité face à une API.
Le même modèle existe aussi en API hébergée en France : OVHcloud sert Qwen 3.8 27B et Scaleway le propose, ce qui permet un pilote sans matériel. Notre page sur l'IA souveraine décrit ce qu'un hébergement européen règle, et ce qu'il ne règle pas.
Questions fréquentes sur le serveur IA local
Quel PC faut-il pour faire tourner une IA en local ?
Pour un modèle comme Qwen 3.8 27B en 4 bits, une carte graphique de 24 ou 32 Go suffit pour un utilisateur : Hardware Corner mesure 40 tokens par seconde sur RTX 3090, 46 sur RTX 4090 et 75 sur RTX 5090. Les machines à 128 Go de mémoire unifiée, comme le DGX Spark ou le Mac Studio, chargent de plus gros modèles mais génèrent ce modèle dense plus lentement.
Qwen 3.8 27B peut-il remplacer Claude pour coder ?
Pas pour du code agentique sur une grosse base de code. Sur Terminal-Bench 2.1, Vals.ai mesure 87,6 % pour Claude Opus 5.5, 83,2 % pour Claude Sonnet 5.5 et 58,4 % pour Qwen 3.8 27B, et l'indice d'Artificial Analysis le place à 20 points contre 59 pour Opus 5.5. Un Qwen local sert plutôt au code qui ne doit pas quitter l'entreprise et aux tâches simples. Pour un chatbot ou un agent métier, en revanche, il suffit le plus souvent.
Combien d'utilisateurs un serveur IA local peut-il servir ?
Cela dépend du GPU, du moteur et de la longueur des documents. Avec vLLM et Qwen 3.8 27B en 4 bits, une RTX PRO 6000 sert 32 requêtes simultanées à environ 42 tokens par seconde chacune, selon Paralon Cloud ; un H200 NVL en sert 128 à environ 26. Le nombre de salariés servis est plus élevé, car la plupart lisent ou écrivent pendant que d'autres attendent une réponse.
Un LLM local est-il aussi rapide que Claude ou Le Chat ?
Non, en général. Sur un poste, Qwen 3.8 27B tourne à 40 à 75 tokens par seconde ; Artificial Analysis mesure Claude Opus 5.5 à environ 110 tokens par seconde sur l'API d'Anthropic, et Cerebras annonce environ 1 850 tokens par seconde pour Qwen 3.8 27B. Cerebras fournit aussi le calcul du Chat de Mistral, qui répond à plus de 1 100 tokens par seconde, et OpenAI a signé avec lui pour 750 mégawatts. Un serveur partagé en charge descend à 30 ou 40 tokens par seconde par utilisateur.
Combien coûte le matériel d'un serveur IA local ?
Au 16 novembre 2026, chez LDLC Pro : 2 333 € HT pour une Radeon AI PRO R9700 de 32 Go, 10 833 € HT pour une station complète avec RTX 5090, 16 142 à 16 600 € HT pour une RTX PRO 6000 de 96 Go et 32 533 € HT pour un H200 NVL, carte seule. Un serveur avec trois RTX PRO 6000 s'affiche à 89 562 € HT. La location d'un H100 coûte 2,80 € de l'heure chez OVHcloud.
Un DGX Spark suffit-il pour un LLM local ?
Pour tester des modèles, oui ; pour servir Qwen 3.8 27B rapidement, non. Ses 128 Go de mémoire chargent de gros modèles, mais il génère ce modèle dense à 11 ou 12 tokens par seconde sans décodage spéculatif, et met 150 secondes à lire un document de 128 000 tokens. Son prix est passé de 3 999 à 6 950 dollars en un an.
Faut-il quantifier un LLM local en 4 bits ?
Pour Qwen 3.8 27B, la perte est faible : la version INT4 de Red Hat conserve 98,5 à 101 % des scores du modèle d'origine, et Quesma ne mesure pas de perte notable en Q4_K_M. La qualité chute nettement à partir de 2 bits. Les versions publiées par Qwen, NVIDIA ou Red Hat sont plus sûres que certaines versions communautaires, qui ont montré des boucles de raisonnement.
Faut-il attendre Qwen 4 pour acheter du matériel ?
Qwen 4 27B n'est pas publié au 16 novembre 2026, et sa mémoire réelle est inconnue. Le matériel dimensionné pour Qwen 3.8 27B le fera probablement tourner s'il garde sa taille, mais l'aperçu de l'architecture de Qwen 4 ajoute de grosses tables d'embeddings : garder une marge de mémoire est plus prudent qu'attendre.
Avant de choisir une carte, une question mérite une semaine de mesure : combien de requêtes arrivent vraiment en même temps, et quelle longueur de texte elles envoient. C'est en analysant les logs d'un pilote que vous obtiendrez une réponse qui peut vous faire économiser plusieurs dizaines de milliers d'euros !
Qwen 3.8 27B sans gérer de serveur, avec ATG
Avec ATG, tout cela est déjà réglé. Choix de la carte, du moteur d'inférence et de la quantification, mesure de la charge, maintenance : notre RAG d'entreprise arrive clé en main, hébergé chez OVHcloud en France. Le modèle qui y rédige les réponses est justement Qwen 3.8 27B, et ces réponses arrivent vite tout en restant pertinentes, ce qu'une démonstration montre sur vos propres questions.