Agentic search : en due diligence, trouver le bon document
Sur FinanceBench, un même modèle passe de 27 % à 86 % de bonnes réponses selon le logiciel qui cherche. En due diligence, le défi : trouver le bon document.

En août 2026, Mistral a publié les résultats de sa recherche agentique (agentic search) sur FinanceBench, un test de 150 questions d'analyste financier posées sur 368 rapports de sociétés cotées. Avec le même modèle, GLM-5.2, la précision passe de 26,7 % à 86 % selon la façon dont le logiciel cherche dans les rapports. Le modèle ne change pas, les documents non plus : seule change la manière d'aller chercher l'information.
Ce résultat confirme ce que le test montrait dès 2023 : un modèle de langage interprète bien un rapport financier quand on lui met la bonne page sous les yeux. Ce qui fait chuter la précision, c'est de devoir trouver cette page. Le modèle n'est plus le sujet : c'est le logiciel qui va chercher l'information et pilote l'agent.
Pour une équipe de due diligence, la conséquence est directe. Une data room, ce sont des centaines de documents qui se ressemblent : trois exercices de comptes, plusieurs versions d'un contrat, une liasse par filiale. Le plus dur n'est pas d'interpréter les documents, c'est de trouver le bon, et c'est sur ce point que les outils d'IA se départagent.
Interpréter un document ou trouver le bon : deux tâches différentes
FinanceBench est un jeu de questions publié par Patronus AI en novembre 2023 pour mesurer la capacité d'une IA à répondre à des questions d'analyste à partir de rapports réels : rapports annuels (10-K), trimestriels (10-Q), communiqués de résultats. Chaque question a une réponse unique et vérifiable, un montant, un ratio ou une explication tirée du rapport.
Les auteurs ont posé les 150 questions publiques à GPT-4 Turbo dans cinq configurations, en ne changeant que ce qu'on donne au modèle. Les réponses ont été notées à la main. Les résultats de la table 2 dessinent un escalier :
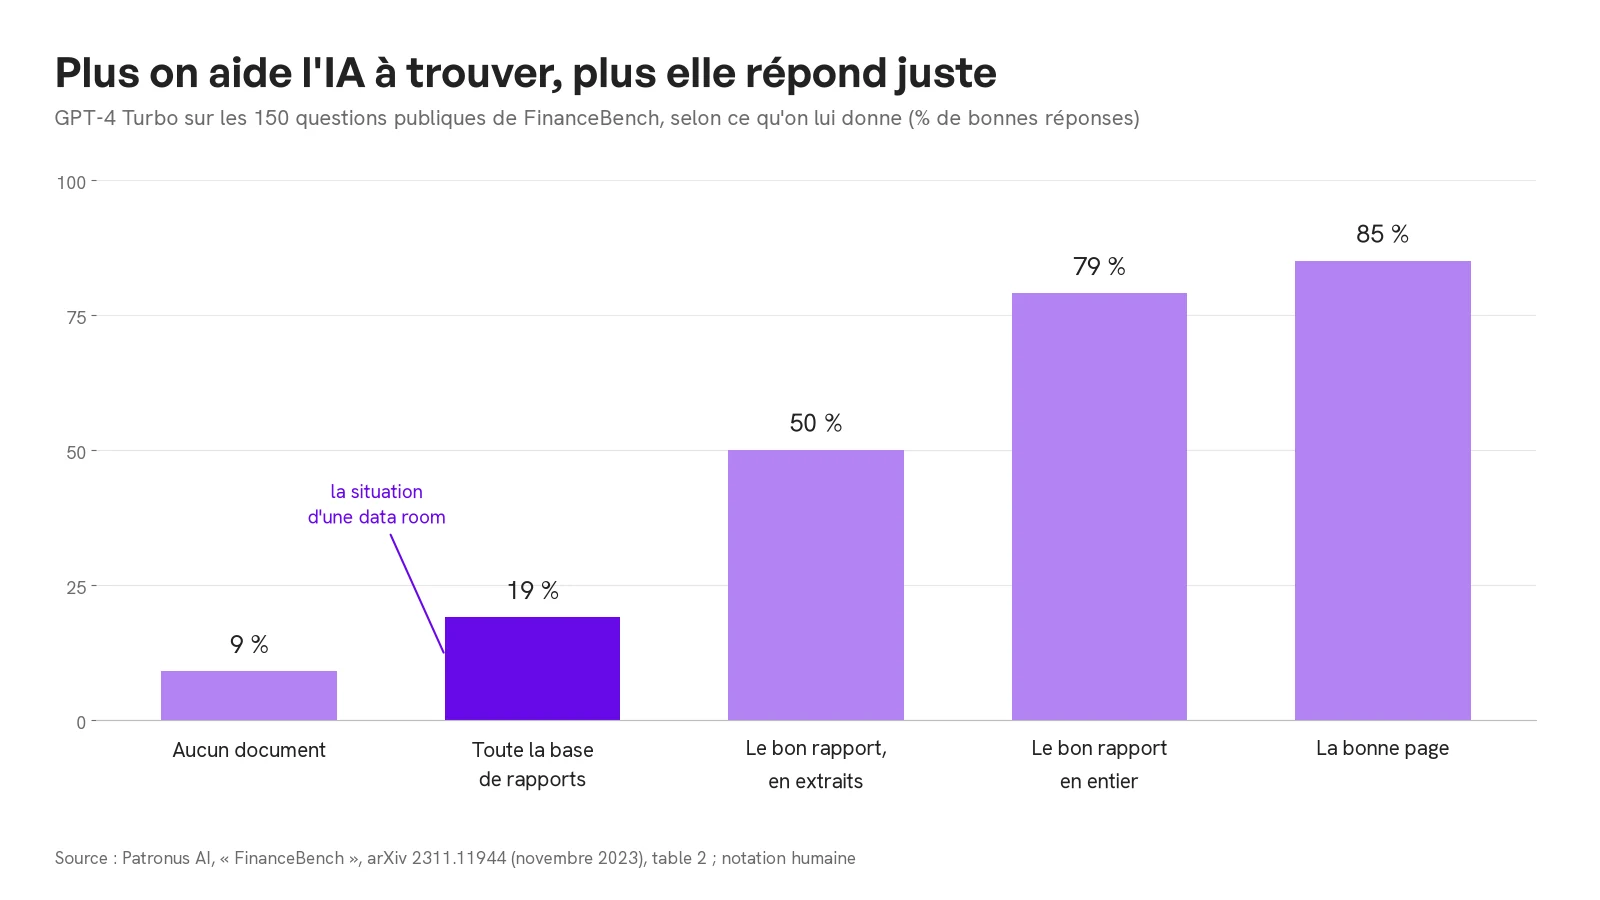 Graphique en barres : GPT-4 Turbo répond juste à 9 % des questions sans document, 19 % quand il cherche dans toute la base de rapports, 50 % avec le bon rapport en extraits, 79 % avec le bon rapport en entier, 85 % avec la bonne page
Sans aucun document, le modèle répond juste à 9 %. Avec la bonne page, il monte à 85 %. Entre les deux, tout dépend de l'effort de recherche qu'on lui laisse : 19 % quand il doit trouver le passage dans une base commune à tous les rapports, 50 % quand la base ne contient que le bon rapport, 79 % quand le rapport entier tient dans sa fenêtre de contexte. De 19 % à 85 %, sans changer de modèle : l'écart vient entièrement de ce qu'il faut trouver.
Le résumé de l'article le dit sans détour : GPT-4 Turbo associé à un système de recherche « incorrectly answered or refused to answer 81% of questions ». L'éditeur Ragie a retrouvé le même écart un an plus tard avec son propre moteur : 27 % dans la base commune, 51 % dans une base limitée au bon document. Réduire le périmètre de recherche double la précision.
Le modèle n'est plus le sujet : à modèle égal, le logiciel triple la précision
La recherche agentique (agentic search, ou RAG agentique) désigne un logiciel qui ne se contente pas d'une recherche unique : il enchaîne les recherches, ouvre les documents qui semblent pertinents, les parcourt, vérifie ce qu'il a trouvé et décide quand il en sait assez pour répondre. Le modèle de langage rédige et raisonne ; le logiciel autour de lui pilote l'enquête.
Le billet de Mistral publié le 20 août 2026 isole précisément l'effet de ce logiciel. Mêmes 150 questions, mêmes 368 rapports, même modèle, trois façons de chercher : un RAG « en un passage », qui « retrieves a fixed set of text chunks and asks a model to answer in a single pass », une boucle de recherches enchaînées, puis la même boucle avec des outils de navigation dans les documents.
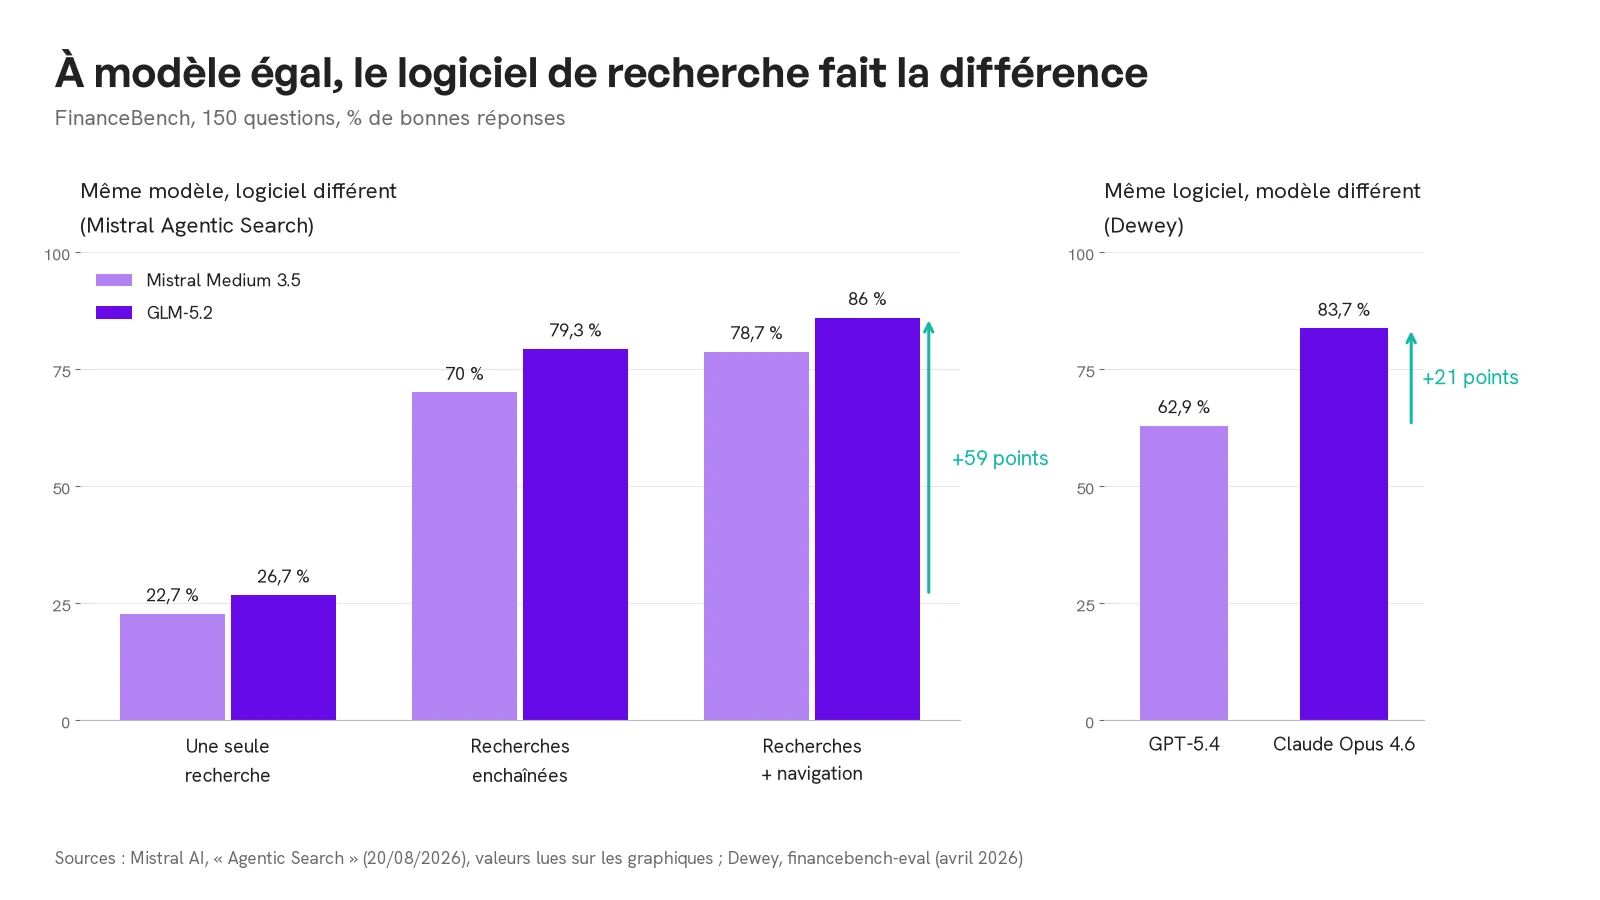 Graphique en deux parties. À gauche, même modèle et logiciel différent : Mistral Medium 3.5 passe de 22,7 % à 70 % puis 78,7 %, GLM-5.2 de 26,7 % à 79,3 % puis 86 %. À droite, même logiciel et modèle différent chez Dewey : 62,9 % pour GPT-5.4, 83,7 % pour Claude Opus 4.6
La boucle de recherche fait gagner 47,3 points à Mistral Medium 3.5 et 52,6 points à GLM-5.2 ; la navigation en ajoute encore 8,7 et 6,7. Au total, le même modèle triple sa précision sans qu'on touche à ses paramètres. Mistral note aussi que la navigation réduit la consommation de tokens d'un quart à un tiers : chercher mieux coûte moins cher que chercher beaucoup.
Le modèle compte encore. Dewey a fait l'expérience inverse : même ingestion, même moteur de recherche agentique, seul le modèle change. Claude Opus 4.6 atteint 83,7 %, GPT-5.4 62,9 %, soit 21 points d'écart. Mais le même billet montre qu'Opus fait en moyenne 21,2 appels à l'outil de recherche par question, contre 9,4 pour GPT-5.4 : une partie de l'écart tient à la façon dont chaque modèle se sert du logiciel. Le modèle compte ; le logiciel compte plus, avec 56 à 59 points d'écart chez Mistral contre 21 chez Dewey.
Notre propre expérience va dans le même sens. Sur FinanceBench, remplacer Qwen 3.8 27B, le modèle qui rédige les réponses d'ATG, par Gemini 3.8 Flash ne change pas le score de façon significative [À COMPLÉTER : score exact obtenu avec Gemini 3.8 Flash]. Nous avons aussi passé le test avec le même modèle chez deux hébergeurs différents, l'un mondial, l'autre européen : 138 et 139 bonnes réponses sur 150. Seul le temps de réponse change : 10,5 secondes en moyenne d'un côté, 30,9 de l'autre.
Ce que fait ce logiciel : chercher, ouvrir, choisir, s'arrêter
Le logiciel qui pilote la recherche prend quatre décisions que le modèle seul ne prend pas. Il réduit le périmètre avant de chercher : la société, l'exercice, le type de document. C'est ce qui permet à un RAG de tenir sur des dizaines de milliers de documents, comme nous l'expliquons dans notre article sur le nombre de documents qu'un RAG peut traiter. Il enchaîne les recherches quand la première ne suffit pas. Il ouvre et parcourt un rapport quand l'information est dans un tableau que les extraits découpent mal. Enfin, il s'arrête : il décide qu'il a assez d'éléments, ou qu'il n'a pas trouvé et doit le dire.
Un exemple tiré de nos rapports FinanceBench montre ces décisions à l'œuvre. Question : « Was there any drop in Cash & Cash equivalents between FY 2023 and Q2 of FY2024? », pour Best Buy. La réponse demande deux documents de deux périodes différentes, parmi les rapports annuels, trimestriels et communiqués du même distributeur. ATG a cité le rapport annuel 2023 et le communiqué du deuxième trimestre 2024 : 1 874 millions de dollars à la clôture de l'exercice 2023, 1 093 millions au deuxième trimestre de l'exercice suivant, soit une baisse de 41,7 %. La réponse attendue était « environ 42 % ». ATG a précisé au passage que l'exercice de Best Buy se termine fin janvier, ce qui décale tous les libellés d'un an. Une recherche, 7,2 secondes.
Le piège des documents semblables
Une base de rapports financiers est un cas difficile pour une raison simple : les documents se ressemblent. Le rapport annuel 2022 et le rapport annuel 2023 d'une même société ont la même structure, les mêmes intitulés, souvent les mêmes phrases. Une recherche par similarité de sens les met sur le même plan. Si le logiciel ne filtre pas sur l'exercice, le modèle reçoit le bon tableau de la mauvaise année, et il l'interprète parfaitement.
FinanceBench en donne un indice. Onze des questions d'origine ne nomment ni l'exercice ni la société (« this 10-K report ») : elles avaient été écrites pour un seul document, alors que la base en contient plusieurs pour chaque entreprise. Posées telles quelles, elles n'ont pas de réponse unique. Dans notre protocole, nous leur avons ajouté une phrase fixe qui précise la période ou la société, sans toucher au reste de la question.
Une data room de due diligence pousse ce piège plus loin. On y trouve trois exercices de comptes, des liasses par filiale, plusieurs versions d'un même contrat, des tableaux Excel qui reprennent les chiffres des PDF. Une bonne réponse tirée du mauvais exercice reste une mauvaise réponse, et c'est au logiciel, pas au modèle, de choisir le bon document. Les voies pour donner à une IA l'accès à ces documents (API, MCP, export) font l'objet de notre article sur les data rooms et l'IA.
Ce que cela change pour une due diligence
Chaque configuration de FinanceBench correspond à une situation de due diligence.
| Configuration FinanceBench | Situation en due diligence | GPT-4 Turbo (2023) |
|---|---|---|
| aucun document | demander à un assistant grand public ce qu'il sait de la cible | 9 % |
| toute la base de rapports | interroger toute la data room | 19 % |
| le bon rapport, en extraits | téléverser le rapport annuel dans un assistant | 50 % |
| la bonne page | copier-coller un tableau dans l'assistant | 85 % |
La ligne qui compte est la deuxième. C'est la seule qui ressemble au travail réel : des centaines de documents, une question, et personne pour indiquer où se trouve la réponse. C'est aussi celle où l'écart entre logiciels est le plus grand, et celle qu'une démonstration sur un seul fichier ne teste pas.
Comment lire la démonstration d'un outil d'IA
Quand une démonstration se fait sur un PDF téléversé devant le client, elle prouve que le modèle interprète bien un rapport. Elle ne dit rien de sa capacité à trouver ce rapport parmi cinq cents autres, qui est la difficulté d'une data room.
Trois questions départagent les outils mieux que le nom du modèle. La démonstration porte-t-elle sur un fichier choisi d'avance, ou sur toute la base ? Que fait le logiciel autour du modèle : une seule recherche, ou une enquête qui ouvre les documents et filtre par société et par exercice ? Et quand l'information n'existe pas, l'outil le dit-il ? Une quatrième question les complète : l'éditeur publie-t-il une mesure de précision sur un test public, avec ses conditions ? Choisir un outil pour son modèle, c'est regarder la mauvaise variable.
Pour les équipes M&A, transaction services et fonds, nous décrivons notre approche de la due diligence financière : data room, comptes, Excel, avec une citation pour chaque réponse.
Nos résultats sur FinanceBench
Nous avons passé FinanceBench dans les conditions de la deuxième ligne du tableau : 368 rapports dans une base de connaissances ATG standard, chaque question posée seule, sans indiquer le bon document. ATG répond juste à 138 questions sur 150 (92 %) avec un temps de réponse moyen de 10,5 secondes, et en moyenne 1,5 appel à l'outil de recherche par question. Le protocole, chaque question, chaque réponse et chaque verdict sont publiés sur notre page FinanceBench. Les conditions de notation diffèrent d'une source à l'autre (notation humaine chez Patronus AI, juge automatique ailleurs) : ces chiffres situent les approches, ils ne font pas un classement.
Questions fréquentes sur la recherche agentique en due diligence
Qu'est-ce que la recherche agentique (agentic search) ?
La recherche agentique désigne un logiciel qui pilote la recherche d'information pour un modèle de langage. Au lieu de lancer une seule recherche et de répondre avec les extraits obtenus, il enchaîne les recherches, filtre par société ou par période, ouvre et parcourt les documents, vérifie ce qu'il a trouvé et décide quand s'arrêter. Sur FinanceBench, cette approche fait passer un même modèle de 26,7 % à 86 % de bonnes réponses selon Mistral.
Le choix du modèle d'IA compte-t-il encore pour analyser des documents financiers ?
Oui, mais moins que le logiciel de recherche. Chez Dewey, avec le même logiciel, Claude Opus 4.6 et GPT-5.4 sont séparés de 21 points sur FinanceBench. Chez Mistral, avec le même modèle, le changement de méthode de recherche fait gagner 56 à 59 points. Le modèle reste décisif pour d'autres tâches, comme rédiger une analyse longue ou comprendre une question mal formulée.
Pourquoi une IA se trompe-t-elle davantage sur une data room que sur un seul PDF ?
Parce qu'elle doit d'abord trouver le bon document. Sur FinanceBench, GPT-4 Turbo répond juste à 50 à 79 % des questions quand on lui donne le bon rapport, et à 19 % quand il doit le chercher dans toute la base. Les documents semblables (exercices successifs, versions, filiales) aggravent l'écart : une recherche par similarité de sens les confond facilement.
Comment évaluer un outil d'IA pour la due diligence ?
Le test le plus parlant pose de vraies questions sur un ensemble de documents complet, sans indiquer à l'outil où se trouve la réponse, et inclut des questions dont la réponse n'est pas dans les documents. On regarde alors la justesse des réponses, la citation de la source, le temps de réponse et la capacité de l'outil à dire qu'il n'a pas trouvé. Un éditeur qui publie ses résultats sur un test public comme FinanceBench permet de comparer avant même l'essai.
Changer de modèle tient en une ligne de configuration. Le logiciel qui le pilote se construit plus lentement : filtres, navigation, choix du bon exercice, refus de répondre sans source. En due diligence, c'est lui qui fait la différence, et c'est sur une vraie data room, pas sur un PDF choisi d'avance, qu'on le voit travailler.