Combien de documents un RAG peut-il traiter ?
Un RAG maison plafonne à quelques milliers de documents par agent, moins s'ils se ressemblent. Un RAG agentique qui filtre d'abord en traite plus de 100 000.
Combien de documents un RAG peut-il traiter ? Tout dépend de son architecture. Un RAG simple, celui qu'on monte en interne avec une base vectorielle et une recherche sur tout le corpus, reste fiable jusqu'à quelques centaines, au mieux quelques milliers de documents par agent. Au-delà, le stockage tient, c'est la précision de la recherche qui décroche. Et le seuil baisse encore quand les documents se ressemblent : quelques centaines de contrats bâtis sur le même modèle pour des clients différents suffisent à dérouter un RAG simple. Un RAG agentique, qui filtre le corpus avant de lancer la recherche vectorielle, absorbe plus de 100 000 documents. Chez plusieurs de nos clients, les agents ATG travaillent en production sur plus de 100 000 documents, soit plus d'un million de pages.
Les deux chiffres circulent et ils sont vrais tous les deux. Ils décrivent deux systèmes différents.
D'où vient le chiffre de « quelques centaines de documents » ?
Il a deux origines, et aucune ne dit grand-chose de la technologie RAG elle-même.
La première, ce sont les plafonds des outils grand public. Quand on cherche « combien de documents peut-on donner à une IA », on tombe sur les limites affichées par les produits que tout le monde connaît. En octobre 2026, NotebookLM accepte 50 sources par carnet en version gratuite et quelques centaines dans les offres payantes. Les projets ChatGPT et les GPT personnalisés acceptent quelques dizaines de fichiers selon l'abonnement. Ce sont des choix produit, calibrés pour une personne qui travaille sur un dossier.
La seconde, ce sont les retours d'expérience des RAG maison. Le tutoriel classique (découper les documents, calculer des embeddings, chercher les dix extraits les plus proches, les donner au modèle) donne une démo bluffante sur cinquante documents. Puis les équipes ajoutent des fichiers, et la qualité baisse sans que rien ne casse. D'où un consensus empirique : « au-delà de quelques milliers de documents, ça ne marche plus très bien ».
Ce consensus est juste, pour cette architecture-là.
Pourquoi un RAG simple perd en précision quand le corpus grossit
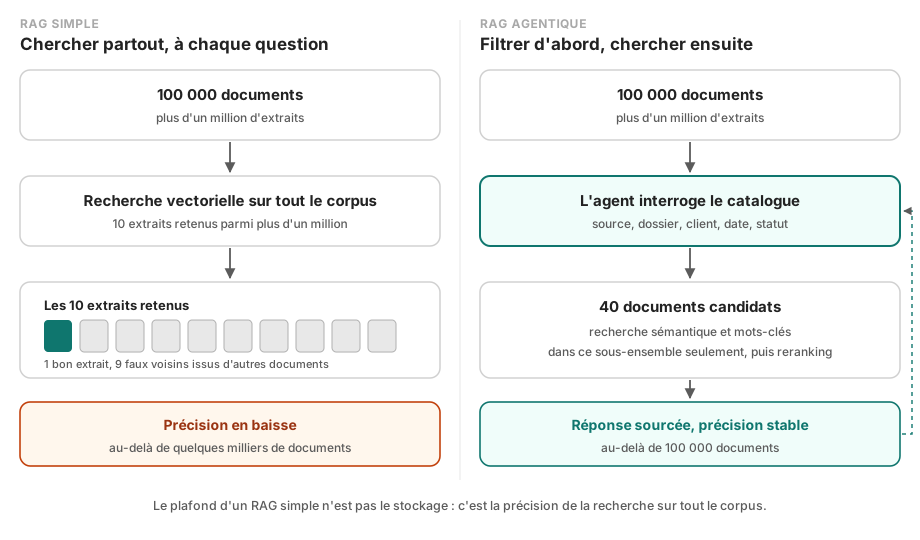
Un RAG simple fonctionne comme ceci : la question est transformée en vecteur, le système cherche dans tout le corpus les extraits dont le vecteur est le plus proche, il en garde un nombre fixe (souvent entre 5 et 20), et le modèle répond à partir de ces extraits seulement.
Sur 50 documents, l'opération est triviale. Sur un million de pages, le même mécanisme doit choisir dix extraits parmi plus d'un million. Chaque document ajouté apporte son lot de passages qui parlent à peu près du sujet de la question sans y répondre, et ils finissent par occuper les dix places.
Les anciennes versions aggravent les choses. Plus la base est grosse, plus elle contient de brouillons et de copies. La procédure de 2022 et celle de 2026 se ressemblent beaucoup, et le système n'a aucune raison de préférer la bonne.
Les noms propres aussi. Un nom de client, une référence produit ou un code projet sont souvent le seul mot qui compte dans une question, et c'est celui qu'un embedding représente le plus mal : ce sont des clés, sans sens général. Nous l'avons détaillé dans notre article sur la recherche hybride.
Le résultat est sournois : l'assistant continue de répondre avec assurance, en citant des sources. Simplement, de moins en moins souvent la bonne.
Des documents qui se ressemblent : le pire cas pour un RAG simple
À mon sens, c'est le point le plus mal compris du sujet. On parle de volume, et on oublie la ressemblance. Deux corpus de même taille peuvent pourtant se comporter de façon opposée.
Prenez 5 000 documents hétérogènes : règlement intérieur, fiches produits, procédures qualité, notes juridiques. Une question sur les congés tombe naturellement sur les documents RH, parce que leur sens se distingue de tout le reste. Le RAG simple s'en sort plutôt bien.
Prenez maintenant 500 contrats clients rédigés sur le même modèle. Un commercial demande : « Quel est le préavis de résiliation dans le contrat Durand ? » Les 500 contrats ont tous une clause de résiliation, presque mot pour mot. Pour la recherche vectorielle, ce sont 500 passages équivalents. Ce qui les distingue tient en un mot, Durand, et c'est justement celui qu'elle capte le moins bien. Les dix extraits retenus viendront de dix clients pris au hasard, et le reranking n'y changera rien : il reclasse les extraits qu'on lui donne, et le bon n'en fait probablement pas partie.
Plus les documents se ressemblent, plus un RAG simple dysfonctionne, et plus tôt. Le plafond de « quelques milliers » tombe alors à quelques centaines.
Ce cas n'a rien de marginal. Contrats, rapports d'audit, dossiers de due diligence, comptes rendus de visite, réponses à appels d'offres : c'est le quotidien des cabinets de conseil, d'audit et d'avocats, des équipes M&A, des assureurs, des bureaux d'études. Ces métiers produisent le même type de livrable pour des dizaines ou des centaines de clients, et ce sont ces documents-là qui ont le plus de valeur pour eux.
La parade consiste à traiter le nom du client comme un filtre, appliqué avant toute recherche de sens, et non comme un mot noyé dans un vecteur. C'est le principe du RAG agentique.
Ce que la recherche dit du passage à l'échelle
Une étude publiée en juillet 2026, BM25 Wins at Scale, a mesuré plusieurs architectures RAG sur un corpus agrandi progressivement, sur un facteur de 450, avec les mêmes questions du début à la fin. Deux résultats nous intéressent.
La recherche vectorielle seule reste rapide, mais elle perd en exactitude face à la recherche par mots-clés quand le corpus grossit. On retrouve les passages « à peu près sur le sujet » décrits plus haut.
Un agent qui explore les fichiers sans index, comme quelqu'un qui ouvrirait les dossiers un par un, est excellent sur un petit corpus et s'effondre à grande échelle : il consomme 39 fois plus de tokens et finit près de 20 points derrière. Les auteurs concluent que le raisonnement agentique donne son meilleur après une première recherche classée.
Il faut donc les deux : des index qui trouvent vite, et un agent qui raisonne sur ce qu'ils trouvent.
Le RAG agentique : filtrer avant de chercher
Un documentaliste à qui l'on demande le préavis du contrat Durand ne relit pas les 500 contrats. Il va dans le dossier Clients, ouvre le sous-dossier Durand, prend la dernière version du contrat et cherche la clause.
Un RAG agentique fait la même chose. Avant toute recherche vectorielle, l'agent réduit le périmètre.
- Il comprend ce que la question désigne : un document précis (le contrat), un client (Durand), une notion (le préavis de résiliation).
- Il interroge le catalogue documentaire. Sources, dossiers, chemins, dates, statuts : le catalogue répond de façon déterministe, sans approximation sémantique. Le périmètre passe de 100 000 documents à une poignée.
- Il cherche dans ce sous-ensemble seulement, en combinant recherche sémantique et recherche par mots-clés, puis trie les extraits par reranking. Les 499 autres clauses de résiliation ne sont même plus candidates.
- Il vérifie. Si les extraits ne suffisent pas, il lit le document en entier, ou repart chercher avec ce qu'il vient d'apprendre.
La recherche vectorielle ne choisit plus dix extraits parmi un million, mais parmi quelques centaines, là où elle est très fiable. La taille totale du corpus cesse d'être le facteur limitant, puisque la recherche fine ne porte jamais sur tout le corpus.
Schéma comparant deux architectures RAG sur 100 000 documents. À gauche, le RAG simple lance une recherche vectorielle sur tout le corpus et retient dix extraits, dont beaucoup de faux voisins issus d'autres documents. À droite, le RAG agentique interroge d'abord le catalogue documentaire pour réduire le périmètre à une quarantaine de documents, puis lance une recherche hybride avec reranking dans ce sous-ensemble et produit une réponse sourcée.
RAG simple ou RAG agentique : la comparaison
| RAG simple | RAG agentique avec filtrage | |
|---|---|---|
| Volume fiable par agent | Quelques centaines à quelques milliers de documents | Plus de 100 000 documents, plus d'un million de pages |
| Périmètre de la recherche | Tout le corpus, à chaque question | Sous-ensemble choisi par l'agent |
| Documents de même typologie pour des clients différents | Le pire cas : dysfonctionne dès quelques centaines | Le client devient un filtre, appliqué avant la recherche |
| Noms propres et références | Mal retrouvés | Retrouvés par mots-clés et par le catalogue |
| Questions d'inventaire (« combien de contrats… ») | Réponse approximative ou fausse | Réponse exacte, depuis le catalogue |
| Versions concurrentes | Mélangées | Arbitrées par date, statut ou dossier |
| Temps de réponse | Quelques secondes | Quelques secondes de plus, selon les allers-retours |
Le RAG agentique a un coût. Chaque étape consomme des tokens et du temps, et un agent sans garde-fou peut tourner en rond. Il faut borner le nombre d'allers-retours et tracer chaque source, faute de quoi le système devient lent et ses réponses invérifiables.
Découper en plusieurs agents : une fausse solution
Quand un RAG simple sature, le réflexe est de créer un agent par service, puis par sujet, voire par client, pour garder chaque corpus sous la barre des quelques milliers de documents. C'est de là que vient l'idée d'une limite « par agent ».
Ça marche, mais la charge passe à l'utilisateur : c'est lui qui doit savoir quel agent interroger. La question « est-ce qu'on tient nos engagements avec Durand ? » touche à la fois les contrats, le support et la facturation, et trois agents cloisonnés ne peuvent pas y répondre. Quant à un agent par client, avec 300 clients, il devient vite ingérable.
Il existe de bonnes raisons de séparer des agents, et elles tiennent aux droits d'accès : un agent RH n'a pas à lire les contrats clients. Chez ATG, ce périmètre se règle avec les catégories de connaissances affectées à chaque agent.
Ce qu'il faut pour tenir 100 000 documents en production
L'architecture agentique lève le plafond de précision. D'autres sujets apparaissent à cette échelle, et mieux vaut les connaître avant.
L'ingestion devient un projet industriel. Un million de pages, ce sont des PDF scannés, des tableurs, des présentations, et une facture d'OCR loin d'être anecdotique. Nous avons chiffré l'écart entre une API et un modèle open weight sur un million de pages dans notre comparatif Mistral OCR et PaddleOCR : de 4 000 $ à moins de 200 $.
Le filtrage vaut ce que valent les métadonnées. L'agent s'appuie sur ce que le catalogue sait : source, dossier, date, auteur, statut. Une arborescence SharePoint cohérente lui rend bien plus service qu'un dossier « Divers » de 40 000 fichiers.
La synchronisation doit être incrémentale. On ne réindexe pas un million de pages chaque nuit, seulement les documents modifiés.
La qualité se mesure sur de vraies questions. Un RAG à 100 000 documents ne se valide pas avec dix questions en comité. Il faut des centaines de questions représentatives, dont des questions pièges : un document précis parmi des milliers de semblables, une référence interne, une question d'inventaire.
Comment tester la volumétrie d'une solution RAG avant de l'acheter
Un éditeur qui annonce « illimité » ne dit rien. Quatre tests suffisent à départager les solutions, et nous les ferions passer à n'importe qui, nous compris.
- Demandez le volume en production, pas en démo : combien de documents et de pages chez un client réel, et sur combien d'agents.
- Cherchez une aiguille parmi des documents jumeaux. Choisissez un document noyé parmi des centaines de documents de même typologie (le contrat d'un client parmi tous les contrats, un rapport d'audit parmi tous les rapports) et posez une question dont la réponse ne se trouve que dans celui-là. C'est le test le plus discriminant.
- Posez une question avec un nom propre ou une référence interne, que la recherche sémantique seule retrouve mal.
- Posez une question d'inventaire, du type « combien de contrats signés en 2025 ? ». Une réponse approximative trahit une recherche sans catalogue.
L'approche Ask This Guy
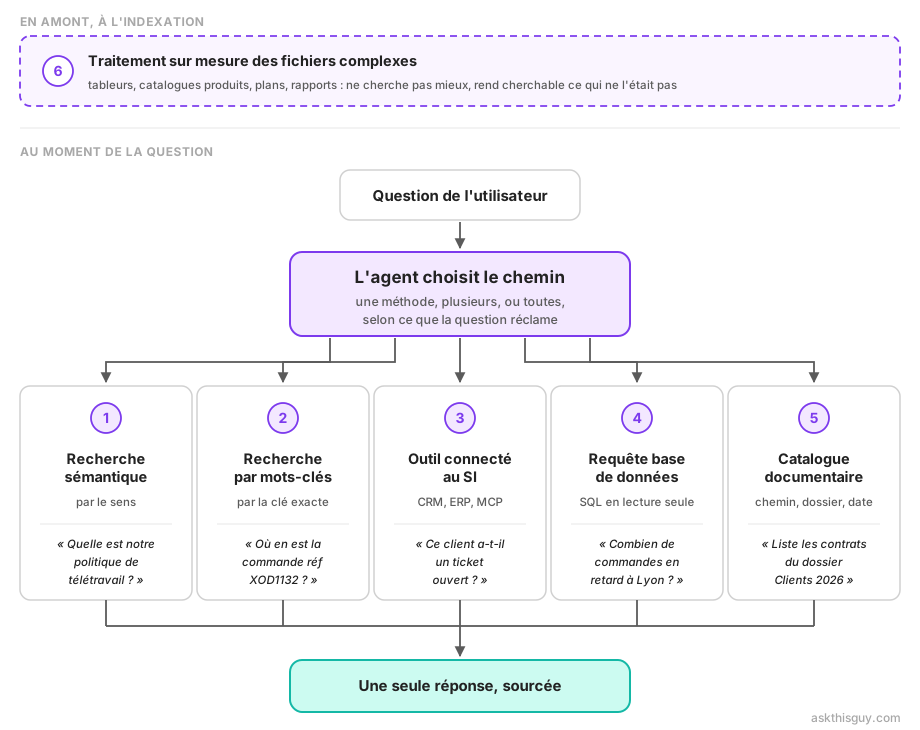
Chez Ask This Guy, l'agent pilote la recherche. Il dispose de plusieurs outils complémentaires : le catalogue documentaire pour situer et dénombrer les documents, la recherche de documents pertinents pour identifier un fichier, la recherche hybride (sémantique et mots-clés) pour trouver le passage, le reranking pour garder les meilleurs extraits, et la lecture intégrale quand un extrait ne suffit pas.
Nos clients connectent ainsi plus de 100 000 documents, soit plus d'un million de pages, à un même agent, sans découper leur base pour rester sous un seuil. Les réponses citent leurs sources, quelle que soit la taille du corpus.
Si votre projet bute sur la volumétrie, découvrez notre RAG entreprise clé en main, ou réservez une démo pour le tester sur vos propres documents.
Questions fréquentes sur le nombre de documents d'un RAG
Combien de documents un RAG peut-il traiter ?
Cela dépend de son architecture. Un RAG simple, qui lance une recherche vectorielle sur tout le corpus à chaque question, reste fiable jusqu'à quelques centaines ou quelques milliers de documents par agent, et moins encore quand les documents se ressemblent. Un RAG agentique, qui filtre le corpus avant de chercher, traite plus de 100 000 documents, soit plus d'un million de pages : c'est le volume que gèrent des agents Ask This Guy en production. La limite vient de la précision de la recherche ; le stockage, lui, suit sans difficulté.
Pourquoi un RAG perd-il en précision quand le nombre de documents augmente ?
Parce qu'un RAG simple choisit un nombre fixe d'extraits, souvent dix, parmi tout le corpus. Plus le corpus grossit, plus il contient de passages proches du sens de la question sans être la bonne réponse : clauses similaires de contrats différents, anciennes versions, copies. Les noms propres et les références internes, mal représentés par les embeddings, aggravent le problème. La bonne réponse finit par ne plus figurer parmi les extraits retenus.
Pourquoi un RAG fonctionne-t-il mal sur des documents similaires ?
Parce que la recherche vectorielle compare le sens des passages, et que des documents de même typologie (contrats sur le même modèle, rapports d'audit, dossiers clients) ont presque tous le même sens. Ce qui les distingue, un nom de client, une date, un montant, est justement ce qu'un embedding capte le moins bien. Un RAG simple ramène alors des passages d'autres clients. La solution consiste à filtrer d'abord sur le client, le dossier ou la source, puis à chercher dans ce sous-ensemble seulement.
Qu'est-ce que le filtrage avant la recherche vectorielle dans un RAG ?
C'est l'étape où l'agent réduit le périmètre avant de chercher le sens. Il interroge le catalogue documentaire (source, dossier, date, statut, nom du client ou du projet) pour isoler les quelques documents concernés, puis lance la recherche sémantique et par mots-clés dans ce sous-ensemble seulement. L'agent décide de ce filtre à partir de la question, sans que l'utilisateur ait à le préciser.
Un RAG peut-il traiter un million de pages ?
Oui, à condition de ne pas chercher dans le million de pages à chaque question. Un RAG agentique filtre d'abord le corpus, puis cherche dans un sous-ensemble réduit, ce qui garde la recherche précise quelle que soit la taille totale. Un million de pages pose surtout des questions d'ingestion : coût de l'OCR, synchronisation incrémentale des documents modifiés, qualité des métadonnées.
Faut-il créer plusieurs agents pour répartir un grand nombre de documents ?
Pas pour des raisons de volume, si l'architecture filtre avant de chercher. Répartir les documents entre plusieurs agents oblige l'utilisateur à savoir lequel interroger, et empêche de répondre aux questions qui croisent plusieurs domaines. Le bon critère pour séparer des agents est celui des droits d'accès : un agent RH n'a pas à lire les contrats clients.
Conclusion
« Quelques centaines, au plus quelques milliers de documents » : la réponse que l'on trouve en ligne est juste pour un RAG simple, et elle explique pourquoi tant de projets internes plafonnent après le POC. Elle décrit une architecture précise, celle qui cherche partout à chaque question.
Le nombre de documents n'est d'ailleurs que la moitié du problème. À volume égal, des documents qui se ressemblent font échouer un RAG simple bien plus tôt.
Un agent qui sait d'abord où chercher, avant de chercher quoi, fait disparaître le plafond, y compris sur des centaines de documents jumeaux. On passe alors de quelques milliers de documents à plus de 100 000, et l'entreprise peut enfin connecter toute sa base documentaire plutôt qu'un échantillon soigneusement choisi.
.webp)