Reranking RAG : définition, reranker et cross-encoder
Le reranking reclasse les passages trouvés par un RAG avant de les donner au LLM. Reranker, cross-encoder, bi-encoder, RRF, coût, latence : quand l'utiliser.
Le reranking est l'étape d'un RAG qui reclasse les passages trouvés par la recherche avant de les donner au LLM. Un modèle spécialisé, le reranker, relit chaque passage avec la question, lui attribue une note de pertinence, puis on ne garde que les mieux notés. Dans les tests d'Anthropic, ajouter un reranker a fait passer le taux d'échec de la recherche de 2,9 % à 1,9 %.
Pourquoi une seconde étape ? Parce que la recherche d'un RAG est rapide mais approximative : elle compare des vecteurs calculés à l'avance, sans jamais lire la question et le passage ensemble. Le reranker, lui, les lit ensemble. Il est plus précis, mais beaucoup plus lent : sur le banc d'essai BEIR, reclasser les 100 premiers résultats avec un cross-encoder améliore la pertinence de 11 % en moyenne, mais demande 450 ms par requête sur GPU, contre 20 ms pour la recherche par mots-clés seule.
Le reranking a donc une limite nette : il trie ce que la recherche a trouvé, et rien d'autre. Bien placé, il améliore les réponses pour un coût modeste. Mal placé, il ajoute de la latence sans rien rattraper. Reste à choisir entre cross-encoder, API, LLM juge ou simple fusion RRF, et à mesurer le gain sur vos propres documents.
Qu'est-ce que le reranking dans un RAG ?
Un RAG répond à une question en deux temps : il cherche dans vos documents les passages utiles, puis il les transmet au LLM qui rédige la réponse. Le reranking s'insère entre les deux. La recherche ramène une liste large de candidats, un reranker note chacun d'eux et la liste est réordonnée, puis coupée.
Loading diagram…
Le reranker n'interroge pas l'index : il reçoit la liste produite par la recherche, note chaque passage au regard de la question, et ne transmet au LLM que les meilleurs, dans l'ordre.
Les volumes varient selon les systèmes. La documentation de Sentence Transformers prend l'exemple d'une centaine de candidats à reclasser. Anthropic, dans sa méthode Contextual Retrieval, reclasse les 150 premiers passages et en garde 20.
L'ordre final compte autant que la sélection. Une étude publiée en 2023 a montré qu'un LLM exploite mieux une information placée au début ou à la fin de son contexte qu'au milieu. Un bon passage noyé en douzième position risque d'être moins bien utilisé qu'en tête de liste. Le reranker décide de ce que le LLM lit en premier.
Bi-encoder ou cross-encoder : quelle différence ?
Le reranking repose sur deux façons de comparer une question et un passage.
Un bi-encoder encode la question et chaque passage séparément, sous forme de vecteurs (les embeddings). Les vecteurs des documents sont calculés une fois pour toutes, à l'indexation. À la question, il suffit de calculer un vecteur et de chercher ses plus proches voisins, ce qui prend une quinzaine de millisecondes sur un million de passages avec un GPU. C'est la recherche sémantique classique, celle dont nous avons raconté nos choix de modèles et de fournisseurs.
Un cross-encoder lit la question et le passage ensemble, dans le même modèle, et renvoie directement un score. Chaque mot de la question peut « regarder » chaque mot du passage : c'est ce qui le rend plus précis. Mais rien ne se calcule à l'avance : chaque couple question-passage demande un passage complet dans le modèle.
L'écart de coût est vertigineux. Selon les auteurs de Sentence-BERT, trouver la paire la plus proche dans 10 000 phrases avec un cross-encoder BERT demande environ 65 heures, contre 5 secondes avec des vecteurs pré-calculés. D'où l'architecture en deux étages : le bi-encoder pour chercher, le cross-encoder pour trier.
Le gain de précision, lui, est mesuré depuis 2019. Dès janvier de cette année-là, un reranker fondé sur BERT dépassait l'état de l'art de 27 % (en relatif) sur le banc d'essai MS MARCO de Microsoft.
Entre les deux existe une voie médiane, la late interaction, popularisée par ColBERT : un vecteur par mot plutôt qu'un vecteur par passage, comparés finement au moment de la requête. Ses auteurs annoncent une qualité proche des cross-encoders pour deux ordres de grandeur de rapidité en plus.
| Bi-encoder | Late interaction (ColBERT) | Cross-encoder | |
|---|---|---|---|
| Lecture question et passage | Séparée | Séparée, comparaison mot à mot | Ensemble |
| Calcul à l'avance | Oui, un vecteur par passage | Oui, un vecteur par mot | Non |
| Vitesse | Millisecondes sur des millions de passages | Intermédiaire | Quelques dizaines de passages par requête |
| Précision | Bonne | Très bonne | La meilleure |
| Rôle dans un RAG | Recherche | Recherche ou reranking | Reranking |
Les quatre familles de rerankers
Les cross-encoders open weight
Ce sont des modèles téléchargeables, que l'on fait tourner soi-même. Le modèle bge-reranker-v2-m3 de BAAI (Beijing Academy of Artificial Intelligence) compte 600 millions de paramètres, est multilingue, sous licence Apache 2.0, et totalise plus de 14 millions de téléchargements sur le dernier mois au 6 novembre 2026. Alibaba publie la famille Qwen3-Reranker en 0,6, 4 et 8 milliards de paramètres, sous Apache 2.0, pour plus de 100 langues. Mixedbread propose mxbai-rerank-large-v2, également sous Apache 2.0.
Attention aux licences : jina-reranker-v3 est sous CC BY-NC 4.0, qui interdit l'usage commercial sans accord de l'éditeur. Des poids téléchargeables ne garantissent pas un usage libre.
L'atout de cette famille est la maîtrise. Un reranker de 600 millions de paramètres tourne sur vos serveurs, sur un GPU modeste, et les passages de vos documents ne sortent pas de votre infrastructure. C'est la voie naturelle pour une entreprise qui impose un traitement des données en Europe.
Les rerankers en API
Cohere, Voyage AI et Jina AI vendent le reranking à l'appel. Cohere a sorti le 21 octobre 2026 Rerank 5, facturé 0,05 dollar par million de tokens en version Pro et 0,02 dollar en version Fast, et évalué sur 20 langues, dont le français. Voyage AI pratique les mêmes prix pour rerank-3 et rerank-3-lite.
Deux de ces fournisseurs appartiennent désormais à des éditeurs de bases de données et de moteurs de recherche : MongoDB a racheté Voyage AI en février 2025, Elastic a finalisé le rachat de Jina AI en octobre 2025.
L'API évite d'exploiter un modèle, mais chaque passage candidat part chez le fournisseur. Pour un DSI, un reranker en API est un sous-traitant de données comme un autre, avec son contrat, sa localisation et sa politique de conservation. Cohere propose un déploiement privé, dans votre cloud ou sur site, sur demande commerciale.
Le LLM comme reranker
On peut aussi demander à un LLM de juger la pertinence de chaque passage, ou de classer directement une liste. Des chercheurs ont montré en 2023 que ChatGPT et GPT-4, bien guidés, obtiennent des résultats compétitifs, voire supérieurs aux méthodes supervisées. Le même article montre qu'un petit modèle de 440 millions de paramètres, entraîné à imiter ces classements, bat un modèle supervisé de 3 milliards.
L'avantage tient à la question posée : avec un LLM, le critère de pertinence s'écrit en toutes lettres au lieu d'être figé à l'entraînement. C'est ce que nous faisons avec Jev, un modèle qui répond à une question fermée par une probabilité. Sur sa première journée en production, il a ramené les passages de 10,7 à 7,7 par recherche, pour 0,70 dollar les 1 000 recherches.
L'inconvénient : un LLM généraliste coûte plus cher et répond plus lentement qu'un cross-encoder spécialisé. Un modèle conçu pour décider, sans générer de texte, réduit l'écart.
La recherche hybride et la fusion RRF
Dernière famille, et la plus simple : ne pas utiliser de modèle du tout. Une recherche hybride lance en parallèle une recherche par mots-clés et une recherche sémantique. Il faut ensuite fusionner deux listes dont les scores ne se comparent pas : celui de la recherche lexicale est sans borne supérieure, celui de la recherche sémantique borné.
La Reciprocal Rank Fusion (RRF) contourne le problème en ignorant les scores. Chaque document reçoit, pour chaque liste où il apparaît, 1 / (60 + son rang), et on additionne. Proposée en 2009 par des chercheurs de l'université de Waterloo et de Google, elle battait de 4 à 5 % le meilleur des systèmes fusionnés. Elasticsearch l'applique avec la même constante de 60 par défaut.
RRF n'est pas un reranker au sens strict : elle ne lit pas le texte. Mais c'est un algorithme déterministe, gratuit et instantané. Avant d'ajouter un modèle, vérifiez ce que RRF donne seule.
Le reranking vaut-il son coût ?
Ce que coûte la latence
Le temps ajouté est la vraie contrainte. Sur BEIR, en 2021, reclasser 100 passages avec un petit cross-encoder prenait 450 ms sur GPU et 6,1 secondes sur CPU, quand la recherche par mots-clés seule prenait 20 ms. Le matériel et les modèles ont progressé : Cohere annonce que Rerank 5 Fast traite environ 187 documents de 1 000 tokens par seconde sur une carte A100. Anthropic résume : le reranking ajoute « inévitablement un peu de latence », et plus on reclasse de passages, plus elle augmente.
Deux leviers limitent la note : réduire le nombre de candidats, et paralléliser les appels. Chez nous, tous les appels de reranking d'une recherche partent en même temps, si bien que le délai dépend de la longueur des passages, pas de leur nombre.
Ce que coûte la facture
En API, le reranking se paie au token. Prenons 50 passages de 400 tokens : environ 20 000 tokens par recherche, soit 0,001 dollar au tarif de Cohere Rerank 5 Pro, ou un dollar pour 1 000 recherches. À cette échelle, la facture du reranking pèse peu à côté de celle du LLM qui rédige la réponse. Et elle peut faire baisser cette dernière : moins de passages transmis, c'est moins de tokens lus par le LLM, ce qu'Anthropic relève aussi. Nous faisons le même constat avec Jev : la facture ne pèse rien, le temps ajouté se surveille.
Quand s'en passer
Le reranking n'apporte rien, ou presque, dans plusieurs cas :
- la recherche ramène peu de candidats : si vous transmettez de toute façon les 5 premiers passages, les reclasser change peu ;
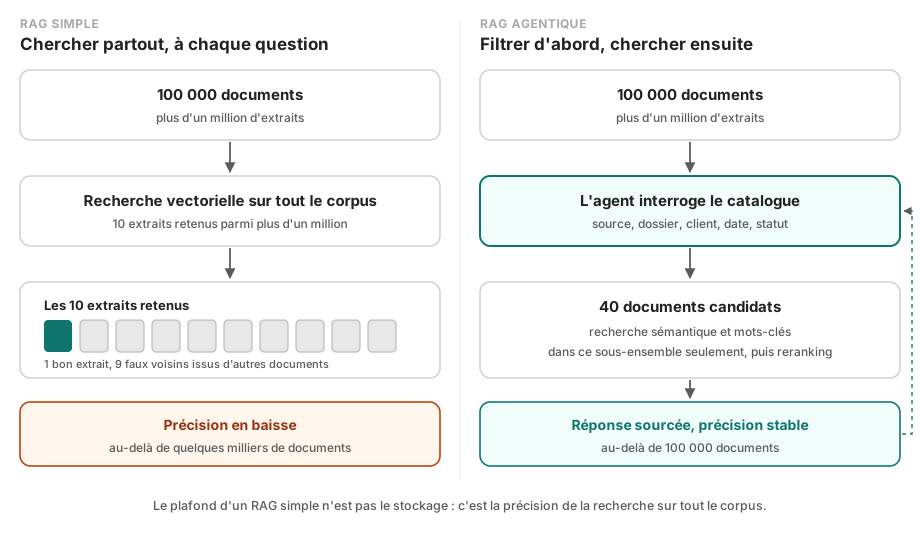
- la question porte sur une référence exacte (un numéro de commande, un code projet) : la recherche par mots-clés trouve la bonne ligne, il n'y a rien à départager ;
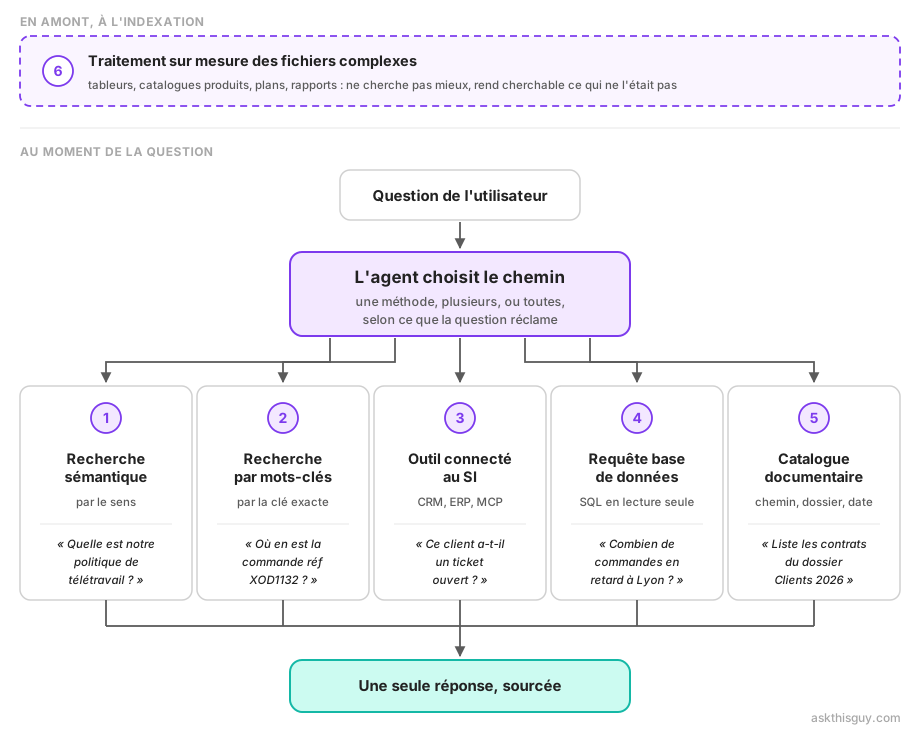
- le bon passage n'est pas dans la liste : un reranker ne retrouve rien, il reclasse. Si la recherche rate le passage, aucun reranker ne le rattrapera ;
- la latence est critique, comme dans une saisie semi-automatique.
C'est la règle que nous appliquons partout : l'IA seulement là où la tâche n'est pas déterministe. Quand un algorithme suffit, il est plus fiable, plus économe et plus sobre. Une recherche par mots-clés bien réglée reste un adversaire sérieux : sur BEIR, BM25, l'algorithme classique de recherche lexicale, est « une base robuste », que plusieurs modèles sémantiques ne battent pas hors de leur domaine d'entraînement.
Comment mesurer le gain d'un reranker ?
Un reranker se juge sur vos documents et vos questions, pas sur un classement public. La méthode tient en cinq étapes.
- Constituer un jeu de test : 50 à 200 questions réelles, tirées des journaux de l'assistant, avec pour chacune les passages qui y répondent.
- Mesurer le rappel de la recherche seule : parmi les 50 ou 100 premiers candidats, combien contiennent le bon passage ? Ce rappel est le plafond du reranker.
- Comparer trois configurations : sans reranker, avec RRF seule, avec reranker. La mesure de référence est le nDCG@10, retenu par BEIR parce qu'il tient compte du rang et des degrés de pertinence ; le MRR, qui regarde le rang du premier bon passage, se lit plus facilement.
- Relever la latence et le coût par requête, en regardant les cas lents (95ᵉ centile) et pas seulement la moyenne.
- Relire à la main les passages écartés. Un reranker qui coupe trop écarte des passages utiles ; c'est en relisant les rapports, extrait par extrait, que nous avons fixé les règles de sélection de Jev.
Une précaution : régler un seuil de note (garder ce qui dépasse 0,5) plutôt qu'un nombre fixe (garder les 10 premiers) adapte la coupe à chaque question. Encore faut-il que les notes soient comparables, ce qui suppose un score normalisé entre 0 et 1, comme le permet bge-reranker-v2-m3 avec une sigmoïde.
Ce qu'une DSI peut en retenir
- Commencez par la recherche. Recherche hybride et RRF d'abord : sans rappel, pas de reranking utile.
- Mesurez avant d'ajouter un modèle. Un jeu de 50 questions réelles suffit pour savoir si le reranker gagne quelque chose sur vos documents.
- Choisissez la famille selon vos données. Données sensibles ou politique européenne : un cross-encoder open weight auto-hébergé, en vérifiant sa licence. Sinon, une API facturée au token, à traiter comme un sous-traitant.
- Surveillez la latence plus que la facture. Le coût du reranking est faible ; le temps ajouté se voit à chaque question.
- Écrivez le critère quand le métier l'exige. Un LLM juge permet de dire ce qui est pertinent pour vous (« au moins partiellement », « document en vigueur »), là où un cross-encoder applique une pertinence apprise ailleurs.
Chez Ask This Guy, le reranking fait partie de la recherche documentaire de notre RAG entreprise clé en main : recherche hybride, puis Jev pour les organisations en politique IA Worldwide. Les organisations en politique UE uniquement n'envoient aucun extrait à ce fournisseur américain.
Questions fréquentes sur le reranking et les rerankers
Qu'est-ce qu'un reranker ?
Un reranker est un modèle qui reçoit une question et une liste de passages déjà trouvés par une recherche, et qui attribue à chaque passage une note de pertinence. La liste est ensuite réordonnée selon ces notes et, le plus souvent, coupée pour ne garder que les meilleurs. Dans un RAG, il se place entre la recherche et le LLM qui rédige la réponse.
Quelle différence entre un cross-encoder et un bi-encoder ?
Un bi-encoder transforme la question et chaque document en vecteurs séparés, calculés à l'avance, ce qui permet de chercher en quelques millisecondes dans des millions de passages. Un cross-encoder lit la question et un passage ensemble dans le même modèle : il est plus précis, mais il doit refaire le calcul pour chaque couple. On utilise donc le bi-encoder pour chercher et le cross-encoder pour reclasser quelques dizaines de candidats.
Le reranking est-il indispensable dans un RAG ?
Non. Il améliore la pertinence quand la recherche ramène beaucoup de candidats de qualité inégale, ce qui est fréquent avec une recherche hybride. Il apporte peu si la recherche renvoie peu de passages, si la question porte sur une référence exacte, ou si le bon passage n'a pas été trouvé. La seule façon de trancher est de mesurer sur un jeu de questions réelles.
Combien de passages faut-il donner à un reranker ?
Il n'existe pas de nombre universel. Les exemples publiés vont d'une centaine de candidats (documentation Sentence Transformers) à 150 candidats pour 20 gardés (Contextual Retrieval d'Anthropic). Plus de candidats améliore le rappel, mais augmente la latence et le coût, puisque le reranker note chaque passage. Le bon réglage se trouve en mesurant les deux.
Quel reranker choisir pour des documents en français ?
Il faut un modèle multilingue. En open weight, bge-reranker-v2-m3 (BAAI) et Qwen3-Reranker (Alibaba) sont sous licence Apache 2.0 et couvrent le français ; ils peuvent être hébergés en Europe sur vos propres serveurs. En API, Cohere évalue Rerank 5 sur une vingtaine de langues, dont le français. Dans tous les cas, testez sur vos propres documents.
La fusion RRF remplace-t-elle un reranker ?
Pas exactement. La Reciprocal Rank Fusion fusionne plusieurs listes de résultats (mots-clés et sémantique) à partir de leurs rangs, sans lire le texte. Elle ne juge pas la pertinence d'un passage par rapport à la question. C'est une excellente première étape, gratuite et déterministe ; un reranker vient ensuite, si la mesure montre qu'il apporte un gain.
Conclusion
Le reranking améliore souvent un RAG à peu de frais, à condition de rester à sa place : après une bonne recherche, jamais à la place de celle-ci. Un cross-encoder ou un LLM juge apporte une lecture fine que les vecteurs n'ont pas. Une fusion RRF règle déjà une bonne partie du problème sans aucun modèle. Entre les deux, la mesure tranche.
Pour voir comment ce reranking se comporte en production, avec ses chiffres de coût et de latence, lisez notre retour d'expérience sur Jev. Et si vous voulez tester une recherche documentaire filtrée sur vos propres documents, réservez une démo.